Grafana OnCall OSS, c’est fini. Le projet est passé en mode maintenance le 11 mars 2025, son développement s’est arrêté le 24 mars 2026 avec l’archivage du dépôt (il se trouve désormais en lecture seule dans l’organisation cold-storage de Grafana sur GitHub), et ce même jour, Grafana a coupé la Cloud Connection qui acheminait les SMS, les appels téléphoniques et les notifications push mobiles vers les instances auto-hébergées. Si votre ingénieur d’astreinte était réveillé par une notification push d’un OnCall auto-hébergé, ce n’est plus arrivé depuis mars.
La voie officielle est Grafana Cloud IRM, le produit managé qui a fusionné OnCall et Incident en avril 2025. C’est la bonne réponse pour certaines équipes et la mauvaise pour d’autres, et ce guide s’adresse au second groupe. J’y détaille exactement ce qui s’est arrêté, ce que coûte Grafana Cloud IRM, cinq alternatives à Grafana OnCall (Hyperping, PagerDuty, incident.io, Rootly et GoAlert pour la place open source) et un tableau de migration qui fait correspondre chaînes d’escalade, plannings et intégrations à chaque outil.
Si vous cherchez la catégorie astreinte au sens large plutôt qu’un plan de sortie de Grafana OnCall, notre guide des 10 meilleurs outils de planning d’astreinte la couvre. Cet article ne reprend pas cette liste.
À retenir
- Grafana OnCall auto-hébergé fonctionne toujours, mais depuis le 24 mars 2026 il ne reçoit plus aucun correctif et ne peut plus envoyer de SMS, d’appels ni de push mobiles via le relais de Grafana. Slack, Telegram, l’e-mail et les webhooks continuent de fonctionner.
- Grafana Cloud IRM coûte 19 $/mois de frais de plateforme (3 utilisateurs IRM actifs inclus), plus 20 $ par utilisateur IRM actif supplémentaire, et l’offre gratuite s’arrête à 3 utilisateurs actifs.
- Le migrateur de Grafana accepte désormais une source OnCall OSS, mais il ne crée ni les utilisateurs ni les équipes, et il ne cible que Grafana Cloud IRM.
- Pour une équipe de 10 personnes, Hyperping Pro coûte 74 $/mois en annuel, monitoring et page de statut compris, contre 159 $/mois pour Grafana Cloud IRM Pro et 200 à 250 $/mois pour Rootly, PagerDuty ou incident.io, dont aucun n’inclut de vérifications de disponibilité.
- GoAlert est le remplaçant open source qui garde plannings, escalades et alertes Twilio sur vos propres serveurs, au prix d’un projet qui avance lentement : la v0.35.0 de septembre 2026 est arrivée onze mois après la v0.34.1.
Pourquoi vous pouvez vous fier à ce guide
Je suis Léo, fondateur d’Hyperping : l’une des cinq alternatives ci-dessous est donc la mienne. Je ne pense pas qu’Hyperping soit le bon choix pour tous les utilisateurs d’OnCall, et je dis où il ne l’est pas : si vos alertes doivent continuer à venir de Prometheus Alertmanager, Hyperping n’est pas la bonne destination, et je cite les outils qui acceptent ces webhooks.
Chaque date de cet article vient de l’annonce du mode maintenance publiée par Grafana, de l’avis sur l’installation OSS et du dépôt archivé. Les prix ont été relevés sur la page tarifs de chaque éditeur le 16 septembre 2026. Quand la documentation de Grafana se contredit sur les outils de migration, je cite les deux pages plutôt que d’en choisir une.
Ce qui s’est arrêté exactement dans Grafana OnCall OSS
Trois choses distinctes se sont produites, et les équipes ont tendance à les confondre.
| Date | Ce qui a changé | Effet sur une instance auto-hébergée |
|---|---|---|
| 11 mars 2025 | OnCall OSS passe en mode maintenance | Seuls les bugs critiques et les CVE d’un score CVSS de 7,0 ou plus sont corrigés. Plus de nouvelles fonctionnalités. |
| 21 avril 2025 | Fin des apps OnCall (Cloud) et Incident dans Grafana Cloud | Les clients Cloud passent à l’app unifiée Grafana Cloud IRM. |
| 24 mars 2026 | Fin du développement, dépôt archivé, Cloud Connection désactivée | Code en lecture seule, déplacé dans l’organisation grafana-cold-storage sur GitHub. Les push de l’app mobile, les SMS et les appels via le relais de Grafana s’arrêtent. |
Ce qui fonctionne encore après le 24 mars 2026 sur une instance auto-hébergée : le ChatOps Slack et Microsoft Teams, Telegram, l’e-mail, les webhooks sortants, et les SMS ou appels vocaux si vous aviez branché votre propre compte Twilio, Exotel ou Zvonok au lieu de la Cloud Connection. L’annonce de Grafana suggère aussi des push via Pushover, Gotify ou ntfy à l’aide de webhooks.
Ce qui ne fonctionne plus : l’application mobile connectée à une stack auto-hébergée, et toutes les notifications qui passaient par les serveurs de Grafana. Les correctifs de sécurité des images de conteneurs s’arrêtent aussi, et c’est ce point qui attire l’attention d’un audit interne.
Une équipe qui n’a jamais utilisé la Cloud Connection et alerte via Slack peut donc continuer à faire tourner la version archivée un moment. Une équipe qui comptait sur l’application mobile pour les alertes de 3 h du matin a déjà perdu son canal de réveil, et c’est elle qui doit migrer maintenant.
Grafana Cloud IRM : l’option par défaut et son prix
Grafana Cloud IRM, c’est là que Grafana veut vous voir aller. C’est OnCall et Incident fusionnés en une seule app dans Grafana Cloud, avec les mêmes chaînes d’escalade, plannings, routes et ChatOps, plus la gestion des incidents et l’application mobile qui ne parle plus à la version OSS.
Tarifs
Selon grafana.com en septembre 2026 :
- Free : limité à 3 utilisateurs IRM actifs par mois, support communautaire.
- Pro : 19 $/mois de frais de plateforme qui incluent 3 utilisateurs IRM actifs, puis 20 $ par utilisateur IRM actif supplémentaire, avec des remises sur volume automatiques et un support par e-mail 8x5.
- Enterprise : engagement minimum de 25 000 $ par an, support premium, options BYOC et cloud fédéral.
Un utilisateur IRM actif est toute personne qui figure dans un planning d’astreinte ou une chaîne d’escalade au cours du mois, ou qui acquitte une alerte, modifie une alerte, crée ou modifie un incident. Lisez bien cette définition : chaque ingénieur d’une rotation compte, qu’il ait été alerté ou non.
| Équipe en rotation | Grafana Cloud IRM Pro, par mois |
|---|---|
| 3 personnes | 19 $ (frais de plateforme seuls) |
| 5 personnes | 59 $ |
| 10 personnes | 159 $ |
| 25 personnes | 459 $ |
Ce que j’apprécie
- La migration la plus courte. Mêmes concepts, même provider Terraform, mêmes apps Slack et Teams. Si vos alertes naissent dans l’alerting Grafana, le lien vers le dashboard et les valeurs des métriques arrivent toujours jusque dans l’alerte.
- Un migrateur existe pour la source OSS. Le dépôt irm-tooling de Grafana accepte
MIGRATING_FROM="oncall_oss"et copie les chaînes d’escalade, les plannings et les shifts, les intégrations, les routes et les webhooks sortants. Il s’exécute d’abord en mode plan. - L’application mobile revient. Les notifications push, SMS et téléphone font partie du produit managé.
Points de vigilance
- La documentation de Grafana se contredit. La page dédiée à la migration OSS indique que « les outils de migration IRM ne prennent pas en charge pour l’instant Grafana OnCall OSS comme plateforme source » et renvoie vers Terraform ou l’API d’OnCall, alors que la vue d’ensemble de la migration et le README de l’outil listent OnCall OSS comme pris en charge. En pratique, le migrateur ne crée ni les utilisateurs ni les équipes, fait correspondre les personnes par e-mail et ne peut pas créer d’intégrations d’appel direct (direct paging). Prévoyez une passe manuelle dans tous les cas.
- Vous perdez l’auto-hébergement. Plannings, contenus des alertes et chronologies d’incidents partent dans le cloud de Grafana. Pour les équipes qui avaient choisi OnCall OSS pour la résidence des données, c’est justement la raison de partir.
- Le compteur par utilisateur est large. Dix ingénieurs dans une rotation, c’est 159 $/mois avant même de payer les métriques, logs ou traces de Grafana Cloud.
- Toujours pas de vérifications externes ni de page de statut publique. Comme OnCall, IRM route des alertes. La détection reste dans Prometheus ou dans le monitoring synthétique, et les pages de statut destinées aux clients restent un abonnement à part.
Choisissez Grafana Cloud IRM si vous payez déjà Grafana Cloud, si vos alertes sont des règles d’alerting Grafana et si vous n’avez aucune exigence d’auto-hébergement. Passez votre chemin si vous quittez OnCall OSS pour une autre raison que l’avis de maintenance, ou si vous voulez arrêter de payer pour chaque ingénieur de la rotation.
Les 5 meilleures alternatives à Grafana OnCall
J’ai retenu cinq outils qui remplacent chacun une chose différente que faisait OnCall pour vous : Hyperping pour les équipes qui veulent la détection et l’astreinte sur une seule facture, PagerDuty pour le routage d’alertes en entreprise, incident.io et Rootly pour une gestion des incidents native dans Slack, et GoAlert pour la place open source et auto-hébergée qu’occupait OnCall OSS.
| Outil | Accepte les webhooks Alertmanager ou Grafana | Vérifications de disponibilité intégrées | Page de statut | Auto-hébergé | Prix pour 10 personnes, par mois |
|---|---|---|---|---|---|
| Grafana Cloud IRM | Oui (natif) | Non | Non | Non | 159 $ |
| Hyperping | Non (Hyperping est la source des alertes) | Oui | Oui | Non | 74 $ (Pro, annuel) |
| PagerDuty | Oui | Non | En option (Statuspage) | Non | 210 $ (Professional, annuel) |
| incident.io | Oui | Non | Oui (limitée en Team) | Non | 250 $ (Team + astreinte) |
| Rootly | Oui | Non | Oui | Non | 200 $ (On-Call Essentials) |
| GoAlert | Oui | Non | Non | Oui | 0 $ plus un serveur et Twilio |
1. Hyperping : astreinte, monitoring et pages de statut dans une seule offre à prix fixe
Idéal pour : les équipes de 2 à 50 personnes dont les intégrations OnCall servaient surtout aux alertes de disponibilité, de SSL et de cron, et qui veulent la vérification, l’alerte et la page de statut dans un seul outil.
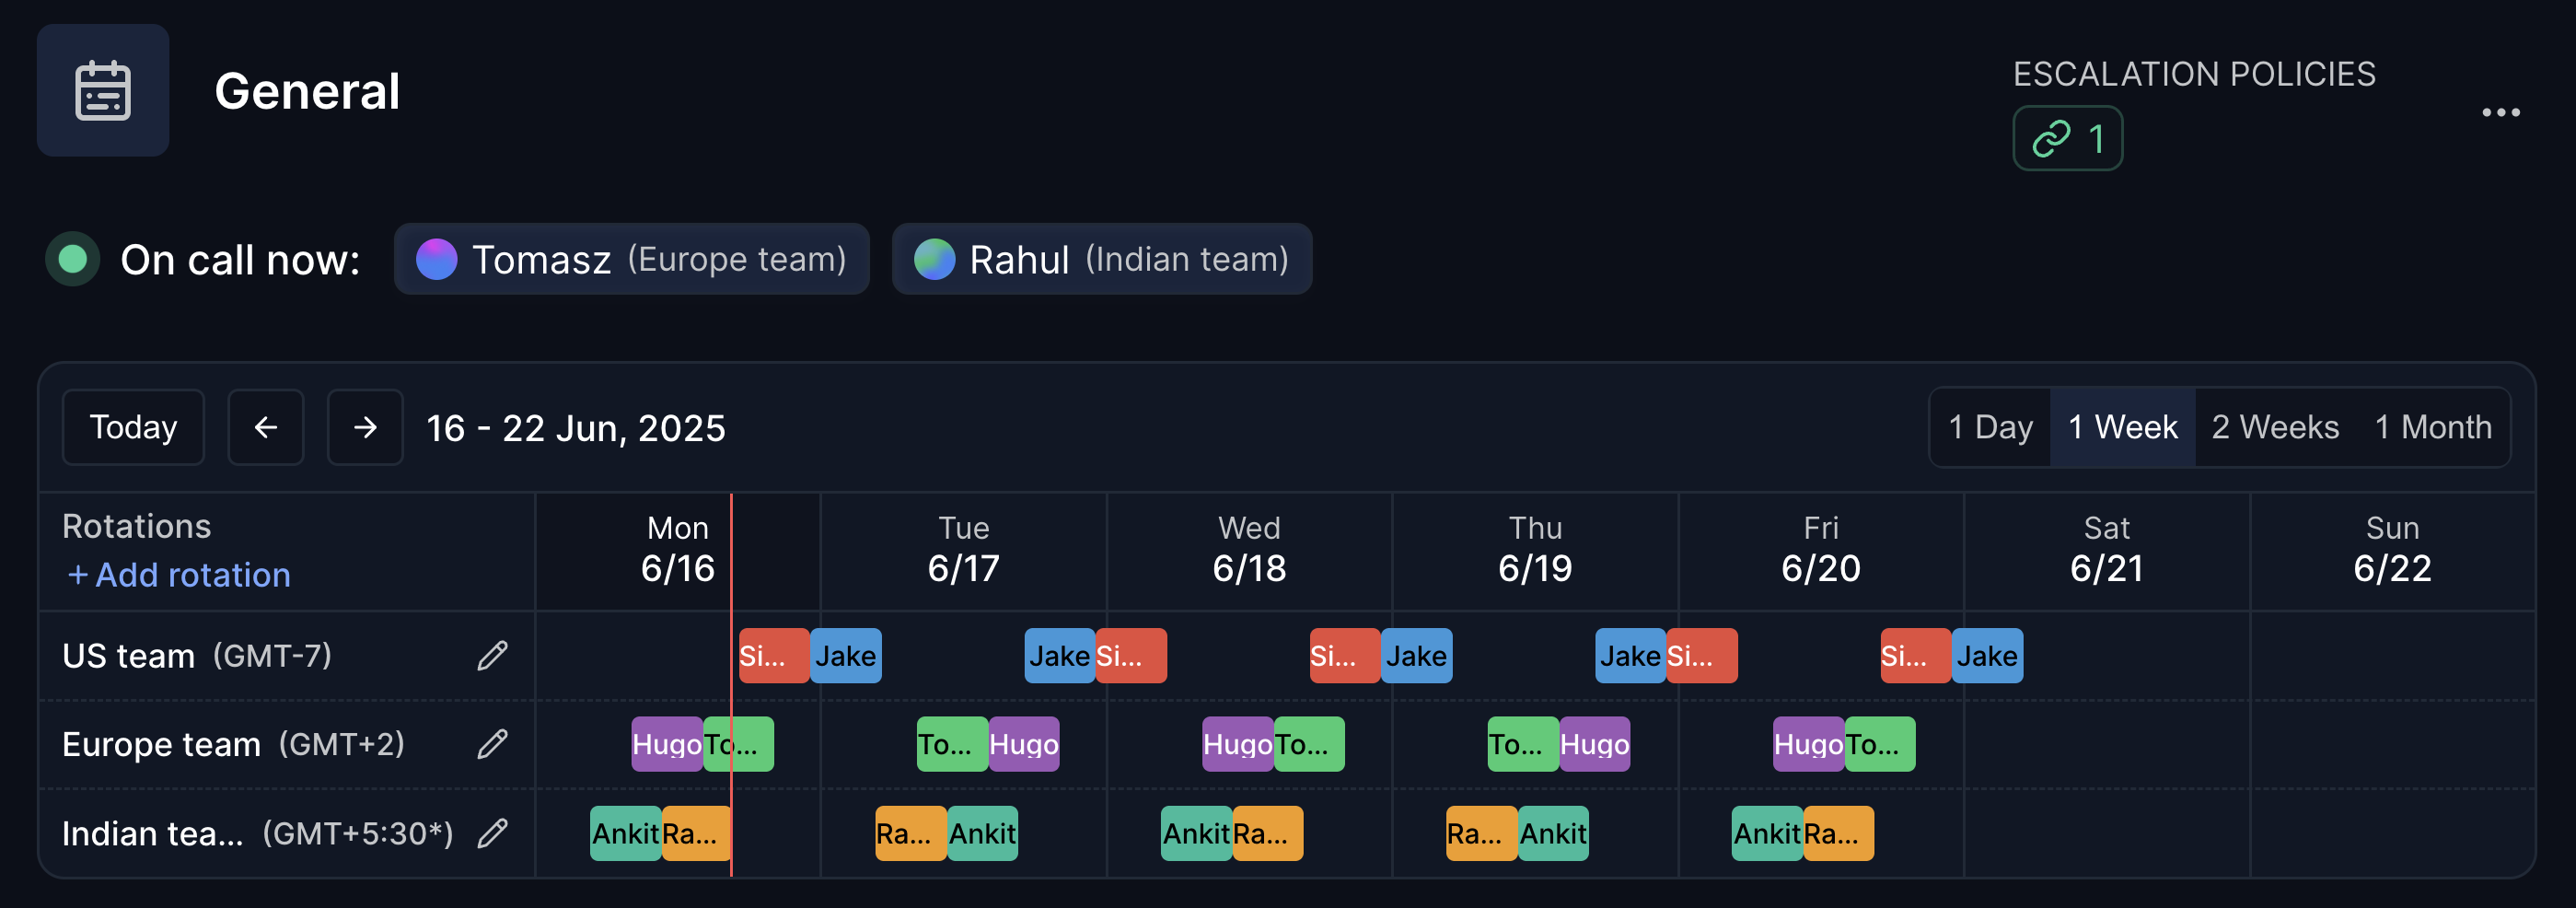
La plupart des déploiements OnCall OSS que j’ai vus routent deux types d’alertes : des règles Prometheus sur des métriques internes, et des vérifications de type blackbox pour savoir si le site répond. Hyperping remplace le second type à la source. Les vérifications HTTP, heartbeat cron, DNS, port et navigateur Playwright tournent depuis 18 régions, et quand l’une échoue, la politique d’escalade alerte directement l’ingénieur d’astreinte. Aucun webhook entre la vérification et l’alerte.
Fonctionnalités notables
- Plannings d’astreinte avec une rotation par équipe ou par fuseau horaire, heure de relève, shifts simultanés, restrictions horaires et remplacements
- Politiques d’escalade avec des étapes ordonnées et des délais sur Slack, Teams, e-mail, SMS et appel téléphonique, où une étape peut cibler « la personne d’astreinte » d’un planning
- Alertes groupées : une panne commune envoie une seule alerte au lieu d’une par moniteur
- Pages de statut sur votre propre domaine avec abonnés, et pages protégées par mot de passe ou SSO en Pro et Business
- Provider Terraform, API REST et un exporteur Prometheus pour que disponibilité et temps de réponse arrivent toujours dans vos dashboards Grafana
- Intégrations sortantes vers PagerDuty et Opsgenie si une partie de l’équipe reste sur un autre outil d’astreinte pendant la transition
Tarifs
Prix de la page tarifs d’Hyperping, en facturation annuelle, avec le prix mensuel entre parenthèses :
- Free : 20 moniteurs, vérifications toutes les 5 minutes, 1 page de statut, pas d’astreinte
- Essentials : 24 €/mois (29 € en mensuel), 3 sièges inclus puis 7 € par siège, 1 planning d’astreinte, 20 SMS par mois
- Pro : 74 €/mois (89 € en mensuel), 10 sièges inclus puis 9 € par siège, 3 plannings, 75 SMS, vérifications navigateur
- Business : 249 €/mois (299 € en mensuel), 20 sièges inclus puis 12 € par siège, 200 SMS, options marque blanche et SAML
Une équipe de 10 personnes tient dans les 10 sièges inclus de Pro et paie 74 €/mois, monitoring et page de statut compris.
Points de vigilance
- Pas d’intégration d’alertes entrantes. Hyperping ne reçoit pas les webhooks d’Alertmanager ni de l’alerting Grafana. Si vos règles Prometheus doivent continuer à alerter des personnes, Hyperping couvre les vérifications externes et vous gardez un outil d’astreinte capable de recevoir des webhooks pour les alertes internes, ou vous choisissez l’un des outils ci-dessous.
- Slack au niveau des notifications, pas un cycle de vie d’incident natif dans Slack. On peut acquitter et escalader depuis Slack, mais il n’y a ni automatisation de canal d’incident ni générateur de post-mortem.
- Catalogue d’intégrations plus réduit que celui de PagerDuty : Slack, Teams, Discord, Google Chat, Telegram, e-mail, SMS, téléphone, webhooks, PagerDuty, Opsgenie, Twilio et Intercom.
- Pas d’application mobile dédiée. Les alertes arrivent sur votre téléphone par SMS, appel, Slack ou Teams.
Choisissez Hyperping si vous voulez arrêter de faire tourner trois outils (vérifications, astreinte, page de statut) et que vos alertes viennent de services en panne plutôt que de seuils de métriques. Essayez gratuitement avec 20 moniteurs.
2. PagerDuty : le routage d’entreprise avec le plus grand catalogue d’intégrations
Idéal pour : les organisations de plus de 50 ingénieurs qui ont besoin d’un SLA éditeur, d’AIOps et de plus de 750 intégrations, et peuvent payer par utilisateur.
PagerDuty est ce que la plupart des déploiements OnCall OSS cherchaient à éviter pour une question de coût. C’est aussi l’outil qui répond le plus complètement à la question « est-ce qu’il s’intègre avec X » : Alertmanager, l’alerting Grafana, Datadog, CloudWatch et 750 autres y envoient des événements, et l’orchestration d’événements les dédoublonne et les route avant que quiconque soit alerté.
Fonctionnalités notables
- Plannings, politiques d’escalade, remplacements et routage round-robin
- Orchestration d’événements et AIOps pour le dédoublonnage et la réduction du bruit (offres PD Reliability Platform)
- Automatisation des runbooks et workflows d’incident
- Application mobile avec push, SMS et téléphone, qu’un utilisateur d’OnCall auto-hébergé trouvera familière
- Provider Terraform
Tarifs
D’après la page tarifs de PagerDuty :
- Free : jusqu’à 5 utilisateurs, 1 planning, 1 politique d’escalade, 100 notifications SMS et téléphone par mois
- Professional : 21 $/utilisateur/mois en annuel (25 $ en mensuel)
- PD Reliability Platform, payé d’avance à l’année : Starter 2 800 $ (10 sièges), Essential 12 000 $ (20 sièges), Plus 48 000 $ (50 sièges), Ultimate sur devis (500 sièges), avec AIOps et automatisation
Dix ingénieurs en Professional coûtent 210 $/mois, et Statuspage comme le monitoring synthétique sont des produits séparés.
Points de vigilance
- Pour une petite équipe, le prix par utilisateur représente 5 à 10 fois les frais de plateforme de Grafana Cloud IRM, avant l’AIOps.
- Le planning unique et la politique d’escalade unique de l’offre gratuite couvrent une équipe au maximum.
- Pas de monitoring intégré, et pas de page de statut sans Statuspage.
Choisissez PagerDuty si vous quittez OnCall OSS parce qu’un audit ou un service achats a exigé un éditeur avec support, et que l’étendue des intégrations compte plus que le prix. Pour une analyse plus complète, consultez notre guide des alternatives à PagerDuty.
3. incident.io : gestion des incidents native dans Slack, astreinte en plus
Idéal pour : les équipes qui gèrent leurs incidents dans Slack et veulent la rotation d’astreinte, le canal d’incident et le post-mortem dans le même produit.
L’intégration Slack était la meilleure fonctionnalité d’OnCall. incident.io va plus loin : l’alerte, le canal d’incident, les rôles, la mise à jour de la page de statut et le post-mortem rédigé par l’IA se font tous depuis Slack ou Teams, avec l’astreinte vendue en option par utilisateur.
Fonctionnalités notables
- Plannings d’astreinte, chemins d’escalade et remplacements, gérés depuis Slack
- Réception d’alertes depuis Alertmanager, Grafana, Datadog et des webhooks
- Canaux d’incident, rôles, chronologies et post-mortems générés par l’IA
- Pages de statut, limitées en offre Team
- Application mobile avec push, SMS et téléphone
Tarifs
D’après la page tarifs d’incident.io :
- Basic : gratuit, astreinte pour une seule équipe et une page de statut
- Team : 15 $/utilisateur/mois en annuel (19 $ en mensuel) plus 10 $/utilisateur/mois pour l’astreinte
- Pro : 25 $/utilisateur/mois plus 20 $/utilisateur/mois pour l’astreinte
- On-call seul : 20 $/utilisateur/mois
- Enterprise : sur devis
Dix personnes en Team avec l’astreinte, c’est 250 $/mois ; l’astreinte seule, 200 $/mois.
Points de vigilance
- Deux compteurs par utilisateur s’additionnent : le siège de gestion des incidents et le siège d’astreinte.
- Sans Slack ni Teams, l’essentiel de l’intérêt disparaît.
- Pas de vérifications de disponibilité. La détection reste dans Grafana ou ailleurs.
Choisissez incident.io si votre goulot d’étranglement après l’alerte est la coordination et non la détection, et que votre équipe vit dans Slack. Notre guide des alternatives à incident.io détaille les compromis.
4. Rootly : gestion des incidents et astreinte orientées IA pour les entreprises de taille intermédiaire
Idéal pour : les équipes de 30 à 300 personnes en forte croissance qui veulent automatiser leurs workflows entre Jira, GitHub et Zoom, avec un module d’astreinte séparé facturé par utilisateur.
Rootly vend la gestion des incidents et l’astreinte comme deux produits séparés, au même prix par utilisateur. Le module d’astreinte a ce qu’un utilisateur d’OnCall OSS attend (plannings, politiques d’escalade, regroupement et routage des alertes), plus ce qu’OnCall n’a jamais eu : rotations en doublure (shadow), gestion des congés, détection des trous dans les plannings et calculateur de primes d’astreinte.
Fonctionnalités notables
- Regroupement et routage des alertes, avec routage d’appels en direct
- Plannings avec rotations en doublure, gestion des congés et détection des trous
- Cycle de vie d’incident natif dans Slack et Teams, avec scribe IA et rétrospectives
- Page de statut incluse dans Incident Response Essentials
- Réception depuis Alertmanager, Grafana, Datadog et des webhooks
Tarifs
D’après la page tarifs de Rootly :
- On-Call Essentials : 20 $/utilisateur/mois
- Incident Response Essentials : 20 $/utilisateur/mois
- Enterprise pour l’un ou l’autre : sur devis
- Programme startup : jusqu’à 50 % de remise sous 100 salariés, « payez ce que vous pouvez » sous 25
Dix ingénieurs en On-Call Essentials coûtent 200 $/mois, et 400 $/mois si vous ajoutez Incident Response.
Points de vigilance
- Pas d’offre gratuite, et les deux modules doublent la facture par utilisateur si vous voulez les deux.
- Une profondeur de configuration qu’une équipe de 5 personnes n’utilisera pas.
- Pas de vérifications de disponibilité.
Choisissez Rootly si vous voulez une automatisation des workflows plus poussée qu’incident.io et un modèle de rotation avec doublures et congés intégrés. Consultez notre guide des alternatives à Rootly pour la comparaison directe.
5. GoAlert : le remplaçant open source et auto-hébergé
Idéal pour : les équipes qui avaient choisi OnCall OSS pour l’auto-hébergement et la résidence des données, et qui ont quelqu’un pour exploiter un service de plus.
GoAlert est maintenu par Target sous licence Apache 2.0. Il fait l’essentiel de ce que faisait OnCall OSS : rotations et plannings, politiques d’escalade, alertes par e-mail, SMS et appel vocal via votre propre compte Twilio, notifications Slack, webhooks génériques et une intégration Prometheus Alertmanager. Il tourne sous la forme d’un unique binaire Go sur PostgreSQL, bien plus léger que la stack Django, Celery, Redis et MySQL d’OnCall.
Fonctionnalités notables
- Plannings d’astreinte, rotations et remplacements temporaires
- Politiques d’escalade avec étapes répétées
- Intégrations Alertmanager, Grafana, webhook générique et e-mail
- SMS et appels vocaux via Twilio, notifications dans des canaux Slack
- Abonnements calendrier et clés d’API
Tarifs
Gratuit. Vous payez un serveur, PostgreSQL et la consommation Twilio.
Points de vigilance
- Rythme des versions. La dernière version, la v0.35.0, date de septembre 2026, après la v0.34.1 en octobre 2025, la v0.34.0 en août 2025 et la v0.33.0 en novembre 2024 (historique des versions). Le projet est vivant mais lent, et mieux vaut lire l’historique des commits avant de lui confier vos alertes.
- Pas d’application mobile. Les alertes arrivent par SMS, appel, e-mail ou Slack.
- Pas de gestion des incidents, pas de page de statut, pas de contexte propre à Grafana dans l’alerte.
- D’autres outils open source couvrent des besoins voisins, mais pas les plannings d’astreinte : Keep gère l’agrégation d’alertes, Uptime Kuma les vérifications, Zabbix le monitoring d’infrastructure avec des escalades basiques.
Choisissez GoAlert si l’auto-hébergement est une exigence ferme et que Slack plus Twilio vous suffisent comme canaux. Si l’exigence est « open source » plutôt qu’« auto-hébergé », demandez-vous si un projet qui avance lentement vaut mieux qu’un service managé que vous pouvez quitter.
Grafana OnCall ou PagerDuty : lequel après l’archivage ?
C’est la comparaison que la plupart des gens recherchent, alors la voici à part. La comparaison qui compte aujourd’hui oppose Grafana Cloud IRM à PagerDuty, puisque la version OSS n’est plus une option pour un nouveau déploiement.
| Grafana Cloud IRM | PagerDuty Professional | |
|---|---|---|
| Prix, 10 ingénieurs en rotation | 159 $/mois | 210 $/mois en annuel |
| Prix, 25 ingénieurs | 459 $/mois | 525 $/mois en annuel |
| Sources d’alertes | Alerting Grafana en natif, plus webhooks | Plus de 750 intégrations |
| Réduction du bruit | Routes et regroupement | Orchestration d’événements, AIOps sur les offres Platform |
| Gestion des incidents | Incluse (ex-app Incident) | Incluse, automatisation des runbooks en supplément |
| Option auto-hébergée | Non | Non |
| Vérifications de disponibilité, page de statut | Non, non | Non, option Statuspage |
| Support éditeur | E-mail 8x5 en Pro | 24x7 à partir de Business |
Prenez Grafana Cloud IRM quand vos alertes viennent de Grafana et que vous voulez le dashboard dans l’alerte. Prenez PagerDuty quand vous avez des sources d’alertes hors de Grafana, besoin d’AIOps ou d’un contrat de support qu’une grande entreprise acceptera de signer. Ne prenez ni l’un ni l’autre quand ce qui déclenchait vos alertes était « le site est en panne », car les deux exigent encore un outil de monitoring séparé pour ça.
Tableau de migration : où va chaque objet Grafana OnCall
Chaque objet d’OnCall OSS a un équivalent quelque part, mais pas toujours là où on l’attend. Exportez d’abord, faites la correspondance ensuite.
| Grafana OnCall OSS | Grafana Cloud IRM | Hyperping | PagerDuty | incident.io | Rootly | GoAlert |
|---|---|---|---|---|---|---|
| Intégration (Alertmanager, alerting Grafana, webhook) | Intégration, même schéma d’URL | Pas d’équivalent : à remplacer par des moniteurs Hyperping pour les vérifications externes | Service avec une clé d’intégration | Source d’alertes | Source d’alertes | Clé d’intégration par service |
| Route (regex sur le contenu pour choisir une chaîne) | Route | Affectation d’un moniteur à une politique d’escalade | Règle d’orchestration d’événements | Route d’alerte | Règle de routage d’alertes | Non disponible, une politique par service |
| Chaîne d’escalade | Chaîne d’escalade | Politique d’escalade avec étapes temporisées | Politique d’escalade | Chemin d’escalade | Politique d’escalade | Politique d’escalade avec répétition |
| Planning (web ou iCal) | Planning | Planning d’astreinte avec une rotation par équipe | Planning avec couches | Planning | Planning | Planning avec rotations |
| Remplacement de shift | Remplacement | Remplacement sur la rotation | Remplacement | Remplacement | Remplacement | Planning temporaire |
| Règles de notification utilisateur | Politique de notification | Choix du canal à chaque étape de la politique | Moyens de contact et règles | Préférences de notification | Règles de notification | Moyens de contact |
| ChatOps Slack et Teams | Mêmes apps | Notifications Slack et Teams, acquittement depuis Slack | Apps Slack et Teams | Slack et Teams en natif | Slack et Teams en natif | Notifications Slack |
| Push mobile | App mobile IRM | SMS et appel téléphonique, pas d’app dédiée | App PagerDuty | App incident.io | App Rootly | SMS et appel vocal uniquement |
| Webhooks sortants | Webhooks sortants | Intégration webhook | Webhooks v3 | Workflows | Workflows | Webhooks |
| Terraform (provider grafana) | Même provider | Provider Terraform Hyperping | Provider PagerDuty | Provider incident.io | Provider Rootly | Non disponible |
Exportez votre configuration avant de commencer
L’API d’OnCall OSS tourne toujours sur votre instance. Générez un jeton dans les réglages du plugin OnCall, notez l’URL du moteur affichée sur la même page et exportez chaque type d’objet en JSON. Gardez ces fichiers quelle que soit la destination choisie.
export ONCALL_URL="https://oncall.example.com"   # l'URL du moteur OnCall, pas celle de Grafana
export ONCALL_TOKEN="your-oncall-api-token"

for resource in integrations routes escalation_chains escalation_policies schedules on_call_shifts users; do
  curl -s -H "Authorization: $ONCALL_TOKEN" \
    "$ONCALL_URL/api/v1/$resource/?perpage=100" \
    > "oncall-$resource.json"
done
Si la destination est Grafana Cloud IRM, lancez le migrateur irm-tooling en mode plan avec ces identifiants avant le mode migrate, et attendez-vous à devoir d’abord inviter les utilisateurs et créer les équipes à la main. Pour toute autre destination, le JSON est votre inventaire : comptez les intégrations, listez les chaînes et reconstruisez-les avec le provider Terraform du nouvel outil quand il en existe un.
Trois points que le tableau ne règle pas
- Les règles Alertmanager qui alertent des personnes. Seuls Grafana Cloud IRM, PagerDuty, incident.io, Rootly et GoAlert acceptent le webhook. Si vous passez à Hyperping, décidez quelles règles deviennent des vérifications Hyperping et lesquelles restent sur un outil d’astreinte capable de recevoir des webhooks.
- L’historique des alertes. Aucun migrateur ne le transfère. Exportez ce dont vous avez besoin pour les post-mortems avant d’éteindre l’instance.
- Les numéros de téléphone. Les utilisateurs OSS sur la Cloud Connection n’ont jamais enregistré leur numéro chez un fournisseur tiers. Chaque intervenant doit saisir à nouveau un numéro vérifié dans le nouvel outil, et c’est l’étape qu’on saute jusqu’à la première alerte manquée.
Comment remplacer Grafana OnCall par Hyperping
La démarche ci-dessous fait quitter OnCall OSS à une équipe en deux semaines environ, l’essentiel en fonctionnement parallèle.
1. Exportez votre configuration OnCall
Lancez le script d’export ci-dessus et ouvrez les fichiers des plannings et des chaînes d’escalade. Notez, pour chaque chaîne, les étapes, les délais et les plannings auxquels elles renvoient. C’est le cahier des charges du reste de la migration.
2. Créez les moniteurs qui remplacent vos vérifications externes
Dans Hyperping, ajoutez un moniteur par endpoint que l’alerting Grafana surveillait depuis l’extérieur : vérifications HTTP avec assertions sur un mot-clé ou un code de statut, expiration SSL, heartbeats cron pour les tâches planifiées, et vérifications navigateur Playwright pour les parcours de connexion et de paiement. Réglez l’intervalle (30 secondes en Essentials et Pro) et les régions.
3. Recréez les plannings d’astreinte
Ouvrez On-Call dans la barre latérale et créez un planning pour chaque planning OnCall. Ajoutez une rotation par équipe ou par fuseau horaire, choisissez le type de rotation, l’heure de relève et l’ordre de rotation, puis vérifiez que l’aperçu du calendrier correspond au planning OnCall exporté. Les remplacements se gèrent par rotation : un échange de shifts n’oblige pas à reconstruire le planning.
4. Transformez les chaînes d’escalade en politiques d’escalade
Allez dans Escalation Policies et créez une politique par chaîne. Étape 1 avec un délai de 0 minute vers Slack ou Teams, étape 2 au bout de 5 minutes par SMS à la personne d’astreinte du planning, étape 3 après 10 minutes de plus par appel téléphonique à cette même personne et au responsable. Affectez la politique aux moniteurs de l’étape 2 et activez les alertes groupées pour qu’une panne commune ne déclenche qu’une alerte.
5. Connectez Slack, Teams, les SMS et le téléphone
Ajoutez l’intégration Slack ou Teams, puis demandez à chaque intervenant d’ajouter et de vérifier un numéro de téléphone dans les réglages de son compte. Si une partie de l’équipe reste sur PagerDuty ou Opsgenie pendant la transition, ajoutez l’intégration PagerDuty ou Opsgenie pour que les incidents Hyperping leur parviennent aussi.
6. Faites tourner les deux outils en parallèle pendant deux semaines
Laissez OnCall OSS router les alertes Grafana vers Slack. Laissez Hyperping alerter l’ingénieur d’astreinte pour les vérifications externes. Comparez les deux : délai jusqu’à la première notification, délai d’acquittement, et quelles alertes Hyperping a levées qu’OnCall n’a pas levées, ou l’inverse. Déclenchez au moins une fois un incident de test qui passe par chaque étape d’escalade.
7. Basculez et archivez
Mettez à jour les runbooks pour qu’ils pointent vers Hyperping, désactivez les chaînes d’escalade dans OnCall pour que plus rien n’alerte depuis lui, et gardez les exports JSON. Si vous avez encore besoin que des règles Prometheus alertent quelqu’un, gardez ce chemin sur un outil capable de recevoir des webhooks et laissez Hyperping prendre en charge les vérifications externes et la page de statut.
Grille de décision
- Déjà sur Grafana Cloud, alertes issues de l’alerting Grafana : Grafana Cloud IRM. Lancez d’abord le migrateur en mode plan.
- L’auto-hébergement n’est pas négociable : GoAlert, avec Twilio pour les SMS et les appels vocaux.
- Moins de 50 personnes, la plupart des alertes disent « c’est en panne » : Hyperping, et profitez-en pour retirer l’outil de monitoring séparé et la page de statut.
- Les incidents se gèrent dans Slack et le post-mortem est la corvée : incident.io, ou Rootly si vous voulez une automatisation des workflows plus poussée.
- Le service achats veut un éditeur avec SLA et 750 intégrations : PagerDuty.
Quel que soit votre choix, faites l’export cette semaine. L’instance archivée continue de tourner, mais il suffit d’une CVE non corrigée pour qu’elle devienne elle-même l’incident.
Pour aller plus loin
- Les 10 meilleurs outils de planning d’astreinte comparés pour la catégorie au sens large
- Opsgenie ferme : guide des alternatives si vous quittez aussi Atlassian
- Guide des politiques d’escalade pour concevoir les étapes et les délais
- Planning d’astreinte pour les petites équipes si votre rotation compte 2 ou 3 personnes
Continuez à comparer : Hyperping vs PagerDuty · Hyperping vs Opsgenie · Tarifs Hyperping · Toutes les comparaisons
Questions fréquentes
Grafana OnCall est-il abandonné ? ▼
La version open source, oui. Grafana OnCall OSS est passé en mode maintenance le 11 mars 2025, et son développement s’est arrêté le 24 mars 2026, date à laquelle le dépôt a été archivé. Il se trouve désormais en lecture seule dans l’organisation grafana-cold-storage de Grafana sur GitHub. Une instance auto-hébergée fonctionne toujours, mais elle ne reçoit plus de mises à jour, et la Cloud Connection qui acheminait les SMS, les appels et les notifications push mobiles a été coupée le jour de l’archivage. Le produit managé continue sous le nom de Grafana Cloud IRM.
Quelle est la meilleure alternative à Grafana OnCall ? ▼
Grafana Cloud IRM si vous voulez changer le moins de choses possible et payez déjà Grafana Cloud. Hyperping si vous voulez l’astreinte, le monitoring de disponibilité et les pages de statut dans une seule offre à prix fixe. PagerDuty pour l’alerting d’entreprise avec plus de 750 intégrations. incident.io ou Rootly pour une gestion des incidents native dans Slack. GoAlert si vous devez rester en open source et en auto-hébergé.
Existe-t-il une alternative open source à Grafana OnCall ? ▼
GoAlert, maintenu par Target sous licence Apache 2.0, est la plus proche encore disponible : plannings, rotations, politiques d’escalade, webhooks Alertmanager et Grafana, SMS et appels vocaux via Twilio. Sa dernière version est la v0.35.0 (septembre 2026), après la v0.34.1 d’octobre 2025 : prévoyez donc de l’exploiter vous-même. Keep, Zabbix et Uptime Kuma auto-hébergé couvrent une partie du travail, mais pas les plannings d’astreinte.
Combien coûte Grafana Cloud IRM ? ▼
Selon grafana.com en septembre 2026, l’offre gratuite autorise 3 utilisateurs IRM actifs par mois. L’offre Pro facture des frais de plateforme de 19 $ par mois qui incluent 3 utilisateurs IRM actifs, puis 20 $ par utilisateur IRM actif supplémentaire, avec des remises sur volume. Enterprise démarre à un engagement annuel de 25 000 $. Un utilisateur IRM actif est toute personne présente dans un planning ou une chaîne d’escalade, ou qui acquitte, alerte ou modifie des incidents au cours du mois.
Grafana OnCall ou PagerDuty : lequel choisir ? ▼
Prenez PagerDuty s’il vous faut un éditeur avec un SLA, plus de 750 intégrations, de l’AIOps et une application mobile mature, et que vous pouvez payer 21 $ par utilisateur et par mois en Professional, puis, pour l’AIOps, des frais PD Reliability Platform payés d’avance à l’année, à partir de 2 800 $ pour 10 sièges. Prenez Grafana Cloud IRM si vos alertes viennent déjà de l’alerting Grafana et que vous voulez le contexte des dashboards dans l’alerte, à 20 $ par utilisateur actif. Aucun des deux n’inclut de vérifications de disponibilité ni de page de statut publique.
Puis-je migrer automatiquement mes plannings et chaînes d’escalade Grafana OnCall OSS ? ▼
En partie. Le migrateur irm-tooling de Grafana accepte une source OnCall OSS et copie les chaînes d’escalade, les plannings, les intégrations, les routes et les règles de notification dans Grafana Cloud IRM, mais il ne crée ni les utilisateurs ni les équipes, et la page de migration OSS de Grafana renvoie toujours vers Terraform ou l’API. Pour toute autre destination, exportez les objets via l’API d’OnCall et reconstruisez-les dans le nouvel outil, idéalement sous forme de code.