Grafana OnCall OSS is voorbij. Het project ging op 11 maart 2025 in onderhoudsmodus, de ontwikkeling stopte op 24 maart 2026 toen de repository werd gearchiveerd (die staat nu alleen-lezen in de cold-storage-organisatie van Grafana op GitHub), en op diezelfde dag zette Grafana de Cloud Connection uit die sms, telefoontjes en mobiele pushmeldingen naar self-hosted instanties stuurde. Werd je engineer met piketdienst wakker van een pushmelding uit een self-hosted OnCall? Dat is sinds maart niet meer gebeurd.
De officiële route is Grafana Cloud IRM, het beheerde product waarin OnCall en Incident in april 2025 zijn samengevoegd. Voor sommige teams is dat het juiste antwoord, voor andere niet, en deze gids is voor die tweede groep. Ik behandel precies wat er is gestopt, wat Grafana Cloud IRM kost, vijf Grafana OnCall alternatieven (Hyperping, PagerDuty, incident.io, Rootly en GoAlert als open-sourceoptie) en een migratietabel die laat zien waar escalation chains, roosters en integraties in elke tool terechtkomen.
Zoek je de bredere categorie pikettools in plaats van een exitplan voor Grafana OnCall, dan behandelt onze gids top 10 tools voor piketroosters die. Dit artikel herhaalt die lijst niet.
Belangrijkste punten
- Self-hosted Grafana OnCall draait nog, maar krijgt sinds 24 maart 2026 geen fixes meer en kan via de relay van Grafana geen sms, telefoontjes of mobiele push meer versturen. Slack, Telegram, e-mail en webhooks blijven werken.
- Grafana Cloud IRM kost $ 19/mnd platformkosten (3 actieve IRM-gebruikers inbegrepen) plus $ 20 per extra actieve IRM-gebruiker, en de gratis versie stopt bij 3 actieve gebruikers.
- De migrator van Grafana accepteert nu OnCall OSS als bron, maar maakt geen gebruikers of teams aan en migreert alleen naar Grafana Cloud IRM.
- Voor een team van 10 personen kost Hyperping Pro $ 74/mnd bij jaarlijkse facturatie, met monitoring en een statuspagina inbegrepen, tegenover $ 159/mnd voor Grafana Cloud IRM Pro en $ 200 tot $ 250/mnd voor Rootly, PagerDuty of incident.io, die geen van alle uptime-checks bevatten.
- GoAlert is de open-source vervanger die roosters, escalaties en oproepen via Twilio op je eigen servers houdt, met als prijs een traag project: v0.35.0 in september 2026 kwam elf maanden na v0.34.1.
Waarom je deze gids kunt vertrouwen
Ik ben Léo, oprichter van Hyperping, dus een van de vijf alternatieven hieronder is van mij. Ik vind Hyperping niet voor elke OnCall-gebruiker de juiste keuze, en ik zeg waar het dat niet is: als je meldingen uit Prometheus Alertmanager moeten blijven komen, is Hyperping de verkeerde bestemming, en ik noem de tools die die webhooks wel accepteren.
Elke datum in dit artikel komt uit Grafana’s eigen aankondiging van de onderhoudsmodus, de OSS-installatiemelding en de gearchiveerde repository. De prijzen heb ik op 16 september 2026 op de prijspagina van elke leverancier gelezen. Waar de documentatie van Grafana zichzelf tegenspreekt over de migratietools, citeer ik beide pagina’s in plaats van er een te kiezen.
Wat er precies is gestopt in Grafana OnCall OSS
Er zijn drie afzonderlijke dingen gebeurd, en teams halen ze vaak door elkaar.
| Datum | Wat er veranderde | Gevolg voor een self-hosted instantie |
|---|---|---|
| 11 maart 2025 | OnCall OSS gaat in onderhoudsmodus | Alleen kritieke bugs en CVE’s met een CVSS-score van 7,0 of hoger worden nog gefixt. Geen nieuwe functies. |
| 21 april 2025 | De apps OnCall (Cloud) en Incident verdwijnen uit Grafana Cloud | Cloudklanten zijn overgezet naar de samengevoegde Grafana Cloud IRM-app. |
| 24 maart 2026 | Ontwikkeling stopt, repository gearchiveerd, Cloud Connection uitgeschakeld | Code alleen-lezen, verhuisd naar de organisatie grafana-cold-storage op GitHub. Push via de mobiele app, sms en telefoontjes via de relay van Grafana stoppen. |
Wat na 24 maart 2026 nog werkt op een self-hosted instantie: ChatOps in Slack en Microsoft Teams, Telegram, e-mail, uitgaande webhooks, en sms of spraak als je je eigen Twilio-, Exotel- of Zvonok-account had gekoppeld in plaats van de Cloud Connection. De aankondiging van Grafana stelt ook push voor via Pushover, Gotify of ntfy met webhooks.
Wat niet meer werkt: de mobiele app gekoppeld aan een self-hosted stack, en elke melding die via de servers van Grafana liep. Ook de beveiligingspatches voor de container-images stoppen, en juist dat trekt de aandacht van een interne audit.
Een team dat de Cloud Connection nooit heeft gebruikt en via Slack oproept, kan de gearchiveerde versie dus nog een tijdje laten draaien. Een team dat op de mobiele app vertrouwde voor oproepen om 3 uur ’s nachts, is zijn wekkanaal al kwijt, en dat is de groep die nu moet overstappen.
Grafana Cloud IRM: de standaardoptie en wat die kost
Grafana Cloud IRM is waar Grafana je naartoe wil hebben. Het is OnCall en Incident samengevoegd tot één app binnen Grafana Cloud, met dezelfde escalation chains, roosters, routes en ChatOps, plus incidentbeheer en de mobiele app die niet meer met OSS praat.
Prijzen
Zoals vermeld op grafana.com in september 2026:
- Free: beperkt tot 3 actieve IRM-gebruikers per maand, community-support.
- Pro: $ 19/mnd platformkosten inclusief 3 actieve IRM-gebruikers, daarna $ 20 per extra actieve IRM-gebruiker, met automatische volumekorting en support per e-mail op 8x5-basis.
- Enterprise: minimale verplichting van $ 25.000 per jaar, premium support, opties voor BYOC en federal cloud.
Een actieve IRM-gebruiker is iedereen die in die maand in een piketrooster of escalation chain staat, of die een oproep bevestigt, een melding wijzigt of een incident aanmaakt of bewerkt. Lees die definitie goed: elke engineer in een rotatie telt mee, of hij nu is opgeroepen of niet.
| Team in de rotatie | Grafana Cloud IRM Pro, per maand |
|---|---|
| 3 personen | $ 19 (alleen platformkosten) |
| 5 personen | $ 59 |
| 10 personen | $ 159 |
| 25 personen | $ 459 |
Wat ik goed vind
- De kortste migratie. Dezelfde concepten, dezelfde Terraform-provider, dezelfde apps voor Slack en Teams. Komen je meldingen uit Grafana alerting, dan komen de dashboardlink en de metriekwaarden nog steeds mee in de oproep.
- Er is een migrator voor de OSS-bron. De repository irm-tooling van Grafana accepteert
MIGRATING_FROM="oncall_oss"en kopieert escalation chains, roosters en diensten, integraties, routes en uitgaande webhooks. Hij draait eerst in een planmodus. - De mobiele app komt terug. Push-, sms- en telefoonmeldingen horen bij het beheerde product.
Aandachtspunten
- De documentatie van Grafana spreekt zichzelf tegen. De speciale migratiepagina voor OSS stelt dat "de IRM-migratietools Grafana OnCall OSS momenteel niet als bronplatform ondersteunen" en verwijst naar Terraform of de OnCall-API, terwijl het migratieoverzicht en de README van de tooling OnCall OSS als ondersteund vermelden. In de praktijk maakt de migrator geen gebruikers of teams aan, koppelt hij mensen op e-mailadres en kan hij geen integraties voor direct paging aanmaken. Reken hoe dan ook op handwerk.
- Je verliest self-hosting. Roosters, meldingspayloads en incidenttijdlijnen verhuizen naar de cloud van Grafana. Voor teams die OnCall OSS kozen vanwege dataresidentie is dat precies de reden om te vertrekken.
- Er telt veel mee als gebruiker. Tien engineers in een rotatie kosten $ 159/mnd, nog voordat je betaalt voor metrics, logs of traces in Grafana Cloud.
- Nog steeds geen externe checks en geen publieke statuspagina. Net als OnCall routeert IRM meldingen. Detectie blijft in Prometheus of synthetische monitoring, en statuspagina’s voor klanten blijven een apart abonnement.
Kies Grafana Cloud IRM als je al voor Grafana Cloud betaalt, je meldingen Grafana alerting-regels zijn en je geen eis hebt om zelf te hosten. Sla het over als je OnCall OSS om een andere reden verliet dan de onderhoudsmelding, of als je niet langer per engineer in de rotatie wilt betalen.
Top 5 Grafana OnCall alternatieven
Ik heb vijf tools gekozen die elk iets anders vervangen van wat OnCall voor je deed: Hyperping voor teams die detectie en piketdienst op één factuur willen, PagerDuty voor alertrouting op enterpriseniveau, incident.io en Rootly voor incidentrespons die volledig in Slack draait, en GoAlert voor de open-source, self-hosted plek die OnCall OSS vroeger innam.
| Tool | Accepteert webhooks van Alertmanager of Grafana | Ingebouwde uptime-checks | Statuspagina | Self-hosted | Prijs voor 10 personen, per maand |
|---|---|---|---|---|---|
| Grafana Cloud IRM | Ja (native) | Nee | Nee | Nee | $ 159 |
| Hyperping | Nee (Hyperping is zelf de bron van de melding) | Ja | Ja | Nee | $ 74 (Pro, jaarlijks) |
| PagerDuty | Ja | Nee | Add-on (Statuspage) | Nee | $ 210 (Professional, jaarlijks) |
| incident.io | Ja | Nee | Ja (beperkt op Team) | Nee | $ 250 (Team + piketdienst) |
| Rootly | Ja | Nee | Ja | Nee | $ 200 (On-Call Essentials) |
| GoAlert | Ja | Nee | Nee | Ja | $ 0 plus een server en Twilio |
1. Hyperping: piketdienst, monitoring en statuspagina’s in één vast abonnement
Ideaal voor: teams van 2 tot 50 personen bij wie de OnCall-integraties vooral uptime-, SSL- en cronmeldingen waren, en die de check, de oproep en de statuspagina in één tool willen.
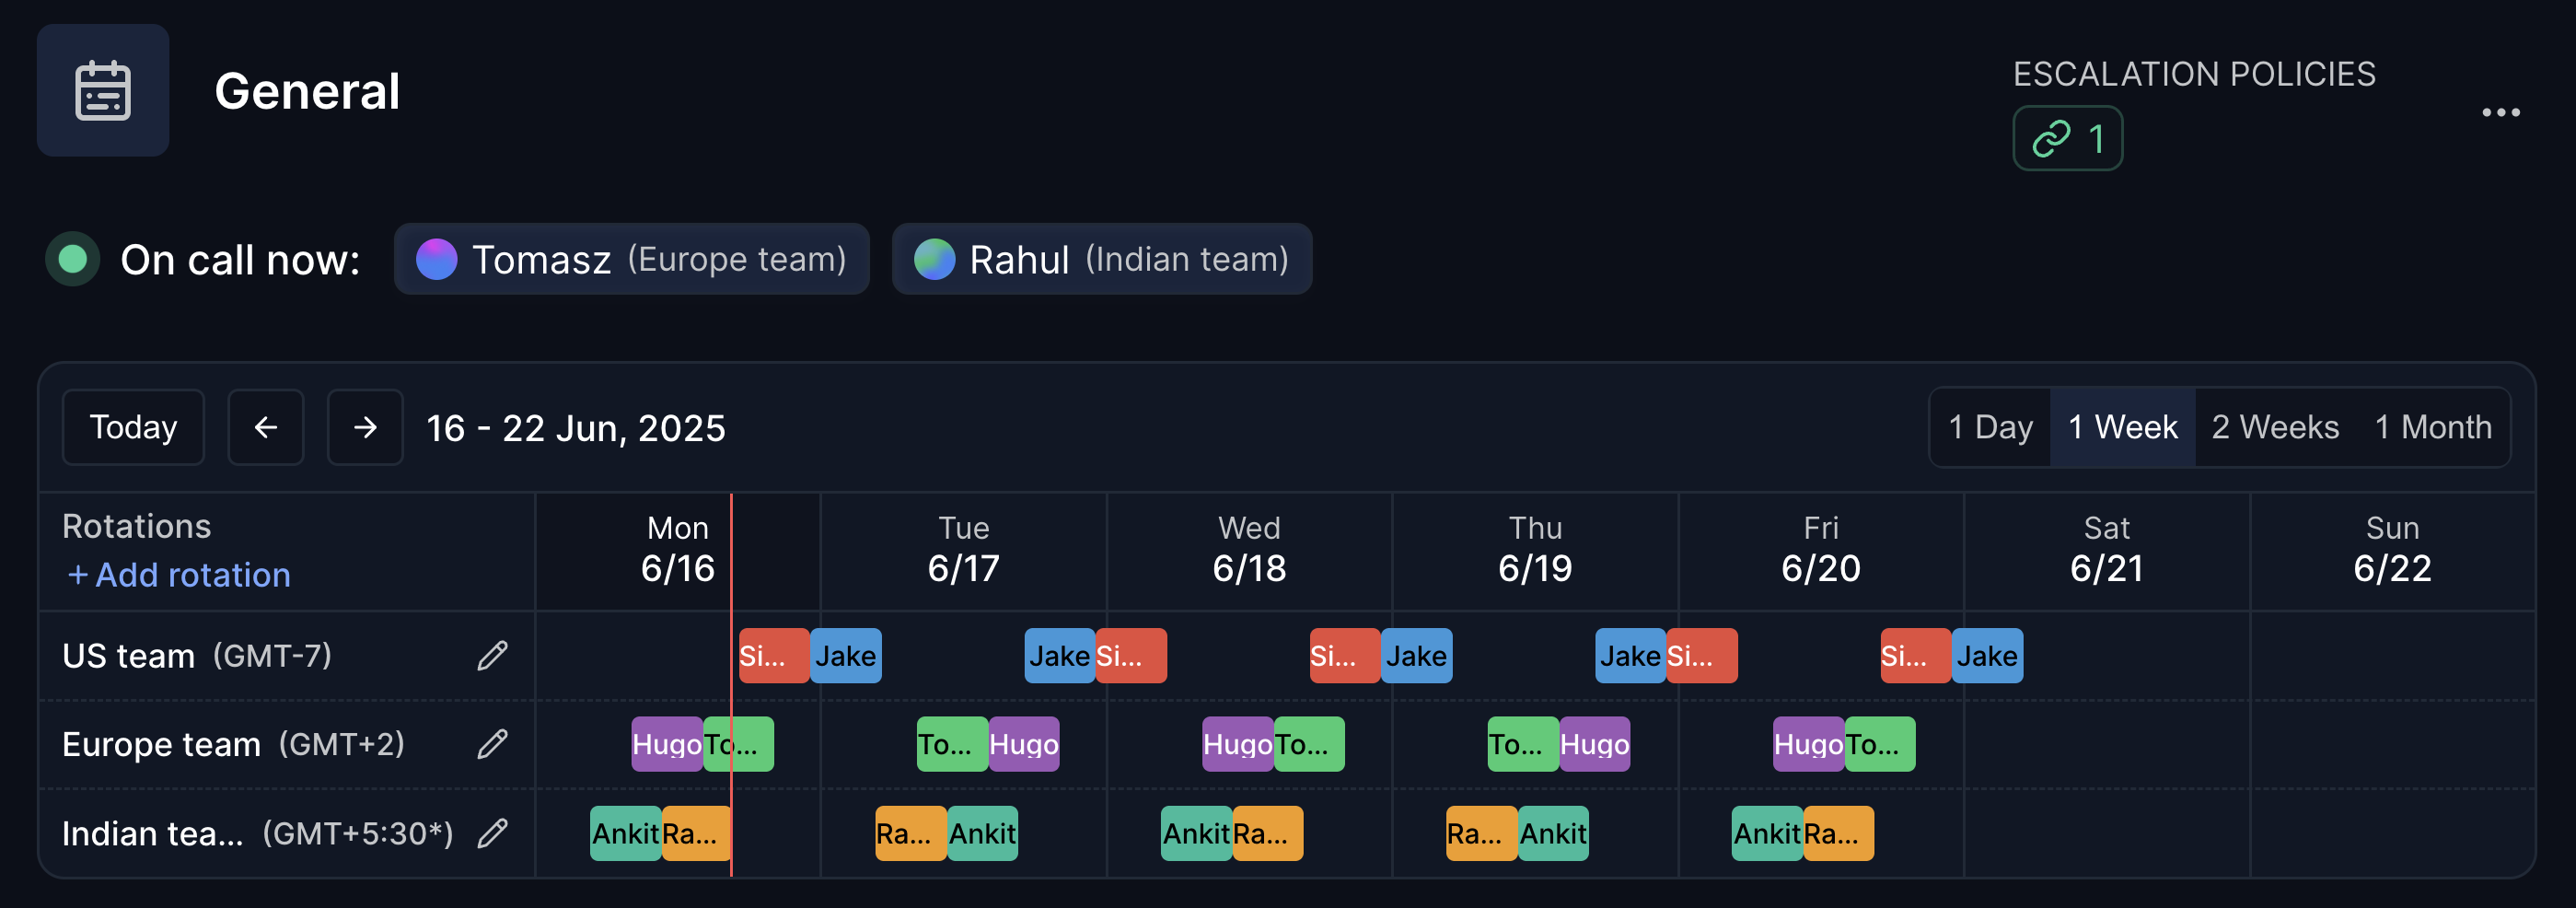
De meeste OnCall OSS-installaties die ik heb gezien routeren twee soorten meldingen: Prometheus-regels over interne metrics, en blackbox-achtige checks die kijken of de site in de lucht is. Hyperping vervangt die tweede soort bij de bron. HTTP-, cron-heartbeat-, DNS-, poort- en Playwright-browserchecks draaien vanuit 18 regio’s, en als er een faalt, roept het escalatiebeleid direct de engineer met piketdienst op. Er zit geen webhook tussen de check en de oproep.
Opvallende functies
- Piketroosters met één rotatie per team of tijdzone, overdrachtstijdstip, gelijktijdige diensten, tijdsbeperkingen en vervangingen
- Escalatiebeleid met geordende stappen en vertragingen via Slack, Teams, e-mail, sms en telefoon, waarbij een stap kan mikken op "wie er piketdienst heeft" in een rooster
- Gegroepeerde meldingen, zodat een gedeelde storing één oproep geeft in plaats van één per monitor
- Statuspagina’s op je eigen domein met abonnees, en pagina’s met wachtwoord of SSO op Pro en Business
- Terraform-provider, REST API en een Prometheus-exporter, zodat uptime en responstijden nog steeds in je Grafana-dashboards terechtkomen
- Uitgaande integraties naar PagerDuty en Opsgenie als een deel van het team tijdens de overgang op een andere pager blijft
Prijzen
Prijzen van de prijspagina van Hyperping, bij jaarlijkse facturatie, met de maandprijs tussen haakjes:
- Free: 20 monitors, checks elke 5 minuten, 1 statuspagina, geen piketdienst
- Essentials: € 24 per maand (€ 29 maandelijks), 3 seats inbegrepen en daarna € 7 per seat, 1 piketrooster, 20 sms per maand
- Pro: € 74 per maand (€ 89 maandelijks), 10 seats inbegrepen en daarna € 9 per seat, 3 roosters, 75 sms, browserchecks
- Business: € 249 per maand (€ 299 maandelijks), 20 seats inbegrepen en daarna € 12 per seat, 200 sms, white label en SAML als add-ons
Een team van 10 personen past in de 10 inbegrepen seats van Pro en betaalt € 74 per maand, met monitoring en de statuspagina inbegrepen.
Aandachtspunten
- Geen inkomende meldingsintegratie. Hyperping ontvangt geen webhooks van Alertmanager of Grafana alerting. Moeten je Prometheus-regels mensen blijven oproepen, dan dekt Hyperping de externe checks en houd je voor de interne een pager die webhooks aankan, of je kiest een tool hieronder.
- Slack op meldingsniveau, geen incidentlevenscyclus die volledig in Slack draait. Bevestigen en escaleren gaat vanuit Slack, maar er is geen automatisering van incidentkanalen en geen generator voor post-mortems.
- Kleinere integratiecatalogus dan PagerDuty: Slack, Teams, Discord, Google Chat, Telegram, e-mail, sms, telefoon, webhooks, PagerDuty, Opsgenie, Twilio en Intercom.
- Geen eigen mobiele app. Oproepen komen binnen via sms, telefoon, Slack of Teams op je telefoon.
Kies Hyperping als je niet langer drie tools (checks, pager, statuspagina) wilt draaien en je oproepen komen doordat iets plat ligt, niet door drempelwaarden van metrics. Probeer het gratis met 20 monitors.
2. PagerDuty: routering op enterpriseniveau met de grootste integratiecatalogus
Ideaal voor: organisaties met meer dan 50 engineers die een SLA van de leverancier, AIOps en 750+ integraties nodig hebben, en per gebruiker kunnen betalen.
PagerDuty is wat de meeste OnCall OSS-installaties vanwege de kosten vermeden. Het is ook de tool met het meest complete antwoord op "integreert het met X": Alertmanager, Grafana alerting, Datadog, CloudWatch en 750 andere sturen events binnen, en event orchestration ontdubbelt en routeert ze voordat iemand wordt opgeroepen.
Opvallende functies
- Roosters, escalatiebeleid, vervangingen en round-robin-routering
- Event orchestration en AIOps voor ontdubbeling en ruisonderdrukking (PD Reliability Platform-niveaus)
- Runbook-automatisering en incidentworkflows
- Mobiele app met push, sms en telefoon die een gebruiker van self-hosted OnCall bekend zal voorkomen
- Terraform-provider
Prijzen
Van de prijspagina van PagerDuty:
- Free: tot 5 gebruikers, 1 rooster, 1 escalatiebeleid, 100 sms- en telefoonmeldingen per maand
- Professional: $ 21/gebruiker/mnd jaarlijks ($ 25 maandelijks)
- PD Reliability Platform, per jaar vooraf gefactureerd: Starter $ 2.800 (10 seats), Essential $ 12.000 (20 seats), Plus $ 48.000 (50 seats), Ultimate op maat (500 seats), met AIOps en automatisering
Tien engineers op Professional kosten $ 210 per maand, en Statuspage en synthetische monitoring zijn aparte producten.
Aandachtspunten
- De prijs per gebruiker is voor een klein team 5 tot 10 keer de platformkosten van Grafana Cloud IRM, nog vóór AIOps.
- Met het ene rooster en het ene escalatiebeleid van de gratis versie kom je hooguit één team ver.
- Geen ingebouwde monitoring en geen statuspagina zonder Statuspage.
Kies PagerDuty als je OnCall OSS verlaat omdat een audit of een inkoopafdeling om een leverancier met support vroeg, en de breedte van de integraties zwaarder weegt dan de prijs. Voor een uitgebreider overzicht, zie onze gids met PagerDuty alternatieven.
3. incident.io: incidentrespons in Slack met piketdienst erbij
Ideaal voor: teams die incidenten in Slack afhandelen en de piketrotatie, het incidentkanaal en de post-mortem in hetzelfde product willen.
De Slack-integratie was de beste functie van OnCall. incident.io gaat nog verder: de oproep, het incidentkanaal, de rollen, de update van de statuspagina en de door AI opgestelde post-mortem gebeuren allemaal vanuit Slack of Teams, met piketdienst als add-on per gebruiker.
Opvallende functies
- Piketroosters, escalatiepaden en vervangingen, beheerd vanuit Slack
- Meldingen binnenhalen uit Alertmanager, Grafana, Datadog en webhooks
- Incidentkanalen, rollen, tijdlijnen en post-mortems gegenereerd door AI
- Statuspagina’s, beperkt op het Team-abonnement
- Mobiele app met push, sms en telefoon
Prijzen
Van de prijspagina van incident.io:
- Basic: gratis, piketdienst voor één team en een statuspagina
- Team: $ 15/gebruiker/mnd jaarlijks ($ 19 maandelijks) plus $ 10/gebruiker/mnd voor piketdienst
- Pro: $ 25/gebruiker/mnd plus $ 20/gebruiker/mnd voor piketdienst
- Alleen piketdienst: $ 20/gebruiker/mnd
- Enterprise: op maat
Tien personen op Team met piketdienst kosten $ 250 per maand; alleen piketdienst is $ 200 per maand.
Aandachtspunten
- Twee tellers per gebruiker stapelen zich op: de seat voor incidentrespons en de seat voor piketdienst.
- Zonder Slack of Teams verdwijnt de meeste waarde.
- Geen uptime-checks. Detectie blijft in Grafana of elders.
Kies incident.io als je knelpunt na de oproep de coördinatie is, niet de detectie, en je team in Slack leeft. Onze gids met incident.io alternatieven behandelt de afwegingen uitgebreid.
4. Rootly: AI-first incidentrespons en piketdienst voor middelgrote teams
Ideaal voor: snelgroeiende teams van 30 tot 300 personen die workflowautomatisering over Jira, GitHub en Zoom willen, en een aparte piketmodule met een prijs per gebruiker.
Rootly verkoopt incidentrespons en piketdienst als aparte producten tegen dezelfde prijs per gebruiker. De piketmodule heeft de onderdelen die een OnCall OSS-gebruiker verwacht (roosters, escalatiebeleid, groeperen en routeren van meldingen), plus dingen die OnCall nooit had, zoals schaduwrotaties, verlofbeheer, detectie van gaten in het rooster en een calculator voor piketvergoedingen.
Opvallende functies
- Groeperen en routeren van meldingen, met live doorschakelen van gesprekken
- Roosters met schaduwrotaties, verlofbeheer en detectie van gaten
- Incidentlevenscyclus die volledig in Slack en Teams draait, met AI-notulist en retrospectives
- Statuspagina inbegrepen in Incident Response Essentials
- Meldingen binnenhalen uit Alertmanager, Grafana, Datadog en webhooks
Prijzen
Van de prijspagina van Rootly:
- On-Call Essentials: $ 20/gebruiker/mnd
- Incident Response Essentials: $ 20/gebruiker/mnd
- Enterprise voor beide: op maat
- Startupprogramma: tot 50% korting onder de 100 medewerkers, "betaal wat je kunt" onder de 25
Tien engineers op On-Call Essentials kosten $ 200 per maand, en $ 400 per maand als je Incident Response toevoegt.
Aandachtspunten
- Geen gratis versie, en de twee modules verdubbelen de rekening per gebruiker als je ze allebei wilt.
- Configuratiediepte die een team van 5 personen niet gaat gebruiken.
- Geen uptime-checks.
Kies Rootly als je diepere workflowautomatisering wilt dan incident.io en een rotatiemodel met schaduwdiensten en verlof ingebouwd. Zie onze gids met Rootly alternatieven voor de directe vergelijking.
5. GoAlert: de open-source, self-hosted vervanger
Ideaal voor: teams die OnCall OSS kozen voor self-hosting en dataresidentie, en iemand hebben die nog een dienst extra kan beheren.
GoAlert wordt onderhouden door Target onder de Apache 2.0-licentie. Het doet de kern van wat OnCall OSS deed: rotaties en roosters, escalatiebeleid, meldingen per e-mail, sms en spraak via je eigen Twilio-account, Slack-meldingen, generieke webhooks en een integratie met Prometheus Alertmanager. Het draait als één Go-binary op PostgreSQL, wat lichter is dan de stack van OnCall met Django, Celery, Redis en MySQL.
Opvallende functies
- Piketroosters, rotaties en tijdelijke vervangingen
- Escalatiebeleid met herhalende stappen
- Integraties met Alertmanager, Grafana, generieke webhooks en e-mail
- Sms en spraak via Twilio, meldingen in Slack-kanalen
- Agenda-abonnementen en API-sleutels
Prijzen
Gratis. Je betaalt voor een server, PostgreSQL en het gebruik van Twilio.
Aandachtspunten
- Releaseritme. De laatste release, v0.35.0, is van september 2026, na v0.34.1 in oktober 2025, v0.34.0 in augustus 2025 en v0.33.0 in november 2024 (releasegeschiedenis). Het project leeft, maar beweegt traag, en je doet er goed aan de commitlog te lezen voordat je je oproepen ervan laat afhangen.
- Geen mobiele app. Oproepen komen binnen via sms, telefoon, e-mail of Slack.
- Geen incidentbeheer, geen statuspagina, geen Grafana-specifieke context in de melding.
- Andere open-sourcetools dekken aangrenzende taken, maar geen piketroosters: Keep doet het bundelen van meldingen, Uptime Kuma de checks, Zabbix de infrastructuurmonitoring met eenvoudige escalaties.
Kies GoAlert als self-hosting een harde eis is en Slack plus Twilio genoeg kanalen zijn. Is de eis eerder "open source" dan "self-hosted", weeg dan af of een traag project echt beter is dan een beheerde tool die je weer kunt verlaten.
Grafana OnCall vs PagerDuty: welke na het archiveren?
Dit is de vergelijking waar de meeste mensen naar zoeken, dus die krijgt een eigen sectie. De vergelijking die er vandaag toe doet is Grafana Cloud IRM tegenover PagerDuty, want OSS is geen kandidaat meer voor nieuwe installaties.
| Grafana Cloud IRM | PagerDuty Professional | |
|---|---|---|
| Prijs, 10 engineers in de rotatie | $ 159/mnd | $ 210/mnd jaarlijks |
| Prijs, 25 engineers | $ 459/mnd | $ 525/mnd jaarlijks |
| Bronnen van meldingen | Grafana alerting native, plus webhooks | 750+ integraties |
| Ruisonderdrukking | Routes en groepering | Event orchestration, AIOps op de platformniveaus |
| Incidentbeheer | Inbegrepen (voormalige Incident-app) | Inbegrepen, runbook-automatisering extra |
| Self-hosted optie | Nee | Nee |
| Uptime-checks, statuspagina | Nee, nee | Nee, Statuspage als add-on |
| Support van de leverancier | E-mail 8x5 op Pro | 24x7 op Business en hoger |
Kies Grafana Cloud IRM als je meldingen uit Grafana komen en je het dashboard in de oproep wilt. Kies PagerDuty als je bronnen van meldingen buiten Grafana hebt, AIOps nodig hebt of een supportcontract nodig hebt dat een enterprise wil tekenen. Kies geen van beide als je oproepen draaiden om "de site ligt plat", want voor dat geval hebben ze allebei nog een aparte monitoringtool nodig.
Migratietabel: waar elk Grafana OnCall-object naartoe gaat
Elk object uit OnCall OSS heeft ergens een tegenhanger, maar niet altijd waar je die verwacht. Eerst exporteren, dan koppelen.
| Grafana OnCall OSS | Grafana Cloud IRM | Hyperping | PagerDuty | incident.io | Rootly | GoAlert |
|---|---|---|---|---|---|---|
| Integration (Alertmanager, Grafana alerting, webhook) | Integration, zelfde URL-schema | Geen tegenhanger: vervang door Hyperping-monitors voor externe checks | Service met een integration key | Alert source | Alert source | Integration key per service |
| Route (regex op de payload om een chain te kiezen) | Route | Toewijzing van monitor aan escalatiebeleid | Event orchestration-regel | Alert route | Alert routing-regel | Niet beschikbaar, één beleid per service |
| Escalation chain | Escalation chain | Escalatiebeleid met getimede stappen | Escalation policy | Escalation path | Escalation policy | Escalation policy met herhaling |
| Schedule (web of iCal) | Schedule | Piketrooster met één rotatie per team | Schedule met layers | Schedule | Schedule | Schedule met rotaties |
| Shift override | Override | Vervanging op de rotatie | Override | Override | Override | Tijdelijk rooster |
| User notification rules | Notification policy | Kanaalkeuze per stap in het beleid | Contact methods en rules | Notification preferences | Notification rules | Contact methods |
| ChatOps in Slack en Teams | Dezelfde apps | Meldingen in Slack en Teams, bevestigen vanuit Slack | Apps voor Slack en Teams | Native Slack en Teams | Native Slack en Teams | Slack-meldingen |
| Mobiele push | Mobiele IRM-app | Sms en telefoon, geen eigen app | PagerDuty-app | incident.io-app | Rootly-app | Alleen sms en spraak |
| Outgoing webhooks | Outgoing webhooks | Webhook-integratie | Webhooks v3 | Workflows | Workflows | Webhooks |
| Terraform (grafana-provider) | Dezelfde provider | Hyperping Terraform-provider | PagerDuty-provider | incident.io-provider | Rootly-provider | Niet beschikbaar |
Exporteer je configuratie voordat je begint
De API van OnCall OSS draait nog op je instantie. Maak een token aan in de instellingen van de OnCall-plugin, noteer de engine-URL die op dezelfde pagina staat en haal elk objecttype op als JSON. Bewaar die bestanden, welke bestemming je ook kiest.
export ONCALL_URL="https://oncall.example.com"   # de engine-URL van OnCall, niet de Grafana-URL
export ONCALL_TOKEN="your-oncall-api-token"

for resource in integrations routes escalation_chains escalation_policies schedules on_call_shifts users; do
  curl -s -H "Authorization: $ONCALL_TOKEN" \
    "$ONCALL_URL/api/v1/$resource/?perpage=100" \
    > "oncall-$resource.json"
done
Is Grafana Cloud IRM je bestemming, draai dan met deze credentials eerst de irm-tooling-migrator in planmodus en pas daarna in migratiemodus, en reken erop dat je eerst zelf gebruikers moet uitnodigen en teams moet aanmaken. Voor elke andere bestemming is de JSON je inventaris: tel de integraties, zet de chains op een rij en bouw ze opnieuw op in de Terraform-provider van de nieuwe tool, als die er een heeft.
Drie dingen die de tabel niet oplost
- Alertmanager-regels die mensen oproepen. Alleen Grafana Cloud IRM, PagerDuty, incident.io, Rootly en GoAlert accepteren de webhook. Stap je over naar Hyperping, bepaal dan welke regels Hyperping-checks worden en welke bij een pager blijven die webhooks aankan.
- Meldingsgeschiedenis. Geen enkele migrator neemt die mee. Exporteer wat je nodig hebt voor post-mortems voordat je de instantie uitzet.
- Telefoonnummers. OSS-gebruikers op de Cloud Connection hebben nooit nummers bij een externe provider opgeslagen. Elke responder moet in de nieuwe tool opnieuw een geverifieerd nummer invoeren, en dat is de stap die wordt overgeslagen tot de eerste gemiste oproep.
Hoe je Grafana OnCall vervangt door Hyperping
Met de workflow hieronder haal je een team in ongeveer twee weken van OnCall OSS af, waarvan het grootste deel parallel draaien is.
1. Exporteer je OnCall-configuratie
Draai het exportscript hierboven en open de bestanden met roosters en escalation chains. Schrijf per chain de stappen, de vertragingen en de roosters op waarnaar ze verwijzen. Dat is de specificatie voor de rest van de migratie.
2. Maak de monitors die je externe checks vervangen
Voeg in Hyperping één monitor toe per endpoint dat Grafana alerting van buitenaf in de gaten hield: HTTP-checks met controles op trefwoord of statuscode, SSL-verloop, cron-heartbeats voor geplande taken en Playwright-browserchecks voor login- en checkoutflows. Stel het controle-interval in (30 seconden op Essentials en Pro) en de regio’s.
3. Bouw de piketroosters opnieuw op
Open On-Call in de zijbalk en maak een rooster aan per OnCall-rooster. Voeg één rotatie per team of tijdzone toe, kies het type rotatie, het overdrachtstijdstip en de volgorde, en controleer of de kalenderpreview overeenkomt met het OnCall-rooster dat je hebt geëxporteerd. Vervangingen regel je per rotatie, dus voor geruilde diensten hoef je het rooster niet opnieuw op te bouwen.
4. Zet escalation chains om naar escalatiebeleid
Ga naar Escalation Policies en maak er een aan per chain. Stap 1 met een vertraging van 0 minuten naar Slack of Teams, stap 2 na 5 minuten per sms naar het piketrooster, stap 3 na nog eens 10 minuten per telefoon naar het rooster en de teamlead. Wijs het beleid toe aan de monitors uit stap 2 en zet gegroepeerde meldingen aan, zodat een gedeelde storing maar één keer oproept.
5. Koppel Slack, Teams, sms en telefoon
Voeg de integratie met Slack of Teams toe en vraag daarna elke responder om in zijn accountinstellingen een telefoonnummer toe te voegen en te verifiëren. Blijft een deel van het team tijdens de overgang op PagerDuty of Opsgenie, voeg dan de integratie met PagerDuty of Opsgenie toe, zodat Hyperping-incidenten hen ook bereiken.
6. Laat beide tools twee weken naast elkaar draaien
Laat OnCall OSS de Grafana-meldingen naar Slack sturen. Laat Hyperping de engineer met piketdienst oproepen voor de externe checks. Vergelijk de twee: tijd tot de eerste melding, tijd tot bevestiging, en welke meldingen Hyperping gaf die OnCall miste, of andersom. Stuur minstens één keer een testincident door elke escalatiestap.
7. Overstappen en archiveren
Laat je runbooks naar Hyperping verwijzen, schakel de escalation chains in OnCall uit zodat OnCall niemand meer oproept, en bewaar de JSON-exports. Moeten Prometheus-regels nog steeds iemand kunnen oproepen, houd die route dan op een tool die webhooks aankan en laat Hyperping de externe checks en de statuspagina doen.
Beslisschema
- Al op Grafana Cloud, meldingen komen uit Grafana alerting: Grafana Cloud IRM. Draai de migrator eerst in planmodus.
- Self-hosting is niet onderhandelbaar: GoAlert, met Twilio voor sms en spraak.
- Minder dan 50 mensen, de meeste oproepen zijn "het ligt plat": Hyperping, en schaf meteen de aparte uptime-tool en statuspagina af.
- Incidenten lopen via Slack en de post-mortem is het pijnpunt: incident.io, of Rootly als je diepere workflowautomatisering wilt.
- Inkoop wil een leverancier met een SLA en 750 integraties: PagerDuty.
Wat je ook kiest, doe de export deze week. De gearchiveerde instantie blijft draaien, maar één ongepatchte CVE en hij is zelf het incident.
Verder lezen
- Top 10 tools voor piketroosters vergeleken voor de bredere categorie
- Opsgenie stopt: gids met alternatieven als je ook bij Atlassian weggaat
- Gids voor escalatiebeleid om de stappen en vertragingen te ontwerpen
- Piketroosters voor kleine teams als je rotatie uit 2 of 3 mensen bestaat
Verder vergelijken: Hyperping vs PagerDuty · Hyperping vs Opsgenie · Prijzen van Hyperping · Alle vergelijkingen
Veelgestelde vragen
Is Grafana OnCall stopgezet? ▼
De open-sourceversie wel. Grafana OnCall OSS ging op 11 maart 2025 in onderhoudsmodus, en de ontwikkeling stopte op 24 maart 2026, toen de repository werd gearchiveerd. Die staat nu alleen-lezen in de organisatie grafana-cold-storage van Grafana op GitHub. Een self-hosted instantie draait nog, maar krijgt geen updates meer, en de Cloud Connection die sms, telefoon en mobiele pushmeldingen verstuurde, is op de archiveringsdatum uitgezet. Het beheerde product gaat verder als Grafana Cloud IRM.
Wat is het beste alternatief voor Grafana OnCall? ▼
Grafana Cloud IRM als je zo weinig mogelijk wilt veranderen en al voor Grafana Cloud betaalt. Hyperping als je piketdienst, uptime-monitoring en statuspagina’s in één abonnement met een vast tarief wilt. PagerDuty voor alerting op enterpriseniveau met 750+ integraties. incident.io of Rootly voor incidentrespons die volledig in Slack draait. GoAlert als je open source en self-hosted moet blijven.
Is er een open-source alternatief voor Grafana OnCall? ▼
GoAlert, onderhouden door Target onder de Apache 2.0-licentie, komt het dichtst in de buurt van wat er nog beschikbaar is: roosters, rotaties, escalatiebeleid, webhooks van Alertmanager en Grafana, sms en spraak via Twilio. De laatste release is v0.35.0 (september 2026), na v0.34.1 in oktober 2025, dus reken erop dat je het zelf moet beheren. Keep, Zabbix en een self-hosted Uptime Kuma doen een deel van het werk, maar geen piketroosters.
Wat kost Grafana Cloud IRM? ▼
Volgens grafana.com in september 2026 staat de gratis versie 3 actieve IRM-gebruikers per maand toe. De Pro-versie rekent $ 19 per maand platformkosten, inclusief 3 actieve IRM-gebruikers, en daarna $ 20 per extra actieve IRM-gebruiker, met volumekorting. Enterprise begint bij een jaarlijkse verplichting van $ 25.000. Een actieve IRM-gebruiker is iedereen die in een rooster of escalation chain staat, of die in die maand incidenten bevestigt, iemand oproept of incidenten bewerkt.
Grafana OnCall vs PagerDuty: welke moet ik kiezen? ▼
Kies PagerDuty als je een leverancier met een SLA, 750+ integraties, AIOps en een volwassen mobiele app nodig hebt, en je $ 21 per gebruiker per maand kunt betalen op Professional, plus voor AIOps een PD Reliability Platform-bijdrage die per jaar vooraf wordt gefactureerd, vanaf $ 2.800 voor 10 seats. Kies Grafana Cloud IRM als je meldingen al uit Grafana alerting komen en je de context van je dashboard in de oproep wilt, voor $ 20 per actieve gebruiker. Geen van beide heeft uptime-checks of een publieke statuspagina.
Kan ik mijn roosters en escalation chains uit Grafana OnCall OSS automatisch migreren? ▼
Gedeeltelijk. De irm-tooling-migrator van Grafana accepteert OnCall OSS als bron en kopieert escalation chains, roosters, integraties, routes en meldingsregels naar Grafana Cloud IRM, maar maakt geen gebruikers of teams aan, en Grafana’s eigen migratiepagina voor OSS verwijst nog steeds naar Terraform of de API. Voor elke andere bestemming exporteer je de objecten via de OnCall-API en bouw je ze opnieuw op in de nieuwe tool, het liefst als code.