Les meilleures alternatives à PagerDuty sont Hyperping (monitoring + astreinte + pages de statut à prix fixe), Better Stack (monitoring, logs et incidents réunis), incident.io (gestion des incidents native Slack), Rootly (réponse aux incidents axée sur l’automatisation) et Squadcast (astreinte à petit budget). J’ai analysé 29 outils au total et j’ai retenu ces cinq-là en m’appuyant sur les avis G2, les retours des forums communautaires et mes propres tests.
PagerDuty est l’acteur historique de la gestion d’astreinte. Mais sa tarification par utilisateur (21 $/utilisateur/mois et plus), ses fonctionnalités taillées pour les grands comptes et les frustrations récentes autour du produit poussent de plus en plus d’équipes à chercher ailleurs.
Dans ce guide, vous verrez :
- Pourquoi des équipes quittent PagerDuty (d’après de vraies plaintes du forum communautaire, pas des suppositions)
- Cinq alternatives qui règlent des problèmes précis que PagerDuty ne règle pas
- Des comparaisons de prix honnêtes, chiffres à l’appui
- Quel outil correspond à la taille de votre équipe, à vos habitudes de travail et à votre budget
Si vous voulez un monitoring qui repère les problèmes en 30 secondes, un planning d’astreinte avec des politiques d’escalade intelligentes et des pages de statut qui inspirent confiance à vos clients, le tout à prix mensuel fixe avec des sièges inclus et des sièges supplémentaires payants, essayez Hyperping gratuitement pendant 14 jours.
Points clés
- Hyperping est la meilleure option si vous voulez le monitoring, l’astreinte et les pages de statut dans un seul outil, avec des prix prévisibles. À partir de 24 €/mois à prix fixe, sièges inclus et sièges supplémentaires payants.
- Better Stack est le choix le plus solide pour les équipes qui veulent réunir monitoring, logs et gestion des incidents. Les plans payants démarrent à 29 $/mois, avec des modules complémentaires.
- incident.io est idéal pour les équipes centrées sur Slack qui veulent gérer tout le cycle de vie d’un incident sans quitter Slack. Le plan Team démarre à environ 15 $/utilisateur/mois, plus une option facturée par utilisateur d’astreinte.
- Rootly convient aux équipes de taille intermédiaire en forte croissance et aux grands comptes qui veulent une réponse aux incidents pensée pour l’IA, centrée sur Slack et très automatisée. Incident Response démarre à 20 $/utilisateur/mois.
- Squadcast (devenu SolarWinds Incident Response) est l’option par utilisateur la plus abordable pour les équipes DevOps, avec le plan Pro à 15 $/utilisateur/mois en facturation annuelle.
Pourquoi vous pouvez faire confiance à ce guide
Je suis Léo, fondateur de Hyperping. Oui, j’ai un intérêt direct dans l’un de ces outils, et je le dirai franchement tout au long de ce guide. Mais j’ai vu des équipes choisir un concurrent quand il leur convenait vraiment mieux, et mon objectif est de vous aider à trouver le bon outil, pas seulement de vous vendre le mien.
Pour ce guide, j’ai lu des centaines d’avis G2, parcouru 444 sujets du forum communautaire de PagerDuty pour repérer les vraies frustrations des utilisateurs, testé les plateformes quand c’était possible et, à défaut, me suis fié à des retours d’utilisateurs vérifiés.
Le top en un coup d’œil
| Idéal pour | Produit |
|---|---|
| Monitoring + astreinte + pages de statut à prix fixe | Hyperping |
| Monitoring, logs et incidents réunis | Better Stack |
| Gestion des incidents native Slack | incident.io |
| Réponse aux incidents axée sur l’automatisation | Rootly |
| Équipes DevOps attentives à leur budget | Squadcast |
Pourquoi les équipes envisagent une alternative à PagerDuty
PagerDuty a créé la catégorie et fixé la norme en matière de gestion d’astreinte et de réponse aux incidents. Mais le produit a accumulé des points de friction qui poussent des équipes vers d’autres solutions. Beaucoup de celles qui l’évaluent en ce moment viennent d’Opsgenie, qu’Atlassian arrête en avril 2027 ; la comparaison Opsgenie vs PagerDuty traite précisément de cette transition.
Une tarification par utilisateur qui passe mal à l’échelle
Le plan Professional de PagerDuty démarre à 21 $/utilisateur/mois. Au-dessus, la PD Reliability Platform se paie d’avance à l’année, à partir de 2 800 $ par an (5 sièges, plus 5 sièges offerts dans le cadre d’une offre limitée dans le temps), et c’est là que se trouvent AIOps et Automation. Pour une équipe technique de 20 personnes, cela fait 5 040 $/an en Professional, ou 12 000 $/an sur le palier Essential de la plateforme (25 sièges).
Je suis tombé sur le message d’un utilisateur du forum qui a passé sept ans à essayer d’obtenir le feu vert de sa direction pour PagerDuty. Le principal obstacle : le coût par utilisateur. Quand la facture augmente au même rythme que les effectifs, chaque recrutement devient une discussion tarifaire.
Ce modèle crée aussi un effet pervers : les équipes limitent le nombre de licences PagerDuty au lieu de donner accès à tous ceux qui pourraient en avoir besoin. C’est l’inverse de ce qu’on attend d’un outil de gestion des incidents.
Frictions produit et régressions sur mobile
Le forum communautaire de PagerDuty met en lumière des frustrations précises qui s’accumulent avec le temps. Le geste de balayage pour résoudre un incident dans l’application mobile, sur lequel les utilisateurs comptaient pour acquitter vite, exige désormais une confirmation supplémentaire. Pour un ingénieur d’astreinte réveillé à 3 h du matin, chaque étape en plus compte.
Dans les workflows d’incident, un délai ne peut pas descendre sous 5 minutes, alors que les utilisateurs réclament des délais de quelques secondes. Quand votre runbook automatisé doit attendre 5 minutes avant l’étape suivante, ce sont 5 minutes pendant lesquelles vos clients subissent la panne.
Limites de l’API et des webhooks
Les équipes qui automatisent autour de PagerDuty se heurtent à des manques précis de l’API. Le champ « description » a été retiré des webhooks, il ne reste que « title ». Les notes de résolution ne sont pas accessibles depuis les automatisations par webhook. Récupérer les valeurs des Service Custom Fields demande N+1 appels d’API.
Pour les équipes qui investissent dans l’automatisation des incidents, ces limites obligent à des contournements qui alourdissent la maintenance et ralentissent la réponse.
Des réglages par défaut qui posent question pour la confidentialité
L’intégration Slack de PagerDuty active par défaut « Chat message ingestion » et « Private channel ingestion ». Les équipes qui n’ont pas vérifié ces réglages à l’installation envoient peut-être, sans le savoir, des messages Slack privés dans PagerDuty. C’est typiquement le genre de réglage par défaut qui entame la confiance des organisations attentives à la sécurité.
Comparatif rapide : les alternatives à PagerDuty
| Outil | Prix de départ | Idéal pour | Principale limite |
|---|---|---|---|
| Hyperping | À partir de 24 €/mois (prix fixe) | PME qui veulent monitoring + astreinte + pages de statut | Pas une plateforme d’observabilité complète |
| Better Stack | À partir de 29 $/mois | Équipes qui veulent monitoring + logs + incidents | Tarification par siège sur les plans supérieurs |
| incident.io | À partir d’environ 15 $/utilisateur/mois | Gestion des incidents native Slack | Suppose une culture très centrée sur Slack |
| Rootly | À partir d’environ 20 $/utilisateur/mois | Réponse aux incidents très automatisée | Moins accessible aux très petites équipes |
| Squadcast | À partir de 15 $/utilisateur/mois (Pro, annuel) | Équipes DevOps attentives à leur budget | Moins de fonctionnalités grands comptes que PagerDuty |
Hyperping : le meilleur pour monitoring + astreinte + pages de statut à prix fixe
À qui s’adresse Hyperping
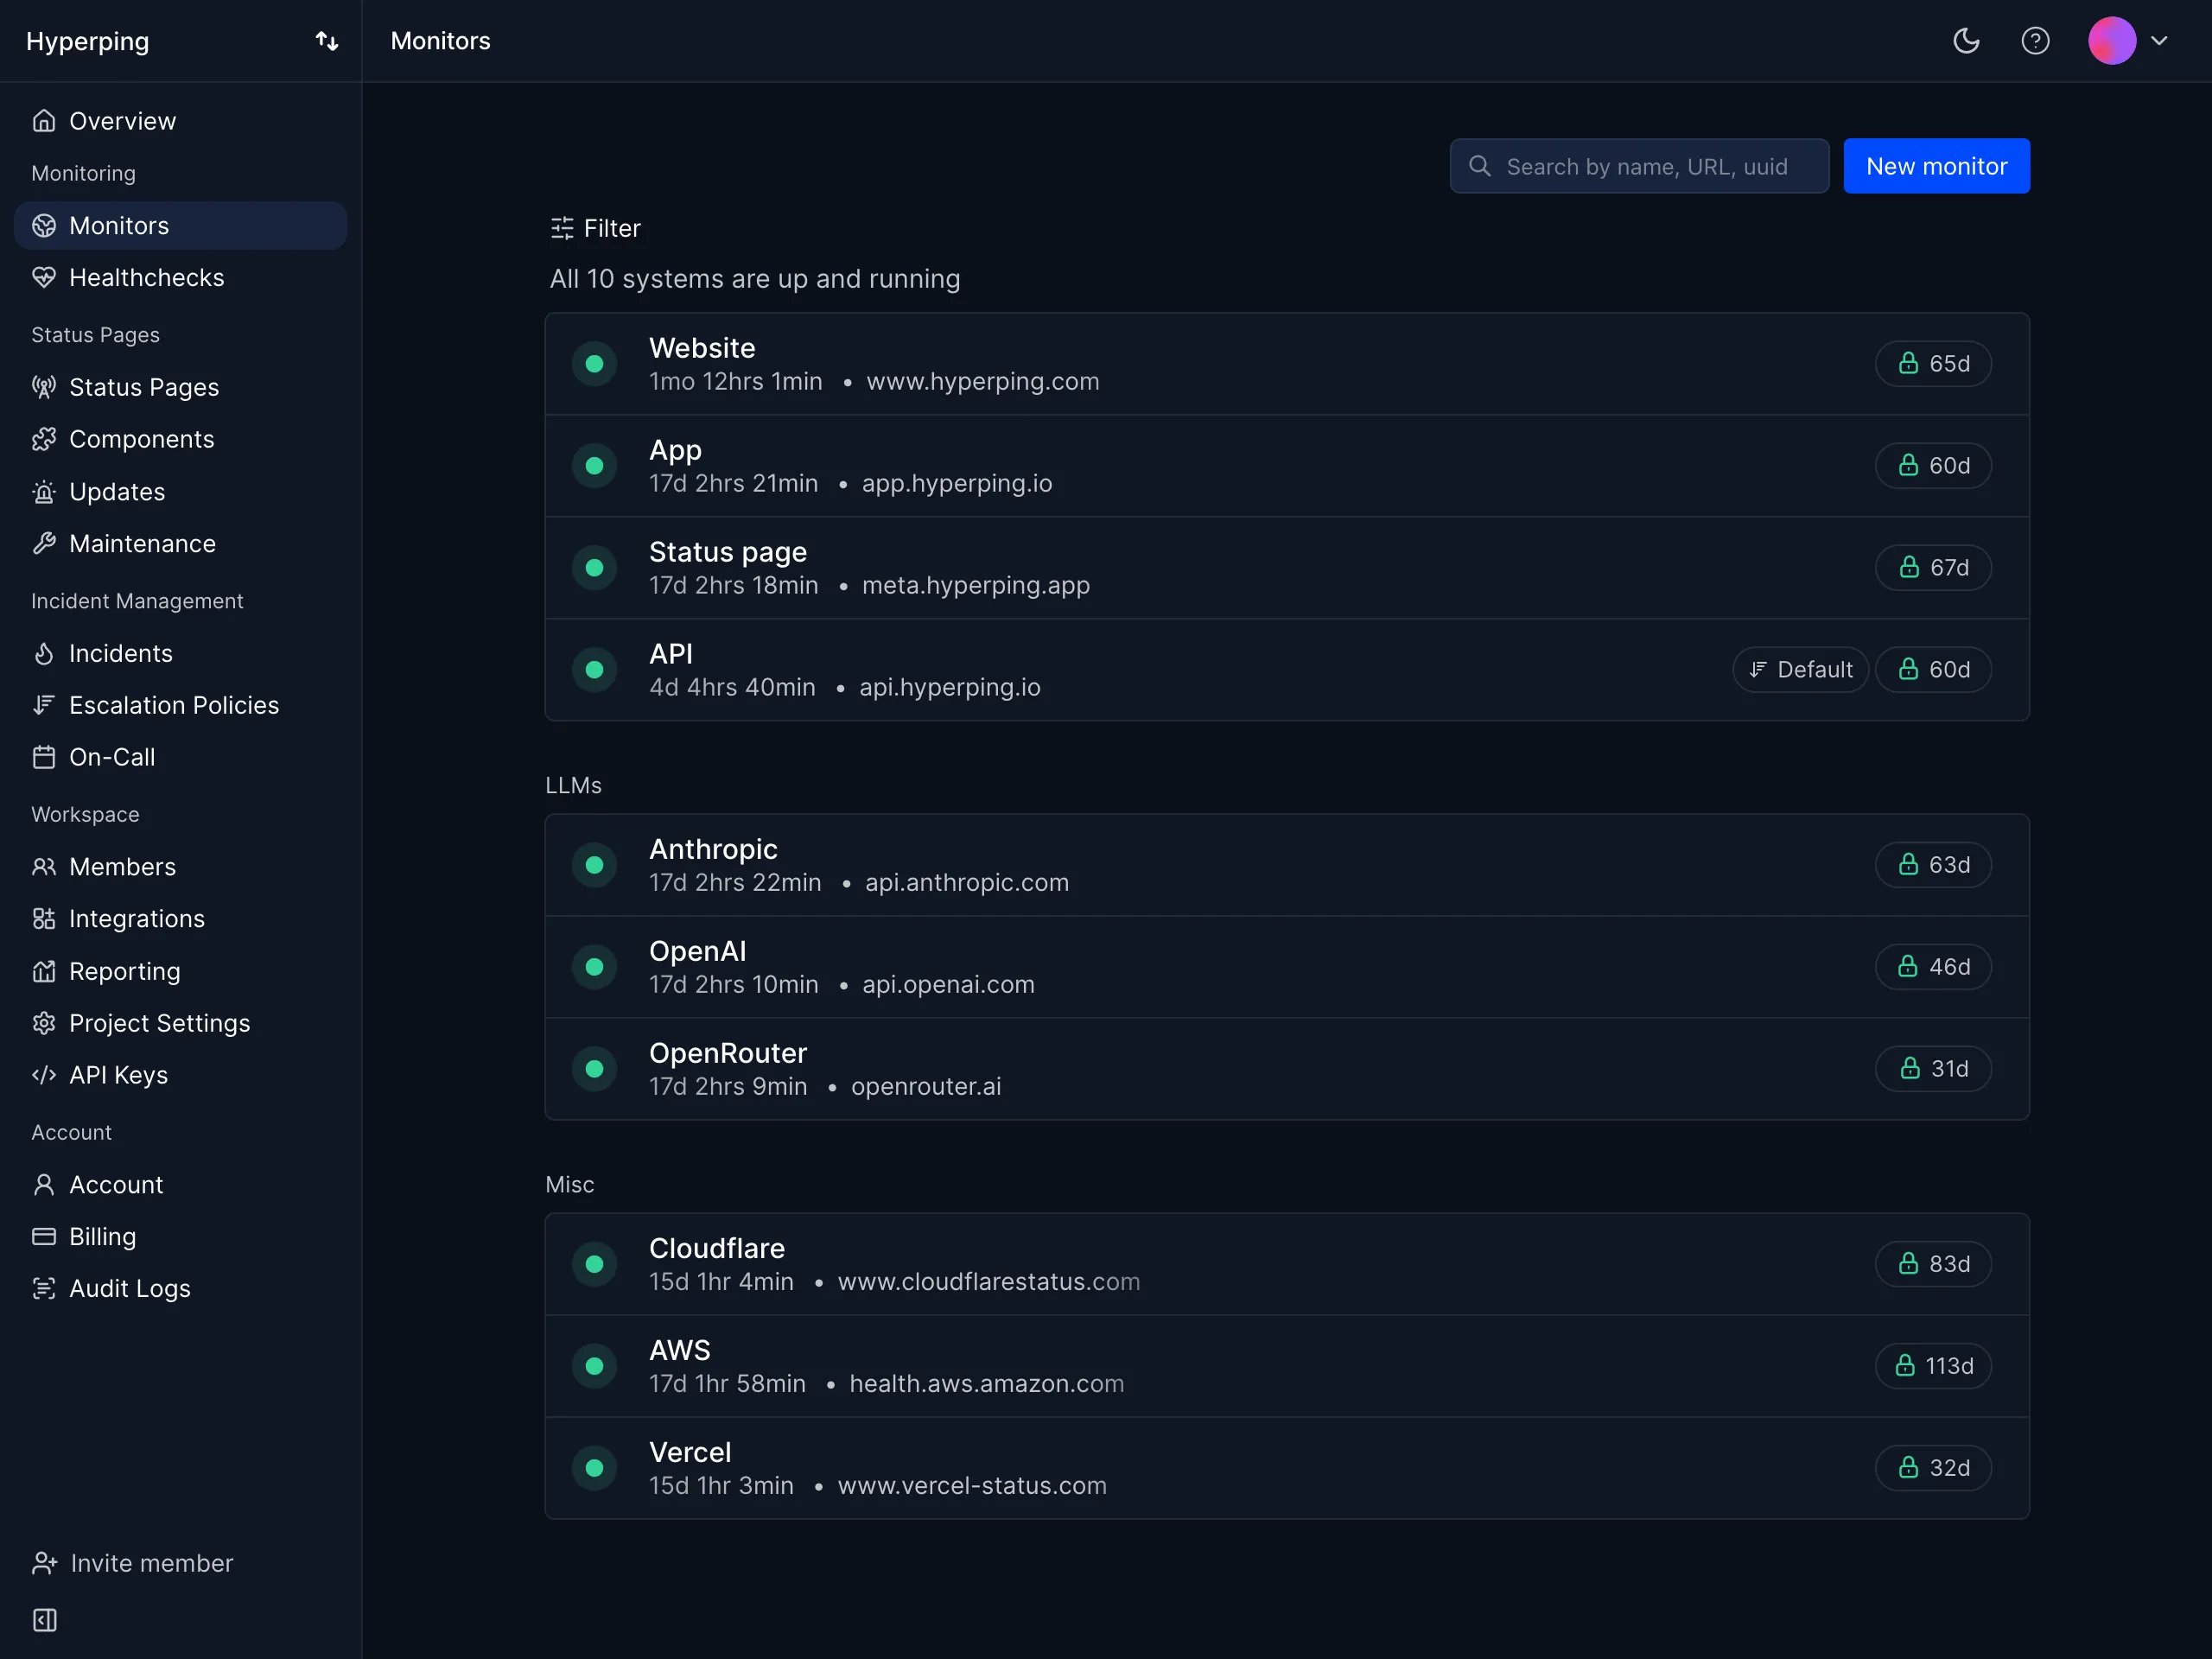
Aux équipes qui veulent le monitoring de disponibilité, le planning d’astreinte, les politiques d’escalade et les pages de statut dans un seul outil, sans jongler entre plusieurs abonnements ni voir la facture grimper à chaque nouvel utilisateur.
En toute transparence : c’est moi qui ai créé Hyperping, gardez-le en tête en lisant mon avis. Je vais être direct sur les cas où il convient et ceux où il ne convient pas.
Fonctionnalités notables
- Intervalles de vérification de 30 secondes depuis des points de monitoring répartis dans le monde
- Planning d’astreinte avec rotations qui tiennent compte des fuseaux horaires et passages de relais automatiques
- Politiques d’escalade à plusieurs étapes qui envoient l’alerte à la bonne personne au bon moment
- Pages de statut à vos couleurs avec domaine personnalisé, plusieurs langues et notifications aux abonnés
- Alertes multicanales : e-mail, SMS, appels vocaux, Slack, Discord, Telegram, Microsoft Teams et webhooks
- Monitoring synthétique avec Playwright pour tester de bout en bout les parcours utilisateurs critiques
- Monitoring des serveurs par agent, installé en une ligne, qui remonte depuis chaque hôte les métriques CPU, mémoire, système de fichiers, E/S disque et réseau
- Infrastructure basée dans l’UE, conforme au RGPD dès la conception
Pourquoi choisir Hyperping plutôt que PagerDuty ?
Des prix prévisibles. PagerDuty facture par utilisateur, Hyperping facture un forfait mensuel fixe. Pour une équipe de 15 personnes, PagerDuty Professional coûte 315 $/mois (21 $ x 15). Hyperping Business coûte 249 $/mois et inclut 1 000 moniteurs, 10 pages de statut et 20 sièges. Soit 792 $ d’économie par an, avant même d’ajouter un outil de monitoring côté PagerDuty.
Le monitoring est intégré, pas greffé. PagerDuty est un outil de gestion des incidents qui dépend d’un monitoring externe pour détecter les problèmes. Hyperping détecte lui-même le problème, qu’il s’agisse d’une vérification HTTP qui échoue depuis l’une de ses régions ou d’un agent serveur qui cesse de répondre puis passe hors ligne, et envoie l’alerte au bon ingénieur d’astreinte, sur une seule plateforme. Les métriques d’hôte comme le CPU, la mémoire et l’utilisation du disque s’affichent sur la même chronologie : la personne qui prend l’alerte voit ce que faisait la machine.
Pas de configuration à rallonge. PagerDuty oblige à configurer séparément Services, Policies, Schedules et Users. Avec Hyperping, la mise en place prend quelques minutes, pas des heures.
Ce qu’en disent les utilisateurs
« Nous avons rendu notre page de statut Hyperping publique et elle est devenue un élément clé de nos argumentaires commerciaux. Nous sommes fiers de notre disponibilité et nous adorons pouvoir la montrer aussi facilement à nos prospects et à nos clients. »
« Les alertes en temps réel de Hyperping nous préviennent quand l’application est en panne. Elles arrivent parfois avant même qu’AWS ne s’en aperçoive ou ne nous prévienne. »
Combien coûte Hyperping ?
- Essentials : 24 €/mois pour 50 moniteurs, 1 page de statut, 3 sièges
- Pro : 74 €/mois en facturation annuelle pour 250 moniteurs, 3 pages de statut publiques ou privées, 10 sièges. Comprend les codes d’accès par e-mail, les pages multilingues et le SSO SAML natif pour le compte.
- Business : 249 €/mois en facturation annuelle pour 1 000 moniteurs, 10 pages de statut, 20 sièges, support prioritaire
Tous les plans payants incluent le planning d’astreinte et les politiques d’escalade. Des sièges sont inclus ; les sièges supplémentaires sont facturés à part.
Les limites de Hyperping
Hyperping n’est pas une plateforme d’observabilité complète. S’il vous faut une gestion des logs intégrée, du tracing distribué ou un APM poussé, vous aurez besoin d’outils complémentaires comme Datadog ou Better Stack.
La plateforme est aussi plus jeune que PagerDuty, et compte donc moins d’intégrations tierces. Si vous dépendez d’une connexion poussée avec ServiceNow ou Jira Service Management, les plus de 700 intégrations de PagerDuty sont difficiles à égaler.
Pour les très grandes organisations avec des plannings follow-the-sun complexes, des politiques d’escalade à 20 règles ou des exigences de conformité ITSM, le moteur de planification de PagerDuty est plus abouti.
Hyperping est-il fait pour vous ?
Choisissez Hyperping si vous êtes une startup, une PME ou une équipe SaaS en croissance qui veut le monitoring, l’astreinte et les pages de statut dans un seul outil, à un prix prévisible. Il convient particulièrement aux équipes lassées de la facturation par utilisateur, aux entreprises européennes attachées à la conformité RGPD et à tous ceux qui veulent un outil qui marche tout de suite, sans des semaines de configuration.
Vous quittez PagerDuty ? Suivez le guide migrer de PagerDuty vers Hyperping.
Better Stack : le meilleur pour réunir monitoring, logs et incidents
À qui s’adresse Better Stack
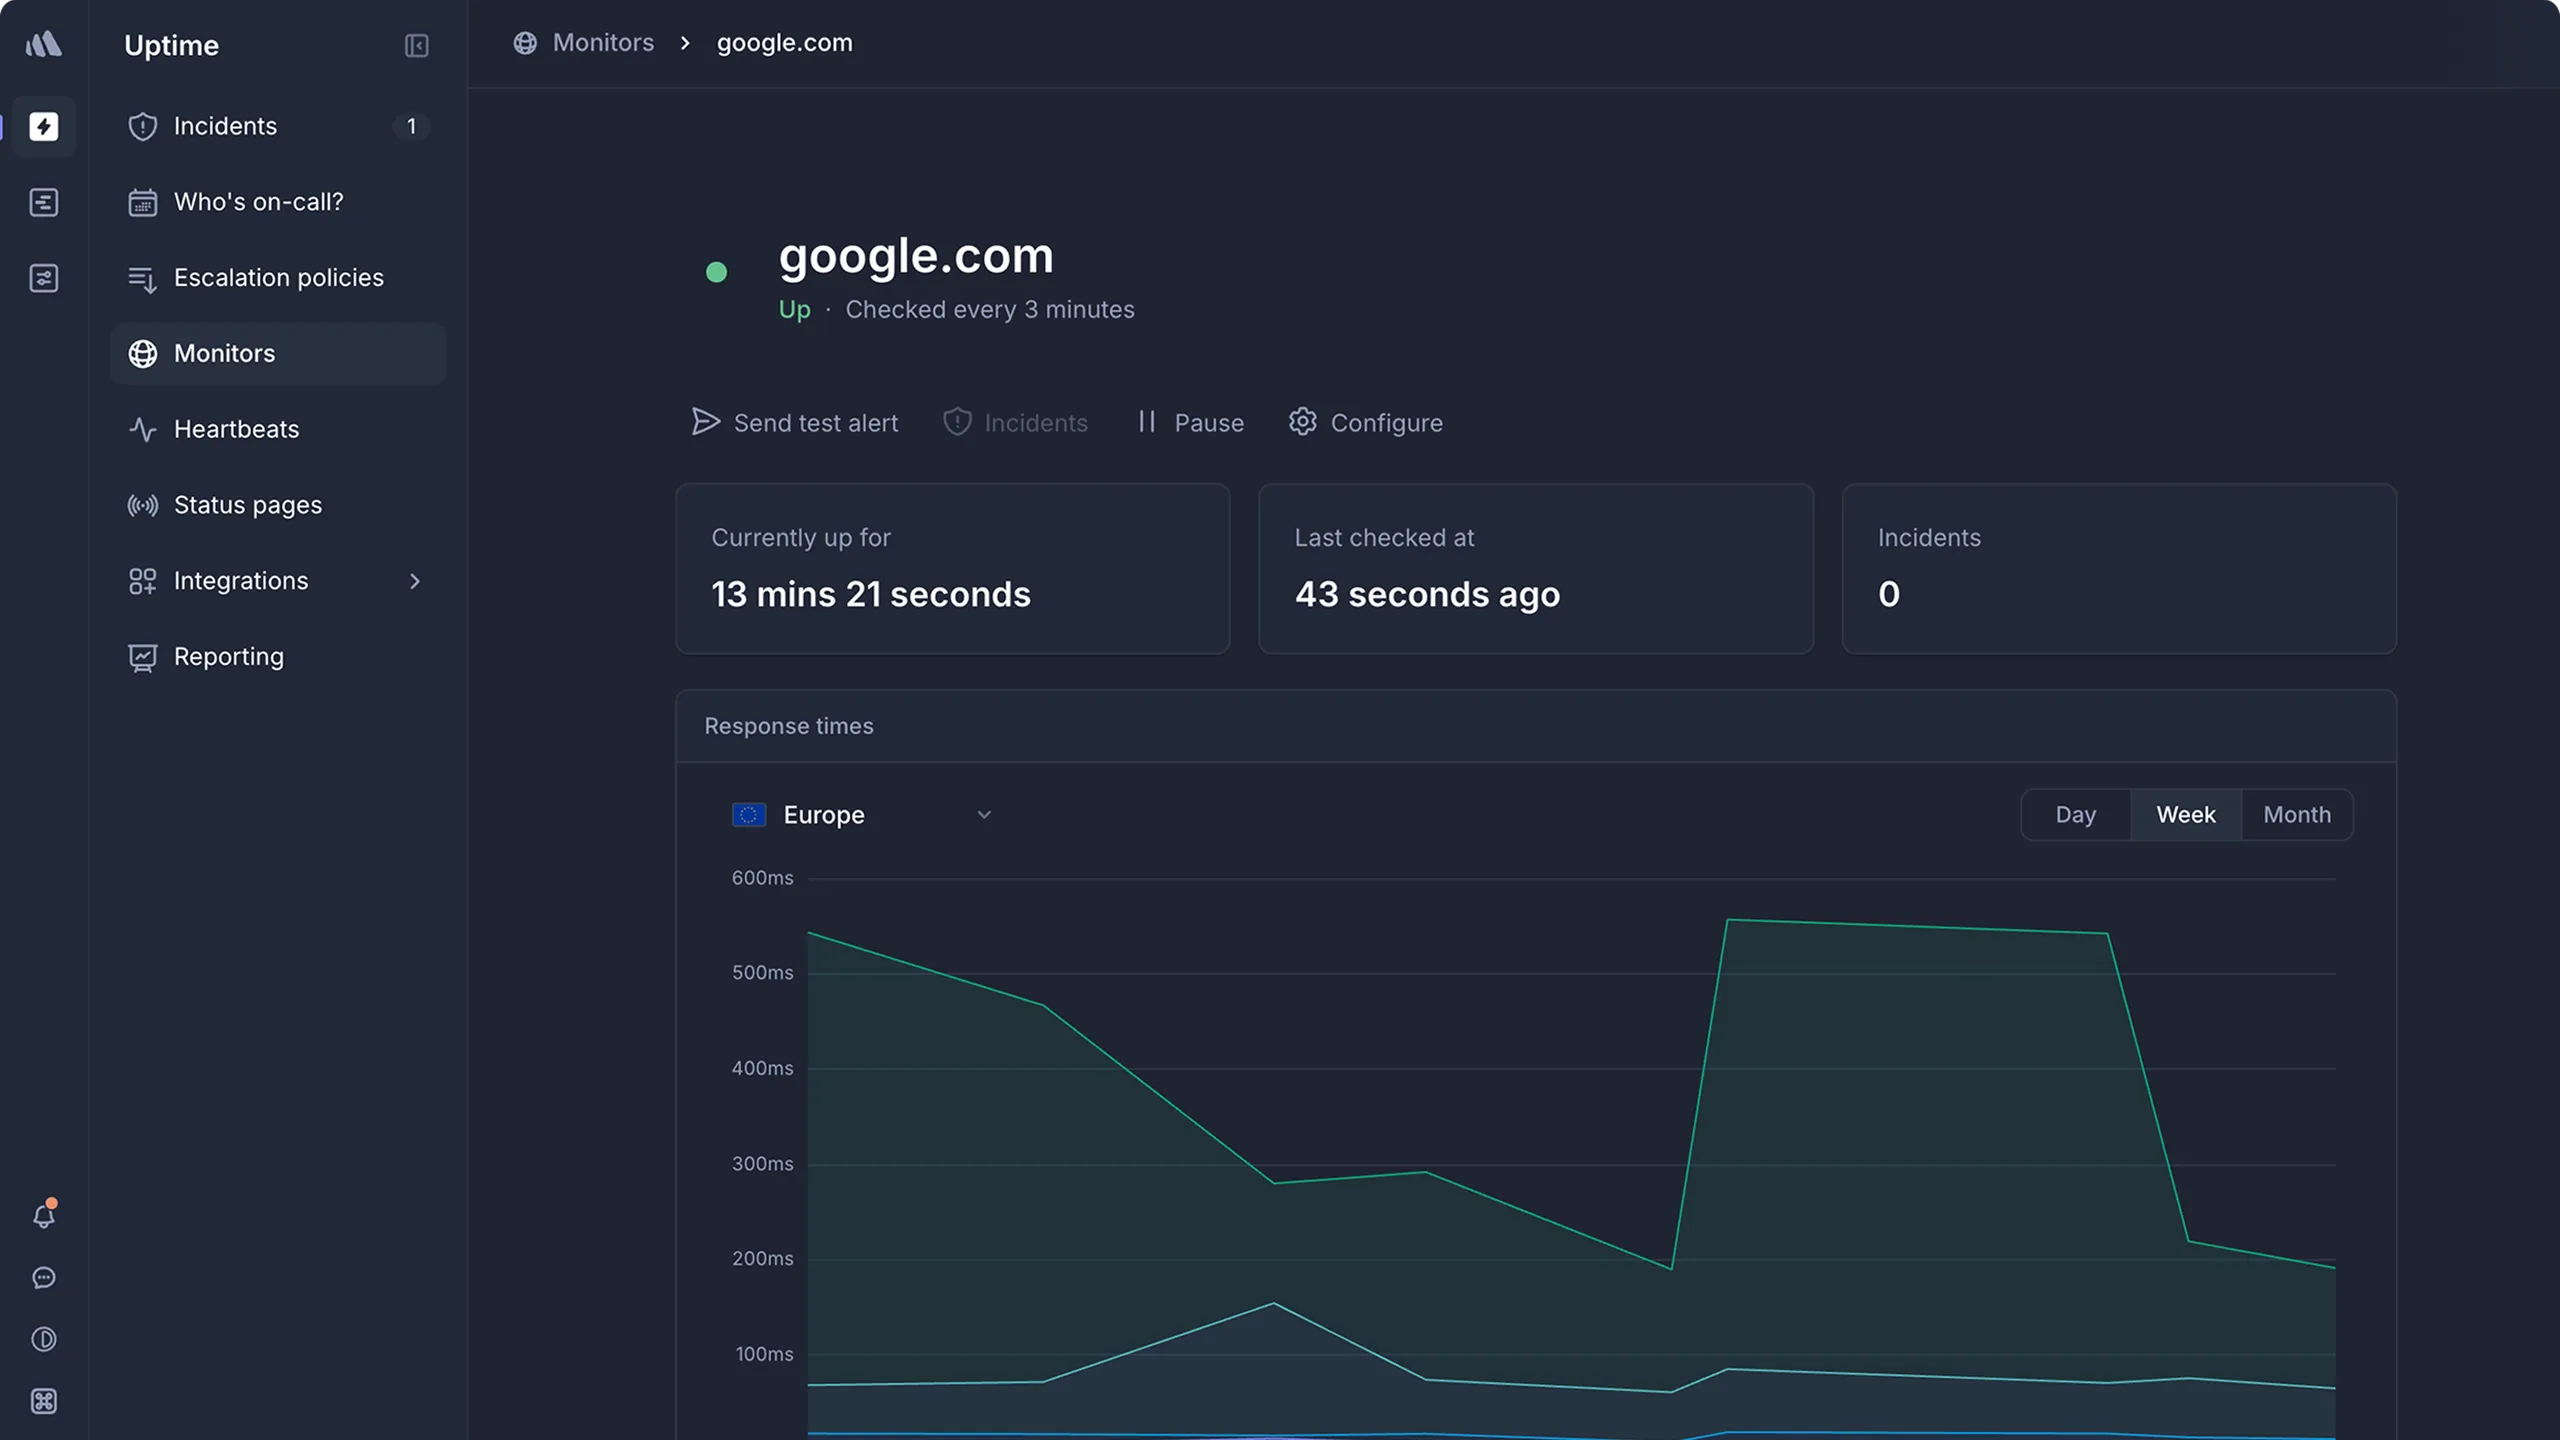
Aux équipes qui veulent une seule plateforme pour le monitoring de disponibilité, la gestion des logs et la réponse aux incidents. Better Stack est un bon choix quand il ne suffit plus de savoir si le service est en ligne et qu’il faut comprendre, dans les logs, pourquoi il est tombé.
Fonctionnalités notables
- Monitoring de disponibilité avec des vérifications depuis plusieurs points dans le monde
- Gestion des logs avec recherche structurée et alertes
- Gestion des incidents avec planning d’astreinte et escalade
- Pages de statut personnalisables à votre marque
- Intégrations avec Slack, Teams, PagerDuty et des outils de développement
- Prise en charge de Terraform et d’une API pour les workflows d’infrastructure as code
Pourquoi choisir Better Stack plutôt que PagerDuty ?
Monitoring et logs inclus. PagerDuty fait uniquement de la gestion des incidents. Better Stack vous donne le monitoring qui détecte les problèmes et l’analyse de logs qui aide à les diagnostiquer, en plus de l’astreinte et des incidents.
Une meilleure prise en main. Better Stack propose une offre gratuite généreuse pour essayer la plateforme sans engagement. L’offre gratuite de PagerDuty est limitée à 5 utilisateurs, avec très peu de fonctionnalités.
Plus abordable pour les petites équipes. L’interface de Better Stack est plus épurée et plus rapide à configurer que la mise en place de PagerDuty, pensée pour les grands comptes.
Ce qu’en disent les utilisateurs G2
« BetterStack Uptime est un excellent outil pour surveiller en temps réel la disponibilité de sites et de services. Son interface est moderne, simple à utiliser et agréable au quotidien. J’apprécie de pouvoir configurer rapidement des moniteurs, recevoir des alertes sur plusieurs canaux (Slack, SMS, e-mail, appel) et partager avec les clients des pages de statut professionnelles. »
« Seul bémol : le coût peut vite grimper si vous avez beaucoup de moniteurs ou besoin d’intégrations avancées. Par ailleurs, certaines options de personnalisation (par exemple sur les pages de statut) restent limitées dans les plans d’entrée de gamme. »
Combien coûte Better Stack ?
- Offre gratuite avec un monitoring de base et des fonctionnalités limitées
- Plans payants à partir de 29 $/mois, avec une tarification par siège sur les plans supérieurs
- La gestion des logs est facturée à l’usage, selon le volume ingéré
Les limites de Better Stack
Le passage de l’offre gratuite aux plans payants est brutal et prend certaines équipes au dépourvu. La licence par intervenant (29 $/mois), plus les options pour des moniteurs supplémentaires (21 $/mois pour 50 de plus) et les pages de statut (12 $/mois chacune), rendent le coût total plus difficile à prévoir qu’avec une alternative à prix fixe.
Better Stack ne propose pas non plus de métriques d’infrastructure natives ni de tracing distribué. Si vous en avez besoin en grandissant, il faudra ajouter d’autres outils.
Better Stack est-il fait pour vous ?
Choisissez Better Stack si vous voulez le monitoring, les logs et les incidents dans un seul outil et qu’une tarification à l’usage ne gêne pas votre équipe. Il convient bien aux startups qui avancent vite, veulent une interface soignée et n’ont pas besoin d’APM poussé ni de tracing. Comparez attentivement le coût total avec les alternatives à prix fixe à mesure que l’équipe grandit.
incident.io : le meilleur pour une gestion des incidents native Slack
À qui s’adresse incident.io
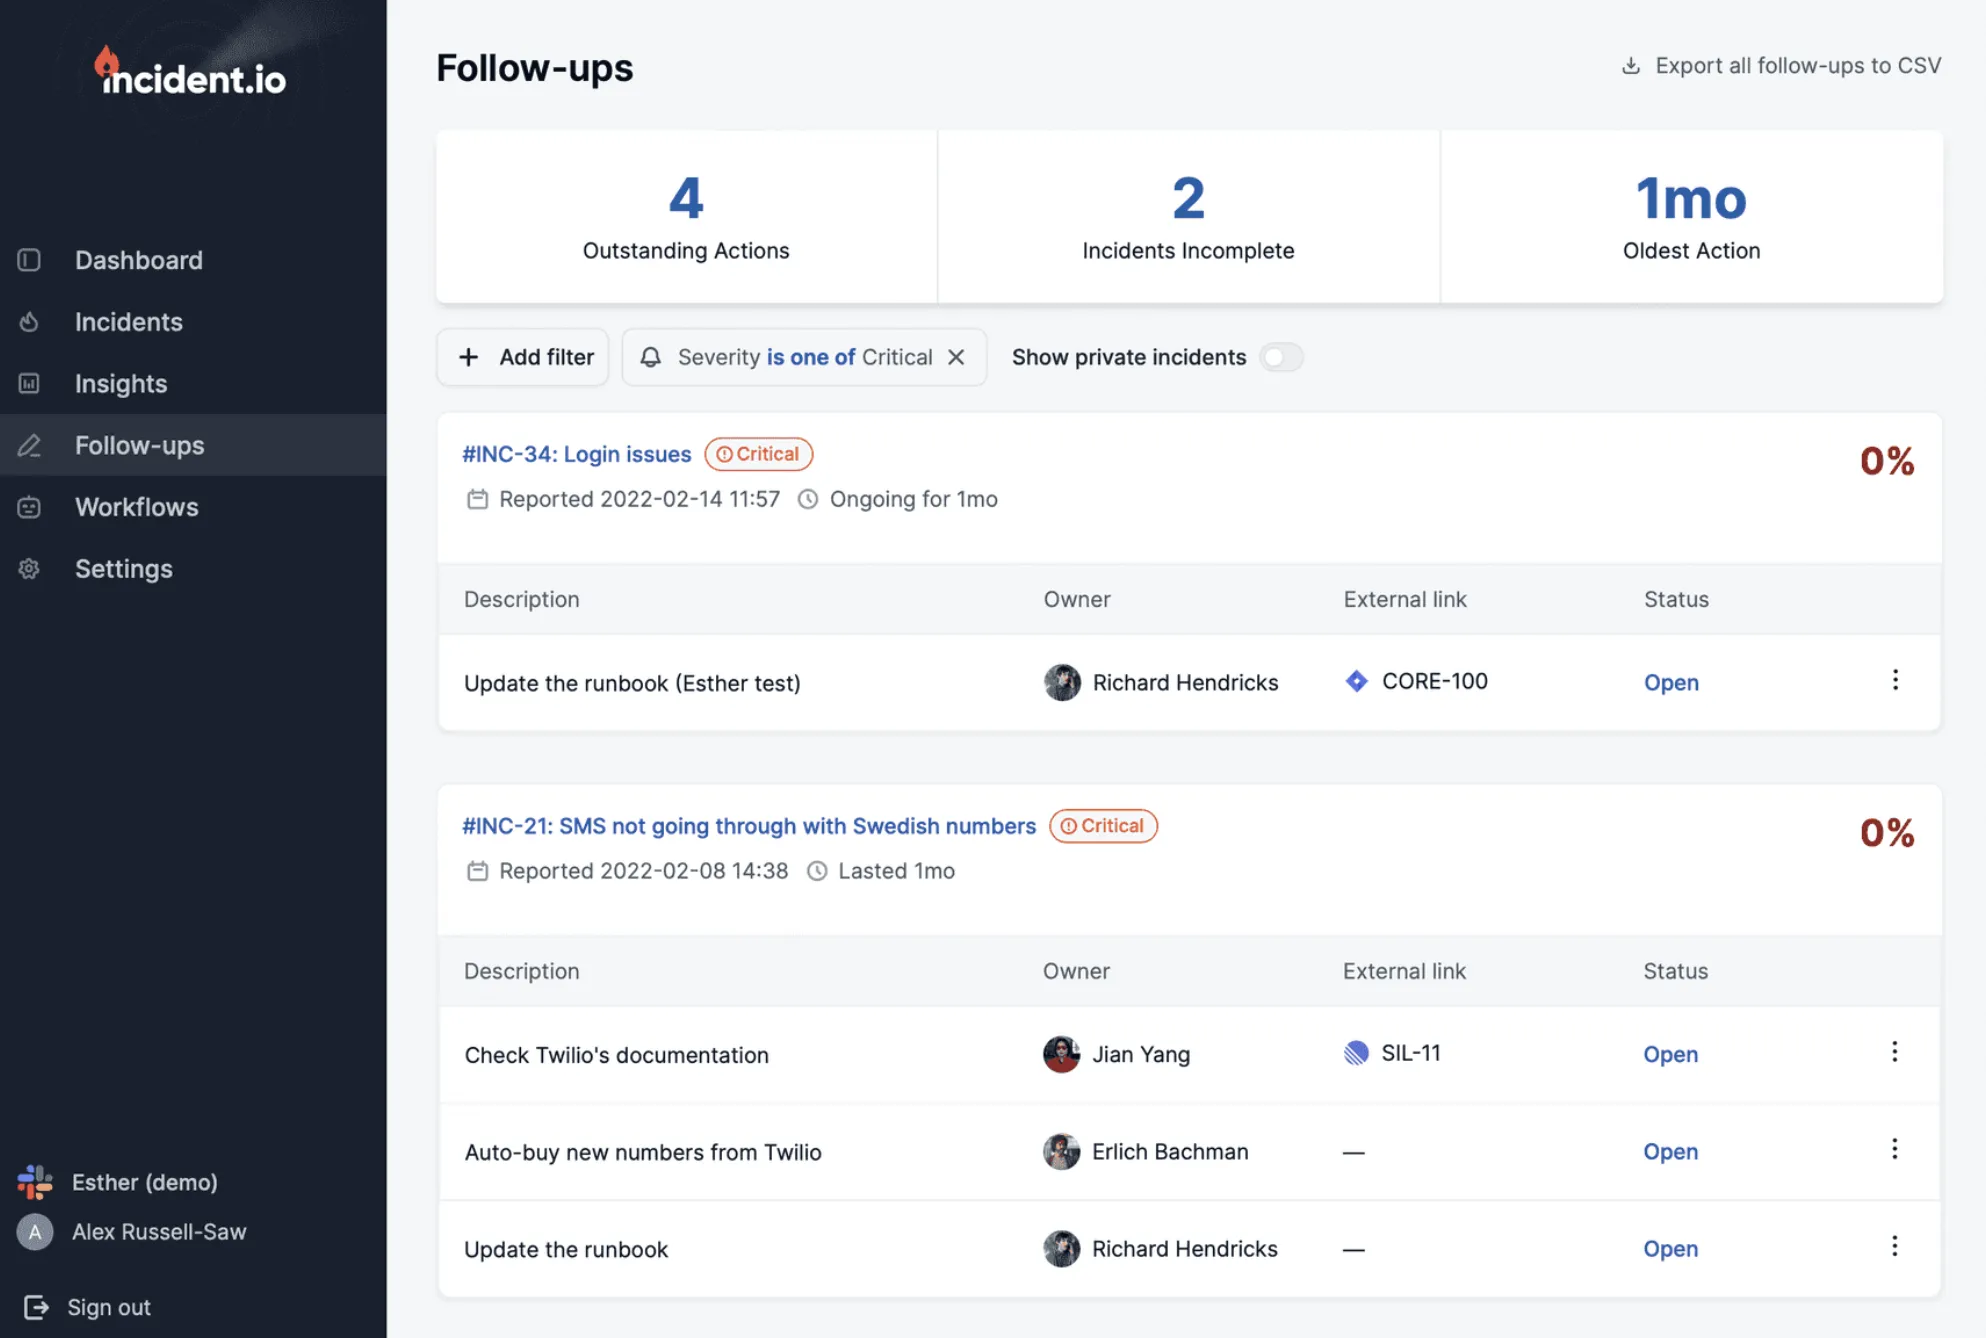
Aux équipes techniques qui vivent dans Slack et veulent que tout le cycle de vie d’un incident, de la déclaration au post-mortem, se déroule dans leur principal outil de communication. incident.io va plus loin que de simples notifications Slack : il fait tourner le processus de gestion des incidents lui-même dans Slack.
Fonctionnalités notables
- Workflow entièrement natif Slack : déclaration des incidents par commandes slash, gestion de la réponse dans des canaux dédiés, coordination des intervenants sans changer de contexte
- Investigation assistée par IA : un agent IA analyse les changements de code, les incidents passés et l’état du système pour identifier les causes probables
- Planning d’astreinte avec routage des appels en direct et analyses de l’épuisement des équipes
- Workflows automatisés qui gèrent la création de canaux, l’attribution des rôles, les notifications et les intégrations selon la gravité
- Analyse post-incident avec des post-mortems générés par IA à partir des chronologies enregistrées
- Pages de statut avec mises à jour automatiques
Pourquoi choisir incident.io plutôt que PagerDuty ?
Les incidents restent là où votre équipe travaille déjà. Avec PagerDuty, les ingénieurs doivent passer sur une interface séparée pendant un incident. incident.io garde tout dans Slack, ce qui réduit l’effort de coordination. D’après leurs données, cela fait gagner 10-15 minutes par incident.
Une IA qui enquête, pas seulement qui regroupe. L’AIOps de PagerDuty regroupe les alertes. L’AI SRE d’incident.io enquête activement sur les incidents : il analyse les commits GitHub et identifie le changement qui a probablement causé le problème.
Un meilleur workflow de post-mortem. incident.io génère automatiquement des brouillons de post-mortem à partir de la chronologie de l’incident enregistrée dans Slack. Avec PagerDuty, les post-mortems demandent davantage de travail manuel.
Pour le face-à-face complet, voir PagerDuty vs incident.io.
Ce qu’en disent les utilisateurs G2
« Incident.io change la donne pour la réponse aux incidents. Son intégration ChatOps sans accroc rend la gestion des incidents rapide, collaborative et intuitive, directement depuis Slack. »
« Le design intuitif, la facilité d’utilisation générale et une relation client remarquable ont fait de moi un fervent adepte de ce produit… la façon dont [les suggestions de l’IA] sont présentées à l’utilisateur est parfaitement fluide. »
« La configuration initiale est complexe. Des outils importants comme les pages de statut sont limités sur la plupart des plans. Des actions simples comme créer un ticket demandent des étapes en plus. »
Combien coûte incident.io ?
- Team : à partir d’environ 15 $/utilisateur/mois, plus une option facturée par utilisateur d’astreinte (environ 10 $/utilisateur/mois) ; comprend l’essentiel de la gestion des incidents et une page de statut
- Pro : à partir d’environ 25 $/utilisateur/mois, avec une option d’astreinte plus chère par utilisateur (environ 20 $/utilisateur/mois), et ajoute des analyses avancées et des fonctionnalités assistées par IA
- Enterprise : tarif sur mesure
Un plan Basic gratuit est disponible. Pour une équipe de 30 personnes dont 20 d’astreinte, le prix catalogue est d’environ 7 800 $/an en Team et 13 800 $/an en Pro.
Les limites d’incident.io
La dépendance à Slack. Si votre équipe utilise surtout Microsoft Teams, ou si la culture Slack n’est pas forte chez vous, incident.io perd une grande partie de son intérêt. L’intégration Teams existe, mais elle est moins complète.
Pas de monitoring intégré. Comme PagerDuty, incident.io se concentre sur ce qui se passe après le déclenchement d’une alerte. Il vous faut toujours un outil de monitoring séparé pour détecter les problèmes.
Le coût à grande échelle. Avec une tarification par utilisateur, la facture suit les effectifs : c’est au fond le même problème qu’avec PagerDuty, même si le tarif par utilisateur est plus bas.
incident.io est-il fait pour vous ?
Choisissez incident.io si votre équipe technique vit réellement dans Slack et que vous voulez une gestion des incidents qui s’intègre naturellement à vos workflows existants. Il est particulièrement solide pour les organisations qui gèrent plus de 10 incidents par mois et ont besoin de processus cohérents, et pour les équipes qui veulent une investigation assistée par IA sans configuration supplémentaire. Assurez-vous que votre équipe est vraiment centrée sur Slack avant de vous engager.
Rootly : le meilleur pour une réponse aux incidents pensée pour l’IA et centrée sur Slack
À qui s’adresse Rootly
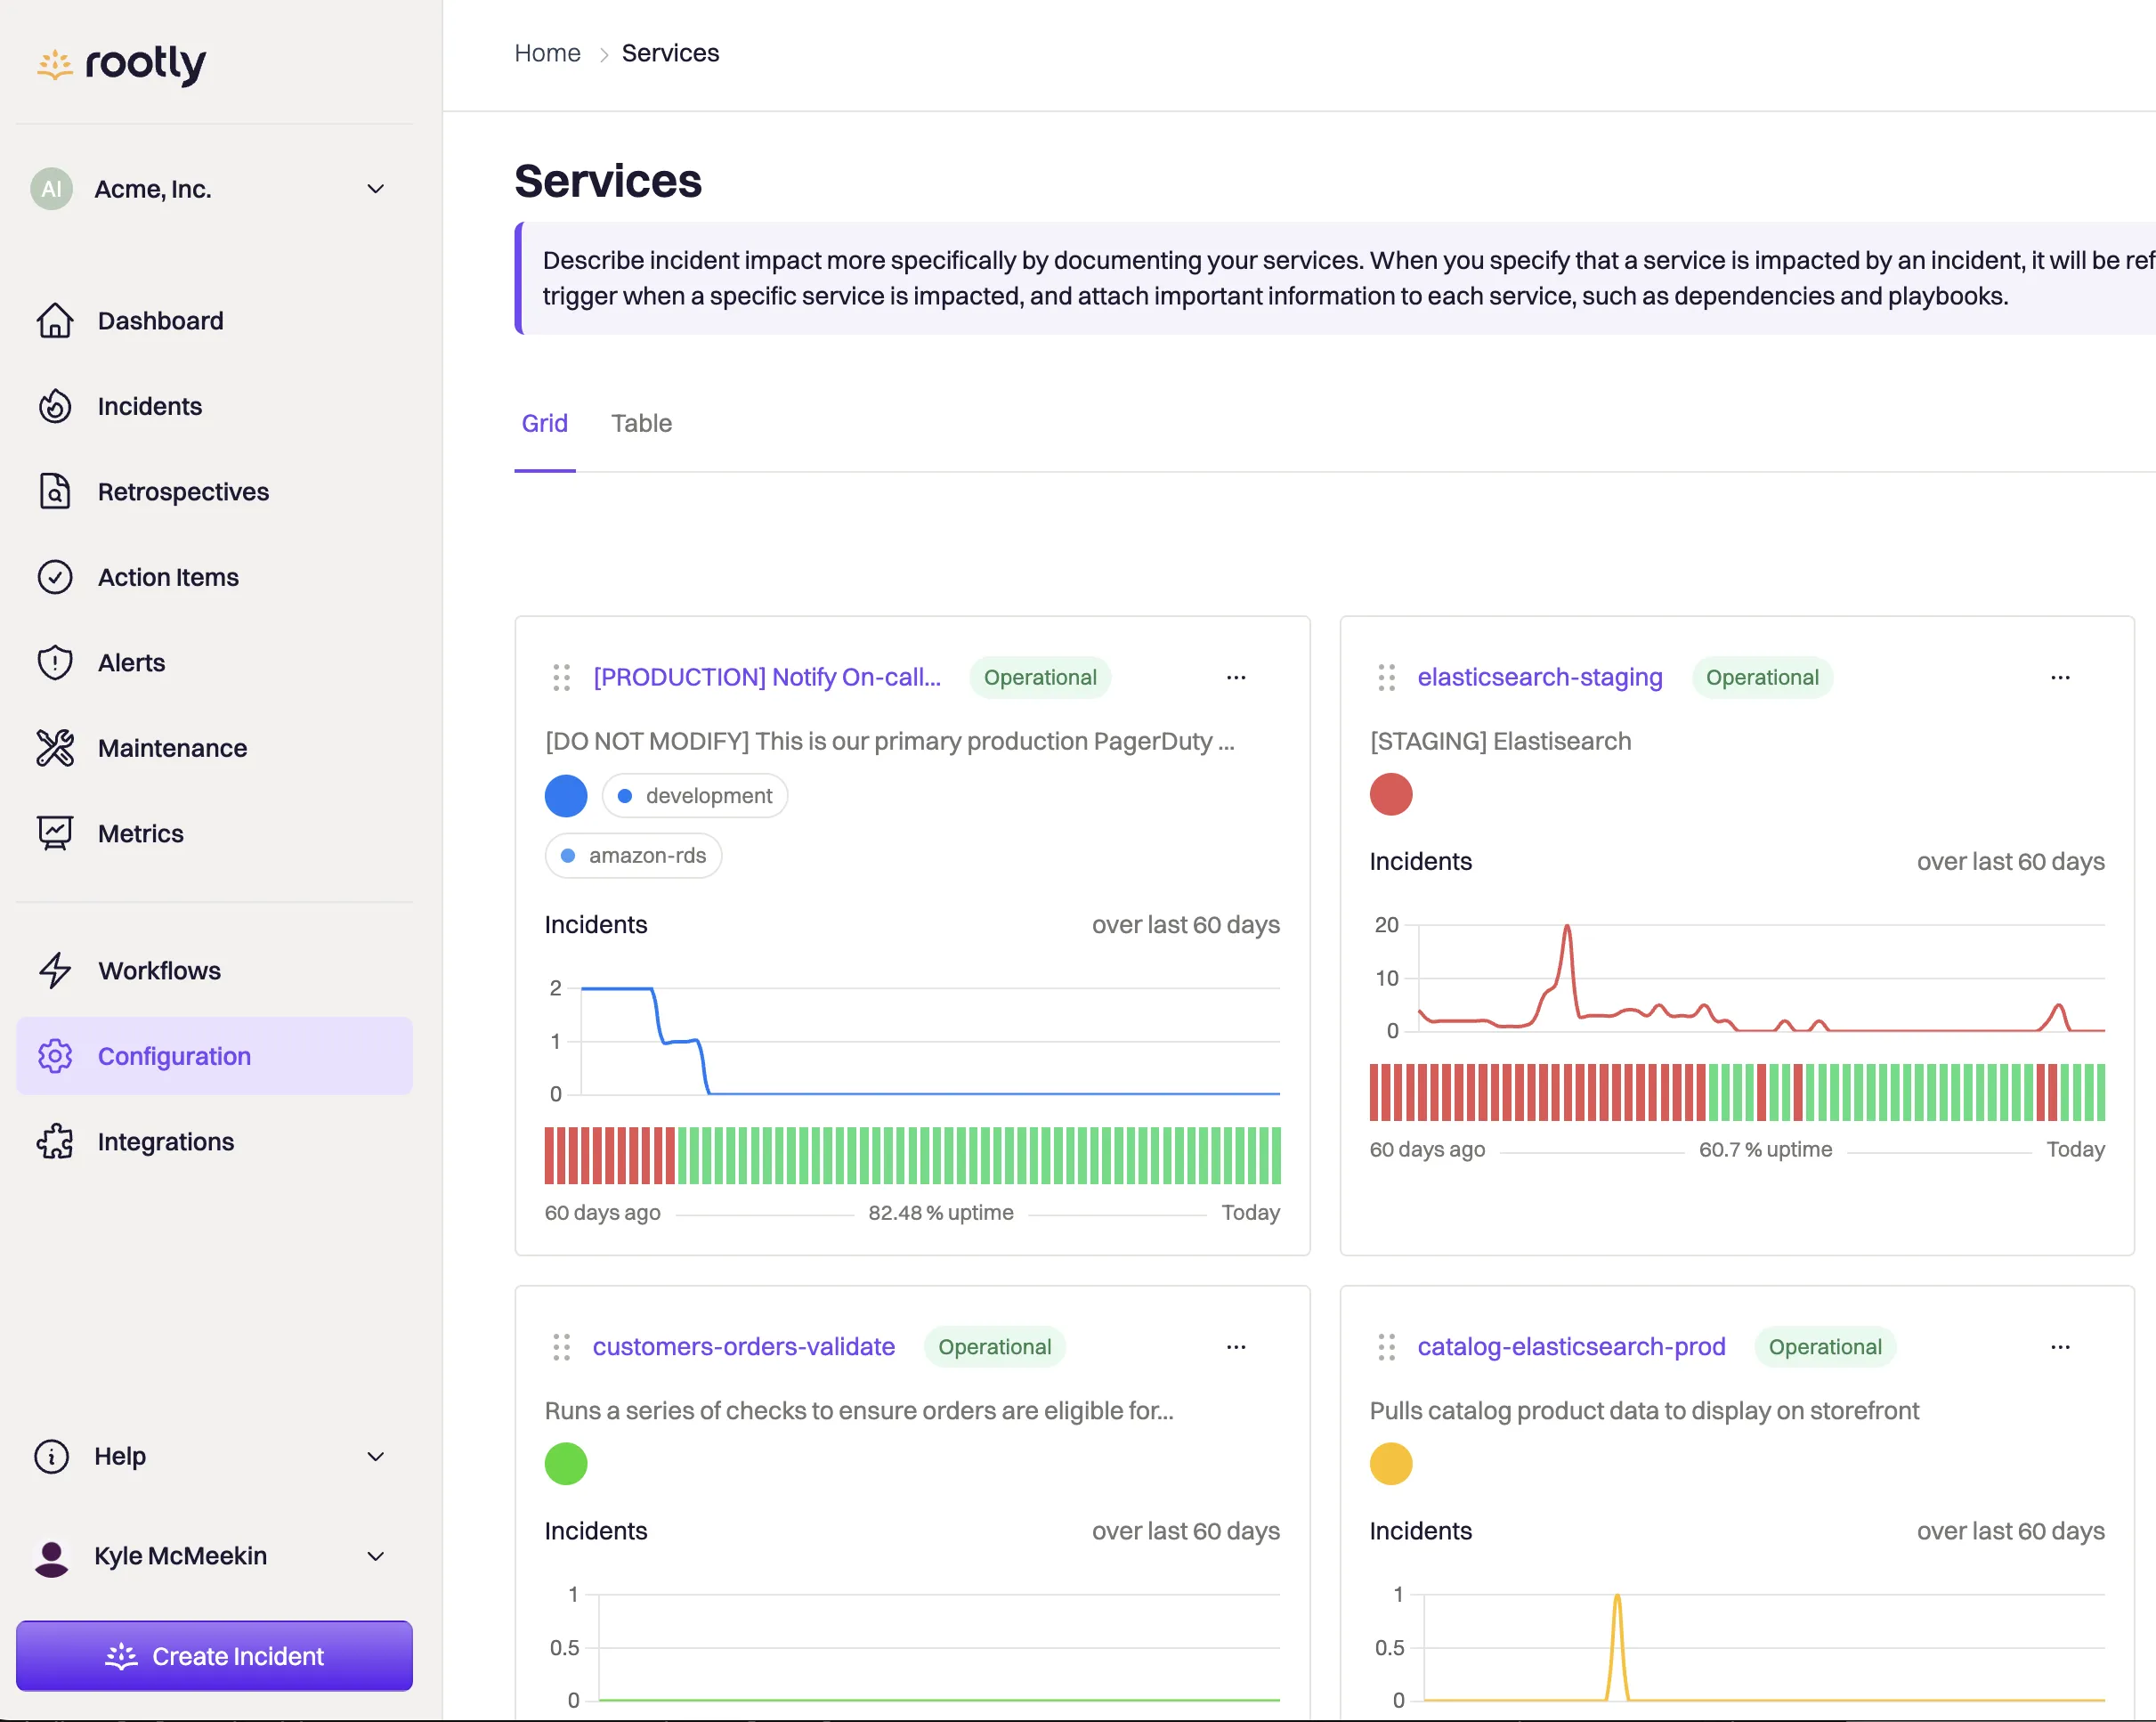
Aux équipes techniques de taille intermédiaire en forte croissance et aux grands comptes qui vivent dans Slack ou Microsoft Teams et veulent une réponse aux incidents pensée pour l’IA, avec une automatisation poussée. Rootly est utilisé par des entreprises comme Cisco, NVIDIA, Figma, Squarespace et Canva. Il est généralement adopté par des équipes SaaS, fintech et plateformes B2B modernes qui veulent moderniser leur réponse aux incidents sans un long projet de mise en œuvre.
Fonctionnalités notables
- Workflows natifs Slack et Teams : déclarer, gérer et résoudre les incidents directement dans la messagerie, avec création automatique de canaux, huddles et transcription
- Automatisation des incidents par IA : résumés générés par IA, suggestions d’intervenants, pistes de remédiation et analyse de l’historique des incidents
- Gestion complète de l’astreinte : plannings, politiques d’escalade, remplacements, routage des alertes et applications iOS/Android
- Moteur de workflows pour des automatisations low-code entre vos outils (Jira, GitHub, Zoom, Slack et d’autres)
- Rétrospectives et chronologies automatisées avec métriques MTTR/MTTA et suivi des actions correctives
- Pages de statut publiques et privées pour la communication interne et externe
- Sécurité de niveau grand compte : SSO, SCIM, RBAC, journaux d’audit, conformité SOC 2, RGPD et CCPA
Pourquoi choisir Rootly plutôt que PagerDuty ?
Pensé pour l’IA, pas une IA greffée après coup. PagerDuty a ajouté AIOps au fil du temps, alors que Rootly a été construit autour de l’IA dès le départ. L’IA intervient dans les résumés, les rétrospectives et les actions suggérées tout au long du cycle de vie de l’incident.
Une conception centrée sur Slack. Pour PagerDuty, la messagerie est un canal de notification. Rootly intègre chaque étape de la réponse aux incidents directement dans Slack ou Teams, ce qui limite les changements de contexte et accélère l’adoption.
Incidents, astreinte et IA réunis à un prix de milieu de marché. Rootly coûte généralement 30-50 % de moins que PagerDuty à périmètre comparable, avec moins de morcellement en SKU quand vous combinez les modules de réponse aux incidents, d’astreinte et d’IA.
Ce qu’en disent les utilisateurs G2
« Rootly nous a aidés à standardiser nos pratiques de gestion des incidents dans Slack, notre principal moyen de communication. Il réduit les changements de contexte et permet aux ingénieurs d’exploitation de rester concentrés sur le vrai problème, au lieu de passer d’un onglet à l’autre pour trouver le bon. »
« J’aime que tout soit stocké au même endroit et s’intègre facilement à tous nos outils existants. La fonctionnalité de workflows permet d’automatiser de nombreuses tâches et de supprimer des étapes manuelles... La mise en place a été très simple, j’étais opérationnel en 2 heures environ. »
Un utilisateur passé de PagerDuty à Rootly explique : « Nous avons changé à cause d’une dette technique écrasante et de la complexité de notre instance PagerDuty, et faute de toute relation constructive avec leur équipe. »
« Rootly n’a pas autant d’intégrations prêtes à l’emploi que certains de ses concurrents. On peut contourner ça avec des webhooks, mais les intégrations natives sont plus puissantes et plus riches en fonctionnalités. »
Combien coûte Rootly ?
- Incident Response Essentials : environ 20 $/utilisateur/mois
- On-Call Essentials : environ 20 $/utilisateur/mois
- AI SRE et Enterprise : tarif sur mesure via l’équipe commerciale, avec des remises si vous combinez plusieurs modules
- Un essai gratuit de 14 jours est disponible, et des remises startup allant jusqu’à environ 50 % sont proposées aux petites entreprises et aux jeunes pousses
La dépense annuelle typique va d’environ 15 000 $ à 60 000 $ selon la taille de l’équipe et le palier.
Les limites de Rootly
La dépendance à Slack/Teams. Les organisations qui n’utilisent pas Slack ou Teams comme principal outil de communication en tireront moins de valeur.
Pas de monitoring intégré. Comme PagerDuty et incident.io, Rootly dépend d’outils externes pour la détection.
Un coût par utilisateur qui s’additionne à grande échelle. Une tarification par utilisateur au-delà de 20 $ peut devenir chère pour de très grandes équipes, surtout si vous cumulez les modules de réponse aux incidents, d’astreinte et d’IA.
Des limites de paliers peu transparentes. Les plafonds exacts de chaque plan (workflows, runbooks, pages de statut) ne se précisent qu’en discutant avec l’équipe commerciale.
Rootly est-il fait pour vous ?
Choisissez Rootly si vous êtes une équipe de taille intermédiaire en forte croissance ou un grand compte qui vit déjà dans Slack ou Teams et veut une réponse aux incidents pensée pour l’IA, avec une automatisation solide. Il convient bien aux plateformes SaaS, fintech et B2B qui gèrent plus de 20 incidents par mois. Il est moins adapté aux très petites équipes et aux organisations qui ne se sont pas standardisées sur Slack/Teams.
Squadcast : le meilleur pour les équipes DevOps attentives à leur budget
À qui s’adresse Squadcast
Aux équipes DevOps et SRE qui ont besoin de planning d’astreinte, de routage des alertes et de gestion des incidents avec les bonnes pratiques SRE intégrées (SLO, budgets d’erreur), sans le prix de PagerDuty. Squadcast a été racheté par SolarWinds et se vend désormais sous le nom « SolarWinds IT Incident Response (Squadcast) », tout en restant présenté comme une plateforme autonome de workflows de fiabilité.
Fonctionnalités notables
- Planning d’astreinte avec rotations, remplacements et routage selon l’horaire
- Politiques d’escalade avec routage à plusieurs étapes, déduplication des alertes et réduction du bruit
- Gestion des incidents avec chronologies, runbooks et collaboration en war room
- Workflows SRE : suivi des SLO/SLA, budgets d’erreur et automatisation de la fiabilité
- Plus de 175 intégrations avec Datadog, Prometheus, Grafana, Jira, Slack, MS Teams et d’autres
- Pages de statut pour communiquer pendant les incidents
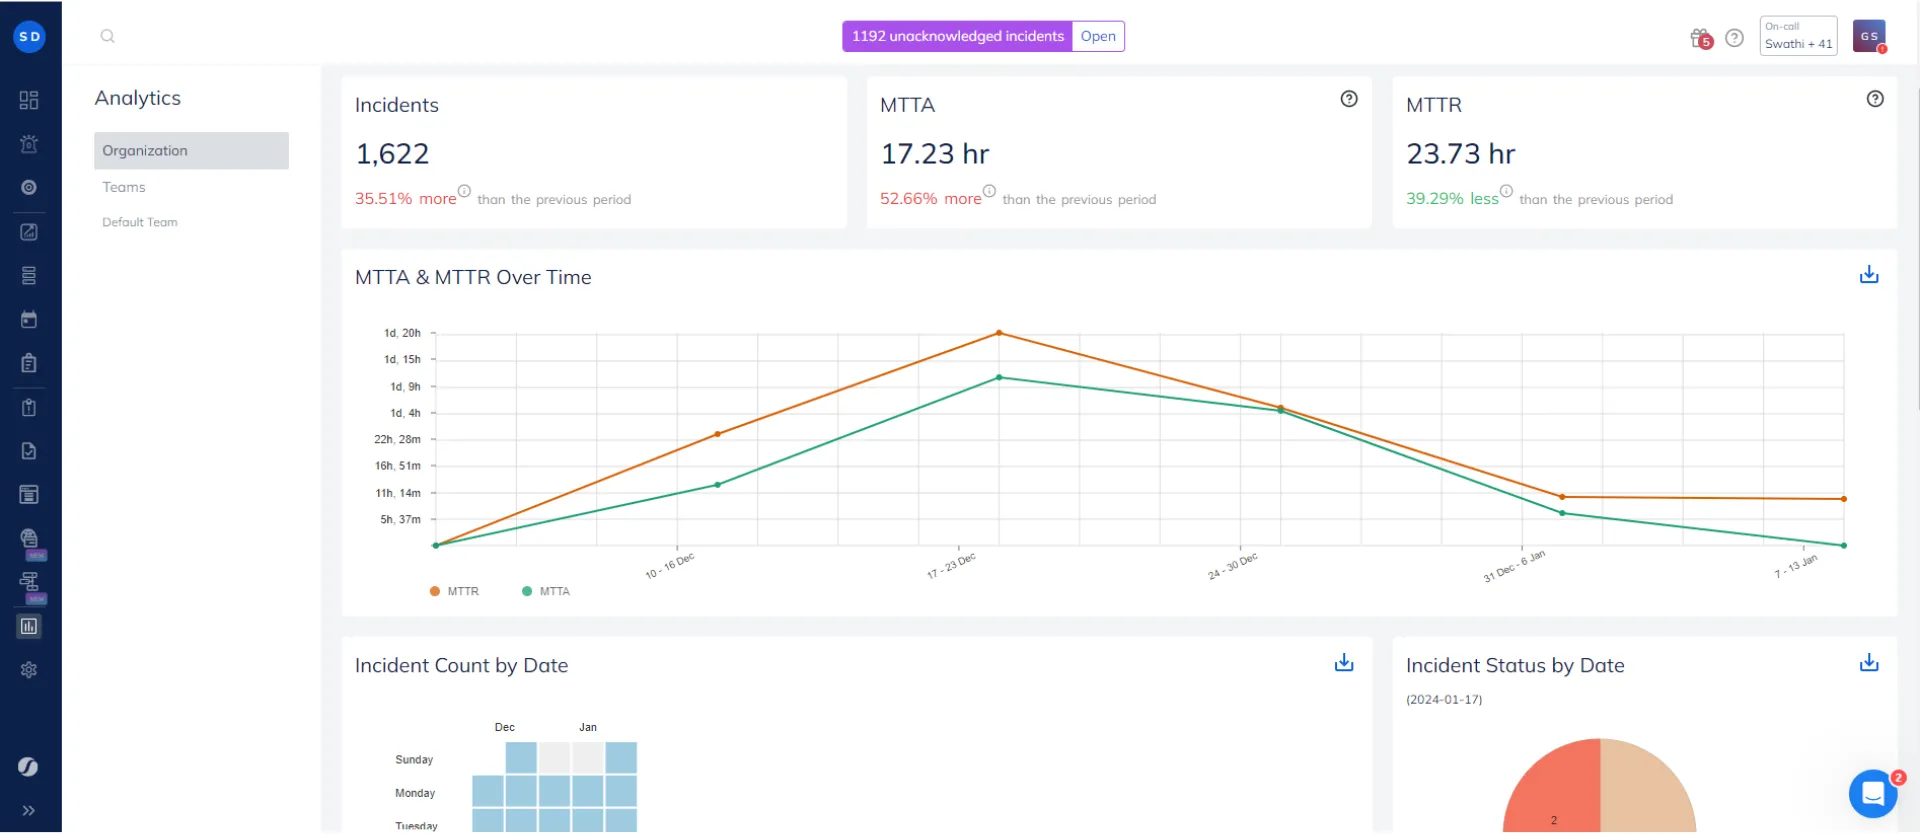
- Analyses et rapports sur le MTTR, le volume d’incidents et les tendances des alertes
Pourquoi choisir Squadcast plutôt que PagerDuty ?
Un coût plus bas. Squadcast Pro à 15 $/utilisateur/mois (facturation annuelle) coûte environ 30 % de moins que le palier Professional de PagerDuty à 21 $/utilisateur/mois. Pour une équipe de 20 personnes, cela fait 3 600 $/an contre 5 040 $/an.
Les pratiques SRE intégrées. Squadcast se présente comme une plateforme de workflows de fiabilité : les SLO, les budgets d’erreur et l’automatisation de la fiabilité font partie du produit, au lieu d’être ajoutés après coup.
Une mise en place plus rapide. Les utilisateurs disent régulièrement avoir configuré Squadcast en quelques heures, pas en quelques jours.
Ce qu’en disent les utilisateurs G2
Un utilisateur passé de PagerDuty à Squadcast raconte : « Après plus de trois ans sur PagerDuty, nous avons décidé de passer à Squadcast, surtout à cause des difficultés liées aux prix et au support client de PagerDuty. La migration s’est faite sans accroc : l’équipe Squadcast nous a aidés à retrouver l’équivalent de notre configuration PagerDuty, y compris la migration de tous les plannings, politiques d’escalade et configurations. »
« Plannings et rotations d’astreinte, routage intelligent des alertes, workflows de réponse aux incidents, intégrations avec les outils de monitoring. »
« Interface et menus très clairs. Un tableau de bord qui donne un aperçu rapide de l’état actuel et de l’incident en cours... la politique d’escalade fait que si une personne manque l’appel, il passe à la suivante, et ainsi de suite. »
Combien coûte Squadcast ?
- Essai : 14 jours, plafonné à 100 notifications par téléphone et SMS (plus de plan gratuit)
- Pro : 15 $/utilisateur/mois (facturation annuelle) avec astreinte, escalades, notifications SMS/vocales et réduction du bruit
- Premium : 24 $/utilisateur/mois (facturation annuelle), qui ajoute les pages de statut, les runbooks, les workflows et le suivi des SLO
- Enterprise : tarif sur mesure avec résumés générés par IA, synchronisation bidirectionnelle avec ServiceNow, SSO et sécurité avancée
Les limites de Squadcast
Moins de fonctionnalités grands comptes. Si vous avez besoin de plannings aussi complexes que ceux de PagerDuty (follow-the-sun avec doublures et politiques d’escalade à 20 règles), le moteur de Squadcast est plus simple.
L’incertitude après le rachat. Depuis l’acquisition par SolarWinds, le produit a été renommé sous la bannière SolarWinds. Après ce genre de rachat, certaines équipes restent prudentes quant à la visibilité de la feuille de route à long terme.
Une marque moins connue des services achats. Dans les organisations où le choix d’un outil doit être validé par la direction, le nom PagerDuty reste parfois plus facile à faire accepter.
Squadcast est-il fait pour vous ?
Choisissez Squadcast si vous êtes une équipe de petite ou moyenne taille qui a besoin d’une gestion d’astreinte fiable sans payer trop cher. Il convient le mieux aux équipes pour qui le coût par utilisateur de PagerDuty est le principal problème, aux organisations qui utilisent les 80 % essentiels des fonctionnalités d’astreinte sans avoir besoin des 20 % réservés aux grands comptes, et aux équipes dont les besoins de planification sont simples (rotations hebdomadaires, politiques d’escalade basiques). Si vos besoins sont simples et votre budget serré, Squadcast offre le meilleur rapport qualité-prix.
Comment choisir la bonne alternative à PagerDuty
Plutôt qu’un vague « ça dépend », voici des critères de décision précis :
Choisissez Hyperping si vous voulez le monitoring, l’astreinte et les pages de statut dans un seul outil, à prix fixe. Idéal pour les équipes de moins de 20 personnes, lassées de payer par utilisateur et qui veulent regrouper leurs outils.
Choisissez Better Stack si vous avez besoin de réunir monitoring, logs et incidents et que votre équipe tient à une interface soignée. Idéal pour les startups et les équipes en croissance qui veulent aller plus loin en observabilité que de simples vérifications de disponibilité.
Choisissez incident.io si votre équipe vit dans Slack et gère plus de 10 incidents par mois. Idéal pour les organisations qui veulent une réponse aux incidents structurée sans arracher les ingénieurs à leur outil de travail principal.
Choisissez Rootly si vous êtes une équipe de taille intermédiaire en forte croissance ou un grand compte qui vit déjà dans Slack ou Teams et veut une réponse aux incidents pensée pour l’IA, avec une automatisation solide. Idéal pour les plateformes SaaS, fintech et B2B qui gèrent plus de 20 incidents par mois.
Choisissez Squadcast si le budget est votre principale contrainte et qu’il vous faut une gestion d’astreinte solide. Idéal pour les équipes de moins de 20 personnes qui utilisent les fonctionnalités essentielles sans avoir besoin de la complexité des grands comptes.
Vous comparez PagerDuty avec VictorOps ou Grafana OnCall ? La section alternatives à VictorOps (Splunk On-Call) met Splunk On-Call et PagerDuty côte à côte, et la comparaison Grafana OnCall vs PagerDuty s’adresse aux équipes dont les alertes viennent de Grafana.
Comment tester ces outils
Les cinq outils retenus proposent une offre gratuite ou un essai :
- Hyperping : offre gratuite disponible, essai de 14 jours sur le plan Essentials. Vous quittez PagerDuty ? Consultez le guide de migration.
- Better Stack : offre gratuite avec les fonctionnalités de base
- incident.io : plan Basic gratuit (1 page de statut, astreinte pour une seule équipe), plans payants à partir de 15 $/utilisateur/mois
- Rootly : essai gratuit d’environ 14 jours ; remises startup jusqu’à 50 % pour les jeunes entreprises
- Squadcast : essai gratuit de 14 jours (pas de plan gratuit)
Faites tourner chaque nouvel outil en parallèle de votre configuration actuelle pendant au moins une semaine. Comparez la vitesse de routage des alertes, le taux de faux positifs, le temps de mise en place et la façon dont l’outil s’intègre au quotidien de votre équipe. La plupart des équipes avec qui j’ai échangé ont essayé 2-3 outils avant de faire leur choix définitif.
À lire aussi
- Migrer de PagerDuty vers Hyperping : le guide de migration pas à pas
- Les meilleurs outils de planning d’astreinte : comparez les principales plateformes d’astreinte
- Un cadre pour vos politiques d’escalade : construisez des politiques d’escalade qui réduisent le MTTR
- Les meilleurs outils de gestion des incidents : un tour d’horizon plus large de la gestion des incidents
- Guide du monitoring de serveurs Linux : métriques CPU, mémoire, disque et réseau de vos propres hôtes
- Calculateur du coût du monitoring de serveurs : comparez les prix par hôte de Datadog, New Relic, Netdata et Hyperping
- L’astreinte Hyperping : le planning d’astreinte avec Hyperping
- La gestion des incidents Hyperping : les fonctionnalités de gestion des incidents
- Les pages de statut Hyperping : des pages de statut à vos couleurs
Continuer la comparaison : Hyperping vs PagerDuty · Hyperping vs Opsgenie · Tarifs Hyperping · Toutes les comparaisons
Questions fréquentes
Quelles sont les meilleures alternatives à PagerDuty en 2026 ? ▼
Les cinq meilleures alternatives à PagerDuty sont Hyperping (monitoring à prix fixe avec astreinte et pages de statut), Better Stack (monitoring, logs et incidents réunis), incident.io (gestion des incidents native Slack), Rootly (réponse aux incidents axée sur l’automatisation) et Squadcast (astreinte économique pour les équipes DevOps).
Pourquoi les équipes quittent-elles PagerDuty ? ▼
Les raisons les plus fréquentes : une tarification par utilisateur qui devient douloureuse à mesure que l’équipe grandit (à partir de 21 $/utilisateur/mois), une complexité dont les petites équipes n’ont pas besoin, des régressions de l’application mobile et des webhooks et une API trop rigides, qui freinent l’automatisation.
Quelle est l’alternative à PagerDuty la moins chère avec planning d’astreinte ? ▼
Squadcast (devenu SolarWinds Incident Response) n’a plus de plan gratuit, mais le plan Pro coûte 15 $/utilisateur/mois en facturation annuelle, avec un essai de 14 jours. Hyperping démarre à 24 €/mois à prix fixe, avec des sièges inclus et des sièges supplémentaires payants, et inclut le planning d’astreinte, les politiques d’escalade et les pages de statut dans tous les plans payants.
Puis-je avoir le monitoring, l’astreinte et les pages de statut dans un seul outil à la place de PagerDuty ? ▼
Oui. Hyperping réunit sur une seule plateforme le monitoring de disponibilité (vérifications toutes les 30 secondes), le planning d’astreinte avec politiques d’escalade et des pages de statut entièrement à vos couleurs. Les plans démarrent à 24 €/mois avec des sièges inclus ; les sièges supplémentaires sont facturés à part.
PagerDuty vaut-il son prix pour une petite équipe ? ▼
Pour la plupart des petites équipes, PagerDuty en fait bien plus que nécessaire. La tarification par utilisateur, la configuration complexe et les fonctionnalités pensées pour les grands comptes alourdissent le quotidien sans apporter une valeur à la hauteur. Des alternatives comme Hyperping ou Squadcast offrent l’essentiel de l’astreinte et de l’escalade pour une fraction du prix.
Quelle est la meilleure alternative à PagerDuty pour les équipes qui travaillent dans Slack ? ▼
incident.io est l’option la plus solide pour les équipes centrées sur Slack. Tout le cycle de vie de l’incident s’y déroule, de la déclaration au post-mortem, avec une investigation assistée par IA et des workflows automatisés. Il existe un plan gratuit (Basic), puis le plan Team à 15 $/utilisateur/mois en facturation annuelle (19 $ au mois), plus 10 $/utilisateur/mois pour l’astreinte.
Migrer depuis PagerDuty, est-ce facile ? ▼
Oui. Le guide de migration de Hyperping explique comment exporter les services, plannings et politiques d’escalade de PagerDuty, reconstruire votre chaîne d’astreinte dans Hyperping et faire tourner les deux outils en parallèle avant de basculer. L’équipe propose aussi une migration accompagnée gratuite sur les plans payants. Voir /docs/migrate/from-pagerduty.