Grafana OnCall OSS ist Geschichte. Das Projekt ging am 11. März 2025 in den Wartungsmodus, die Entwicklung endete am 24. März 2026 mit der Archivierung des Repositorys (es liegt jetzt schreibgeschützt in Grafanas Organisation cold-storage auf GitHub), und am selben Tag hat Grafana die Cloud Connection abgeschaltet, die SMS, Anrufe und mobile Push-Benachrichtigungen an selbst gehostete Instanzen zugestellt hat. Wenn Ihre Bereitschaft bisher per Push aus einem selbst gehosteten OnCall geweckt wurde: Das passiert seit März nicht mehr.
Der offizielle Weg ist Grafana Cloud IRM, das gehostete Produkt, in dem OnCall und Incident im April 2025 zusammengeführt wurden. Für manche Teams ist das die richtige Antwort, für andere die falsche, und dieser Leitfaden richtet sich an die zweite Gruppe. Ich zeige genau, was weggefallen ist, was Grafana Cloud IRM kostet, fünf Grafana-OnCall-Alternativen (Hyperping, PagerDuty, incident.io, Rootly und GoAlert als Open-Source-Option) und eine Migrationstabelle, die Eskalationsketten, Bereitschaftspläne und Integrationen auf jedes Tool abbildet.
Wenn Sie eher die ganze Kategorie Rufbereitschaft suchen als einen Ausstiegsplan aus Grafana OnCall, finden Sie sie in unserem Leitfaden zu den 10 besten Tools für Bereitschaftsplanung. Dieser Artikel wiederholt diese Liste nicht.
Das Wichtigste in Kürze
- Selbst gehostetes Grafana OnCall läuft weiter, bekommt aber seit dem 24. März 2026 keine Fixes mehr und kann über Grafanas Relay weder SMS noch Anrufe noch mobile Push-Benachrichtigungen senden. Slack, Telegram, E-Mail und Webhooks funktionieren weiter.
- Grafana Cloud IRM kostet eine Plattformgebühr von 19 $/Monat (3 aktive IRM-Nutzer inklusive) plus 20 $ pro weiterem aktivem IRM-Nutzer, und die kostenlose Stufe endet bei 3 aktiven Nutzern.
- Grafanas Migrator akzeptiert inzwischen OnCall OSS als Quelle, legt aber keine Nutzer oder Teams an und hat als einziges Ziel Grafana Cloud IRM.
- Für ein Team von 10 Personen kostet Hyperping Pro bei jährlicher Zahlung 74 $/Monat, Monitoring und Statusseite inklusive. Grafana Cloud IRM Pro kostet 159 $/Monat, Rootly, PagerDuty oder incident.io 200 bis 250 $/Monat, und keines davon enthält Uptime-Prüfungen.
- GoAlert ist der Open-Source-Ersatz, der Bereitschaftspläne, Eskalationen und Alarmierung über Twilio auf Ihren eigenen Servern hält, um den Preis eines langsamen Projekts: v0.35.0 kam im September 2026, elf Monate nach v0.34.1.
Warum Sie diesem Leitfaden vertrauen können
Ich bin Léo, Gründer von Hyperping, eine der fünf Alternativen unten ist also meine. Ich halte Hyperping nicht für jeden OnCall-Nutzer für die richtige Wahl und sage, wo es nicht passt: Wenn Ihre Alarme weiter aus Prometheus Alertmanager kommen müssen, ist Hyperping das falsche Ziel, und ich nenne die Tools, die diese Webhooks stattdessen annehmen.
Jedes Datum in diesem Artikel stammt aus Grafanas eigener Ankündigung des Wartungsmodus, dem Hinweis in der OSS-Einrichtungsanleitung und dem archivierten Repository. Die Preise habe ich am 16. September 2026 auf der Preisseite jedes Anbieters abgelesen. Wo sich Grafanas Dokumentation beim Thema Migrationstools widerspricht, zitiere ich beide Seiten, statt mich für eine zu entscheiden.
Was genau in Grafana OnCall OSS weggefallen ist
Es sind drei getrennte Dinge passiert, und Teams werfen sie gern durcheinander.
| Datum | Was sich geändert hat | Auswirkung auf eine selbst gehostete Instanz |
|---|---|---|
| 11. März 2025 | OnCall OSS geht in den Wartungsmodus | Nur noch kritische Bugs und CVEs mit einem CVSS-Score ab 7,0 werden behoben. Keine neuen Funktionen. |
| 21. April 2025 | Die Apps OnCall (Cloud) und Incident werden in Grafana Cloud eingestellt | Cloud-Kunden wurden auf die vereinheitlichte App Grafana Cloud IRM umgestellt. |
| 24. März 2026 | Entwicklung beendet, Repository archiviert, Cloud Connection abgeschaltet | Schreibgeschützter Code, verschoben in die Organisation grafana-cold-storage auf GitHub. Push in der Mobile-App, SMS und Anrufe über Grafanas Relay sind vorbei. |
Was auf einer selbst gehosteten Instanz nach dem 24. März 2026 noch funktioniert: ChatOps in Slack und Microsoft Teams, Telegram, E-Mail, ausgehende Webhooks sowie SMS oder Anrufe, wenn Sie statt der Cloud Connection Ihr eigenes Konto bei Twilio, Exotel oder Zvonok angebunden hatten. Grafanas Ankündigung schlägt außerdem Push über Pushover, Gotify oder ntfy per Webhook vor.
Was nicht mehr funktioniert: die mit einem selbst gehosteten Stack verbundene Mobile-App und jede Benachrichtigung, die über Grafanas Server lief. Auch die Sicherheitspatches für die Container-Images bleiben aus, und genau das ist der Punkt, an dem ein internes Audit hellhörig wird.
Ein Team, das die Cloud Connection nie genutzt hat und über Slack alarmiert, kann die archivierte Version also noch eine Weile weiterbetreiben. Ein Team, das sich für Alarme um 3 Uhr nachts auf die Mobile-App verlassen hat, hat seinen Weckkanal bereits verloren, und genau diese Gruppe muss jetzt wechseln.
Grafana Cloud IRM: die Standardoption und was sie kostet
Grafana Cloud IRM ist das, wohin Grafana Sie umziehen sehen will. Es sind OnCall und Incident, zusammengeführt in einer App innerhalb von Grafana Cloud, mit denselben Eskalationsketten, Bereitschaftsplänen, Routen und ChatOps, dazu Incident-Management und die Mobile-App, die nicht mehr mit OSS spricht.
Preise
Laut grafana.com im September 2026:
- Free: begrenzt auf 3 aktive IRM-Nutzer pro Monat, Community-Support.
- Pro: Plattformgebühr von 19 $/Monat mit 3 aktiven IRM-Nutzern inklusive, dann 20 $ pro weiterem aktivem IRM-Nutzer, mit automatischen Mengenrabatten und E-Mail-Support 8x5.
- Enterprise: Mindestabnahme von 25.000 $ pro Jahr, Premium-Support, Optionen für BYOC und Federal Cloud.
Als aktiver IRM-Nutzer zählt, wer im Laufe des Monats in einem Bereitschaftsplan oder einer Eskalationskette steht oder einen Alarm quittiert, einen Alarm ändert oder einen Incident anlegt oder bearbeitet. Lesen Sie diese Definition genau: Jede Person in einer Rotation zählt, egal ob sie alarmiert wurde oder nicht.
| Team in der Rotation | Grafana Cloud IRM Pro, monatlich |
|---|---|
| 3 Personen | 19 $ (nur Plattformgebühr) |
| 5 Personen | 59 $ |
| 10 Personen | 159 $ |
| 25 Personen | 459 $ |
Was mir gefällt
- Die kürzeste Migration. Dieselben Konzepte, derselbe Terraform-Provider, dieselben Apps für Slack und Teams. Wenn Ihre Alarme aus Grafana Alerting stammen, landen der Dashboard-Link und die Metrikwerte weiterhin im Alarm.
- Für die OSS-Quelle gibt es einen Migrator. Grafanas Repository irm-tooling akzeptiert
MIGRATING_FROM="oncall_oss"und kopiert Eskalationsketten, Bereitschaftspläne und Schichten, Integrationen, Routen und ausgehende Webhooks. Er läuft zuerst in einem Plan-Modus. - Die Mobile-App ist zurück. Push, SMS und Anrufe gehören zum gehosteten Produkt.
Zu bedenken
- Grafanas Dokumentation widerspricht sich selbst. Die eigene Migrationsseite für OSS sagt, dass „die IRM-Migrationstools Grafana OnCall OSS derzeit nicht als Quellplattform unterstützen“, und verweist auf Terraform oder die OnCall-API, während die Migrationsübersicht und das README des Tools OnCall OSS als unterstützt aufführen. In der Praxis legt der Migrator keine Nutzer oder Teams an, ordnet Personen über die E-Mail-Adresse zu und kann keine Integrationen für Direct Paging anlegen. Planen Sie in jedem Fall einen manuellen Durchgang ein.
- Sie verlieren das Self-Hosting. Bereitschaftspläne, Alarm-Payloads und Incident-Timelines wandern in Grafanas Cloud. Für Teams, die OnCall OSS wegen der Datenresidenz gewählt haben, ist genau das der Grund zu gehen.
- Die Zählung pro Nutzer greift weit. Zehn Personen in einer Rotation kosten 159 $/Monat, bevor Sie für Metriken, Logs oder Traces in Grafana Cloud zahlen.
- Weiterhin keine externen Prüfungen und keine öffentliche Statusseite. Wie OnCall leitet IRM Alarme weiter. Die Erkennung bleibt bei Prometheus oder beim synthetischen Monitoring, und Statusseiten für Kunden bleiben ein separates Abo.
Wählen Sie Grafana Cloud IRM, wenn Sie Grafana Cloud bereits bezahlen, Ihre Alarme aus Regeln in Grafana Alerting kommen und Sie kein Self-Hosting brauchen. Lassen Sie es, wenn Sie OnCall OSS aus einem anderen Grund als der Ankündigung des Wartungsmodus verlassen oder nicht mehr pro Person in der Rotation zahlen wollen.
Die 5 besten Grafana-OnCall-Alternativen
Ich habe fünf Tools ausgewählt, die jeweils eine andere Aufgabe übernehmen, die OnCall für Sie erledigt hat: Hyperping für Teams, die Erkennung und Rufbereitschaft auf einer Rechnung wollen, PagerDuty für Alarm-Routing auf Enterprise-Niveau, incident.io und Rootly für Incident Response direkt in Slack und GoAlert für den Open-Source-Platz zum Selbsthosten, den bisher OnCall OSS besetzt hat.
| Tool | Nimmt Webhooks von Alertmanager oder Grafana an | Eingebaute Uptime-Prüfungen | Statusseite | Self-Hosting | Preis für 10 Personen, monatlich |
|---|---|---|---|---|---|
| Grafana Cloud IRM | Ja (nativ) | Nein | Nein | Nein | 159 $ |
| Hyperping | Nein (Hyperping ist selbst die Alarmquelle) | Ja | Ja | Nein | 74 $ (Pro, jährlich) |
| PagerDuty | Ja | Nein | Add-on (Statuspage) | Nein | 210 $ (Professional, jährlich) |
| incident.io | Ja | Nein | Ja (eingeschränkt im Team-Tarif) | Nein | 250 $ (Team + On-Call) |
| Rootly | Ja | Nein | Ja | Nein | 200 $ (On-Call Essentials) |
| GoAlert | Ja | Nein | Nein | Ja | 0 $ plus Server und Twilio |
1. Hyperping: Rufbereitschaft, Monitoring und Statusseiten in einem Festpreis-Tarif
Ideal für: Teams von 2 bis 50 Personen, deren OnCall-Integrationen hauptsächlich Uptime-, SSL- und Cron-Alarme waren und die Prüfung, Alarmierung und Statusseite in einem Tool wollen.
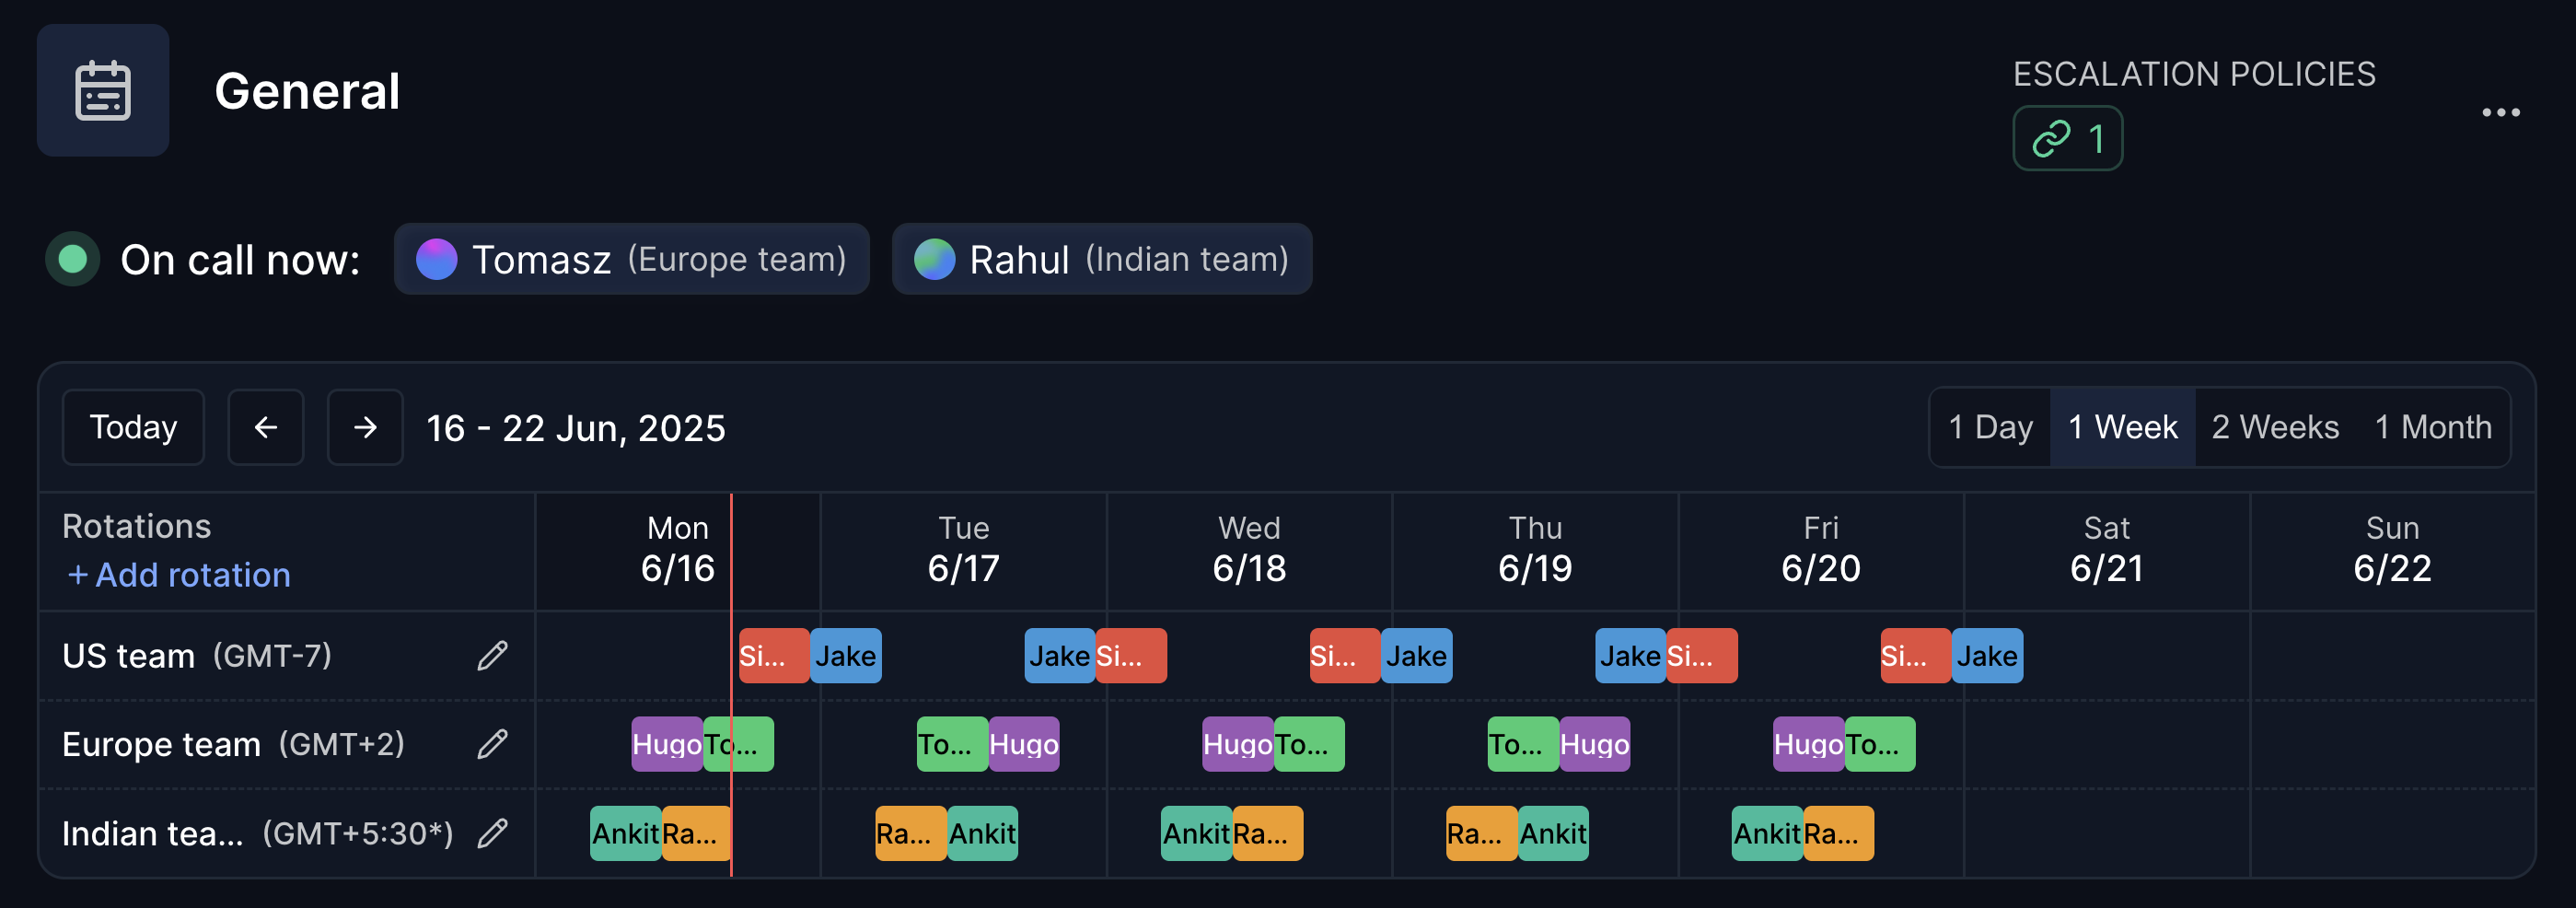
Die meisten OnCall-OSS-Installationen, die ich gesehen habe, leiten zwei Arten von Alarmen weiter: Prometheus-Regeln zu internen Metriken und Blackbox-Prüfungen, ob die Website erreichbar ist. Hyperping ersetzt die zweite Art direkt an der Quelle. HTTP-, Cron-Heartbeat-, DNS-, Port- und Playwright-Browser-Checks laufen aus 18 Regionen, und schlägt einer fehl, alarmiert die Eskalationsrichtlinie direkt die Person in Rufbereitschaft. Zwischen Prüfung und Alarm steht kein Webhook.
Wichtige Funktionen
- Bereitschaftspläne mit einer Rotation pro Team oder Zeitzone, Übergabezeit, parallelen Schichten, zeitlichen Einschränkungen und Overrides
- Eskalationsrichtlinien mit geordneten Stufen und Verzögerungen über Slack, Teams, E-Mail, SMS und Anruf, wobei eine Stufe „wer gerade Bereitschaft hat“ in einem Bereitschaftsplan adressieren kann
- Gruppierte Alarme, damit ein gemeinsamer Ausfall einen einzigen Alarm auslöst statt einen pro Monitor
- Statusseiten auf Ihrer eigenen Domain mit Abonnenten sowie passwortgeschützte oder SSO-Seiten in Pro und Business
- Terraform-Provider, REST-API und ein Prometheus-Exporter, damit Uptime und Antwortzeiten weiterhin in Ihren Grafana-Dashboards landen
- Ausgehende Integrationen zu PagerDuty und Opsgenie, falls ein Teil des Teams während der Umstellung bei einem anderen Pager bleibt
Preise
Preise von der Preisseite von Hyperping, bei jährlicher Zahlung, der Monatspreis in Klammern:
- Free: 20 Monitore, Prüfungen alle 5 Minuten, 1 Statusseite, keine Rufbereitschaft
- Essentials: 24 €/Monat (29 € monatlich), 3 Nutzerplätze inklusive, dann 7 € pro Platz, 1 Bereitschaftsplan, 20 SMS pro Monat
- Pro: 74 €/Monat (89 € monatlich), 10 Nutzerplätze inklusive, dann 9 € pro Platz, 3 Bereitschaftspläne, 75 SMS, Browser-Checks
- Business: 249 €/Monat (299 € monatlich), 20 Nutzerplätze inklusive, dann 12 € pro Platz, 200 SMS, White-Label und SAML als Add-ons
Ein Team von 10 Personen passt in die 10 inklusiven Plätze von Pro und zahlt 74 €/Monat, Monitoring und Statusseite inklusive.
Zu bedenken
- Keine eingehende Alarm-Integration. Hyperping empfängt keine Webhooks von Alertmanager oder Grafana Alerting. Wenn Ihre Prometheus-Regeln weiter Personen alarmieren müssen, übernimmt Hyperping die externen Prüfungen und Sie behalten für die internen einen Pager, der Webhooks annimmt, oder Sie wählen eines der Tools unten.
- Slack für Benachrichtigungen, kein in Slack integrierter Incident-Lebenszyklus. Quittieren und Eskalieren funktionieren aus Slack heraus, aber es gibt keine Automatisierung von Incident-Channels und keinen Post-Mortem-Generator.
- Kleinerer Integrationskatalog als bei PagerDuty: Slack, Teams, Discord, Google Chat, Telegram, E-Mail, SMS, Telefon, Webhooks, PagerDuty, Opsgenie, Twilio und Intercom.
- Keine eigene Mobile-App. Alarme kommen per SMS, Anruf, Slack oder Teams auf Ihr Smartphone.
Wählen Sie Hyperping, wenn Sie nicht mehr drei Tools (Prüfungen, Pager, Statusseite) betreiben wollen und Ihre Alarme eher durch Ausfälle als durch Metrik-Schwellenwerte ausgelöst werden. Kostenlos testen mit 20 Monitoren.
2. PagerDuty: Enterprise-Routing mit dem größten Integrationskatalog
Ideal für: Organisationen mit mehr als 50 Entwicklern, die ein Anbieter-SLA, AIOps und über 750 Integrationen brauchen und pro Nutzer zahlen können.
PagerDuty ist das, was die meisten OnCall-OSS-Installationen aus Kostengründen vermieden haben. Es ist aber auch das Tool mit der vollständigsten Antwort auf die Frage „Lässt es sich mit X integrieren?“: Alertmanager, Grafana Alerting, Datadog, CloudWatch und 750 weitere liefern Events ein, und Event Orchestration dedupliziert und routet sie, bevor jemand alarmiert wird.
Wichtige Funktionen
- Bereitschaftspläne, Eskalationsrichtlinien, Overrides und Round-Robin-Routing
- Event Orchestration und AIOps für Deduplizierung und weniger Alarmrauschen (Stufen der PD Reliability Platform)
- Runbook-Automatisierung und Incident-Workflows
- Mobile-App mit Push, SMS und Anruf, die Nutzern eines selbst gehosteten OnCall vertraut vorkommen wird
- Terraform-Provider
Preise
Laut Preisseite von PagerDuty:
- Free: bis zu 5 Nutzer, 1 Bereitschaftsplan, 1 Eskalationsrichtlinie, 100 SMS- und Telefonbenachrichtigungen pro Monat
- Professional: 21 $/Nutzer/Monat bei jährlicher Zahlung (25 $ monatlich)
- PD Reliability Platform, jährlich im Voraus abgerechnet: Starter 2.800 $ (10 Plätze), Essential 12.000 $ (20 Plätze), Plus 48.000 $ (50 Plätze), Ultimate auf Anfrage (500 Plätze), mit AIOps und Automatisierung
Zehn Entwickler in Professional kosten 210 $/Monat, und Statuspage sowie synthetisches Monitoring sind separate Produkte.
Zu bedenken
- Der Preis pro Nutzer liegt für ein kleines Team beim 5- bis 10-Fachen der Plattformgebühr von Grafana Cloud IRM, noch vor AIOps.
- Der einzige Bereitschaftsplan und die einzige Eskalationsrichtlinie der kostenlosen Stufe reichen höchstens für ein Team.
- Kein eingebautes Monitoring und keine Statusseite ohne Statuspage.
Wählen Sie PagerDuty, wenn Sie OnCall OSS verlassen, weil ein Audit oder der Einkauf einen Anbieter mit Support verlangt, und die Breite der Integrationen wichtiger ist als der Preis. Eine ausführlichere Übersicht finden Sie in unserem Leitfaden zu PagerDuty-Alternativen.
3. incident.io: Incident Response direkt in Slack, mit Rufbereitschaft dazu
Ideal für: Teams, die Incidents in Slack abwickeln und Bereitschaftsrotation, Incident-Channel und Post-Mortem im selben Produkt wollen.
Die Slack-Integration war die beste Funktion von OnCall. incident.io geht noch weiter: Alarm, Incident-Channel, Rollen, Update der Statusseite und das von KI entworfene Post-Mortem laufen alle aus Slack oder Teams heraus, und On-Call wird als Add-on pro Nutzer verkauft.
Wichtige Funktionen
- Bereitschaftspläne, Eskalationspfade und Overrides, verwaltet aus Slack
- Alarmeingang aus Alertmanager, Grafana, Datadog und per Webhook
- Incident-Channels, Rollen, Timelines und KI-generierte Post-Mortems
- Statusseiten, im Team-Tarif eingeschränkt
- Mobile-App mit Push, SMS und Anruf
Preise
Laut Preisseite von incident.io:
- Basic: kostenlos, Rufbereitschaft für ein einzelnes Team und eine Statusseite
- Team: 15 $/Nutzer/Monat bei jährlicher Zahlung (19 $ monatlich) plus 10 $/Nutzer/Monat für On-Call
- Pro: 25 $/Nutzer/Monat plus 20 $/Nutzer/Monat für On-Call
- Nur On-Call: 20 $/Nutzer/Monat
- Enterprise: auf Anfrage
Zehn Personen im Team-Tarif mit On-Call kosten 250 $/Monat, nur On-Call 200 $/Monat.
Zu bedenken
- Zwei Zähler pro Nutzer addieren sich: der Platz für Incident Response und der Platz für On-Call.
- Ohne Slack oder Teams geht der Großteil des Nutzens verloren.
- Keine Uptime-Prüfungen. Die Erkennung bleibt bei Grafana oder anderswo.
Wählen Sie incident.io, wenn Ihr Engpass nach dem Alarm die Koordination ist, nicht die Erkennung, und Ihr Team in Slack lebt. Unser Leitfaden zu incident.io-Alternativen geht ausführlich auf die Abwägungen ein.
4. Rootly: KI-zentrierte Incident Response und Rufbereitschaft für den Mittelstand
Ideal für: schnell wachsende Teams von 30 bis 300 Personen, die Workflow-Automatisierung über Jira, GitHub und Zoom hinweg wollen und ein separates On-Call-Modul mit Preis pro Nutzer.
Rootly verkauft Incident Response und On-Call als getrennte Produkte zum gleichen Preis pro Nutzer. Das On-Call-Modul hat die Bausteine, die ein Nutzer von OnCall OSS erwartet (Bereitschaftspläne, Eskalationsrichtlinien, Gruppierung und Routing von Alarmen), plus solche, die OnCall nie hatte, etwa Shadow-Rotationen, Urlaubsverwaltung, Erkennung von Lücken im Bereitschaftsplan und einen Rechner für die Bereitschaftsvergütung.
Wichtige Funktionen
- Gruppierung und Routing von Alarmen mit Live Call Routing
- Bereitschaftspläne mit Shadow-Rotationen, Urlaubsverwaltung und Lückenerkennung
- Incident-Lebenszyklus direkt in Slack und Teams mit KI-Protokollant und Retrospektiven
- Statusseite in Incident Response Essentials enthalten
- Alarmeingang aus Alertmanager, Grafana, Datadog und per Webhook
Preise
Laut Preisseite von Rootly:
- On-Call Essentials: 20 $/Nutzer/Monat
- Incident Response Essentials: 20 $/Nutzer/Monat
- Enterprise für beide: auf Anfrage
- Startup-Programm: bis zu 50 % Rabatt unter 100 Beschäftigten, „zahlen Sie, was Sie können“ unter 25
Zehn Entwickler in On-Call Essentials kosten 200 $/Monat, mit Incident Response dazu 400 $/Monat.
Zu bedenken
- Keine kostenlose Stufe, und wer beide Module will, zahlt pro Nutzer das Doppelte.
- Eine Konfigurationstiefe, die ein Team von 5 Personen nicht ausschöpfen wird.
- Keine Uptime-Prüfungen.
Wählen Sie Rootly, wenn Sie tiefere Workflow-Automatisierung als bei incident.io wollen und ein Rotationsmodell mit eingebauten Shadows und Urlaubsverwaltung. Den direkten Vergleich finden Sie in unserem Leitfaden zu Rootly-Alternativen.
5. GoAlert: der Open-Source-Ersatz zum Selbsthosten
Ideal für: Teams, die OnCall OSS wegen Self-Hosting und Datenresidenz gewählt haben und jemanden haben, der einen weiteren Dienst betreibt.
GoAlert wird von Target unter der Apache-2.0-Lizenz gepflegt. Es deckt den Kern dessen ab, was OnCall OSS konnte: Rotationen und Bereitschaftspläne, Eskalationsrichtlinien, Alarme per E-Mail, SMS und Anruf über Ihr eigenes Twilio-Konto, Slack-Benachrichtigungen, generische Webhooks und eine Integration für Prometheus Alertmanager. Es läuft als einzelnes Go-Binary auf PostgreSQL, was schlanker ist als der Stack aus Django, Celery, Redis und MySQL von OnCall.
Wichtige Funktionen
- Bereitschaftspläne, Rotationen und temporäre Overrides
- Eskalationsrichtlinien mit Wiederholungsstufen
- Integrationen für Alertmanager, Grafana, generische Webhooks und E-Mail
- SMS und Anrufe über Twilio, Benachrichtigungen in Slack-Channels
- Kalenderabonnements und API-Schlüssel
Preise
Kostenlos. Sie zahlen für einen Server, PostgreSQL und die Nutzung von Twilio.
Zu bedenken
- Release-Rhythmus. Die neueste Version, v0.35.0, stammt vom September 2026, nach v0.34.1 im Oktober 2025, v0.34.0 im August 2025 und v0.33.0 im November 2024 (Release-Historie). Das Projekt lebt, bewegt sich aber langsam, und Sie sollten das Commit-Log lesen, bevor Sie Ihre Alarmierung darauf verwetten.
- Keine Mobile-App. Alarme kommen per SMS, Anruf, E-Mail oder Slack.
- Kein Incident-Management, keine Statusseite, kein Grafana-spezifischer Kontext im Alarm.
- Andere Open-Source-Tools decken benachbarte Aufgaben ab, aber keine Bereitschaftsplanung: Keep übernimmt die Bündelung von Alarmen, Uptime Kuma die Prüfungen, Zabbix das Infrastruktur-Monitoring mit einfachen Eskalationen.
Wählen Sie GoAlert, wenn Self-Hosting eine harte Anforderung ist und Slack plus Twilio als Kanäle reichen. Lautet die Anforderung „Open Source“ statt „selbst gehostet“, wägen Sie ab, ob ein langsames Projekt besser ist als ein gehostetes, das Sie wieder verlassen können.
Grafana OnCall vs. PagerDuty: Was nach der Archivierung?
Nach diesem Vergleich wird am häufigsten gesucht, deshalb bekommt er hier einen eigenen Abschnitt. Der Vergleich, der heute zählt, ist Grafana Cloud IRM gegen PagerDuty, denn OSS kommt für neue Installationen nicht mehr in Frage.
| Grafana Cloud IRM | PagerDuty Professional | |
|---|---|---|
| Preis, 10 Entwickler in der Rotation | 159 $/Monat | 210 $/Monat jährlich |
| Preis, 25 Entwickler | 459 $/Monat | 525 $/Monat jährlich |
| Alarmquellen | Grafana Alerting nativ, dazu Webhooks | Über 750 Integrationen |
| Weniger Alarmrauschen | Routen und Gruppierung | Event Orchestration, AIOps in den Plattformstufen |
| Incident-Management | Enthalten (frühere App Incident) | Enthalten, Runbook-Automatisierung extra |
| Self-Hosting möglich | Nein | Nein |
| Uptime-Prüfungen, Statusseite | Nein, nein | Nein, Statuspage als Add-on |
| Support des Anbieters | E-Mail 8x5 in Pro | 24x7 ab Business |
Wählen Sie Grafana Cloud IRM, wenn Ihre Alarme aus Grafana kommen und Sie das Dashboard im Alarm sehen wollen. Wählen Sie PagerDuty, wenn Sie Alarmquellen außerhalb von Grafana haben, AIOps brauchen oder einen Supportvertrag, den ein Konzern unterschreibt. Wählen Sie keines von beiden, wenn Sie bisher vor allem wegen „die Website ist down“ alarmiert haben, denn dafür brauchen beide weiterhin ein separates Monitoring-Tool.
Migrationstabelle: wohin jedes Grafana-OnCall-Objekt wandert
Jedes Objekt aus OnCall OSS hat irgendwo eine Entsprechung, aber nicht immer dort, wo Sie sie erwarten. Erst exportieren, dann zuordnen.
| Grafana OnCall OSS | Grafana Cloud IRM | Hyperping | PagerDuty | incident.io | Rootly | GoAlert |
|---|---|---|---|---|---|---|
| Integration (Alertmanager, Grafana Alerting, Webhook) | Integration, gleiches URL-Schema | Keine Entsprechung: durch Hyperping-Monitore für externe Prüfungen ersetzen | Service mit Integration Key | Alert Source | Alert Source | Integration Key pro Service |
| Route (Regex auf die Payload, um eine Kette zu wählen) | Route | Zuordnung von Monitor zu Eskalationsrichtlinie | Event-Orchestration-Regel | Alert Route | Alert-Routing-Regel | Nicht verfügbar, eine Richtlinie pro Service |
| Eskalationskette | Eskalationskette | Eskalationsrichtlinie mit zeitgesteuerten Stufen | Escalation Policy | Escalation Path | Escalation Policy | Escalation Policy mit Wiederholung |
| Bereitschaftsplan (Web oder iCal) | Bereitschaftsplan | Bereitschaftsplan mit einer Rotation pro Team | Schedule mit Layers | Schedule | Schedule | Schedule mit Rotationen |
| Schicht-Override | Override | Override auf der Rotation | Override | Override | Override | Temporärer Bereitschaftsplan |
| Benachrichtigungsregeln der Nutzer | Notification Policy | Kanalwahl pro Stufe in der Richtlinie | Contact Methods und Regeln | Notification Preferences | Notification Rules | Contact Methods |
| ChatOps in Slack und Teams | Dieselben Apps | Benachrichtigungen in Slack und Teams, Quittieren aus Slack | Apps für Slack und Teams | Nativ in Slack und Teams | Nativ in Slack und Teams | Slack-Benachrichtigungen |
| Mobiler Push | Mobile-App von IRM | SMS und Anruf, keine eigene App | PagerDuty-App | incident.io-App | Rootly-App | Nur SMS und Anruf |
| Ausgehende Webhooks | Ausgehende Webhooks | Webhook-Integration | Webhooks v3 | Workflows | Workflows | Webhooks |
| Terraform (Grafana-Provider) | Derselbe Provider | Terraform-Provider von Hyperping | PagerDuty-Provider | incident.io-Provider | Rootly-Provider | Nicht verfügbar |
Exportieren Sie Ihre Konfiguration, bevor Sie anfangen
Die API von OnCall OSS läuft auf Ihrer Instanz weiter. Erzeugen Sie in den Einstellungen des OnCall-Plugins ein Token, notieren Sie die auf derselben Seite angezeigte Engine-URL und ziehen Sie jeden Objekttyp als JSON herunter. Bewahren Sie diese Dateien auf, egal welches Ziel Sie wählen.
export ONCALL_URL="https://oncall.example.com"   # die Engine-URL von OnCall, nicht die Grafana-URL
export ONCALL_TOKEN="your-oncall-api-token"

for resource in integrations routes escalation_chains escalation_policies schedules on_call_shifts users; do
  curl -s -H "Authorization: $ONCALL_TOKEN" \
    "$ONCALL_URL/api/v1/$resource/?perpage=100" \
    > "oncall-$resource.json"
done
Ist das Ziel Grafana Cloud IRM, führen Sie den Migrator irm-tooling mit diesen Zugangsdaten zuerst im Plan-Modus aus, bevor Sie in den Migrate-Modus wechseln, und rechnen Sie damit, vorher Nutzer einzuladen und Teams von Hand anzulegen. Für jedes andere Ziel ist das JSON Ihr Inventar: Zählen Sie die Integrationen, listen Sie die Ketten auf und bauen Sie sie im Terraform-Provider des neuen Tools nach, sofern es einen gibt.
Drei Dinge, die die Tabelle nicht löst
- Alertmanager-Regeln, die Personen alarmieren. Nur Grafana Cloud IRM, PagerDuty, incident.io, Rootly und GoAlert nehmen den Webhook an. Wenn Sie zu Hyperping wechseln, entscheiden Sie, welche Regeln zu Hyperping-Prüfungen werden und welche bei einem Pager bleiben, der Webhooks annimmt.
- Alarm-Historie. Kein Migrator überträgt sie. Exportieren Sie, was Sie für Post-Mortems brauchen, bevor Sie die Instanz abschalten.
- Telefonnummern. OSS-Nutzer mit Cloud Connection haben ihre Nummern nie bei einem Drittanbieter hinterlegt. Jede alarmierte Person muss im neuen Tool erneut eine verifizierte Nummer eintragen, und genau dieser Schritt wird gern übersprungen, bis der erste Alarm ins Leere geht.
So ersetzen Sie Grafana OnCall durch Hyperping
Mit dem folgenden Ablauf zieht ein Team in etwa zwei Wochen von OnCall OSS um, den Großteil davon im Parallelbetrieb.
1. OnCall-Konfiguration exportieren
Führen Sie das Export-Skript oben aus und öffnen Sie die Dateien mit den Bereitschaftsplänen und Eskalationsketten. Notieren Sie für jede Kette die Stufen, die Verzögerungen und die Bereitschaftspläne, auf die sie verweist. Das ist die Spezifikation für den Rest der Migration.
2. Monitore anlegen, die Ihre externen Prüfungen ersetzen
Legen Sie in Hyperping einen Monitor pro Endpunkt an, den Grafana Alerting von außen überwacht hat: HTTP-Prüfungen mit Keyword- oder Statuscode-Assertions, SSL-Ablauf, Cron-Heartbeats für geplante Jobs und Playwright-Browser-Checks für Login- und Checkout-Abläufe. Legen Sie das Intervall (30 Sekunden in Essentials und Pro) und die Regionen fest.
3. Bereitschaftspläne neu anlegen
Öffnen Sie On-Call in der Seitenleiste und legen Sie für jeden Plan aus OnCall einen Bereitschaftsplan an. Fügen Sie eine Rotation pro Team oder Zeitzone hinzu, wählen Sie Rotationstyp, Übergabezeit und Reihenfolge der Rotation, und prüfen Sie, ob die Kalendervorschau dem exportierten OnCall-Bereitschaftsplan entspricht. Overrides werden pro Rotation verwaltet, getauschte Schichten erfordern also keinen Neuaufbau des Bereitschaftsplans.
4. Eskalationsketten als Eskalationsrichtlinien nachbauen
Gehen Sie zu Escalation Policies und legen Sie eine Richtlinie pro Kette an. Stufe 1 mit 0 Minuten Verzögerung an Slack oder Teams, Stufe 2 nach 5 Minuten per SMS an den Bereitschaftsplan, Stufe 3 nach weiteren 10 Minuten per Anruf an den Bereitschaftsplan und die Teamleitung. Weisen Sie die Richtlinie den Monitoren aus Schritt 2 zu und aktivieren Sie gruppierte Alarme, damit ein gemeinsamer Ausfall nur einmal alarmiert.
5. Slack, Teams, SMS und Telefon verbinden
Fügen Sie die Integration für Slack oder Teams hinzu und bitten Sie dann jede alarmierte Person, in ihren Kontoeinstellungen eine Telefonnummer hinzuzufügen und zu verifizieren. Bleibt ein Teil des Teams während der Umstellung bei PagerDuty oder Opsgenie, fügen Sie die Integration für PagerDuty oder Opsgenie hinzu, damit Hyperping-Incidents auch dort ankommen.
6. Beide Tools zwei Wochen parallel betreiben
Lassen Sie OnCall OSS die Grafana-Alarme weiter an Slack leiten. Lassen Sie Hyperping für die externen Prüfungen die Person in Rufbereitschaft alarmieren. Vergleichen Sie beide: Zeit bis zur ersten Benachrichtigung, Zeit bis zur Quittierung und welche Alarme Hyperping ausgelöst hat, die OnCall nicht ausgelöst hat, oder umgekehrt. Spielen Sie mindestens einmal einen Test-Incident durch jede Eskalationsstufe durch.
7. Umstellen und archivieren
Passen Sie die Runbooks so an, dass sie auf Hyperping verweisen, deaktivieren Sie die Eskalationsketten in OnCall, damit von dort nichts mehr alarmiert, und bewahren Sie die JSON-Exporte auf. Wenn Prometheus-Regeln weiterhin jemanden alarmieren sollen, lassen Sie diesen Weg über ein Tool laufen, das Webhooks annimmt, und überlassen Sie Hyperping die externen Prüfungen und die Statusseite.
Entscheidungshilfe
- Bereits auf Grafana Cloud, Alarme kommen aus Grafana Alerting: Grafana Cloud IRM. Lassen Sie den Migrator zuerst im Plan-Modus laufen.
- Self-Hosting ist nicht verhandelbar: GoAlert, mit Twilio für SMS und Anrufe.
- Unter 50 Personen, die meisten Alarme lauten „ist down“: Hyperping, und schaffen Sie bei der Gelegenheit gleich das separate Uptime-Tool und die Statusseite ab.
- Incidents laufen in Slack und das Post-Mortem ist der Schmerzpunkt: incident.io, oder Rootly, wenn Sie tiefere Workflow-Automatisierung wollen.
- Der Einkauf will einen Anbieter mit SLA und 750 Integrationen: PagerDuty.
Egal, wofür Sie sich entscheiden: Machen Sie den Export diese Woche. Die archivierte Instanz läuft weiter, aber ihr fehlt nur eine ungepatchte CVE, um selbst zum Incident zu werden.
Weiterlesen
- Die 10 besten Tools für Bereitschaftsplanung im Vergleich für die ganze Kategorie
- Opsgenie wird eingestellt: Leitfaden zu den Alternativen, falls Sie auch Atlassian verlassen
- Leitfaden zu Eskalationsrichtlinien für die Gestaltung von Stufen und Verzögerungen
- Bereitschaftsplanung für kleine Teams, wenn Ihre Rotation 2 oder 3 Personen umfasst
Weiter vergleichen: Hyperping vs. PagerDuty · Hyperping vs. Opsgenie · Preise von Hyperping · Alle Vergleiche
Häufige Fragen
Wird Grafana OnCall eingestellt? ▼
Die Open-Source-Version ja. Grafana OnCall OSS ging am 11. März 2025 in den Wartungsmodus, und die Entwicklung endete am 24. März 2026 mit der Archivierung des Repositorys. Es liegt jetzt schreibgeschützt in Grafanas Organisation grafana-cold-storage auf GitHub. Eine selbst gehostete Instanz läuft weiter, bekommt aber keine Updates mehr, und die Cloud Connection, die SMS, Anrufe und mobile Push-Benachrichtigungen zugestellt hat, wurde am Tag der Archivierung abgeschaltet. Das gehostete Produkt lebt als Grafana Cloud IRM weiter.
Was ist die beste Alternative zu Grafana OnCall? ▼
Grafana Cloud IRM, wenn Sie möglichst wenig ändern wollen und Grafana Cloud ohnehin bezahlen. Hyperping, wenn Sie Rufbereitschaft, Uptime-Monitoring und Statusseiten in einem Tarif zum Festpreis wollen. PagerDuty für Alarmierung auf Enterprise-Niveau mit über 750 Integrationen. incident.io oder Rootly für Incident Response direkt in Slack. GoAlert, wenn Sie bei Open Source und Self-Hosting bleiben müssen.
Gibt es eine Open-Source-Alternative zu Grafana OnCall? ▼
GoAlert, von Target unter der Apache-2.0-Lizenz gepflegt, ist die nächstliegende, die es noch gibt: Bereitschaftspläne, Rotationen, Eskalationsrichtlinien, Webhooks von Alertmanager und Grafana, SMS und Anrufe über Twilio. Die neueste Version ist v0.35.0 (September 2026), nach v0.34.1 im Oktober 2025. Planen Sie also ein, das Tool selbst zu betreiben. Keep, Zabbix und ein selbst gehostetes Uptime Kuma decken Teile der Aufgabe ab, aber keine Bereitschaftsplanung.
Was kostet Grafana Cloud IRM? ▼
Laut grafana.com im September 2026 erlaubt die kostenlose Stufe 3 aktive IRM-Nutzer pro Monat. Die Pro-Stufe kostet eine Plattformgebühr von 19 $/Monat, in der 3 aktive IRM-Nutzer enthalten sind, dann 20 $ pro weiterem aktivem IRM-Nutzer, mit Mengenrabatten. Enterprise beginnt bei einer jährlichen Mindestabnahme von 25.000 $. Als aktiver IRM-Nutzer zählt, wer im Laufe des Monats in einem Bereitschaftsplan oder einer Eskalationskette steht oder Incidents quittiert, auslöst oder bearbeitet.
Grafana OnCall vs. PagerDuty: Was soll ich wählen? ▼
Wählen Sie PagerDuty, wenn Sie einen Anbieter mit SLA, über 750 Integrationen, AIOps und einer ausgereiften Mobile-App brauchen und 21 $ pro Nutzer und Monat für Professional zahlen können, für AIOps dann zusätzlich eine jährlich im Voraus abgerechnete Gebühr für die PD Reliability Platform ab 2.800 $ für 10 Plätze. Wählen Sie Grafana Cloud IRM, wenn Ihre Alarme bereits aus Grafana Alerting kommen und Sie den Dashboard-Kontext direkt im Alarm sehen wollen, für 20 $ pro aktivem Nutzer. Keines der beiden enthält Uptime-Prüfungen oder eine öffentliche Statusseite.
Kann ich meine Bereitschaftspläne und Eskalationsketten aus Grafana OnCall OSS automatisch migrieren? ▼
Teilweise. Der Migrator irm-tooling von Grafana akzeptiert OnCall OSS als Quelle und kopiert Eskalationsketten, Bereitschaftspläne, Integrationen, Routen und Benachrichtigungsregeln nach Grafana Cloud IRM, legt aber keine Nutzer oder Teams an, und Grafanas eigene Migrationsseite für OSS verweist weiterhin auf Terraform oder die API. Für jedes andere Ziel exportieren Sie die Objekte über die OnCall-API und bauen sie im neuen Tool nach, am besten als Code.