En 2026, les meilleures alternatives à incident.io sont Rootly pour une réponse native Slack pensée autour de l’IA avec une automatisation des workflows plus poussée, FireHydrant pour des runbooks d’entreprise matures, Hyperping pour le monitoring, l’astreinte et les pages de statut à prix fixe, PagerDuty pour un alerting d’entreprise très complet, Squadcast pour les équipes DevOps au budget serré, et Better Stack pour réunir monitoring, logs et incidents.
J’ai analysé plus de 25 outils, relevé les tendances des fils r/sre, r/devops et r/incidentio où des ingénieurs comparent incident.io à Rootly, FireHydrant et PagerDuty, et comparé les prix réels pour des tailles d’équipe courantes. incident.io est un bon produit. La plupart des équipes qui cherchent une alternative n’en sont pas mécontentes en tant qu’outil : elles veulent un autre compromis. Plus de souplesse, moins de dépendance à Slack, une couverture plus large que la réponse dans le chat, ou un outil qui ne leur réserve pas de surprise avec le minimum du forfait Pro.
Dans ce guide, vous trouverez :
- Pourquoi les équipes étudient vraiment des alternatives à incident.io (c’est rarement parce qu’« incident.io est mauvais »)
- Les six outils que je recommanderais, avec des prix honnêtes et les vrais compromis
- Une comparaison des prix pour des tailles d’équipe courantes
- La liste complète des plus de 25 alternatives à incident.io que j’ai étudiées
Si vous voulez un monitoring qui repère les problèmes en 30 secondes, des plannings d’astreinte avec des escalades intelligentes et des pages de statut que vos clients consultent vraiment, le tout à prix mensuel fixe avec des sièges inclus et des sièges supplémentaires payants, essayez Hyperping gratuitement.
Points clés
- Rootly est l’alternative la plus directe si vous voulez une réponse dans le chat avec des workflows plus poussés. À partir de ~20 $/utilisateur/mois pour Incident Response Essentials, avec des paliers par utilisateur distincts pour On-Call et AI SRE.
- FireHydrant est le plus proche pour les équipes qui veulent des runbooks matures et un vrai catalogue de services. Gratuit jusqu’à 10 intervenants, puis Pro à 25 $/intervenant/mois en facturation annuelle ; l’IA et les pages de statut privées sont réservées à Enterprise.
- Hyperping offre le meilleur rapport qualité-prix si votre goulot d’étranglement est la détection, l’astreinte et les pages de statut plutôt que la réponse dans le chat. 24 €/mois à prix fixe, sièges inclus et sièges supplémentaires facturés à part.
- PagerDuty est l’acteur historique, avec le moteur d’alerting le plus complet et plus de 700 intégrations. 21 $/utilisateur/mois en Professional, puis un abonnement PD Reliability Platform payé d’avance à l’année, à partir de 2 800 $ pour 10 sièges : c’est là que se trouve l’AIOps.
- Squadcast (désormais SolarWinds Incident Response) est l’option sérieuse la moins chère, avec Pro à 15 $/utilisateur/mois en facturation annuelle et un essai de 14 jours (pas de forfait gratuit).
- Better Stack réunit monitoring, logs et incidents dans une interface moderne à partir de 29 $/mois, mais les frais par intervenant et par module complémentaire peuvent vite s’additionner.
Pourquoi vous pouvez faire confiance à ce guide
Je suis Léo, fondateur d’Hyperping. Oui, j’ai un intérêt dans l’un de ces outils. Mon but n’est pas de vous convaincre qu’Hyperping est toujours la réponse. C’est rarement le cas. La gestion des incidents est une vaste catégorie, et Hyperping en couvre une partie précise : la détection, l’astreinte et les pages de statut. Pour une réponse native Slack poussée ou des post-mortems générés par IA, les outils ci-dessous conviennent mieux, et je le dis.
Pour écrire ce guide, j’ai lu des analyses produit de chaque outil, relevé des avis sur G2 et croisé mes critères avec des fils Reddit où des SRE en poste racontent ce qui marche et ce qui ne marche pas. Les principaux fils sur lesquels je me suis appuyé :
- My experience after testing both Rootly and incident.io (r/sre)
- Incident management tools comparison (r/sre)
- Anyone here using AI RCA tools like incident.io (r/sre)
- Best PagerDuty alternatives in 2026 (r/devops)
- r/incidentio
Quand je n’ai pas pu tester un outil moi-même, je l’ai dit et je me suis appuyé sur des retours d’utilisateurs vérifiés.
Les meilleurs choix en un coup d’œil
| Idéal pour | Produit |
|---|---|
| Réponse native Slack avec une automatisation des workflows plus poussée | Rootly |
| Runbooks d’entreprise matures et workflows structurés | FireHydrant |
| Monitoring + astreinte + pages de statut à prix fixe | Hyperping |
| Alerting d’entreprise complet avec le plus grand catalogue d’intégrations | PagerDuty |
| Équipes DevOps au budget serré qui ont besoin d’une astreinte solide | Squadcast |
| Monitoring, logs et incidents réunis | Better Stack |
Pourquoi les équipes cherchent des alternatives à incident.io
incident.io reçoit parmi les meilleurs avis de la catégorie. Dans les fils r/sre que j’ai lus, les équipes saluent son intégration Slack soignée, ses choix par défaut affirmés et ses post-mortems générés par IA. Quand elles étudient des alternatives, c’est en général une question d’adéquation, pas d’échec.
- Des prix moins transparents qu’il n’y paraît. Le prix d’appel, c’est le forfait Team à ~15 $/utilisateur/mois, mais la facture réelle comprend un module payant par utilisateur d’astreinte (~10 $/utilisateur/mois) et un plancher réel du forfait Pro que plusieurs fils r/incidentio situent autour de 4 000 $/an minimum. Les équipes qui ont estimé leur facture à partir du prix public par utilisateur se font surprendre.
- Des limites de personnalisation. C’est la critique qui revient le plus nettement dans le fil r/sre Rootly vs incident.io : incident.io impose sa façon de faire. Les équipes qui ont une logique conditionnelle complexe (plus de deux branches), des processus d’escalade particuliers ou des cycles de vie d’incident inhabituels se heurtent à des murs. Un utilisateur résume : « On avait l’impression qu’il avait été conçu pour le processus d’incident de quelqu’un d’autre, pas pour le nôtre. »
- La dépendance à Slack. Microsoft Teams est pris en charge, mais toujours avec des fonctionnalités en retard sur Slack. Pour les organisations dont Teams est l’outil de chat principal, une grande partie de la différence disparaît.
- L’astreinte en option. incident.io a d’abord été lancé pour la seule réponse aux incidents. L’astreinte a été greffée plus tard et reste un module payant à part. Les équipes qui veulent un seul palier couvrant les deux trouvent le calcul peu flatteur face à Rootly ou FireHydrant.
- « On a juste besoin de détection et d’astreinte. » Beaucoup d’équipes qui regardent incident.io se rendent compte qu’elles n’ont pas vraiment de problème de coordination dans le chat. Leur problème, c’est la détection et l’alerte des personnes d’astreinte, et un orchestrateur de réponse n’est pas la bonne couche.
- Des fonctions d’IA encore jeunes. Le fil r/sre sur l’analyse de cause racine par IA déborde de scepticisme pragmatique : les résumés par IA font gagner du temps sur la documentation, mais les pistes de cause racine sont trop inégales pour que les équipes s’y fient déjà.
Un thème revient souvent sur r/sre : aucun outil ne couvre à lui seul toutes les étapes du cycle de vie d’un incident. Beaucoup d’équipes associent un outil de détection (Hyperping, Datadog, Prometheus), un outil de réponse (incident.io, Rootly, FireHydrant) et une page de statut (Hyperping, Statuspage). Le but n’est pas un outil unique pour tout faire, mais le bon outil à chaque étape, avec le moins de chevauchement possible.
Pourquoi ces 6 outils ont été retenus
J’ai étudié plus de 25 outils, dont Blameless, OpsGenie, Grafana OnCall, xMatters, Zenduty, iLert, Splunk On-Call, ServiceNow, Jira Service Management, Freshservice, GoAlert, BigPanda, Spike.sh et PagerTree. Beaucoup ont été écartés pour des raisons précises :
- En fin de vie. OpsGenie ferme en avril 2027. Si vous choisissez un outil aujourd’hui, regardez ce qui le remplace, pas l’outil qui disparaît.
- Trop limités. Spike.sh, GoAlert et PagerTree conviennent aux équipes qui ont seulement besoin d’alerter quelqu’un, mais il leur manque les fonctions de cycle de vie (chronologies, post-mortems, pages de statut) qui reviennent sans cesse dans les fils r/sre.
- Des outils de service desk avant tout. Jira Service Management, ServiceNow et Freshservice sont d’abord des outils ITSM, et des outils de réponse aux incidents ensuite. Ils sont pensés pour les tickets, pas pour le problème de coordination à 2 h du matin que résout incident.io.
- Des prix opaques. Les outils qui exigent encore un appel commercial pour obtenir un chiffre (BigPanda, Moogsoft, BMC Helix) sont exclus : les évaluer à l’aveugle n’a pas de sens.
- Mieux au sein d’une autre stack. Grafana OnCall est excellent si vous utilisez déjà Grafana, même si la version open source est archivée ; le guide des alternatives à Grafana OnCall explique ce que cela change. Splunk On-Call (VictorOps) est le meilleur choix si vous utilisez déjà Splunk ; si vous le quittez, voyez les alternatives à VictorOps. Aucun des deux ne remplace incident.io à lui seul.
- Solides, mais moins prioritaires. Blameless a une vraie proposition autour des post-mortems et des pratiques SRE, mais sa dynamique et le rythme de son produit sont restés derrière les outils natifs du chat. Bon à connaître, mais pas en tête de la plupart des listes restreintes en 2026.
Chacun des six outils ci-dessous couvre un cas d’usage précis qu’incident.io couvre moins bien, ou le même cas d’usage à un autre prix.
Comparaison des fonctionnalités
| Fonctionnalité | Rootly | FireHydrant | Hyperping | PagerDuty | Squadcast | Better Stack |
|---|---|---|---|---|---|---|
| Modèle de prix | Par utilisateur (par module) | Par utilisateur (par paliers) | Prix fixe | Par utilisateur + options | Par utilisateur | Palier + par intervenant + options |
| Monitoring intégré | Non | Non | Oui | Non | Non | Oui |
| Plannings d’astreinte | Oui (module à part) | Oui | Oui | Oui | Oui | Oui |
| Workflow natif Slack | Cycle de vie complet | Cycle de vie complet | Notifications | Notifications | Notifications | Notifications |
| Prise en charge de Microsoft Teams | Complète | Complète | Notifications | Complète | Complète | Complète |
| Profondeur du moteur de workflows | Profond (low-code) | Runbooks solides | N/A | Solide (web) | Palier Premium | Limitée |
| Post-mortems par IA | Oui | Oui (Enterprise) | Non | En option | Premium | Limités |
| Pages de statut intégrées | Oui | Oui | Oui | En option (Statuspage) | Oui | Oui (frais par page) |
| Alertes par appel téléphonique | Oui | Via intégration | Oui | Oui | Oui | Oui |
| Offre gratuite | Essai seulement | Oui (10 intervenants) | Oui | Jusqu’à 5 utilisateurs | Non (essai) | Oui |
| Hébergement | US | US | UE (RGPD) | US | US | US/UE |
1. Rootly : l’alternative la plus directe à incident.io
Idéal pour
Les équipes d’ingénierie d’entreprises moyennes ou grandes en forte croissance, déjà standardisées sur Slack ou Microsoft Teams, qui veulent une réponse aux incidents pensée autour de l’IA avec une automatisation poussée sur Jira, GitHub, Zoom et le reste de la stack de développement. C’est le face-à-face avec incident.io le plus cité dans les fils r/sre.
Fonctionnalités notables
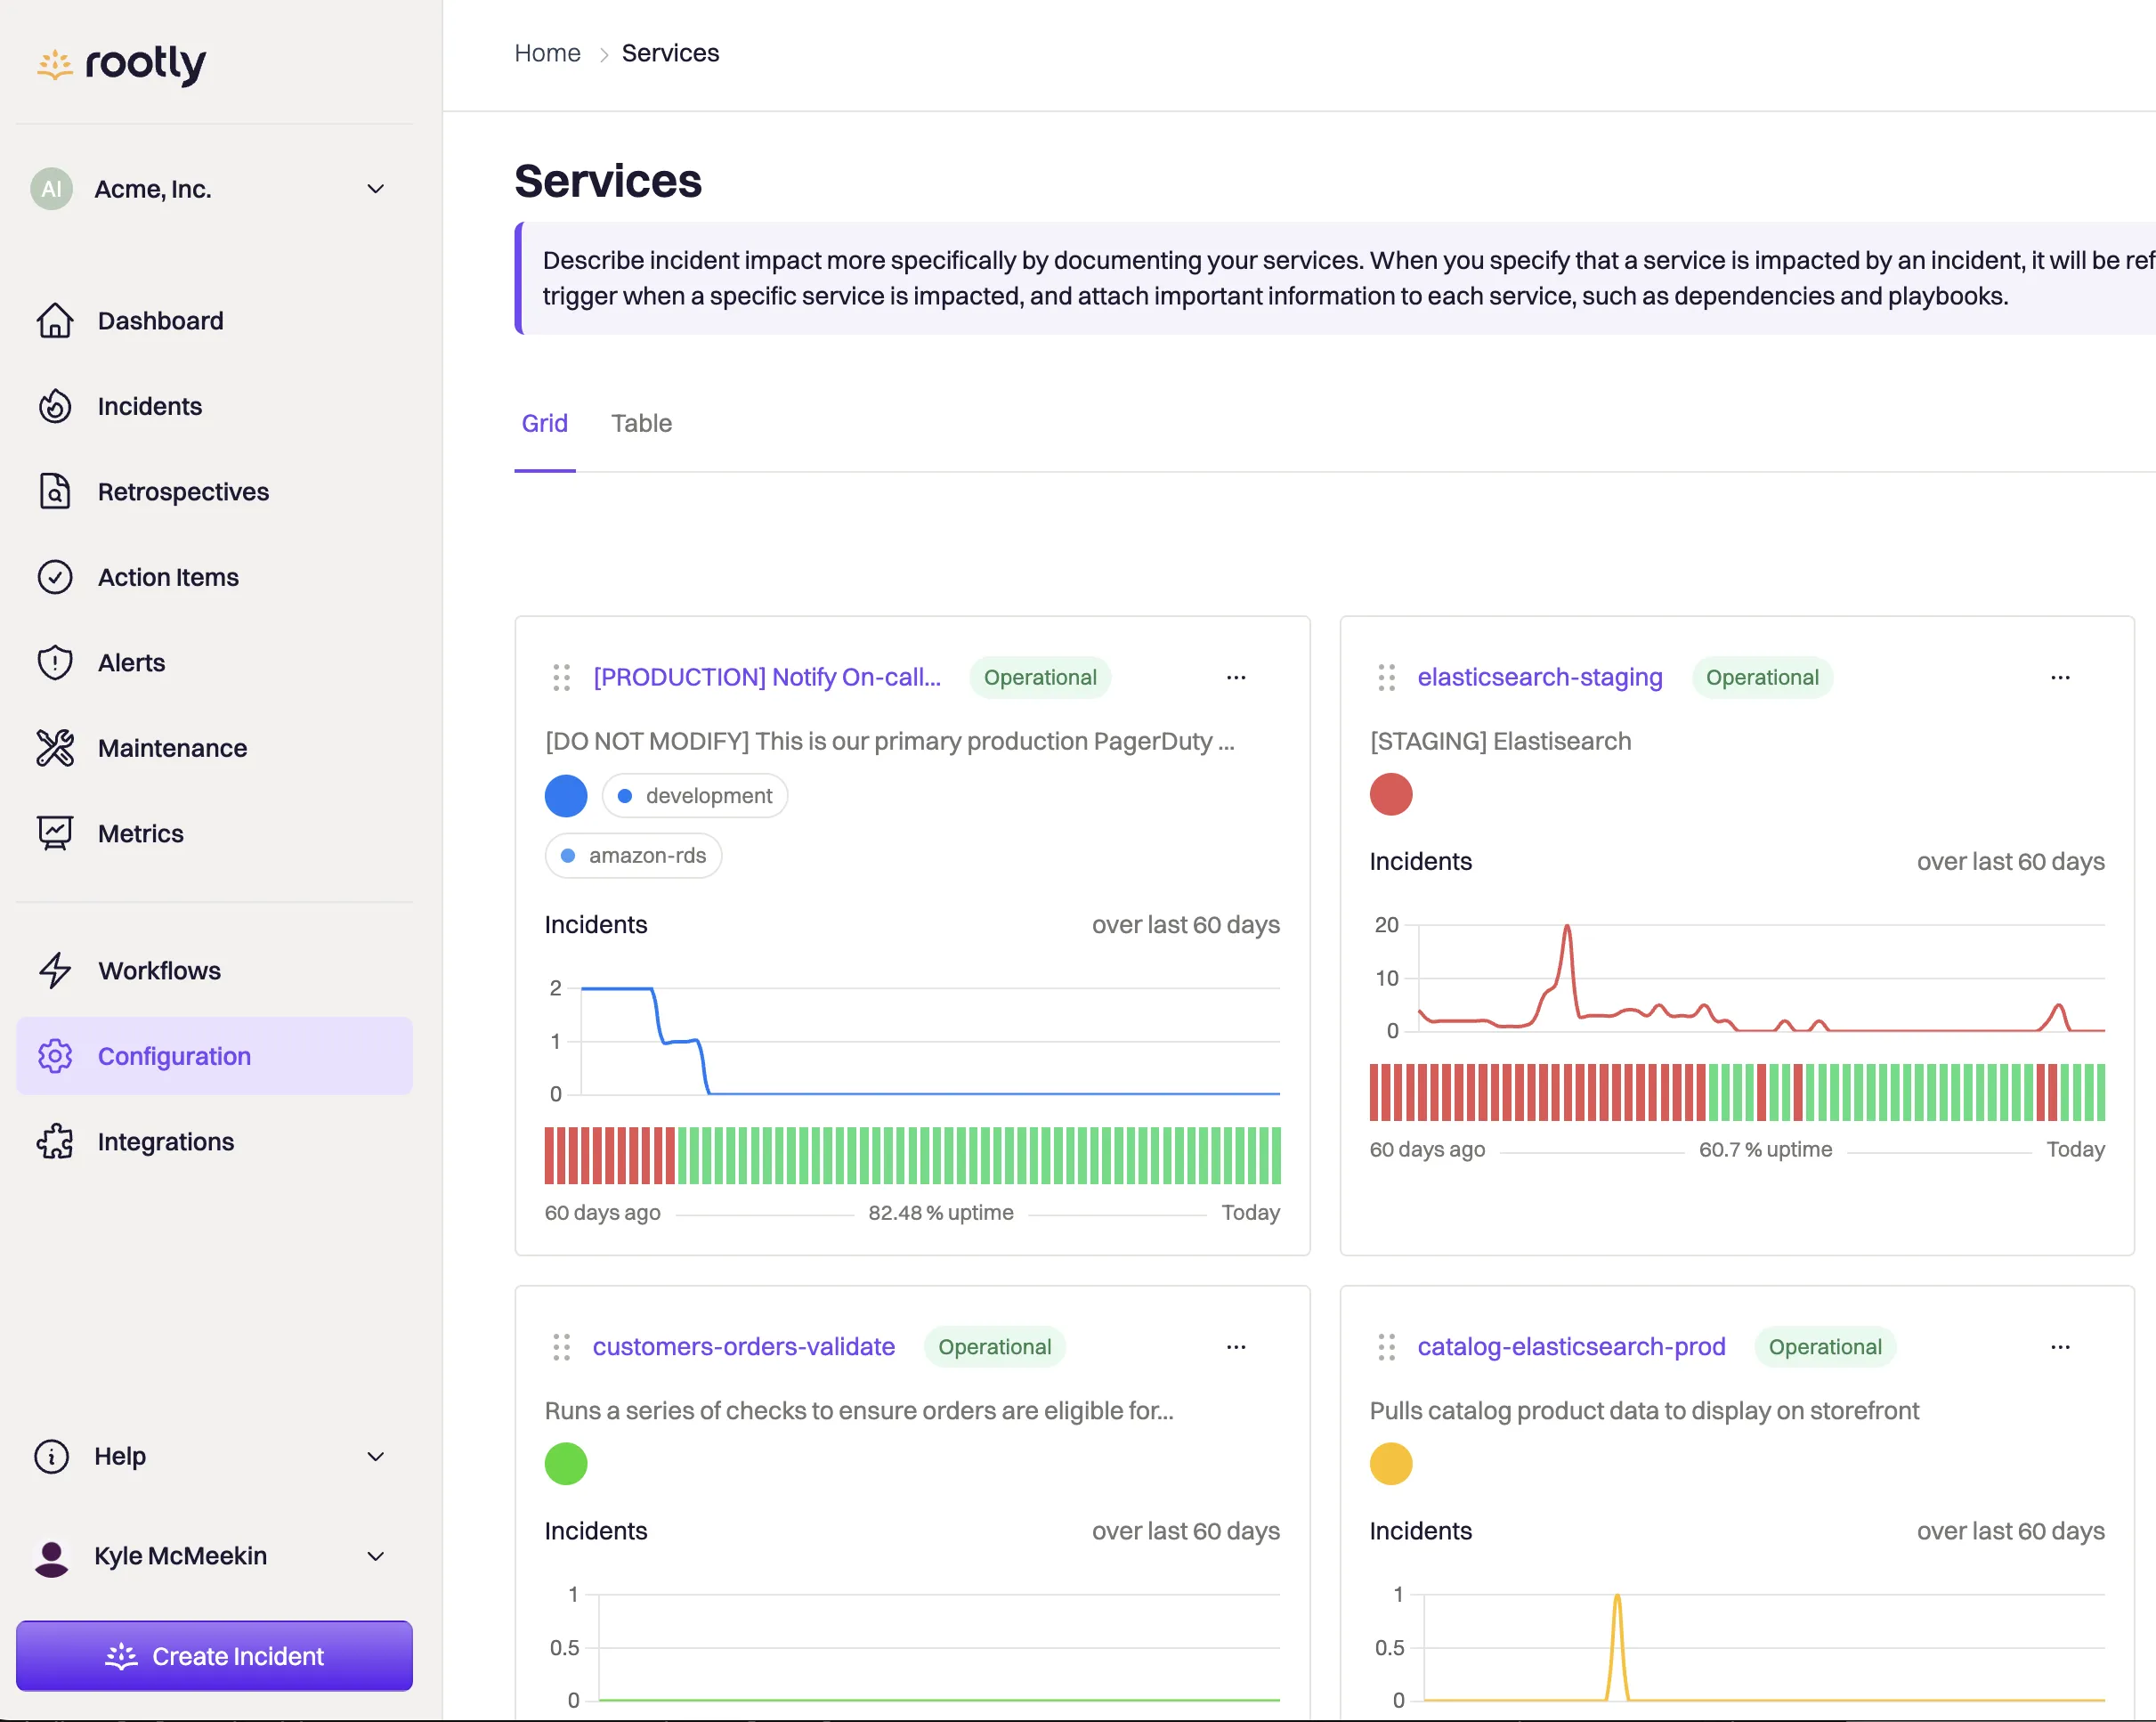
- Workflows natifs Slack et Teams. Déclarez, gérez et résolvez les incidents depuis le chat, avec création automatique des canaux, huddles et transcription.
- Moteur de workflows pour l’automatisation low-code. Construisez des flux déclenchés par les incidents à travers votre stack sans écrire de code de liaison.
- Résumés par IA, intervenants suggérés et pistes de remédiation. Pensé autour de l’IA dès le premier jour, pas ajouté après coup.
- Gestion complète de l’astreinte. Plannings, politiques d’escalade, remplacements et applications mobiles. Vendue comme un module à part, par utilisateur, et non incluse.
- Rétrospectives automatisées avec suivi du MTTR et du MTTA et attribution des tâches de suivi.
- Pages de statut, publiques et privées.
- Sécurité d’entreprise. SSO, SCIM, RBAC, journaux d’audit, SOC 2, RGPD, CCPA.
Pourquoi choisir Rootly plutôt qu’incident.io
La profondeur des workflows. C’est le contraste le plus net dans le fil r/sre Rootly vs incident.io : le constructeur de workflows low-code de Rootly va plus loin dans Jira, GitHub et le reste de la stack de développement. Les équipes qui ont une logique conditionnelle complexe, des escalades entre plusieurs équipes ou des processus particuliers se heurtent à moins de murs. incident.io impose sa façon de faire ; Rootly se configure davantage.
Pas d’outil « conçu pour le processus de quelqu’un d’autre ». Là où les utilisateurs d’incident.io se plaignent de choix par défaut qui ne correspondent pas à leur fonctionnement, ceux de Rootly apprécient de pouvoir modéliser le leur.
Des clients de grande taille. Cisco, NVIDIA, Figma, Squarespace et Canva utilisent Rootly. C’est la profondeur de configuration qui attire les grandes organisations d’ingénierie aux processus bien établis.
Les points faibles de Rootly
Le coût de la configuration. C’est le revers de la « souplesse ». Un commentateur sur r/devops qui a choisi incident.io plutôt que Rootly le décrit ainsi : « des tonnes de fonctionnalités, mais beaucoup trop de configuration pour que ça marche dans notre environnement e-commerce ». Les équipes qui veulent des bonnes pratiques intégrées d’emblée s’en sortent mieux avec incident.io.
Un coût par utilisateur qui s’additionne d’un module à l’autre. Incident Response, On-Call et AI SRE sont vendus comme des paliers distincts, chacun par utilisateur. À ~20 $/utilisateur/mois chacun, la stack complète revient vite plus cher que le forfait Pro tout compris d’incident.io.
Des limites de paliers moins transparentes. Les avis G2 notent que les plafonds exacts sur les workflows, les runbooks et les pages de statut passent en général par une discussion avec les commerciaux.
Des aspérités dans l’interface. Certains utilisateurs signalent des rechargements de page gênants et une recherche pénible sur les champs personnalisés en plein incident. Des détails, mais qui comptent à 3 h du matin.
Prix
- Incident Response Essentials : ~20 $/utilisateur/mois
- On-Call Essentials : ~20 $/utilisateur/mois
- AI SRE / Enterprise : sur devis, avec des remises quand on combine les modules
- Essai gratuit de 14 jours ; remises jusqu’à ~50 % pour les startups en phase de démarrage
Dépense annuelle typique : 15 000 à 60 000 $ selon la taille de l’équipe et le palier.
Choisissez Rootly si
Votre équipe d’ingénierie vit dans Slack ou Teams, vous avez une chaîne d’outils complexe à automatiser, et vous voulez une réponse pensée autour de l’IA, avec des workflows qui suivent vos propres processus plutôt que ceux de quelqu’un d’autre. Écartez-le si vous voulez des bonnes pratiques intégrées dès l’installation (incident.io convient mieux) ou si le budget est la contrainte décisive.
2. FireHydrant : le meilleur pour des runbooks d’entreprise matures
Idéal pour
Les équipes d’ingénierie d’entreprises moyennes ou grandes qui veulent une réponse native Slack avec des runbooks et un catalogue de services plus aboutis que ceux d’incident.io. C’est le troisième nom qui revient systématiquement à côté d’incident.io et de Rootly dans les fils r/sre de comparaison.
Fonctionnalités notables
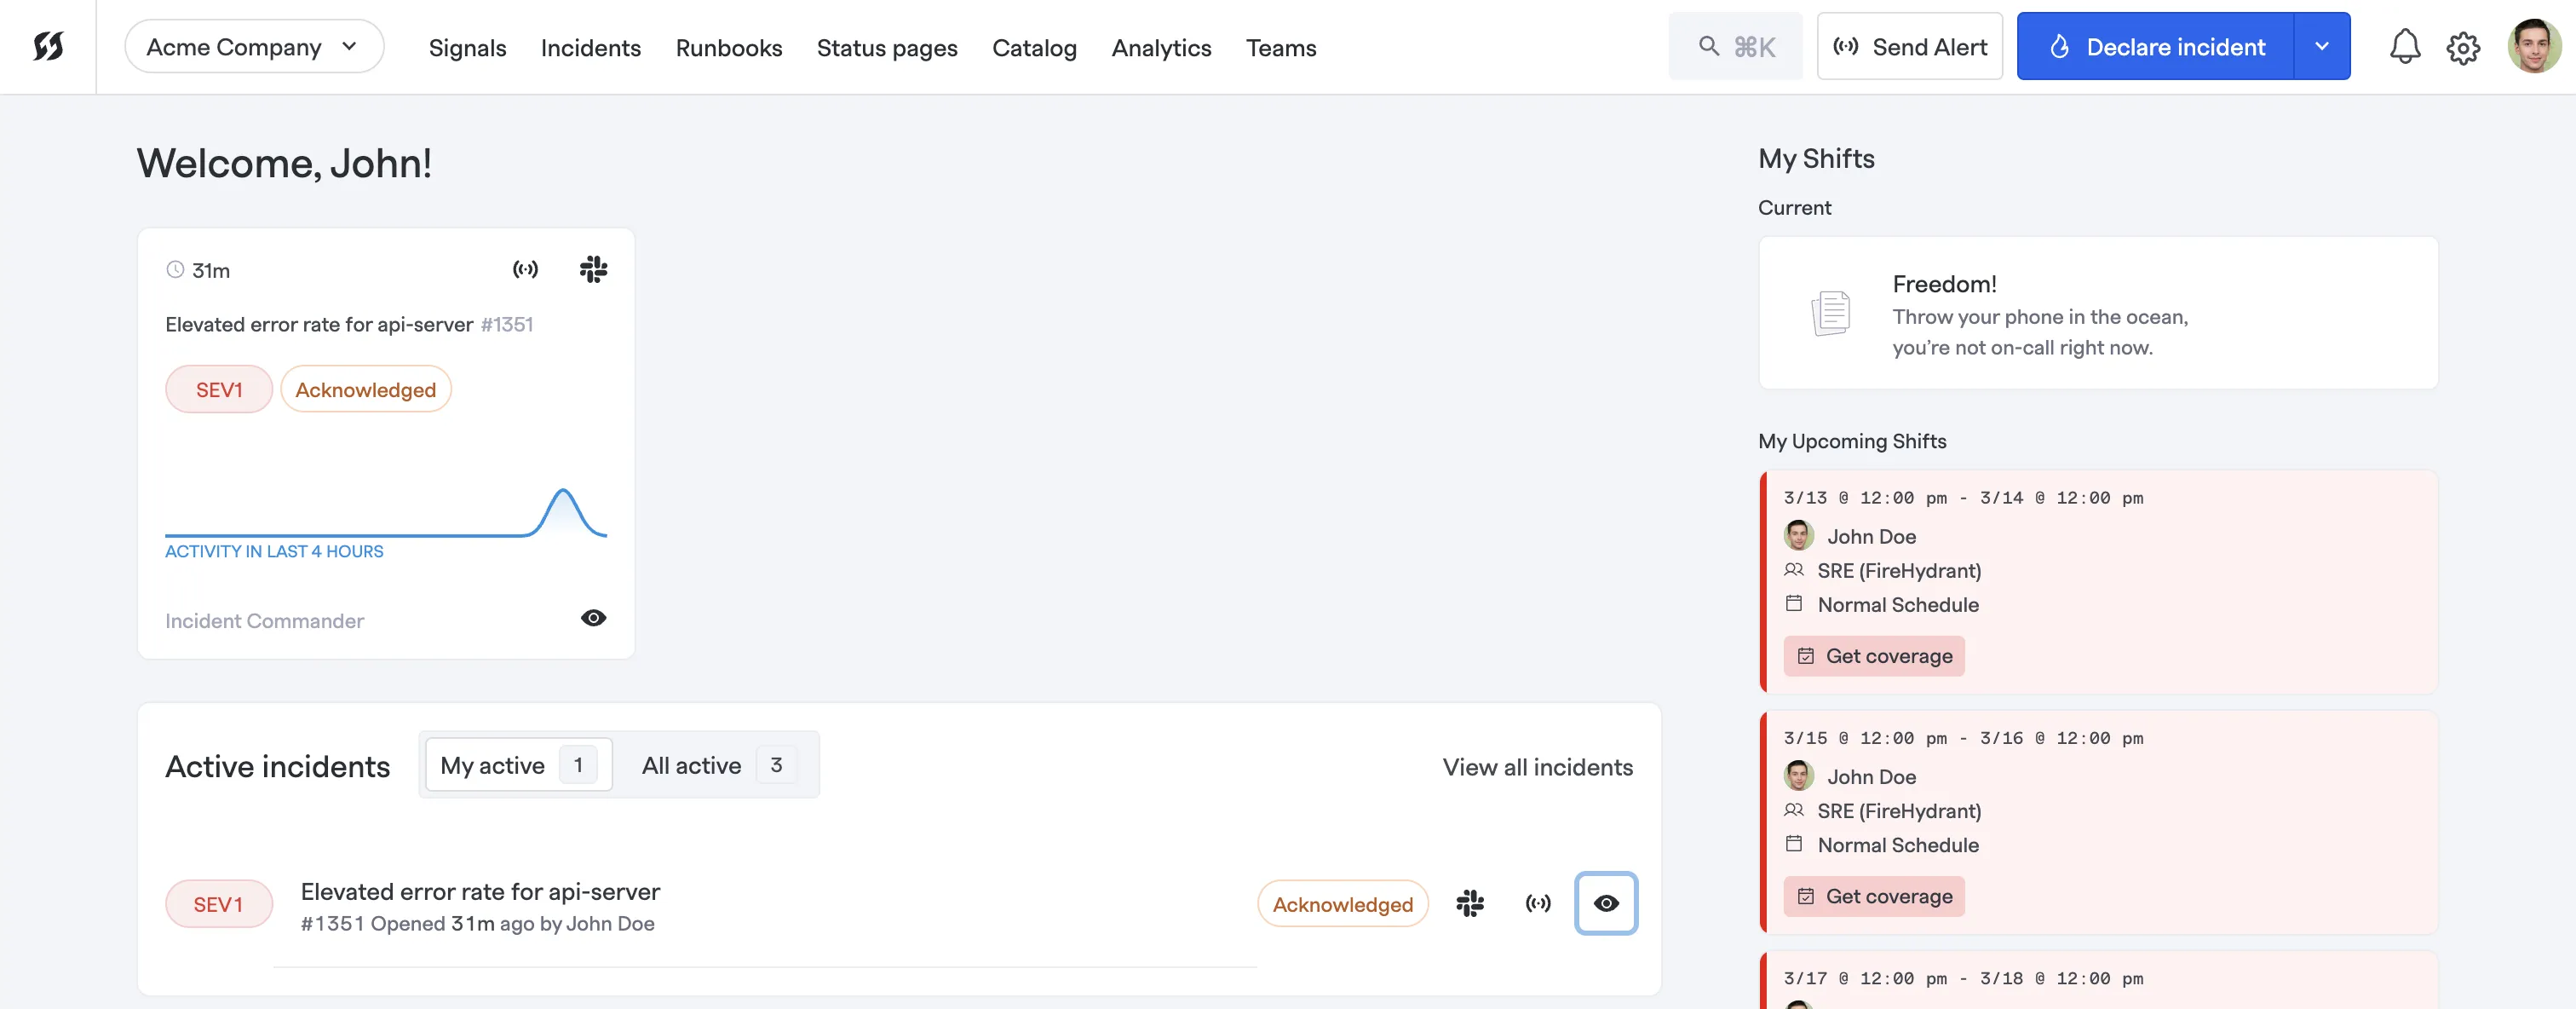
- Cycle de vie natif Slack et Teams, avec création automatique des canaux, attribution des rôles et réponse structurée.
- Un moteur de runbooks solide. FireHydrant investit beaucoup dans des runbooks codifiés et reproductibles qui s’exécutent aux côtés des intervenants humains.
- Une analyse post-incident structurée. Modèles, culture blameless par défaut et suivi des actions avec responsables et échéances.
- Catalogue de services. Cartographiez les services, leurs responsables et leurs dépendances. Les incidents héritent automatiquement du catalogue.
- Fonctions d’IA en Enterprise. FireHydrant AI (résumés, transcriptions, tri, rétrospectives) est inclus dans le forfait Enterprise plutôt que vendu comme un module à part.
- Pages de statut. Publiques et privées, avec la communication aux parties prenantes intégrée au flux de réponse.
Pourquoi choisir FireHydrant plutôt qu’incident.io
Les runbooks au premier plan. incident.io a des runbooks, mais ceux de FireHydrant vont plus loin. Les équipes qui ont des playbooks matures et documentés les transposent plus facilement ici.
Le catalogue de services au centre. Le catalogue de FireHydrant relie par défaut les incidents aux services et à leurs responsables. incident.io le permet aussi, mais chez FireHydrant ce modèle est plus central dans le produit.
Des prix plus lisibles pour l’IA. Là où incident.io place ses fonctions d’IA plus haut dans l’échelle des paliers et vend l’astreinte en option, FireHydrant inclut son IA dans le forfait Enterprise.
Les points faibles de FireHydrant
L’IA et les pages de statut privées sont réservées à Enterprise. Pro coûte 25 $/intervenant/mois en facturation annuelle ; les équipes qui veulent FireHydrant AI finissent sur Enterprise, sur devis.
Moins visible qu’incident.io et Rootly. Les échanges avec les achats peuvent prendre plus de temps.
Des engagements annuels fréquents. Les prix publics sont mensuels, mais les contrats réels passent souvent par un engagement annuel.
Moins directif qu’incident.io. Les équipes qui voulaient justement les bons choix par défaut d’incident.io trouveront FireHydrant un peu plus exigeant en configuration.
Prix
- Free : jusqu’à 10 intervenants, pages de statut publiques, gestion des incidents de base
- Pro : 25 $/intervenant/mois en facturation annuelle, astreinte (Signals), pages de statut publiques, SSO
- Enterprise : sur devis, FireHydrant AI, pages de statut privées
Choisissez FireHydrant si
Vous voulez une plateforme de réponse aux incidents mature, centrée sur les runbooks, avec un catalogue de services au cœur du produit et une IA incluse plutôt que facturée à part. Mieux vaut l’écarter si le budget est la contrainte décisive ou si ce sont justement les choix par défaut affirmés d’incident.io qui vous ont attiré vers cette catégorie.
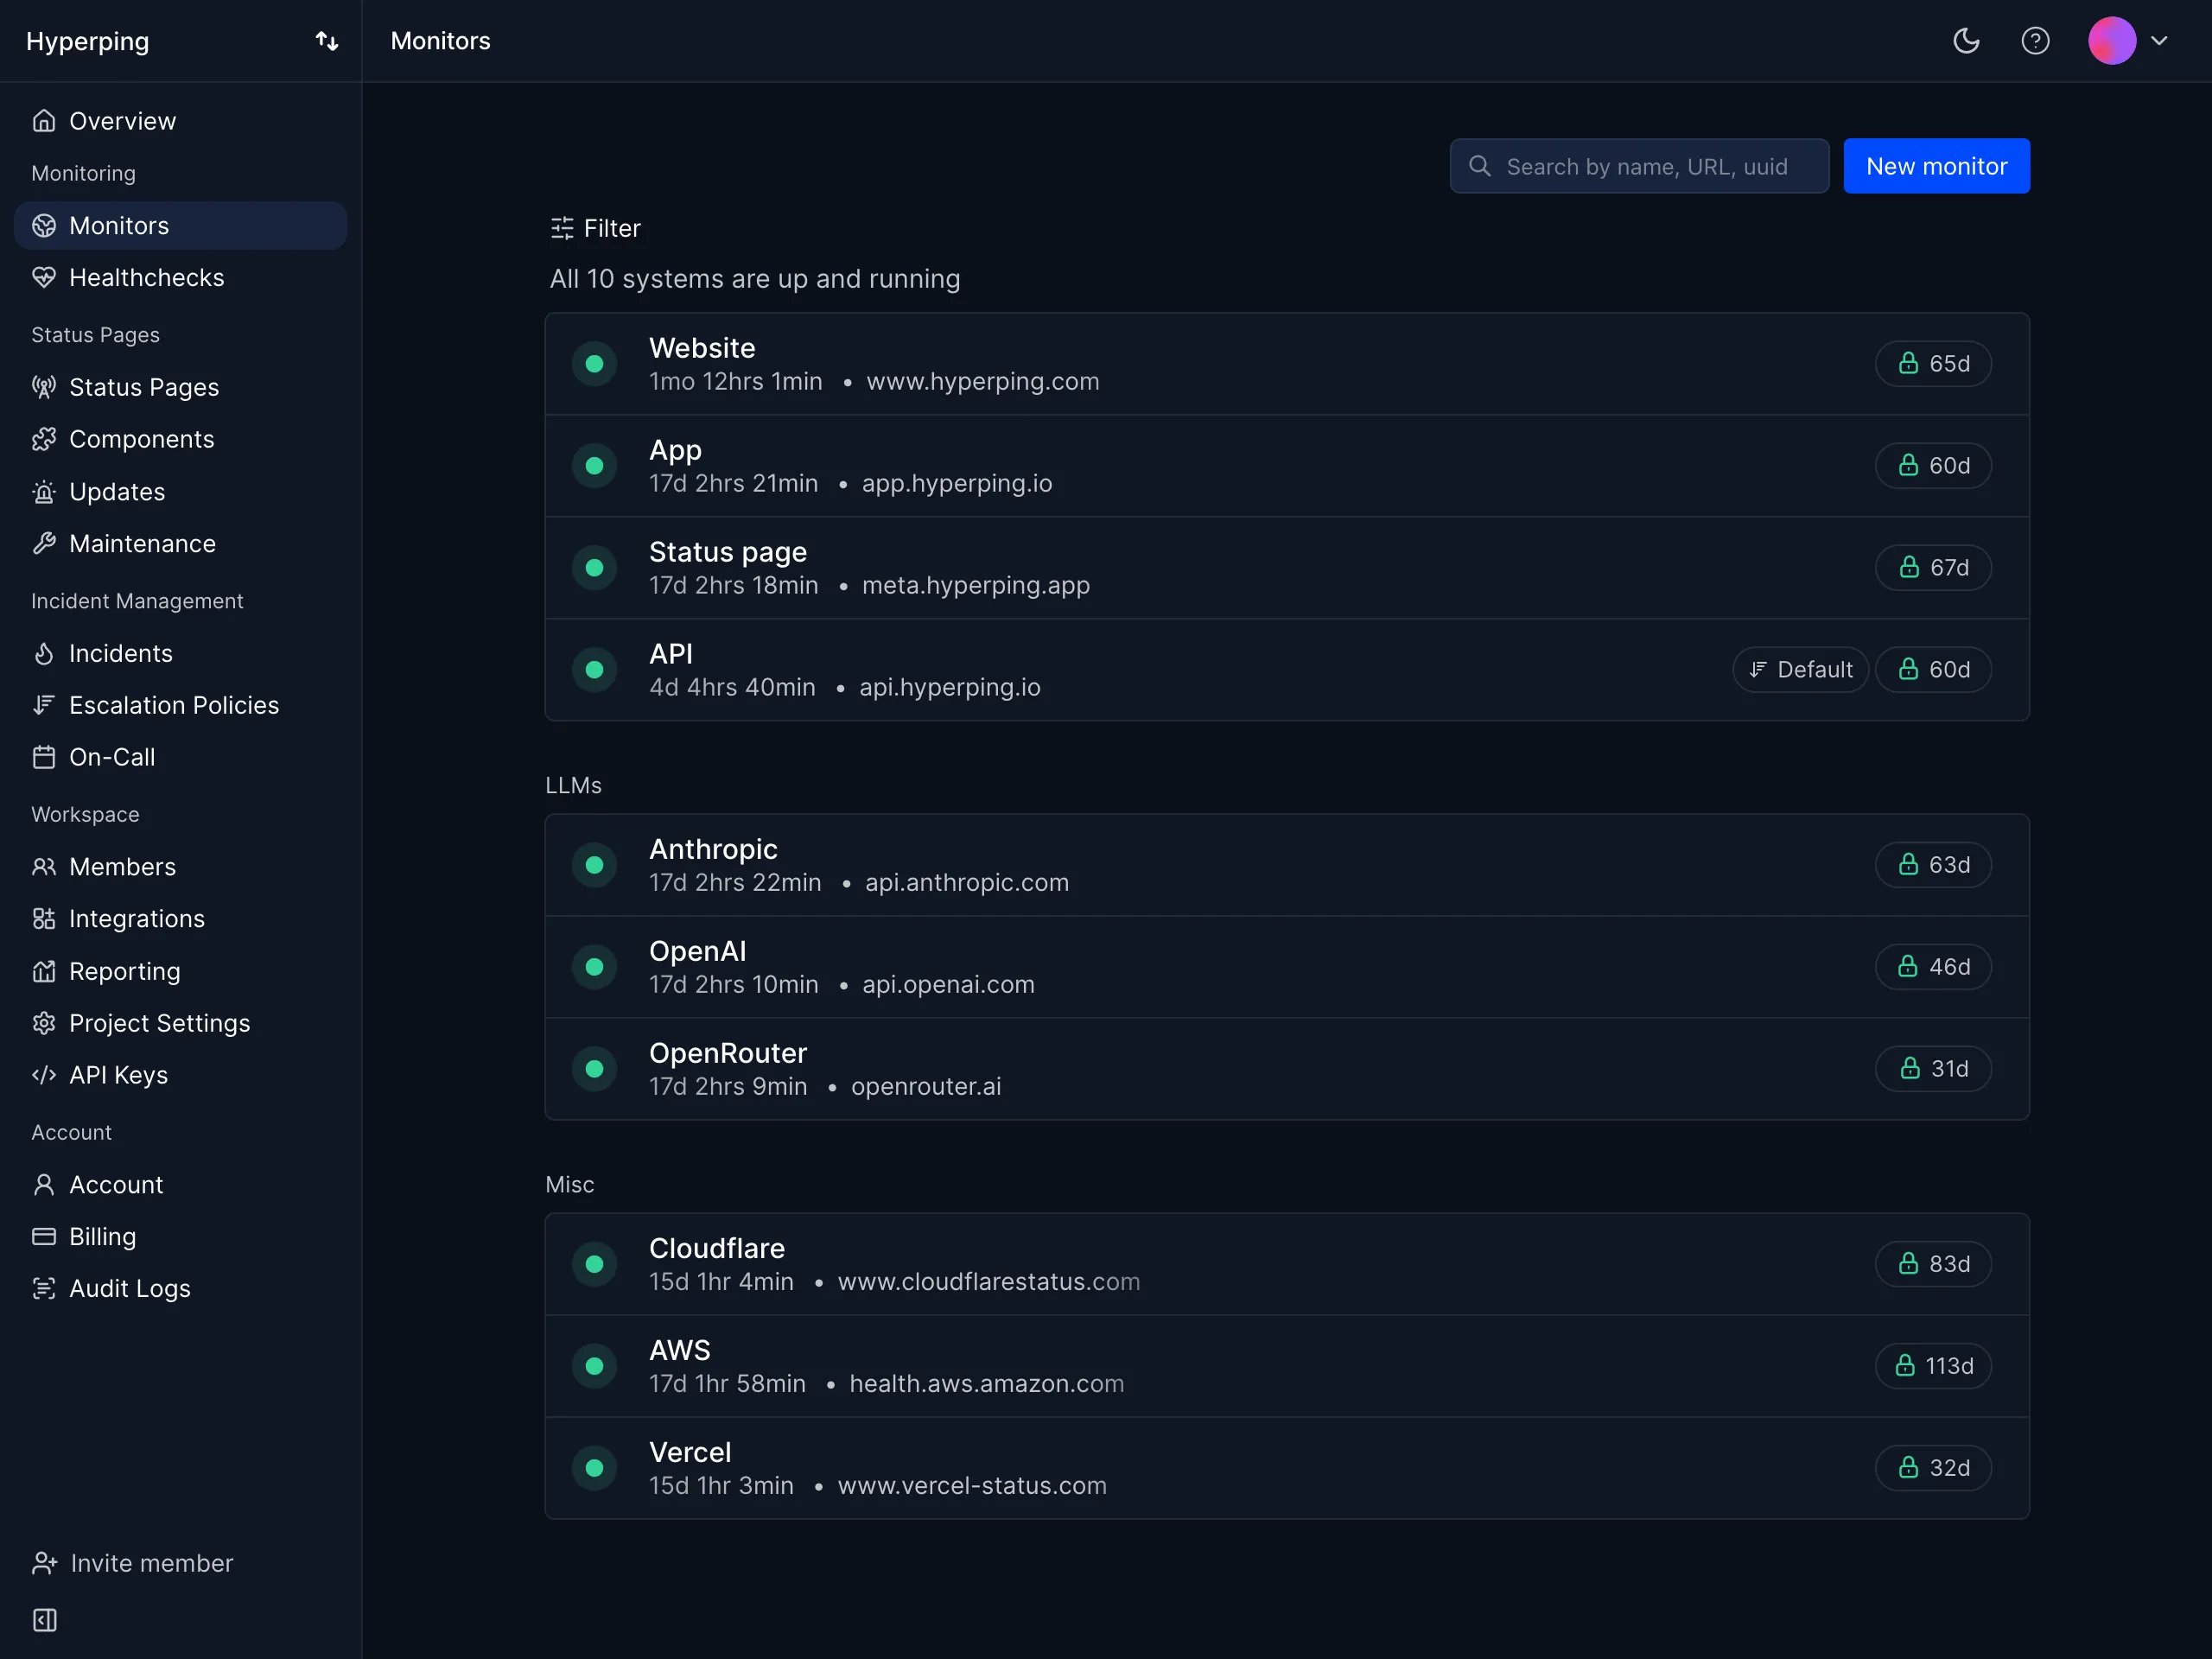
3. Hyperping : le meilleur si votre goulot d’étranglement est la détection, l’astreinte et les pages de statut
Idéal pour
Les startups, les PME et les équipes SaaS en croissance qui veulent le monitoring de disponibilité, les plannings d’astreinte, les politiques d’escalade et des pages de statut soignées dans un seul outil, sans facture par utilisateur qui grossit à chaque recrutement. C’est souvent la bonne réponse quand les équipes qui étudient incident.io se rendent compte qu’elles n’ont pas vraiment de problème de coordination dans le chat.
Fonctionnalités notables
- Monitoring externe depuis 18 régions dans le monde. Repérez les problèmes du point de vue de vos clients, pas seulement depuis votre VPC.
- Plannings d’astreinte et politiques d’escalade. Rotations qui tiennent compte des fuseaux horaires, relèves automatiques, escalade en plusieurs étapes. Inclus dans tous les forfaits payants, pas vendus comme un module à part.
- Nouvelle tentative automatique avant d’alerter. Hyperping confirme la panne depuis plusieurs régions avant de réveiller qui que ce soit, ce qui réduit nettement les fausses alertes.
- Alertes multicanales. Slack, Teams, Discord, Telegram, PagerDuty, OpsGenie, SMS, appels vocaux, webhooks.
- Pages de statut à vos couleurs incluses. Pages publiques et privées, domaines personnalisés, marque blanche, protection par SSO, plusieurs langues. 3 pages en Pro, 10 en Business, sans frais par page dans ces limites.
- Monitoring synthétique avec Playwright. Vérifications navigateur de bout en bout pour la connexion, le paiement et les autres parcours critiques.
- Agent de monitoring serveur. Un agent léger pour Linux et macOS qui remonte les métriques CPU, mémoire, disque et réseau, construit sur OpenTelemetry.
- Hébergement dans l’UE. Conforme au RGPD, toutes les données sont stockées dans des centres de données européens.
Pourquoi choisir Hyperping plutôt qu’incident.io
Un autre problème, un autre outil. incident.io est une plateforme de coordination. Hyperping, c’est la détection, l’alerte des personnes d’astreinte et la communication avec les clients. Beaucoup d’équipes qui étudient incident.io cherchent en réalité ce second rôle et n’ont pas besoin du premier. Une équipe de 20 personnes a rarement assez d’incidents pour justifier un orchestrateur de réponse dans le chat.
Des prix fixes et prévisibles, sans minimum de forfait Pro. Une équipe de 20 personnes sur Hyperping Pro coûte 179 $/mois, soit environ 149,17 $/mois en facturation annuelle, avec 10 sièges supplémentaires en plus des 10 inclus. La même équipe sur incident.io Team avec l’astreinte revient à environ 500 $/mois. Aucun palier d’incident.io n’inclut le monitoring ni les pages de statut dans le même forfait : il faudrait les acheter à part, en plus.
Trois outils en un. Le monitoring, l’astreinte et les pages de statut sont inclus dans tous les forfaits payants. Cela remplace UptimeRobot + Statuspage.io + un outil d’alerte d’astreinte (facilement plus de 200 $ au total pour une petite équipe).
Dix sièges inclus en Pro. Les neuvième et dixième membres de l’équipe tiennent dans le forfait de base. Chaque siège supplémentaire coûte 9 €/mois ou 90 €/an.
Les points faibles d’Hyperping
Hyperping n’est pas une plateforme de réponse aux incidents native Slack. Vous n’avez pas de canaux d’incident riches avec attribution des rôles, de post-mortems générés par IA ni de chronologies capturées automatiquement. Pour les équipes qui gèrent plus de 20 incidents par mois et veulent toute l’expérience d’incident.io ou de Rootly, Hyperping couvre la détection et l’astreinte, mais n’orchestre pas la réponse elle-même.
Il n’y a pas non plus d’APM intégré ni de tracing distribué. Pour l’observabilité interne, associez Hyperping à Datadog, New Relic ou Prometheus.
Ce qu’en disent les utilisateurs
« Dans notre entreprise, Hyperping a la réputation d’être plus réactif que Datadog. Nous recevons en général les notifications d’Hyperping avant celles de Datadog. C’est utile comme filet de sécurité, une solution de monitoring de secours plus légère. »
« Nous avons rendu notre page de statut Hyperping publique et elle est devenue un élément clé de nos argumentaires commerciaux. Nous sommes fiers de notre disponibilité et nous aimons pouvoir la montrer à nos prospects. »
Prix
- Free : 1 siège, 20 moniteurs, 1 agent serveur, 1 page de statut basique
- Essentials : 24 €/mois pour 50 moniteurs, 1 page de statut, 3 vérifications navigateur, 3 sièges
- Pro : 74 €/mois en facturation annuelle pour 250 moniteurs, 3 pages de statut publiques ou privées, 10 vérifications navigateur, alertes par appel vocal, 10 sièges. Comprend les codes d’accès par email, les pages multilingues et le SSO SAML natif pour le compte.
- Business : 249 €/mois en facturation annuelle pour 1 000 moniteurs, 10 pages de statut, des vérifications à moins de 30 secondes, 25 vérifications navigateur, 20 sièges
Tous les forfaits payants comprennent les plannings d’astreinte et les politiques d’escalade.
Choisissez Hyperping si
Vous vous rendez compte que ce qu’il vous faut vraiment, c’est du monitoring, de l’astreinte et une page de statut, pas un orchestrateur de réponse dans le chat. Particulièrement adapté aux équipes de moins de 30 personnes lassées de la facturation par utilisateur, aux entreprises européennes qui ont besoin de la conformité RGPD et d’un hébergement des données dans l’UE, et aux équipes SRE qui veulent un filet de sécurité indépendant à côté de Datadog (voir l’étude de cas d’Alma).
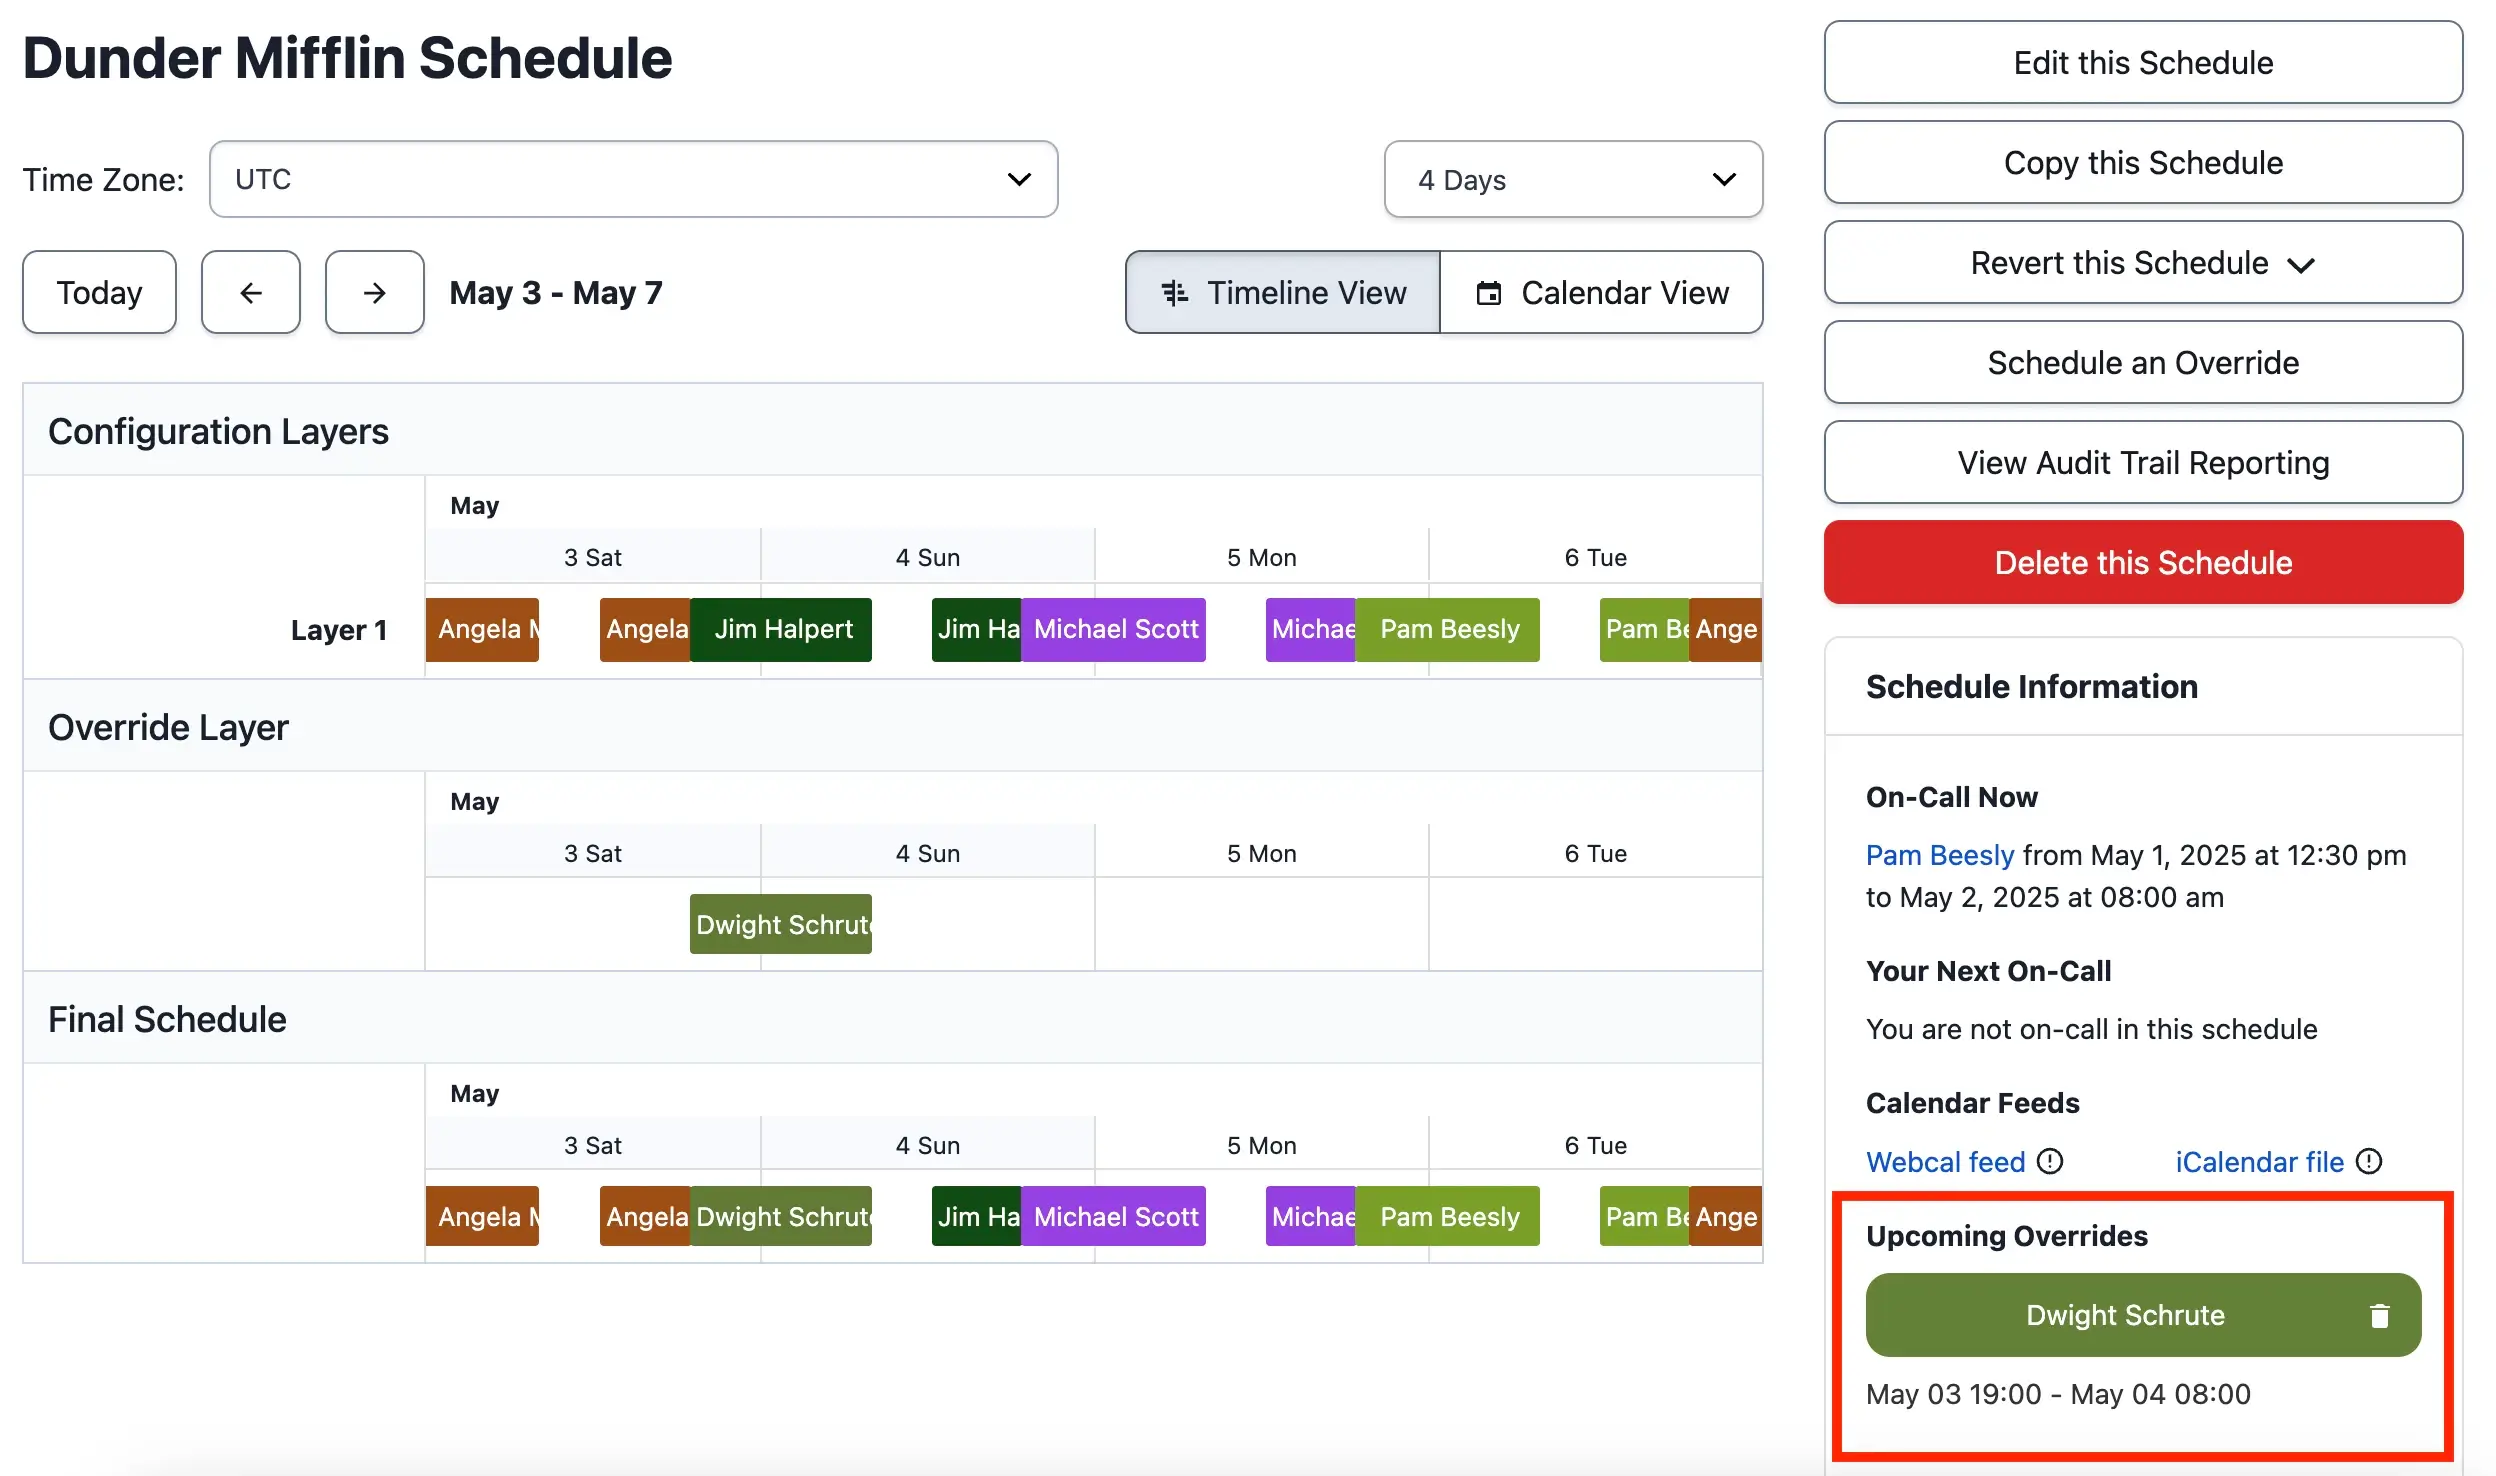
4. PagerDuty : le meilleur pour un alerting d’entreprise complet
Idéal pour
Les grandes entreprises qui ont des plannings d’astreinte complexes, de forts besoins d’intégration ITSM (ServiceNow, Jira) et le budget pour absorber un prix par utilisateur plus des options AIOps. C’est le repli par défaut quand le modèle d’incident.io, très directif et centré sur le chat, ne convient pas.
Fonctionnalités notables
- Un moteur d’alerting et de routage mature. Event Orchestration gère une logique conditionnelle complexe que les outils plus récents n’égalent pas encore.
- Plus de 700 intégrations. Le catalogue le plus fourni de cette liste, systèmes d’entreprise historiques compris.
- Options AIOps. Réduction du bruit, regroupement des alertes, workflows d’incident automatisés.
- Des alertes mobiles fiables. Plusieurs fils r/devops citent l’application mobile de PagerDuty comme la référence pour réveiller les gens à coup sûr à 3 h du matin.
- Architecture multicloud. PagerDuty a beaucoup investi pour ne pas tomber quand AWS ou Azure tombent.
Pourquoi choisir PagerDuty plutôt qu’incident.io
La profondeur de l’alerting et du routage. Si vous avez des rotations « follow-the-sun » sur cinq régions, des politiques d’escalade à 20 règles et une intégration ServiceNow qui doit fonctionner dans les deux sens, le moteur de planification et de routage de PagerDuty reste plus capable que le module d’astreinte d’incident.io. incident.io part de la réponse ; PagerDuty part de l’alerte.
Le confort côté achats. « Personne ne s’est jamais fait licencier pour avoir acheté PagerDuty » : c’est une réalité. Dans les grandes organisations prudentes, PagerDuty passe les achats plus vite que toutes les alternatives modernes.
Le catalogue d’intégrations. Plus de 700 intégrations, y compris des systèmes d’entreprise historiques que le catalogue d’incident.io n’atteint pas.
Pour la comparaison complète, voyez PagerDuty vs incident.io.
Les points faibles de PagerDuty
Le coût. 21 $/utilisateur/mois en Professional, puis un abonnement PD Reliability Platform payé d’avance à l’année pour l’AIOps et l’automatisation, de 2 800 $ pour 10 sièges à 48 000 $ pour 50. Pour une organisation d’ingénierie de 50 personnes, comptez 12 600 $ par an en Professional, ou 48 000 $ par an sur le palier de plateforme Plus.
Une coordination centrée sur l’application web. PagerDuty envoie des notifications dans Slack, mais l’incident lui-même vit dans son interface web. Les équipes qui veulent une réponse dans le chat constatent régulièrement une meilleure adoption avec incident.io.
Des manques dans l’API et les webhooks. Sur les forums, les utilisateurs signalent régulièrement des champs manquants (description retirée des webhooks, notes de résolution non exposées) et des appels API N+1 pour les champs personnalisés des services.
Des régressions sur mobile. Des mises à jour récentes ont ajouté une confirmation au balayage pour résoudre, ce dont les ingénieurs d’astreinte se plaignent souvent.
Des réglages de confidentialité par défaut. L’intégration Slack de PagerDuty active par défaut « Chat message ingestion » et « Private channel ingestion ». À vérifier lors de la configuration.
Prix
- Professional : 21 $/utilisateur/mois (annuel)
- PD Reliability Platform, payée d’avance à l’année : Starter 2 800 $ (10 sièges), Essential 12 000 $ (20 sièges), Plus 48 000 $ (50 sièges), Ultimate sur devis (500 sièges)
- L’AIOps et l’automatisation sont dans les paliers de la plateforme ; les sièges supplémentaires passent par des packs de crédits
- Offre gratuite limitée à 5 utilisateurs, 1 planning, 1 politique d’escalade et 100 notifications SMS/téléphone par mois
Choisissez PagerDuty si
Vous avez plus de 200 ingénieurs, des plannings complexes sur plusieurs régions, besoin d’intégrations ITSM poussées, et le prix par utilisateur n’est pas le problème. Évitez-le si vous êtes moins de 50 (le calcul par utilisateur ne tient pas) ou si vous voulez une expérience centrée sur le chat.
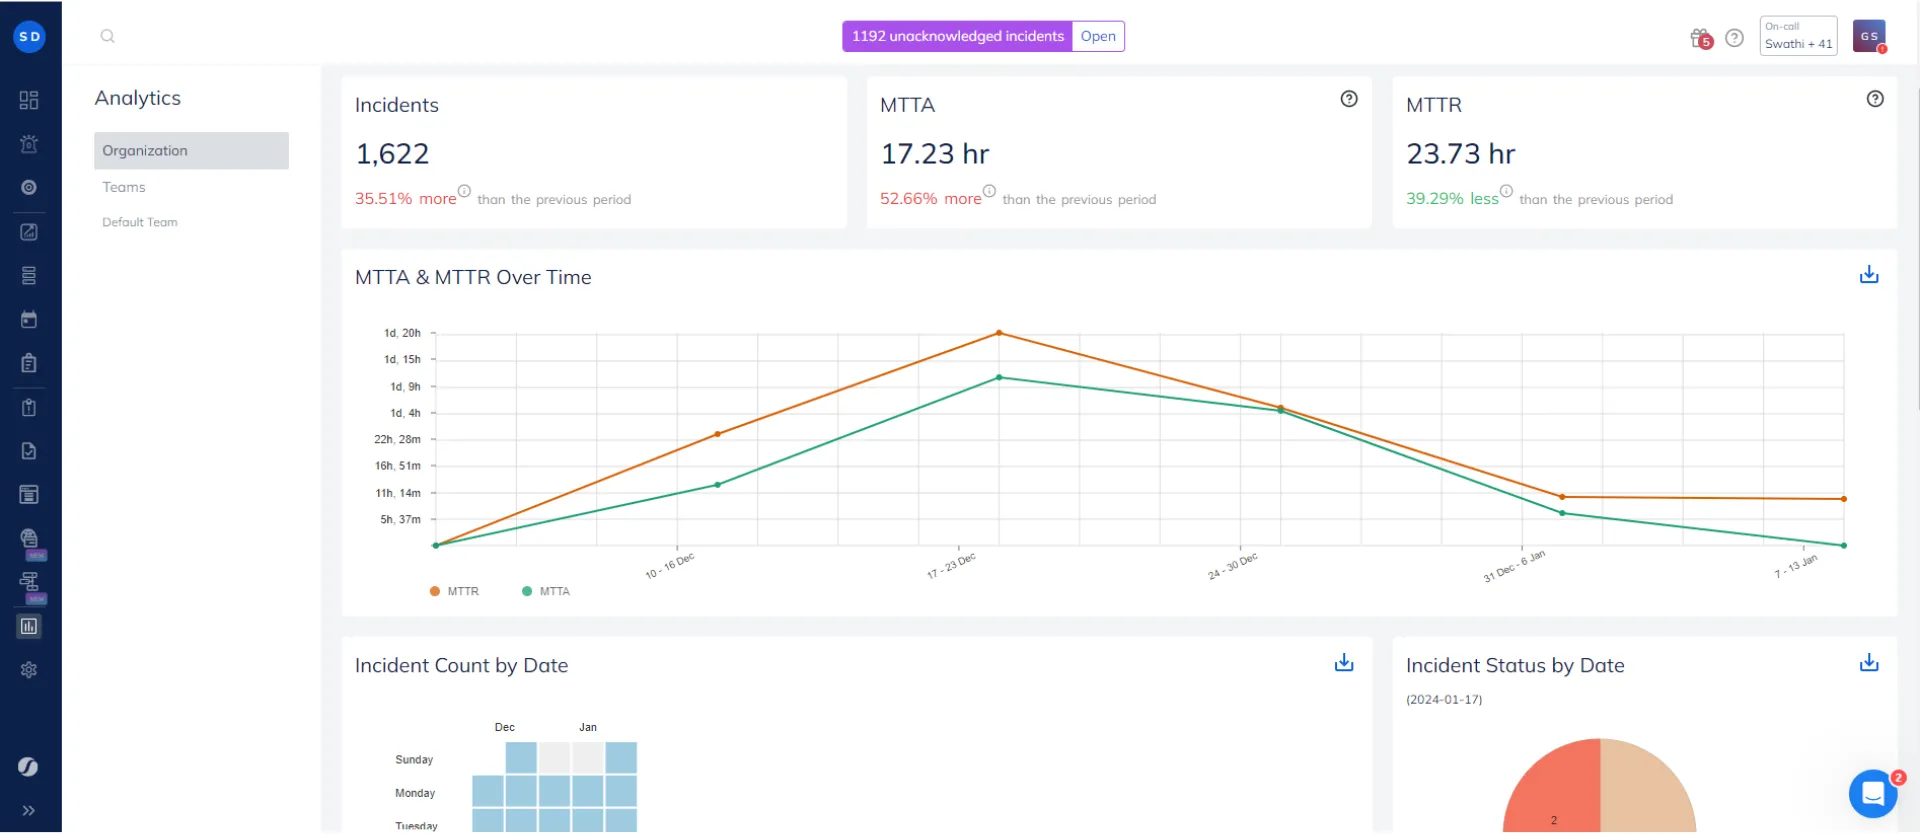
5. Squadcast : le meilleur pour les équipes DevOps au budget serré
Idéal pour
Les petites et moyennes équipes DevOps et SRE qui ont besoin de plannings d’astreinte solides, de routage des alertes et d’une gestion des incidents de base, au prix par utilisateur le plus bas parmi les outils sérieux. La bonne réponse quand incident.io est, sur le principe, disproportionné.
Fonctionnalités notables
- Plannings d’astreinte avec rotations, remplacements et routage selon l’heure
- Politiques d’escalade avec déduplication et réduction du bruit
- Workflows SRE, dont le suivi des SLO et des SLA, les budgets d’erreur et l’automatisation de la fiabilité
- Plus de 175 intégrations avec Datadog, Prometheus, Grafana, Jira, Slack, Teams
- Pages de statut incluses
- Offre gratuite jusqu’à 5 utilisateurs, avec email/push et 100 SMS/appels vocaux gratuits pour tout le compte
Pourquoi choisir Squadcast plutôt qu’incident.io
L’alternative sérieuse la moins chère. Pro, à 15 $/utilisateur/mois (en facturation annuelle), coûte environ 40 % de moins que le coût réel par utilisateur d’incident.io une fois le module d’astreinte inclus. Pour une équipe de 20 personnes, cela fait 3 600 $/an contre plus de 6 000 $/an.
La rapidité de mise en place. Plusieurs utilisateurs sur G2 disent avoir été opérationnels en quelques heures, pas en quelques jours.
Les pratiques SRE intégrées. Les SLO, les budgets d’erreur et le suivi de la fiabilité sont livrés dans le produit, au lieu d’être greffés avec des dashboards sur mesure.
Les points faibles de Squadcast
Moins natif Slack qu’incident.io ou Rootly. Squadcast est d’abord un outil d’alerte et d’astreinte, avec la réponse aux incidents ajoutée par-dessus. Le cycle de vie dans le chat est moins poussé.
Moins de fonctionnalités d’entreprise. Les post-mortems par IA et le soin des workflows n’atteignent pas le niveau d’incident.io.
Des incertitudes après le rachat. SolarWinds a racheté Squadcast et l’a renommé. Sur r/devops, des équipes appellent à une saine prudence sur la clarté de la feuille de route à long terme.
La notoriété face aux achats. « Nous avons choisi Squadcast » demande plus d’explications auprès des achats d’une grande entreprise que « nous avons choisi incident.io ».
Prix
- Essai : 14 jours, limité à 100 notifications par téléphone et SMS (plus de forfait gratuit)
- Pro : 15 $/utilisateur/mois (annuel), astreinte, escalades, SMS/appels vocaux, réduction du bruit
- Premium : 24 $/utilisateur/mois (annuel), ajoute les pages de statut, les runbooks, les workflows, le suivi des SLO
- Enterprise : sur devis, avec résumés par IA, synchronisation bidirectionnelle avec ServiceNow, SSO
Choisissez Squadcast si
Le budget est la contrainte principale, vos besoins de planification sont simples, et vous voulez un outil qui couvre l’essentiel (80 %) de la couche d’astreinte d’incident.io pour une fraction du prix. Il ne vous conviendra pas si vous avez besoin d’une réponse poussée pensée autour de l’IA ou d’un cycle de vie complet dans le chat.
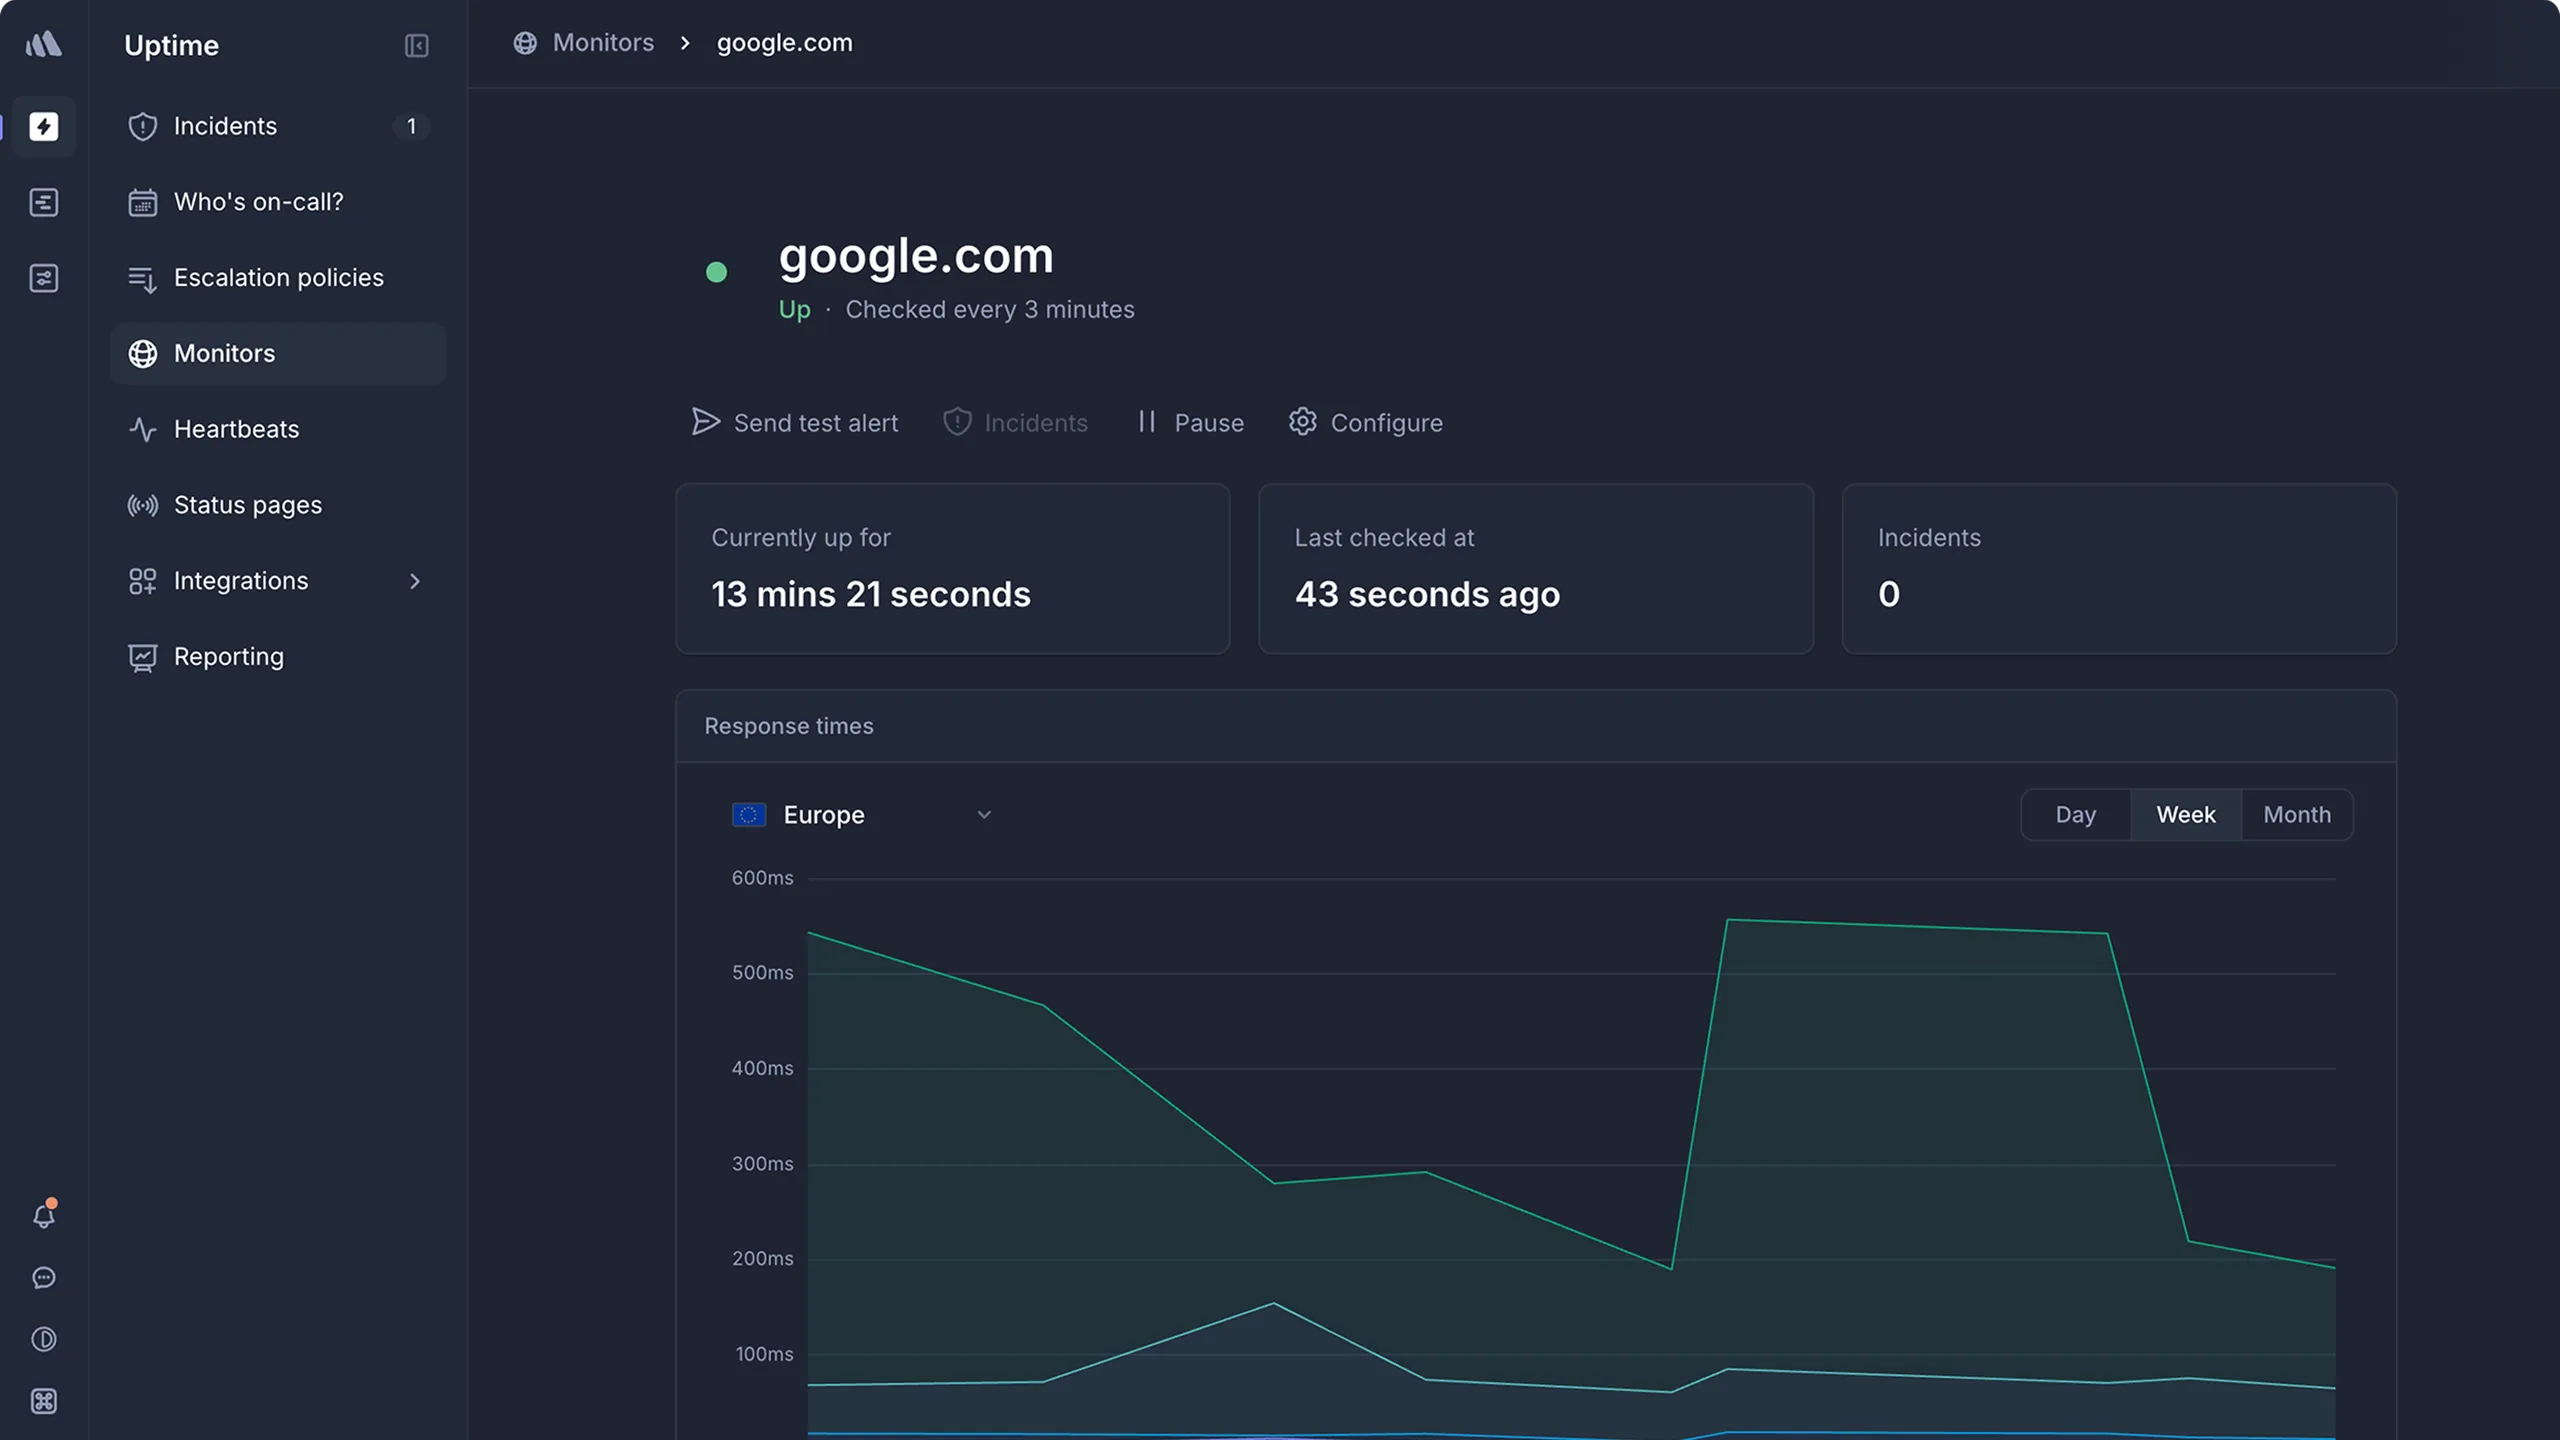
6. Better Stack : le meilleur pour réunir monitoring, logs et incidents
Idéal pour
Les startups et les équipes SaaS en croissance qui veulent le monitoring, la gestion des logs et la réponse aux incidents dans une interface moderne et soignée, et que le suivi des options facturées à l’usage ne dérange pas.
Fonctionnalités notables
- Monitoring de disponibilité avec des vérifications depuis plusieurs régions dans le monde
- Gestion des logs avec recherche structurée et alertes
- Plannings d’astreinte et escalade avec alertes multicanales
- Pages de statut à vos couleurs avec domaines personnalisés
- Interface moderne, saluée régulièrement dans les avis G2
- Tracing OpenTelemetry basé sur eBPF pour l’auto-instrumentation
- Terraform et API pour les workflows d’infrastructure as code
Pourquoi choisir Better Stack plutôt qu’incident.io
Trois couches sur une seule plateforme. Le monitoring, les logs et les incidents au même endroit, soit une facture SaaS et une intégration à maintenir en moins. incident.io part du principe que vous apportez votre propre détection et votre propre observabilité.
Une interface soignée. C’est le point le plus souvent salué dans les avis. Comparable à incident.io en finition, mais avec la couche de monitoring incluse.
Une offre gratuite généreuse. Elle permet d’essayer la plateforme sans s’engager.
Les points faibles de Better Stack
Des surprises avec le prix par intervenant. Le prix d’appel est de 29 $/mois, mais les intervenants supplémentaires (29 $ chacun), les moniteurs en plus (21 $ par tranche de 50) et les pages de statut supplémentaires (12 $ chacune) s’additionnent plus vite que ne le laisse croire le marketing.
Un cycle de vie moins mature qu’incident.io ou Rootly. L’astreinte et les incidents sont solides, mais les post-mortems par IA et la profondeur des workflows dans le chat sont en retrait.
Peu de personnalisation sur les premiers paliers. La personnalisation des pages de statut, en particulier, est limitée sur les forfaits d’entrée de gamme.
Prix
- Offre gratuite avec un monitoring de base et des fonctionnalités limitées
- Forfaits payants à partir de 29 $/mois, avec un prix par intervenant sur les paliers supérieurs
- Options : moniteurs en plus, pages de statut en plus, rétention des logs, tout est facturé à part
Choisissez Better Stack si
Vous voulez monitoring + logs + incidents dans un seul outil, vous tenez à une interface moderne et le suivi des options facturées à l’usage ne vous gêne pas. Écartez-le si vous voulez la prévisibilité d’un prix fixe (Hyperping convient mieux) ou un cycle de vie d’incident complet dans le chat (Rootly ou FireHydrant conviennent mieux).
Face-à-face
Rootly vs incident.io : lequel pour une réponse native Slack ?
C’est le face-à-face le plus cité dans les fils r/sre. Rootly est plus configurable et automatise plus profondément les workflows sur Jira, GitHub et le reste de la stack de développement. incident.io impose davantage sa façon de faire et s’adopte plus vite dès l’installation, avec les meilleurs post-mortems par IA. Si vous avez une chaîne d’outils complexe et voulez l’automatiser, Rootly. Si vous voulez des bonnes pratiques intégrées, incident.io.
FireHydrant vs incident.io : lequel pour des runbooks d’entreprise ?
Le moteur de runbooks et le catalogue de services de FireHydrant sont plus aboutis et plus centraux dans le produit. La force d’incident.io, ce sont ses choix par défaut affirmés et ses post-mortems par IA. FireHydrant inclut l’IA dans Enterprise ; incident.io la répartit entre les paliers et un module d’astreinte payant. Pour les équipes dont la priorité est d’avoir des playbooks codifiés et reproductibles et un catalogue de services central, FireHydrant. Pour celles qui veulent la finition d’incident.io, incident.io.
Hyperping vs incident.io : ai-je vraiment besoin d’une plateforme de réponse ?
Si vous gérez moins de 5 incidents par mois, la réponse honnête est probablement non. Hyperping couvre la détection, l’alerte des personnes d’astreinte, l’escalade et les pages de statut à prix fixe, avec des sièges inclus et les sièges supplémentaires facturés à l’unité. incident.io est fait pour l’équipe qui gère plus de 10 incidents par mois et a besoin d’orchestration. Pour la plupart des équipes de moins de 30 ingénieurs, le vrai goulot d’étranglement se trouve dans la détection et l’alerte.
Squadcast vs incident.io : lequel pour les équipes au budget serré ?
À 15 $/utilisateur/mois, Squadcast couvre l’astreinte et la réponse aux incidents de base pour environ 40 % de moins que le coût réel d’incident.io une fois le module d’astreinte inclus. En contrepartie : pas de post-mortems par IA, un cycle de vie moins poussé dans le chat et des workflows moins soignés. Pour la plupart des équipes de moins de 50 ingénieurs dont le budget est la contrainte décisive, Squadcast est le meilleur choix économique.
PagerDuty vs incident.io : lequel pour les grandes entreprises ?
Le moteur d’alerting et le catalogue d’intégrations de PagerDuty restent plus matures. La réponse dans le chat et les post-mortems par IA d’incident.io sont plus modernes. Pour les organisations où la profondeur de l’alerting et le confort côté achats comptent le plus, PagerDuty. Pour celles qui ont décidé que l’avenir passe par la réponse dans le chat et veulent se moderniser, incident.io.
Grille de décision
Selon la taille de l’équipe :
- Seul ou petite équipe (1 à 10) : Hyperping ou Squadcast (essai de 14 jours).
- Taille moyenne (10 à 50) : Hyperping pour monitoring + astreinte + pages de statut, Rootly ou FireHydrant pour un cycle de vie natif Slack.
- Grande équipe (50 à 200) : Rootly ou FireHydrant pour la réponse dans le chat, PagerDuty si la complexité des plannings domine.
- Grande entreprise (plus de 200) : PagerDuty, FireHydrant Enterprise ou Rootly Enterprise.
Selon le workflow :
- Natif Slack, automatisation poussée des workflows : Rootly.
- Natif Slack, runbooks poussés et catalogue de services : FireHydrant.
- Natif Slack, choix par défaut affirmés : incident.io lui-même (l’alternative, c’est de rester).
- Application web d’abord, routage complexe : PagerDuty.
- Surtout besoin d’une astreinte solide : Squadcast ou Hyperping.
- Envie d’avoir le monitoring inclus : Hyperping ou Better Stack.
Selon le budget (équipe de 20 personnes) :
- 100 à 300 $/mois : Hyperping Pro, Squadcast Pro, Better Stack avec quelques options.
- 300 à 1 000 $/mois : FireHydrant Pro ou Rootly Incident Response.
- Plus de 1 000 $/mois : le palier de plateforme Essential de PagerDuty (12 000 $/an pour 25 sièges), FireHydrant Enterprise, Rootly Enterprise.
Liste complète des alternatives à incident.io que j’ai étudiées
Par souci d’exhaustivité, voici l’ensemble des outils de gestion des incidents et d’astreinte que j’ai passés en revue avant de retenir les six choix. Les prix sont approximatifs, valables en 2026, et varient selon l’usage et la taille de l’équipe.
| Nom | Prix (approx. 2026) | Point fort principal | Point faible principal |
|---|---|---|---|
| Rootly | ~20 $+/utilisateur/mois par module | Automatisation poussée dans Slack/Teams, cycle de vie complet, rétrospectives par IA | Les prix par module s’additionnent ; dépend du chat |
| FireHydrant | Gratuit (10 intervenants) ; Pro 25 $/intervenant/mois (annuel) ; Enterprise sur devis | Runbooks solides, workflows structurés, analyse post-incident | Saut de prix entre les paliers ; engagements annuels fréquents |
| Hyperping | Forfait gratuit basique ; à partir de ~24 €/mois à prix fixe | Monitoring + pages de statut + astreinte intégrés à prix fixe | Pas une plateforme de réponse dans le chat |
| PagerDuty | Professional 21 $/utilisateur/mois ; plateforme à partir de 2 800 $/an avec l’AIOps | Alerting d’entreprise mature, astreinte, plus de 700 intégrations, AIOps | Options coûteuses ; interface complexe et vieillissante ; prise en main difficile |
| Squadcast | Pro 15 $/utilisateur/mois ; Premium 24 $/utilisateur/mois (annuel) | Abordable et orienté SRE (astreinte, SLO, post-mortems) | Moins connu que les leaders |
| Better Stack | Offre gratuite ; payant à partir de ~29 $/mois (à l’usage) | Monitoring + incidents + pages de statut tout-en-un ; interface moderne | Les prix par module s’additionnent |
| Opsgenie (Atlassian) | Plus commercialisé (fin de vente le 4 juin 2025) | Alerting et astreinte intégrés à Jira, pour les clients existants | Fermeture le 5 avril 2027 ; les clients migrent vers Jira Service Management |
| xMatters | À partir de ~9 $/utilisateur/mois (gratuit jusqu’à 10 utilisateurs) ; plus cher sur devis | Analyses poussées, insights par ML, workflows complexes | Interface datée ; prise en main plus difficile |
| Jira Service Management | Gratuit (limité) ; Standard ~20 $/agent/mois ; Premium ~49 $/agent/mois | Intégration naturelle avec Atlassian/Jira pour l’ITSM par tickets | Centré sur les tickets, pas sur la réponse SRE en temps réel |
| ServiceNow | Sur devis pour les entreprises (souvent plus de 100 $/utilisateur/mois) | Suite ITSM complète, automatisation, conformité | Très complexe, coûteux, déploiement long |
| Splunk On-Call (VictorOps) | Contacter les commerciaux (à l’usage) | Intégration étroite avec l’observabilité Splunk | Interface vieillissante ; peu d’intérêt seul |
| Freshservice | À partir de ~19 $/agent/mois | ITSM cloud simple à utiliser, avec automatisation par IA | Plus orienté helpdesk ; moins spécialisé SRE |
| Zenduty (Xurrent IMR) | Gratuit puis ~5 $/utilisateur/mois (Starter) ; jusqu’à 21 $ en Enterprise | Abordable, IA (analyse de cause racine, post-mortems), bonnes intégrations | Marque peu connue ; quelques manques pour les grandes entreprises |
| iLert | Gratuit (limité) ; Pro ~19 €/utilisateur/mois ; Enterprise ~49 $+ | Adapté à l’Europe, IA d’abord, pages de statut, couvre toute la stack | L’ancrage régional peut nuire à son image à l’international |
| PagerTree | À partir de ~10 $/utilisateur/mois ou forfaitaire ; gratuit en version basique | Routage des alertes et astreinte simples et légers pour les petites équipes | Automatisation et cycle de vie avancés limités |
| Spike.sh | À partir de ~5 $/mois | Réponse aux incidents simple et économique | Fonctions basiques ; pas fait pour les grandes entreprises |
| Grafana OnCall / IRM | Offre gratuite ; payant ~20 $/utilisateur + usage | Intégration native avec Grafana et l’observabilité, origines open source | Idéal avec la stack Grafana ; moins intéressant seul |
| Blameless | Sur devis (contacter les commerciaux) | Centré sur les pratiques SRE, post-mortems structurés | Dynamique en retrait face aux outils natifs du chat |
| BigPanda | Entreprise (contacter les commerciaux) | Corrélation d’alertes AIOps et réduction du bruit solides | Cher ; plus AIOps que cycle de vie complet des incidents |
| Moogsoft | Entreprise (contacter les commerciaux) | AIOps pour la réduction du bruit et le regroupement | Complexe ; coûteux à grande échelle |
| OnPage | ~12 $/utilisateur/mois | Alertes sécurisées pour la santé et les secteurs réglementés | Niche ; fonctions SRE moins larges |
| ManageEngine ServiceDesk Plus | Contacter les commerciaux / paliers d’entrée moins chers | Suite ITSM abordable avec des modules de gestion des incidents | Interface datée ; ITSM plus traditionnel |
| InvGate Service Management | Starter ~17 $/agent/mois ; Pro ~40 $ | Workflows no-code pratiques, intégration ITAM | Peu connu dans les milieux SRE |
| BMC Helix | Entreprise (contacter les commerciaux) | ITSM d’entreprise avec IA | Coûteux et complexe à déployer |
| NinjaOne | Variable (orienté MSP) | Gestion des correctifs + réponse aux incidents | Plus endpoint/RMM que gestion des incidents |
| GoAlert | Open source gratuit | Plannings d’astreinte open source simples | Auto-hébergement à gérer ; fonctions de cycle de vie minimales |
| All Quiet | À partir de ~5 $/utilisateur/mois | Alternative d’astreinte économique | Fonctions plus réduites ; nouvel entrant |
Les tendances de cette liste viennent d’analyses de 2025 et 2026 sur Gartner Peer Insights, des pages de prix des éditeurs, de comparatifs et de fils Reddit sur r/sre, r/devops, r/incidentio et r/SaaS.
Les erreurs fréquentes quand on quitte incident.io
Quelques schémas que j’ai vus revenir dans les fils Reddit :
- Remplacer incident.io par Rootly sans mesurer le coût de migration des workflows. La profondeur de Rootly a de la valeur, mais transposer des workflows incident.io très cadrés dans le constructeur low-code de Rootly demande un vrai travail. Faites l’inventaire des workflows que vous utilisez réellement avant de migrer.
- Passer à un outil sans les post-mortems par IA sur lesquels vous comptiez. Si les post-mortems générés automatiquement par incident.io étaient la fonction essentielle, FireHydrant Enterprise (FireHydrant AI) et Rootly AI SRE sont les plus proches. PagerDuty et Squadcast sont en retrait sur ce point.
- Oublier les pages de statut et la détection. Beaucoup d’équipes remplacent incident.io par un autre outil de réponse, puis se rendent compte qu’elles utilisaient aussi un outil de monitoring de disponibilité et une page de statut à part. Un outil tout-en-un comme Hyperping ou Better Stack comble ce manque.
- Choisir sur la liste des fonctions d’IA. Post-mortems par IA, résumés par IA, intervenants suggérés par IA : ce sont de vraies fonctions, mais leur qualité réelle varie. Le fil r/sre sur l’analyse de cause racine par IA déborde de scepticisme pragmatique. Menez un POC en parallèle sur trois à cinq incidents réels avant de décider.
- Voir « natif Slack » comme une case à cocher. « Natif Slack » recouvre des réalités très différentes chez Rootly, FireHydrant et incident.io. Faites passer de vrais intervenants par le flux dans le chat pendant un POC. Les utilisateurs avancés et les ingénieurs qui découvrent l’astreinte ne vous feront pas les mêmes retours.
En résumé
Il n’y a pas une seule meilleure alternative à incident.io, seulement le meilleur outil pour une place précise dans votre stack.
- Pour une réponse native Slack avec une automatisation des workflows plus poussée : Rootly.
- Pour des runbooks d’entreprise matures et un catalogue de services au centre : FireHydrant.
- Pour le monitoring, l’astreinte et les pages de statut dans un seul outil à prix fixe : Hyperping.
- Pour un alerting d’entreprise complet et le catalogue d’intégrations le plus large : PagerDuty.
- Pour les équipes DevOps au budget serré qui ont juste besoin d’une astreinte solide : Squadcast.
- Pour réunir monitoring, logs et incidents dans une interface soignée : Better Stack.
Si vous voulez un monitoring qui repère les problèmes en 30 secondes, des plannings d’astreinte avec des escalades intelligentes et des pages de statut que vos clients consulteront vraiment, le tout à prix mensuel fixe avec des sièges inclus et des sièges supplémentaires payants, essayez Hyperping gratuitement.
À lire aussi
- Meilleurs outils de gestion des incidents : un guide plus large de la catégorie, sur 6 outils
- Meilleures alternatives à Rootly : si Rootly est aussi dans votre liste restreinte
- Meilleures alternatives à FireHydrant pour les plannings d’astreinte : si FireHydrant est l’autre nom de votre liste restreinte
- Meilleures alternatives à PagerDuty : si PagerDuty est aussi dans votre liste restreinte
- Meilleurs outils de planning d’astreinte : centré sur la couche d’astreinte
- Meilleurs logiciels de page de statut : la couche de communication client que la plupart des outils de réponse laissent de côté
- Tarifs d’Hyperping
Continuer la comparaison : Hyperping vs incident.io · Hyperping vs PagerDuty · Tarifs d’Hyperping · Toutes les comparaisons
Questions fréquentes
Quelle est la meilleure alternative à incident.io ? ▼
Il n’y a pas une seule meilleure alternative à incident.io. Pour une réponse native Slack avec une automatisation des workflows plus poussée, Rootly. Pour des runbooks d’entreprise matures et un catalogue de services au centre, FireHydrant. Pour le monitoring, l’astreinte et les pages de statut dans un seul outil à prix fixe, Hyperping. Pour un alerting d’entreprise très complet et plus de 700 intégrations, PagerDuty. Pour les équipes DevOps au budget serré, Squadcast. Pour réunir monitoring, logs et incidents, Better Stack.
Pourquoi les équipes cherchent-elles des alternatives à incident.io ? ▼
D’après les fils Reddit que j’ai lus, les raisons principales sont les mauvaises surprises sur le prix (le plancher réel du forfait Pro dépasse largement le prix public par utilisateur dès qu’on ajoute l’astreinte), des choix par défaut très arrêtés qui gênent les équipes aux processus particuliers, des limites de personnalisation dès que la logique conditionnelle se complique, et la dépendance à Slack comme interface principale. Les équipes qui utilisent surtout Microsoft Teams signalent aussi des fonctionnalités en retard sur Slack.
Rootly est-il meilleur qu’incident.io ? ▼
Tout dépend de ce que vous cherchez. Rootly est plus configurable, avec un moteur de workflows plus profond qui couvre Jira, GitHub, Zoom et le reste de la stack de développement. incident.io impose davantage sa façon de faire, s’adopte plus vite dès l’installation et propose les meilleurs post-mortems générés par IA. Les équipes à la chaîne d’outils complexe choisissent Rootly. Celles qui veulent des bonnes pratiques intégrées d’emblée choisissent incident.io.
Quelle est l’alternative la moins chère à incident.io ? ▼
Squadcast (désormais SolarWinds Incident Response) Pro, à 15 $/utilisateur/mois en facturation annuelle, est l’outil sérieux de gestion des incidents le moins cher avec une vraie astreinte. Hyperping démarre à 24 €/mois à prix fixe, avec des sièges inclus et des sièges supplémentaires payants, et comprend le monitoring, l’astreinte, les politiques d’escalade et les pages de statut. Pour la plupart des équipes de moins de 30 personnes, Hyperping est la solution tout-en-un la moins chère.
incident.io vaut-il son prix ? ▼
Pour les équipes qui vivent vraiment dans Slack, gèrent plus de 10 incidents par mois et veulent un processus cohérent sans obliger les ingénieurs à passer par une application web à part, oui. Pour les entreprises sous Microsoft Teams, les petites équipes qui n’ont que quelques incidents par mois, ou celles dont le goulot d’étranglement est la détection plutôt que la coordination, le module d’astreinte payant et les minimums du forfait Pro le rendent difficile à justifier.