Les meilleures alternatives à Zabbix en 2026 sont Hyperping (monitoring hébergé des serveurs et de la disponibilité, astreinte et pages de statut incluses), Prometheus avec Grafana (métriques open source pour les conteneurs et les piles cloud-native), Checkmk (l’équivalent open source le plus proche du périmètre de Zabbix, avec découverte automatique), Netdata (métriques à la seconde sans configuration), Datadog (observabilité complète avec APM et logs) et Site24x7 (monitoring tout-en-un hébergé et bon marché).
Zabbix n’a rien de cassé. Il est gratuit, il tient la charge, et Zabbix 7.0 LTS est supporté jusqu’en 2027. Les équipes partent à cause de ce qu’il faut pour le faire tourner : un serveur Linux, une base MySQL ou PostgreSQL à dimensionner et à optimiser, des templates et des triggers à maintenir, et une couche d’alerte qui notifie mais ne gère pas qui est d’astreinte.
Dans ce guide, vous verrez :
- Pourquoi les équipes remplacent Zabbix, d’après les avis d’utilisateurs et la documentation de Zabbix elle-même
- Six alternatives, avec leurs prix vérifiés le 28 septembre 2026, leur mode d’hébergement et l’effort de mise en place
- Lesquelles sont open source, lesquelles sont gratuites, et lesquelles conviennent le mieux aux environnements Windows
- Dans quels cas Zabbix reste le meilleur choix, et comment lui retirer l’alerte d’astreinte sans grosse migration
Points clés
- Le serveur Zabbix ne tourne que sur des systèmes de type Unix et demande 2 cœurs CPU et 8 Gio de mémoire même pour sa configuration de référence « small » à 1 000 métriques, plus une base de données que vous maintenez.
- Prometheus + Grafana est la meilleure alternative gratuite pour les conteneurs et Kubernetes. Checkmk est l’équivalent gratuit le plus proche pour les parcs mixtes de serveurs et d’équipements réseau.
- Hyperping prend le relais pour la santé des hôtes et l’alerte d’astreinte, sans rien à héberger : un agent qui s’installe en une commande sur Linux, macOS et Windows, des plannings d’astreinte et des pages de statut, à partir de 24 €/mois en facturation annuelle.
- Datadog démarre à 15 $ par hôte et par mois en facturation annuelle et se justifie quand il vous faut l’APM et les logs. Site24x7 démarre à 9 $/mois en facturation annuelle pour les petites installations.
- Zabbix reste le meilleur choix pour les grands parcs sur site, les réseaux remplis d’équipements SNMP et les sites isolés du réseau (air-gapped).
Pourquoi vous pouvez faire confiance à ce guide
Je suis Léo, fondateur de Hyperping. J’ai un intérêt dans l’un de ces outils, et Hyperping apparaît en premier. J’ai essayé d’être précis sur ses limites, car il ne fait pas tout ce que fait Zabbix : pas d’interrogation SNMP, pas encore d’alertes sur seuil de métrique, et pas d’édition auto-hébergée.
Pour les autres outils, j’ai vérifié les prix sur la page tarifs officielle de chaque éditeur le 28 septembre 2026, lu les prérequis d’installation et la politique de versions de Zabbix, et parcouru les avis Capterra sur Zabbix. J’ai aussi lu les fils récurrents « Zabbix est trop complexe pour mon installation » sur r/sysadmin et r/zabbix, mais je cite les avis Capterra parce qu’ils indiquent le rôle de l’auteur, que je peux attribuer. Quand je n’ai pas pu vérifier quelque chose, je le dis.
Le meilleur choix en un coup d’œil
| Idéal pour | Produit |
|---|---|
| Monitoring des serveurs hébergé, astreinte et pages de statut incluses | Hyperping |
| Monitoring centré sur les métriques pour les conteneurs et Kubernetes | Prometheus + Grafana |
| Outil open source polyvalent le plus proche de Zabbix, avec découverte automatique | Checkmk |
| Métriques d’hôte à la seconde, presque sans configuration | Netdata |
| Observabilité complète avec APM, logs et traces | Datadog |
| Monitoring hébergé bon marché pour les petites équipes IT | Site24x7 |
Pourquoi les équipes quittent Zabbix
Zabbix existe depuis 2001 et couvre beaucoup de choses : agents, SNMP, IPMI, JMX, scénarios web, templates pour des centaines d’équipements et un langage de triggers pour les seuils et les tendances. Les reproches que j’ai trouvés portent rarement sur des fonctionnalités manquantes. Ils portent sur le coût d’exploitation de tout cela.
Le serveur, la base de données et le frontend, c’est vous qui les faites tourner
La page des prérequis de Zabbix 7.4 cite Linux, BSD, macOS, AIX, Solaris et HP-UX pour le serveur. Windows n’y figure pas. Vous choisissez MySQL, MariaDB, PostgreSQL ou PostgreSQL avec TimescaleDB, et le dimensionnement de référence commence à 2 cœurs CPU et 8 Gio de mémoire pour environ 1 000 métriques, pour monter à 16 cœurs et 64 Gio pour 100 000.
Et c’est avant le housekeeping, le partitionnement, les sauvegardes et les montées de version majeure. Le système de monitoring devient un système de production de plus, que quelqu’un doit garder en bonne santé, et s’il tombe, vos alertes tombent avec lui.
Templates et triggers demandent une vraie expertise
Dans Zabbix, une vérification est un item, une condition est un trigger, une notification est une action, et tout cela vient en général d’un template que vous importez, clonez et ajustez. C’est souple, et c’est beaucoup de concepts pour quelqu’un qui veut juste savoir quand un disque est plein.
D’après les avis Capterra sur Zabbix :
« La courbe d’apprentissage est raide, aussi bien pour installer que pour configurer Zabbix, surtout quand il faut créer des capteurs personnalisés. »
Ingénieur infrastructure, éducation
« Certaines configurations peuvent être difficiles si vous ne lisez pas beaucoup de documentation. »
Spécialiste TIC, services informatiques
Un autre utilisateur, ingénieur infrastructure dans le secteur aérien, souligne que trouver des modules et des templates qui fonctionnent est laissé à l’administrateur, et qu’ils ne fonctionnent pas toujours. Cela rejoint ce que j’ai lu dans les fils Reddit : il y a ceux qui aiment Zabbix une fois réglé, et ceux qui ont dix serveurs et le trouvent démesuré.
L’alerte s’arrête aux notifications
Les actions Zabbix gèrent des étapes d’escalade : notifier un groupe d’utilisateurs, attendre, notifier un autre groupe, lancer une commande à distance. Les types de média couvrent l’email, les SMS, Slack, Teams, PagerDuty et d’autres. Ce qui manque, c’est un calendrier d’astreinte : des rotations, des remplacements pour un jour d’arrêt maladie, et un acquittement depuis votre téléphone pour arrêter l’étape suivante.
Les équipes sous Zabbix ajoutent donc en général un outil d’alerte d’astreinte (PagerDuty, Opsgenie, qui ferme le 5 avril 2027, voir notre guide sur la fermeture d’Opsgenie, ou Grafana IRM). Et les clients apprennent les pannes par les tickets de support, car Zabbix n’a pas de page de statut publique. Cela fait trois outils à connecter et à garder synchronisés.
Zabbix Cloud supprime l’hébergement, pas la configuration
Zabbix Cloud fait tourner le serveur pour vous, de 50 $/mois (Nano, 50 nouvelles valeurs par seconde) à 5 000 $/mois (10 000 valeurs par seconde), avec 10 % de remise sur les offres annuelles et un essai de 5 jours. Cela règle la question de la base de données et des mises à jour. Vous construisez toujours templates, items, triggers et actions à la manière de Zabbix.
Comparatif rapide : les alternatives à Zabbix
| Outil | Prix de départ | Hébergement | Effort de mise en place | Alertes et astreinte | Windows |
|---|---|---|---|---|---|
| Hyperping | Gratuit ; 24 €/mois en annuel | Hébergé (SaaS) | Faible : une commande par hôte | Plannings d’astreinte, politiques d’escalade, téléphone/SMS/Slack/Teams, pages de statut incluses | Agent natif (Windows 10 / Server 2016+) |
| Prometheus + Grafana | Gratuit ; Grafana Cloud Pro 19 $/mois + usage | Auto-hébergé ou Grafana Cloud | Élevé | Routage par Alertmanager ; Grafana IRM pour l’astreinte (20 $/utilisateur actif) | windows_exporter |
| Checkmk | Community gratuit ; Pro dès 190 €/mois en annuel | Auto-hébergé (Linux) ou Checkmk Cloud | Moyen | Notifications par règles ; alerte d’astreinte via des intégrations | Agent natif |
| Netdata | Gratuit (5 nœuds) ; Business 7 $/nœud/mois en annuel | Agent + Netdata Cloud, ou sur site | Faible | Notifications d’alerte ; pas de planning d’astreinte | Agent natif |
| Datadog | Gratuit (5 hôtes) ; 15 $/hôte/mois en annuel | Hébergé (SaaS) | Faible à moyen | Monitors + produit On-Call séparé, au siège | Agent natif |
| Site24x7 | Offre gratuite ; 9 $/mois en annuel | Hébergé (SaaS) | Faible | Profils d’alerte, astreinte basique ; pages de statut dans un produit séparé (StatusIQ) | Agent natif |
| Zabbix (pour référence) | Gratuit ; Cloud dès 50 $/mois | Auto-hébergé (type Unix) ou Zabbix Cloud | Moyen à élevé | Actions avec étapes d’escalade ; pas de calendrier d’astreinte | Agent uniquement ; le serveur ne tourne pas sous Windows |
Hyperping : idéal pour un monitoring hébergé avec astreinte et pages de statut intégrées
Pour qui est fait Hyperping
Les équipes qui font tourner de quelques serveurs à quelques centaines, qui ne veulent pas maintenir un serveur de monitoring, et dont le plus gros manque concerne ce qui se passe après une panne : qui est alerté, ce qui se passe si personne ne répond, et comment les clients sont prévenus.
Hyperping n’est pas un remplaçant de Zabbix à l’identique. Il n’interroge pas les switchs en SNMP et n’évalue pas d’expressions de triggers. Il couvre ce pour quoi la plupart des petites et moyennes équipes utilisent réellement Zabbix (l’hôte est-il vivant, où en sont CPU, mémoire et disque, le service répond-il) et ajoute la couche d’alerte d’astreinte et de page de statut que Zabbix laisse à d’autres outils.
Fonctionnalités notables
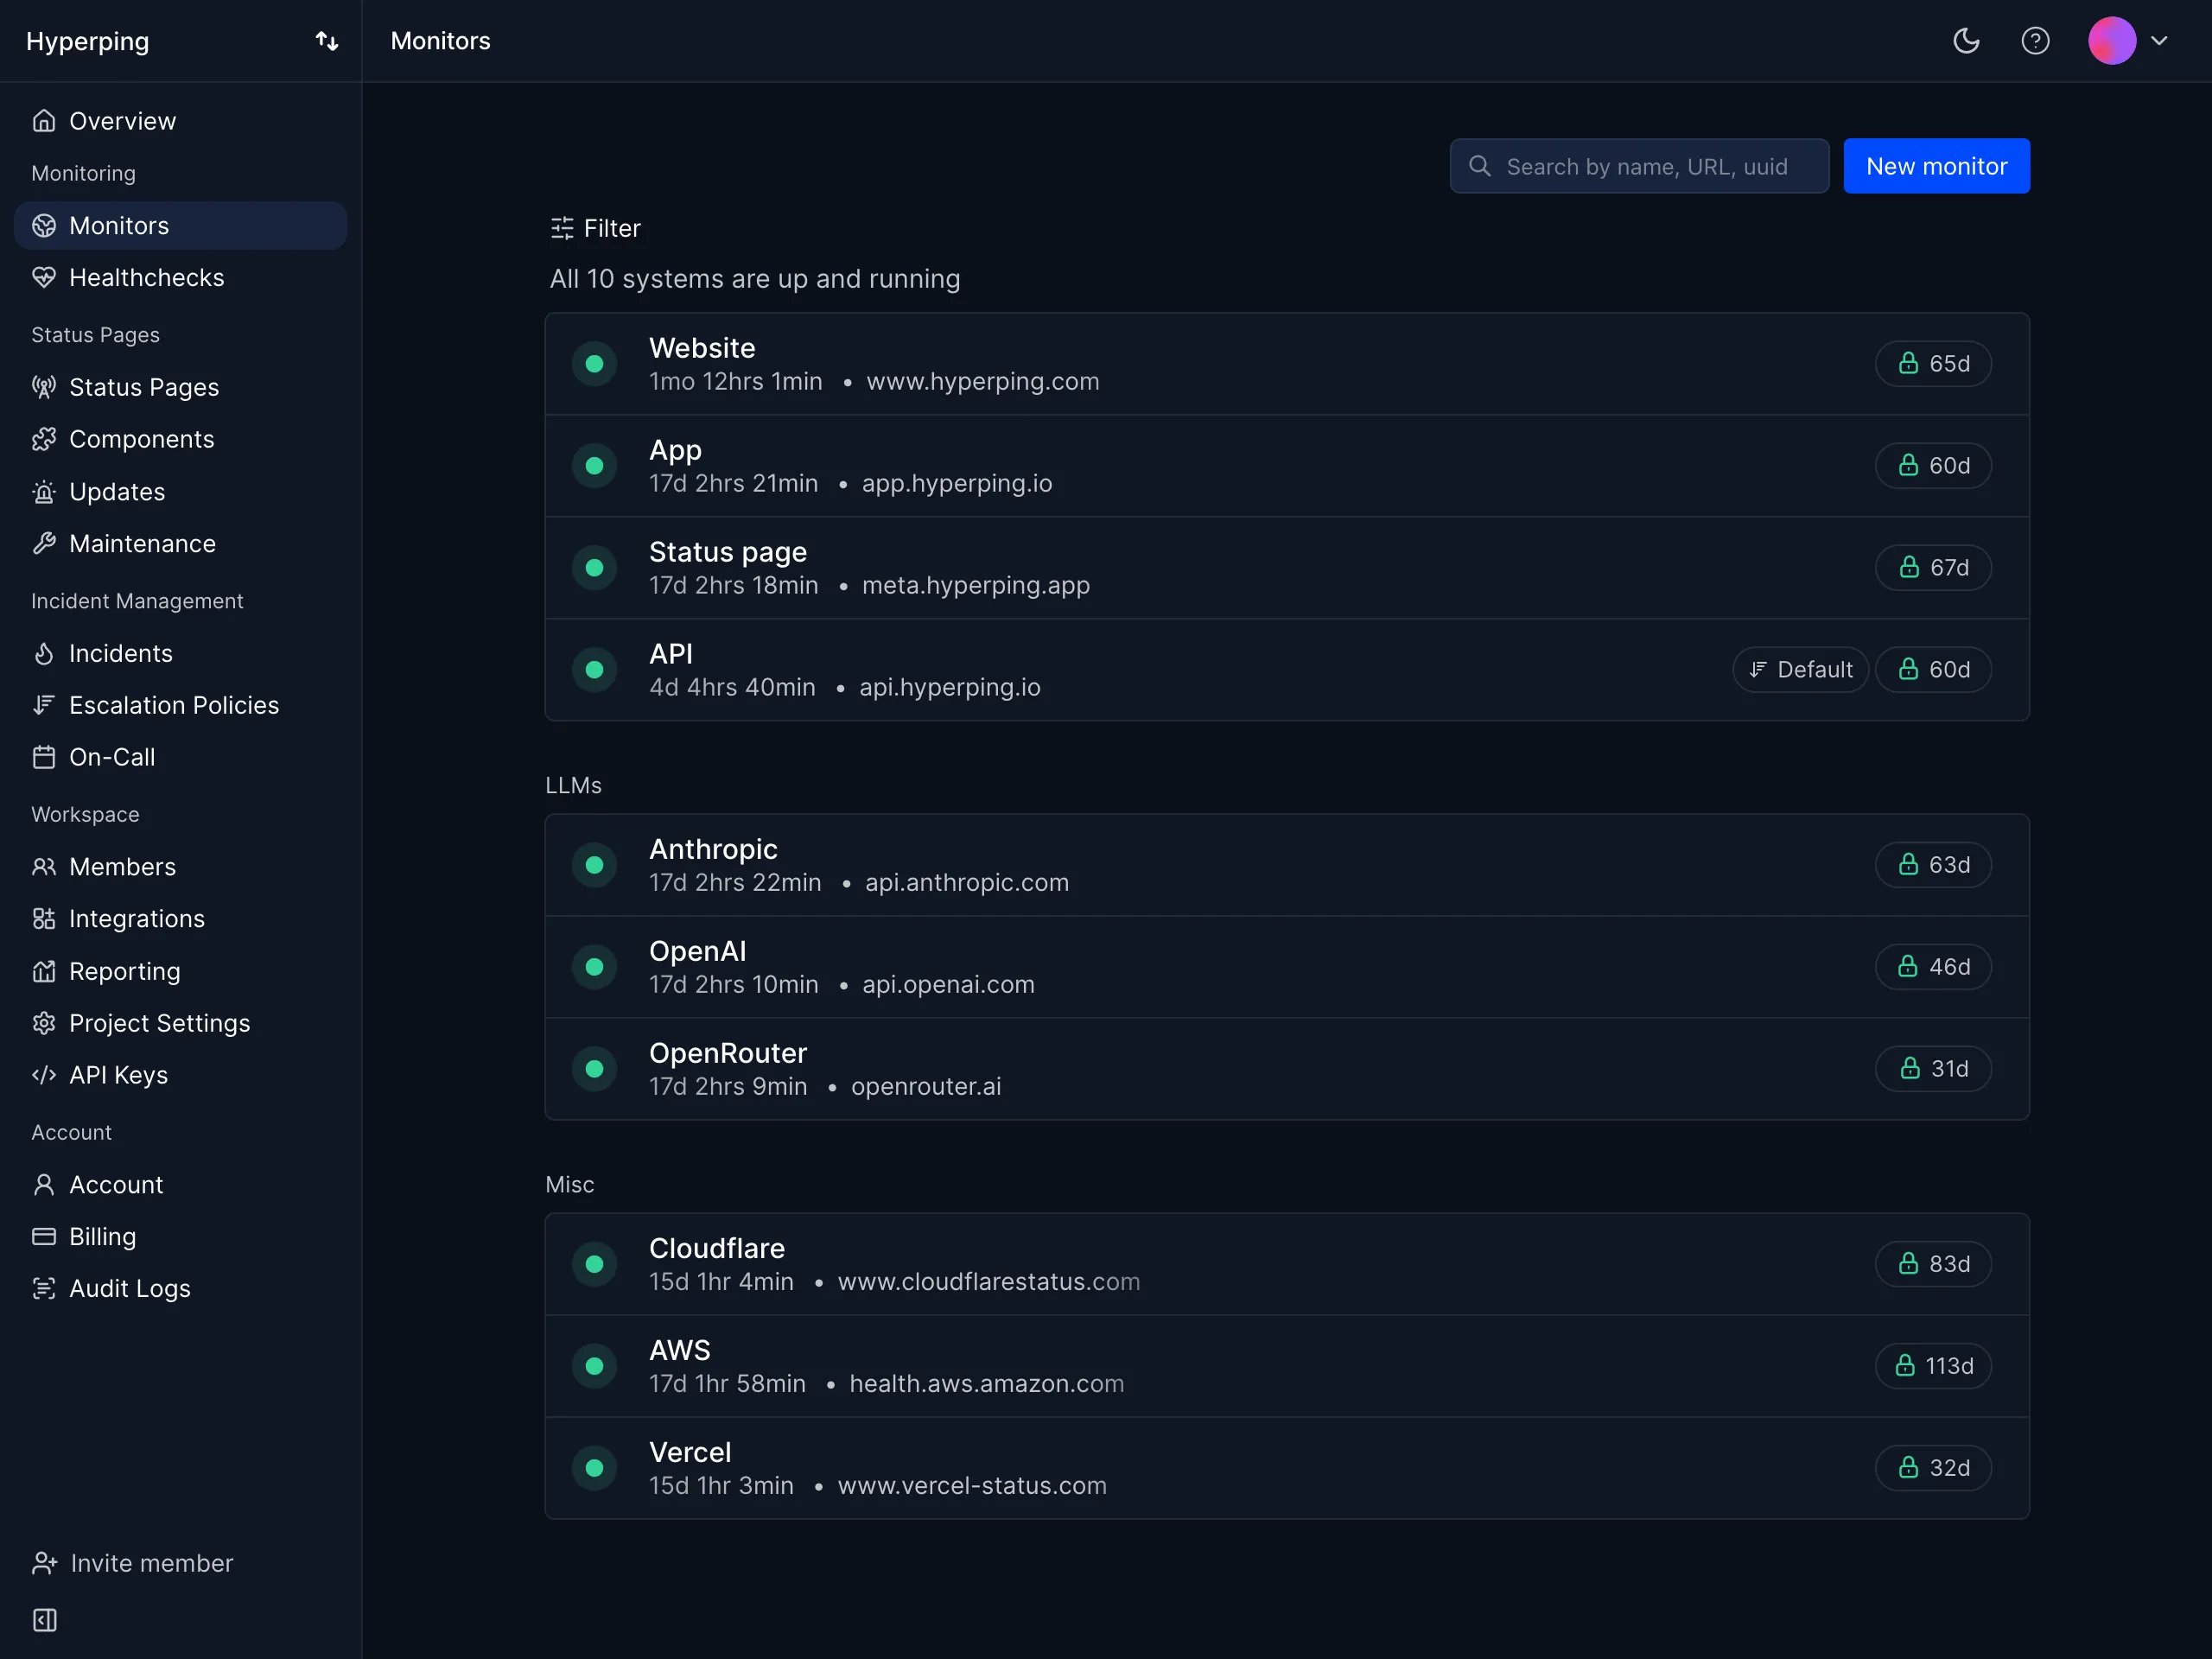
- Un agent en une ligne pour Linux, macOS et Windows : une seule commande enregistre un service systemd, launchd ou Windows. Il tourne sur amd64 et arm64 (amd64 sous Windows), c’est un binaire unique avec un collecteur OpenTelemetry intégré qui utilise environ 50 Mo de mémoire, et il n’a besoin que de HTTPS sortant. Voir la référence d’installation de l’agent.
- Métriques d’hôte toutes les 30 secondes : CPU par état avec la charge moyenne sur 1, 5 et 15 minutes, mémoire par état, espace utilisé et libre par point de montage, octets lus et écrits par disque, octets entrants et sortants par interface réseau, et métadonnées de l’hôte (OS, noyau, modèle de CPU, heure de démarrage).
- Aucun template à écrire : le serveur apparaît avec ses graphiques environ 30 secondes après l’installation. Des options comme
--name,--policyet--grouppermettent à Ansible ou Terraform d’enrôler tout un parc avec la bonne politique d’escalade dès le premier lancement. - Une détection de mise hors ligne qui alerte l’astreinte : quand un serveur cesse de remonter des données au-delà de son seuil de mise hors ligne (90 secondes par défaut, 60 secondes minimum, réglable par serveur), une panne s’ouvre et la politique d’escalade associée alerte ses canaux : email, SMS, appels téléphoniques, Slack, Teams, PagerDuty, webhooks ou un planning d’astreinte. Détails dans les alertes serveur.
- Des moniteurs de disponibilité dans le même compte : vérifications HTTP, ping, port et mot-clé depuis 18 régions, toutes les 30 secondes par défaut, plus des vérifications quotidiennes des certificats SSL et des heartbeats cron. Ils remplacent les scénarios web et les simple checks Zabbix pointés vers vos points d’accès publics.
- Plannings d’astreinte et politiques d’escalade : inclus dès Essentials et partagés par les serveurs et les moniteurs. Voir l’astreinte.
- Pages de statut : des pages à vos couleurs avec abonnés, pour que l’incident qui a alerté votre ingénieur puisse être publié auprès des clients. Voir les pages de statut.
- Pas de trous après une coupure réseau : l’agent met en file d’attente sur disque les métriques non envoyées et réessaie, si bien que de courtes pannes d’ingestion ou des redémarrages ne laissent pas de trous dans les graphiques.
Pourquoi choisir Hyperping plutôt que Zabbix ?
Rien à héberger, à dimensionner ni à mettre à jour
Zabbix a besoin d’un serveur, d’une base de données, d’un frontend web et de quelqu’un pour les mettre à jour. Avec Hyperping, l’agent est la seule chose installée sur vos hôtes. Le scénario où la machine de monitoring meurt en même temps que ce qu’elle surveille disparaît.
L’alerte d’astreinte fait partie du produit
Dans Zabbix, changer la personne d’astreinte veut dire modifier des groupes d’utilisateurs ou des actions. Dans Hyperping, vous définissez une fois un planning et une politique d’escalade, et chaque étape a son propre délai et ses propres canaux : une alerte sans réponse passe à la personne suivante. Notre guide des politiques d’escalade et notre guide des rotations d’astreinte expliquent comment les concevoir.
Les clients apprennent les incidents par vous
Zabbix n’a pas de page de statut. Avec Hyperping, la même panne peut être publiée sur une page de statut qui prévient les abonnés par email, sans troisième outil.
Si votre installation Zabbix se résume désormais à « préviens-moi quand une machine tombe et réveille la bonne personne », et que plus personne ne veut s’occuper de la base de données derrière, c’est le moment où il devient plus logique d’être alerté quand un serveur se tait, sans faire tourner de serveur de monitoring, que de continuer à maintenir la pile.
Ce qu’en disent de vrais utilisateurs de Hyperping
« Nous avons rendu notre page de statut Hyperping publique et elle est devenue un élément clé de nos argumentaires commerciaux. Nous sommes fiers de notre disponibilité et nous aimons pouvoir la partager aussi facilement avec nos prospects et nos clients. »
Combien coûte Hyperping ?
- Free : 1 agent de monitoring serveur, 20 moniteurs avec vérifications toutes les 5 minutes, 1 page de statut basique
- Essentials : 24 €/mois en facturation annuelle (29 € en mensuel) pour 5 agents serveur, 50 moniteurs, 3 vérifications navigateur, 1 page de statut avec domaine personnalisé, astreinte et politiques d’escalade, alertes par appel téléphonique, 3 sièges
- Pro : 74 €/mois en facturation annuelle (89 € en mensuel) pour 20 agents serveur, 250 moniteurs, 3 pages de statut publiques ou privées, abonnés SMS, SSO SAML pour le compte, 10 sièges
- Business : 249 €/mois en facturation annuelle (299 € en mensuel) pour 100 agents serveur, 1 000 moniteurs, 10 pages de statut, marque blanche, journaux d’audit, 20 sièges
Les alertes serveur sont incluses dans toutes les offres payantes, avec un essai gratuit de 14 jours. L’historique des métriques dépend de l’offre, d’après la référence des métriques : la précision à la minute est conservée 2 jours en Free, 7 jours en Essentials, 14 jours en Pro et 30 jours en Business, et les agrégats horaires sont conservés 30 jours en Free, 6 mois en Essentials et 13 mois en Pro et Business.
Les limites de Hyperping
Pas encore d’alertes sur seuil de métrique. Hyperping vous alerte quand un serveur cesse de remonter des données. Il n’ouvre pas d’incident quand le CPU dépasse 90 % ou qu’un disque atteint 85 % : vous le voyez dans le tableau de bord. Si les triggers Zabbix sur l’espace disque et la charge sont au cœur de votre façon de travailler, gardez-les pour l’instant ou choisissez Checkmk. Notre guide des seuils d’alerte pour le monitoring des serveurs détaille ceux qui valent la peine.
Un ensemble fixe de métriques système. Pas d’items personnalisés, de user parameters, de CPU et mémoire par processus, de métriques de conteneurs, de logs, d’APM ni de tracing.
Pas de SNMP, pas d’équipements réseau, pas d’édition auto-hébergée. Switchs, routeurs, imprimantes et onduleurs sont hors périmètre, et vous ne pouvez pas faire tourner Hyperping dans un réseau isolé (air-gapped). Là, Zabbix fait mieux.
Hyperping est-il fait pour vous ?
Choisissez Hyperping si votre parc est composé de serveurs Linux, macOS ou Windows plutôt que d’équipements réseau, si vous préférez ne pas exploiter vous-même le système de monitoring, et si vous payez aujourd’hui un outil d’alerte d’astreinte et une page de statut séparés. Les parcs très dépendants du SNMP et les sites isolés du réseau ont intérêt à rester sur Zabbix ou à regarder Checkmk.
Prometheus + Grafana : la meilleure alternative open source pour les piles cloud-native
Pour qui est fait Prometheus
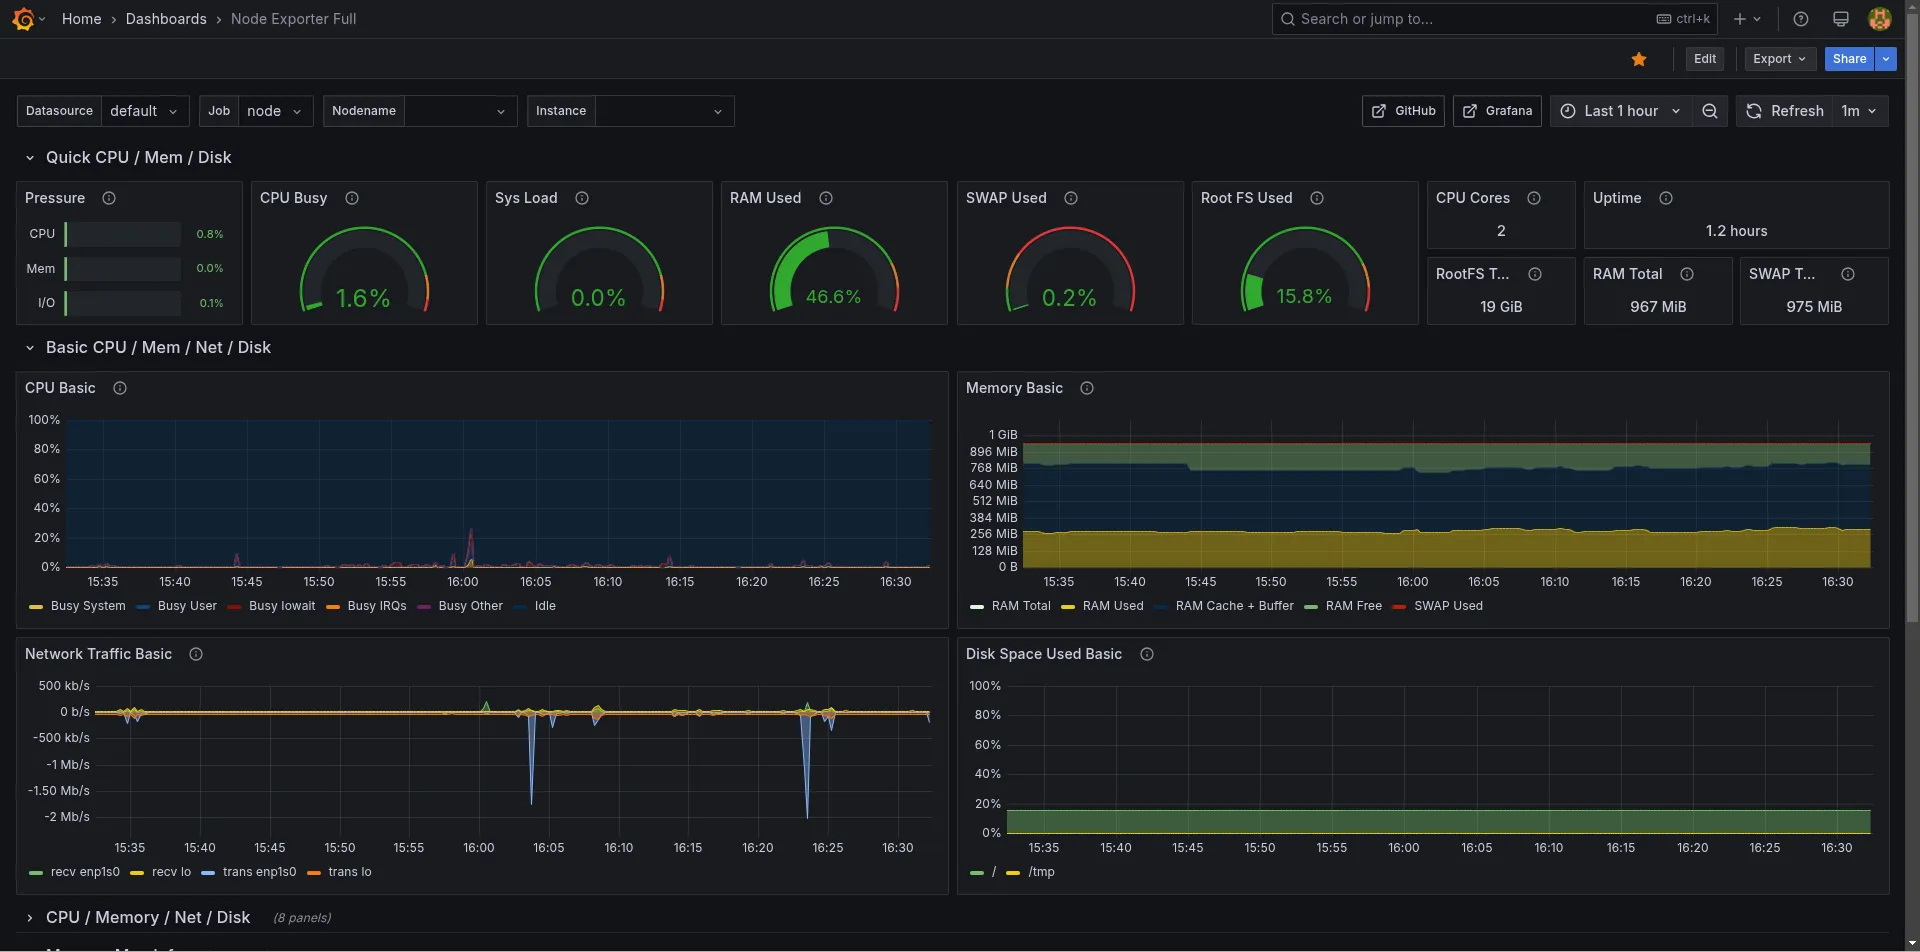
Les équipes qui font tourner Kubernetes, des conteneurs ou des groupes d’autoscaling, où les hôtes apparaissent et disparaissent plus vite que quiconque ne peut maintenir des fiches d’hôtes Zabbix. Prometheus collecte (scrape) les métriques des exporters et des applications, Grafana dessine les tableaux de bord et Alertmanager route les alertes.
Fonctionnalités notables
- Découverte de services : les cibles viennent de Kubernetes, Consul, EC2 et d’autres sources au lieu d’être ajoutées à la main.
- PromQL : un langage de requête pour les taux, les percentiles et les conditions d’alerte sur des séries temporelles.
- Exporters :
node_exporterpour Linux,windows_exporterpour Windows, et des exporters pour les bases de données, les files de messages et le matériel. - Alertmanager : regroupement, inhibition, mises en silence et routage vers des destinataires.
- Tableaux de bord Grafana : très répandus, avec des tableaux de bord communautaires pour la plupart des exporters.
Combien ça coûte ?
Prometheus (Apache 2.0) et Grafana (AGPLv3) sont gratuits en auto-hébergement. D’après les tarifs de Grafana Cloud, vérifiés le 28 septembre 2026 :
- Free : 10 000 séries de métriques actives, 50 Go de logs, 3 utilisateurs actifs, 14 jours de rétention
- Pro : 19 $/mois de frais de plateforme plus l’usage (6,50 $ pour 1 000 séries au-delà des 10 000 incluses), 13 mois de rétention des métriques
- Grafana IRM (astreinte) : à partir de 20 $ par utilisateur IRM actif et par mois sur Pro
Points d’attention
C’est une pile que vous assemblez : Prometheus, des exporters, Alertmanager, Grafana, puis Thanos, Mimir ou VictoriaMetrics quand le stockage local ne suffit plus. Chaque alerte est une requête PromQL que vous écrivez. Prometheus n’a pas de workflow pensé d’abord pour le SNMP comme Zabbix (il existe snmp_exporter, mais c’est à vous d’écrire la configuration) et Alertmanager n’a pas de plannings, ce qui explique que Grafana vende IRM à part.
Qui devrait envisager Prometheus + Grafana
Choisissez-le si vos charges de travail sont conteneurisées et que vos ingénieurs lisent déjà le PromQL. Pour un parc stable de VM, c’est en général plus de mécanique que Zabbix, pas moins. Pour une comparaison en version hébergée, voir Datadog vs Grafana Cloud.
Checkmk : le meilleur outil open source polyvalent, le plus proche de Zabbix
Pour qui est fait Checkmk
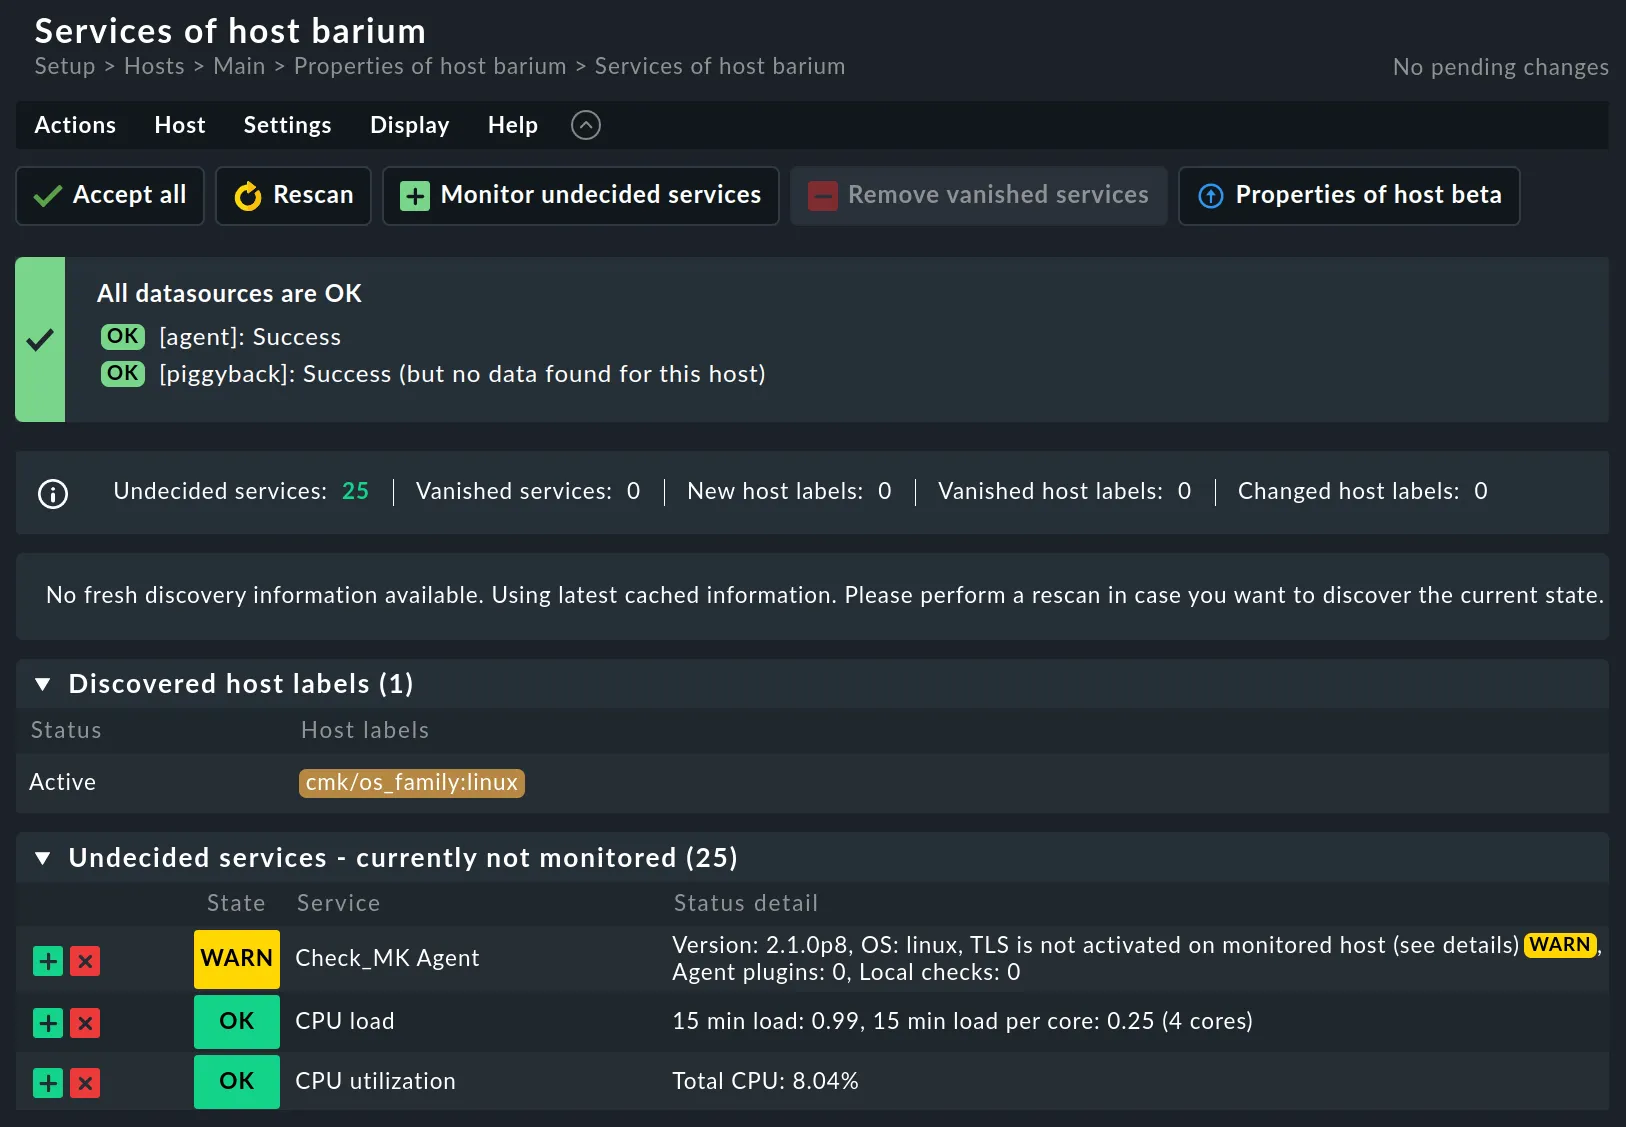
Les équipes ops qui veulent ce que couvre Zabbix (serveurs, équipements réseau, SNMP, seuils) avec moins de configuration faite à la main. L’agent Checkmk découvre les systèmes de fichiers, les interfaces, les services et les processus de chaque hôte et les transforme automatiquement en vérifications.
Fonctionnalités notables
- Découverte automatique des services sur Linux, Windows et les équipements réseau.
- Configuration par règles dans l’interface web : les seuils et les règles de notification s’appliquent à des dossiers et à des tags d’hôtes, pas à des hôtes individuels.
- Prise en charge du SNMP pour les switchs, routeurs et appliances.
- Compatibilité avec les plugins Nagios pour les vérifications personnalisées.
- Checkmk Cloud si vous ne voulez pas faire tourner le serveur.
Combien coûte Checkmk ?
D’après la page tarifs de Checkmk, vérifiée le 28 septembre 2026 (la tarification compte les services, environ 30 par hôte en moyenne) :
- Community : gratuit et open source, présenté pour environ 100 hôtes au maximum
- Pro (auto-hébergé) : à partir de 190 €/mois en facturation annuelle
- Ultimate (auto-hébergé) : à partir de 275 €/mois en facturation annuelle
- Checkmk Cloud (SaaS) : 240 €/mois en facturation mensuelle pour 1 000 services, ou 2 400 €/an (environ 200 €/mois) en facturation annuelle
Points d’attention
Le serveur Checkmk ne tourne que sous Linux, vous hébergez donc toujours quelque chose, sauf à payer Cloud. La tarification au service augmente avec ce que la découverte trouve sur chaque hôte. Les notifications reposent sur des règles et sont souples, mais les rotations d’astreinte passent toujours par une intégration comme PagerDuty plutôt que par Checkmk lui-même.
Qui devrait envisager Checkmk
Choisissez Checkmk si vous voulez rester en auto-hébergé et couvrir serveurs et équipements réseau, mais passer moins de temps à écrire des templates. Parmi les outils présentés ici, c’est celui qu’un administrateur Zabbix trouvera le plus familier.
Netdata : idéal pour des métriques à la seconde presque sans mise en place
Pour qui est fait Netdata
Les ingénieurs qui veulent installer un agent et voir immédiatement des métriques détaillées pour un hôte, sans définir d’items ni de templates. Netdata détecte automatiquement les services et collecte les métriques chaque seconde.
Fonctionnalités notables
- Collecte à la seconde, avec des milliers de métriques détectées automatiquement par hôte.
- Des tableaux de bord sans configuration pour l’hôte et les applications qu’il trouve.
- Détection d’anomalies par ML intégrée sur chaque métrique.
- Agent Windows natif en plus de Linux, macOS et des conteneurs.
- Alertes préconfigurées livrées avec l’agent.
Combien coûte Netdata ?
D’après la page tarifs de Netdata, vérifiée le 28 septembre 2026 :
- Community : gratuit, jusqu’à 5 nœuds connectés actifs et 1 tableau de bord personnalisé par room
- Homelab : 90 $/an pour des nœuds illimités, usage non commercial
- Business : 7 $/nœud/mois en facturation annuelle (8,75 $ en mensuel), avec RBAC, SSO, journaux d’audit et Netdata AI, essai de 14 jours
- Enterprise sur site : à partir de 200 nœuds, prix sur demande
Points d’attention
L’agent est sous GPLv3, mais l’expérience complète se trouve dans Netdata Cloud, et 5 nœuds gratuits, c’est juste pour qui remplace Zabbix. Netdata est conçu pour le dépannage en temps réel d’hôtes individuels plus que pour la planification de capacité à long terme. Les alertes notifient des canaux, mais il n’y a ni planning d’astreinte ni page de statut.
Qui devrait envisager Netdata
Choisissez Netdata si vous voulez une visibilité fine et en temps réel sur vos hôtes sans mise en place, et qu’un abonnement par nœud au-delà de 5 nœuds ne vous gêne pas.
Datadog : idéal pour une observabilité complète

Pour qui est fait Datadog
Les équipes d’ingénierie qui ont besoin de corréler métriques d’infrastructure, APM, tracing, logs et tests synthétiques au même endroit, et qui ont le budget pour une tarification à l’hôte, au Go et au siège.
Fonctionnalités notables
- Monitoring d’infrastructure avec plus de 1 000 intégrations et 15 mois de rétention des métriques en Pro.
- APM, logs, RUM et tests synthétiques sur la même plateforme.
- Datadog On-Call pour les plannings et les escalades, vendu séparément.
- Agents natifs pour Linux, Windows, macOS et les conteneurs.
Combien coûte Datadog ?
D’après la page tarifs de Datadog, vérifiée le 28 septembre 2026 :
- Free : jusqu’à 5 hôtes avec 1 jour de rétention des métriques
- Infrastructure Pro : 15 $/hôte/mois en facturation annuelle, 18 $ à la demande
- Infrastructure Enterprise : 23 $/hôte/mois en facturation annuelle, 27 $ à la demande
- APM : à partir de 31 $/hôte/mois en plus
- Log management : à partir de 0,10 $ par Go ingéré, plus l’indexation
On-Call est facturé au siège, comme un produit séparé. Je n’ai pas trouvé son prix sur la page tarifs publique le 28 septembre 2026.
Points d’attention
Datadog remplace Zabbix et plusieurs autres outils à la fois, mais la facture additionne hôtes, métriques personnalisées, logs, exécutions de tests synthétiques et sièges. Les équipes qui viennent d’un Zabbix gratuit ont souvent du mal à justifier le saut quand elles n’ont besoin que de la santé des hôtes. Notre comparatif Hyperping vs Datadog et notre guide des alternatives à Datadog passent les chiffres en revue.
Qui devrait envisager Datadog
Choisissez Datadog s’il vous faut l’APM et les logs à côté des métriques d’hôte et que votre équipe s’en servira. Pour « l’hôte va-t-il bien et qui est alerté », vous paierez pour beaucoup de plateforme que vous ne toucherez pas.
Site24x7 : le meilleur tout-en-un hébergé bon marché pour les petites équipes IT
Pour qui est fait Site24x7
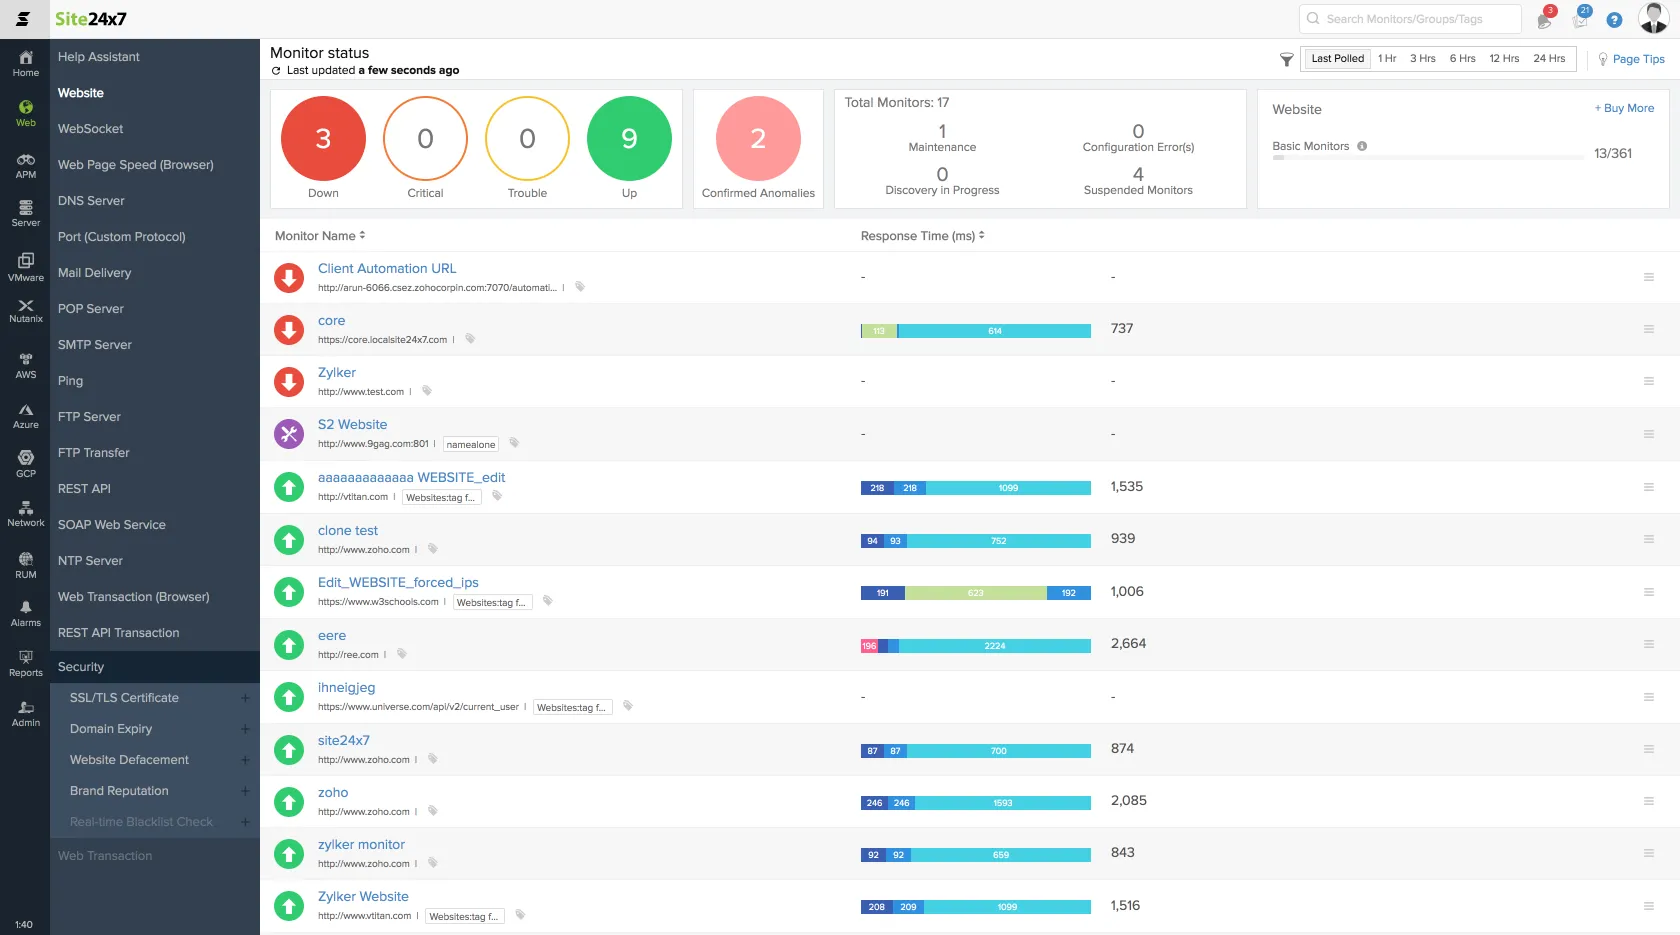
Les petites équipes IT et les MSP qui veulent surveiller serveurs, sites web et quelques équipements réseau depuis un outil hébergé, avec un prix d’entrée bas. Site24x7 fait partie de la famille ManageEngine de Zoho.
Fonctionnalités notables
- Agents serveur pour Windows et Linux, plus le monitoring des sites web, des API et du réseau depuis le même compte.
- Monitoring réseau inclus dans les offres supérieures (10 composants réseau en Professional).
- Gestion des logs en Professional (4 Go d’ingestion inclus).
- Offres MSP pour gérer plusieurs clients.
- StatusIQ, un produit Site24x7 séparé, pour les pages de statut publiques.
Combien coûte Site24x7 ?
D’après la page tarifs de Site24x7, offres infrastructure, vérifiée le 28 septembre 2026 :
- Free : offre gratuite à vie avec alertes par email pour un petit nombre de ressources
- Lite : 9 $/mois en facturation annuelle (10 $ en mensuel) pour 2 serveurs, 5 sites web et 25 ressources enfants
- Professional : 42 $/mois en facturation annuelle (49 $ en mensuel) pour 5 serveurs, 1 application, 20 sites web et 10 composants réseau
- Enterprise : à partir de 625 $/mois en facturation annuelle
- Essai gratuit de 30 jours, sans carte bancaire
Points d’attention
Le prix d’entrée est bas, mais les offres se construisent à partir de nombres de ressources et d’options, si bien que la facture grimpe par paliers à mesure que vous ajoutez serveurs, sites web et volume de logs. Les pages de statut sont un produit séparé, et le planning d’astreinte reste basique comparé à un outil d’alerte d’astreinte dédié.
Qui devrait envisager Site24x7
Choisissez Site24x7 si vous voulez un outil hébergé qui couvre serveurs, sites web et quelques équipements réseau pour un petit budget, et que vous utilisez déjà d’autres produits Zoho ou ManageEngine.
Les autres outils que j’ai envisagés
- Icinga : un bon choix si vous venez de plugins à la Nagios plutôt que de Zabbix. Toujours auto-hébergé.
- LibreNMS : gratuit et solide sur les équipements réseau SNMP, plus faible sur les serveurs et les applications.
- PRTG : son serveur principal tourne sous Windows, ce que certains environnements Windows préfèrent, mais il est tarifé au capteur et reste quelque chose que vous hébergez.
Quand Zabbix reste le meilleur choix
Je garderais Zabbix, ou du moins je ne le remplacerais pas en bloc, dans ces cas :
- Grands parcs sur site : des milliers d’hôtes répartis sur plusieurs sites, avec des proxys Zabbix qui collectent localement. Zabbix gère cela sans coût de licence.
- Réseaux très dépendants du SNMP : switchs, routeurs, pare-feux, onduleurs et imprimantes. Aucun des outils hébergés présentés ici n’égale les templates SNMP et la découverte de bas niveau (low-level discovery) de Zabbix.
- Environnements isolés du réseau (air-gapped) ou réglementés, où les données ne peuvent pas quitter le réseau.
- Items et logique de triggers personnalisés : si votre équipe a investi des années dans des user parameters, des triggers de tendance et des dépendances, ce travail ne se transpose proprement nulle part.
Une voie médiane courante : garder Zabbix pour les équipements réseau et les métriques d’hôte détaillées, et passer les vérifications de disponibilité, l’alerte d’astreinte et la communication client sur un outil hébergé. Ainsi, la partie qui doit fonctionner à 3 h du matin ne dépend plus du serveur que vous maintenez.
Quelle alternative à Zabbix choisir ?
- Vous ne voulez rien héberger, et l’alerte d’astreinte et les pages de statut comptent le plus : Hyperping.
- Vous faites tourner Kubernetes ou des conteneurs et vous connaissez PromQL : Prometheus + Grafana.
- Vous voulez rester en auto-hébergé avec serveurs et équipements réseau, avec moins de configuration : Checkmk.
- Vous voulez des métriques d’hôte en temps réel sans aucune mise en place, sur quelques nœuds : Netdata.
- Il vous faut l’APM, les logs et les traces à côté des métriques d’hôte : Datadog.
- Vous êtes une petite équipe IT ou un MSP avec un budget serré : Site24x7.
- Votre parc est sous Windows et vous ne voulez pas d’une machine Linux rien que pour le monitoring : un outil hébergé avec un agent Windows natif (Hyperping, Datadog ou Site24x7). Le serveur Zabbix lui-même ne tourne pas sous Windows.
Côté budget : Checkmk Community, Prometheus et Zabbix lui-même sont gratuits si vous avez quelqu’un pour les faire tourner. Parmi les outils hébergés, Hyperping Essentials (24 $/mois en facturation annuelle pour 5 serveurs) et Site24x7 Lite (9 $/mois en facturation annuelle pour 2 serveurs) sont les points d’entrée les moins chers, tandis que Datadog se facture par hôte à partir de 15 $/mois.
Comment utiliser Hyperping à la place de Zabbix
Inutile de tout couper d’un coup. Les étapes ci-dessous font passer sur Hyperping la détection des hôtes hors ligne, les vérifications de disponibilité, l’alerte d’astreinte et la communication client, pendant que Zabbix continue de tourner jusqu’à ce que vous ayez confiance dans la nouvelle installation. Pour en savoir plus sur les métriques elles-mêmes, le guide du monitoring des serveurs Linux est un bon complément.
1. Installer l’agent Hyperping sur vos serveurs
Dans Hyperping, ouvrez Servers, cliquez sur Add server et copiez la commande d’installation. Elle contient votre jeton d’installation. Sur un hôte Linux ou macOS :
curl -fsSL https://hyperping.com/install.sh | sh -s -- \
  HP_INSTALL_xxxxx \
  --name "web-01" \
  --group web-tier
Sous Windows 10 ou Windows Server 2016 et versions ultérieures, depuis un PowerShell ouvert avec Exécuter en tant qu’administrateur :
& ([scriptblock]::Create((irm https://hyperping.com/install.ps1))) HP_INSTALL_xxxxx `
  -Name "web-01" `
  -Group web-tier
Vérifiez que le service tourne :
sudo systemctl status hp-agent.serviceLes lignes à repérer :
     Loaded: loaded (/etc/systemd/system/hp-agent.service; enabled)
     Active: active (running) since Mon 2026-09-28 10:14:02 UTC; 41s ago
Sous Windows, Get-Service hp-agent doit afficher Running. Le serveur apparaît dans le tableau de bord avec ses graphiques CPU, mémoire, disque et réseau en 30 secondes environ. Vous pouvez lancer la même commande sur tout le parc depuis Ansible ou votre outil de gestion de configuration, à côté de l’agent Zabbix, que vous retirerez plus tard. La référence d’installation couvre les jetons d’installation liés et le réenrôlement.
2. Associer une politique d’escalade à chaque serveur
Ouvrez le serveur, allez dans le panneau Alerting et choisissez la politique d’escalade à alerter quand cet hôte se tait. Réglez le seuil de mise hors ligne : 90 secondes par défaut, 60 secondes minimum. Choisissez une durée supérieure à la pire coupure réseau que vous attendez.
Si vous n’avez pas encore de politique, créez-en une dans les politiques d’escalade : par exemple Slack immédiatement, puis un appel téléphonique au planning d’astreinte après 5 minutes, puis le responsable d’équipe après 15. Pour associer la politique dès l’installation, passez plutôt --policy <policy-uuid> à la commande d’installation.
Testez la chaîne de bout en bout sur un serveur non critique :
sudo systemctl stop hp-agent.serviceUne fois le seuil de mise hors ligne dépassé, une panne s’ouvre et la politique alerte ses canaux. Redémarrez l’agent et la notification de rétablissement part vers les mêmes canaux.
3. Ajouter des vérifications de disponibilité pour les services que Zabbix pinguait
Listez les scénarios web, les simple checks (icmpping, net.tcp.service) et les items HTTP agent que vous avez dans Zabbix. Recréez ceux qui visent des services, et non l’intérieur des hôtes, sous forme de moniteurs Hyperping :
- Les scénarios web et les items HTTP agent de Zabbix deviennent des moniteurs HTTP, avec codes de statut attendus et vérification de mots-clés.
- Les simple checks
icmppingdeviennent des moniteurs ping. - Les vérifications
net.tcp.servicesur les ports de base de données ou SMTP deviennent des moniteurs de port. - Les scripts planifiés que Zabbix surveillait via des items trapper deviennent des heartbeats cron.
Par défaut, les moniteurs s’exécutent toutes les 30 secondes depuis plusieurs régions, ce qui réduit les fausses alertes dues à un seul chemin réseau. Routez-les vers les mêmes politiques d’escalade que vos serveurs, pour n’avoir qu’un seul endroit où changer qui est alerté.
4. Publier une page de statut
Créez une page de statut, ajoutez-y les moniteurs qui comptent pour vos clients (API, tableau de bord, connexion) et faites pointer un domaine personnalisé dessus. Quand une panne s’ouvre, vous y publiez l’incident et les abonnés sont prévenus par email, sans outil de page de statut séparé.
Une fois que les deux systèmes ont tourné côte à côte pendant une semaine ou deux et que Hyperping a détecté ce que Zabbix détectait, retirez les actions et vérifications Zabbix qu’il couvre désormais. Gardez Zabbix pour les équipements réseau ou les items personnalisés si vous en avez encore besoin.
Conclusion
Zabbix reste l’un des outils de monitoring gratuits les plus complets, et pour les grands parcs sur site ou les réseaux très dépendants du SNMP, il est difficile à battre. La plupart des équipes qui partent ne manquent pas de fonctionnalités. Elles en ont assez de faire tourner le serveur, la base de données et les templates, et de brancher par-dessus un outil d’alerte d’astreinte et une page de statut séparés.
Si vos charges de travail sont conteneurisées, Prometheus et Grafana sont le choix open source naturel. Si vous voulez rester en auto-hébergé avec moins de configuration, Checkmk est l’équivalent le plus proche. Si vous voulez la santé des hôtes, des vérifications de disponibilité, l’astreinte et des pages de statut sans rien héberger, créez un compte Hyperping gratuit et installez l’agent sur un serveur pour le comparer à ce que Zabbix vous montre aujourd’hui.
Pour aller plus loin : Hyperping vs Netdata · Hyperping vs Datadog · Tarifs de Hyperping · Tous les comparatifs
Questions fréquentes
Quelle est la meilleure alternative gratuite à Zabbix ? ▼
Si vous voulez auto-héberger, Checkmk Community et Prometheus avec Grafana sont gratuits et sans limite d’hôtes, mais vous faites toujours tourner un serveur et une base de données ou un stockage de séries temporelles. Si vous ne voulez rien héberger, Hyperping Free couvre 1 agent serveur et 20 moniteurs de disponibilité, Netdata Community couvre 5 nœuds, l’offre gratuite de Datadog couvre 5 hôtes avec 1 jour de rétention, et Site24x7 propose une offre gratuite pour les petites installations.
Quelles sont les meilleures alternatives open source à Zabbix ? ▼
Prometheus (Apache 2.0) avec Grafana (AGPLv3) est la principale alternative open source pour les charges de travail centrées sur les métriques et les conteneurs. Checkmk Community (GPLv2) est le plus proche de Zabbix en périmètre, avec découverte automatique par agent et SNMP. L’agent Netdata (GPLv3) fournit des métriques à la seconde sans configuration. Icinga et LibreNMS méritent aussi un coup d’œil pour les vérifications à base de plugins et les équipements réseau.
Quelle alternative à Zabbix choisir sous Windows ? ▼
Le serveur Zabbix lui-même ne tourne pas sous Windows : sa documentation ne cite que des systèmes de type Unix, si bien que les environnements Windows font souvent tourner une VM Linux rien que pour Zabbix. Hyperping, Datadog et Site24x7 sont hébergés, il n’y a donc aucun serveur à faire tourner, et tous trois fournissent des agents Windows natifs. Checkmk et Netdata ont aussi des agents Windows, et Prometheus passe par windows_exporter.
Zabbix ou Prometheus : lequel choisir ? ▼
Zabbix convient aux parcs stables de serveurs et d’équipements réseau : il réunit dans un seul paquet des templates, l’interrogation SNMP, une interface web de configuration et des triggers à seuil. Prometheus convient à une infrastructure dynamique et conteneurisée : il découvre ses cibles via Kubernetes ou les API cloud, stocke efficacement les séries temporelles et utilise PromQL pour les requêtes et les alertes, mais c’est à vous d’assembler la pile (exporters, Alertmanager, Grafana, stockage longue durée).
Zabbix vaut-il encore le coup en 2026 ? ▼
Oui, pour la bonne équipe. Zabbix 7.0 LTS bénéficie d’un support complet jusqu’en juin 2027, la 8.0 LTS est prévue pour le troisième trimestre 2026, et il reste l’un des outils gratuits les plus complets pour les grands parcs sur site et les réseaux très dépendants du SNMP. Il convient mal quand personne ne veut prendre en charge le serveur, la base de données et les templates, ou quand le vrai besoin est d’alerter la bonne personne et d’informer les clients.
Combien coûte Zabbix Cloud par rapport aux alternatives ? ▼
Zabbix Cloud démarre à 50 $/mois pour le palier Nano (50 nouvelles valeurs par seconde) et monte jusqu’à 5 000 $/mois, avec 10 % de remise sur les offres annuelles. À titre de comparaison, Hyperping Essentials coûte 24 $/mois en facturation annuelle pour 5 agents serveur et 50 moniteurs, Checkmk Cloud 240 €/mois en facturation mensuelle (2 400 €/an en facturation annuelle), et Datadog Infrastructure Pro 15 $ par hôte et par mois en facturation annuelle.