De beste Zabbix alternatieven in 2026 zijn Hyperping (gehoste server- en uptime-monitoring met piketdienst en statuspagina’s inbegrepen), Prometheus met Grafana (open source metrics voor containers en cloud-native stacks), Checkmk (het open source alternatief dat qua reikwijdte het dichtst bij Zabbix komt, met auto-discovery), Netdata (metrics per seconde zonder configuratie), Datadog (volledige observability met APM en logs) en Site24x7 (goedkope gehoste all-in-one monitoring).
Zabbix is niet kapot. Het is gratis, het schaalt, en Zabbix 7.0 LTS wordt ondersteund tot 2027. Teams vertrekken vanwege wat het kost om het te draaien: een Linux-server, een MySQL- of PostgreSQL-database om te dimensioneren en te tunen, templates en triggers om te onderhouden, en een alertinglaag die wel meldingen stuurt maar niet regelt wie er piketdienst heeft.
In deze gids lees je:
- Waarom teams Zabbix vervangen, op basis van reviews en de eigen documentatie van Zabbix
- Zes alternatieven, met prijzen gecontroleerd op 28 september 2026, hostingmodel en installatie-inspanning
- Welke open source zijn, welke gratis zijn en welke het best werken voor Windows-omgevingen
- Waar Zabbix nog steeds de betere keuze is, en hoe je het oproepen van mensen eruit haalt zonder grote migratie
Belangrijkste conclusies
- De Zabbix-server draait alleen op Unix-achtige systemen en vraagt 2 CPU-cores en 8 GiB geheugen, zelfs voor de "kleine" referentieopstelling met 1.000 metrics, plus een database die je zelf onderhoudt.
- Prometheus + Grafana is het sterkste gratis alternatief voor containers en Kubernetes. Checkmk komt als gratis tool het dichtst in de buurt voor gemengde omgevingen met servers en netwerkapparatuur.
- Hyperping neemt de hostgezondheid en het oproepen over zonder dat je iets hoeft te hosten: een agent met één commando voor Linux, macOS en Windows, piketroosters en statuspagina’s, vanaf € 24 per maand bij jaarlijkse facturatie.
- Datadog begint bij $ 15 per host per maand bij jaarlijkse facturatie en is zinvol als je APM en logs nodig hebt. Site24x7 begint bij $ 9 per maand bij jaarlijkse facturatie voor kleine omgevingen.
- Zabbix blijft de betere keuze voor grote on-premises omgevingen, netwerkapparatuur met veel SNMP en air-gapped locaties.
Waarom je deze gids kunt vertrouwen
Ik ben Léo, oprichter van Hyperping. Ik heb dus belang bij een van deze tools, en Hyperping staat bovenaan. Ik heb geprobeerd precies te zijn over waar het tekortschiet, want het doet niet alles wat Zabbix doet: geen SNMP-polling, nog geen alerts op drempelwaarden van metrics en geen self-hosted editie.
Voor de andere tools heb ik op 28 september 2026 de prijzen gecontroleerd op de officiële prijspagina van elke leverancier, de installatie-eisen en het releasebeleid van Zabbix gelezen en de Capterra-reviews van Zabbix doorgenomen. Ik heb ook de terugkerende threads "Zabbix is te complex voor mijn setup" op r/sysadmin en r/zabbix gelezen, maar ik citeer reviews van Capterra omdat daar een functie van de reviewer bij staat die ik kan vermelden. Waar ik iets niet kon verifiëren, zeg ik dat.
Topkeuzes in één oogopslag
| Beste voor | Product |
|---|---|
| Gehoste servermonitoring met piketdienst en statuspagina’s inbegrepen | Hyperping |
| Monitoring rond metrics voor containers en Kubernetes | Prometheus + Grafana |
| Open source allrounder die het dichtst bij Zabbix komt, met auto-discovery | Checkmk |
| Hostmetrics per seconde met vrijwel geen configuratie | Netdata |
| Volledige observability met APM, logs en traces | Datadog |
| Goedkope gehoste monitoring voor kleine IT-teams | Site24x7 |
Waarom teams Zabbix verlaten
Zabbix bestaat sinds 2001 en dekt veel: agents, SNMP, IPMI, JMX, webscenario’s, templates voor honderden apparaten en een triggertaal voor drempelwaarden en trends. De klachten die ik vond gaan zelden over ontbrekende functies. Ze gaan over wat het kost om dat allemaal te beheren.
De server, de database en de frontend draai je zelf
De pagina met de vereisten van Zabbix 7.4 noemt Linux, BSD, macOS, AIX, Solaris en HP-UX voor de server. Windows staat er niet tussen. Je kiest MySQL, MariaDB, PostgreSQL of PostgreSQL met TimescaleDB, en de referentiedimensionering begint bij 2 CPU-cores en 8 GiB geheugen voor ongeveer 1.000 metrics, oplopend tot 16 cores en 64 GiB voor 100.000.
Dan heb je het nog niet over housekeeping, partitionering, back-ups en upgrades naar een nieuwe hoofdversie. Het monitoringsysteem wordt nog een productiesysteem dat iemand gezond moet houden, en als het uitvalt, valt je alerting mee uit.
Templates en triggers vragen echte expertise
In Zabbix is een check een item, een voorwaarde een trigger, een melding een action, en dat alles komt meestal uit een template die je importeert, kloont en aanpast. Dat is flexibel, maar het zijn veel concepten voor iemand die gewoon wil weten wanneer een schijf vol is.
Uit Capterra-reviews van Zabbix:
"Zowel de installatie als de configuratie van Zabbix heeft een steile leercurve, vooral als je eigen sensoren nodig hebt."
Infrastructure engineer, onderwijs
"Sommige configuraties kunnen lastig zijn als je niet veel documentatie leest."
ICT-specialist, IT-dienstverlening
Een andere reviewer, een infrastructure engineer in de luchtvaart, wees erop dat het vinden van werkende modules en templates aan de beheerder wordt overgelaten, en dat ze niet altijd werken. Dat klopt met wat ik in Reddit-threads las: mensen die Zabbix prima vinden zodra het eenmaal getuned is, en mensen met tien servers die het overkill vinden.
De alerting houdt op bij meldingen
Zabbix-actions ondersteunen escalatiestappen: een gebruikersgroep waarschuwen, wachten, een andere groep waarschuwen, een remote command uitvoeren. De mediatypes dekken e-mail, sms, Slack, Teams, PagerDuty en meer. Wat ontbreekt is een piketkalender: roosters, vervanging bij een ziektedag en bevestigen vanaf je telefoon om de volgende stap te stoppen.
Daarom voegen Zabbix-gebruikers meestal een tool voor het oproepen toe (PagerDuty, Opsgenie, dat op 5 april 2027 stopt, zie onze gids over het einde van Opsgenie, of Grafana IRM). En klanten horen van storingen via supporttickets, want Zabbix heeft geen openbare statuspagina. Dat zijn drie tools om te koppelen en synchroon te houden.
Zabbix Cloud neemt de hosting weg, niet de configuratie
Zabbix Cloud draait de server voor je, van $ 50 per maand (Nano, 50 nieuwe waarden per seconde) tot $ 5.000 per maand (10.000 waarden per seconde), met 10% korting op jaarabonnementen en een proefperiode van 5 dagen. Het lost de database en de upgrades op. Templates, items, triggers en actions bouw je nog steeds op de Zabbix-manier.
Snelle vergelijking: Zabbix alternatieven
| Tool | Startprijs | Hosting | Installatie-inspanning | Alerting en piketdienst | Windows |
|---|---|---|---|---|---|
| Hyperping | Gratis; € 24 per maand bij jaarlijkse facturatie | Gehost (SaaS) | Laag: één commando per host | Piketroosters, escalatiebeleid, telefoon/sms/Slack/Teams, statuspagina’s inbegrepen | Native agent (Windows 10 / Server 2016+) |
| Prometheus + Grafana | Gratis; Grafana Cloud Pro $ 19 per maand + gebruik | Self-hosted of Grafana Cloud | Hoog | Routing via Alertmanager; Grafana IRM voor piketdienst ($ 20 per actieve gebruiker) | windows_exporter |
| Checkmk | Gratis Community; Pro vanaf € 190 per maand bij jaarlijkse facturatie | Self-hosted (Linux) of Checkmk Cloud | Gemiddeld | Meldingen op basis van regels; oproepen via integraties | Native agent |
| Netdata | Gratis (5 nodes); Business $ 7 per node per maand bij jaarlijkse facturatie | Agent + Netdata Cloud, of on-prem | Laag | Alertmeldingen; geen piketroosters | Native agent |
| Datadog | Gratis (5 hosts); $ 15 per host per maand bij jaarlijkse facturatie | Gehost (SaaS) | Laag tot gemiddeld | Monitors + apart On-Call-product, per seat | Native agent |
| Site24x7 | Gratis abonnement; $ 9 per maand bij jaarlijkse facturatie | Gehost (SaaS) | Laag | Alertprofielen, eenvoudige piketdienst; statuspagina’s in een apart product (StatusIQ) | Native agent |
| Zabbix (ter referentie) | Gratis; Cloud vanaf $ 50 per maand | Self-hosted (Unix-achtig) of Zabbix Cloud | Gemiddeld tot hoog | Actions met escalatiestappen; geen piketkalender | Alleen de agent; de server draait niet op Windows |
Hyperping: Beste keuze voor gehoste monitoring met ingebouwde piketdienst en statuspagina’s
Voor wie Hyperping bedoeld is
Teams met een paar tot een paar honderd servers die geen monitoringserver willen onderhouden, en bij wie het grootste gat zit in wat er gebeurt nadat iets faalt: wie wordt opgeroepen, wat er gebeurt als die niet opneemt, en hoe klanten het te horen krijgen.
Hyperping is geen één-op-één vervanging van Zabbix. Het pollt geen switches via SNMP en evalueert geen trigger-expressies. Het dekt waar de meeste kleine en middelgrote teams Zabbix echt voor gebruiken (leeft de host nog, hoe staan CPU, geheugen en schijf ervoor, antwoordt de service) en voegt de laag voor oproepen en statuspagina’s toe die Zabbix aan andere tools overlaat.
Opvallende functies
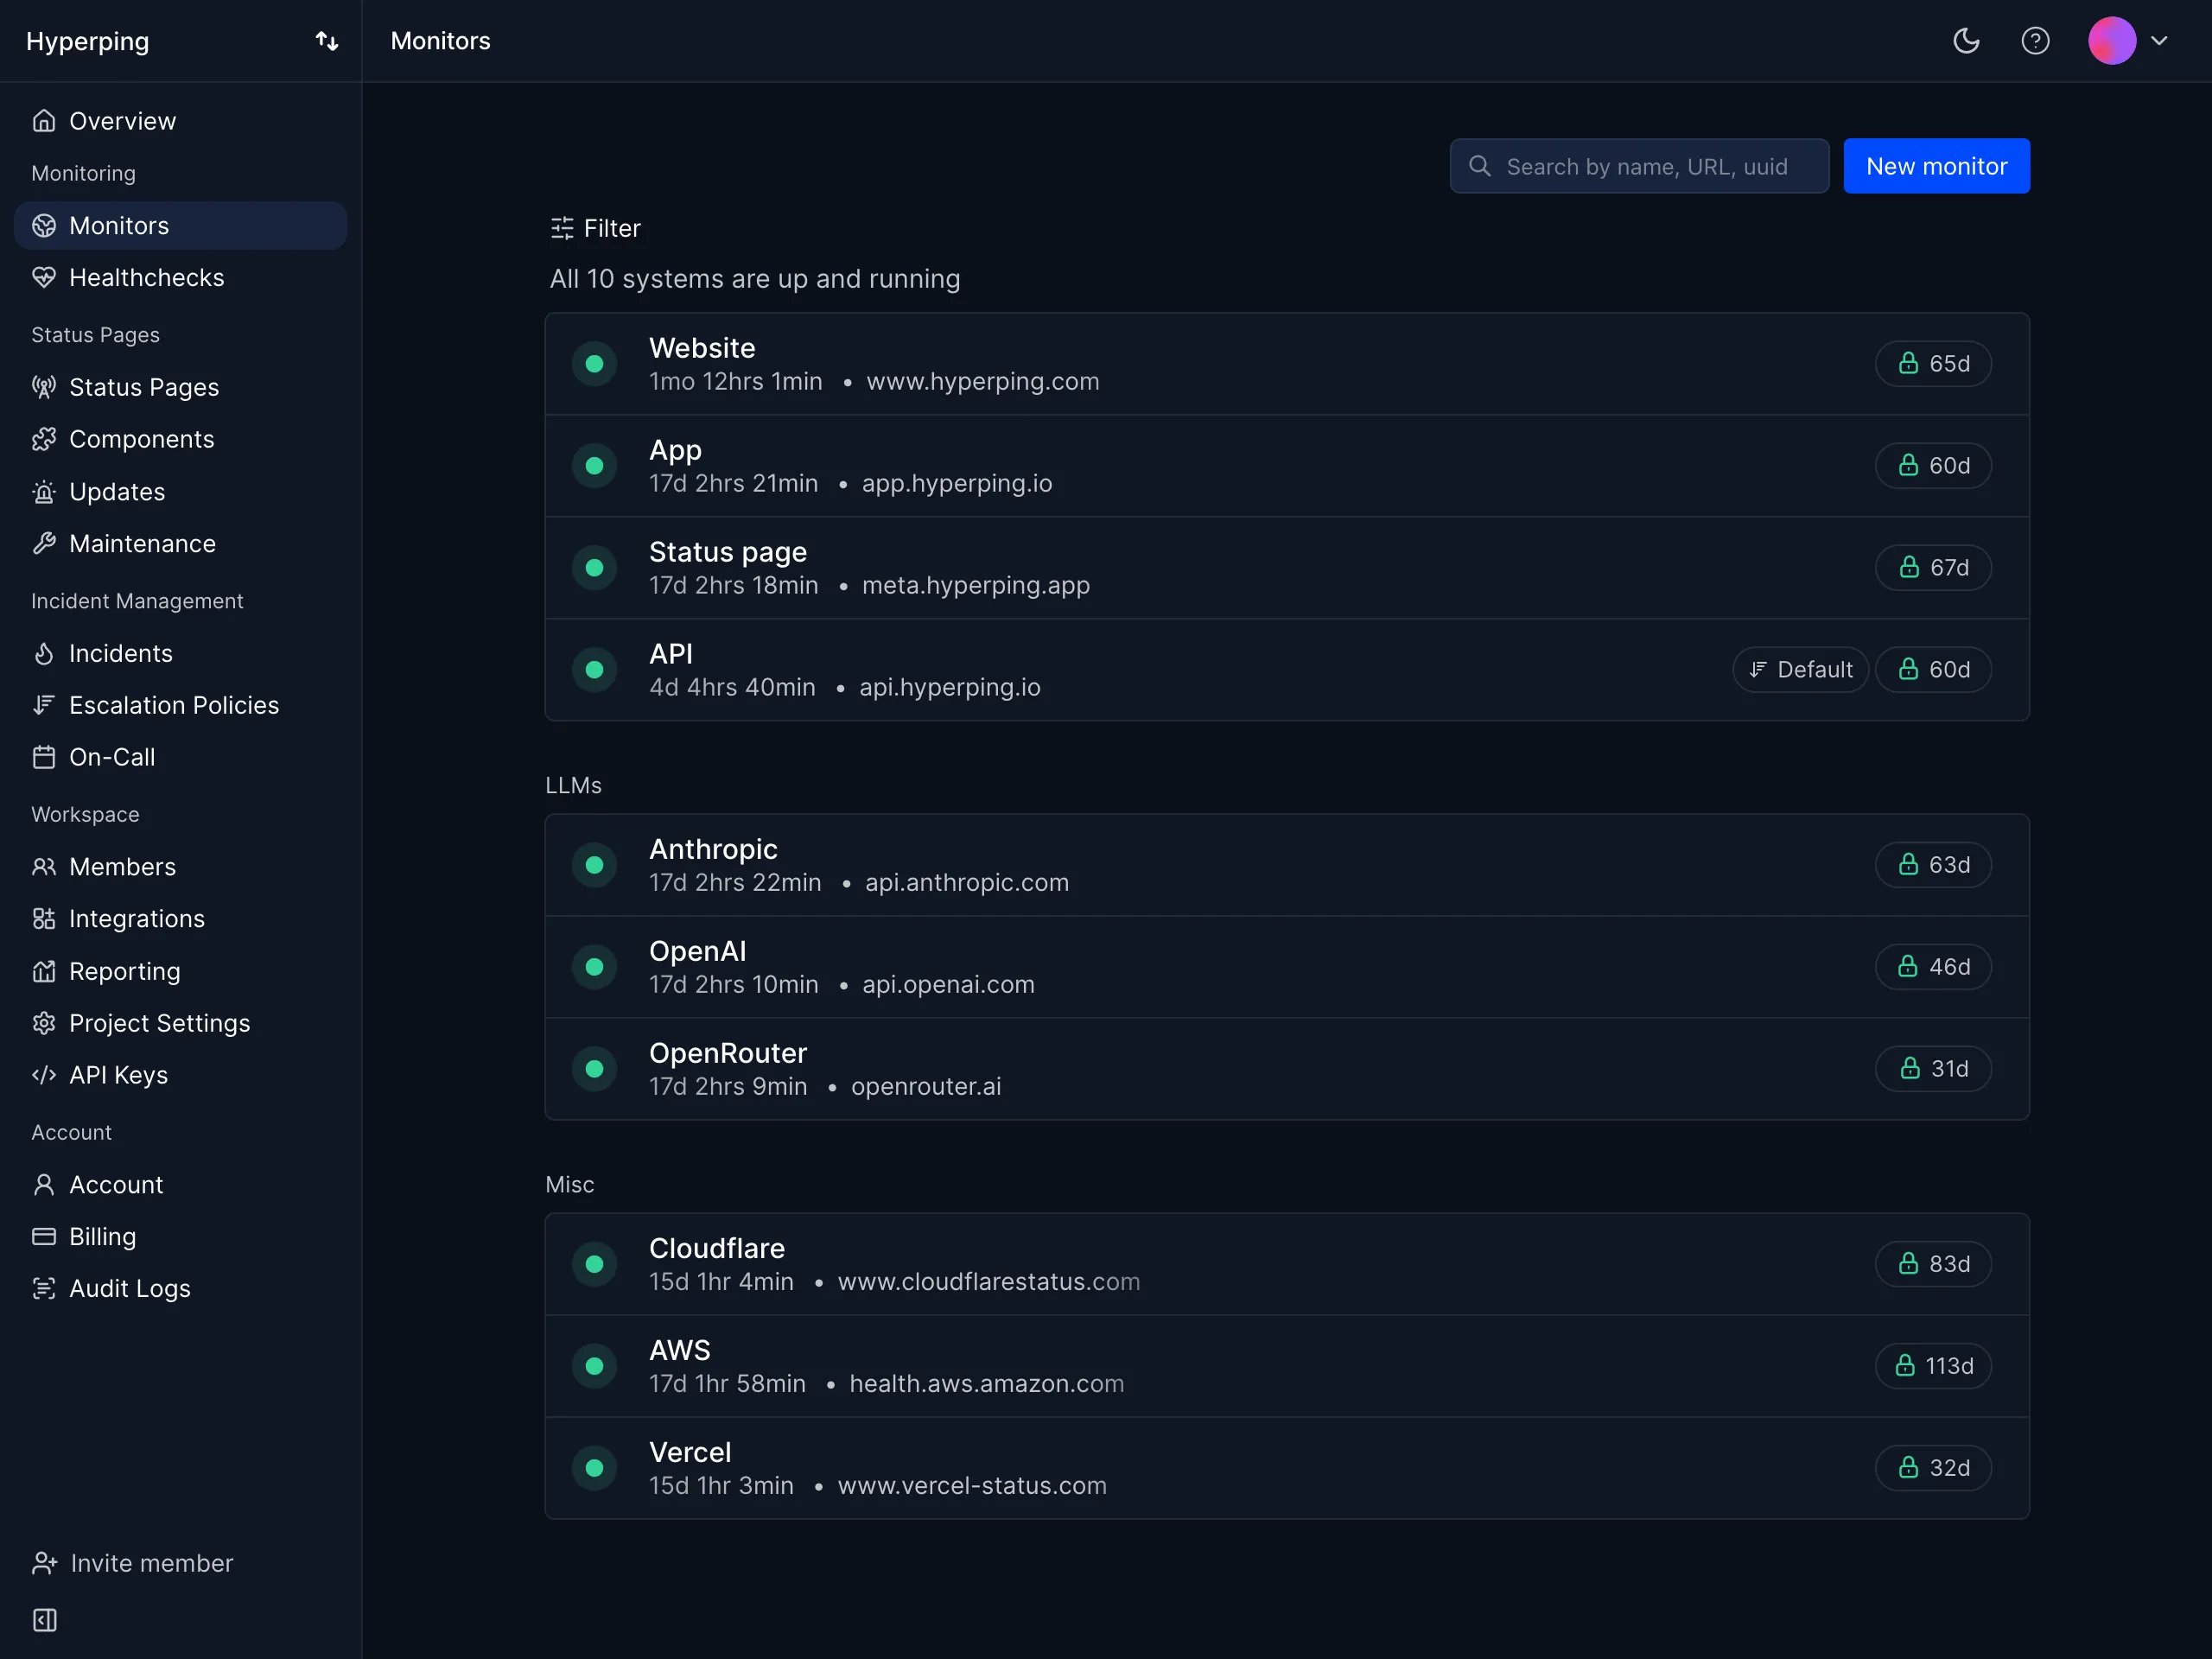
- Agent van één regel voor Linux, macOS en Windows: Eén commando registreert een systemd-, launchd- of Windows-service. De agent draait op amd64 en arm64 (amd64 op Windows), is één binary met een ingebouwde OpenTelemetry-collector die ongeveer 50 MB geheugen gebruikt, en heeft alleen uitgaand HTTPS nodig. Zie de installatiereferentie van de agent.
- Hostmetrics elke 30 seconden: CPU per toestand met load averages over 1, 5 en 15 minuten, geheugen per toestand, gebruikte en vrije ruimte per mount, gelezen en geschreven bytes per schijf, inkomende en uitgaande bytes per netwerkinterface, en hostmetadata (OS, kernel, CPU-model, opstarttijd).
- Geen templates nodig: De server verschijnt met zijn grafieken ongeveer 30 seconden na de installatie. Met flags als
--name,--policyen--groupkan Ansible of Terraform een hele vloot inschrijven, vanaf de eerste run met het juiste escalatiebeleid. - Offline-detectie die de piketdienst oproept: Als een server langer dan zijn offline-drempel niets meer rapporteert (standaard 90 seconden, minimaal 60 seconden, per server in te stellen), wordt een storing geopend en roept het gekoppelde escalatiebeleid zijn kanalen op: e-mail, sms, telefoonoproepen, Slack, Teams, PagerDuty, webhooks of een piketrooster. Details in alerting voor servers.
- Uptime-monitors in hetzelfde account: HTTP-, ping-, poort- en keyword-checks vanuit 18 regio’s, standaard elke 30 seconden, plus dagelijkse controles van SSL-certificaten en cron-heartbeats. Die vervangen Zabbix-webscenario’s en simple checks op je publieke endpoints.
- Piketroosters en escalatiebeleid: Inbegrepen vanaf Essentials en gedeeld door servers en monitors. Zie piketdienst.
- Statuspagina’s: Pagina’s in je eigen huisstijl met abonnees, zodat het incident waarvoor je engineer werd opgeroepen ook voor klanten gepubliceerd kan worden. Zie statuspagina’s.
- Geen gaten na een netwerkhapering: De agent zet niet-verzonden metrics in een wachtrij op schijf en probeert opnieuw, zodat korte storingen bij de ingest of een reboot geen gaten in de grafieken achterlaten.
Waarom Hyperping kiezen in plaats van Zabbix?
Niets te hosten, te dimensioneren of te upgraden
Zabbix heeft een server, een database, een webfrontend en iemand nodig die ze upgradet. Met Hyperping is de agent het enige op je hosts. Het scenario waarin de monitoringmachine tegelijk uitvalt met wat ze bewaakt, verdwijnt.
Oproepen hoort bij het product
In Zabbix pas je gebruikersgroepen of actions aan om te wijzigen wie piketdienst heeft. In Hyperping definieer je één keer een rooster en een escalatiebeleid, en elke stap heeft een eigen vertraging en eigen kanalen, zodat een onbeantwoorde oproep doorschuift naar de volgende persoon. Onze gids over escalatiebeleid en gids over piketroosters leggen uit hoe je ze opzet.
Klanten horen het van jou
Zabbix heeft geen statuspagina. Met Hyperping kan dezelfde storing op een statuspagina komen die abonnees per e-mail op de hoogte brengt, zonder derde tool.
Is je Zabbix-setup gekrompen tot "laat me weten wanneer een machine uitvalt en maak de juiste persoon wakker", en wil niemand nog eigenaar zijn van de database erachter? Dan is het logischer om opgeroepen te worden als een server stil valt, zonder een monitoringserver te draaien dan de stack te blijven onderhouden.
Wat Hyperping-gebruikers zeggen
"We hebben onze Hyperping-statuspagina openbaar gemaakt en die werd een essentieel onderdeel van onze salespitches. We zijn trots op onze uptime en vinden het geweldig dat we die zo makkelijk met prospects en klanten kunnen delen."
Wat kost Hyperping?
- Free: 1 agent voor servermonitoring, 20 monitors met checks om de 5 minuten, 1 eenvoudige statuspagina
- Essentials: € 24 per maand bij jaarlijkse facturatie (€ 29 maandelijks) voor 5 server-agents, 50 monitors, 3 browserchecks, 1 statuspagina met eigen domein, piketdienst en escalatiebeleid, telefonische meldingen, 3 seats
- Pro: € 74 per maand bij jaarlijkse facturatie (€ 89 maandelijks) voor 20 server-agents, 250 monitors, 3 openbare of privéstatuspagina’s, abonnees via sms, SAML SSO voor het account, 10 seats
- Business: € 249 per maand bij jaarlijkse facturatie (€ 299 maandelijks) voor 100 server-agents, 1.000 monitors, 10 statuspagina’s, white labeling, auditlogs, 20 seats
Alerting voor servers zit in alle betaalde abonnementen, met een gratis proefperiode van 14 dagen. Hoe lang metrics bewaard blijven hangt af van het abonnement, volgens de referentie van de metrics: precisie van 1 minuut blijft 2 dagen bewaard op Free, 7 dagen op Essentials, 14 dagen op Pro en 30 dagen op Business, en uurgemiddelden blijven 30 dagen op Free, 6 maanden op Essentials en 13 maanden op Pro en Business.
Waar Hyperping tekortschiet
Nog geen alerts op drempelwaarden van metrics. Hyperping roept je op als een server niets meer rapporteert. Het opent geen incident als de CPU boven 90% komt of een schijf 85% bereikt: dat zie je in het dashboard. Zijn Zabbix-triggers op schijfruimte en load essentieel voor hoe je werkt, houd ze dan voorlopig aan of kies Checkmk. Onze gids over drempelwaarden voor alerts in servermonitoring bespreekt welke de moeite waard zijn.
Een vaste set systeemmetrics. Geen eigen items, user parameters, CPU en geheugen per proces, containermetrics, logs, APM of tracing.
Geen SNMP, geen netwerkapparatuur, geen self-hosted editie. Switches, routers, printers en UPS’en vallen erbuiten, en je kunt Hyperping niet in een air-gapped netwerk draaien. Daar is Zabbix beter.
Is Hyperping geschikt voor jou?
Kies Hyperping als je vloot bestaat uit Linux-, macOS- of Windows-servers in plaats van netwerkapparatuur, als je het monitoringsysteem liever niet zelf beheert, en als je nu betaalt voor een aparte oproeptool en statuspagina. Omgevingen met veel SNMP en air-gapped locaties blijven beter bij Zabbix of kijken naar Checkmk.
Prometheus + Grafana: Beste open source alternatief voor cloud-native stacks
Voor wie Prometheus bedoeld is
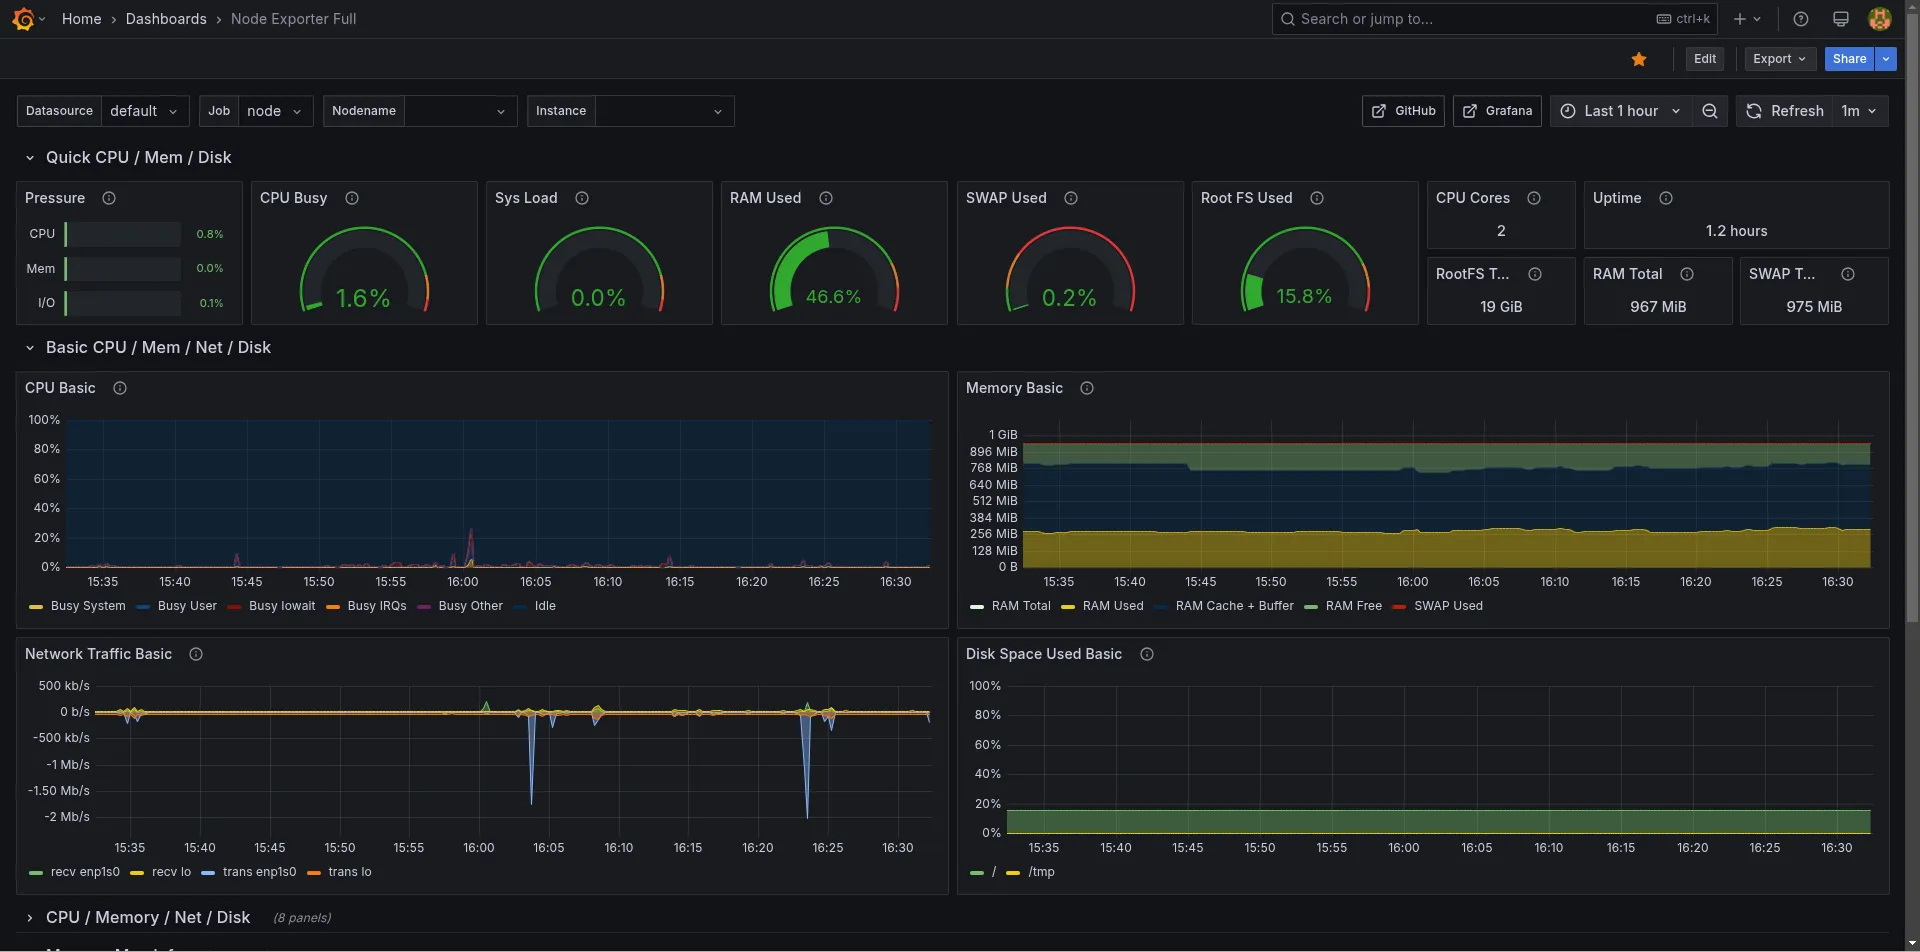
Teams met Kubernetes, containers of autoscaling groups, waar hosts sneller komen en gaan dan iemand Zabbix-hosts kan bijhouden. Prometheus scrapet metrics van exporters en applicaties, Grafana tekent de dashboards en Alertmanager routeert de alerts.
Opvallende functies
- Service discovery: Targets komen uit Kubernetes, Consul, EC2 en andere bronnen in plaats van dat je ze met de hand toevoegt.
- PromQL: Een querytaal voor rates, percentielen en alertvoorwaarden over time series.
- Exporters:
node_exportervoor Linux,windows_exportervoor Windows, en exporters voor databases, queues en hardware. - Alertmanager: Groeperen, inhibition, silences en routing naar receivers.
- Grafana-dashboards: Veel gebruikt, met communitydashboards voor de meeste exporters.
Wat kost het?
Prometheus (Apache 2.0) en Grafana (AGPLv3) zijn gratis om zelf te hosten. Volgens de prijzen van Grafana Cloud, gecontroleerd op 28 september 2026:
- Free: 10.000 actieve metric-series, 50 GB logs, 3 actieve gebruikers, 14 dagen retentie
- Pro: $ 19 per maand platformkosten plus gebruik ($ 6,50 per 1.000 series boven de inbegrepen 10.000), 13 maanden retentie voor metrics
- Grafana IRM (piketdienst): vanaf $ 20 per actieve IRM-gebruiker per maand op Pro
Aandachtspunten
Dit is een stack die je zelf samenstelt: Prometheus, exporters, Alertmanager, Grafana, en Thanos, Mimir of VictoriaMetrics zodra lokale opslag niet meer volstaat. Elke alert is PromQL die je zelf schrijft. Prometheus heeft geen SNMP-gerichte workflow zoals Zabbix (er is snmp_exporter, maar de config bouw je zelf) en Alertmanager kent geen roosters, en daarom verkoopt Grafana IRM apart.
Wie Prometheus + Grafana kan overwegen
Kies het als je workloads in containers draaien en je engineers PromQL al lezen. Voor een vaste vloot VM’s is het meestal meer machinerie dan Zabbix, niet minder. Voor een gehoste vergelijking, zie Datadog vs Grafana Cloud.
Checkmk: Beste open source allrounder die het dichtst bij Zabbix komt
Voor wie Checkmk bedoeld is
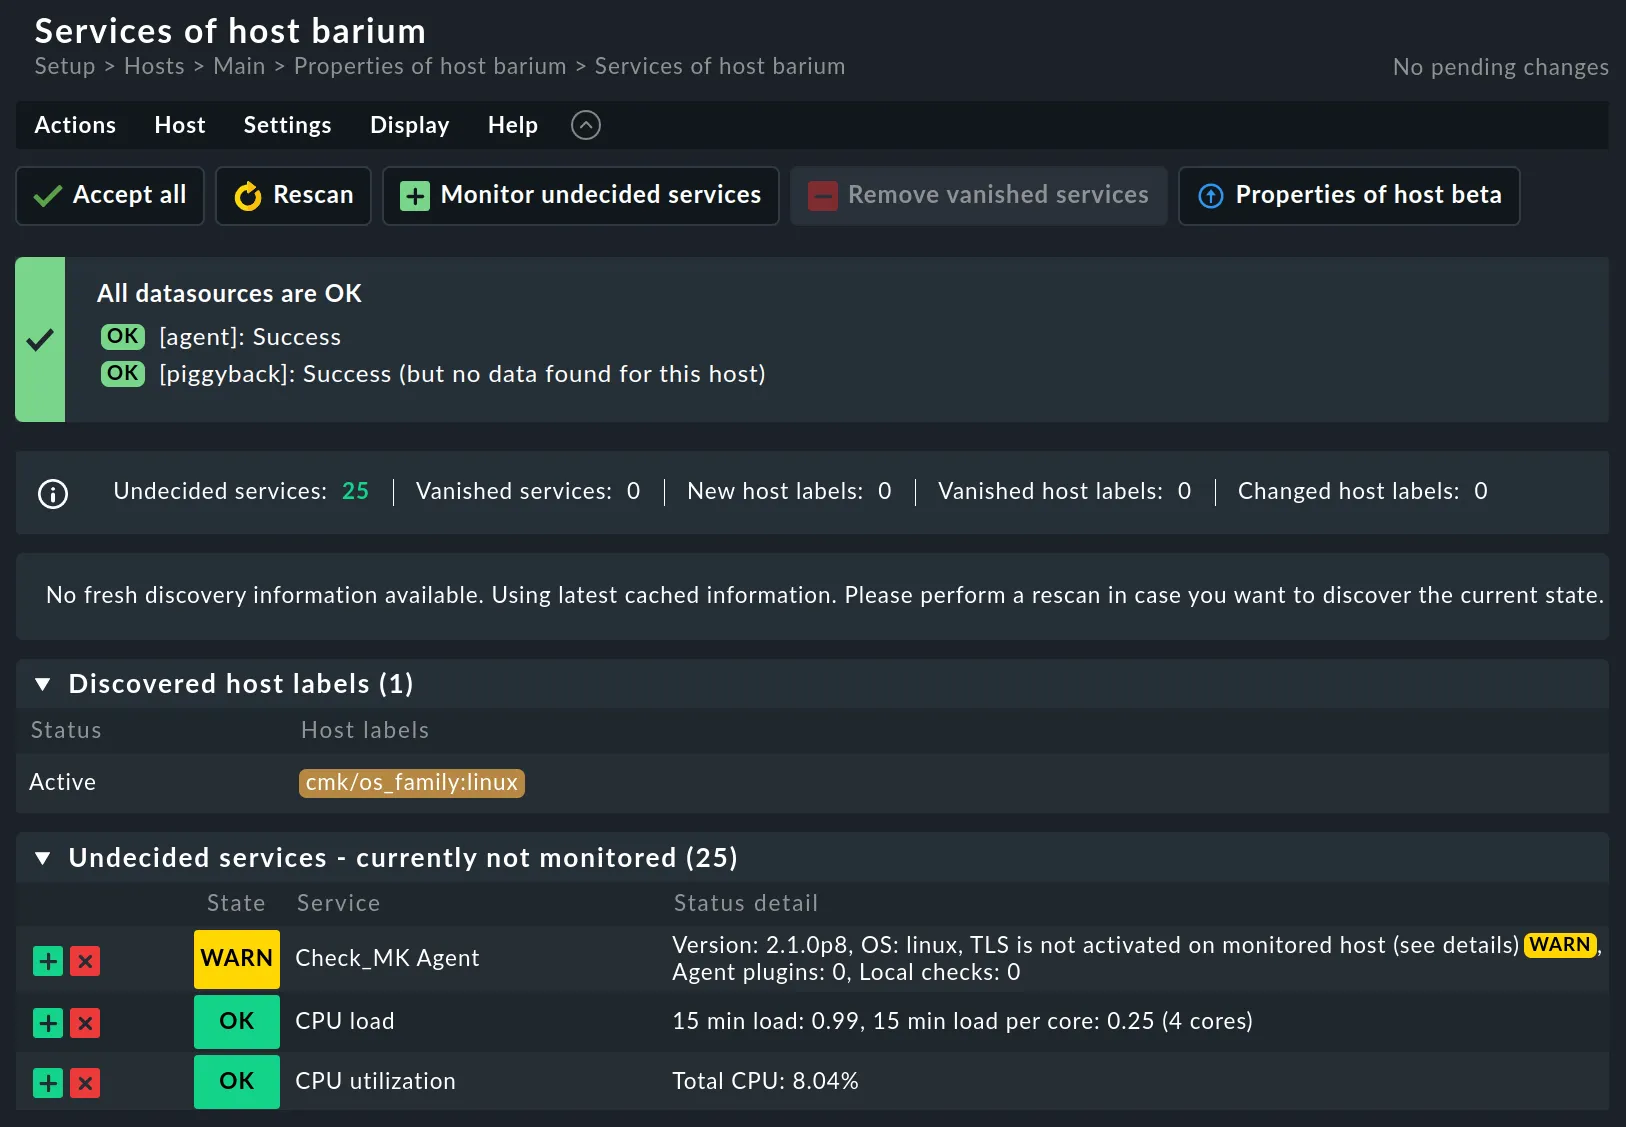
Ops-teams die willen wat Zabbix dekt (servers, netwerkapparatuur, SNMP, drempelwaarden) met minder handwerk in de configuratie. De agent van Checkmk ontdekt bestandssystemen, interfaces, services en processen op elke host en maakt er automatisch checks van.
Opvallende functies
- Automatische service discovery op Linux, Windows en netwerkapparatuur.
- Configuratie op basis van regels in de webinterface: drempelwaarden en meldingsregels gelden voor mappen en host-tags, niet voor losse hosts.
- SNMP-ondersteuning voor switches, routers en appliances.
- Compatibel met Nagios-plugins voor eigen checks.
- Checkmk Cloud als je de server niet zelf wilt draaien.
Wat kost Checkmk?
Volgens de prijspagina van Checkmk, gecontroleerd op 28 september 2026 (de prijs telt services, gemiddeld zo’n 30 per host):
- Community: gratis en open source, bedoeld voor tot ongeveer 100 hosts
- Pro (self-hosted): vanaf € 190 per maand bij jaarlijkse facturatie
- Ultimate (self-hosted): vanaf € 275 per maand bij jaarlijkse facturatie
- Checkmk Cloud (SaaS): € 240 per maand bij maandelijkse facturatie voor 1.000 services, of € 2.400 per jaar (ongeveer € 200 per maand) bij jaarlijkse facturatie
Aandachtspunten
De Checkmk-server draait alleen op Linux, dus je host nog steeds iets, tenzij je voor Cloud betaalt. Prijzen per service groeien mee met wat de discovery op elke host vindt. Meldingen werken met regels en zijn flexibel, maar piketroosters komen nog steeds uit een integratie zoals PagerDuty, niet uit Checkmk zelf.
Wie Checkmk kan overwegen
Kies Checkmk als je self-hosted wilt blijven en servers plus netwerkapparatuur wilt dekken, maar minder tijd wilt besteden aan het schrijven van templates. Van de tools hier is dit degene die een Zabbix-beheerder het meest vertrouwd zal voorkomen.
Netdata: Beste keuze voor metrics per seconde met vrijwel geen setup
Voor wie Netdata bedoeld is
Engineers die een agent willen installeren en meteen gedetailleerde metrics van een host willen zien, zonder items of templates te definiëren. Netdata herkent services automatisch en verzamelt elke seconde metrics.
Opvallende functies
- Verzameling per seconde met duizenden automatisch herkende metrics per host.
- Dashboards zonder configuratie voor de host en de applicaties die het vindt.
- Ingebouwde anomaliedetectie met ML op elke metric.
- Native Windows-agent naast Linux, macOS en containers.
- Vooraf ingestelde alerts die met de agent worden meegeleverd.
Wat kost Netdata?
Volgens de prijspagina van Netdata, gecontroleerd op 28 september 2026:
- Community: gratis, tot 5 actieve verbonden nodes en 1 eigen dashboard per room
- Homelab: $ 90 per jaar voor onbeperkt veel nodes, niet-commercieel gebruik
- Business: $ 7 per node per maand bij jaarlijkse facturatie ($ 8,75 maandelijks), met RBAC, SSO, auditlogs en Netdata AI, proefperiode van 14 dagen
- Enterprise on-premises: vanaf 200 nodes, prijs op aanvraag
Aandachtspunten
De agent is GPLv3, maar de volledige ervaring zit in Netdata Cloud, en 5 gratis nodes is krap voor wie Zabbix vervangt. Netdata is meer gemaakt voor realtime troubleshooting van losse hosts dan voor capaciteitsplanning op lange termijn. Alerts gaan naar kanalen, maar er zijn geen piketroosters of statuspagina.
Wie Netdata kan overwegen
Kies Netdata als je zonder setup diep en realtime in je hosts wilt kijken, en je geen probleem hebt met een abonnement per node boven de 5 nodes.
Datadog: Beste keuze voor volledige observability

Voor wie Datadog bedoeld is
Engineeringteams die infrastructuurmetrics, APM, tracing, logs en synthetics op één plek gecorreleerd willen zien, en het budget hebben voor prijzen per host, per GB en per seat.
Opvallende functies
- Infrastructuurmonitoring met meer dan 1.000 integraties en 15 maanden retentie voor metrics op Pro.
- APM, logs, RUM en synthetics op hetzelfde platform.
- Datadog On-Call voor roosters en escalaties, apart verkocht.
- Native agents voor Linux, Windows, macOS en containers.
Wat kost Datadog?
Volgens de prijspagina van Datadog, gecontroleerd op 28 september 2026:
- Free: tot 5 hosts met 1 dag retentie voor metrics
- Infrastructure Pro: $ 15 per host per maand bij jaarlijkse facturatie, $ 18 on demand
- Infrastructure Enterprise: $ 23 per host per maand bij jaarlijkse facturatie, $ 27 on demand
- APM: vanaf $ 31 per host per maand extra
- Logbeheer: vanaf $ 0,10 per ingenomen GB, plus indexering
On-Call wordt als apart product per seat gefactureerd. Op 28 september 2026 kon ik de prijs ervan niet vinden op de openbare prijspagina.
Aandachtspunten
Datadog vervangt Zabbix en meteen nog een paar andere tools, maar de rekening is de som van hosts, custom metrics, logs, synthetic runs en seats. Teams die van het gratis Zabbix komen, vinden die sprong vaak moeilijk te verantwoorden als ze alleen hostgezondheid nodig hebben. Onze vergelijking Hyperping vs Datadog en gids met Datadog alternatieven rekenen het door.
Wie Datadog kan overwegen
Kies Datadog als je APM en logs naast je hostmetrics nodig hebt en je team ze ook gaat gebruiken. Voor "is de host gezond en wie wordt opgeroepen" betaal je voor veel platform dat je niet aanraakt.
Site24x7: Beste goedkope gehoste all-in-one voor kleine IT-teams
Voor wie Site24x7 bedoeld is
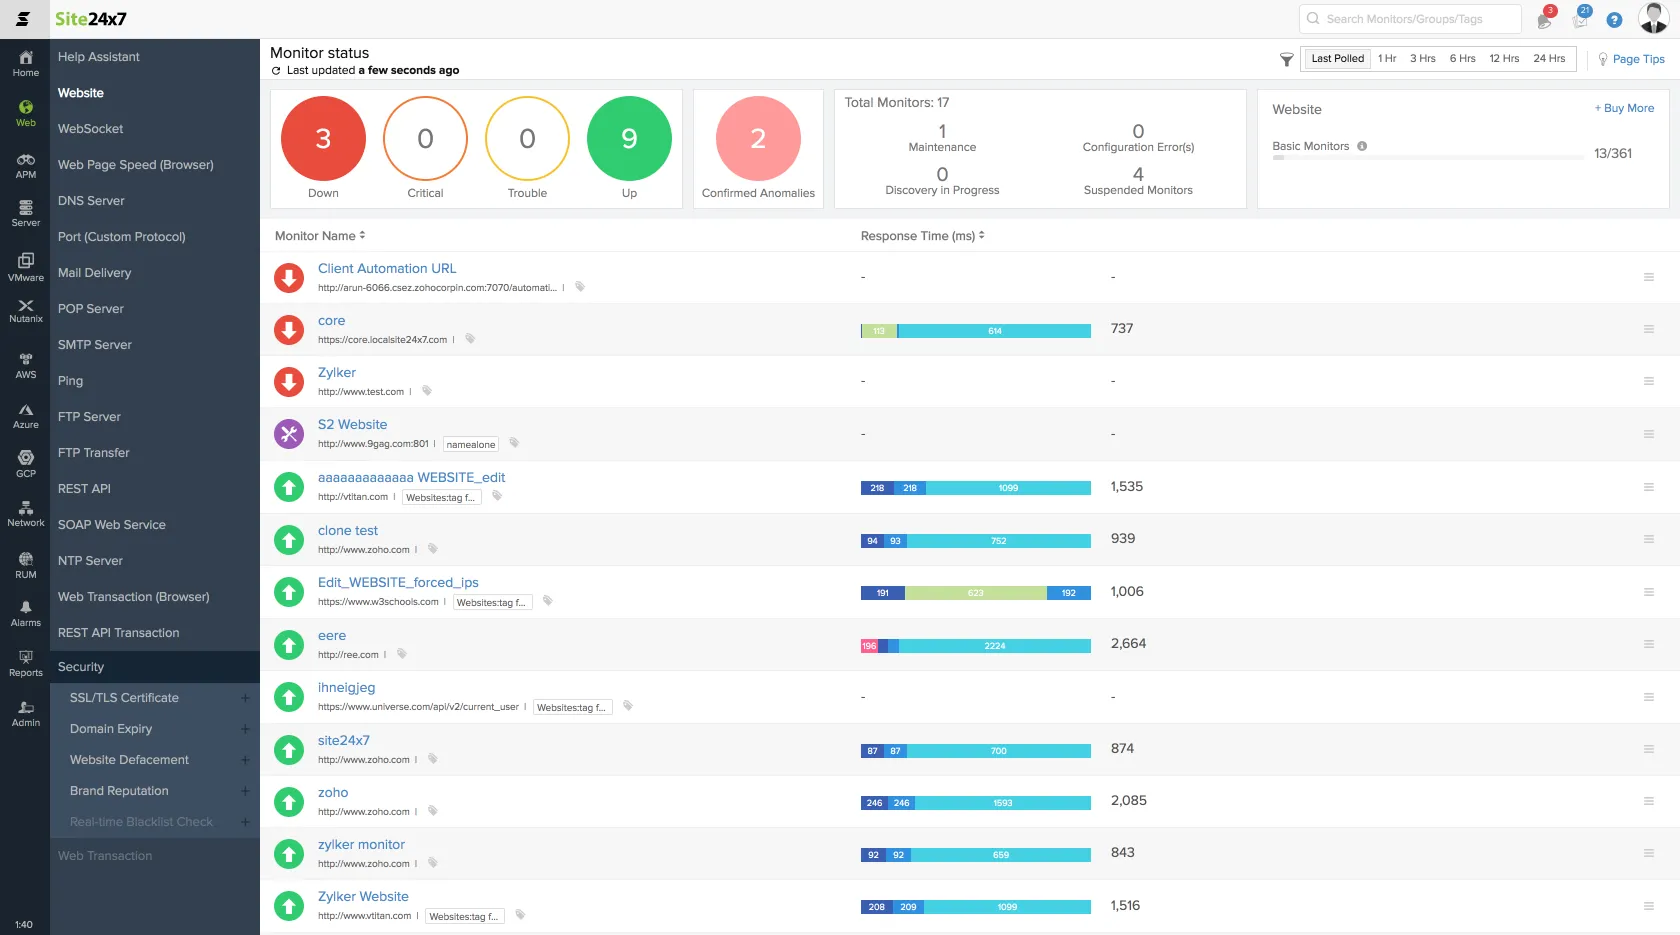
Kleine IT-teams en MSP’s die servers, websites en wat netwerkapparatuur willen monitoren vanuit een gehoste tool, tegen een lage instapprijs. Site24x7 hoort bij de ManageEngine-familie van Zoho.
Opvallende functies
- Server-agents voor Windows en Linux, plus monitoring van websites, API’s en netwerk vanuit hetzelfde account.
- Netwerkmonitoring inbegrepen in de hogere abonnementen (10 netwerkcomponenten op Professional).
- Logbeheer op Professional (4 GB ingestie inbegrepen).
- MSP-abonnementen om meerdere klanten te beheren.
- StatusIQ, een apart product van Site24x7, voor openbare statuspagina’s.
Wat kost Site24x7?
Volgens de prijspagina van Site24x7, infrastructuurabonnementen, gecontroleerd op 28 september 2026:
- Free: een voor altijd gratis abonnement met e-mailalerts voor een klein aantal resources
- Lite: $ 9 per maand bij jaarlijkse facturatie ($ 10 maandelijks) voor 2 servers, 5 websites en 25 child resources
- Professional: $ 42 per maand bij jaarlijkse facturatie ($ 49 maandelijks) voor 5 servers, 1 applicatie, 20 websites en 10 netwerkcomponenten
- Enterprise: vanaf $ 625 per maand bij jaarlijkse facturatie
- Gratis proefperiode van 30 dagen, geen creditcard nodig
Aandachtspunten
De instapprijs is laag, maar de abonnementen zijn opgebouwd uit aantallen resources en add-ons, dus de rekening stijgt stapsgewijs naarmate je servers, websites en logvolume toevoegt. Statuspagina’s zijn een apart product en de piketroosters zijn eenvoudig vergeleken met een echte oproeptool.
Wie Site24x7 kan overwegen
Kies Site24x7 als je met een klein budget een gehoste tool wilt die servers, websites en een paar netwerkapparaten dekt, en je al met andere producten van Zoho of ManageEngine werkt.
Andere tools die ik heb bekeken
- Icinga: een goede keuze als je overstapt van plugins in Nagios-stijl in plaats van van Zabbix. Nog steeds self-hosted.
- LibreNMS: gratis en sterk in SNMP-netwerkapparatuur, zwakker in servers en applicaties.
- PRTG: de kernserver draait op Windows, wat sommige Windows-omgevingen prettig vinden, maar de prijs gaat per sensor en je host het nog steeds zelf.
Wanneer Zabbix nog steeds de betere keuze is
In deze gevallen zou ik Zabbix houden, of het in elk geval niet in één keer helemaal vervangen:
- Grote on-premises omgevingen: duizenden hosts op meerdere locaties, met Zabbix-proxy’s die lokaal verzamelen. Zabbix doet dat zonder licentiekosten.
- Netwerken met veel SNMP: switches, routers, firewalls, UPS’en en printers. Geen van de gehoste tools hier kan tippen aan de SNMP-templates en de low-level discovery van Zabbix.
- Air-gapped of gereguleerde omgevingen waar data het netwerk niet mag verlaten.
- Eigen items en triggerlogica: als je team jaren in user parameters, trendtriggers en dependencies heeft gestoken, laat dat werk zich nergens netjes naartoe overzetten.
Een gangbare middenweg: houd Zabbix voor netwerkapparatuur en diepe hostmetrics, en verhuis uptime-checks, oproepen en klantcommunicatie naar een gehoste tool. Dan hangt het deel dat om 3 uur ’s nachts moet werken niet meer aan de server die je zelf onderhoudt.
Welk Zabbix alternatief moet je kiezen?
- Je wilt niets hosten en oproepen plus statuspagina’s zijn het belangrijkst: Hyperping.
- Je draait Kubernetes of containers en kent PromQL: Prometheus + Grafana.
- Je wilt self-hosted blijven met servers en netwerkapparatuur, met minder configuratiewerk: Checkmk.
- Je wilt realtime hostmetrics zonder setup, op een paar nodes: Netdata.
- Je hebt APM, logs en traces naast je hostmetrics nodig: Datadog.
- Je bent een klein IT-team of MSP met een krap budget: Site24x7.
- Je werkt met Windows en wilt geen Linux-machine alleen voor de monitoring: een gehoste tool met een native Windows-agent (Hyperping, Datadog of Site24x7). De Zabbix-server zelf draait niet op Windows.
Naar budget: Checkmk Community, Prometheus en Zabbix zelf zijn gratis als je iemand hebt om ze te beheren. Onder de gehoste tools zijn Hyperping Essentials ($ 24 per maand bij jaarlijkse facturatie voor 5 servers) en Site24x7 Lite ($ 9 per maand bij jaarlijkse facturatie voor 2 servers) de goedkoopste instappers, terwijl Datadog per host schaalt vanaf $ 15 per maand.
Hyperping gebruiken in plaats van Zabbix
Je hoeft niet alles in één keer uit te zetten. Met de stappen hieronder verhuis je de bewaking van hosts, de uptime-checks, het oproepen en de klantcommunicatie naar Hyperping, terwijl Zabbix blijft draaien tot je de nieuwe setup vertrouwt. Meer achtergrond over de metrics zelf vind je in de gids voor monitoring van Linux-servers.
1. Installeer de Hyperping-agent op je servers
Open in Hyperping Servers, klik op Add server en kopieer het installatiecommando. Daarin staat je installatietoken. Op een Linux- of macOS-host:
curl -fsSL https://hyperping.com/install.sh | sh -s -- \
  HP_INSTALL_xxxxx \
  --name "web-01" \
  --group web-tier
Op Windows 10 of Windows Server 2016 en nieuwer, vanuit PowerShell geopend met Run as Administrator:
& ([scriptblock]::Create((irm https://hyperping.com/install.ps1))) HP_INSTALL_xxxxx `
  -Name "web-01" `
  -Group web-tier
Controleer of de service draait:
sudo systemctl status hp-agent.serviceOp deze regels let je:
     Loaded: loaded (/etc/systemd/system/hp-agent.service; enabled)
     Active: active (running) since Mon 2026-09-28 10:14:02 UTC; 41s ago
Op Windows hoort Get-Service hp-agent de status Running te tonen. De server verschijnt binnen ongeveer 30 seconden in het dashboard met grafieken voor CPU, geheugen, schijf en netwerk. Je kunt hetzelfde commando vanuit Ansible of je configuratiebeheer over de hele vloot uitrollen, naast de Zabbix-agent, die je later verwijdert. De installatiereferentie behandelt gebonden installatietokens en opnieuw inschrijven.
2. Koppel een escalatiebeleid aan elke server
Open de server, ga naar het paneel Alerting en kies het escalatiebeleid dat opgeroepen moet worden als deze host stil valt. Stel de offline-drempel in: standaard 90 seconden, minimaal 60 seconden. Kies iets wat langer is dan de ergste netwerkhapering die je verwacht.
Heb je nog geen beleid, maak er dan een aan onder escalatiebeleid: bijvoorbeeld meteen Slack, na 5 minuten een telefoonoproep naar het piketrooster, en na 15 minuten de teamlead. Wil je het beleid liever bij de installatie koppelen, geef dan --policy <policy-uuid> mee aan het installatiecommando.
Test het van begin tot eind op een niet-kritieke server:
sudo systemctl stop hp-agent.serviceZodra de offline-drempel verstreken is, wordt een storing geopend en roept het beleid zijn kanalen op. Start de agent opnieuw en de herstelmelding gaat naar dezelfde kanalen.
3. Voeg uptime-checks toe voor de services die Zabbix pingde
Maak een lijst van de webscenario’s, simple checks (icmpping, net.tcp.service) en HTTP agent-items die je in Zabbix hebt. Bouw de checks die op services gericht zijn, niet op de binnenkant van de host, opnieuw op als Hyperping-monitors:
- Zabbix-webscenario’s en HTTP agent-items worden HTTP-monitors, met verwachte statuscodes en keyword-checks.
- Simple checks met
icmppingworden pingmonitors. net.tcp.service-checks op database- of SMTP-poorten worden poortmonitors.- Geplande scripts die Zabbix via trapper-items bewaakte, worden cron-heartbeats.
Monitors draaien standaard elke 30 seconden vanuit meerdere regio’s, wat valse alarmen door één enkel netwerkpad voorkomt. Routeer ze via hetzelfde escalatiebeleid als je servers, zodat je op één plek wijzigt wie er wordt opgeroepen.
4. Publiceer een statuspagina
Maak een statuspagina aan, voeg de monitors toe waar je klanten om geven (API, dashboard, login) en laat er een eigen domein naar verwijzen. Als er een storing opent, plaats je het incident daar en krijgen abonnees een e-mail, zonder aparte statuspaginatool.
Hebben beide systemen een week of twee naast elkaar gedraaid en heeft Hyperping opgepikt wat Zabbix oppikte, schakel dan de Zabbix-actions en -checks uit die nu gedekt zijn. Houd Zabbix voor netwerkapparatuur of eigen items als je die nog nodig hebt.
Conclusie
Zabbix is nog steeds een van de meest complete gratis monitoringtools, en voor grote on-premises omgevingen of netwerken met veel SNMP is het moeilijk te verslaan. De meeste teams die vertrekken missen geen functies. Ze zijn het beu om de server, de database en de templates te draaien, en daar nog een aparte oproeptool en statuspagina aan te knopen.
Draaien je workloads in containers, dan zijn Prometheus en Grafana de logische open source stap. Wil je self-hosted blijven met minder configuratie, dan komt Checkmk het dichtst in de buurt. Wil je hostgezondheid, uptime-checks, piketdienst en statuspagina’s zonder iets te hosten, maak dan een gratis Hyperping-account aan en installeer de agent op één server om het te vergelijken met wat Zabbix je vandaag laat zien.
Verder vergelijken: Hyperping vs Netdata · Hyperping vs Datadog · Prijzen van Hyperping · Alle vergelijkingen
Veelgestelde vragen
Wat is het beste gratis alternatief voor Zabbix? ▼
Wil je zelf hosten, dan zijn Checkmk Community en Prometheus met Grafana gratis zonder limiet op het aantal hosts, maar je draait nog steeds een server en een database of time-series-opslag. Wil je niets hosten, dan dekt Hyperping Free 1 server-agent en 20 uptime-monitors, Netdata Community 5 nodes, het gratis abonnement van Datadog 5 hosts met 1 dag retentie, en heeft Site24x7 een gratis abonnement voor kleine omgevingen.
Wat zijn de beste open source alternatieven voor Zabbix? ▼
Prometheus (Apache 2.0) met Grafana (AGPLv3) is het belangrijkste open source alternatief voor workloads waarin metrics centraal staan en voor containers. Checkmk Community (GPLv2) komt qua reikwijdte het dichtst bij Zabbix, met auto-discovery via de agent en SNMP. De Netdata-agent (GPLv3) levert metrics per seconde zonder configuratie. Icinga en LibreNMS zijn ook het bekijken waard voor checks op basis van plugins en voor netwerkapparatuur.
Wat is een goed Zabbix alternatief voor Windows? ▼
De Zabbix-server zelf draait niet op Windows: de documentatie noemt alleen Unix-achtige systemen, dus Windows-omgevingen draaien meestal een Linux-VM alleen voor Zabbix. Hyperping, Datadog en Site24x7 zijn gehost, dus er is helemaal geen server om te beheren, en alle drie leveren een native Windows-agent. Checkmk en Netdata hebben ook Windows-agents, en Prometheus gebruikt windows_exporter.
Zabbix vs Prometheus: welke moet ik kiezen? ▼
Zabbix past bij een vaste vloot servers en netwerkapparatuur: templates, SNMP-polling, een webinterface voor de configuratie en drempelwaarde-triggers zitten in één pakket. Prometheus past bij dynamische, gecontaineriseerde infrastructuur: het vindt targets via Kubernetes of cloud-API’s, slaat time series efficiënt op en gebruikt PromQL voor queries en alerts, maar de stack bouw je zelf (exporters, Alertmanager, Grafana, opslag voor de lange termijn).
Is Zabbix in 2026 nog de moeite waard? ▼
Ja, voor het juiste team. Zabbix 7.0 LTS heeft volledige ondersteuning tot juni 2027, 8.0 LTS staat gepland voor Q3 2026, en het blijft een van de meest complete gratis tools voor grote on-premises omgevingen en netwerken met veel SNMP. Het past slecht als niemand eigenaar wil zijn van de server, de database en de templates, of als het echte probleem is de juiste persoon op te roepen en klanten te informeren.
Wat kost Zabbix Cloud vergeleken met de alternatieven? ▼
Zabbix Cloud begint bij $ 50 per maand voor de Nano-tier (50 nieuwe waarden per seconde) en loopt op tot $ 5.000 per maand, met 10% korting bij een jaarabonnement. Ter vergelijking: Hyperping Essentials kost $ 24 per maand bij jaarlijkse facturatie voor 5 server-agents en 50 monitors, Checkmk Cloud kost € 240 per maand bij maandelijkse facturatie (€ 2.400 per jaar bij jaarlijkse facturatie) en Datadog Infrastructure Pro kost $ 15 per host per maand bij jaarlijkse facturatie.