Die besten Zabbix-Alternativen 2026 sind Hyperping (gehostetes Server- und Uptime-Monitoring mit Rufbereitschaft und Statusseiten inklusive), Prometheus mit Grafana (Open-Source-Metriken für Container und Cloud-native Stacks), Checkmk (kommt dem Funktionsumfang von Zabbix als Open Source am nächsten, mit Auto-Discovery), Netdata (sekundengenaue Metriken ohne Konfiguration), Datadog (vollständige Observability mit APM und Logs) und Site24x7 (günstiges, gehostetes All-in-one-Monitoring).
Zabbix ist nicht kaputt. Es ist kostenlos, es skaliert, und Zabbix 7.0 LTS wird bis 2027 unterstützt. Teams wechseln wegen des Betriebsaufwands: ein Linux-Server, eine MySQL- oder PostgreSQL-Datenbank, die dimensioniert und getunt werden will, Templates und Trigger, die gepflegt werden müssen, und eine Alarmierung, die zwar benachrichtigt, aber nicht verwaltet, wer gerade Bereitschaft hat.
In diesem Leitfaden erfahren Sie:
- Warum Teams Zabbix ablösen, auf Basis von Nutzerbewertungen und der Zabbix-Dokumentation selbst
- Sechs Alternativen mit Preisen (geprüft am 28. September 2026), Hosting-Modell und Einrichtungsaufwand
- Welche Open Source sind, welche kostenlos und welche sich am besten für Windows-Umgebungen eignen
- Wo Zabbix weiterhin die bessere Wahl ist und wie Sie die Alarmierung ohne große Migration davon lösen
Das Wichtigste in Kürze
- Der Zabbix-Server läuft nur auf Unix-artigen Systemen und braucht selbst für das „kleine“ Referenz-Setup mit 1.000 Metriken 2 CPU-Kerne und 8 GiB Arbeitsspeicher, dazu eine Datenbank, die Sie selbst pflegen.
- Prometheus + Grafana ist die stärkste kostenlose Alternative für Container und Kubernetes. Checkmk ist die passendste kostenlose Lösung für gemischte Server- und Netzwerklandschaften.
- Hyperping übernimmt Host-Health und Alarmierung, ohne dass Sie etwas hosten: ein Agent mit einem einzigen Befehl für Linux, macOS und Windows, Bereitschaftspläne und Statusseiten, ab 24 €/Monat bei jährlicher Abrechnung.
- Datadog beginnt bei 15 $ pro Host und Monat bei jährlicher Abrechnung und lohnt sich, wenn Sie APM und Logs brauchen. Site24x7 beginnt bei 9 $/Monat bei jährlicher Abrechnung für kleine Umgebungen.
- Zabbix bleibt die bessere Wahl für große On-Premises-Umgebungen, SNMP-lastige Netzwerkhardware und Air-Gapped-Standorte.
Warum Sie diesem Leitfaden vertrauen können
Ich bin Léo, Gründer von Hyperping. Ich bin an einem dieser Tools beteiligt, und Hyperping steht an erster Stelle. Ich habe versucht, genau zu benennen, wo es an Grenzen stößt, denn es kann nicht alles, was Zabbix kann: kein SNMP-Polling, noch keine Schwellwert-Alarme auf Metriken und keine selbst gehostete Edition.
Bei den anderen Tools habe ich die Preise am 28. September 2026 auf der offiziellen Preisseite des jeweiligen Anbieters geprüft, die Installationsanforderungen und die Release-Policy von Zabbix gelesen und die Capterra-Bewertungen zu Zabbix durchgesehen. Ich habe auch die immer wiederkehrenden Threads à la „Zabbix ist für mein Setup zu komplex“ auf r/sysadmin und r/zabbix gelesen, zitiere aber Bewertungen von Capterra, weil dort eine Rolle angegeben ist, die ich zuordnen kann. Wo ich etwas nicht überprüfen konnte, sage ich das.
Die Top-Empfehlungen im Überblick
| Am besten für | Produkt |
|---|---|
| Gehostetes Server-Monitoring mit Rufbereitschaft und Statusseiten inklusive | Hyperping |
| Metrikzentriertes Monitoring für Container und Kubernetes | Prometheus + Grafana |
| Open-Source-Allrounder, der Zabbix am nächsten kommt, mit Auto-Discovery | Checkmk |
| Sekundengenaue Host-Metriken mit fast keiner Konfiguration | Netdata |
| Vollständige Observability mit APM, Logs und Traces | Datadog |
| Günstiges gehostetes Monitoring für kleine IT-Teams | Site24x7 |
Warum Teams Zabbix verlassen
Zabbix gibt es seit 2001, und es deckt viel ab: Agenten, SNMP, IPMI, JMX, Webszenarien, Templates für Hunderte von Geräten und eine Trigger-Sprache für Schwellwerte und Trends. Die Kritik, die ich gefunden habe, betrifft selten fehlende Funktionen. Es geht um den Aufwand, das alles zu betreiben.
Server, Datenbank und Frontend betreiben Sie selbst
Die Anforderungsseite von Zabbix 7.4 nennt für den Server Linux, BSD, macOS, AIX, Solaris und HP-UX. Windows steht nicht auf der Liste. Sie wählen MySQL, MariaDB, PostgreSQL oder PostgreSQL mit TimescaleDB, und die Referenzdimensionierung beginnt bei 2 CPU-Kernen und 8 GiB Arbeitsspeicher für etwa 1.000 Metriken und steigt auf 16 Kerne und 64 GiB für 100.000.
Und das noch vor Housekeeping, Partitionierung, Backups und Major-Upgrades. Das Monitoring wird zu einem weiteren Produktivsystem, das jemand am Laufen halten muss, und fällt es aus, ist auch Ihre Alarmierung weg.
Templates und Trigger erfordern echtes Fachwissen
In Zabbix ist eine Prüfung ein Item, eine Bedingung ein Trigger, eine Benachrichtigung eine Action, und all das stammt meist aus einem Template, das Sie importieren, klonen und anpassen. Das ist flexibel, aber eine Menge Konzepte für jemanden, der nur wissen will, wann eine Festplatte voll ist.
Aus den Capterra-Bewertungen zu Zabbix:
„Sowohl die Installation als auch die Konfiguration von Zabbix haben eine steile Lernkurve, vor allem wenn man eigene Sensoren braucht.“
Infrastructure Engineer, Bildungswesen
„Manche Konfigurationen sind schwierig, wenn man nicht viel Dokumentation liest.“
ICT-Fachkraft, IT-Dienstleistungen
Eine weitere Bewertung, von jemandem aus dem Infrastrukturbereich der Luftfahrtbranche, weist darauf hin, dass die Suche nach funktionierenden Modulen und Templates dem Administrator überlassen bleibt und diese nicht immer funktionieren. Das deckt sich mit dem, was ich in Reddit-Threads gelesen habe: Leute, die Zabbix mögen, sobald es einmal eingestellt ist, und Leute mit zehn Servern, denen es zu viel des Guten ist.
Die Alarmierung endet bei Benachrichtigungen
Zabbix-Actions unterstützen Eskalationsstufen: eine Benutzergruppe benachrichtigen, warten, eine andere Gruppe benachrichtigen, einen Remote-Befehl ausführen. Die Medientypen decken E-Mail, SMS, Slack, Teams, PagerDuty und mehr ab. Was fehlt, ist ein Bereitschaftskalender: Rotationen, Vertretungen bei Krankheit und das Quittieren vom Handy aus, um die nächste Stufe zu stoppen.
Deshalb ergänzen Zabbix-Teams meist ein Alarmierungstool (PagerDuty, Opsgenie, das am 5. April 2027 eingestellt wird, siehe unseren Leitfaden zur Opsgenie-Einstellung, oder Grafana IRM). Und Kunden erfahren von Ausfällen über Support-Tickets, weil Zabbix keine öffentliche Statusseite hat. Das sind drei Tools, die verbunden und synchron gehalten werden müssen.
Zabbix Cloud nimmt Ihnen das Hosting ab, nicht die Konfiguration
Zabbix Cloud betreibt den Server für Sie, von 50 $/Monat (Nano, 50 neue Werte pro Sekunde) bis 5.000 $/Monat (10.000 Werte pro Sekunde), mit 10 % Rabatt auf Jahrespläne und einer 5-tägigen Testphase. Datenbank und Upgrades sind damit erledigt. Templates, Items, Trigger und Actions bauen Sie aber weiterhin auf die Zabbix-Art.
Schnellvergleich: Zabbix-Alternativen
| Tool | Einstiegspreis | Hosting | Einrichtungsaufwand | Alarmierung und Rufbereitschaft | Windows |
|---|---|---|---|---|---|
| Hyperping | Kostenlos; 24 €/Mon. bei jährlicher Abrechnung | Gehostet (SaaS) | Gering: ein Befehl pro Host | Bereitschaftspläne, Eskalationsrichtlinien, Anruf/SMS/Slack/Teams, Statusseiten inklusive | Nativer Agent (Windows 10 / Server 2016+) |
| Prometheus + Grafana | Kostenlos; Grafana Cloud Pro 19 $/Mon. + Nutzung | Selbst gehostet oder Grafana Cloud | Hoch | Routing über Alertmanager; Grafana IRM für Rufbereitschaft (20 $ pro aktivem Nutzer) | windows_exporter |
| Checkmk | Community kostenlos; Pro ab 190 €/Mon. bei jährlicher Abrechnung | Selbst gehostet (Linux) oder Checkmk Cloud | Mittel | Regelbasierte Benachrichtigungen; Alarmierung über Integrationen | Nativer Agent |
| Netdata | Kostenlos (5 Nodes); Business 7 $/Node/Mon. bei jährlicher Abrechnung | Agent + Netdata Cloud oder On-Premises | Gering | Alarm-Benachrichtigungen; keine Bereitschaftsplanung | Nativer Agent |
| Datadog | Kostenlos (5 Hosts); 15 $/Host/Mon. bei jährlicher Abrechnung | Gehostet (SaaS) | Gering bis mittel | Monitore + separates On-Call-Produkt, pro Nutzer | Nativer Agent |
| Site24x7 | Kostenloser Plan; 9 $/Mon. bei jährlicher Abrechnung | Gehostet (SaaS) | Gering | Alarmprofile, einfache Rufbereitschaft; Statusseiten in einem separaten Produkt (StatusIQ) | Nativer Agent |
| Zabbix (zum Vergleich) | Kostenlos; Cloud ab 50 $/Mon. | Selbst gehostet (Unix-artig) oder Zabbix Cloud | Mittel bis hoch | Actions mit Eskalationsstufen; kein Bereitschaftskalender | Nur Agent; der Server läuft nicht unter Windows |
Hyperping: am besten für gehostetes Monitoring mit integrierter Rufbereitschaft und Statusseiten
Für wen Hyperping gemacht ist
Für Teams mit einigen wenigen bis einigen hundert Servern, die keinen Monitoring-Server pflegen wollen und deren größte Lücke das ist, was nach einem Ausfall passiert: Wer wird alarmiert, was passiert, wenn niemand reagiert, und wie erfahren die Kunden davon?
Hyperping ist kein Eins-zu-eins-Ersatz für Zabbix. Es fragt keine Switches per SNMP ab und wertet keine Trigger-Ausdrücke aus. Es deckt ab, wofür die meisten kleinen und mittelgroßen Teams Zabbix tatsächlich nutzen (Lebt der Host? Wie steht es um CPU, Arbeitsspeicher und Festplatte? Antwortet der Dienst?), und ergänzt die Ebene aus Alarmierung und Statusseite, die Zabbix anderen Tools überlässt.
Wichtige Funktionen
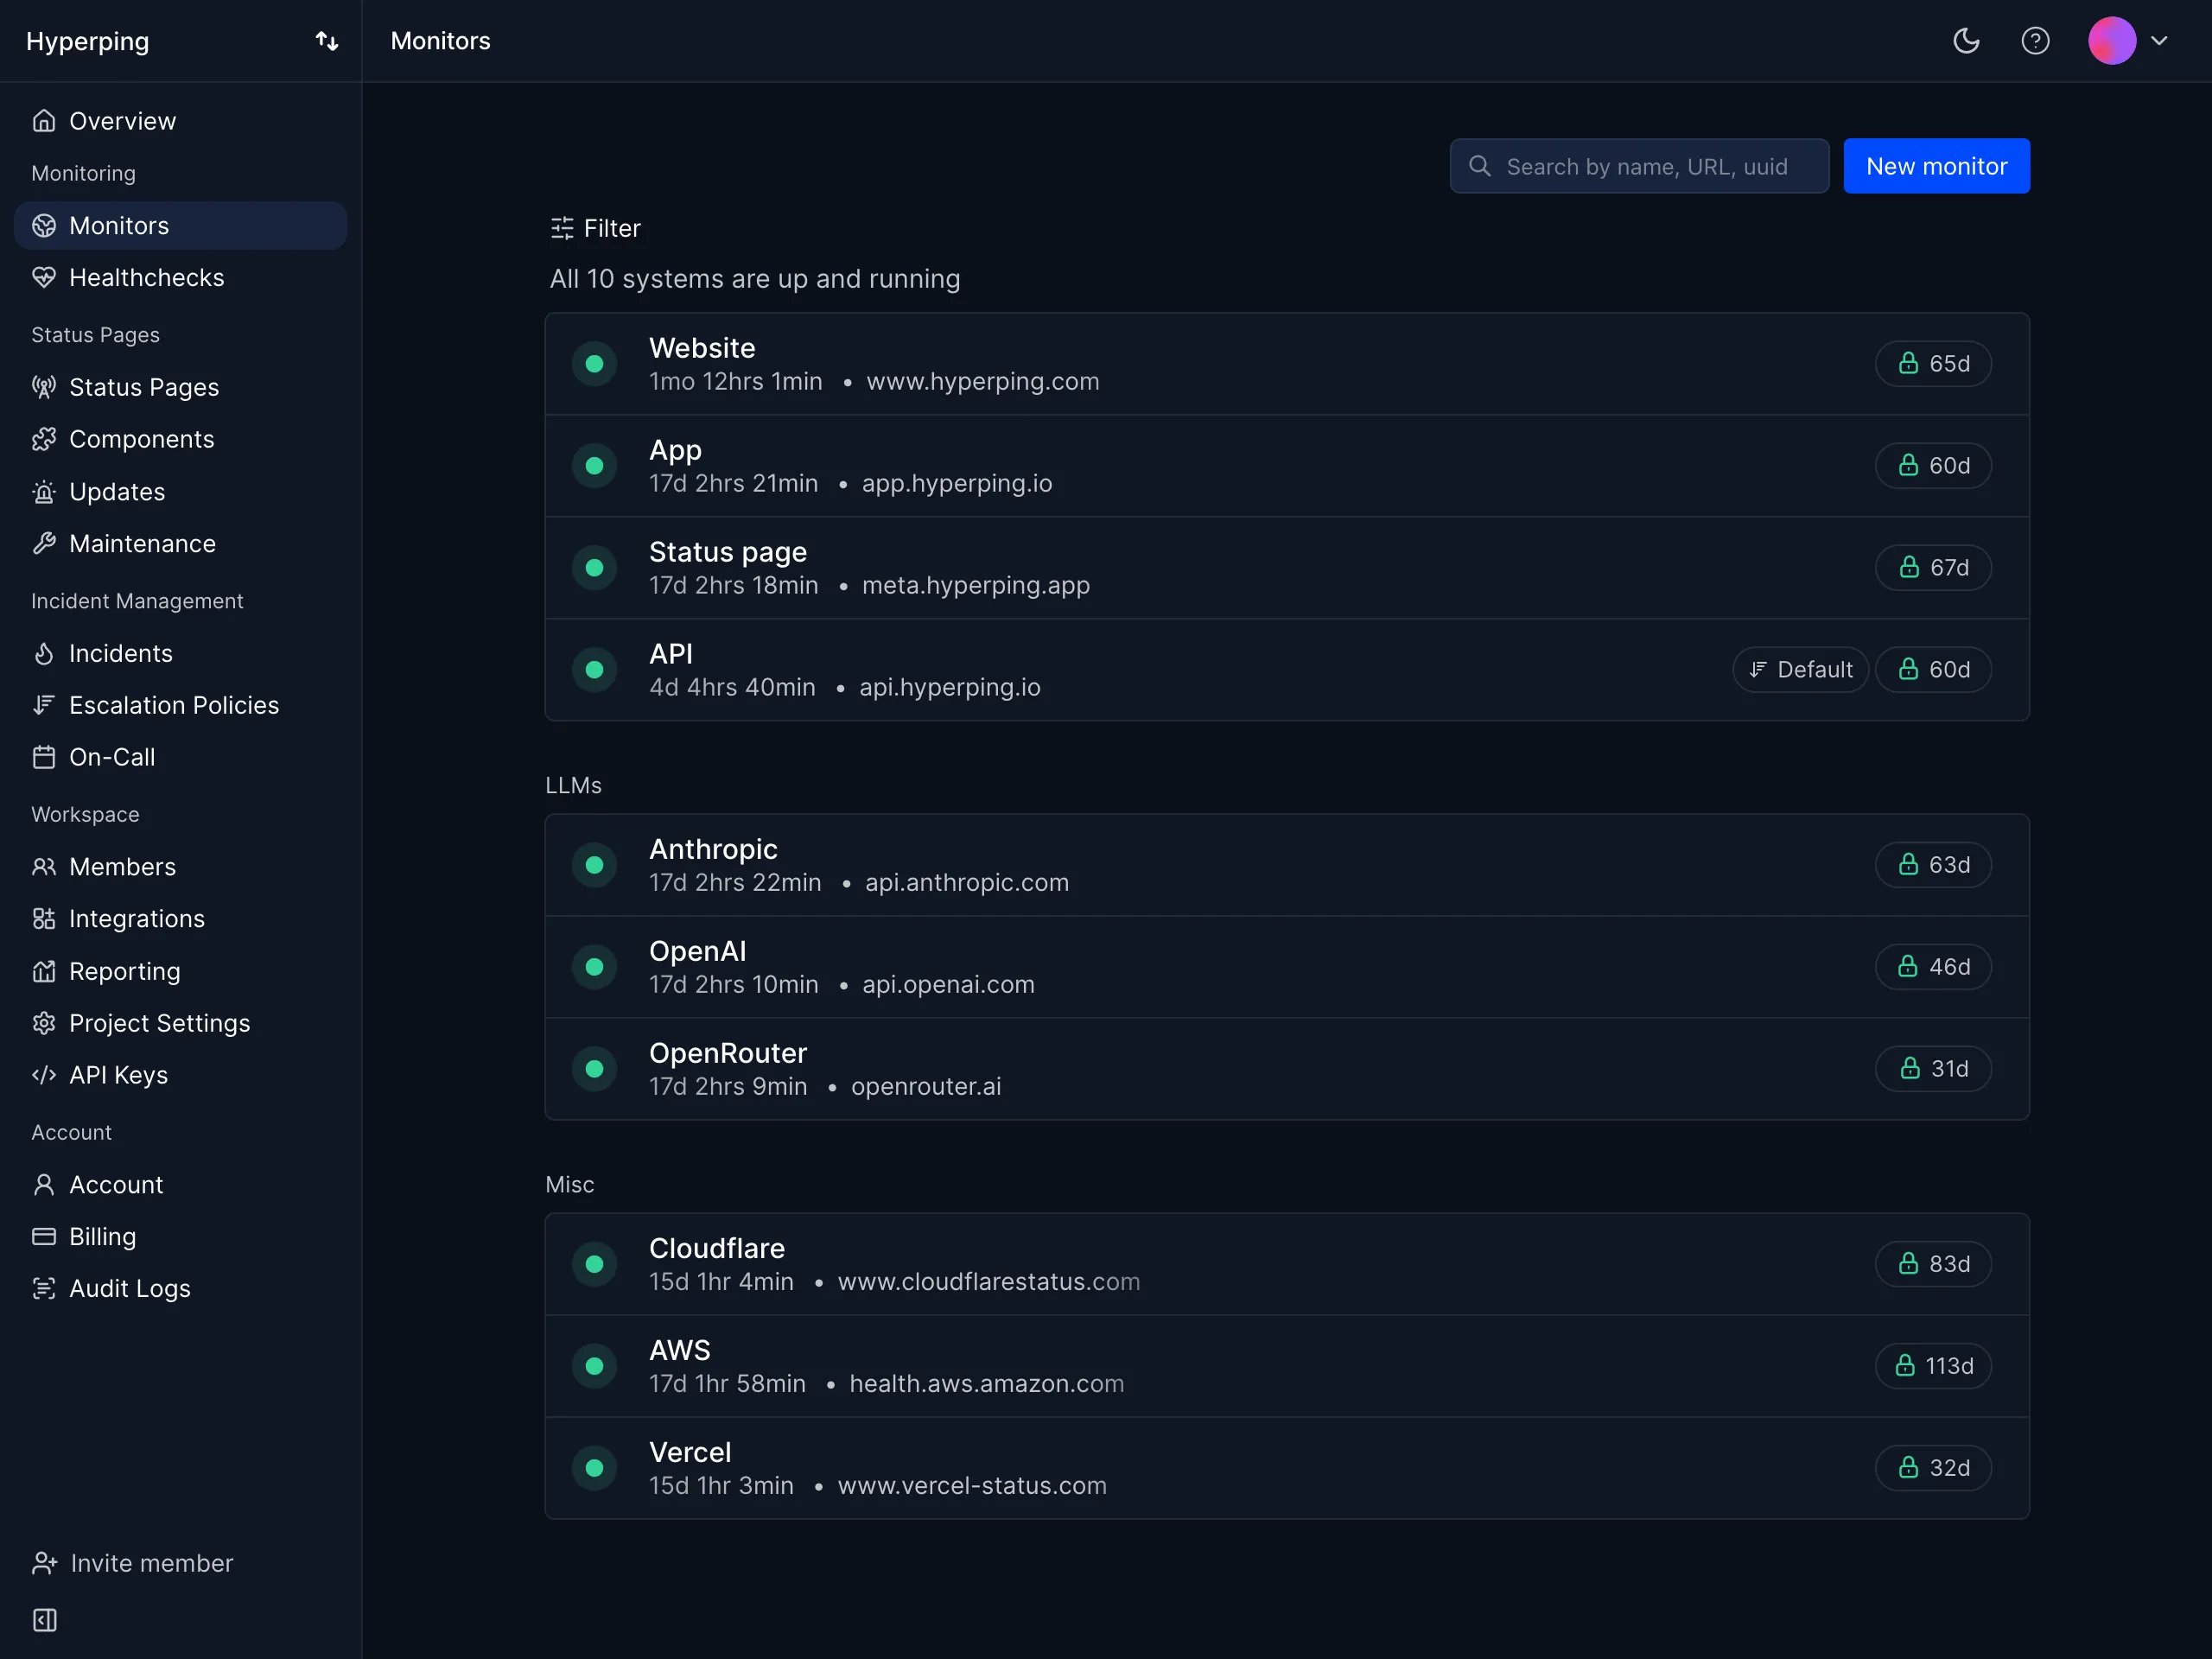
- Agent mit einer Zeile für Linux, macOS und Windows: Ein Befehl registriert einen systemd-, launchd- oder Windows-Dienst. Der Agent läuft auf amd64 und arm64 (unter Windows amd64), ist ein einzelnes Binary mit eingebettetem OpenTelemetry Collector, braucht etwa 50 MB Arbeitsspeicher und nur ausgehendes HTTPS. Siehe die Referenz zur Agent-Installation.
- Host-Metriken alle 30 Sekunden: CPU pro Zustand mit Load Average über 1, 5 und 15 Minuten, Arbeitsspeicher pro Zustand, belegter und freier Speicher pro Mountpoint, gelesene und geschriebene Bytes pro Laufwerk, ein- und ausgehende Bytes pro Netzwerkschnittstelle sowie Host-Metadaten (Betriebssystem, Kernel, CPU-Modell, Bootzeit).
- Keine Templates nötig: Der Server erscheint etwa 30 Sekunden nach der Installation mit seinen Diagrammen. Mit Flags wie
--name,--policyund--groupkann Ansible oder Terraform eine ganze Flotte vom ersten Lauf an mit der richtigen Eskalationsrichtlinie einbinden. - Offline-Erkennung, die die Bereitschaft alarmiert: Meldet sich ein Server länger nicht als sein Offline-Schwellwert (standardmäßig 90 Sekunden, mindestens 60 Sekunden, pro Server einstellbar), wird ein Ausfall eröffnet, und die zugewiesene Eskalationsrichtlinie alarmiert ihre Kanäle: E-Mail, SMS, Anrufe, Slack, Teams, PagerDuty, Webhooks oder einen Bereitschaftsplan. Details unter Server-Alarmierung.
- Uptime-Monitore im selben Konto: HTTP-, Ping-, Port- und Keyword-Checks aus 18 Regionen, standardmäßig alle 30 Sekunden, dazu tägliche Prüfungen der SSL-Zertifikate und Cron-Heartbeats. Sie ersetzen Zabbix-Webszenarien und Simple Checks auf Ihre öffentlichen Endpunkte.
- Bereitschaftspläne und Eskalationsrichtlinien: Ab Essentials enthalten und von Servern und Monitoren gemeinsam genutzt. Siehe Rufbereitschaft.
- Statusseiten: Seiten in Ihrem Branding mit Abonnenten, sodass Sie den Incident, für den Ihr Entwickler alarmiert wurde, auch für Kunden veröffentlichen können. Siehe Statusseiten.
- Keine Lücken nach einem Netzwerkaussetzer: Der Agent puffert nicht gesendete Metriken auf der Festplatte und versucht es erneut, sodass kurze Ausfälle der Datenannahme oder Neustarts keine Löcher in den Diagrammen hinterlassen.
Warum Hyperping statt Zabbix?
Nichts zu hosten, zu dimensionieren oder zu aktualisieren
Zabbix braucht einen Server, eine Datenbank, ein Web-Frontend und jemanden, der all das aktualisiert. Mit Hyperping ist der Agent das Einzige auf Ihren Hosts. Das Szenario, in dem die Monitoring-Maschine gleichzeitig mit dem überwachten System ausfällt, gibt es nicht mehr.
Alarmierung ist Teil des Produkts
Wer in Zabbix die Bereitschaft ändern will, bearbeitet Benutzergruppen oder Actions. In Hyperping definieren Sie einmal einen Plan und eine Eskalationsrichtlinie, und jede Stufe hat eigene Wartezeiten und Kanäle, sodass ein unbeantworteter Alarm an die nächste Person weitergeht. Unser Leitfaden zu Eskalationsrichtlinien und unser Leitfaden zu Bereitschaftsrotationen zeigen, wie man sie aufbaut.
Kunden erfahren von Incidents durch Sie
Zabbix hat keine Statusseite. Mit Hyperping landet derselbe Ausfall auf einer Statusseite, die Abonnenten per E-Mail benachrichtigt, ohne drittes Tool.
Wenn Ihr Zabbix-Setup auf „Sag mir, wenn eine Kiste ausfällt, und weck die richtige Person“ geschrumpft ist und niemand mehr für die Datenbank dahinter verantwortlich sein will, ist der Punkt erreicht, an dem es sinnvoller ist, alarmiert zu werden, wenn ein Server verstummt, ohne einen Monitoring-Server zu betreiben, als den Stack weiter zu pflegen.
Was echte Hyperping-Nutzer sagen
„Wir haben unsere Hyperping-Statusseite öffentlich gemacht, und sie ist zu einem zentralen Teil unserer Verkaufsgespräche geworden. Wir sind stolz auf unsere Uptime und lieben es, dass wir sie so einfach mit Interessenten und Kunden teilen können.“
Was kostet Hyperping?
- Free: 1 Server-Monitoring-Agent, 20 Monitore mit Checks alle 5 Minuten, 1 einfache Statusseite
- Essentials: 24 €/Monat bei jährlicher Abrechnung (29 € monatlich) für 5 Server-Agenten, 50 Monitore, 3 Browser-Checks, 1 Statusseite mit eigener Domain, Rufbereitschaft und Eskalationsrichtlinien, Alarme per Anruf, 3 Nutzerplätze
- Pro: 74 €/Monat bei jährlicher Abrechnung (89 € monatlich) für 20 Server-Agenten, 250 Monitore, 3 öffentliche oder private Statusseiten, SMS-Abonnenten, SAML SSO für das Konto, 10 Nutzerplätze
- Business: 249 €/Monat bei jährlicher Abrechnung (299 € monatlich) für 100 Server-Agenten, 1.000 Monitore, 10 Statusseiten, White-Labeling, Audit-Logs, 20 Nutzerplätze
Die Server-Alarmierung ist in allen kostenpflichtigen Plänen enthalten, mit einer 14-tägigen kostenlosen Testphase. Wie lange Metriken gespeichert werden, hängt laut Metrik-Referenz vom Plan ab: Minutengenaue Daten bleiben 2 Tage in Free, 7 Tage in Essentials, 14 Tage in Pro und 30 Tage in Business erhalten, stündliche Aggregate 30 Tage in Free, 6 Monate in Essentials und 13 Monate in Pro und Business.
Wo Hyperping an Grenzen stößt
Noch keine Schwellwert-Alarme auf Metrikwerte. Hyperping alarmiert Sie, wenn ein Server sich nicht mehr meldet. Es eröffnet keinen Incident, wenn die CPU 90 % überschreitet oder eine Festplatte 85 % erreicht: Das sehen Sie im Dashboard. Wenn Zabbix-Trigger auf Speicherplatz und Last zentral für Ihre Arbeit sind, behalten Sie sie vorerst oder wählen Sie Checkmk. Unser Leitfaden zu Alarm-Schwellwerten im Server-Monitoring zeigt, welche sich lohnen.
Ein fester Satz an Systemmetriken. Keine eigenen Items, keine User Parameters, keine CPU- und Speicherwerte pro Prozess, keine Container-Metriken, keine Logs, kein APM und kein Tracing.
Kein SNMP, keine Netzwerkgeräte, keine selbst gehostete Edition. Switches, Router, Drucker und USV-Anlagen sind außen vor, und in einem Air-Gapped-Netz lässt sich Hyperping nicht betreiben. Dort ist Zabbix besser.
Ist Hyperping das Richtige für Sie?
Wählen Sie Hyperping, wenn Ihre Flotte eher aus Linux-, macOS- oder Windows-Servern als aus Netzwerkhardware besteht, wenn Sie das Monitoring-System nicht selbst betreiben möchten und wenn Sie heute für ein separates Alarmierungstool und eine Statusseite bezahlen. SNMP-lastige Umgebungen und Air-Gapped-Standorte bleiben besser bei Zabbix oder schauen sich Checkmk an.
Prometheus + Grafana: die beste Open-Source-Alternative für Cloud-native Stacks
Für wen Prometheus gemacht ist
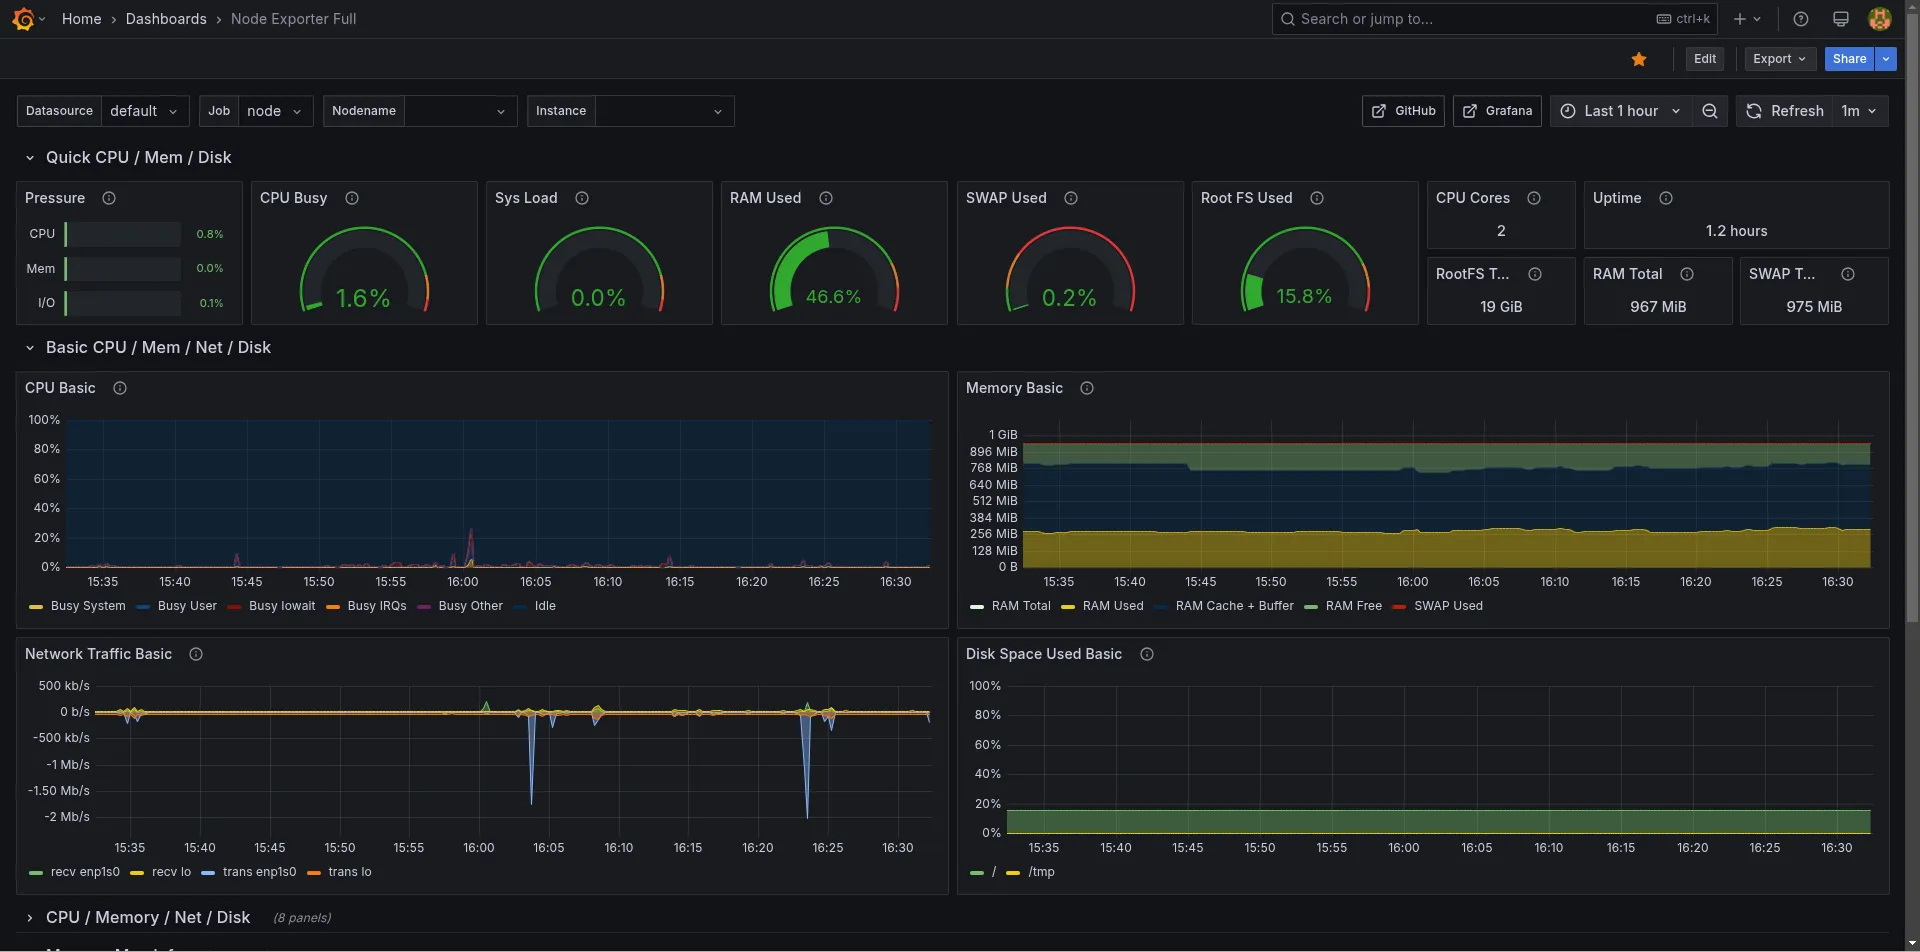
Für Teams mit Kubernetes, Containern oder Autoscaling-Gruppen, in denen Hosts schneller kommen und gehen, als jemand Zabbix-Host-Einträge pflegen könnte. Prometheus holt Metriken per Scraping von Exportern und Anwendungen, Grafana zeichnet die Dashboards, und Alertmanager routet die Alarme.
Wichtige Funktionen
- Service Discovery: Targets kommen aus Kubernetes, Consul, EC2 und anderen Quellen, statt von Hand eingetragen zu werden.
- PromQL: Eine Abfragesprache für Raten, Perzentile und Alarmbedingungen über Zeitreihen.
- Exporter:
node_exporterfür Linux,windows_exporterfür Windows sowie Exporter für Datenbanken, Queues und Hardware. - Alertmanager: Gruppierung, Inhibition, Silences und Routing an Empfänger.
- Grafana-Dashboards: Weit verbreitet, mit Community-Dashboards für die meisten Exporter.
Was kostet es?
Prometheus (Apache 2.0) und Grafana (AGPLv3) sind kostenlos selbst zu hosten. Laut Preisseite von Grafana Cloud, geprüft am 28. September 2026:
- Free: 10.000 aktive Metrik-Serien, 50 GB Logs, 3 aktive Nutzer, 14 Tage Aufbewahrung
- Pro: 19 $/Monat Plattformgebühr plus Nutzung (6,50 $ pro 1.000 Serien über die enthaltenen 10.000 hinaus), 13 Monate Aufbewahrung für Metriken
- Grafana IRM (Rufbereitschaft): ab 20 $ pro aktivem IRM-Nutzer und Monat in Pro
Zu bedenken
Diesen Stack bauen Sie selbst zusammen: Prometheus, Exporter, Alertmanager, Grafana und, sobald der lokale Speicher nicht mehr reicht, Thanos, Mimir oder VictoriaMetrics. Jeder Alarm ist PromQL, das Sie selbst schreiben. Prometheus hat keinen SNMP-zentrierten Workflow wie Zabbix (es gibt den snmp_exporter, aber die Konfiguration bauen Sie selbst), und Alertmanager kennt keine Bereitschaftspläne, weshalb Grafana IRM separat verkauft wird.
Für wen sich Prometheus + Grafana lohnt
Wählen Sie diesen Stack, wenn Ihre Workloads containerisiert sind und Ihre Entwickler PromQL bereits beherrschen. Für eine statische Flotte von VMs ist das meist mehr Maschinerie als Zabbix, nicht weniger. Einen Vergleich gehosteter Angebote finden Sie unter Datadog vs Grafana Cloud.
Checkmk: der Open-Source-Allrounder, der Zabbix am nächsten kommt
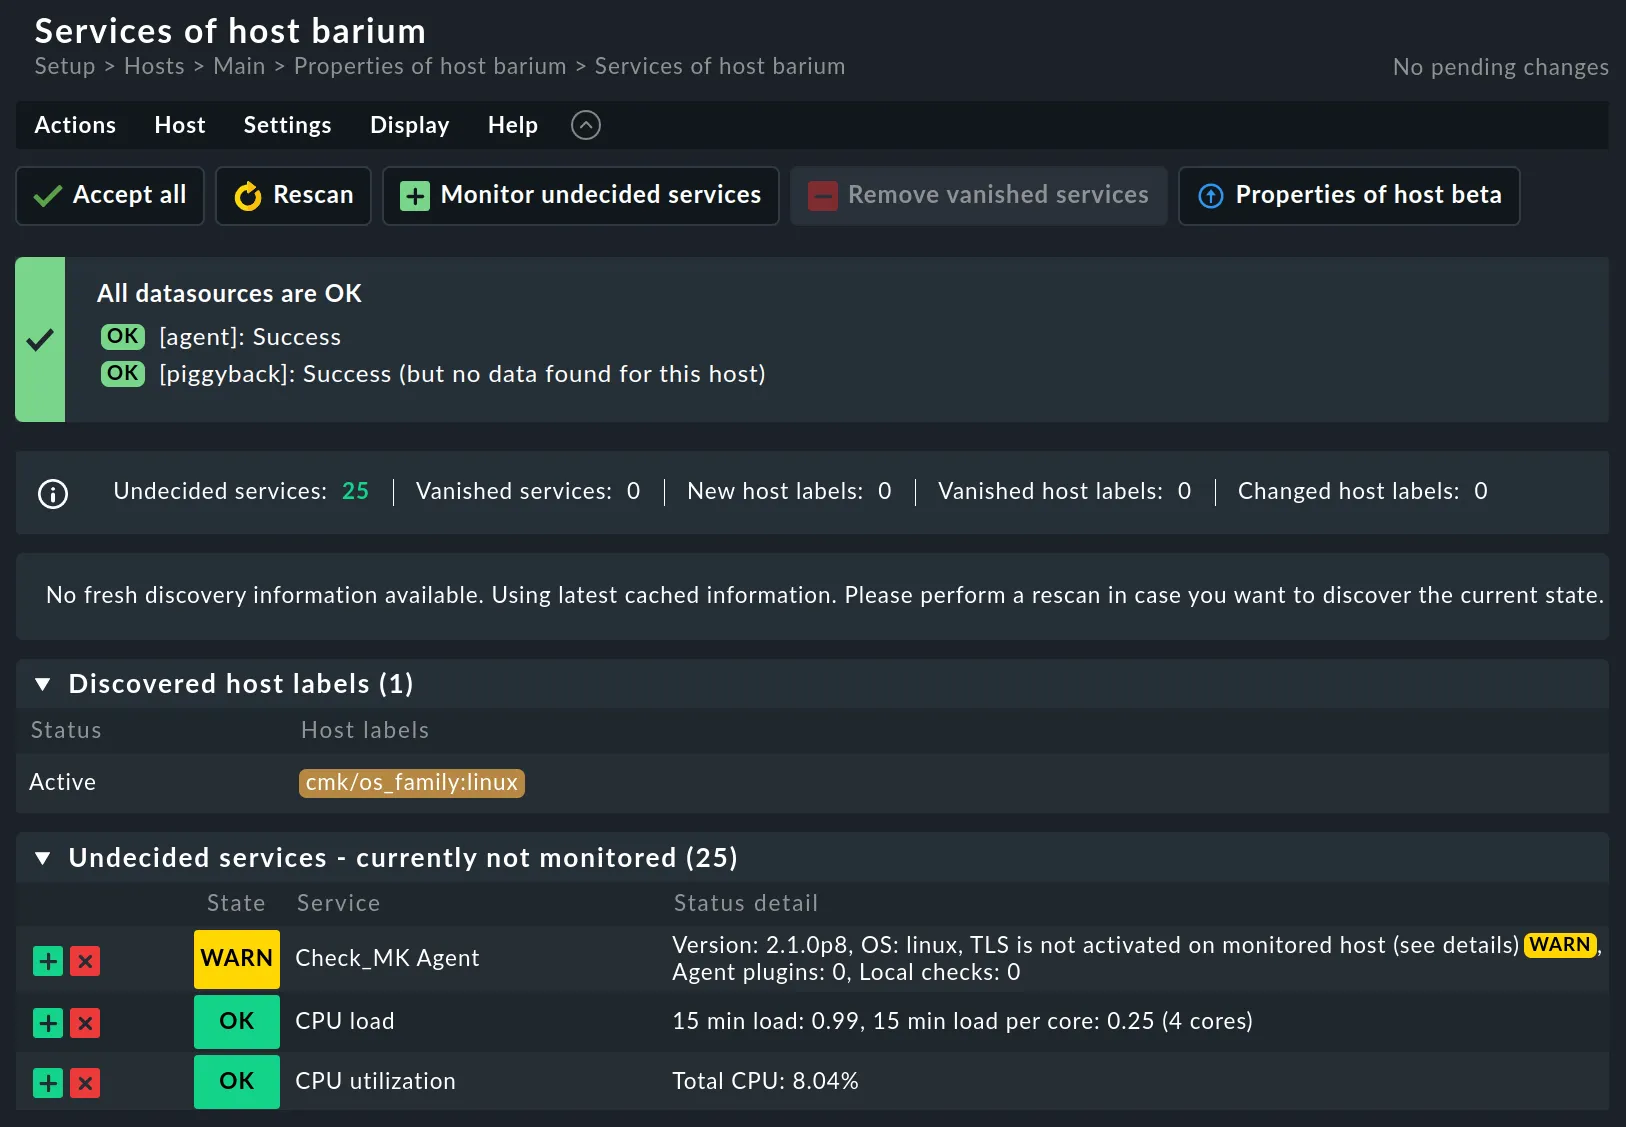
Für wen Checkmk gemacht ist
Für Ops-Teams, die das wollen, was Zabbix abdeckt (Server, Netzwerkgeräte, SNMP, Schwellwerte), aber mit weniger handgebauter Konfiguration. Der Checkmk-Agent erkennt Dateisysteme, Schnittstellen, Dienste und Prozesse auf jedem Host und macht daraus automatisch Checks.
Wichtige Funktionen
- Automatische Service-Erkennung auf Linux, Windows und Netzwerkgeräten.
- Regelbasierte Konfiguration in der Web-Oberfläche: Schwellwerte und Benachrichtigungsregeln gelten für Ordner und Host-Tags, nicht für einzelne Hosts.
- SNMP-Unterstützung für Switches, Router und Appliances.
- Kompatibilität mit Nagios-Plugins für eigene Checks.
- Checkmk Cloud, wenn Sie den Server nicht selbst betreiben wollen.
Was kostet Checkmk?
Laut Checkmk-Preisseite, geprüft am 28. September 2026 (abgerechnet werden Services, im Schnitt etwa 30 pro Host):
- Community: kostenlos und Open Source, positioniert für bis zu etwa 100 Hosts
- Pro (selbst gehostet): ab 190 €/Monat bei jährlicher Abrechnung
- Ultimate (selbst gehostet): ab 275 €/Monat bei jährlicher Abrechnung
- Checkmk Cloud (SaaS): 240 €/Monat bei monatlicher Abrechnung für 1.000 Services oder 2.400 €/Jahr (etwa 200 €/Monat) bei jährlicher Abrechnung
Zu bedenken
Der Checkmk-Server läuft nur unter Linux, Sie hosten also weiterhin etwas, es sei denn, Sie zahlen für Cloud. Die Abrechnung nach Services wächst mit dem, was die Discovery auf jedem Host findet. Benachrichtigungen sind regelbasiert und flexibel, Bereitschaftsrotationen kommen aber weiterhin über eine Integration wie PagerDuty statt aus Checkmk selbst.
Für wen sich Checkmk lohnt
Wählen Sie Checkmk, wenn Sie selbst gehostet bleiben, Server und Netzwerkhardware abdecken, aber weniger Zeit mit Templates verbringen wollen. Von allen Tools hier ist es dasjenige, das einem Zabbix-Admin am vertrautesten vorkommt.
Netdata: am besten für sekundengenaue Metriken fast ohne Einrichtung
Für wen Netdata gemacht ist
Für Entwickler, die einen Agenten installieren und sofort detaillierte Metriken eines Hosts sehen wollen, ohne Items oder Templates zu definieren. Netdata erkennt Dienste automatisch und erfasst Metriken jede Sekunde.
Wichtige Funktionen
- Erfassung im Sekundentakt mit Tausenden automatisch erkannten Metriken pro Host.
- Dashboards ohne Konfiguration für den Host und die Anwendungen, die er findet.
- Integrierte ML-Anomalieerkennung auf jeder Metrik.
- Nativer Windows-Agent neben Linux, macOS und Containern.
- Vorkonfigurierte Alarme, die mit dem Agenten ausgeliefert werden.
Was kostet Netdata?
Laut Netdata-Preisseite, geprüft am 28. September 2026:
- Community: kostenlos, bis zu 5 aktive verbundene Nodes und 1 eigenes Dashboard pro Room
- Homelab: 90 $/Jahr für unbegrenzt viele Nodes, nicht kommerzielle Nutzung
- Business: 7 $/Node/Monat bei jährlicher Abrechnung (8,75 $ monatlich), mit RBAC, SSO, Audit-Logs und Netdata AI, 14-tägige Testphase
- Enterprise On-Premises: ab 200 Nodes, Preis auf Anfrage
Zu bedenken
Der Agent steht unter GPLv3, aber der volle Funktionsumfang steckt in Netdata Cloud, und 5 kostenlose Nodes sind knapp für alle, die Zabbix ablösen. Netdata ist eher für Echtzeit-Fehlersuche auf einzelnen Hosts gebaut als für langfristige Kapazitätsplanung. Alarme gehen an Kanäle, aber es gibt weder Bereitschaftsplanung noch Statusseite.
Für wen sich Netdata lohnt
Wählen Sie Netdata, wenn Sie ohne Einrichtung tiefe Echtzeit-Einblicke in Ihre Hosts wollen und ab 5 Nodes mit einem Abo pro Node einverstanden sind.
Datadog: am besten für vollständige Observability

Für wen Datadog gemacht ist
Für Engineering-Teams, die Infrastrukturmetriken, APM, Tracing, Logs und Synthetics korreliert an einem Ort brauchen und das Budget für Preise pro Host, pro GB und pro Nutzer haben.
Wichtige Funktionen
- Infrastruktur-Monitoring mit 1.000+ Integrationen und 15 Monaten Aufbewahrung für Metriken in Pro.
- APM, Logs, RUM und Synthetics auf derselben Plattform.
- Datadog On-Call für Bereitschaftspläne und Eskalationen, separat verkauft.
- Native Agenten für Linux, Windows, macOS und Container.
Was kostet Datadog?
Laut Datadog-Preisseite, geprüft am 28. September 2026:
- Free: bis zu 5 Hosts mit 1 Tag Aufbewahrung für Metriken
- Infrastructure Pro: 15 $/Host/Monat bei jährlicher Abrechnung, 18 $ bei On-Demand
- Infrastructure Enterprise: 23 $/Host/Monat bei jährlicher Abrechnung, 27 $ bei On-Demand
- APM: ab 31 $/Host/Monat zusätzlich
- Log Management: ab 0,10 $ pro aufgenommenem GB, zuzüglich Indexierung
On-Call wird als separates Produkt pro Nutzer abgerechnet. Den Preis konnte ich am 28. September 2026 auf der öffentlichen Preisseite nicht finden.
Zu bedenken
Datadog ersetzt Zabbix und mehrere andere Tools auf einmal, aber die Rechnung ist die Summe aus Hosts, Custom Metrics, Logs, synthetischen Durchläufen und Nutzerplätzen. Teams, die vom kostenlosen Zabbix kommen, können den Sprung oft kaum rechtfertigen, wenn sie nur Host-Health brauchen. Unser Vergleich Hyperping vs Datadog und unser Leitfaden zu Datadog-Alternativen rechnen die Zahlen durch.
Für wen sich Datadog lohnt
Wählen Sie Datadog, wenn Sie APM und Logs neben Host-Metriken brauchen und Ihr Team sie auch nutzt. Für „Ist der Host gesund, und wer wird alarmiert?“ zahlen Sie für sehr viel Plattform, die Sie nie anfassen.
Site24x7: das beste günstige, gehostete All-in-one für kleine IT-Teams
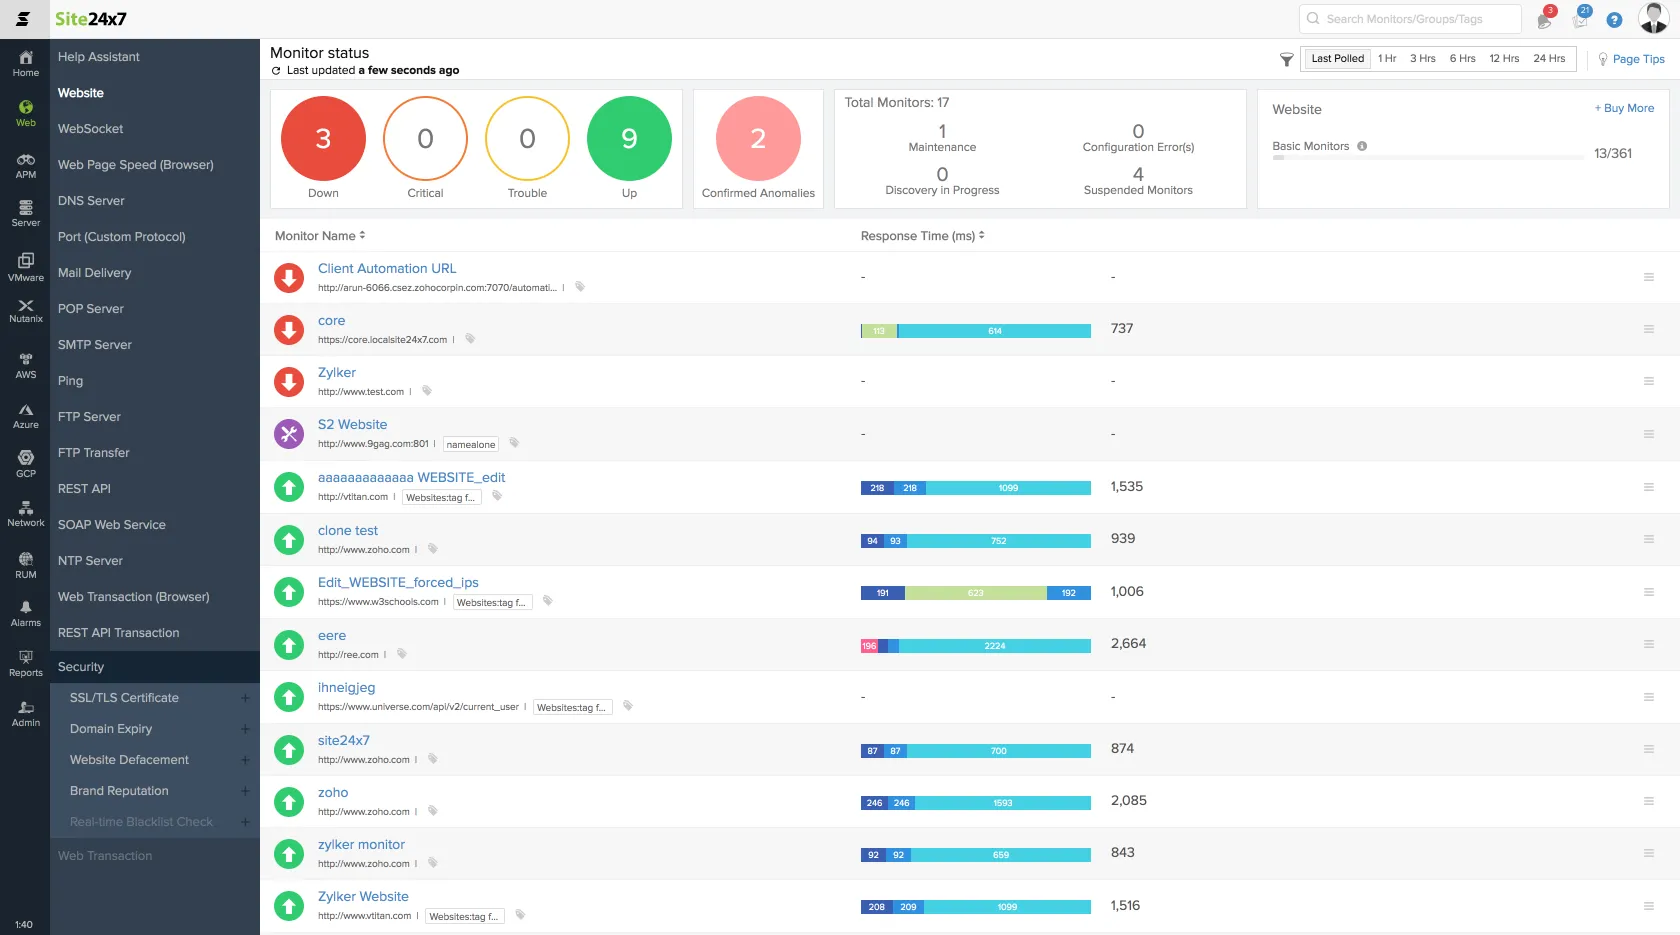
Für wen Site24x7 gemacht ist
Für kleine IT-Teams und MSPs, die Server, Websites und einige Netzwerkgeräte zu einem niedrigen Einstiegspreis über ein gehostetes Tool überwachen wollen. Site24x7 gehört zur ManageEngine-Familie von Zoho.
Wichtige Funktionen
- Server-Agenten für Windows und Linux, dazu Website-, API- und Netzwerk-Monitoring im selben Konto.
- Netzwerk-Monitoring in den höheren Plänen enthalten (10 Netzwerkkomponenten in Professional).
- Log Management in Professional (4 GB Datenaufnahme inklusive).
- MSP-Pläne zur Verwaltung mehrerer Kunden.
- StatusIQ, ein separates Site24x7-Produkt, für öffentliche Statusseiten.
Was kostet Site24x7?
Laut Site24x7-Preisseite, Infrastruktur-Pläne, geprüft am 28. September 2026:
- Free: dauerhaft kostenloser Plan mit E-Mail-Alarmen für eine kleine Anzahl von Ressourcen
- Lite: 9 $/Monat bei jährlicher Abrechnung (10 $ monatlich) für 2 Server, 5 Websites und 25 untergeordnete Ressourcen
- Professional: 42 $/Monat bei jährlicher Abrechnung (49 $ monatlich) für 5 Server, 1 Anwendung, 20 Websites und 10 Netzwerkkomponenten
- Enterprise: ab 625 $/Monat bei jährlicher Abrechnung
- 30-tägige kostenlose Testphase, keine Kreditkarte
Zu bedenken
Der Einstiegspreis ist niedrig, aber die Pläne setzen sich aus Ressourcenanzahl und Add-ons zusammen, sodass die Rechnung stufenweise wächst, sobald Sie Server, Websites und Logvolumen hinzufügen. Statusseiten sind ein separates Produkt, und die Bereitschaftsplanung ist im Vergleich zu einem dedizierten Alarmierungstool einfach gehalten.
Für wen sich Site24x7 lohnt
Wählen Sie Site24x7, wenn Sie ein gehostetes Tool wollen, das Server, Websites und ein paar Netzwerkgeräte mit kleinem Budget abdeckt, und Sie bereits mit anderen Produkten von Zoho oder ManageEngine arbeiten.
Weitere Tools, die ich in Betracht gezogen habe
- Icinga: passt gut, wenn Sie eher von Plugins im Nagios-Stil kommen als von Zabbix. Weiterhin selbst gehostet.
- LibreNMS: kostenlos und stark bei SNMP-Netzwerkgeräten, schwächer bei Servern und Anwendungen.
- PRTG: Der Core-Server läuft unter Windows, was manche Windows-Umgebungen bevorzugen, aber abgerechnet wird nach Sensoren, und hosten müssen Sie es trotzdem.
Wann Zabbix weiterhin die bessere Wahl ist
In diesen Fällen würde ich Zabbix behalten oder zumindest nicht komplett ersetzen:
- Große On-Premises-Umgebungen: Tausende Hosts an mehreren Standorten, mit Zabbix-Proxys, die lokal sammeln. Zabbix schafft das ohne Lizenzkosten.
- SNMP-lastige Netzwerke: Switches, Router, Firewalls, USV-Anlagen und Drucker. Keines der gehosteten Tools hier kommt an die SNMP-Templates und die Low-Level Discovery von Zabbix heran.
- Air-Gapped- oder regulierte Umgebungen, in denen Daten das Netzwerk nicht verlassen dürfen.
- Eigene Items und Trigger-Logik: Wenn Ihr Team jahrelang in User Parameters, Trend-Trigger und Abhängigkeiten investiert hat, lässt sich diese Arbeit nirgendwohin sauber übertragen.
Ein üblicher Mittelweg: Zabbix für Netzwerkhardware und tiefe Host-Metriken behalten und Uptime-Checks, Alarmierung und Kundenkommunikation auf ein gehostetes Tool verlagern. So hängt der Teil, der um 3 Uhr nachts funktionieren muss, nicht mehr an dem Server, den Sie pflegen.
Welche Zabbix-Alternative sollten Sie wählen?
- Sie wollen nichts hosten, und Alarmierung plus Statusseiten sind am wichtigsten: Hyperping.
- Sie betreiben Kubernetes oder Container und kennen PromQL: Prometheus + Grafana.
- Sie wollen mit Servern und Netzwerkhardware selbst gehostet bleiben, mit weniger Konfigurationsaufwand: Checkmk.
- Sie wollen Echtzeit-Host-Metriken ohne jede Einrichtung, auf wenigen Nodes: Netdata.
- Sie brauchen APM, Logs und Traces neben Host-Metriken: Datadog.
- Sie sind ein kleines IT-Team oder MSP mit knappem Budget: Site24x7.
- Sie arbeiten mit Windows und wollen keine Linux-Kiste nur fürs Monitoring: ein gehostetes Tool mit nativem Windows-Agenten (Hyperping, Datadog oder Site24x7). Der Zabbix-Server selbst läuft nicht unter Windows.
Nach Budget: Checkmk Community, Prometheus und Zabbix selbst sind kostenlos, wenn Sie jemanden haben, der sie betreibt. Unter den gehosteten Tools sind Hyperping Essentials (24 $/Monat bei jährlicher Abrechnung für 5 Server) und Site24x7 Lite (9 $/Monat bei jährlicher Abrechnung für 2 Server) die günstigsten Einstiege, während Datadog pro Host ab 15 $/Monat skaliert.
So nutzen Sie Hyperping statt Zabbix
Sie müssen nicht alles auf einmal abschalten. Mit den folgenden Schritten verlagern Sie Host-Liveness, Uptime-Checks, Alarmierung und Kundenkommunikation zu Hyperping, während Zabbix weiterläuft, bis Sie dem neuen Setup vertrauen. Mehr Hintergrund zu den Metriken selbst liefert der Leitfaden zum Linux-Server-Monitoring.
1. Den Hyperping-Agenten auf Ihren Servern installieren
Öffnen Sie in Hyperping Servers, klicken Sie auf Add server und kopieren Sie den Installationsbefehl. Er enthält Ihr Installations-Token. Auf einem Linux- oder macOS-Host:
curl -fsSL https://hyperping.com/install.sh | sh -s -- \
  HP_INSTALL_xxxxx \
  --name "web-01" \
  --group web-tier
Unter Windows 10 oder Windows Server 2016 und neuer, in einer PowerShell, die mit Als Administrator ausführen geöffnet wurde:
& ([scriptblock]::Create((irm https://hyperping.com/install.ps1))) HP_INSTALL_xxxxx `
  -Name "web-01" `
  -Group web-tier
Prüfen Sie, ob der Dienst läuft:
sudo systemctl status hp-agent.serviceAuf diese Zeilen kommt es an:
     Loaded: loaded (/etc/systemd/system/hp-agent.service; enabled)
     Active: active (running) since Mon 2026-09-28 10:14:02 UTC; 41s ago
Unter Windows sollte Get-Service hp-agent den Status Running anzeigen. Der Server erscheint innerhalb von etwa 30 Sekunden im Dashboard, mit Diagrammen für CPU, Arbeitsspeicher, Festplatte und Netzwerk. Denselben Befehl können Sie über Ansible oder Ihr Konfigurationsmanagement auf der ganzen Flotte ausführen, neben dem Zabbix-Agenten, den Sie später entfernen. Die Installationsreferenz behandelt gebundene Installations-Tokens und die erneute Registrierung.
2. Jedem Server eine Eskalationsrichtlinie zuweisen
Öffnen Sie den Server, gehen Sie zum Bereich Alerting und wählen Sie die Eskalationsrichtlinie, die alarmiert werden soll, wenn dieser Host verstummt. Legen Sie den Offline-Schwellwert fest: standardmäßig 90 Sekunden, mindestens 60 Sekunden. Wählen Sie einen Wert, der länger ist als Ihr schlimmster zu erwartender Netzwerkaussetzer.
Wenn Sie noch keine Richtlinie haben, legen Sie eine unter Eskalationsrichtlinien an: zum Beispiel sofort Slack, nach 5 Minuten ein Anruf an den Bereitschaftsplan, nach 15 Minuten die Teamleitung. Um die Richtlinie stattdessen bei der Installation zuzuweisen, übergeben Sie dem Installationsbefehl --policy <policy-uuid>.
Testen Sie das Ganze von Anfang bis Ende auf einem unkritischen Server:
sudo systemctl stop hp-agent.serviceNach Ablauf des Offline-Schwellwerts wird ein Ausfall eröffnet, und die Richtlinie alarmiert ihre Kanäle. Starten Sie den Agenten wieder, und die Entwarnung geht an dieselben Kanäle.
3. Uptime-Checks für die Dienste anlegen, die Zabbix angepingt hat
Listen Sie die Webszenarien, Simple Checks (icmpping, net.tcp.service) und HTTP-Agent-Items auf, die Sie in Zabbix haben. Bauen Sie diejenigen, die auf Dienste zeigen und nicht auf Host-Interna, als Hyperping-Monitore nach:
- Zabbix-Webszenarien und HTTP-Agent-Items werden zu HTTP-Monitoren, mit erwarteten Statuscodes und Keyword-Checks.
- Simple Checks mit
icmppingwerden zu Ping-Monitoren. net.tcp.service-Checks auf Datenbank- oder SMTP-Ports werden zu Port-Monitoren.- Geplante Skripte, die Zabbix über Trapper-Items überwacht hat, werden zu Cron-Heartbeats.
Monitore laufen standardmäßig alle 30 Sekunden aus mehreren Regionen, was Fehlalarme durch einen einzelnen Netzwerkpfad reduziert. Routen Sie sie über dieselben Eskalationsrichtlinien wie Ihre Server, damit es nur eine Stelle gibt, an der Sie festlegen, wer alarmiert wird.
4. Eine Statusseite veröffentlichen
Erstellen Sie eine Statusseite, fügen Sie die Monitore hinzu, die für Ihre Kunden zählen (API, Dashboard, Login), und richten Sie eine eigene Domain darauf. Wenn ein Ausfall eröffnet wird, veröffentlichen Sie den Incident dort, und die Abonnenten werden per E-Mail benachrichtigt, ganz ohne separates Statusseiten-Tool.
Wenn beide Systeme ein, zwei Wochen parallel gelaufen sind und Hyperping erfasst hat, was auch Zabbix erfasst hat, legen Sie die Zabbix-Actions und -Checks still, die Hyperping jetzt abdeckt. Behalten Sie Zabbix für Netzwerkgeräte oder eigene Items, wenn Sie sie noch brauchen.
Fazit
Zabbix ist nach wie vor eines der vollständigsten kostenlosen Monitoring-Tools, und für große On-Premises-Umgebungen oder SNMP-lastige Netzwerke ist es schwer zu schlagen. Den meisten Teams, die wechseln, fehlen keine Funktionen. Sie sind es leid, Server, Datenbank und Templates zu betreiben und obendrein ein separates Alarmierungstool und eine Statusseite anzubinden.
Wenn Ihre Workloads containerisiert sind, ist Prometheus mit Grafana der naheliegende Open-Source-Schritt. Wenn Sie mit weniger Konfiguration selbst gehostet bleiben wollen, kommt Checkmk Zabbix am nächsten. Wenn Sie Host-Health, Uptime-Checks, Rufbereitschaft und Statusseiten wollen, ohne etwas zu hosten, erstellen Sie ein kostenloses Hyperping-Konto und installieren Sie den Agenten auf einem Server, um ihn mit dem zu vergleichen, was Zabbix Ihnen heute zeigt.
Weiter vergleichen: Hyperping vs Netdata · Hyperping vs Datadog · Preise von Hyperping · Alle Vergleiche
Häufige Fragen
Was ist die beste kostenlose Alternative zu Zabbix? ▼
Wenn Sie selbst hosten möchten, sind Checkmk Community und Prometheus mit Grafana ohne Host-Limit kostenlos, aber Sie betreiben weiterhin einen Server und eine Datenbank oder einen Time-Series-Speicher. Wenn Sie gar nichts hosten möchten: Hyperping Free umfasst 1 Server-Agent und 20 Uptime-Monitore, Netdata Community 5 Nodes, der kostenlose Tarif von Datadog 5 Hosts mit 1 Tag Aufbewahrung, und Site24x7 hat einen kostenlosen Plan für kleine Umgebungen.
Was sind die besten Open-Source-Alternativen zu Zabbix? ▼
Prometheus (Apache 2.0) mit Grafana (AGPLv3) ist die wichtigste Open-Source-Alternative für metrikzentriertes Monitoring und Container-Workloads. Checkmk Community (GPLv2) kommt Zabbix im Funktionsumfang am nächsten, mit agentenbasierter Auto-Discovery und SNMP. Der Netdata-Agent (GPLv3) liefert sekundengenaue Metriken ohne jede Konfiguration. Icinga und LibreNMS lohnen ebenfalls einen Blick, für pluginbasierte Checks bzw. Netzwerkgeräte.
Was ist eine gute Zabbix-Alternative für Windows? ▼
Der Zabbix-Server selbst läuft nicht unter Windows: Die Dokumentation nennt nur Unix-artige Systeme, deshalb betreiben reine Windows-Umgebungen meist eine Linux-VM nur für Zabbix. Hyperping, Datadog und Site24x7 sind gehostet, es gibt also gar keinen Server zu betreiben, und alle drei bringen native Windows-Agenten mit. Auch Checkmk und Netdata haben Windows-Agenten, Prometheus nutzt den windows_exporter.
Zabbix vs Prometheus: Was sollte ich verwenden? ▼
Zabbix passt zu statischen Flotten aus Servern und Netzwerkgeräten: Templates, SNMP-Polling, eine Web-Oberfläche für die Konfiguration und Schwellwert-Trigger kommen in einem Paket. Prometheus passt zu dynamischer, containerisierter Infrastruktur: Es findet Targets über Kubernetes oder Cloud-APIs, speichert Zeitreihen effizient und nutzt PromQL für Abfragen und Alarme, aber den Stack bauen Sie selbst zusammen (Exporter, Alertmanager, Grafana, Langzeitspeicher).
Lohnt sich Zabbix 2026 noch? ▼
Ja, für das richtige Team. Zabbix 7.0 LTS hat vollen Support bis Juni 2027, 8.0 LTS ist für Q3 2026 geplant, und Zabbix bleibt eines der vollständigsten kostenlosen Tools für große On-Premises-Umgebungen und SNMP-lastige Netzwerke. Schlecht passt es, wenn niemand für Server, Datenbank und Templates verantwortlich sein will oder wenn es eigentlich darum geht, die richtige Person zu alarmieren und Kunden zu informieren.
Was kostet Zabbix Cloud im Vergleich zu den Alternativen? ▼
Zabbix Cloud beginnt bei 50 $/Monat für den Nano-Tarif (50 neue Werte pro Sekunde) und reicht bis 5.000 $/Monat, mit 10 % Rabatt bei jährlicher Zahlung. Zum Vergleich: Hyperping Essentials kostet 24 $/Monat bei jährlicher Abrechnung für 5 Server-Agenten und 50 Monitore, Checkmk Cloud 240 €/Monat bei monatlicher Abrechnung (2.400 €/Jahr bei jährlicher Abrechnung) und Datadog Infrastructure Pro 15 $ pro Host und Monat bei jährlicher Abrechnung.