Les meilleures alternatives à Datadog en 2026 sont Hyperping pour la disponibilité, les pages de statut, l’astreinte et le monitoring de serveurs à prix fixe, New Relic pour l’APM avec une offre gratuite généreuse, Dynatrace pour l’analyse des causes racines par IA en entreprise, et Better Stack pour le monitoring couplé aux logs et à la réponse aux incidents.
J’ai étudié plus de 30 outils, lu des centaines d’avis G2 et Capterra, relevé les tendances des fils r/devops et r/sre, et comparé les vrais prix pour des tailles d’équipe courantes. La version courte : la plupart des équipes qui quittent Datadog le font pour le prix, pas pour les fonctionnalités. Le bon remplaçant dépend de la partie de Datadog dont vous vous servez vraiment.
Dans ce guide, vous trouverez :
- Les quatre outils que je recommanderais, avec des prix honnêtes
- Pourquoi les équipes quittent vraiment Datadog (c’est presque toujours le coût)
- Une comparaison des prix pour trois tailles d’équipe
- La liste complète des plus de 30 alternatives à Datadog que j’ai examinées
Si vous voulez le monitoring de disponibilité, le monitoring de serveurs, les pages de statut et l’astreinte dans un seul outil, à un prix qui ne grimpe pas avec votre volume de logs, Hyperping couvre les quatre. Démarrez votre essai gratuit.
Pourquoi vous pouvez faire confiance à ce guide
Je suis Léo, fondateur d’Hyperping. J’ai un intérêt dans l’un de ces outils et je le dis clairement tout au long de l’article. Hyperping couvre une partie précise de la pile Datadog : les vérifications externes, le monitoring de serveurs, les pages de statut et l’astreinte. Pour l’APM en profondeur, le tracing distribué ou l’analyse de logs corrélés à grande échelle, les autres outils de ce guide conviennent mieux, et je le dis plus bas.
Pour écrire ce guide, j’ai lu des analyses produit de chaque outil, relevé des citations sur G2, TrustRadius et Reddit, et croisé mes critères avec les fils où ingénieurs et SRE discutent de ce qui marche vraiment.
Quand je n’ai pas pu tester un outil moi-même, je l’ai indiqué et je me suis appuyé sur des retours d’utilisateurs vérifiés.
Les meilleurs choix en un coup d’œil
| Idéal pour | Produit | Prix de départ |
|---|---|---|
| Disponibilité, monitoring de serveurs, pages de statut et astreinte dans un seul outil | Hyperping | 24 €/mois |
| L’APM avec l’offre gratuite la plus généreuse | New Relic | Gratuit jusqu’à 100 Go/mois, puis 0,40 $/Go |
| L’analyse des causes racines par IA à l’échelle de l’entreprise | Dynatrace | ~58 $/hôte/mois en full-stack (hôte de 8 Gio), 29 $ pour l’infrastructure seule |
| Le monitoring avec les logs et la réponse aux incidents | Better Stack | 29 $/mois |
Pourquoi les équipes quittent Datadog
Dans les fils Reddit et les avis que j’ai lus, les reproches suivent toujours le même schéma. Les fonctionnalités posent rarement problème. Le prix et sa prévisibilité, si.
- Des factures qui s’emballent. C’est de loin le reproche le plus fréquent. Métriques personnalisées, ingestion de logs, événements indexés, spans APM et nombre d’hôtes sont tous facturés à part et grossissent avec l’usage. Sur r/devops, des utilisateurs parlent de factures trois à dix fois supérieures à leur budget de départ. Un fil r/devops décrit un modèle de facturation qui donne l’impression de surfacturer à dessein.
- Une facturation opaque. Difficile à prévoir, encore plus à maîtriser. Des métriques personnalisées sur un cluster Kubernetes avec des tags à forte cardinalité peuvent multiplier votre facture sans bruit. Beaucoup d’équipes disent avoir besoin d’une personne dédiée à la gestion de l’usage de Datadog.
- Le support en plus. Le support Premier est vendu en pourcentage de votre dépense mensuelle, en plus de la facture de la plateforme. À grande échelle, ça fait mal.
- La dépendance au fournisseur. Les agents et l’instrumentation propriétaires de Datadog rendent le changement pénible. Les équipes qui ont adopté Datadog il y a des années citent souvent ce point quand elles regrettent de ne pas avoir choisi un outil pensé d’abord pour OpenTelemetry.
- La fatigue d’alerte et le réglage. L’alerting est puissant, mais son réglage (surtout sur des logs basés sur Elasticsearch) revient sans cesse comme une corvée dans les fils r/devops sur l’observabilité.
Il y a aussi du positif. Beaucoup d’utilisateurs considèrent toujours Datadog comme la plateforme d’observabilité tout-en-un la plus aboutie du marché. Sur r/devops, des ingénieurs le qualifient de « GOAT » quand le coût n’est pas la contrainte principale. Le schéma est clair : les équipes qui s’engagent à fond et surveillent leur usage de près restent satisfaites. Celles qui dépassent 100 hôtes ou de gros volumes de logs commencent à chercher la sortie.
Ce que les gens attendent vraiment d’un remplaçant, à peu près dans cet ordre :
- Un prix prévisible (forfait fixe ou prix par hôte transparent).
- La prise en charge d’OpenTelemetry, pour ne plus être enfermé.
- Un APM et un monitoring d’infrastructure suffisants pour leur pile.
- Des pages de statut et une astreinte sans devoir greffer Statuspage.io et PagerDuty.
- Un alerting peu exigeant, qui ne demande pas de réglages permanents.
Chacun des quatre outils ci-dessous couvre au moins trois de ces points pour un type d’équipe précis.
Comment j’ai choisi ces quatre outils
Je suis parti des plus de 30 outils de la liste d’alternatives en bas de ce guide. J’ai écarté ceux qui échouaient sur au moins un de ces trois critères :
- Prix opaque. Les outils qui exigent un appel commercial avant de donner un chiffre.
- Trop étroit. Les outils qui ne couvrent qu’une partie sans combler assez le vide laissé par Datadog.
- Charge d’exploitation. Les outils techniquement gratuits mais qui coûtent un vrai temps d’ingénierie à faire tourner, sauf quand ce compromis est justement l’intérêt (Prometheus, SigNoz, Uptrace).
Il me restait une sélection où chaque outil l’emporte nettement pour un usage précis. J’ai changé un choix par rapport à la version précédente de ce guide : AppDynamics sort, Better Stack entre. AppDynamics a un APM solide, mais son prix est opaque, façon grands comptes, et le produit ressemble plus à un bundle Cisco qu’à un outil d’observabilité de 2026. Better Stack comble une plus grande partie du même vide que Datadog laisse aux PME et aux entreprises de taille intermédiaire, à des prix transparents.
Les prix pour trois tailles d’équipe
Voici mes calculs pour trois tailles d’équipe courantes. Les montants sont mensuels, au prix catalogue en facturation annuelle quand elle existe, en novembre 2026. Hyperping est chiffré pour chaque hôte du scénario : les serveurs au-delà des agents du forfait coûtent 2 $ chacun en Essentials et en Pro, 1,50 $ en Business.
Startup (5 ingénieurs, 20 hôtes, 1 page de statut) :
| Outil | Coût mensuel | Comprend |
|---|---|---|
| Hyperping | 68 $ | Essentials : monitoring + 20 serveurs (5 inclus, 15 en plus) + astreinte + 1 page de statut + 2 sièges supplémentaires |
| Better Stack | ~170 $ | Moniteurs + astreinte (5 utilisateurs) + 1 page de statut |
| New Relic | Gratuit | Dans les 100 Go de l’offre gratuite, 1 utilisateur full platform, les autres en sièges basic |
| Dynatrace | ~1 160 $ | 58 $/hôte x 20 hôtes (full-stack, hôtes de 8 Gio) |
| Datadog | ~460 $ | 23 $/hôte x 20 hôtes (niveau Enterprise) |
SaaS en croissance (10 ingénieurs, 100 hôtes, 3 pages de statut) :
| Outil | Coût mensuel | Comprend |
|---|---|---|
| Hyperping | 234 $ | Pro : 250 moniteurs + 100 serveurs (20 inclus, 80 en plus) + astreinte + 3 pages de statut |
| Better Stack | ~368 $ | Moniteurs + astreinte (10 utilisateurs) + 3 pages de statut |
| New Relic | ~200 à 600 $ | Ingestion de données au-delà des 100 Go gratuits, 1 utilisateur full platform et 9 sièges basic |
| Dynatrace | ~5 800 $ | Full-stack sur 100 hôtes (58 $/hôte) |
| Datadog | ~2 300 $ et plus | Prix par hôte, plus l’APM, plus l’ingestion de logs |
Grande entreprise (50 ingénieurs, 500 hôtes, 10 pages de statut) :
| Outil | Coût mensuel | Comprend |
|---|---|---|
| Hyperping | 1 209 $ (Business) | 1 000 moniteurs + 500 serveurs (100 inclus, 400 en plus) + 50 sièges (20 inclus, 30 en plus) + 10 pages de statut + SSO SAML |
| Better Stack | Sur devis | Niveau Enterprise |
| New Relic | Sur devis | Contrat Enterprise, pool de sièges et ingestion négociés |
| Dynatrace | ~29 000 $ et plus | 58 $/hôte x 500 hôtes (prix catalogue, avant remises sur volume) |
| Datadog | ~11 500 $ et plus | Avant métriques personnalisées et volume de logs |
La tendance est nette. Hyperping est l’option prévisible : le prix du forfait plus un prix fixe par serveur au-delà des agents inclus, sans facturation au Go ni à la métrique. New Relic reste bon marché tant que votre volume de données ne grossit pas et qu’un deuxième ingénieur n’a pas besoin d’un siège full platform : 99 $/utilisateur/mois en Standard (5 utilisateurs au plus), ou 349 $/utilisateur/mois en Pro avec engagement annuel (418,80 $ sans engagement). Better Stack se situe entre le SaaS transparent et la tarification modulaire. Dynatrace et Datadog augmentent linéairement avec votre parc. Pour faire le calcul avec votre propre parc, le calculateur de coût du monitoring de serveurs compare Datadog, New Relic, Netdata et Hyperping selon le nombre d’hôtes.
1. Hyperping : le meilleur tout-en-un pour les équipes SaaS
Idéal pour
Les startups, les PME et les équipes SaaS en croissance qui ont besoin du monitoring de disponibilité, de la santé des serveurs, des pages de statut et des plannings d’astreinte dans un seul outil, avec un prix mensuel prévisible.
Fonctionnalités notables
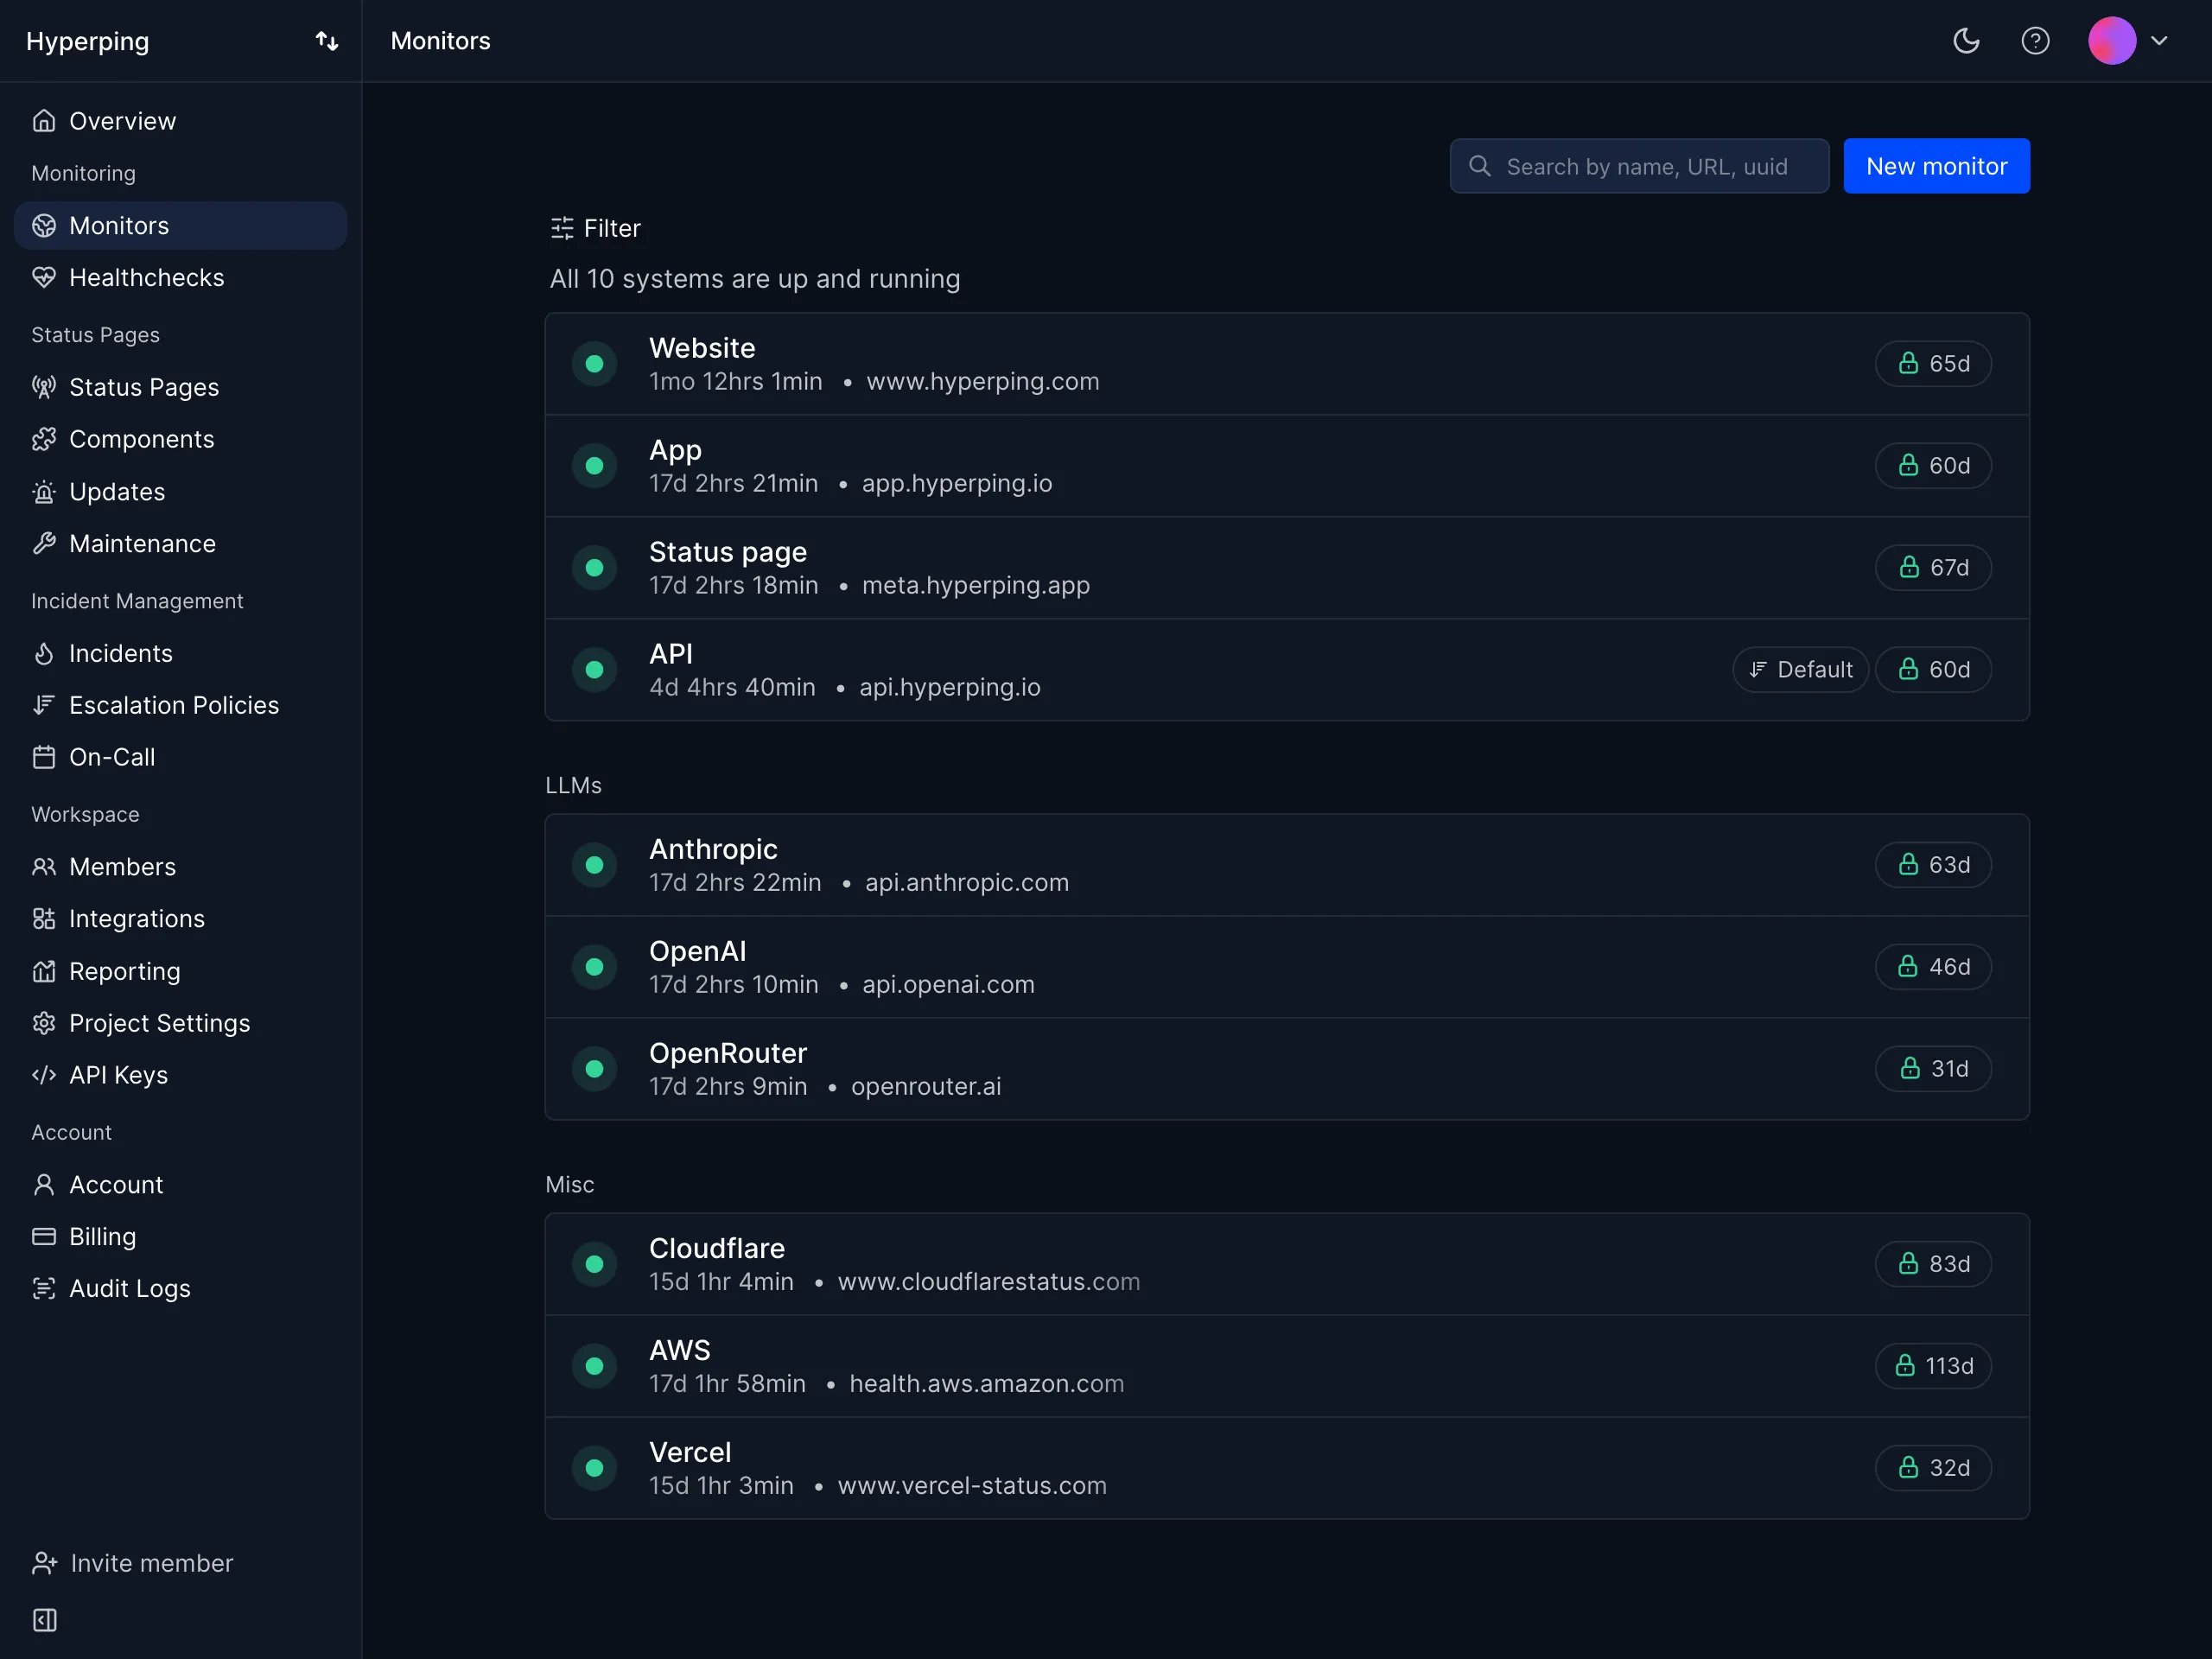
- Monitoring externe depuis 18 régions dans le monde. Repérez les problèmes du point de vue de vos clients, pas seulement depuis votre VPC. Vérifications HTTP, port, ping, mot-clé et DNS toutes les 30 secondes (20 secondes en Business), plus une vérification quotidienne des certificats SSL.
- Monitoring de serveurs avec un agent léger. Nouveau en 2026. Installez-le sur Linux (systemd) ou macOS (launchd) pour envoyer CPU, mémoire, système de fichiers, E/S disque, réseau et métadonnées de l’hôte vers votre tableau de bord toutes les 30 secondes. Construit sur OpenTelemetry, avec une file d’attente sur disque pour que les métriques survivent aux pannes d’ingestion.
- Vérifications navigateur basées sur Playwright. Monitoring synthétique de bout en bout pour la connexion, le paiement et les autres parcours critiques.
- Des pages de statut complètes incluses. Pages publiques et privées, domaines personnalisés en HTTPS, marque blanche, protection par SSO SAML, multilingue, graphiques intégrés. 3 pages en Pro, 10 en Business, sans frais par page dans ces limites.
- Plannings d’astreinte et politiques d’escalade. Rotations qui tiennent compte des fuseaux horaires, relèves automatiques, escalade en plusieurs étapes. Acquittez et escaladez depuis Slack, Teams ou par SMS.
- Alerting multicanal. Email, SMS, appels vocaux, Slack, Teams, Discord, Telegram, PagerDuty, OpsGenie, webhooks. Nouvelle tentative automatique depuis d’autres régions pour écarter les faux positifs.
- Hébergement dans l’UE et conformité RGPD. Certifié DIN ISO/IEC 27001, centres de données dans l’UE.
Pourquoi choisir Hyperping
L’argument en faveur d’Hyperping tient en deux points. D’abord, un prix fixe et prévisible. Une configuration avec 100 moniteurs, 20 serveurs, 5 sièges et 3 pages de statut coûte 74 $/mois avec le forfait Pro. La même configuration avec Datadog, Statuspage.io et PagerDuty dépasserait 1 000 $/mois avant même le volume de logs. Ensuite, trois ou quatre produits sur une seule facture. Monitoring, agents serveur, pages de statut et plannings d’astreinte sont inclus dans tous les forfaits payants.
L’agent de monitoring de serveurs de 2026 comble le principal manque historique face à Datadog pour les PME. Vous lancez une seule commande sur un hôte Linux ou macOS, et CPU, mémoire, système de fichiers, E/S disque, réseau et métadonnées de l’hôte arrivent dans le tableau de bord en quelques secondes. Le collecteur intègre les métriques d’hôte OpenTelemetry et écrit sur disque les lots non envoyés, pour que les métriques survivent aux redémarrages et aux coupures réseau. Les vérifications HTTP externes vous disent qu’une page ne se charge plus depuis l’extérieur de votre réseau. L’agent vous dit que l’hôte a manqué de mémoire deux minutes plus tôt. Les deux fonctionnent ensemble.
Alma, une fintech française qui traite des millions de transactions de paiement fractionné, utilise Hyperping comme filet de sécurité indépendant à côté de Datadog. Son SRE Fabrice Gregoire m’a dit :
« Chez nous, Hyperping a la réputation d’être plus réactif que Datadog. En général, on reçoit les notifications d’Hyperping avant celles de Datadog. C’est utile comme solution de repli, un monitoring de secours plus léger. »
« Datadog facture à la vérification. Vous [Hyperping], vous avez un forfait, c’est mieux. Payer à l’usage, c’est pénible et cher. »
Lire l’étude de cas complète d’Alma.
Ce qu’en disent les utilisateurs
« Hyperping a complètement changé la donne pour nous. Le service est fiable, facile à utiliser et incroyablement riche en fonctionnalités. »
« Nous avons rendu notre page de statut Hyperping publique et elle est devenue un élément clé de nos argumentaires commerciaux. Nous sommes fiers de notre disponibilité et nous aimons pouvoir la montrer à nos prospects. »
Points d’attention
Hyperping n’est pas une plateforme d’observabilité complète. Vous n’avez ni tracing distribué, ni analyse de logs indexés, ni APM pour un travail de performance fin au niveau du code. Si vous devez relier une requête de base de données lente à un chemin de code précis à travers plusieurs microservices, associez Hyperping à New Relic, Datadog ou SigNoz.
L’historique des métriques serveur dépend du forfait : la résolution à la minute est conservée 7 jours en Essentials, 14 jours en Pro et 30 jours en Business, et les agrégats horaires 6 mois en Essentials et 13 mois en Pro et Business. Il n’y a pas encore d’alertes sur seuil de métrique : Hyperping vous alerte quand un serveur cesse de remonter des données, pas quand un disque dépasse 90 %. Les métriques par processus, les paquets et erreurs par interface et les statistiques de swap sont sur la feuille de route, mais l’ingesteur ne les accepte pas encore.
Prix
- Free : 1 siège, 20 moniteurs, 1 agent serveur, 1 page de statut basique, vérifications toutes les 5 min
- Essentials : 24 €/mois en annuel (3 sièges, 50 moniteurs, 5 agents serveur, 1 page de statut, vérifications toutes les 30 s)
- Pro : 74 €/mois en annuel (10 sièges, 250 moniteurs, 20 agents serveur, 3 pages de statut publiques ou privées, alertes par téléphone). Comprend les codes d’accès par email, les pages multilingues et le SSO SAML natif du compte.
- Business : 249 €/mois en annuel (20 sièges, 1 000 moniteurs, 100 agents serveur, 10 pages de statut, vérifications toutes les 20 s, options SSO SAML)
- Enterprise : sur devis
Tous les forfaits payants comprennent les plannings d’astreinte, les politiques d’escalade et l’agent de monitoring de serveurs. La facturation annuelle offre 2 mois. Consultez la page des tarifs, ou la comparaison serveur par serveur avec Datadog pour voir ce que coûtent 20 ou 100 hôtes chez l’un et l’autre.
Choisissez Hyperping si
Vous voulez le monitoring, la santé des serveurs, les pages de statut et l’astreinte dans un seul outil, avec une facture qui ne grimpe pas chaque fois que vous déployez de nouveaux services. Il convient particulièrement aux entreprises européennes soumises au RGPD, aux équipes SaaS qui se servent de leur page de statut comme argument commercial, et aux équipes SRE qui font tourner Hyperping comme filet de sécurité indépendant à côté de Datadog (voir l’étude de cas d’Alma).
2. New Relic : le meilleur pour l’APM avec une offre gratuite généreuse
Idéal pour
Les équipes d’ingénierie moyennes à grandes qui font tourner des charges cloud-native, en microservices ou sur Kubernetes, et qui ont besoin d’un APM et d’un tracing en profondeur sans prix par hôte.
Fonctionnalités notables
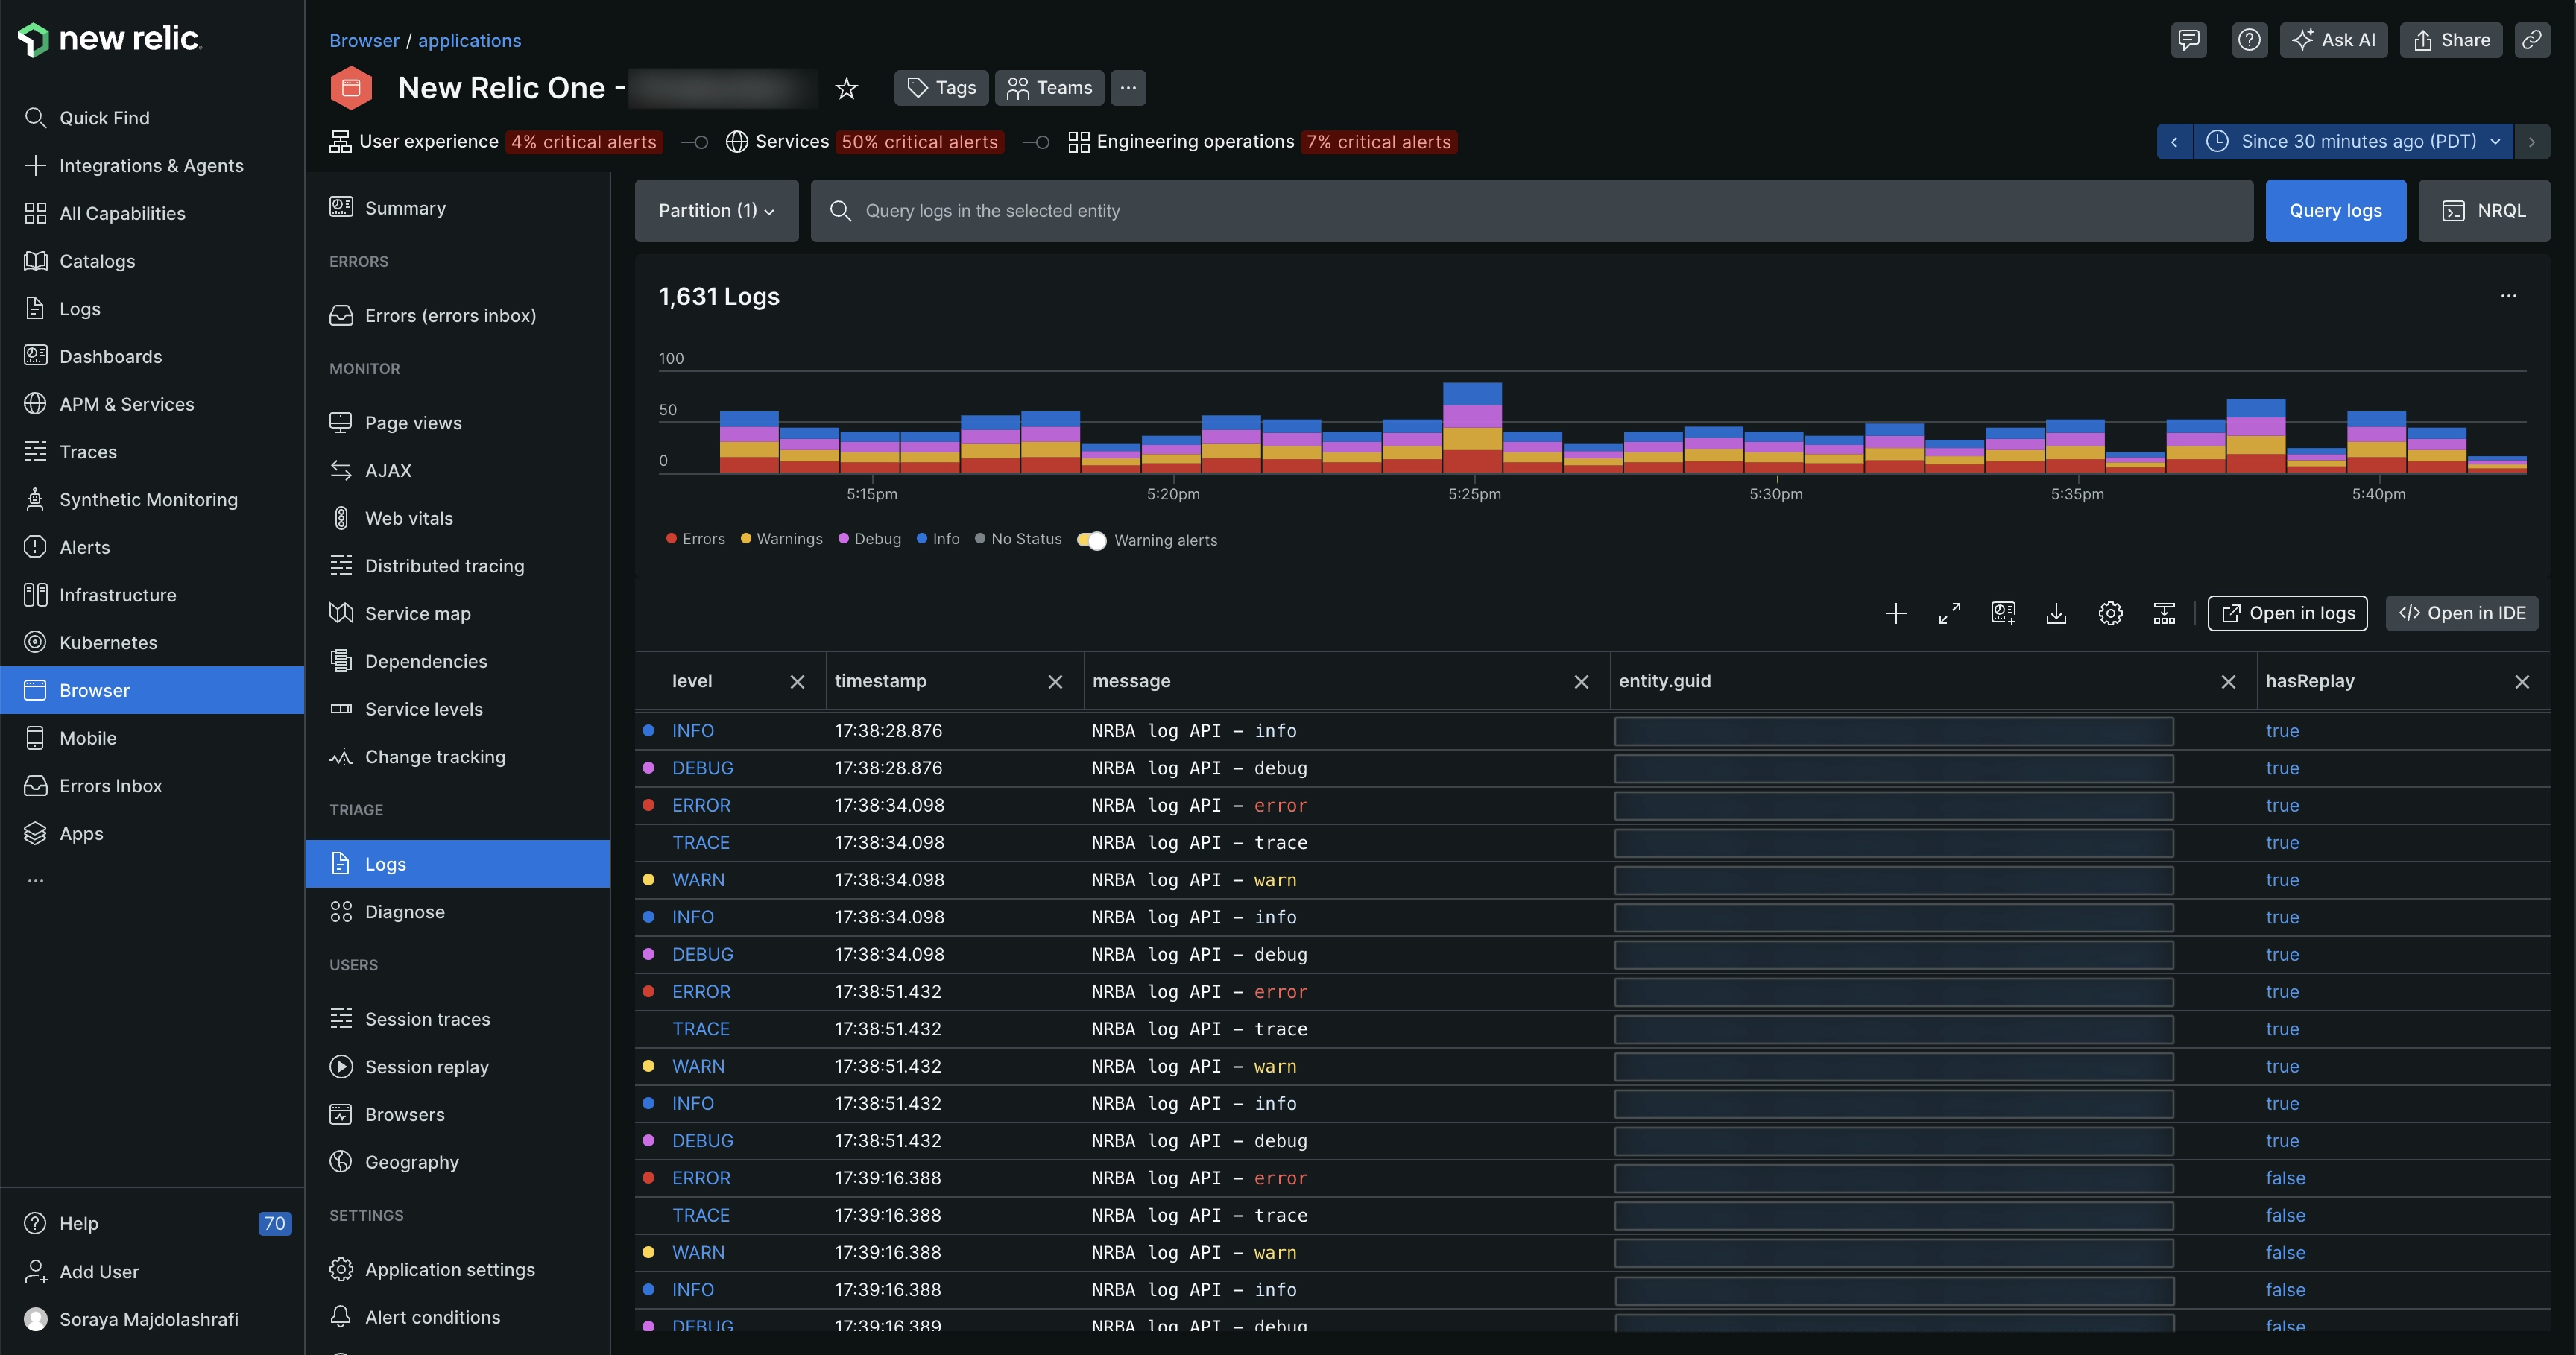
- Tracing distribué et APM. Visibilité au niveau du code à travers les microservices, avec auto-instrumentation en Java, Python, Node.js, Go, Ruby, .NET et PHP.
- Monitoring d’infrastructure. Métriques en temps réel des hôtes, conteneurs, Kubernetes et du cloud. Pas de frais par hôte, contrairement à Datadog ou Dynatrace.
- Monitoring de l’expérience numérique. RUM navigateur, monitoring mobile, session replay et vérifications synthétiques corrélés à la télémétrie backend.
- Gestion des logs en contexte. Ingérez, analysez et corrélez les logs avec les traces et les métriques dans la même interface.
- New Relic AI et AIOps. Détection d’anomalies, corrélation automatique des incidents et analyse des causes racines liée aux déploiements. Parmi les ajouts récents, « New Relic Knowledge » pour le dépannage en contexte et l’observabilité des agents IA pour les applications basées sur des LLM.
- OpenTelemetry d’abord. Prise en charge native solide d’OTel, plus de 780 intégrations prêtes à l’emploi.
Pourquoi choisir New Relic
L’offre gratuite est l’argument phare : 100 Go d’ingestion de données par mois, un utilisateur full platform, des utilisateurs basic illimités et l’accès à plus de 50 fonctionnalités. Pour les petites équipes ou les jeunes startups, cela couvre souvent tout, indéfiniment. Au-delà, l’ingestion est facturée au Go (0,40 $ en Original, 0,60 $ en Data Plus), sans frais par hôte. C’est la principale raison pour laquelle les équipes qui fuient Datadog atterrissent ici : activer le monitoring sur des centaines d’hôtes ne multiplie pas votre facture.
Le travail sur l’observabilité de l’IA mérite aussi d’être noté. New Relic a été parmi les premiers à proposer le tracing des agents IA et des applications LLM, y compris le tracing des hallucinations et la corrélation du raisonnement des agents. Si votre pile comprend déjà des charges IA, la même plateforme les couvre.
Ce qu’en disent les utilisateurs
« Notre façon de surveiller notre application et d’analyser les problèmes de performance s’est énormément améliorée depuis l’arrivée de New Relic, car nous découvrons des choses qui nous étaient cachées jusque-là. Ses tableaux de bord polyvalents permettent à chaque membre de l’équipe de choisir les métriques utiles à son domaine. »
« La structure de prix est volatile et grimpe facilement avec de forts volumes de publication et d’alimentation, ce qui complique le budget. L’API a aussi des fonctions avancées réservées aux forfaits haut de gamme. »
Ce qui ressort des avis : des éloges pour l’offre gratuite et la profondeur de l’APM, avec une mise en garde constante sur des coûts d’ingestion qui deviennent imprévisibles à grande échelle. NRQL (le langage de requête) demande aussi un temps d’apprentissage que certains jugent raide.
Points d’attention
Le prix des sièges full platform grimpe vite. Le premier utilisateur full platform est gratuit avec l’offre Free, les utilisateurs Core coûtent 49 $/utilisateur/mois pour un jeu de fonctions restreint, et les utilisateurs full platform coûtent 10 $ pour le premier et 99 $ pour chacun des suivants en Standard (5 au plus), ou 349 $/utilisateur/mois en Pro en facturation annuelle (418,80 $ au mois). Pour une équipe où beaucoup d’ingénieurs ont besoin d’un accès complet, cela peut rivaliser avec les factures par hôte de Datadog.
L’interface est dense. Avec ses nombreuses couches, tableaux de bord et outils affichés en même temps, les nouveaux utilisateurs la trouvent souvent écrasante tant qu’ils n’y ont pas passé quelques semaines. Certains avis signalent aussi une surcharge de l’agent dans les anciennes versions.
Prix
- Free : 100 Go/mois d’ingestion, 1 utilisateur full platform, utilisateurs basic illimités
- Utilisateur Core : 49 $/utilisateur/mois pour un ensemble restreint de fonctions
- Utilisateur full platform : Standard 10 $ pour le premier utilisateur, puis 99 $/utilisateur/mois (5 au maximum) ; Pro 349 $/utilisateur/mois en annuel, 418,80 $ en mensuel
- Ingestion de données : 0,40 $/Go en Original, 0,60 $/Go en Data Plus, au-delà des 100 Go gratuits
- Enterprise : sur devis (FedRAMP, HIPAA, SLA avancés)
- Advanced Compute : modèle CCU à l’usage, sans frais par utilisateur ou avec des frais limités
Choisissez New Relic si
Vous avez besoin d’APM, de tracing distribué et de monitoring d’infrastructure sans les multiplicateurs de facture par hôte. L’offre gratuite suffit à elle seule à beaucoup de petites équipes, et la facturation à l’usage au-delà évolue de façon plus prévisible que la tarification modulaire par fonction de Datadog. C’est aussi le bon choix si vous instrumentez des charges IA ou LLM à côté de services classiques.
3. Dynatrace : le meilleur pour l’analyse des causes racines par IA en entreprise
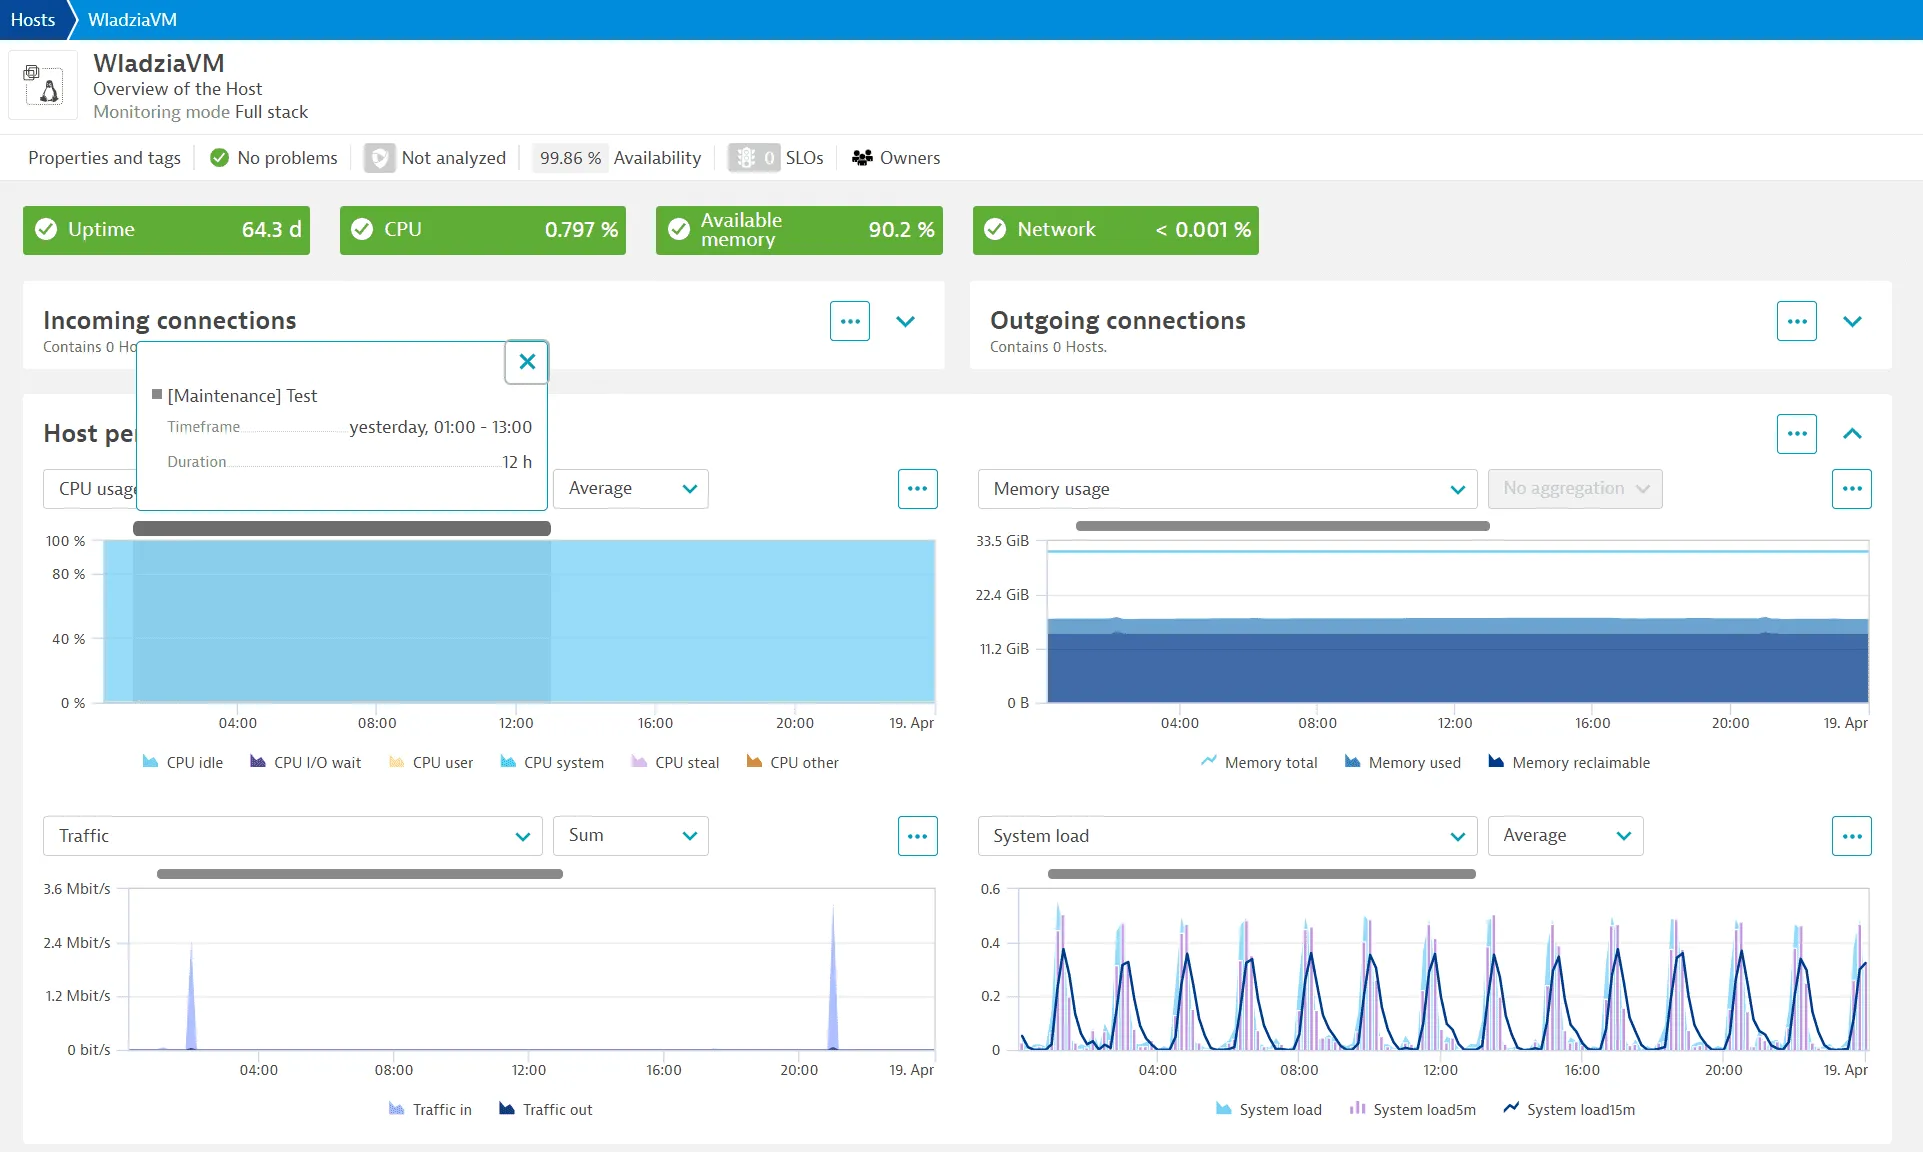
Idéal pour
Les grandes entreprises (souvent plus de 1 000 hôtes) qui exploitent des architectures complexes, cloud-native, en microservices ou hybrides, avec des équipes SRE et plateforme expérimentées.
Fonctionnalités notables
- Auto-instrumentation OneAgent. Un seul agent par hôte, qui découvre automatiquement chaque service, processus et dépendance. Aucune instrumentation manuelle.
- Moteur Davis AI. Corrèle métriques, logs, traces et topologie en une seule cause racine accompagnée de pistes de correction, au lieu de déverser 40 alertes sur votre personne d’astreinte.
- Topologie Smartscape. Une carte des dépendances en temps réel qui suit l’évolution de votre infrastructure.
- Tracing distribué PurePath. Tracing au niveau du code à travers les microservices.
- Data lakehouse Grail. Stockage sans index, en schema-on-read, pour les données d’observabilité, de sécurité et métier, interrogeable en DQL.
- Sécurité applicative incluse. Détection des vulnérabilités à l’exécution, liée au comportement réel de l’application.
Pourquoi choisir Dynatrace
Davis AI est le principal attrait. Les équipes qui gèrent des environnements vastes et changeants constatent une vraie baisse du volume d’alertes et du MTTR, parce que Davis regroupe les signaux liés en un seul incident avec une cause racine proposée. Si votre équipe d’astreinte se noie dans le bruit, la couche IA justifie son prix. OneAgent supprime la corvée de l’instrumentation manuelle, ce qui compte quand votre parc compte des milliers de services qui changent tous les jours.
Pour les entreprises des secteurs réglementés (banque, assurance, santé), réunir l’observabilité et la sécurité applicative à l’exécution sur une seule plateforme réduit l’éparpillement des outils et la charge des audits.
Ce qu’en disent les utilisateurs
« Le produit s’adresse à tout le monde, des dirigeants aux designers, en passant par le marketing et les ingénieurs. Cette large audience stimule l’innovation dans toute l’entreprise et évite que les équipes cloisonnent leur pile technique. J’apprécie aussi sa vision “les processus métier d’abord, la technologie ensuite”. »
Avis Dynatrace sur G2, services financiers, grande entreprise
« Impossible de migrer d’un tenant à l’autre sans risquer de perdre des données. Les outils d’IA doivent être cohérents dans tout le produit. Le modèle de facturation à la consommation n’est pas clair, par exemple ce que coûte réellement une requête en argent, ou ce qu’elle représente en pourcentage de l’engagement annuel. »
Le thème qui revient : l’IA et la découverte automatique impressionnent vraiment à l’échelle d’une grande entreprise, mais optimiser les unités DPS (Dynatrace Platform Subscription) devient un travail permanent à part entière. Les avis décrivent régulièrement la plateforme comme écrasante pour les petites équipes.
Points d’attention
Il n’y a pas d’offre gratuite permanente, seulement un essai de 15 jours. Pour les équipes de moins de 100 hôtes, Dynatrace est surdimensionné et vous payez des fonctions d’IA conçues pour des situations inextricables que vous n’avez pas encore. Le modèle de prix DPS fait baisser le coût unitaire quand la consommation augmente, mais en contrepartie, les petits parcs paient plus cher.
La mise en place est aussi plus lourde qu’avec New Relic ou Datadog. La plateforme impose ses choix, et pour que Davis AI produise du signal plutôt que du bruit, il faut aligner vos conventions de tags et de topologie sur ce qu’il attend.
Prix
- Monitoring full-stack : 58 $/mois par hôte de 8 Gio au prix catalogue (facturé 0,01 $ par Gio de mémoire et par heure) ; l’Infrastructure Monitoring coûte 29 $/hôte/mois
- Logs, synthétique, DEM et sécurité : facturés à part
- Pas d’offre gratuite : essai de 15 jours seulement
- Niveaux : Starter, Professional et Enterprise, selon la profondeur des fonctions et le support
Choisissez Dynatrace si
Vous avez plus de 500 hôtes, une équipe SRE expérimentée, des microservices complexes où la découverte automatique et la corrélation par IA font gagner de vraies heures d’ingénierie, et un budget qui accepte les prix catalogue des grands comptes. Passez votre chemin si vous êtes une petite ou moyenne équipe, ou si vous avez surtout besoin de monitoring d’infrastructure sans APM ni sécurité par-dessus.
4. Better Stack : le meilleur pour le monitoring avec logs et réponse aux incidents
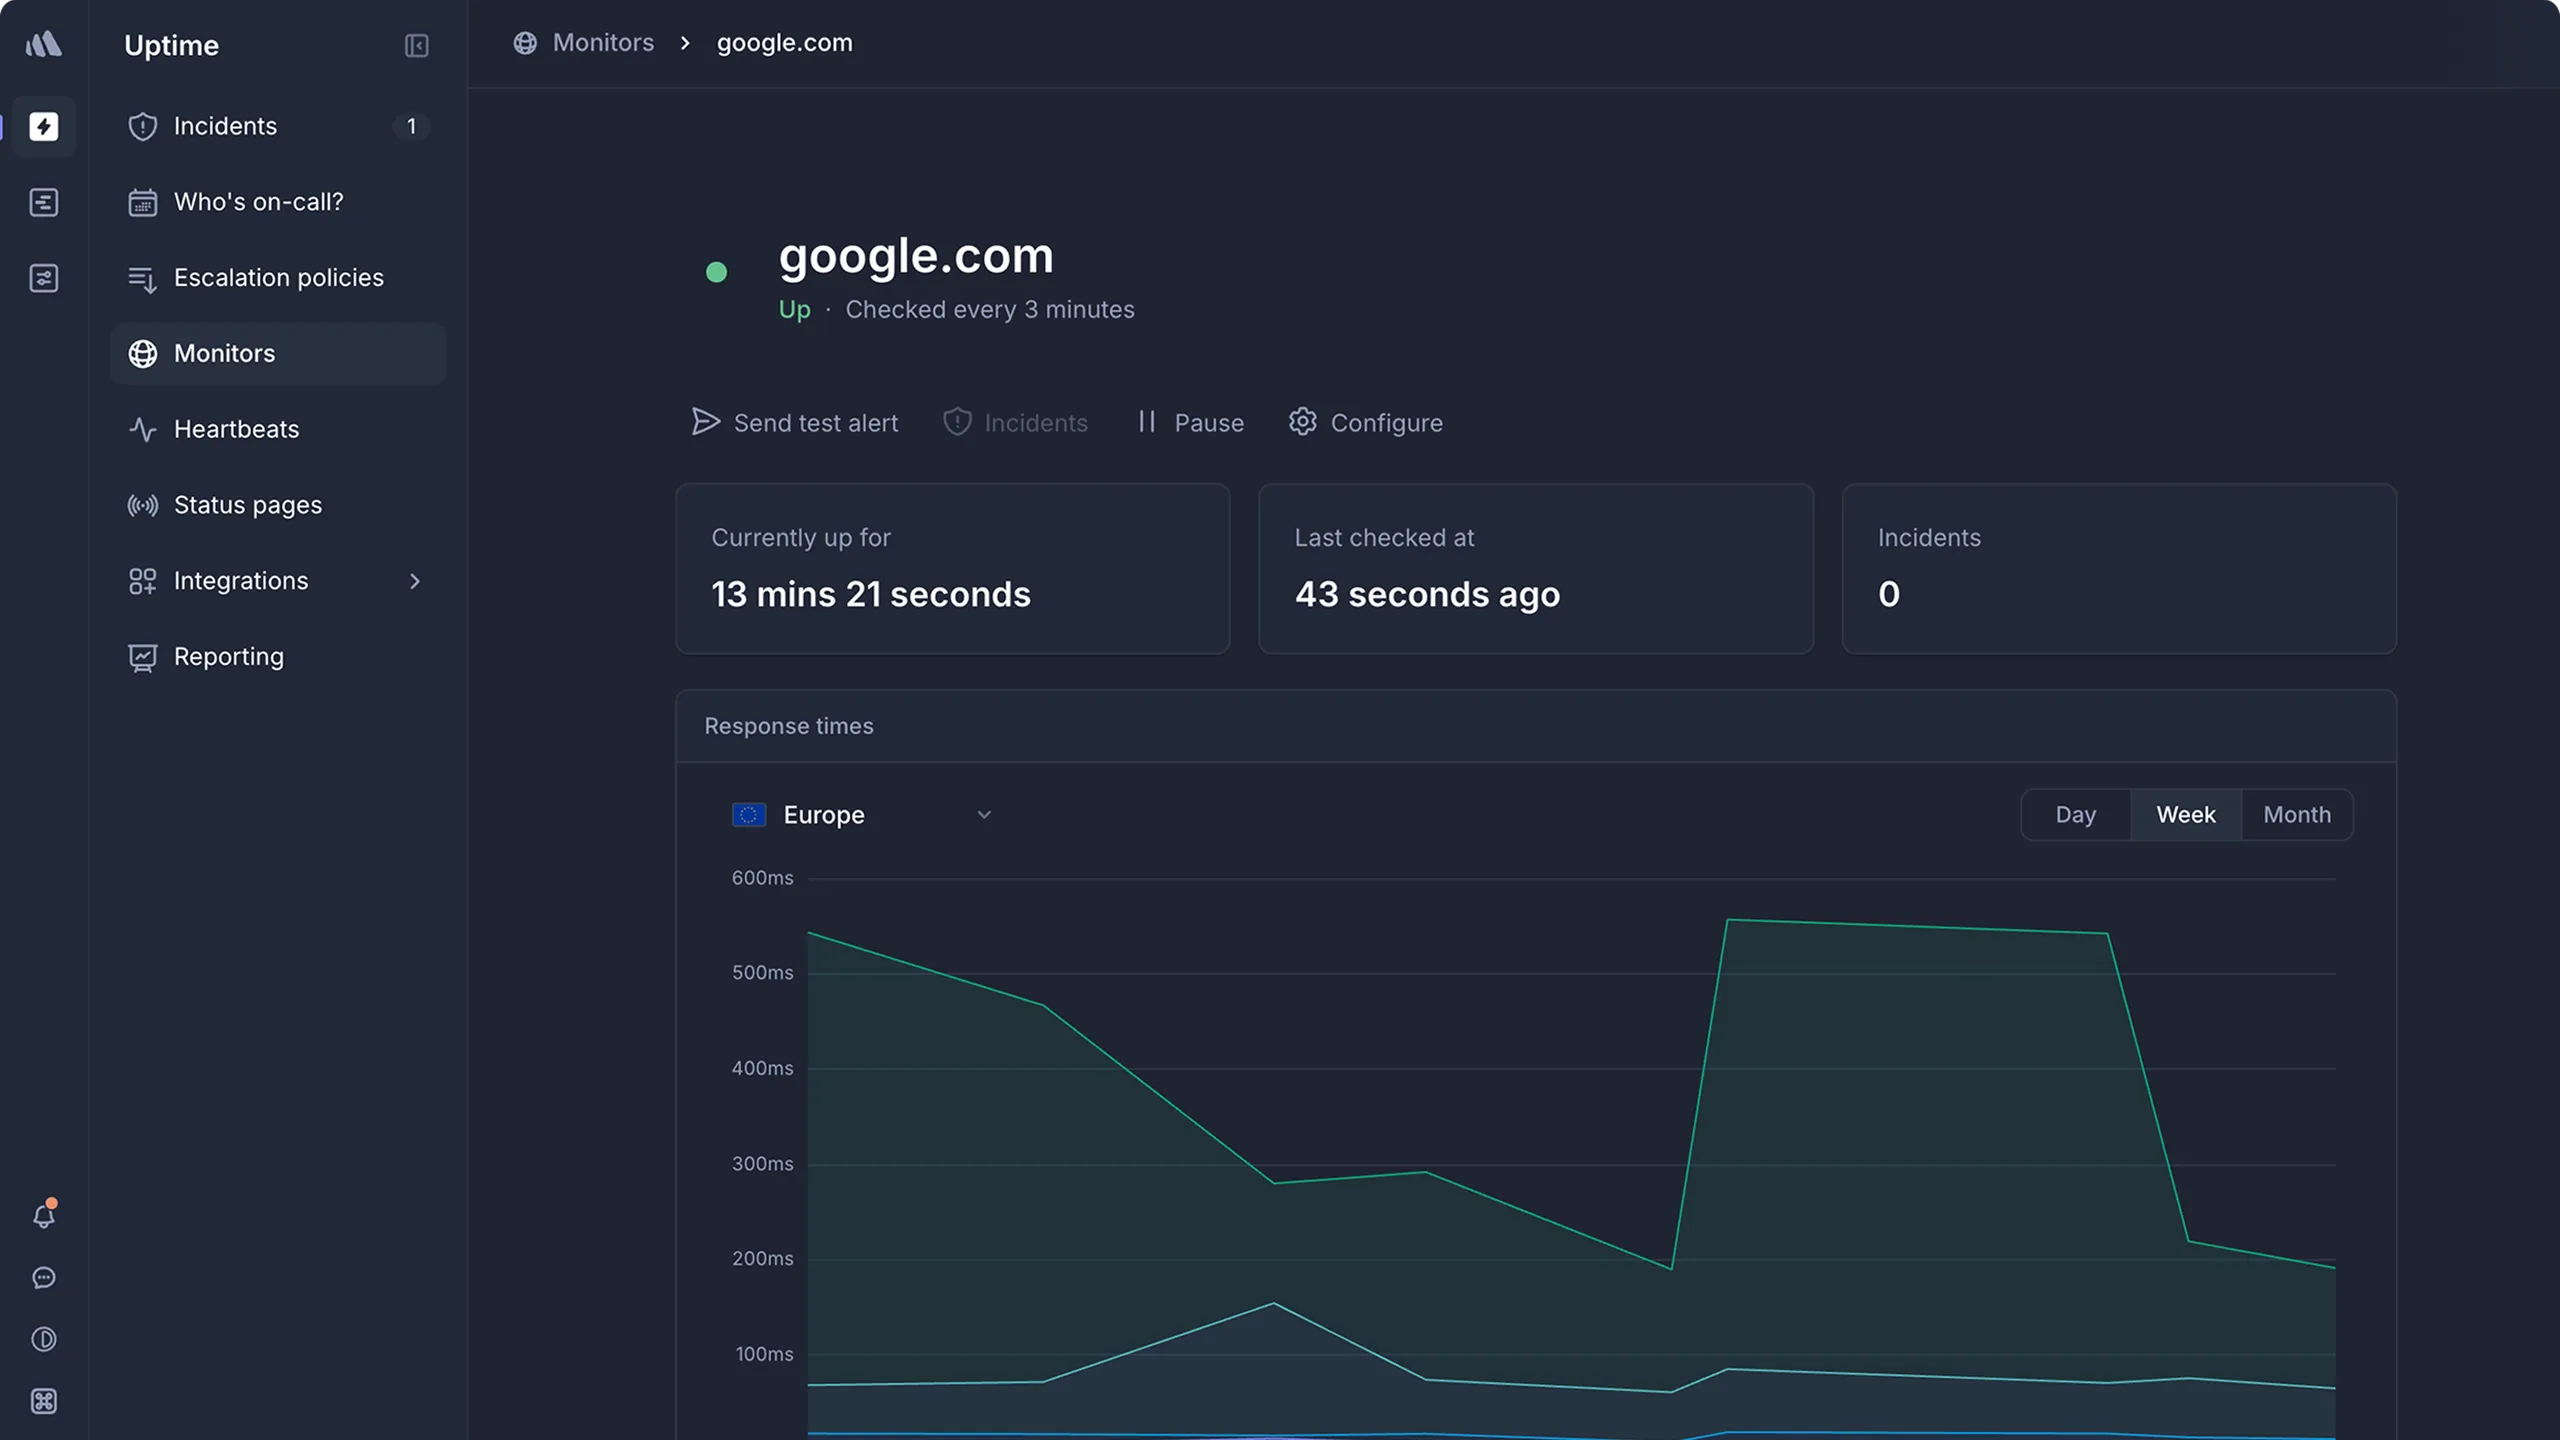
Idéal pour
Les équipes d’ingénierie qui veulent réunir le monitoring de disponibilité, la gestion des logs et la réponse aux incidents dans une plateforme pensée pour les développeurs, avec une interface moderne.
Fonctionnalités notables
- Monitoring de disponibilité avec des vérifications toutes les 30 secondes depuis 17 régions dans le monde. Moniteurs HTTP, SSL, DNS, TCP, UDP, SMTP, POP3, IMAP et cron/heartbeat. Confirmation depuis plusieurs régions avant d’alerter.
- Gestion des logs à grande échelle. Stockage sur ClickHouse, requêtes proches du SQL, suivi en temps réel et agrégation capable d’absorber jusqu’à un milliard de lignes de logs par seconde.
- Gestion des incidents avec astreinte. Plannings, politiques d’escalade, post-mortems assistés par IA, intégration Slack et Teams.
- Pages de statut. Publiques et privées, avec domaines personnalisés et votre marque.
- Tracing OpenTelemetry basé sur eBPF. Auto-instrumentation des services sans modifier le code.
- Réponse aux incidents native IA. Fusion intelligente des alertes pour réduire le bruit, et commentaires sur les logs façon Google Docs pour dépanner en équipe.
Pourquoi choisir Better Stack
Better Stack est le concurrent direct le plus proche de Datadog pour les PME et les entreprises de taille intermédiaire. Il couvre le même large périmètre (disponibilité, logs, traces, incidents, pages de statut) à des prix transparents, généralement une fraction de ceux de Datadog à échelle égale. Son interface est saluée partout comme moderne et pensée pour les développeurs, à l’opposé de l’interface dense et chargée de Datadog.
Le tracing basé sur eBPF fait vraiment la différence pour les équipes qui veulent un APM natif OpenTelemetry sans instrumenter le code à la main. ClickHouse pour les logs offre les performances de requête du log explorer de Datadog, sans son modèle de prix au Go indexé.
Ce qu’en disent les utilisateurs
« BetterStack Uptime est un excellent outil pour surveiller la disponibilité des sites et des services en temps réel. Son interface est moderne, simple et agréable au quotidien. Les diagnostics fournis (captures d’écran, traceroute, monitoring des tâches cron) facilitent vraiment la résolution des incidents. »
« Le seul bémol : le coût peut vite grimper si vous avez beaucoup de moniteurs ou besoin d’intégrations avancées. De plus, certaines options de personnalisation (par exemple sur les pages de statut) restent limitées dans les forfaits d’entrée de gamme. »
« Le premier palier payant démarre d’emblée à 29 $, ce qui est très cher pour les petits services open source que je fais tourner. »
Ce qui ressort des avis : de vrais éloges pour l’interface et l’ensemble des fonctions réunies, avec un retour constant sur le prix qui grimpe vite quand on cumule monitoring, sièges d’astreinte, pages de statut et logs. Certains utilisateurs notent aussi un tableau de bord chargé au-delà de 100 moniteurs.
Points d’attention
La tarification modulaire (facturation séparée des moniteurs, des sièges d’astreinte, des pages de statut et des logs) permet de démarrer petit, mais la note s’alourdit. Une équipe avec 250 moniteurs, l’astreinte pour 5 ingénieurs, 3 pages de statut et une rétention de logs basique dépassera 250 $/mois, là où Hyperping, avec un monitoring et une astreinte comparables, coûte 74 $/mois.
Les options d’auto-hébergement et de personnalisation poussée sont limitées par rapport aux outils pour grands comptes. Pour des charges très réglementées, cela peut être une contrainte.
Prix
- Free : 10 moniteurs, 1 page de statut, rétention des logs limitée
- Monitoring de disponibilité : 29 $/mois de base, selon le nombre de moniteurs
- Astreinte : ~29 $/utilisateur/mois
- Pages de statut : 12 $/mois par page supplémentaire
- Logs : à partir d’environ 25 $/mois avec 30 jours de rétention
- Enterprise : sur devis, avec endpoints illimités et SLA
Choisissez Better Stack si
Vous voulez un seul fournisseur pensé pour les développeurs, qui couvre monitoring, astreinte, logs et réponse aux incidents avec une interface moderne et soignée, et vous acceptez que la facture grossisse à mesure que vous ajoutez des produits. Il convient bien aux startups SaaS qui évoluent vers une observabilité complète et veulent éviter d’assembler trois ou quatre outils spécialisés.
Mentions honorables à connaître
Quelques outils que j’ai examinés sans les retenir dans les quatre premiers. Chacun tient une niche précise.
- Honeycomb. Excellent pour le tracing à forte cardinalité et l’observabilité pilotée par les requêtes. Sa philosophie évite explicitement les écueils du modèle de métriques de Datadog. Idéal pour les équipes qui déboguent des systèmes distribués sans savoir à l’avance quoi chercher. Moins centré sur l’infrastructure ou le monitoring synthétique.
- SigNoz. Open source, natif OpenTelemetry, avec une interface proche de celle de Datadog. L’auto-hébergé est gratuit ; le cloud démarre à 49 $/mois, dont 49 $ d’usage inclus, avec un essai gratuit. Des économies de 80 à 90 % annoncées face à Datadog à grande échelle. Écosystème plus jeune et moins d’intégrations pour les grands comptes.
- Grafana Cloud / pile LGTM (Loki, Mimir, Tempo, Grafana). Le choix par défaut des équipes très Kubernetes et très ingénierie. Offre gratuite généreuse, payant à partir de 19 $/mois plus l’usage. La contrepartie : c’est à vous de l’assembler.
- Chronosphere. Prix à l’usage, centré sur les pipelines de télémétrie et la maîtrise des coûts (jusqu’à 80 % d’économies annoncées). Racheté par Palo Alto Networks fin 2025, il rejoint une offre de sécurité plus large.
- Splunk Observability Cloud. Solide pour l’analyse de logs et le recoupement entre sécurité et observabilité. Prix complexe et coût élevé pour une ingestion à grande échelle.
- Elastic Observability. Logs et métriques fondés sur la recherche, avec de bonnes options d’auto-hébergement. Gourmand en ressources à exploiter à grande échelle.
Pour les équipes Kubernetes qui veulent assembler leur propre pile, Prometheus + Grafana reste le choix par défaut. Gratuit, souple et standard de la CNCF, mais c’est vous qui l’exploitez (en ajoutant Thanos ou Mimir pour le stockage longue durée, Loki pour les logs, Tempo pour les traces).
Les choix open source
Si vous avez du temps d’ingénierie et voulez zéro coût de licence :
- Prometheus + Grafana pour les métriques Kubernetes et cloud-native
- SigNoz ou Uptrace pour une observabilité tout-en-un native OpenTelemetry
- OpenObserve ou Parseable pour un stockage de logs et de métriques performant et peu coûteux
- Zabbix pour le monitoring d’infrastructure sur site et hybride à grande échelle
- Uptime Kuma pour de simples vérifications de disponibilité et une page de statut basique (homelabs et petites équipes)
En pratique, l’auto-hébergement est rarement gratuit. Vous payez en infrastructure, en maintenance continue, en astreinte pour l’outil de monitoring lui-même et en temps d’ingénierie pour les mises à jour. Le calcul fonctionne surtout si vous avez déjà une équipe plateforme ou SRE dédiée.
La liste complète des alternatives à Datadog que j’ai examinées
Par souci d’exhaustivité, voici les plus de 30 outils que j’ai passés en revue avant de m’arrêter sur les quatre choix. Les prix sont approximatifs, tirés de données de marché 2025 à 2026, et varient selon l’usage (hôtes, Go ingérés, événements, séries temporelles).
| Nom | Point fort | Point faible | Prix de départ |
|---|---|---|---|
| Hyperping | Tout-en-un à prix fixe pour le SaaS | Ni APM complet ni stockage de traces | 24 €/mois |
| New Relic | Offre gratuite généreuse, APM solide | Apprentissage de NRQL | Gratuit jusqu’à 100 Go/mois |
| Dynatrace | Davis AI, découverte automatique OneAgent | Cher, pas d’offre gratuite | ~58 $/hôte/mois en full-stack |
| Better Stack | Interface moderne, logs et incidents réunis | La tarification modulaire s’additionne | 29 $/mois |
| Datadog | Intégrations nombreuses, finition | Coût à grande échelle | ~15 $/hôte/mois |
| Splunk Observability | Analyse de logs, sécurité | Prix complexe | Sur devis |
| Elastic Observability | Recherche, option auto-hébergée | Gourmand en ressources | OSS gratuit / cloud dès 95 $ |
| Grafana Cloud / LGTM | Visualisation, modulaire | À assembler soi-même | Gratuit / dès 19 $ + usage |
| SigNoz | Natif OpenTelemetry, OSS | Écosystème jeune | OSS gratuit / cloud payant |
| Honeycomb | Tracing à forte cardinalité | Moins centré sur l’infra | Gratuit jusqu’à 20 M d’événements |
| Chronosphere | Maîtrise des coûts de télémétrie | Virage sécurité après le rachat | À l’usage |
| Prometheus | Le standard Kubernetes | Modules de stockage nécessaires | OSS gratuit |
| Zabbix | Sur site à grande échelle | Apprentissage difficile | OSS gratuit |
| Nagios XI / Core | Monitoring réseau éprouvé | Interface datée, faible sur les traces | Gratuit / milliers de $ par an |
| SolarWinds Observability | IT hybride, réseau | Image de marque (SUNBURST) | Abonnement |
| AppDynamics (Cisco) | APM pour grands comptes | Complexe, opaque | Sur devis |
| LogicMonitor | AIOps, infrastructure | Prix opaque | À l’usage |
| Sumo Logic | Analyse de logs | Interface vieillissante | À l’usage |
| OpenObserve | Logs OSS performants | Communauté plus petite | OSS gratuit |
| Uptrace | OSS natif OpenTelemetry | Peu connu | OSS gratuit |
| OneUptime | Tout-en-un open source | Encore peu adopté en entreprise | OSS gratuit |
| Netdata | Métriques d’infra en temps réel | Centré sur l’hôte | OSS gratuit |
| Parseable | Logs sur stockage objet | En cours de maturation | OSS gratuit |
| HyperDX | Unifié, centré sur l’expérience développeur | Présence plus discrète | Offre gratuite + usage |
| Middleware | Observabilité LLM/IA | Niche | À l’usage |
| Site24x7 | Disponibilité + infra, prix PME | APM moins poussé | Abonnement |
| Groundcover | eBPF, Kubernetes | Centré sur K8s | À l’usage / par hôte |
| Dash0 | Natif OpenTelemetry | Nouveau venu | Offre gratuite |
| Arize Phoenix | Observabilité ML/LLM | Périmètre étroit | OSS gratuit / payant |
| Kloudfuse | Observabilité unifiée | Peu connu | Grands comptes |
| ScienceLogic | AIOps pour l’exploitation IT | Centré sur l’exploitation classique | Abonnement |
| ManageEngine | Large suite IT | Interface surchargée | Par paliers |
| Uptime Kuma | Gratuit, auto-hébergé | Une seule région, pas d’API | OSS gratuit |
Les informations de cette liste viennent d’analyses 2025 à 2026 de Gartner Peer Insights, des pages de prix des éditeurs, de comparatifs publiés par SigNoz, OneUptime, Uptrace et OpenObserve, et de fils Reddit sur r/devops, r/sre et r/Monitoring.
Comment choisir
Trois questions suffisent à trancher la plupart des cas.
Vous avez surtout besoin de disponibilité, de santé des serveurs, de pages de statut et d’astreinte ? Hyperping est le choix prévisible à prix fixe, et la comparaison Hyperping vs Datadog détaille le remplacement fonction par fonction. L’agent serveur de 2026 couvre CPU, mémoire, disque et réseau sur les hôtes Linux et macOS. Pages de statut et astreinte sont incluses. Aucun multiplicateur de facture par hôte.
Vous avez besoin d’un vrai APM et de tracing distribué ? New Relic si vous voulez l’offre gratuite la plus généreuse et une conception OpenTelemetry d’abord. Dynatrace si vous êtes à l’échelle d’une grande entreprise avec des milliers d’hôtes et voulez que Davis AI trie les incidents pour vous.
Vous avez besoin du monitoring, des logs et de la réponse aux incidents dans un seul outil pensé pour les développeurs ? Better Stack. Interface moderne, logs sur ClickHouse, tracing eBPF. La contrepartie : la facture grimpe à mesure que vous ajoutez des produits.
Si vous faites tourner une pile Kubernetes et avez du temps d’ingénierie, Prometheus + Grafana + Loki + Tempo reste la voie la moins chère à grande échelle. Le coût est opérationnel, pas en licences.
Les erreurs fréquentes en quittant Datadog
Quelques schémas que j’ai vus revenir dans les fils Reddit.
- Choisir un outil qui règle la facture d’aujourd’hui, pas la pile de l’an prochain. La plupart des équipes sous-estiment la croissance de leur volume de données. Un outil bon marché à 20 hôtes ne l’est pas forcément à 200 s’il facture les logs à l’usage.
- Sous-estimer le coût de la migration. L’instrumentation propriétaire de Datadog ne se transpose pas proprement chez un autre fournisseur. Prévoyez du temps d’ingénierie pour réécrire l’instrumentation, recréer les alertes et reconstruire les tableaux de bord. Les remplaçants pensés d’abord pour OpenTelemetry (New Relic, SigNoz, Uptrace) réduisent cet effort sans le supprimer.
- Oublier les pages de statut et l’astreinte. Beaucoup d’équipes remplacent Datadog puis se rendent compte qu’elles utilisaient aussi Statuspage.io et PagerDuty, à 200 à 400 $/mois chacun. Un outil groupé comme Hyperping ou Better Stack comble ce manque. Datadog seul ne l’a jamais fait.
- Passer entièrement à l’open source sans les effectifs. Prometheus, Loki et Tempo sont gratuits en tant que logiciels, pas en exploitation. Sans ingénieur plateforme dédié, les économies partent en temps d’incident et en mises à jour à répétition.
- Traiter le « tout-en-un » comme une liste de fonctions à cocher. Aucun remplaçant n’égale tout le périmètre de Datadog avec le même niveau de finition. Choisissez la partie dont vous vous servez vraiment au quotidien.
En résumé
Il n’y a pas de meilleure alternative à Datadog dans l’absolu, seulement le meilleur remplaçant pour la partie de Datadog dont vous dépendez vraiment.
- Pour la disponibilité, le monitoring de serveurs, les pages de statut et l’astreinte dans un seul outil à prix fixe : Hyperping.
- Pour l’APM et le tracing avec une offre gratuite qui dure : New Relic.
- Pour l’analyse des causes racines par IA à l’échelle de l’entreprise : Dynatrace.
- Pour le monitoring avec les logs et la réponse aux incidents dans un seul produit pensé pour les développeurs : Better Stack.
Si vous voulez un outil qui détecte les problèmes depuis l’extérieur de votre réseau en 30 secondes, suit le CPU et la mémoire de chaque hôte après une installation en une ligne, et réunit pages de statut et astreinte dans le même abonnement, essayez Hyperping gratuitement pendant 14 jours.
À lire aussi
- Les meilleurs outils de monitoring de sites web : comparez les principales plateformes de monitoring
- Les meilleurs outils de monitoring de serveurs : Datadog, Dynatrace, Hyperping et des options open source
- Guide du monitoring de serveurs Linux : CPU, mémoire, disque et réseau sur vos propres hôtes
- Seuils d’alerte pour le monitoring de serveurs : où placer les alertes CPU, mémoire et disque
- Les meilleurs outils de planning d’astreinte : associer monitoring et astreinte
- Better Stack vs Datadog vs Hyperping : comparaison directe
- Alternatives à Pingdom : si vous évaluez aussi Pingdom
- Alternatives à Better Stack : si Better Stack fait partie de votre sélection
- Guide du MTTR : mesurer et réduire le temps moyen de résolution
- Tarifs d’Hyperping
Continuer la comparaison : Hyperping vs Datadog · Hyperping vs New Relic · Tarifs d’Hyperping · Toutes les comparaisons
Questions fréquentes
Quelle est la meilleure alternative à Datadog ? ▼
Tout dépend de ce dont vous avez vraiment besoin. Pour le monitoring de disponibilité, les pages de statut, l’astreinte et le monitoring de serveurs dans un seul outil à prix fixe, Hyperping démarre à 24 €/mois. Pour un APM complet avec une offre gratuite généreuse, New Relic offre 100 Go/mois. Pour l’analyse des causes racines par IA en entreprise, Dynatrace. Pour le monitoring avec les logs et la réponse aux incidents, Better Stack.
Pourquoi les équipes quittent-elles Datadog ? ▼
D’après les fils Reddit et les avis que j’ai lus, la raison principale est le prix. La facture gonfle avec l’ingestion de logs, les métriques personnalisées, le nombre d’hôtes et les spans APM. Beaucoup d’utilisateurs parlent de factures trois à dix fois supérieures à leur budget. La dépendance au fournisseur, liée aux agents propriétaires, arrive en deuxième position.
Existe-t-il une alternative gratuite à Datadog ? ▼
Oui. New Relic a une offre gratuite permanente avec 100 Go d’ingestion de données par mois et un utilisateur full platform. Prometheus avec Grafana est entièrement open source. SigNoz et Uptrace sont des options open source natives OpenTelemetry. Hyperping a aussi un forfait gratuit avec 20 moniteurs, un agent serveur et une page de statut.
Quelle est l’alternative à Datadog la moins chère ? ▼
En auto-hébergé, Prometheus avec Grafana et SigNoz sont gratuits si vous avez le temps d’ingénierie pour les faire tourner. En SaaS, Hyperping démarre à 24 €/mois avec le monitoring, les pages de statut, l’astreinte et les agents serveur inclus. L’offre gratuite de New Relic suffit indéfiniment à la plupart des petites équipes.
Datadog vaut-il son prix ? ▼
Pour les équipes qui font tourner plus de 50 hôtes avec des microservices distribués et qui se servent vraiment de l’APM, des logs et des métriques ensemble, oui. Pour celles qui ont surtout besoin de monitoring de disponibilité, de la santé des serveurs ou de pages de statut, Datadog est surdimensionné, et la facture grimpe plus vite que prévu à mesure que le volume de logs et les métriques personnalisées augmentent.