Les meilleures alternatives à Nagios en 2026 sont Hyperping (monitoring hébergé des serveurs et de la disponibilité, avec astreinte et pages de statut intégrées), Icinga (le remplaçant open source le plus direct, avec les mêmes plugins), Checkmk (compatible avec les plugins Nagios, avec la découverte automatique en plus), Zabbix (monitoring open source tout-en-un à base de templates) et Prometheus avec Grafana (monitoring centré sur les métriques pour les stacks cloud native). Je présente aussi Netdata, Datadog, PRTG et LibreNMS pour les équipes à qui ils conviennent mieux.
Nagios fonctionne toujours. Nagios Core 4.5.14 est sorti le 5 août 2026, et beaucoup d’équipes le font tourner sans incident. Si l’on s’en va, c’est à cause de tout ce qui entoure les vérifications : des fichiers d’objets écrits à la main, un plugin à installer et à mettre à jour sur chaque hôte, une interface qui a peu changé depuis des années et une couche d’alerte qui s’arrête à « envoyer un e-mail à ce contact ».
Dans ce guide, vous verrez :
- Pourquoi les équipes remplacent Nagios, d’après les avis d’utilisateurs et la documentation de chaque outil
- Neuf alternatives avec leurs prix, leur mode d’hébergement, l’effort de mise en place et leur gestion des alertes et de l’astreinte
- Lesquelles sont open source, lesquelles sont gratuites et lesquelles conviennent le mieux aux hôtes Windows
- Comment sortir l’alerte et la communication client de Nagios sans migration big bang
Points clés
- Icinga est la transition open source la plus simple : il exécute vos plugins Nagios existants, ajoute une API REST et du clustering, et il est gratuit, sans limite d’hôtes.
- Checkmk reste compatible avec les plugins Nagios mais remplace la configuration écrite à la main par une découverte des services via agent et une interface web. Community est gratuit, Pro démarre à 190 €/mois en facturation annuelle.
- Zabbix et Prometheus + Grafana sont les plateformes open source les plus solides si vous acceptez de reconstruire vos vérifications de zéro plutôt que de les porter.
- Hyperping convient aux équipes dont le vrai problème, c’est l’alerte d’astreinte : un agent Linux, macOS et Windows, des plannings d’astreinte, des politiques d’escalade et des pages de statut dans un seul outil hébergé, à partir de 24 €/mois en facturation annuelle.
- PRTG est le bon choix si vous voulez le serveur de monitoring lui-même sous Windows. Son serveur central ne tourne que sous Windows.
Pourquoi faire confiance à ce guide
Je suis Léo, fondateur de Hyperping. J’ai donc un intérêt dans l’un de ces outils, et Hyperping est cité en premier. J’ai essayé d’être précis sur ses limites, car il ne remplace pas tout ce que fait Nagios : il n’a pas de système de plugins, pas d’interrogation SNMP des équipements réseau et pas d’édition auto-hébergée.
Pour les autres outils, j’ai vérifié les prix et les licences sur le site officiel de chaque éditeur le 28 septembre 2026, lu les avis Capterra sur Nagios Core et Nagios XI, et parcouru la documentation des éditeurs sur les alertes et l’astreinte. Quand je n’ai pas pu vérifier un point directement, je le dis.
Les meilleurs choix en un coup d’œil
| Idéal pour | Produit |
|---|---|
| Monitoring des serveurs hébergé, astreinte et pages de statut incluses | Hyperping |
| Remplaçant open source direct qui réutilise les plugins Nagios | Icinga |
| Compatibilité Nagios avec découverte automatique et configuration web | Checkmk |
| Monitoring tout-en-un gratuit avec templates et interface web | Zabbix |
| Monitoring centré sur les métriques pour conteneurs et stacks cloud native | Prometheus + Grafana |
| Métriques à la seconde, presque sans configuration | Netdata |
| Observabilité complète avec APM, logs et traces | Datadog |
| Serveur de monitoring sous Windows avec capteurs réseau | PRTG |
| Monitoring des équipements réseau SNMP avec découverte automatique | LibreNMS |
Pourquoi les équipes quittent Nagios
Nagios est né en 1999 sous le nom de NetSaint et il est devenu l’outil de monitoring open source de référence des années 2000. Son modèle de vérification (lancer un petit programme, lire le code de sortie, alerter sur 0, 1, 2 ou 3) est si répandu que la moitié des outils ci-dessous le parlent encore. Les reproches que j’ai trouvés portent sur tout le reste.
Des plugins à gérer sur chaque hôte
Chaque vérification Nagios est un programme externe. Vérifier l’espace disque d’un hôte Linux distant implique d’installer NRPE ou NCPA sur cet hôte, d’y déployer check_disk et ses dépendances, puis de garder les versions synchronisées sur tout le parc. Les hôtes Windows demandent en plus NSClient++ ou NCPA. Les vérifications sur mesure finissent généralement en scripts Perl, Bash ou Python écrits par une personne et que personne d’autre ne comprend.
Sur Capterra, un utilisateur de Nagios XI décrit un modèle qui vous oblige à assembler une collection de scripts de test, à les distribuer et à installer leurs dépendances sur chaque nœud géré. Multipliez cela par quelques centaines d’hôtes et la maintenance des plugins devient un mi-temps.
La configuration vit dans des fichiers texte
Nagios Core définit les hôtes, services, contacts, commandes et timeperiods comme des objets dans des fichiers .cfg. Ajouter un serveur, c’est écrire (ou générer depuis un template) ses définitions d’hôte et de services, lancer nagios -v pour valider, puis recharger. Il n’y a aucune découverte : rien n’apparaît tant que quelqu’un ne l’a pas ajouté.
C’est le point que les utilisateurs signalent le plus. Extraits des avis Capterra sur Nagios Core :
« Il n’y a pas de fonction de découverte automatique, chaque hôte et chaque service doivent être ajoutés à la main. »
Administrateur IT, secteur du jeu vidéo
« Pour que tout fonctionne, il faut une bonne maîtrise de l’administration Linux en ligne de commande et savoir modifier des fichiers de configuration depuis le terminal. »
Directeur des opérations
Nagios XI ajoute un Core Config Manager web et des assistants de configuration, ce qui règle une grande partie du problème. Mais XI est un produit commercial, et son édition gratuite s’arrête à 7 nœuds ou 100 services.
Une interface datée, sans graphiques intégrés dans Core
L’interface web de Nagios Core est un ensemble de pages CGI qui ressemblent beaucoup à ce qu’elles étaient il y a dix ans. Core n’a pas de graphiques de métriques natifs : les équipes y greffent PNP4Nagios, Graphite ou Grafana pour voir une tendance CPU. Un utilisateur de Nagios XI sur Capterra le dit sans détour : « L’UI/UX paraît un peu datée face aux plateformes d’observabilité SaaS modernes. » XI inclut bien des graphiques de performance, mais les utilisateurs jugent toujours son interface datée.
L’alerte s’arrête aux notifications
C’est le manque qui compte le plus dès qu’une équipe est d’astreinte. Les notifications Nagios sont des commandes shell (notify-service-by-email) envoyées à des contacts pendant des timeperiods. Les escalades existent sous forme d’objets de configuration, mais il n’y a ni calendrier d’astreinte, ni rotation modifiable depuis un téléphone, ni remplacement ponctuel pour un jour de maladie, ni acquittement en dehors de l’interface web.
La plupart des équipes sous Nagios branchent donc un deuxième outil pour l’alerte : PagerDuty, Opsgenie (qui ferme le 5 avril 2027, voir notre guide sur la fermeture d’Opsgenie) ou un script maison. Et les clients apprennent toujours les pannes par des tickets au support, car Nagios n’a pas de page de statut publique. Cela fait trois outils, trois configurations et trois endroits où une alerte peut se perdre.
Le coût des licences XI à grande échelle
Nagios Core est gratuit sous GPLv2. Nagios XI Standard est une licence perpétuelle à partir de 2 595 $ pour 100 nœuds et 14 995 $ pour 1 000 nœuds, les fonctionnalités Enterprise étant facturées en option (à partir de 4 690 $ pour 100 nœuds). Un contrat de maintenance et de support est obligatoire pour conserver les fonctionnalités premium après la première année, selon la page de tarifs de Nagios XI. Un utilisateur Capterra résume : « Le coût de la licence est très élevé. »
Comparatif rapide : les alternatives à Nagios
| Outil | Prix de départ | Hébergement | Mise en place | Alertes et astreinte | Hôtes Windows |
|---|---|---|---|---|---|
| Hyperping | Gratuit ; 24 €/mois en annuel | Hébergé (SaaS) | Faible : une commande par hôte | Plannings d’astreinte, politiques d’escalade, téléphone/SMS/Slack/Teams, pages de statut incluses | Agent natif (Windows 10 / Server 2016+) |
| Icinga | Gratuit ; abonnements à partir de 2 000 $/an | Auto-hébergé | Moyenne à élevée | Notifications par règles ; plannings dans Icinga Notifications (bêta) | Icinga for Windows (PowerShell) |
| Checkmk | Community gratuit ; Pro à partir de 190 €/mois en annuel | Auto-hébergé ou Cloud | Moyenne | Notifications par règles ; alerte d’astreinte via des intégrations | Agent natif |
| Zabbix | Gratuit ; Cloud à partir de 50 $/mois | Auto-hébergé ou Cloud | Moyenne à élevée | Actions avec étapes d’escalade ; pas de calendrier d’astreinte | Agent natif |
| Prometheus + Grafana | Gratuit ; Grafana Cloud Pro 19 $/mois + usage | Auto-hébergé ou Grafana Cloud | Élevée | Routage Alertmanager ; Grafana IRM pour l’astreinte (20 $/utilisateur actif) | windows_exporter |
| Netdata | Gratuit (5 nœuds) ; Business 7 $/nœud/mois en annuel | Agent + Netdata Cloud ou sur site | Faible | Notifications d’alertes ; pas de plannings d’astreinte | Agent natif |
| Datadog | Gratuit (5 hôtes) ; 15 $/hôte/mois en annuel | Hébergé (SaaS) | Faible à moyenne | Monitors + produit On-Call séparé (20 $/siège) | Agent natif |
| PRTG | Gratuit (100 capteurs) ; 200 $/mois en annuel | Auto-hébergé (Windows) ou PRTG Hosted Monitor | Moyenne | Déclencheurs de notification ; pas de plannings d’astreinte | Serveur central uniquement sous Windows |
| LibreNMS | Gratuit | Auto-hébergé (Linux) | Moyenne | Règles d’alerte vers e-mail, Slack et plus ; pas d’astreinte | SNMP |
Hyperping : idéal pour un monitoring hébergé avec astreinte et pages de statut intégrées
Pour qui est conçu Hyperping
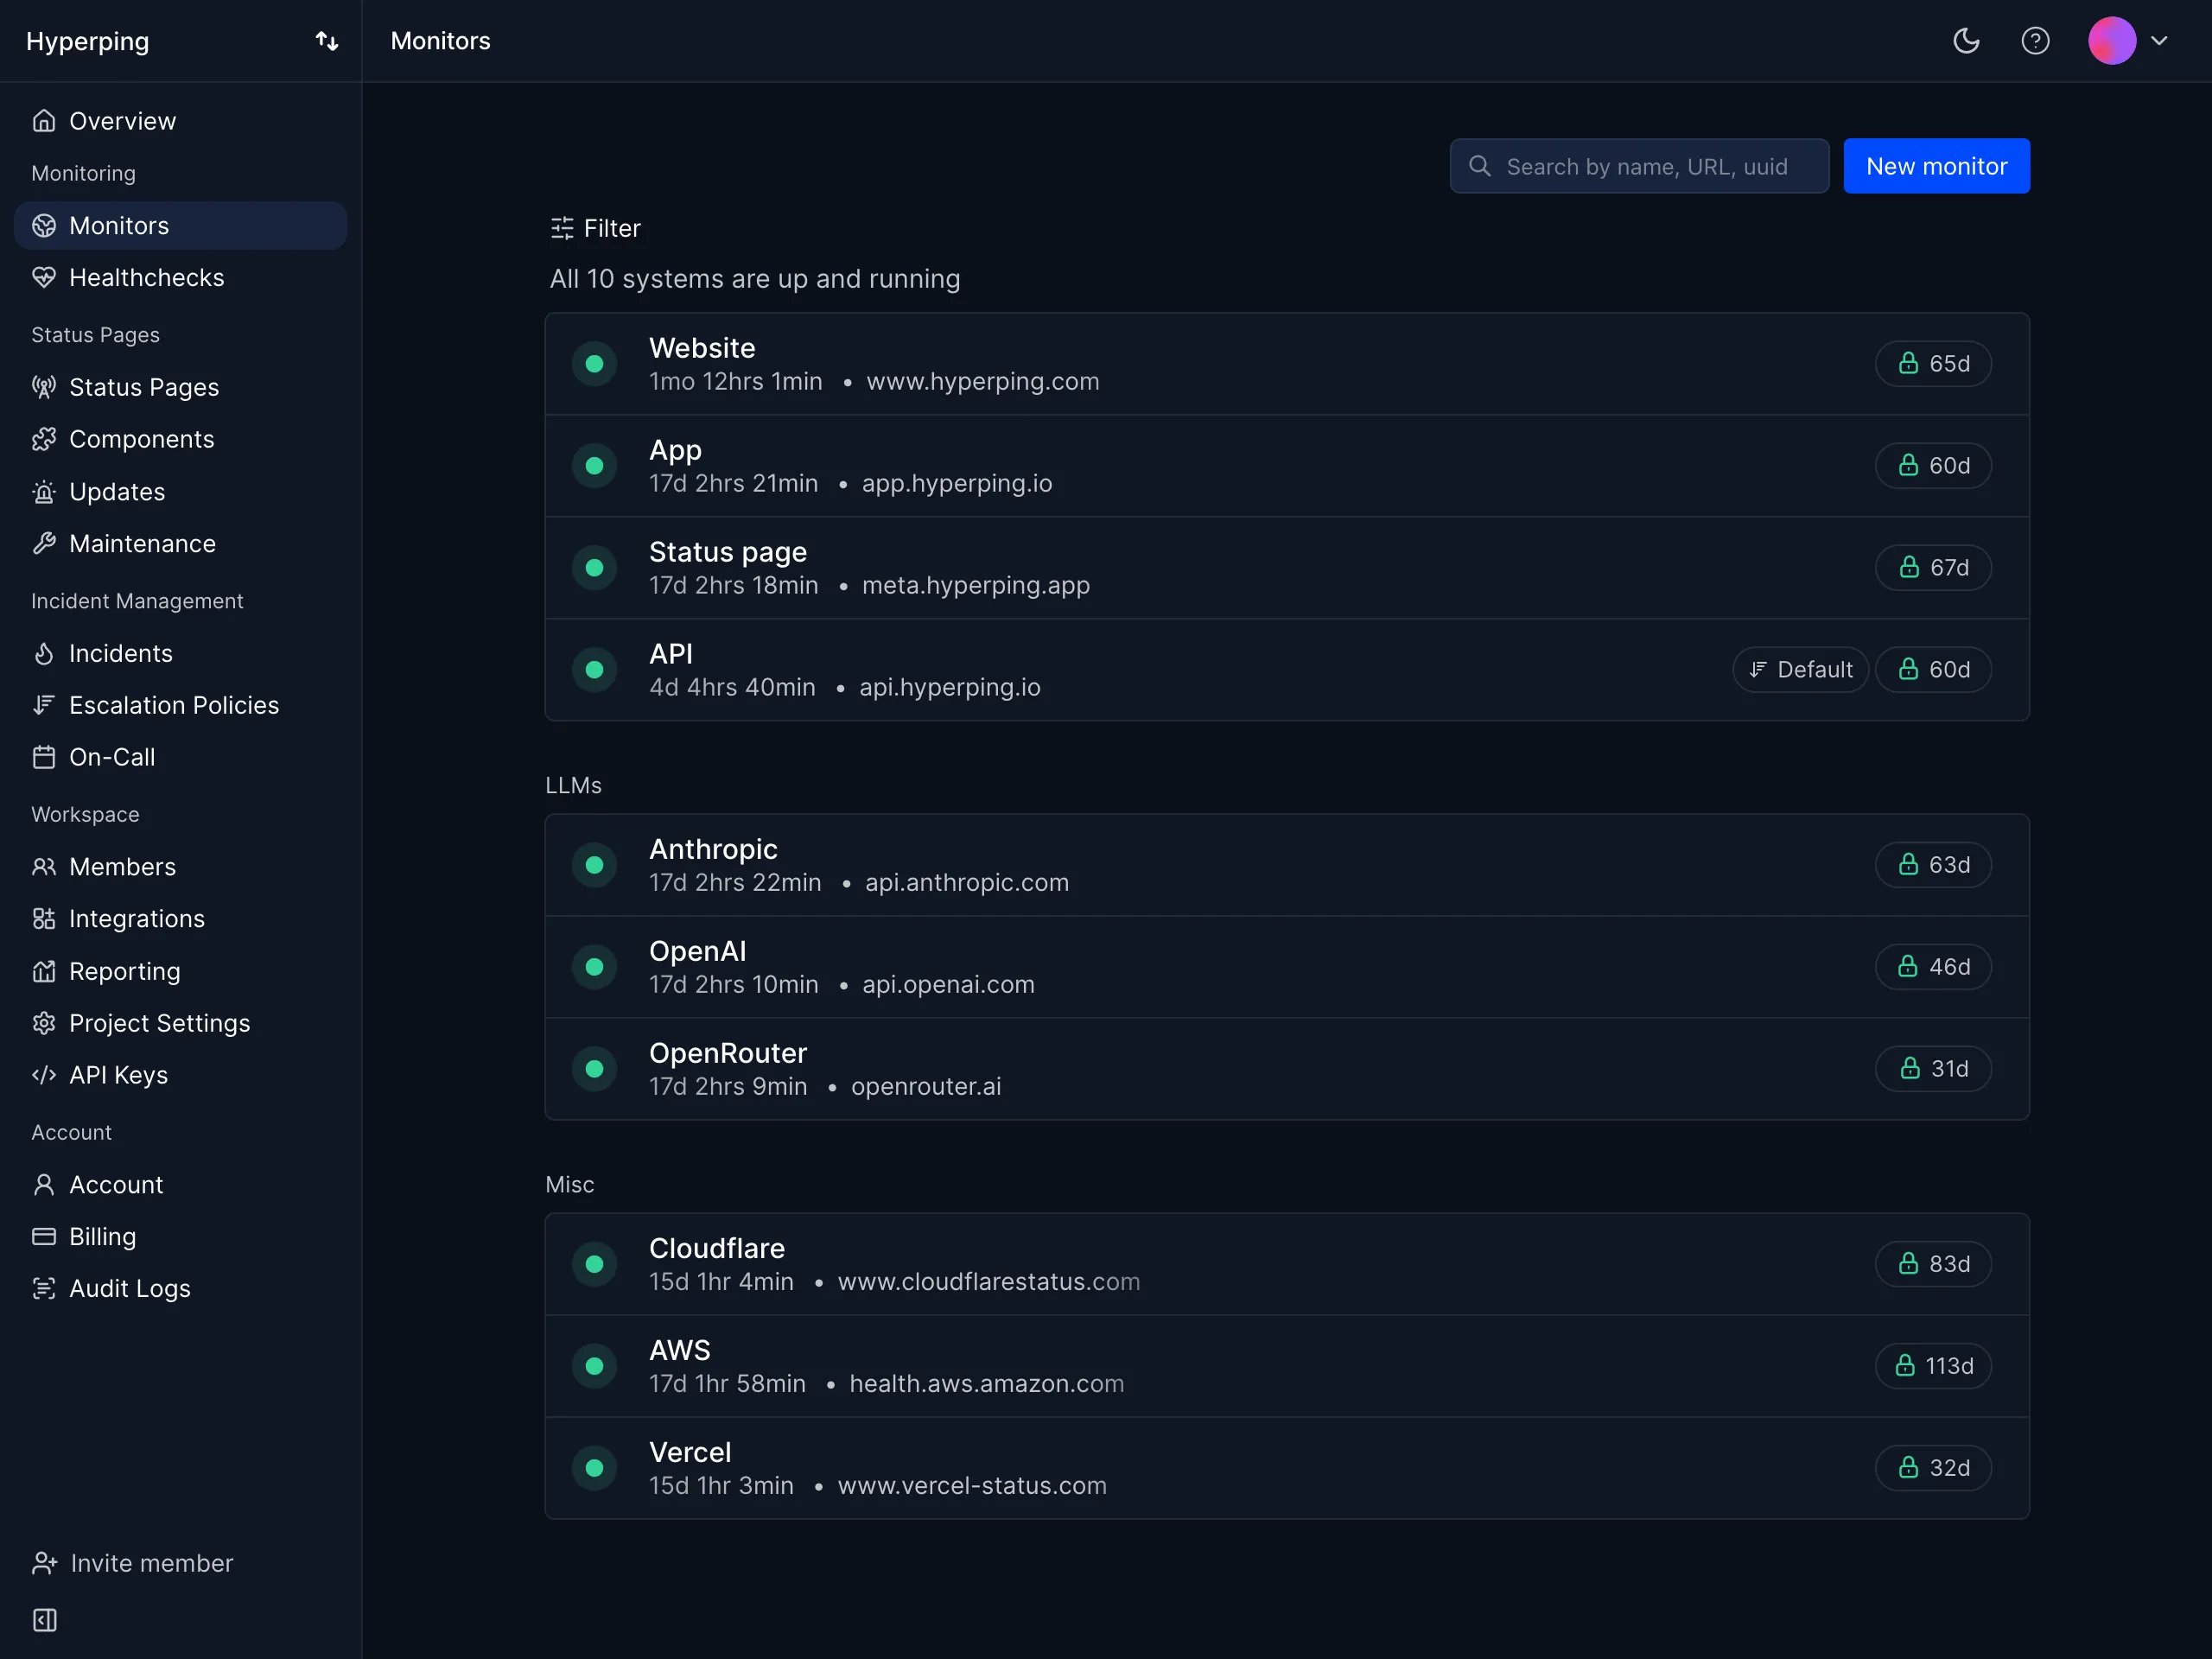
Les équipes qui gèrent de quelques serveurs à quelques centaines, qui ne veulent plus maintenir le serveur de monitoring lui-même, et dont le plus gros manque se situe après l’échec d’une vérification : qui est alerté, que se passe-t-il si cette personne ne répond pas, et comment les clients sont-ils informés.
Hyperping n’est pas un remplaçant équivalent de Nagios. Il n’exécute pas de plugins Nagios et n’interroge pas les switchs en SNMP. Il couvre la partie d’une installation Nagios que la plupart des petites et moyennes équipes utilisent vraiment (l’hôte est-il en vie, manque-t-il de CPU, de mémoire ou de disque, le service répond-il) et ajoute la couche d’alerte d’astreinte et de page de statut que Nagios n’a jamais eue.
Fonctionnalités notables
- Agent en une ligne pour Linux, macOS et Windows : une seule commande d’installation enregistre un service systemd, launchd ou Windows. Il tourne sur amd64 et arm64 (amd64 sous Windows), vise environ 50 Mo de mémoire et n’a besoin que de HTTPS sortant. Les détails sont dans la référence d’installation de l’agent.
- Métriques de l’hôte toutes les 30 secondes : utilisation CPU avec load average sur 1, 5 et 15 minutes, mémoire utilisée et disponible, occupation de chaque point de montage, I/O disque par périphérique et octets réseau par interface, plus les métadonnées de l’hôte (OS, noyau, modèle de CPU, uptime). La liste complète est dans métriques collectées.
- Aucun fichier de configuration à écrire : le serveur apparaît dans le tableau de bord avec ses métriques environ 30 secondes après l’installation. Des options comme
--name,--policyet--grouppermettent à Ansible ou Terraform d’enrôler un parc avec la bonne politique d’escalade dès le premier lancement. - Détection hors ligne qui alerte l’astreinte : quand un serveur cesse de remonter des données plus longtemps que son seuil hors ligne (90 secondes par défaut, 60 secondes minimum), une panne est ouverte et la politique d’escalade associée à ce serveur alerte ses canaux : e-mail, SMS, appels téléphoniques, Slack, Teams, PagerDuty, OpsGenie, webhooks ou un planning d’astreinte. Les notifications de rétablissement partent vers les mêmes canaux.
- Plannings d’astreinte et politiques d’escalade : inclus dès l’offre Essentials, partagés entre le monitoring des serveurs et les moniteurs de disponibilité. Voir astreinte.
- Moniteurs de disponibilité : vérifications HTTP, de port, ping et de mot-clé contre vos services depuis l’extérieur de votre réseau, le même travail que
check_httpetcheck_tcpde Nagios pointés sur vos endpoints publics. - Pages de statut : une page de statut avec domaine personnalisé sur Essentials, trois pages publiques ou privées sur Pro, avec abonnés par e-mail (et abonnés SMS à partir de Pro). Voir pages de statut.
- Des métriques qui résistent aux coupures réseau : l’agent met en file sur disque les données non envoyées et réessaie, pour qu’une courte panne d’ingestion ou un redémarrage ne laisse pas de trous dans vos graphiques.
Pourquoi choisir Hyperping plutôt que Nagios ?
Rien à héberger, à patcher ni à sauvegarder
Nagios demande un serveur, un serveur web, un ensemble de plugins et quelqu’un pour les mettre à jour. Avec Hyperping, l’agent est la seule chose installée sur vos hôtes, et le monitoring est hébergé. Si votre machine Nagios tombe, vous perdez le monitoring et les alertes en même temps. Ce scénario de panne disparaît.
L’alerte et les rotations font partie du produit
Dans Nagios, une rotation signifie modifier des contacts et des timeperiods, puis recharger. Dans Hyperping, vous définissez une fois un planning et une politique d’escalade, et les serveurs, les moniteurs de disponibilité et les pages de statut passent tous par eux. Chaque étape de la politique a son propre délai et ses propres canaux : une alerte restée sans réponse passe à la personne suivante. Notre guide des politiques d’escalade et notre guide des rotations d’astreinte expliquent comment les concevoir.
Vos clients apprennent les incidents par vous
Nagios n’a pas de page de statut. Avec Hyperping, l’incident qui a alerté votre ingénieur peut être publié sur une page de statut à vos couleurs qui prévient les abonnés par e-mail, sans deuxième outil.
Si votre installation Nagios se résume désormais à « préviens-moi quand une machine meurt et réveille la bonne personne », et que la facture PagerDuty plus l’entretien de Nagios coûtent plus cher que ce que valent les vérifications, c’est le moment où il devient plus logique d’être alerté quand un serveur se tait, sans faire tourner de serveur de monitoring plutôt que de continuer à maintenir la stack vous-même.
Ce qu’en disent de vrais utilisateurs de Hyperping
« Nous avons rendu notre page de statut Hyperping publique et elle est devenue un élément essentiel de nos présentations commerciales. Nous sommes fiers de notre disponibilité et nous adorons pouvoir la partager aussi facilement avec nos prospects et nos clients. »
Combien coûte Hyperping ?
- Free : 1 agent de monitoring serveur, 20 moniteurs avec vérifications toutes les 5 minutes, 1 page de statut basique
- Essentials : 24 €/mois en facturation annuelle (29 € en mensuel) pour 5 agents serveur, 50 moniteurs, 3 vérifications navigateur, 1 page de statut avec domaine personnalisé, astreinte et politiques d’escalade, alertes par appel téléphonique, 3 sièges
- Pro : 74 €/mois en facturation annuelle (89 € en mensuel) pour 20 agents serveur, 250 moniteurs, 3 pages de statut publiques ou privées, abonnés SMS, SSO SAML pour le compte, 10 sièges
- Business : 249 €/mois en facturation annuelle (299 € en mensuel) pour 100 agents serveur, 1 000 moniteurs, 10 pages de statut, marque blanche, journaux d’audit, 20 sièges
Les alertes serveur sont incluses dans toutes les offres payantes, avec un essai gratuit de 14 jours. L’historique des métriques dépend de l’offre : 7 jours à la minute et 6 mois à l’heure sur Essentials, jusqu’à 30 jours à la minute et 13 mois à l’heure sur Business.
Les limites de Hyperping
Pas encore d’alertes sur des seuils de métriques. Hyperping vous alerte quand un serveur cesse de remonter des données. Il n’alerte pas aujourd’hui quand le CPU dépasse 90 % ou qu’un disque atteint 85 % : vous le voyez dans le tableau de bord, mais cela n’ouvre pas d’incident. Si les avertissements check_disk de Nagios sont au cœur de votre façon de travailler, gardez-les pour l’instant ou choisissez Checkmk ou Zabbix.
Pas de plugins ni de vérifications personnalisées sur l’hôte. Impossible de brancher Hyperping sur un plugin Nagios, une vérification de contrôleur RAID ou un script maison. L’agent collecte un ensemble fixe de métriques système.
Métriques qu’il n’ingère pas aujourd’hui : CPU et mémoire par processus, utilisation du swap, erreurs de paquets et nombre d’opérations disque.
Pas de SNMP, pas d’équipements réseau, pas d’édition auto-hébergée. Switchs, routeurs, imprimantes et onduleurs sont hors périmètre, et il est impossible de faire tourner Hyperping dans un réseau isolé (air-gapped). LibreNMS, PRTG ou Zabbix conviennent mieux dans ce cas.
Hyperping est-il fait pour vous ?
Choisissez Hyperping si votre parc est composé de serveurs Linux, macOS ou Windows plutôt que d’équipements réseau, si plus personne ne veut s’occuper de la machine Nagios, et si vous payez aujourd’hui un outil d’alerte et une page de statut séparés. Les équipes très investies dans les plugins ou dont le parc repose massivement sur SNMP devraient d’abord regarder Icinga, Checkmk ou LibreNMS.
Icinga : idéal comme remplaçant open source direct
Pour qui est conçu Icinga
Les équipes qui ont des années de configuration Nagios et de plugins maison, et qui veulent un moteur moderne sans réécrire leurs vérifications. Icinga est né en 2009 comme fork de Nagios, et Icinga 2 a été reconstruit avec son propre langage de configuration tout en restant compatible avec l’API des plugins Nagios.
Fonctionnalités notables
- Exécute les plugins Nagios tels quels : vos scripts
check_*et les Monitoring Plugins continuent de fonctionner. - Un DSL de configuration plus propre : les règles Apply affectent des services aux hôtes selon leurs attributs, si bien qu’une seule règle remplace des centaines de définitions de services.
- Icinga Director : une interface web de configuration, avec import depuis des CMDB et des API cloud.
- API REST et clustering natif : monitoring distribué sur plusieurs zones et satellites, sans module supplémentaire.
- Icinga for Windows : un framework basé sur PowerShell pour surveiller les hôtes Windows.
- Icinga Notifications : un composant plus récent, avec des plannings construits à partir de rotations et des escalades déclenchées selon l’ancienneté ou la gravité de l’incident. À sa version 0.2.0 (novembre 2025), il était encore étiqueté bêta.
Combien coûte Icinga ?
L’édition open source est gratuite, sans limite d’hôtes ni de services. Abonnements payants, d’après la page d’abonnements d’Icinga :
- Module subscription : 2 000 $/an (2 000 € en Europe) pour les modules entreprise
- Repository subscription : 5 000 $/an pour les paquets RHEL, SLES et Amazon Linux
- Support subscription : à partir de 15 000 $/an, modules et accès aux dépôts compris
Points d’attention
Icinga supprime le pire de la configuration Nagios, mais vous hébergez, faites évoluer et mettez à jour tout vous-même : le cœur, la base de données, la stack web et Director. Les plannings de notification ne sont arrivés que récemment, en bêta, si bien que la plupart des équipes Icinga envoient encore leurs alertes vers un outil d’astreinte séparé. Il n’y a pas de page de statut publique.
À qui s’adresse Icinga
Choisissez Icinga si vos vérifications sont votre principal capital et que vous voulez toutes les garder tout en gagnant un meilleur moteur, une API et une meilleure interface. C’est le plus petit pas pour sortir de Nagios.
Checkmk : idéal pour la compatibilité Nagios avec découverte automatique
Pour qui est conçu Checkmk
Les équipes ops qui aiment le modèle de vérification de Nagios mais sont lasses d’écrire de la configuration. Checkmk est issu de l’écosystème Nagios, et son édition gratuite utilise depuis longtemps le cœur de Nagios comme moteur. Ses agents découvrent automatiquement les services de chaque hôte.
Fonctionnalités notables
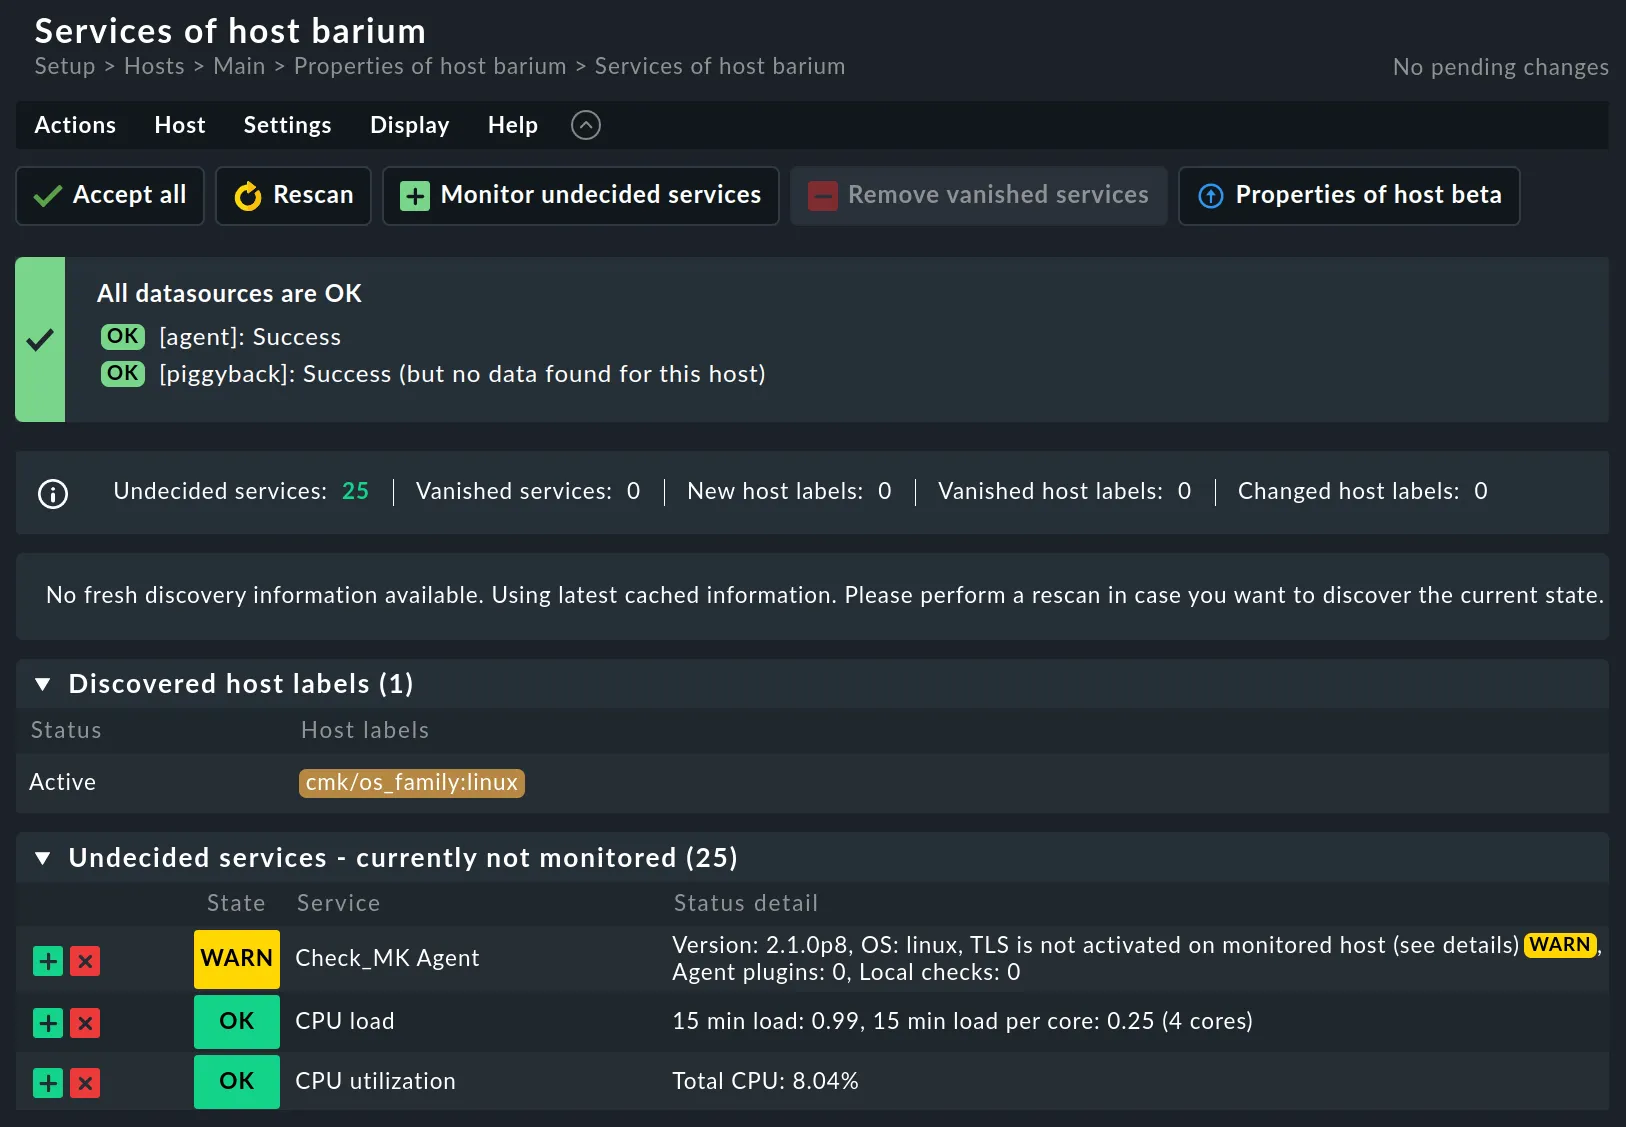
- Découverte automatique des services : installez l’agent, lancez la découverte, et les systèmes de fichiers, interfaces, services et processus apparaissent sous forme de vérifications.
- Configuration web à base de règles : seuils et règles de notification se définissent dans l’interface et s’appliquent à des dossiers ou à des tags d’hôtes plutôt qu’à des objets individuels.
- Prise en charge des plugins Nagios : les plugins existants tournent comme vérifications « classiques » à côté de celles de Checkmk.
- Agents natifs pour Linux et Windows, plus le SNMP pour les équipements réseau.
- Checkmk Cloud : une édition SaaS managée si vous ne voulez pas faire tourner le serveur.
Depuis la version 2.5, les éditions ont été renommées : Raw devient Community, Enterprise devient Pro et Cloud devient Ultimate, avec en plus une offre hébergée distincte, Checkmk Cloud.
Combien coûte Checkmk ?
D’après la page de tarifs de Checkmk, avec une tarification au service (environ 30 services par hôte) :
- Community : gratuit et open source, positionné jusqu’à environ 100 hôtes
- Pro (auto-hébergé) : à partir de 190 €/mois en facturation annuelle
- Ultimate (auto-hébergé) : à partir de 275 €/mois en facturation annuelle
- Checkmk Cloud (SaaS) : 240 €/mois en facturation mensuelle pour 1 000 services, ou 2 400 €/an (environ 200 €/mois) en facturation annuelle
Points d’attention
Avec une tarification au service, la facture grimpe avec le nombre d’éléments découverts sur chaque hôte, pas seulement avec le nombre d’hôtes. Le serveur Checkmk ne tourne que sous Linux. Les notifications sont puissantes mais pilotées par des règles, et les rotations d’astreinte passent toujours par une intégration comme PagerDuty ou ilert plutôt que par Checkmk lui-même.
À qui s’adresse Checkmk
Choisissez Checkmk si vous voulez garder la logique de Nagios (états, vérifications, seuils, plugins) avec beaucoup moins de configuration écrite à la main. Pour des parcs mixtes Linux, Windows et réseau de 50 à plusieurs milliers d’hôtes, c’est la voie de sortie de Nagios la plus complète.
Zabbix : idéal comme plateforme tout-en-un gratuite
Pour qui est conçu Zabbix
Les équipes infrastructure qui veulent un seul système open source pour les serveurs, les équipements réseau, les VM et les applications, et qui sont prêtes à reconstruire leur monitoring autour de templates plutôt que de porter les plugins Nagios un par un.
Fonctionnalités notables
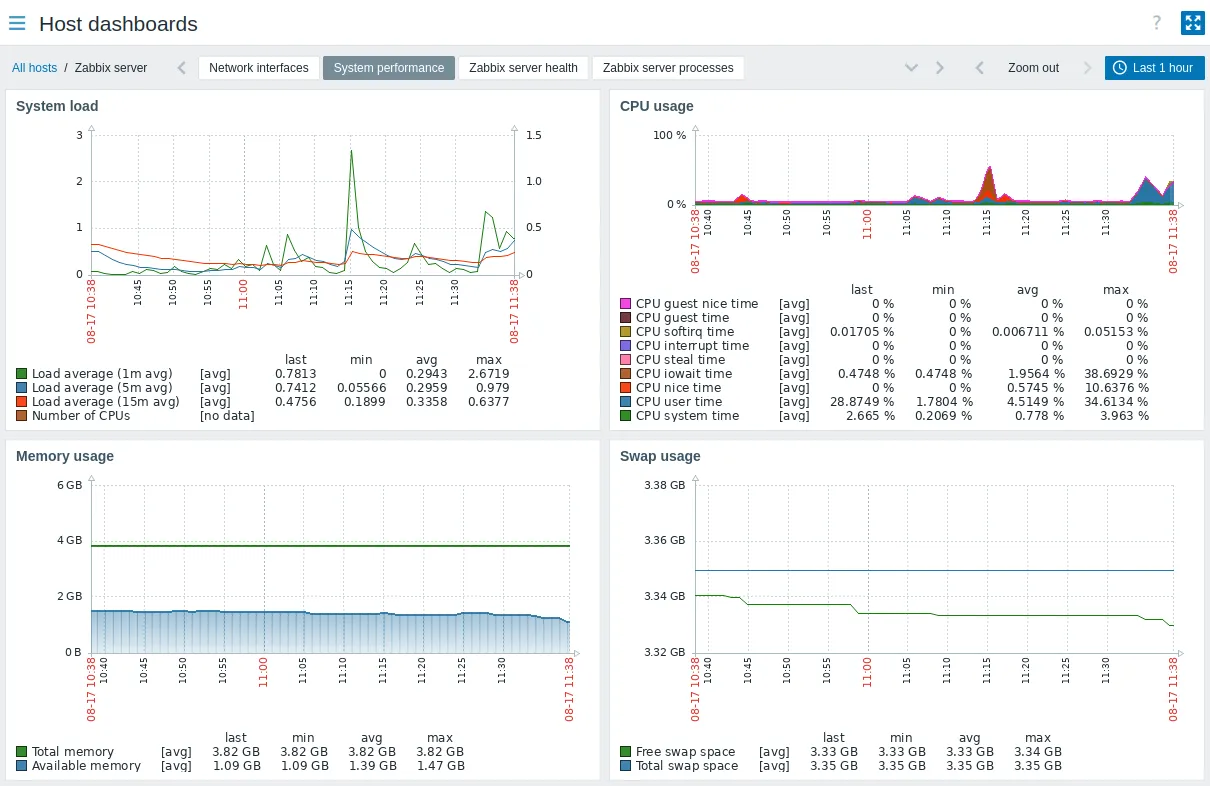
- Des templates pour des centaines d’équipements et d’applications : Linux, Windows, MySQL, VMware, Cisco et d’autres, avec items, triggers et graphiques prédéfinis.
- Low-level discovery : les systèmes de fichiers, interfaces et services de chaque hôte sont découverts et surveillés automatiquement.
- Triggers à base d’expressions : conditions de seuil, de tendance et d’anomalie évaluées sur le serveur.
- Actions avec étapes d’escalade : envoyer un message, attendre, puis prévenir un autre groupe ou exécuter une commande à distance.
- Agents natifs pour Linux et Windows, plus des vérifications SNMP, IPMI et sans agent.
Combien coûte Zabbix ?
Zabbix est gratuit et open source : GPLv2 jusqu’à la 6.4, puis AGPLv3 à partir de la version 7.0. Zabbix Cloud démarre à 50 $/mois (palier Nano, 50 nouvelles valeurs par seconde) et monte jusqu’à 5 000 $/mois, avec un essai de 5 jours. Les abonnements de support commercial se font sur devis.
Points d’attention
Zabbix repose lourdement sur sa base de données : à grande échelle, vous devrez optimiser MySQL ou PostgreSQL (souvent avec TimescaleDB) et le housekeeping. Le modèle templates et triggers demande son propre apprentissage, et les plugins Nagios ne se transposent pas directement. Les escalades existent dans les actions, mais il n’y a ni calendrier d’astreinte ni page de statut publique.
À qui s’adresse Zabbix
Choisissez Zabbix si vous voulez un seul outil gratuit et auto-hébergé qui couvre serveurs et équipements réseau avec seuils et tendances, et que quelqu’un peut prendre en charge la base de données et les templates.
Prometheus + Grafana : idéal pour les stacks cloud native et conteneurisées
Pour qui est conçu Prometheus
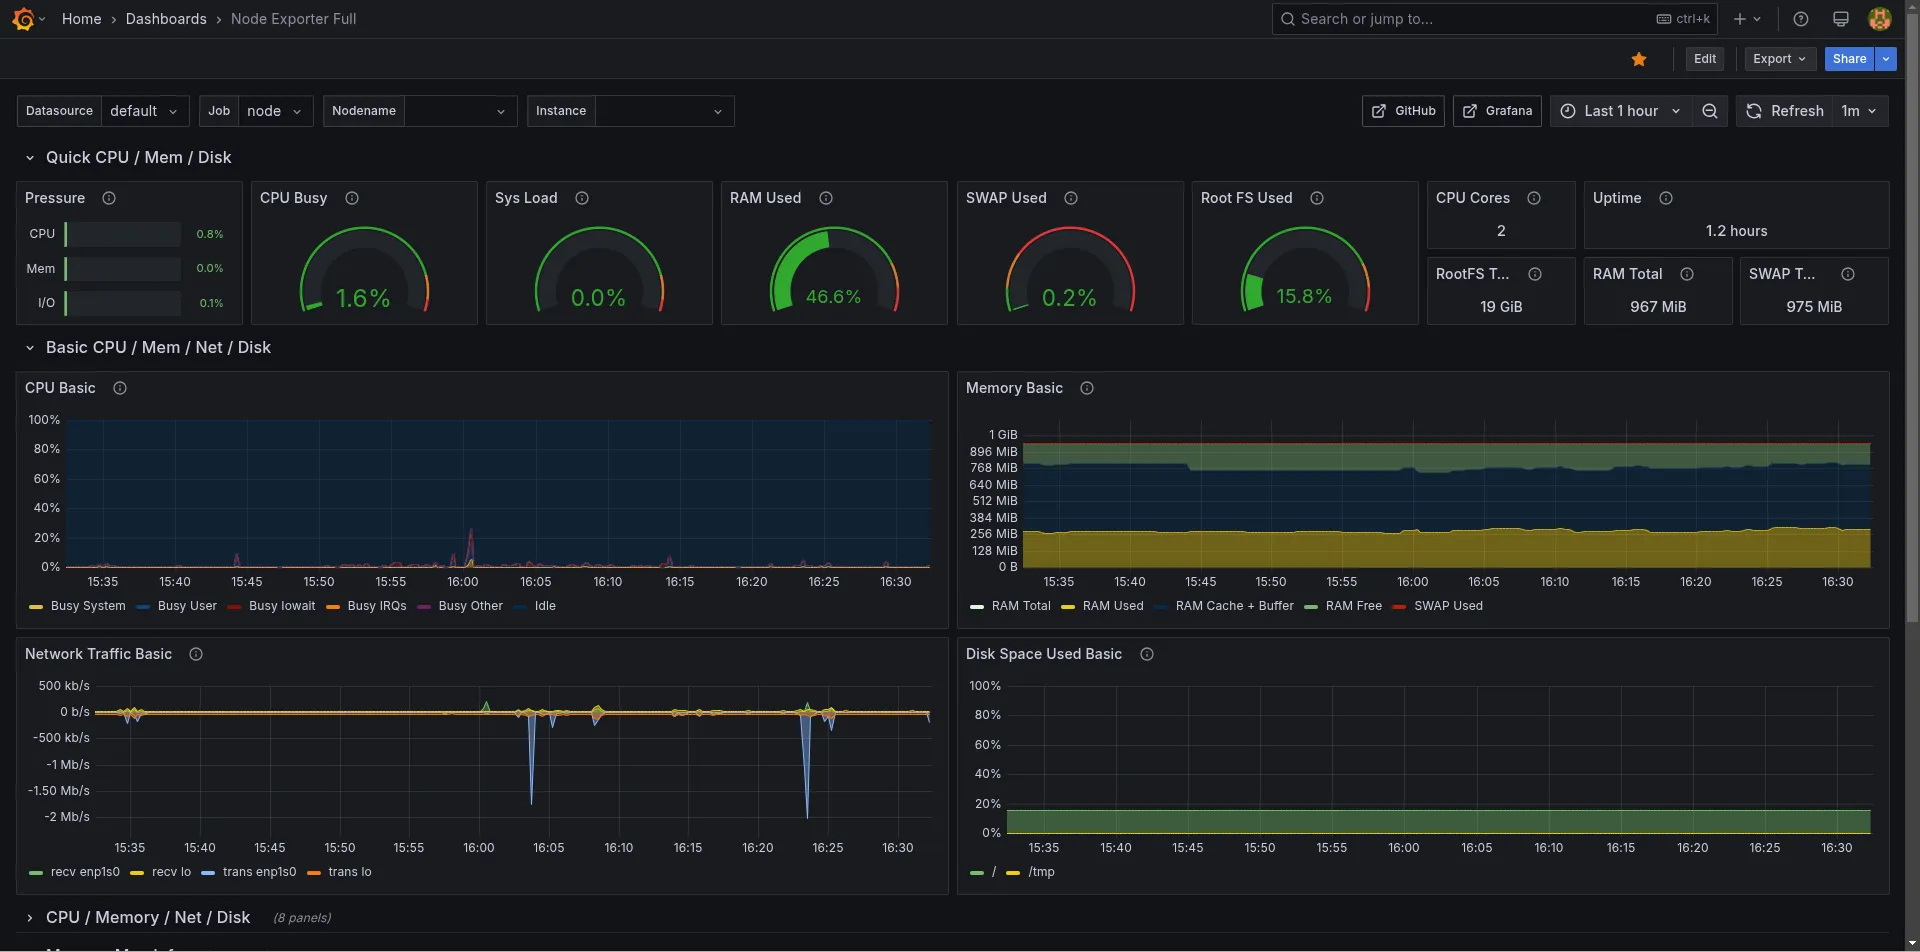
Les équipes qui font tourner Kubernetes, des conteneurs ou des microservices, où les hôtes vont et viennent et où une liste figée de définitions d’hôtes Nagios ne peut pas suivre. Prometheus collecte les métriques des exporters et des services, Grafana les visualise et Alertmanager route les alertes.
Fonctionnalités notables
- Métriques en mode pull avec découverte de services : les cibles sont découvertes depuis Kubernetes, Consul, EC2 et d’autres sources au lieu d’être listées à la main.
- PromQL : un langage de requête qui transforme les métriques brutes en taux, percentiles et conditions d’alerte.
- Des exporters pour tout :
node_exporterpour les hôtes Linux,windows_exporterpour Windows, et des exporters pour les bases de données, les files de messages et le matériel. - Alertmanager : regroupement, inhibition, silences et routage vers des destinataires.
- Tableaux de bord Grafana : le standard de fait pour la visualisation de métriques.
Combien ça coûte ?
Prometheus (Apache 2.0) et Grafana (AGPLv3) sont gratuits en auto-hébergé. Grafana Cloud propose une offre gratuite avec 10 000 séries de métriques actives, 50 Go de logs, 3 utilisateurs actifs et 14 jours de rétention. L’offre Pro coûte 19 $/mois de frais de plateforme, plus l’usage. L’astreinte passe par Grafana IRM : gratuit pour 3 utilisateurs IRM actifs, puis 20 $ par utilisateur IRM actif et par mois.
Points d’attention
C’est une stack, pas un produit. Vous devrez faire tourner et faire évoluer Prometheus (plus Thanos, Mimir ou VictoriaMetrics pour le stockage long terme), maintenir les exporters et écrire du PromQL pour chaque alerte. Prometheus est conçu pour les métriques, donc les vérifications du type « ce service répond-il » demandent le blackbox exporter. Alertmanager route les alertes mais n’a ni plannings ni escalade vers une deuxième personne, et c’est pour cela que Grafana vend IRM séparément.
À qui s’adresse Prometheus + Grafana
Choisissez cette stack si vos workloads sont conteneurisés, que vos ingénieurs lisent déjà le PromQL et que vous voulez un monitoring centré sur les métriques qui suit une infrastructure dynamique. Pour un parc figé de VM, c’est généralement plus de machinerie que le problème n’en demande. Pour une comparaison directe, voir Datadog vs Grafana Cloud.
Netdata : idéal pour des métriques à la seconde presque sans configuration
Pour qui est conçu Netdata
Les ingénieurs qui veulent installer quelque chose et voir aussitôt des métriques détaillées sur un hôte, sans écrire la moindre configuration. L’agent Netdata détecte automatiquement les services et collecte les métriques chaque seconde.
Fonctionnalités notables
- Collecte à la seconde, avec des milliers de métriques détectées automatiquement sur chaque hôte.
- Tableaux de bord sans configuration pour l’hôte et les applications qu’il trouve.
- Détection d’anomalies par ML intégrée sur chaque métrique.
- Agent Windows natif, en plus de Linux, macOS et des conteneurs.
- Des centaines d’alertes préconfigurées fournies avec l’agent.
Combien coûte Netdata ?
D’après la page de tarifs de Netdata :
- Community : gratuit, limité à 5 nœuds connectés actifs et 1 tableau de bord personnalisé par room
- Homelab : 90 $/an, nœuds illimités dans le cadre d’une politique d’usage raisonnable
- Business : 7 $/nœud/mois en facturation annuelle (8,75 $ en mensuel), avec RBAC, SSO, tableaux de bord illimités et Netdata AI
- Enterprise : sur devis au-delà de 500 nœuds, avec une option sur site
Points d’attention
L’agent lui-même est sous GPLv3, mais l’expérience complète passe par Netdata Cloud, et la limite de 5 nœuds de l’offre gratuite est serrée pour remplacer Nagios. Sous Windows, la documentation de Netdata précise que le tableau de bord local est verrouillé sur l’offre gratuite Community : vous consultez donc les données dans Netdata Cloud. Les alertes notifient des canaux, mais il n’y a ni plannings d’astreinte ni page de statut.
À qui s’adresse Netdata
Choisissez Netdata si vous voulez une visibilité fine et en temps réel sur chaque hôte pour le dépannage, et qu’un abonnement par nœud au-delà de 5 nœuds ne vous gêne pas.
Datadog : idéal pour une observabilité complète

Pour qui est conçu Datadog
Les organisations d’ingénierie qui ont besoin de corréler au même endroit métriques d’infrastructure, APM, tracing distribué, logs et tests synthétiques, et qui ont le budget pour une tarification par hôte, par Go et par siège.
Fonctionnalités notables
- Monitoring d’infrastructure avec plus de 1 000 intégrations et 15 mois de rétention des métriques sur Pro.
- APM, logs, RUM et synthétique sur la même plateforme.
- Datadog On-Call pour les plannings et les escalades, vendu au siège.
- Status Pages, intégré à la suite Incident Response de Datadog.
- Agents natifs pour Linux, Windows, macOS et les conteneurs.
Combien coûte Datadog ?
D’après la page de tarifs de Datadog :
- Free : jusqu’à 5 hôtes avec 1 jour de rétention des métriques
- Infrastructure Pro : 15 $/hôte/mois en facturation annuelle, 18 $ à la demande
- Infrastructure Enterprise : 23 $/hôte/mois en facturation annuelle, 27 $ à la demande
- On-Call : 20 $/siège/mois en engagement annuel, en plus de l’infrastructure
Points d’attention
Datadog remplace Nagios et plusieurs autres outils d’un coup, mais la facture additionne hôtes, métriques personnalisées, ingestion et indexation des logs, exécutions synthétiques et sièges. Les équipes qui viennent de Nagios Core, gratuit, ont souvent du mal à justifier ce saut pour savoir simplement si l’hôte est en bonne santé. Notre comparatif Hyperping vs Datadog et notre guide des alternatives à Datadog entrent dans les chiffres.
À qui s’adresse Datadog
Choisissez Datadog si vous avez besoin de l’APM et des logs à côté des métriques d’hôtes et que votre équipe s’en servira vraiment. Si vous n’avez besoin que de la santé des hôtes et des alertes, vous paierez pour une grande partie de plateforme que vous n’utiliserez pas.
PRTG : idéal pour un serveur de monitoring sous Windows
Pour qui est conçu PRTG
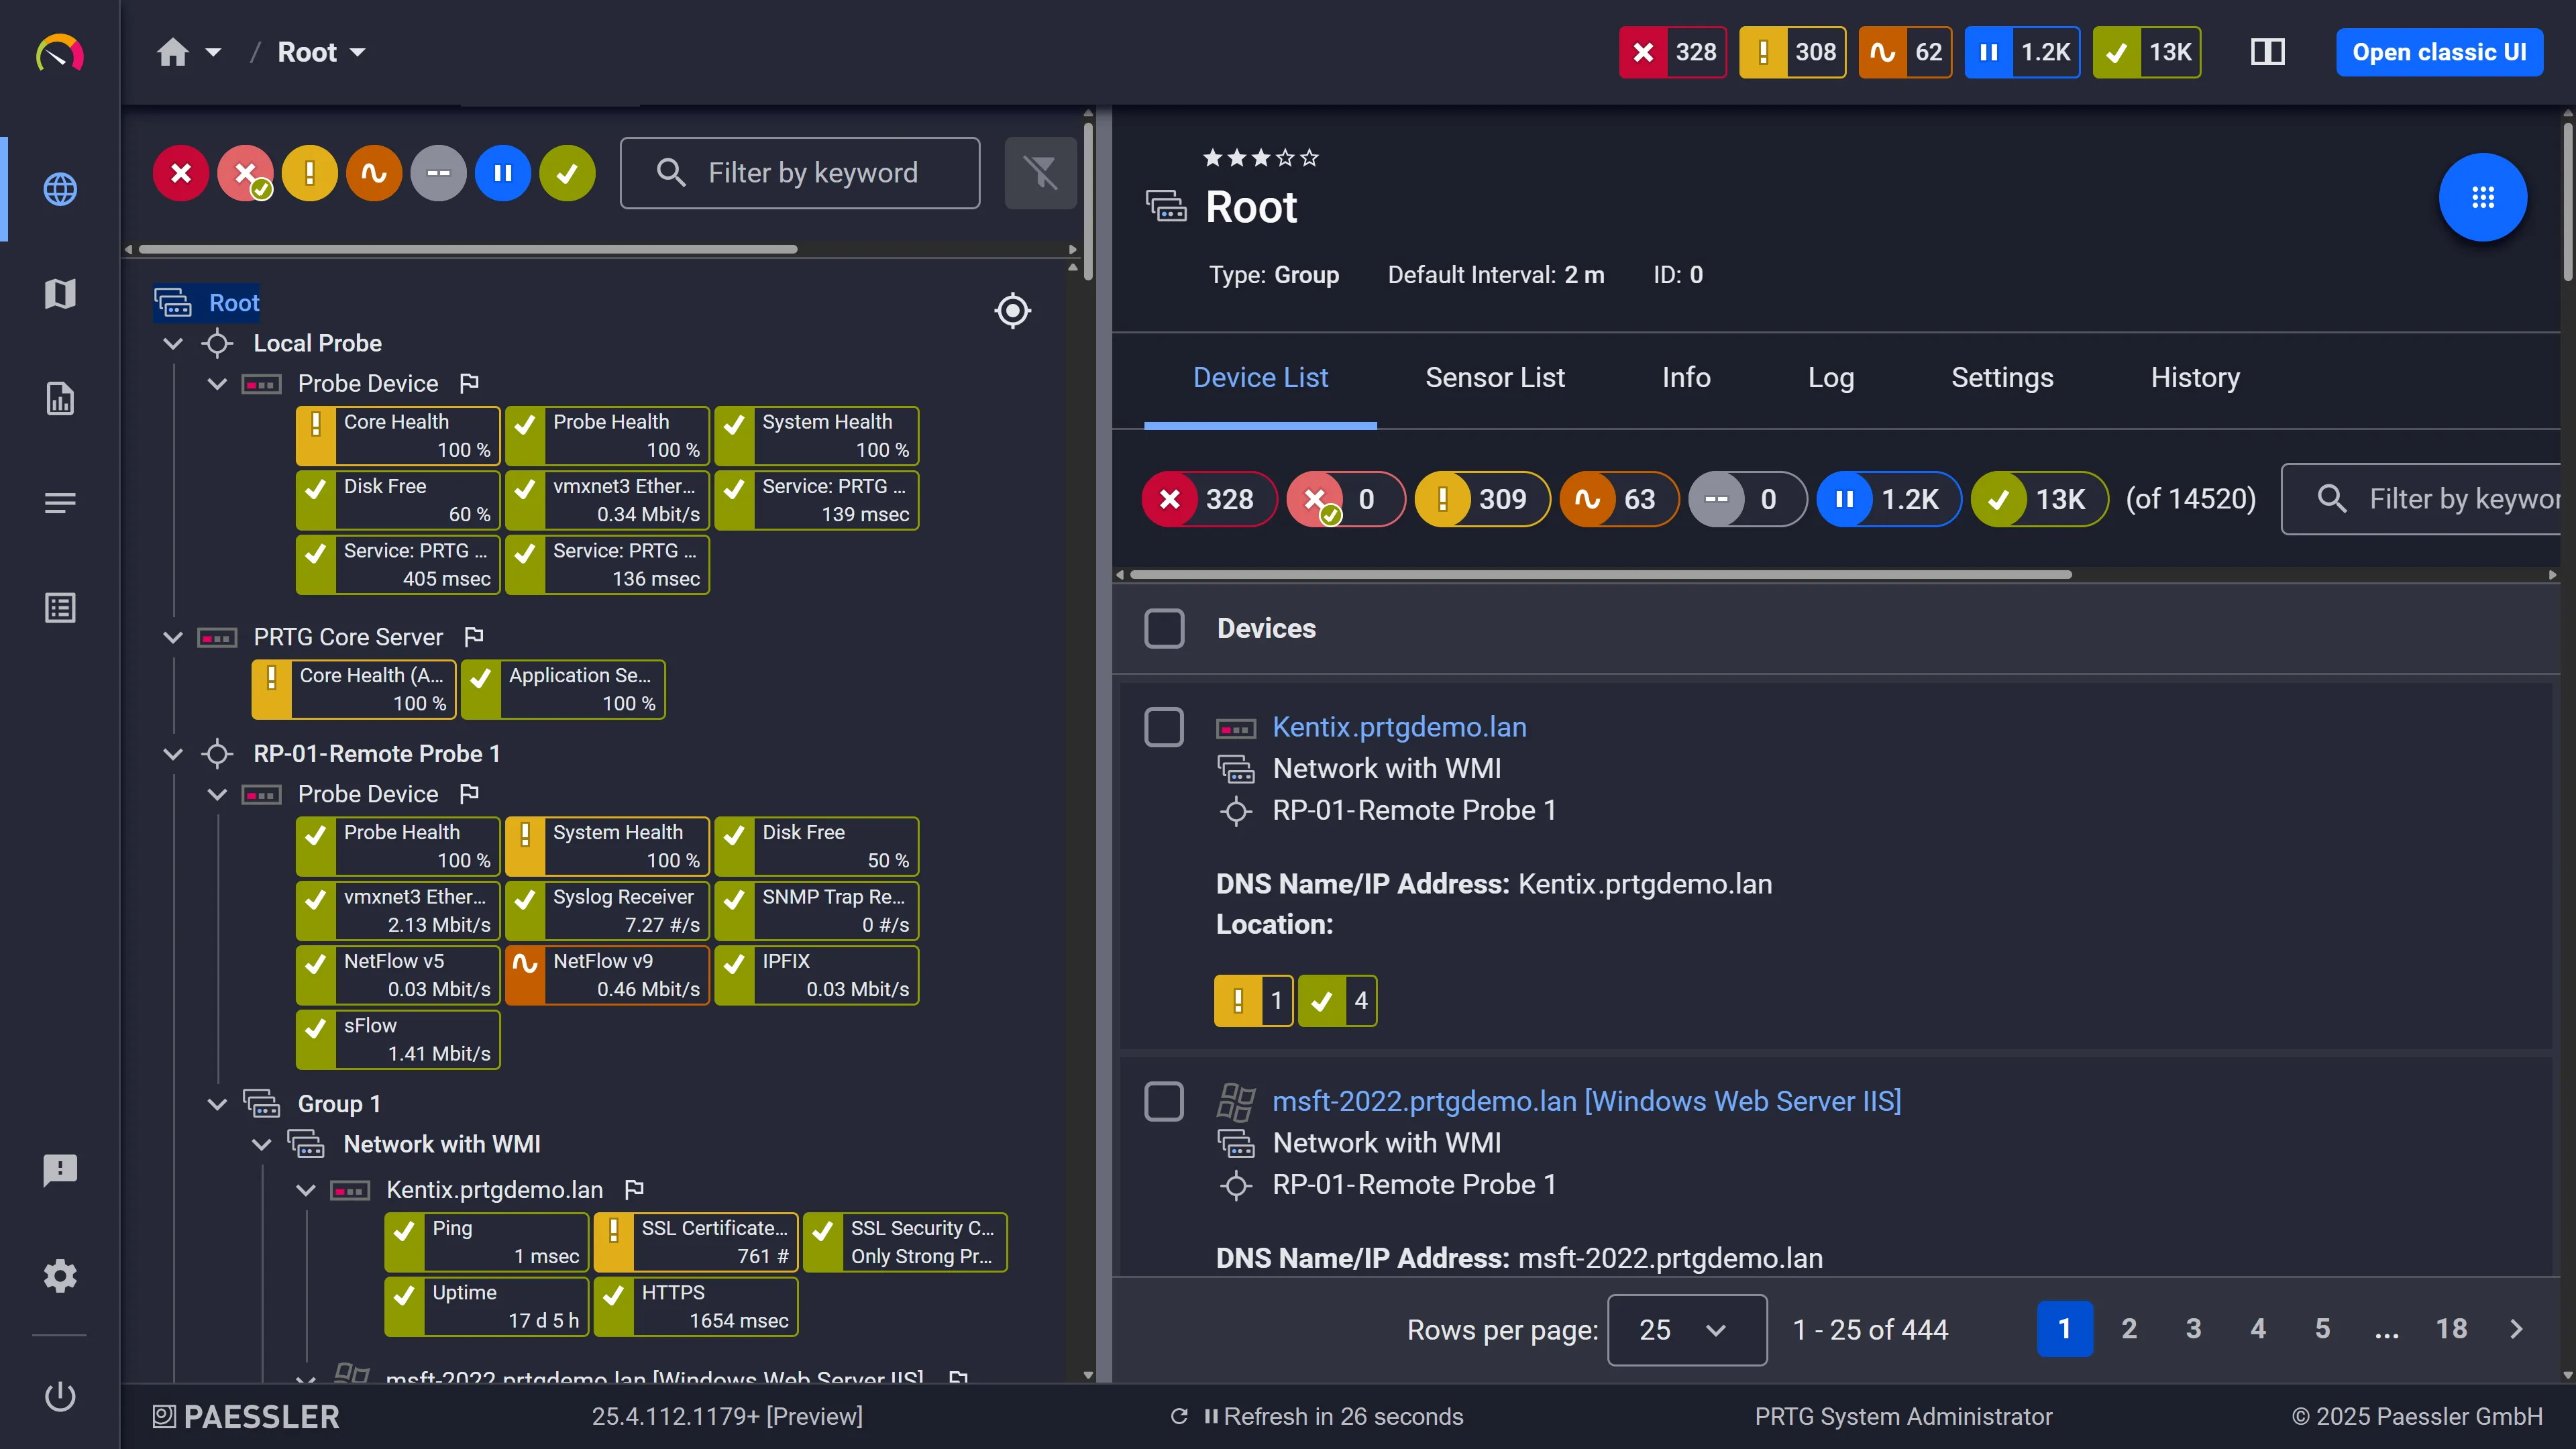
Les DSI centrées sur Windows qui veulent un serveur de monitoring installable sur Windows Server, avec une interface graphique pour tout et une bonne couverture réseau (SNMP, NetFlow, WMI).
Fonctionnalités notables
- Modèle à base de capteurs : chaque métrique d’un équipement (CPU, un port, un service) est un capteur, avec des types de capteurs prédéfinis.
- Découverte automatique des équipements sur une plage réseau.
- Monitoring Windows sans agent via WMI et les compteurs de performance.
- Cartes et tableaux de bord construits dans l’interface web.
- Sondes distantes, dont une sonde multiplateforme pour Linux, pour surveiller des sites distants.
Combien coûte PRTG ?
D’après la page de tarifs de Paessler, tous les abonnements en facturation annuelle :
- Freeware : jusqu’à 100 capteurs (environ 10 équipements)
- PRTG 500 : 200 $/mois (500 capteurs, environ 50 équipements)
- PRTG 1000 : 358 $/mois
- PRTG 2500 : 742 $/mois
- PRTG 10000 : 1 642 $/mois
Au-delà de 1 000 équipements, Paessler vous oriente vers PRTG Enterprise Monitor. Une version hébergée, PRTG Hosted Monitor, est aussi disponible.
Points d’attention
Le serveur central de PRTG ne tourne que sous Windows (Windows Server 2016 à 2025, Windows 10 et 11). Le décompte des capteurs grimpe vite : un serveur avec CPU, mémoire, disque, réseau et quelques services peut consommer 10 capteurs. Les déclencheurs de notification peuvent escalader en répétant l’envoi ou en ciblant d’autres contacts, mais il n’y a ni plannings d’astreinte ni page de statut publique.
À qui s’adresse PRTG
Choisissez PRTG si votre équipe gère une infrastructure Windows, veut tout configurer via une interface graphique et surveille beaucoup d’équipements réseau en plus des serveurs.
LibreNMS : idéal pour le monitoring réseau SNMP
Pour qui est conçu LibreNMS
Les équipes réseau qui utilisaient surtout Nagios pour surveiller switchs, routeurs, pare-feu et points d’accès, et qui veulent la découverte automatique et des graphiques par port sans écrire de définitions de services.
Fonctionnalités notables
- Découverte automatique du réseau via CDP, FDP, LLDP, OSPF, BGP, SNMP et ARP.
- Large prise en charge des constructeurs pour les OS réseau, avec graphiques de trafic et d’erreurs par port et de santé des équipements.
- Règles d’alerte avec transports vers e-mail, Slack, IRC et beaucoup d’autres canaux.
- Polling distribué pour les grands réseaux.
- Images Docker pour une installation plus rapide.
Combien coûte LibreNMS ?
LibreNMS est gratuit et open source sous GPLv3. Il n’existe pas d’édition payante. Le support est assuré par la communauté.
Points d’attention
LibreNMS se concentre sur les équipements réseau. Il peut surveiller des serveurs en SNMP et exécute des plugins Nagios via une intégration de services, mais ce n’est pas l’outil naturel pour les alertes applicatives ou au niveau de l’hôte. Vous l’hébergez vous-même sous Linux, et il n’y a ni plannings d’astreinte ni page de statut.
À qui s’adresse LibreNMS
Choisissez LibreNMS si l’essentiel de votre configuration Nagios portait sur des switchs et des routeurs. Associez-le à un outil orienté serveurs pour vos hôtes.
Alternatives open source à Nagios
Si rester en open source est une exigence, les options se distinguent surtout par leur licence et par la part de votre travail Nagios qui se transpose :
| Outil | Licence | Réutilise les plugins Nagios ? | Point fort |
|---|---|---|---|
| Icinga 2 | GPLv2 | Oui, tels quels | Remplaçant direct avec API et clustering |
| Checkmk Community | GPLv2 | Oui, comme vérifications classiques | Découverte automatique et configuration par règles |
| Zabbix | AGPLv3 (7.0+) | Pas directement (via des scripts externes) | Tout-en-un avec templates et triggers |
| Prometheus + Grafana | Apache 2.0 / AGPLv3 | Non (exporters à la place) | Métriques pour stacks dynamiques et conteneurisées |
| LibreNMS | GPLv3 | En partie, via les services | Découverte et graphiques réseau SNMP |
| Agent Netdata | GPLv3 | Non | Métriques d’hôte à la seconde sans configuration |
Deux points à prévoir, quel que soit l’outil. D’abord, la disponibilité de votre monitoring devient votre affaire : si le serveur de monitoring, sa base de données ou son chemin réseau tombe, personne n’est alerté. Ensuite, aucun de ces projets n’inclut de page de statut publique, et seuls Icinga (en bêta) et Grafana (en option cloud payante) proposent des plannings d’astreinte. Prévoyez le budget d’un outil d’alerte d’astreinte, même quand le monitoring est gratuit.
Alternatives gratuites à Nagios
« Gratuit » recouvre ici deux choses : un logiciel libre que vous hébergez, ou une offre gratuite hébergée avec des limites.
Gratuits en auto-hébergé, sans limite d’hôtes : Icinga 2, Zabbix, Prometheus + Grafana et LibreNMS. Checkmk Community est gratuit lui aussi, positionné jusqu’à environ 100 hôtes. Le coût, ce sont le serveur, le stockage et les heures passées.
Offres gratuites hébergées :
- Hyperping Free : 1 agent serveur, 20 moniteurs avec vérifications toutes les 5 minutes, 1 page de statut basique
- Netdata Community : 5 nœuds actifs
- Datadog : 5 hôtes avec 1 jour de rétention des métriques
- Grafana Cloud Free : 10 000 séries actives, 3 utilisateurs, 14 jours de rétention, 3 utilisateurs IRM
- PRTG Freeware : 100 capteurs (auto-hébergé sous Windows)
- Nagios XI Free : 7 nœuds ou 100 services
Pour une poignée de serveurs, une offre gratuite hébergée vous donne un monitoring en quelques minutes. Au-delà, les outils open source ne sont gratuits que par leur licence.
Alternatives à Nagios pour Windows
Windows revient de deux façons dans les recherches : faire tourner le serveur de monitoring sous Windows, ou surveiller des hôtes Windows.
Faire tourner le serveur de monitoring sous Windows. Nagios Core ne tourne pas sous Windows, pas plus que le cœur d’Icinga, le serveur Checkmk, le serveur Zabbix ou LibreNMS (tous sous Linux). PRTG est la principale option dont le serveur est conçu pour Windows, et il ne tourne que là. Les outils hébergés (Hyperping, Datadog, Netdata Cloud, Grafana Cloud) contournent la question puisqu’il n’y a pas de serveur à installer.
Surveiller des hôtes Windows. Avec Nagios, cela veut dire NSClient++ ou NCPA sur chaque machine, plus des plugins côté Nagios. Les alternatives sont plus simples :
- Hyperping : l’agent s’installe comme service Windows depuis une fenêtre PowerShell Administrateur, sur Windows 10 ou Windows Server 2016 et versions ultérieures. Il remonte le CPU, la mémoire, chaque lettre de lecteur, les I/O disque et le réseau, et calcule un load average à partir de la longueur de la file d’attente du processeur, puisque Windows n’en a pas. Voir les notes d’installation Windows et l’annonce du monitoring des serveurs Windows.
- Checkmk et Zabbix : agents Windows natifs avec découverte des services et templates Windows.
- Datadog et Netdata : agents Windows natifs (le tableau de bord local de Netdata est verrouillé sur son offre gratuite).
- Prometheus :
windows_exporterexpose les métriques WMI et des compteurs de performance. - PRTG : monitoring sans agent via WMI et les compteurs de performance.
Quelle alternative à Nagios choisir ?
- Vous avez des centaines de plugins Nagios maison et voulez les garder : Icinga.
- Vous voulez des vérifications à la Nagios sans écrire de configuration : Checkmk.
- Vous voulez un seul outil gratuit pour les serveurs et les équipements réseau, avec des seuils : Zabbix.
- Votre infrastructure, c’est Kubernetes et des conteneurs : Prometheus + Grafana.
- Vous surveillez surtout des switchs et des routeurs : LibreNMS, ou PRTG si vous êtes une équipe Windows.
- Vous avez aussi besoin d’APM, de logs et de traces : Datadog.
- Vous voulez la santé des hôtes, des vérifications de disponibilité, l’astreinte et une page de statut sans faire tourner de serveur de monitoring : Hyperping.
Beaucoup d’équipes finissent avec deux outils : un outil open source pour les vérifications poussées et les équipements réseau, et un outil hébergé pour l’alerte d’astreinte et la communication client, afin qu’une panne du serveur de monitoring ne coupe pas aussi les alertes.
Comment remplacer les alertes de Nagios par Hyperping
Inutile de tout migrer d’un coup. La méthode qui marche le mieux consiste à déplacer d’abord la détection des hôtes hors ligne, les vérifications de services, l’alerte d’astreinte et la communication sur le statut, et à garder Nagios pour les vérifications que Hyperping ne couvre pas, le temps de décider quoi en faire.
1. Installer l’agent sur vos serveurs
Dans la vue Servers, cliquez sur New server et copiez la commande d’installation. Lancez-la avec sudo sur chaque hôte Linux ou macOS, ou dans une fenêtre PowerShell Administrateur sous Windows. Pour un parc entier, passez --name, --policy et --group (ou les variables d’environnement correspondantes) depuis Ansible ou Terraform. Chaque hôte apparaît en ligne avec CPU, mémoire, disque, réseau et informations système en 30 secondes environ.
2. Associer une politique d’escalade et régler le seuil hors ligne
Ouvrez le panneau Alerting du serveur, associez une politique d’escalade et définissez le seuil hors ligne : assez long pour encaisser une coupure réseau, assez court pour que vous vouliez être alerté. La valeur par défaut est de 90 secondes. Testez-le en arrêtant l’agent sur un hôte non critique et en vérifiant que l’alerte arrive. La documentation des alertes serveur donne les détails.
3. Recréer vos vérifications Nagios externes sous forme de moniteurs
Listez les services check_http, check_tcp et check_ping que Nagios exécute contre vos endpoints publics et recréez-les sous forme de moniteurs HTTP, de port, ping ou de mot-clé. Faites-les passer par les mêmes politiques d’escalade, pour qu’un hôte mort et un endpoint en échec alertent la même personne.
4. Mettre en place les plannings d’astreinte
Remplacez les contacts et timeperiods de Nagios par un planning d’astreinte, puis faites pointer les étapes de votre politique d’escalade vers lui. Les étapes suivantes, après le délai que vous fixez, peuvent alerter un second niveau ou le responsable d’équipe.
5. Publier une page de statut
Ajoutez à une page de statut sur votre propre domaine les services qui comptent pour vos clients. Quand un incident est ouvert, publiez une mise à jour : les abonnés la reçoivent par e-mail.
6. Faire tourner les deux en parallèle, puis retirer Nagios
Laissez Nagios tourner une à deux semaines. Comparez ce que chacun a détecté et à quelle vitesse la bonne personne a été alertée. Supprimez ensuite les vérifications Nagios que Hyperping couvre désormais, et décidez si ce qui reste (vérifications de seuils, SNMP, plugins maison) justifie de garder une instance Nagios, Checkmk ou Zabbix plus petite.
Comment tester ces outils
- Hyperping : offre Free et essai de 14 jours
- Icinga : téléchargement gratuit ; les modules Director et Icinga Web sont gratuits aussi
- Checkmk : Community est gratuit ; essais de 30 jours pour Pro, Ultimate et Checkmk Cloud
- Zabbix : téléchargement gratuit ; essai de 5 jours pour Zabbix Cloud
- Grafana Cloud : offre gratuite, sans limite de durée
- Netdata : gratuit pour 5 nœuds
- Datadog : gratuit pour 5 hôtes, plus un essai gratuit des offres payantes
- PRTG : essai de 30 jours sans restriction, puis freeware pour 100 capteurs
Pendant l’évaluation, testez tout le chemin de la panne jusqu’à l’humain : arrêtez un service sur un hôte de test et chronométrez le temps qu’il faut pour que le téléphone de la bonne personne sonne, pas seulement pour qu’un tableau de bord passe au rouge.
Pour aller plus loin
- Guide du monitoring des serveurs Linux : CPU, mémoire, disque et réseau sur vos hôtes
- Guide des politiques d’escalade : comment décider qui est alerté et quand
- Rotations d’astreinte : construire un planning qui n’épuise pas les équipes
- Meilleures alternatives à PagerDuty : si vous voulez seulement remplacer la couche d’alerte
- Monitoring par agent : ce qu’un agent voit et que les vérifications externes ne voient pas
Continuer la comparaison : Hyperping vs Netdata · Hyperping vs Datadog · Tarifs de Hyperping · Toutes les comparaisons
Questions fréquentes
Quelle est la meilleure alternative à Nagios ? ▼
Tout dépend de ce qui coince dans Nagios. Icinga est le remplaçant le plus direct : il exécute les mêmes plugins de vérification avec un langage de configuration plus propre. Checkmk reste compatible avec les plugins mais ajoute la découverte automatique par agent et la configuration web. Si le problème vient des alertes, des rotations et de la communication client plutôt que des vérifications, Hyperping remplace la partie alerte d’astreinte et page de statut, avec un agent, des plannings d’astreinte et des pages de statut hébergés, à partir de 24 €/mois.
Quelles sont les meilleures alternatives open source à Nagios ? ▼
Icinga 2 (GPLv2), Checkmk Community (GPLv2, anciennement Raw Edition), Zabbix (AGPLv3 depuis la 7.0), Prometheus avec Grafana (Apache 2.0 et AGPLv3), LibreNMS (GPLv3) et l’agent Netdata (GPLv3). Icinga et Checkmk réutilisent les plugins Nagios, ce qui en fait les migrations les plus simples. Avec Zabbix et Prometheus, il faut reconstruire vos vérifications de zéro.
Existe-t-il une alternative gratuite à Nagios ? ▼
Oui. Icinga 2, Checkmk Community, Zabbix, Prometheus et LibreNMS sont gratuits en auto-hébergé, sans limite d’hôtes, mais vous payez en temps serveur et en maintenance. Les offres gratuites hébergées sont plus limitées : Hyperping Free inclut 1 agent serveur et 20 moniteurs, Netdata Community couvre 5 nœuds, l’offre gratuite de Datadog couvre 5 hôtes avec 1 jour de rétention, et le freeware PRTG couvre 100 capteurs.
Quelle alternative à Nagios choisir pour Windows ? ▼
Nagios Core lui-même ne tourne pas sous Windows, et les hôtes Windows sont surveillés via des agents comme NSClient++ ou NCPA. PRTG est le principal outil dont le serveur tourne sous Windows (son serveur central ne fonctionne que sous Windows). Pour surveiller des hôtes Windows depuis un serveur Linux ou hébergé, Hyperping, Checkmk, Zabbix, Netdata et Datadog fournissent tous des agents Windows natifs, et Prometheus utilise windows_exporter.
Nagios est-il encore maintenu en 2026 ? ▼
Oui. Nagios Core 4.5.14 est sorti le 5 août 2026 avec des correctifs de sécurité, et Nagios XI est vendu et supporté par Nagios Enterprises. Les équipes quittent rarement Nagios parce qu’il a cessé de fonctionner. Elles partent à cause de la charge de configuration, de la maintenance des plugins sur chaque hôte et de l’absence de plannings d’astreinte et de pages de statut intégrés.
Icinga est-il meilleur que Nagios ? ▼
Pour la plupart des équipes, oui. Icinga est né en 2009 comme fork de Nagios, et Icinga 2 a été réécrit avec son propre langage de configuration, une API REST, du clustering natif et une interface web moderne, tout en exécutant des plugins compatibles Nagios. La contrepartie : vous hébergez et maintenez toujours tout vous-même, y compris la couche de notifications.
Combien coûte Nagios XI par rapport aux alternatives ? ▼
Nagios XI Standard est une licence perpétuelle à partir de 2 595 $ pour 100 nœuds, avec un contrat de maintenance et de support obligatoire après la première année pour conserver les fonctionnalités premium. Checkmk Pro démarre à 190 €/mois en facturation annuelle, PRTG 500 coûte 200 $/mois en facturation annuelle, Datadog Infrastructure Pro 15 $ par hôte et par mois en engagement annuel, et Hyperping Essentials 24 $/mois en facturation annuelle pour 5 agents serveur, 50 moniteurs, l’astreinte et une page de statut.