Die besten FireHydrant-Alternativen für die Bereitschaftsplanung 2026 sind Hyperping für Monitoring, Rufbereitschaft und Statusseiten in einem Festpreis-Plan, incident.io für eine Slack-native Incident-Reaktion mit integrierter Rufbereitschaft, Rootly für tiefere Workflow-Automatisierung und ein reichhaltigeres Rotationsmodell, PagerDuty für Alarm-Routing im Enterprise-Umfeld, Grafana Cloud IRM für Teams, deren Alarme schon aus Grafana kommen, und GoAlert als Open-Source-Lösung zum Selbsthosten.
Ich habe diese sechs mit den aktuellen Plänen von FireHydrant verglichen, die Threads auf r/sre gelesen, in denen Entwickler FireHydrant gegen incident.io und Rootly abwägen, und für jedes Tool den Preis für ein Team mit 20 Personen berechnet. FireHydrant ist ein ernstzunehmendes Produkt mit der tiefsten Runbook-Engine der Kategorie. Die meisten Teams, die einen Ersatz suchen, gehen nicht, weil es versagt. Sie gehen, weil die On-Call-Ebene (Signals) an eine Lebenszyklus-Plattform gebunden ist, die sie nicht nutzen, weil KI und Analysen hinter dem Enterprise-Plan liegen oder weil der Incident in einer Web-App lebt, während das Team in Slack lebt.
Was Sie in diesem Leitfaden erfahren:
- Warum Teams tatsächlich nach Alternativen zu FireHydrant suchen (die Gründe sind konkret und selten „es ist schlecht“)
- Die sechs Tools, die ich empfehlen würde, mit aktuellen Preisen und den Kompromissen, die jedes mit sich bringt
- Direkte Antworten auf incident.io vs FireHydrant und FireHydrant vs Rootly
- Eine Schritt-für-Schritt-Anleitung, um die Bereitschaftsplanung ohne Lücke in der Abdeckung zu Hyperping zu verlagern
Wenn Sie ein Monitoring wollen, das Probleme in 30 Sekunden erkennt, Bereitschaftspläne mit Eskalationsrichtlinien und eine Statusseite, die Ihre Kunden tatsächlich lesen, alles in einem monatlichen Festpreis-Plan mit enthaltenen Nutzerplätzen (zusätzliche Plätze werden pro Nutzer abgerechnet), dann testen Sie Hyperping kostenlos.
Das Wichtigste in Kürze
- FireHydrant verkauft inzwischen drei Pläne: Free (bis zu 10 Responder), Pro für 25 $ pro Responder und Monat bei jährlicher Abrechnung, mit Signals für die Rufbereitschaft, aber separat verkauften SMS und Anrufen, und Enterprise mit individuellem Preis. Dort liegen KI, private Statusseiten, Alarmgruppierung und Analysen.
- Hyperping ersetzt Check, Pager und Statusseite in einem Plan. Ein Team mit 20 Personen zahlt auf Pro 179 $/Monat bei monatlicher oder etwa 149 $/Monat bei jährlicher Abrechnung, gegenüber 500 $/Monat für dasselbe Team auf FireHydrant Pro.
- incident.io ist die nächstliegende Slack-native Alternative und bietet KI-Post-Mortems schon im Pro-Plan, rechnet aber doppelt ab: 15 $ pro Nutzer und Monat für Team plus 10 $ pro Nutzer und Monat für jeden Nutzer in Rufbereitschaft.
- Rootly verkauft On-Call Essentials einzeln für 20 $ pro Nutzer und Monat, mit Shadow-Rotationen, Urlaubsverwaltung und Lückenerkennung, die FireHydrant Signals nicht hat.
- PagerDuty bleibt der Enterprise-Standard mit 21 $ pro Nutzer und Monat für Professional, dazu eine jährlich im Voraus fällige Gebühr für die PD Reliability Platform ab 2.800 $ für 10 Plätze, mit 750+ Integrationen und AIOps in den Plattform-Stufen.
- Grafana Cloud IRM kostet eine Plattformgebühr von 19 $/Monat plus 20 $ pro aktivem IRM-Nutzer und lohnt sich nur, wenn Grafana Alerting bereits Ihre Alarmquelle ist.
- GoAlert ist kostenlos und selbst gehostet, deckt Bereitschaftspläne und Eskalationen mit Alarmierung über Twilio ab und hat seit Oktober 2024 kein Release mehr veröffentlicht.
Warum Sie diesem Leitfaden vertrauen können
Ich bin Léo, Gründer von Hyperping. Eines der sechs Tools unten ist meins, und ich sage, wo es die falsche Wahl ist: Wenn Ihre Alarme weiterhin per Webhook aus Prometheus Alertmanager oder Datadog kommen müssen, ist Hyperping nicht Ihr FireHydrant-Ersatz, und ich nenne stattdessen die vier Tools, die diese Webhooks annehmen.
Die Preise habe ich am 16. September 2026 auf den öffentlichen Preisseiten der Anbieter abgelesen. FireHydrant hat seine früheren Stufen Starter und Advanced durch die Aufstellung Free, Pro und Enterprise ersetzt. Jeder Leitfaden, der noch 20 $ und 44 $ pro Nutzer nennt, ist also veraltet. Für die Stimmung unter Nutzern habe ich mich auf die Threads gestützt, die praktizierende SREs immer wieder verlinken:
- Rootly vs FireHydrant: any experience? (r/sre)
- Incident management tools comparison (r/sre)
- Das SaaS-Unternehmen mit 95 Personen, das PagerDuty, FireHydrant, Rootly und incident.io evaluiert hat (r/SaaS)
- Best PagerDuty alternatives (r/devops)
Stammt eine Aussage von der Vergleichsseite eines Anbieters, kennzeichne ich das. Wo ich ein Tool nicht selbst testen konnte, habe ich mich auf Bewertungen bei G2 und PeerSpot gestützt und sage das auch.
Die Empfehlungen im Überblick
| Am besten für | Produkt |
|---|---|
| Monitoring, Rufbereitschaft und Statusseiten in einem Festpreis-Plan | Hyperping |
| Slack-native Incident-Reaktion mit integrierter Rufbereitschaft | incident.io |
| Tiefe Workflow-Automatisierung und ein reichhaltigeres Rotationsmodell | Rootly |
| Alarm-Routing im Enterprise-Umfeld mit dem größten Integrationskatalog | PagerDuty |
| Rufbereitschaft für Teams, deren Alarme aus Grafana kommen | Grafana Cloud IRM |
| Open-Source-Bereitschaftsplanung zum Selbsthosten | GoAlert |
Warum Teams nach FireHydrant-Alternativen suchen
FireHydrant wird gut bewertet. Auf G2 wird immer wieder der schnell reagierende Support gelobt, der Chatbot für Slack und Teams und Runbooks, die einer Organisation mit 30 Services einen wiederholbaren Weg durch jeden Incident geben. Die Gründe, sich anderswo umzusehen, betreffen Paketierung und Passung.
- Die On-Call-Ebene ist an eine Lebenszyklus-Plattform gebunden. Signals, das Produkt von FireHydrant für Rufbereitschaft und Alarmierung, ist in Pro für 25 $ pro Responder enthalten. Wenn Sie eine Rotation, eine Eskalationsrichtlinie und einen Anruf um 3 Uhr nachts brauchen, zahlen Sie für Runbooks, einen Servicekatalog und Retrospektiven-Vorlagen, die Sie vielleicht nie öffnen. Rootly und incident.io verkaufen die Rufbereitschaft beide einzeln für 20 $ pro Nutzer und Monat.
- SMS und Anrufe werden bei Pro separat verkauft. Der Plan nennt Push, Slack, Teams und E-Mail als enthaltene Benachrichtigungskanäle, dazu „SMS und Anrufe separat erhältlich“. Für ein Team, das den Anruf als letzten Weckkanal nutzt, ist das ein zweiter Posten, über den verhandelt werden muss.
- KI und Analysen gibt es nur in Enterprise. KI-Zusammenfassungen, Transkripte, Triage und Retrospektiven, Incident-Analysen, Alarmgruppierung, private Incidents und private Statusseiten liegen alle in der Stufe mit individuellem Preis. incident.io bietet KI-Post-Mortems im Pro-Plan, und der AI Scribe von Rootly ist in den Essentials-Plänen enthalten.
- Der Incident lebt in einer Web-App. Der Slack-Bot von FireHydrant löst Aktionen aus, aber Zeitleiste, Rollen und Retrospektive liegen in der Oberfläche von FireHydrant. Teams, deren Responder Slack nie verlassen, berichten von besserer Akzeptanz bei incident.io oder Rootly. Die Vergleichsseite von incident.io sagt das selbst, nehmen Sie diese Aussage also als Marketing, aber das Muster taucht auch im r/sre-Thread auf, in dem Entwickler FireHydrant als Tool für SREs beschreiben, die den Prozess steuern, und Rootly als das Tool, das das ganze Team tatsächlich nutzt.
- Grenzen bei Automatisierung und Integrationen. G2-Rezensenten erwähnen Einschränkungen bei dem, was eine Automatisierung auslösen kann, einen Slack-Bot, der „Spam produziert und kaum Einstellmöglichkeiten bietet“, und Analysen, mit denen sich einfache Fragen zur Incident-Last kaum beantworten lassen. Pro begrenzt Sie außerdem auf 5 Integrationen und 10 benutzerdefinierte Felder.
- Funktionen brechen, wenn neue erscheinen. Mehrere G2-Bewertungen merken an, dass bestehende Funktionen nach einem Release gelegentlich nicht mehr funktionieren. Am Schreibtisch eine Kleinigkeit, um 3 Uhr nachts ein großes Problem.
- Mindshare. Nach den Zahlen von PeerSpot vom Dezember 2025 hält Rootly 8,5 % der Mindshare in der Kategorie, FireHydrant 1,6 %. Das zählt im Einkauf, bei der Einstellung von Entwicklern, die das Tool schon kennen, und dabei, wie viele Integrationspartner zuerst dafür entwickeln.
Ein Thema wiederholt sich in jedem Thread: Kein einzelnes Tool deckt jede Ebene eines Incidents ab. Erkennung, Alarmierung, Koordination und Kundenkommunikation sind vier Aufgaben. FireHydrant erledigt die mittleren beiden gut. Die Alternativen unten machen entweder die Alarmierung günstiger, die Koordination direkt im Chat, oder sie holen Erkennung und Kommunikation auf dieselbe Rechnung.
Warum es diese 6 Tools in die Auswahl geschafft haben
Ich habe 25+ Tools betrachtet, darunter Better Stack, Squadcast, Blameless, Opsgenie, xMatters, Zenduty, iLert, Splunk On-Call, ServiceNow, Jira Service Management, Freshservice, OneUptime, Keep, Spike.sh, PagerTree und All Quiet. Viele schieden aus einem konkreten Grund aus:
- Auslaufmodell. Opsgenie wird im April 2027 eingestellt. Wer heute evaluiert, sollte den Nachfolger evaluieren, nicht das Tool, das ersetzt wird. Unser Leitfaden zur Opsgenie-Abschaltung behandelt diesen Fall.
- Zu eng. Spike.sh, PagerTree und All Quiet alarmieren Menschen und hören dort auf. Ihnen fehlen die Eskalationstiefe und die Statusseite, die in jedem r/sre-Thread zum Ersatz von FireHydrant zur Sprache kommen.
- Service Desk zuerst. Jira Service Management, ServiceNow und Freshservice sind auf Tickets ausgelegt. Das Koordinationsproblem um 2 Uhr nachts, das FireHydrant löst, steht bei ihnen nicht im Mittelpunkt.
- Intransparente Preise. Bei Blameless, BigPanda und BMC Helix braucht es immer noch ein Vertriebsgespräch, um eine Zahl zu bekommen. FireHydrant veröffentlicht seinen Pro-Preis, und ein Ersatz sollte das auch tun.
- Unsicherheit nach einer Übernahme. Squadcast (heute SolarWinds Incident Response) ist mit 15 $ pro Nutzer und Monat bei jährlicher Abrechnung eine glaubwürdige günstige Option, aber durch die Übernahme durch SolarWinds ist die Roadmap schwer einzuschätzen, und unser Leitfaden zu Rootly-Alternativen behandelt es bereits.
- Monitoring zuerst. Better Stack bündelt Monitoring, Logs und Incidents in einer ausgefeilten Oberfläche, aber durch Add-ons pro Responder und pro Statusseite steigt die Rechnung schleichend, und es passt schlechter zu der Suche nach Rufbereitschaft, um die es in diesem Leitfaden geht.
Jedes der sechs Tools unten steht für einen eigenen Grund, warum jemand „FireHydrant-Alternativen für Bereitschaftsplanung“ in ein Suchfeld tippt.
Funktionsvergleich
| Funktion | Hyperping | incident.io | Rootly | PagerDuty | Grafana Cloud IRM | GoAlert |
|---|---|---|---|---|---|---|
| Preismodell | Festpreis + Plätze | Pro Nutzer + On-Call | Pro Nutzer, pro Modul | Pro Nutzer + Add-ons | Plattformgebühr + pro Nutzer | Kostenlos, selbst gehostet |
| Rufbereitschaft separat verkauft | Nein, enthalten | Ja (10 $ bis 20 $ pro Nutzer) | Ja (20 $ pro Nutzer) | Enthalten | Enthalten | k. A. |
| Integriertes Uptime-Monitoring | Ja | Nein | Nein | Nein | Nein | Nein |
| Nimmt Webhooks von Alertmanager oder Datadog an | Nein | Ja | Ja | Ja | Ja | Ja |
| Incident-Lebenszyklus in Slack oder Teams | Benachrichtigungen | Vollständig | Vollständig | Benachrichtigungen | ChatOps | Benachrichtigungen |
| KI-Post-Mortems | Nein | Ja (Pro) | Ja | Add-on | Ja (Cloud) | Nein |
| Runbooks | Nein | Workflows | Workflows | Automation-Add-on | Nein | Nein |
| Integrierte Statusseite | Ja | Ja (eingeschränkt in Team) | Ja | Add-on (Statuspage) | Nein | Nein |
| Alarmierung per Anruf | Ja | Ja | Ja | Ja | Ja | Ja (Twilio) |
| Kostenlose Stufe | Ja | Basic-Plan | Nein | Bis zu 5 Nutzer | 3 aktive Nutzer | Kostenlos |
| Hosting | EU (DSGVO) | US/EU | US | US/EU | US/EU | Bei Ihnen |
1. Hyperping: am besten, wenn Ihre Alarme aus Uptime-Checks kommen
Ideal für
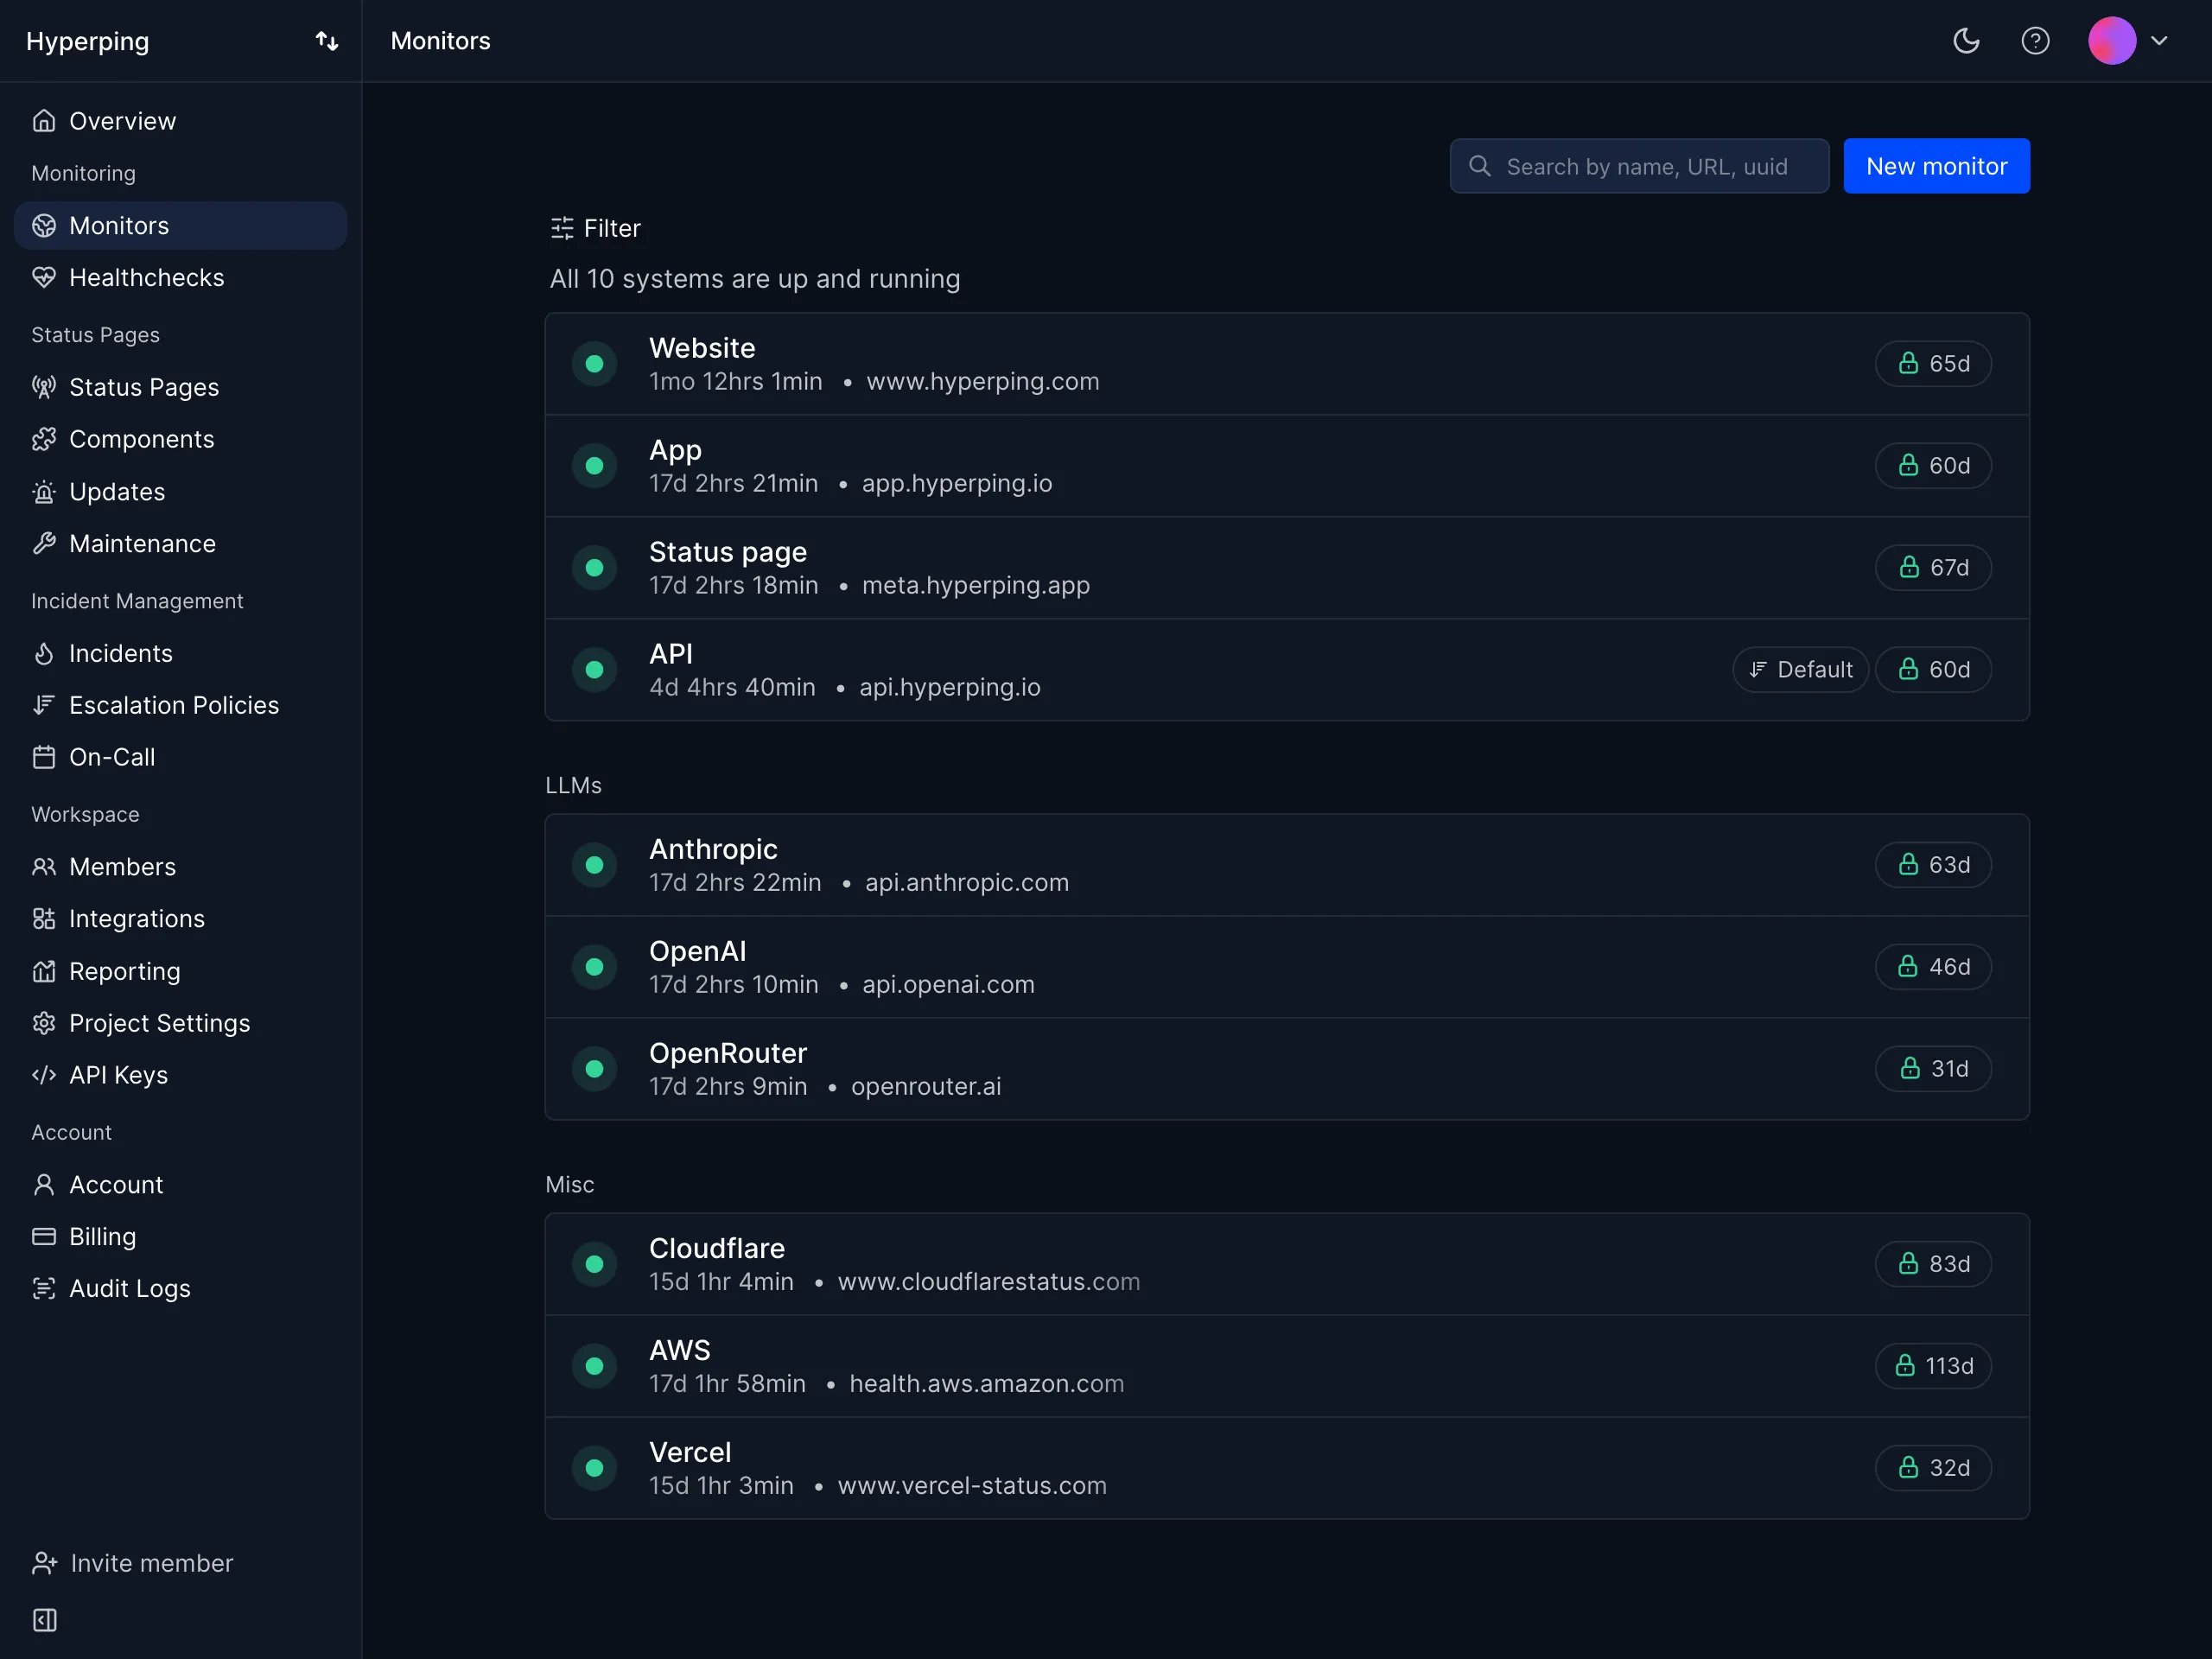
Teams von 2 bis 50 Personen, deren Integrationen in FireHydrant Signals größtenteils Uptime-, SSL- und Cron-Alarme waren und die Check, Alarm und öffentliche Statusseite in einem Produkt wollen. Die naheliegende Wahl, wenn in Ihrer Incident-Liste in FireHydrant die meisten Einträge „Seite down“ oder „Zertifikat abgelaufen“ lauten.
Wichtige Funktionen
- Checks aus 18 Regionen für HTTP, DNS, Ports, Cron-Heartbeats und Playwright-Browser-Flows, alle 30 Sekunden bei Essentials und Pro, alle 20 Sekunden bei Business, dazu eine tägliche Prüfung des SSL-Zertifikats bei jedem HTTPS-Monitor.
- Bereitschaftspläne mit einer Rotation pro Team oder Zeitzone, Übergabezeiten, zeitlichen Einschränkungen und Vertretungen.
- Eskalationsrichtlinien mit geordneten Stufen und Verzögerungen über Slack, Teams, E-Mail, SMS und Telefon, wobei eine Stufe die Person ansprechen kann, die laut Plan gerade Bereitschaft hat.
- Bestätigung aus einer zweiten Region, bevor jemand alarmiert wird. Das beseitigt die meisten Fehlalarme direkt an der Quelle statt über Gruppierungsregeln.
- Statusseiten inklusive: 1 bei Essentials, 3 bei Pro, 10 bei Business, mit eigenen Domains, Abonnenten und ab Pro mit Schutz per Passwort oder E-Mail-Code.
- Server-Monitoring-Agent für CPU, Arbeitsspeicher, Festplatte und Netzwerk unter Linux und macOS.
- Ausgehende Integrationen zu Slack, Teams, Discord, Telegram, PagerDuty, Opsgenie und Webhooks.
- Hosting in der EU, alle Daten liegen in europäischen Rechenzentren.
Warum Hyperping statt FireHydrant
Alarm und Check sind dasselbe Produkt. FireHydrant Signals empfängt Alarme von etwas anderem. Hyperping ist dieses andere und alarmiert direkt aus dem fehlschlagenden Check. Das spart einen Anbieter, einen Webhook und eine Stelle, an der ein Alarm verloren gehen kann.
Eine Rechnung, die nicht mit jeder Neueinstellung wächst. Ein Team mit 20 Personen zahlt auf Hyperping Pro 179 $/Monat bei monatlicher oder etwa 149 $/Monat bei jährlicher Abrechnung. Das deckt die 10 enthaltenen Plätze plus 10 zusätzliche Plätze zu je 9 $/Monat. FireHydrant Pro kostet für dieselben 20 Personen 500 $/Monat bei jährlicher Abrechnung, vor SMS und Anrufen, und prüft trotzdem nicht, ob Ihre Seite erreichbar ist.
SMS und Anrufe sind im Plan enthalten. Essentials enthält 20 SMS pro Monat, Pro 75, Business 200, und Anrufe gibt es ab Essentials. Bei FireHydrant Pro werden diese beiden Kanäle separat gekauft.
Eine Statusseite, die Ihre Kunden finden. FireHydrant Pro enthält öffentliche Statusseiten, aber der Incident muss trotzdem erst in FireHydrant ausgerufen werden, um dort zu erscheinen. Bei Hyperping teilen sich Monitor, Incident und Statusseite eine Datenquelle, die Seite aktualisiert sich also in dem Moment, in dem der Check fehlschlägt.
Wo Hyperping Schwächen hat
Hyperping nimmt keine eingehenden Alarme von Alertmanager, Datadog oder Grafana an. Wenn Ihre Prometheus-Regeln weiterhin Menschen alarmieren müssen, deckt Hyperping die externen Checks ab und Sie behalten für die internen einen Pager, der Webhooks annimmt. Oder Sie wählen eines der vier Tools unten, die diese Webhooks annehmen.
Es ist auch keine Lebenszyklus-Plattform. Es gibt keine Runbooks pro Service, keinen Servicekatalog, keine KI-Retrospektiven und keine Slack-Incident-Kanäle mit Rollen. Incidents in Hyperping werden manuell oder von Monitoren ausgelöst, mit Zeitleiste und Update auf der Statusseite, und mehr ist es nicht. Für ein Team mit 20+ koordinierten Incidents im Monat ist das eine Lücke, und incident.io oder Rootly schließen sie.
Was Nutzer sagen
„Hyperping gilt bei uns im Unternehmen als reaktionsschneller als Datadog. Meistens bekommen wir die Benachrichtigungen von Hyperping vor denen von Datadog. Es ist nützlich als Fallback, als leichtere Backup-Monitoring-Lösung.“
„Wir haben unsere Hyperping-Statusseite öffentlich gemacht, und sie ist zu einem wichtigen Teil unserer Verkaufsgespräche geworden. Wir sind stolz auf unsere Uptime und finden es großartig, dass wir sie Interessenten zeigen können.“
Preise
Laut Preisseite von Hyperping, bei jährlicher Abrechnung:
- Free: 0 €, 1 Platz, 20 Monitore alle 5 Minuten, 18 Regionen, 1 gehostete Statusseite, keine Rufbereitschaft
- Essentials: 24 €/Monat (29 € monatlich), 3 Plätze, danach 7 € pro Platz, 50 Monitore alle 30 Sekunden, 1 Bereitschaftsplan, Eskalationsrichtlinien, 20 SMS, 1 Statusseite
- Pro: 74 €/Monat (89 € monatlich), 10 Plätze, danach 9 € pro Platz, 250 Monitore, 3 Pläne, 75 SMS, 3 Statusseiten, private Seiten
- Business: 249 €/Monat (299 € monatlich), 20 Plätze, danach 12 € pro Platz, 1.000 Monitore alle 20 Sekunden, 200 SMS, 10 Statusseiten, White Label
Bereitschaftspläne und Eskalationsrichtlinien sind ab Essentials enthalten. Ein Team mit 20 Personen zahlt auf Pro bei jährlicher Abrechnung etwa 149 €/Monat.
Hyperping ist die richtige Wahl, wenn
das meiste, weswegen FireHydrant Sie alarmiert hat, von außen erkennbar ist, Ihr Team weniger als 50 Personen hat und Sie lieber aufhören, für drei Tools (Monitor, Pager, Statusseite) zu zahlen, als für eine Lebenszyklus-Plattform. Lassen Sie es aus, wenn Alertmanager-Webhooks nicht verhandelbar sind oder wenn die Koordination Ihr eigentlicher Engpass ist.
2. incident.io: am besten für Slack-native Reaktion mit integrierter Rufbereitschaft
Ideal für
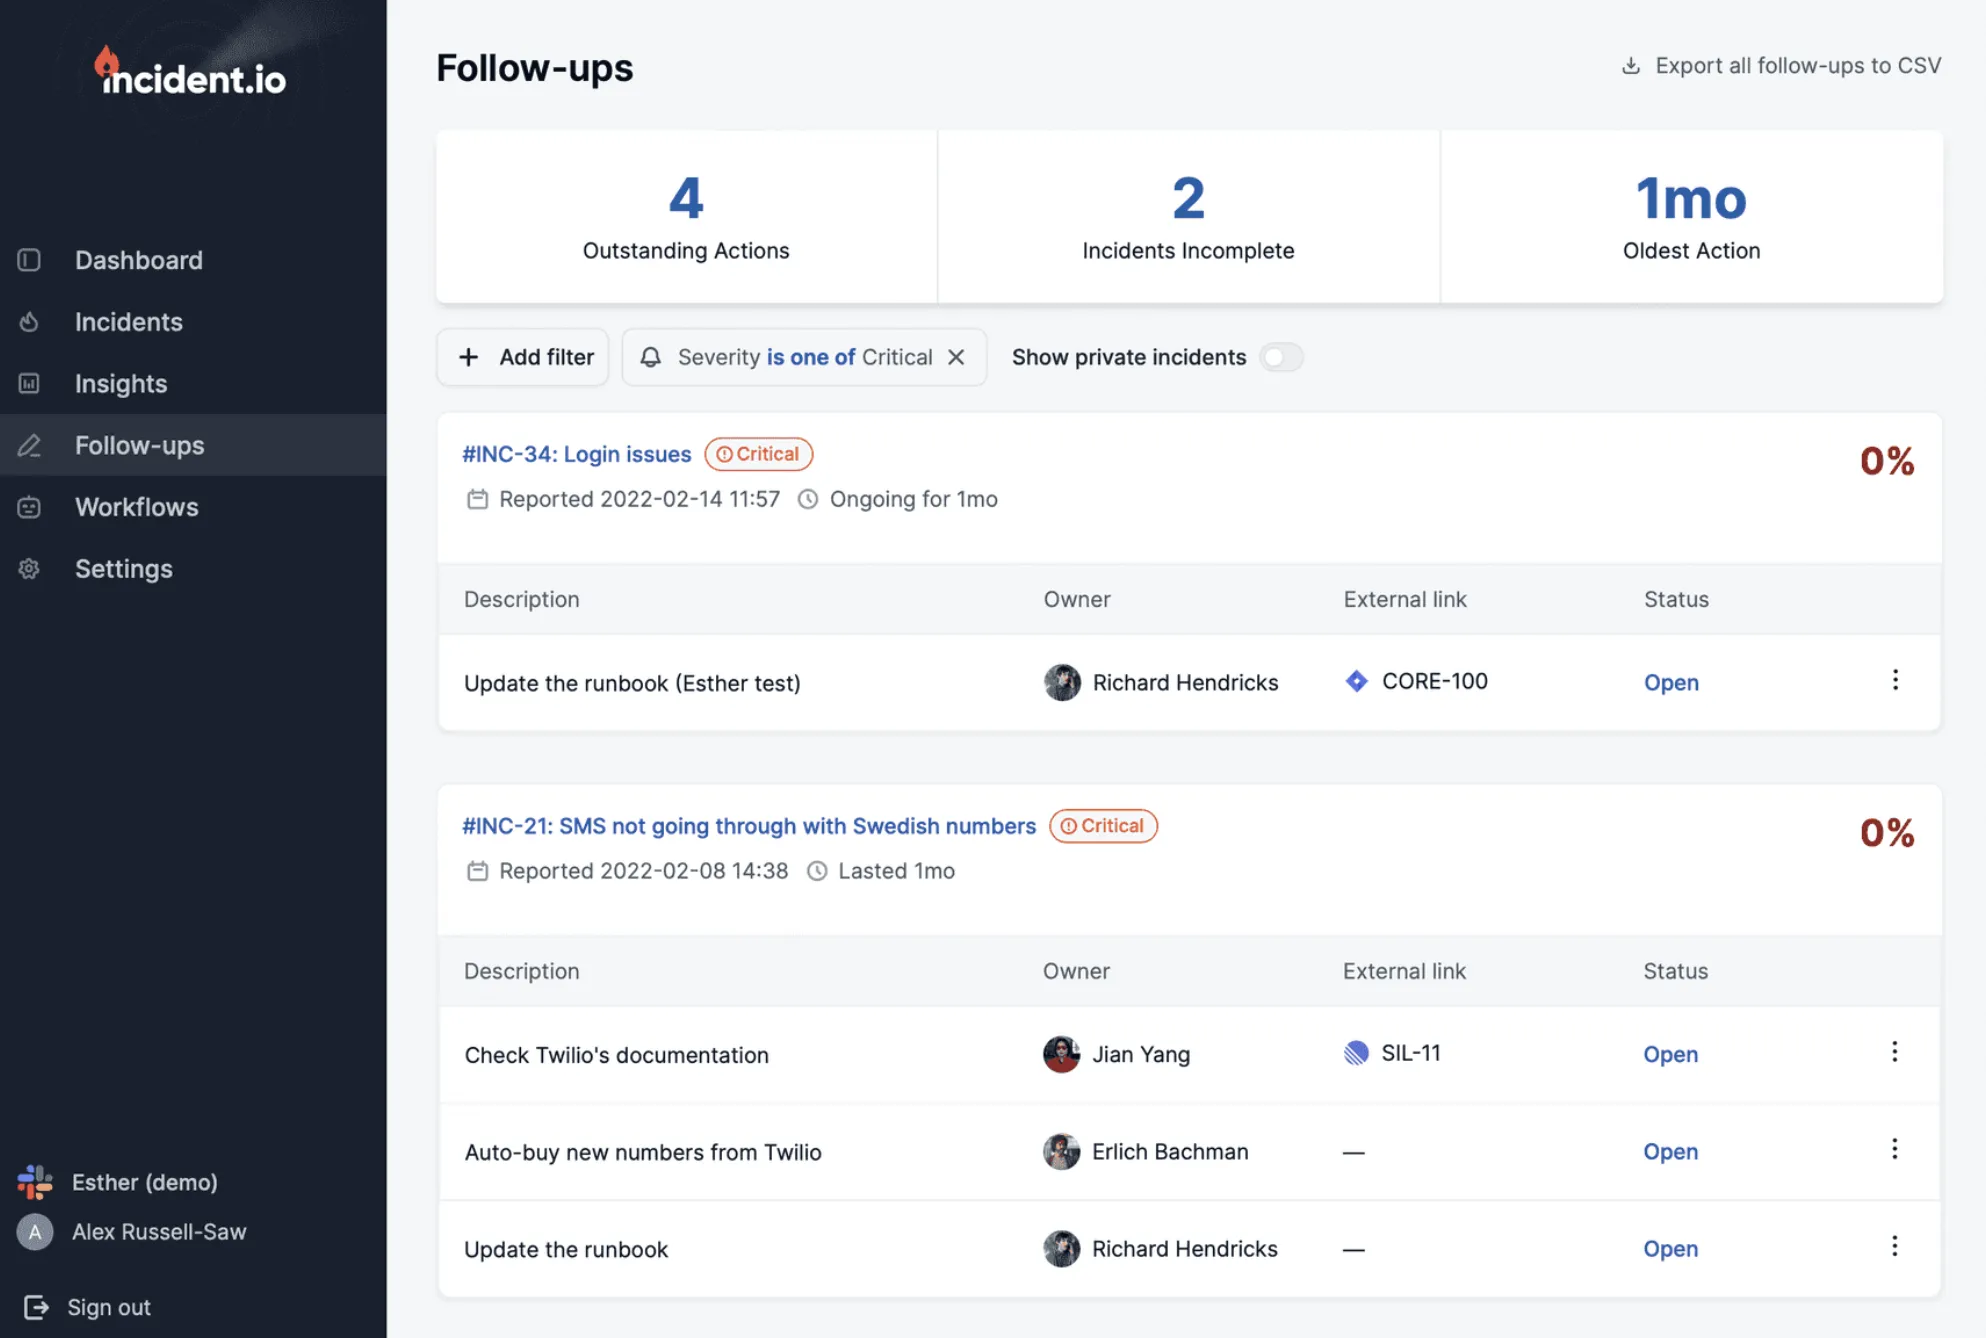
Teams, die Incidents in Slack oder Microsoft Teams abwickeln und wollen, dass Alarm, Incident-Kanal, Update der Statusseite und Post-Mortem ablaufen, ohne eine separate Web-App zu öffnen. Das Tool, für das sich das SaaS-Unternehmen mit 95 Personen auf r/SaaS entschieden hat, nachdem es PagerDuty, FireHydrant, Rootly und incident.io direkt nebeneinander evaluiert hatte.
Wichtige Funktionen
- Bereitschaftspläne, Eskalationspfade und Vertretungen, verwaltet aus Slack, verkauft als Add-on pro Nutzer oder als eigenständiger On-call-Plan.
- Alarmeingang aus Alertmanager, Grafana, Datadog und generischen Webhooks, mit Routing der Alarme in Eskalationspfade.
- Incident-Kanäle mit Rollen und Zeitleisten, die beim Ausrufen automatisch angelegt werden.
- KI-Post-Mortems, entworfen aus der aufgezeichneten Zeitleiste, im Pro-Plan.
- Visueller Workflow-Builder für Routing nach Schweregrad, Updates an Stakeholder und Nachbereitung.
- Statusseiten, eine in Team, mehr in Pro.
- Mobile App mit Push, SMS und Anruf.
Warum incident.io statt FireHydrant
Der gesamte Incident bleibt im Chat. Auf diesem Unterschied hat incident.io das Unternehmen aufgebaut, und er zeigt sich in den Nutzungszahlen. Der Erfahrungsbericht auf r/SaaS beschreibt, wie die Quote abgeschlossener Post-Mortems nach dem Wechsel zu incident.io von „vielleicht 50 %“ auf 92 % stieg, weil der Entwurf schon im Kanal wartete, als der Incident geschlossen wurde. Der Slack-Bot von FireHydrant löst Aktionen aus, aber geschrieben wird in der Oberfläche von FireHydrant.
KI in Pro, nicht auf individuelle Anfrage. KI-Post-Mortems, KI-Untersuchung und vorgeschlagene Responder gibt es in incident.io Pro zu einem veröffentlichten Preis. Bei FireHydrant sind KI-Zusammenfassungen, Transkripte, Triage und Retrospektiven Enterprise-Funktionen.
Klare Vorgaben. Schweregrade, Rollen und der Ablauf zum Ausrufen eines Incidents funktionieren sofort. FireHydrant positioniert sich selbst als „not opinionated“, also bewusst ohne feste Vorgaben. Für ein reifes SRE-Team mit dokumentierten Runbooks ist das eine Stärke, für ein Team, das noch keine geschrieben hat, ein Kostenfaktor.
Für das ganze Unternehmen gebaut. Die Vergleichsseite von incident.io (Anbieteraussage, deckt sich aber mit den Bewertungen) richtet das Produkt neben Entwicklern auch an Support, Compliance und Führungsebene. FireHydrant zielt auf SREs, die den Prozess verantworten.
Wo incident.io Schwächen hat
Zwei Abrechnungsposten addieren sich. Der Team-Plan kostet 15 $ pro Nutzer und Monat, und jeder Nutzer in Rufbereitschaft kommt mit 10 $ pro Nutzer und Monat dazu. Ein Team mit 20 Personen, die alle in der Rotation sind, kostet 500 $/Monat, genauso viel wie FireHydrant Pro. Pro mit Rufbereitschaft erreicht 45 $ pro Nutzer und Monat.
Abhängigkeit von Slack. Microsoft Teams wird unterstützt, hinkt Slack aber hinterher. Koordinieren Ihre Responder per E-Mail oder in einem Ticketsystem, verschwindet der größte Teil des Unterschieds.
Weniger Runbook-Tiefe als FireHydrant. incident.io hat Workflows, keine Runbooks pro Service. Ein Team, das 40 dokumentierte Playbooks in FireHydrant übertragen hat, wird den Builder von incident.io als eingeschränkter empfinden.
Die Einrichtung dauert eine echte Woche. G2-Rezensenten merken an, dass die Konfiguration von Workflows und Katalog aufwendig ist.
Preise
Laut Preisseite von incident.io:
- Basic: kostenlos, Rufbereitschaft für ein einzelnes Team und eine Statusseite
- Team: 15 $ pro Nutzer und Monat jährlich (19 $ monatlich) plus 10 $ pro Nutzer und Monat für jeden Nutzer in Rufbereitschaft
- Pro: 25 $ pro Nutzer und Monat plus 20 $ pro Nutzer und Monat für jeden Nutzer in Rufbereitschaft, mit KI-Funktionen und erweiterten Insights
- Nur On-call: 20 $ pro Nutzer und Monat
- Enterprise: individuell
Ein Team mit 20 Personen auf Team, alle in Rufbereitschaft, kostet 500 $/Monat; nur On-call kostet 400 $/Monat.
incident.io ist die richtige Wahl, wenn
Ihr Team wirklich in Slack lebt, Sie 10+ Incidents im Monat haben und der Rückstau bei Post-Mortems das Problem ist, das Sie lösen wollen. Lassen Sie es aus, wenn Microsoft Teams Ihr wichtigstes Werkzeug ist, wenn Sie FireHydrant wegen der Runbook-Tiefe gewählt haben oder wenn Ihr Engpass die Erkennung ist. Unser Leitfaden zu incident.io-Alternativen geht tiefer auf die Kompromisse ein.
3. Rootly: am besten für Workflow-Automatisierung und ein reichhaltigeres Rotationsmodell
Ideal für
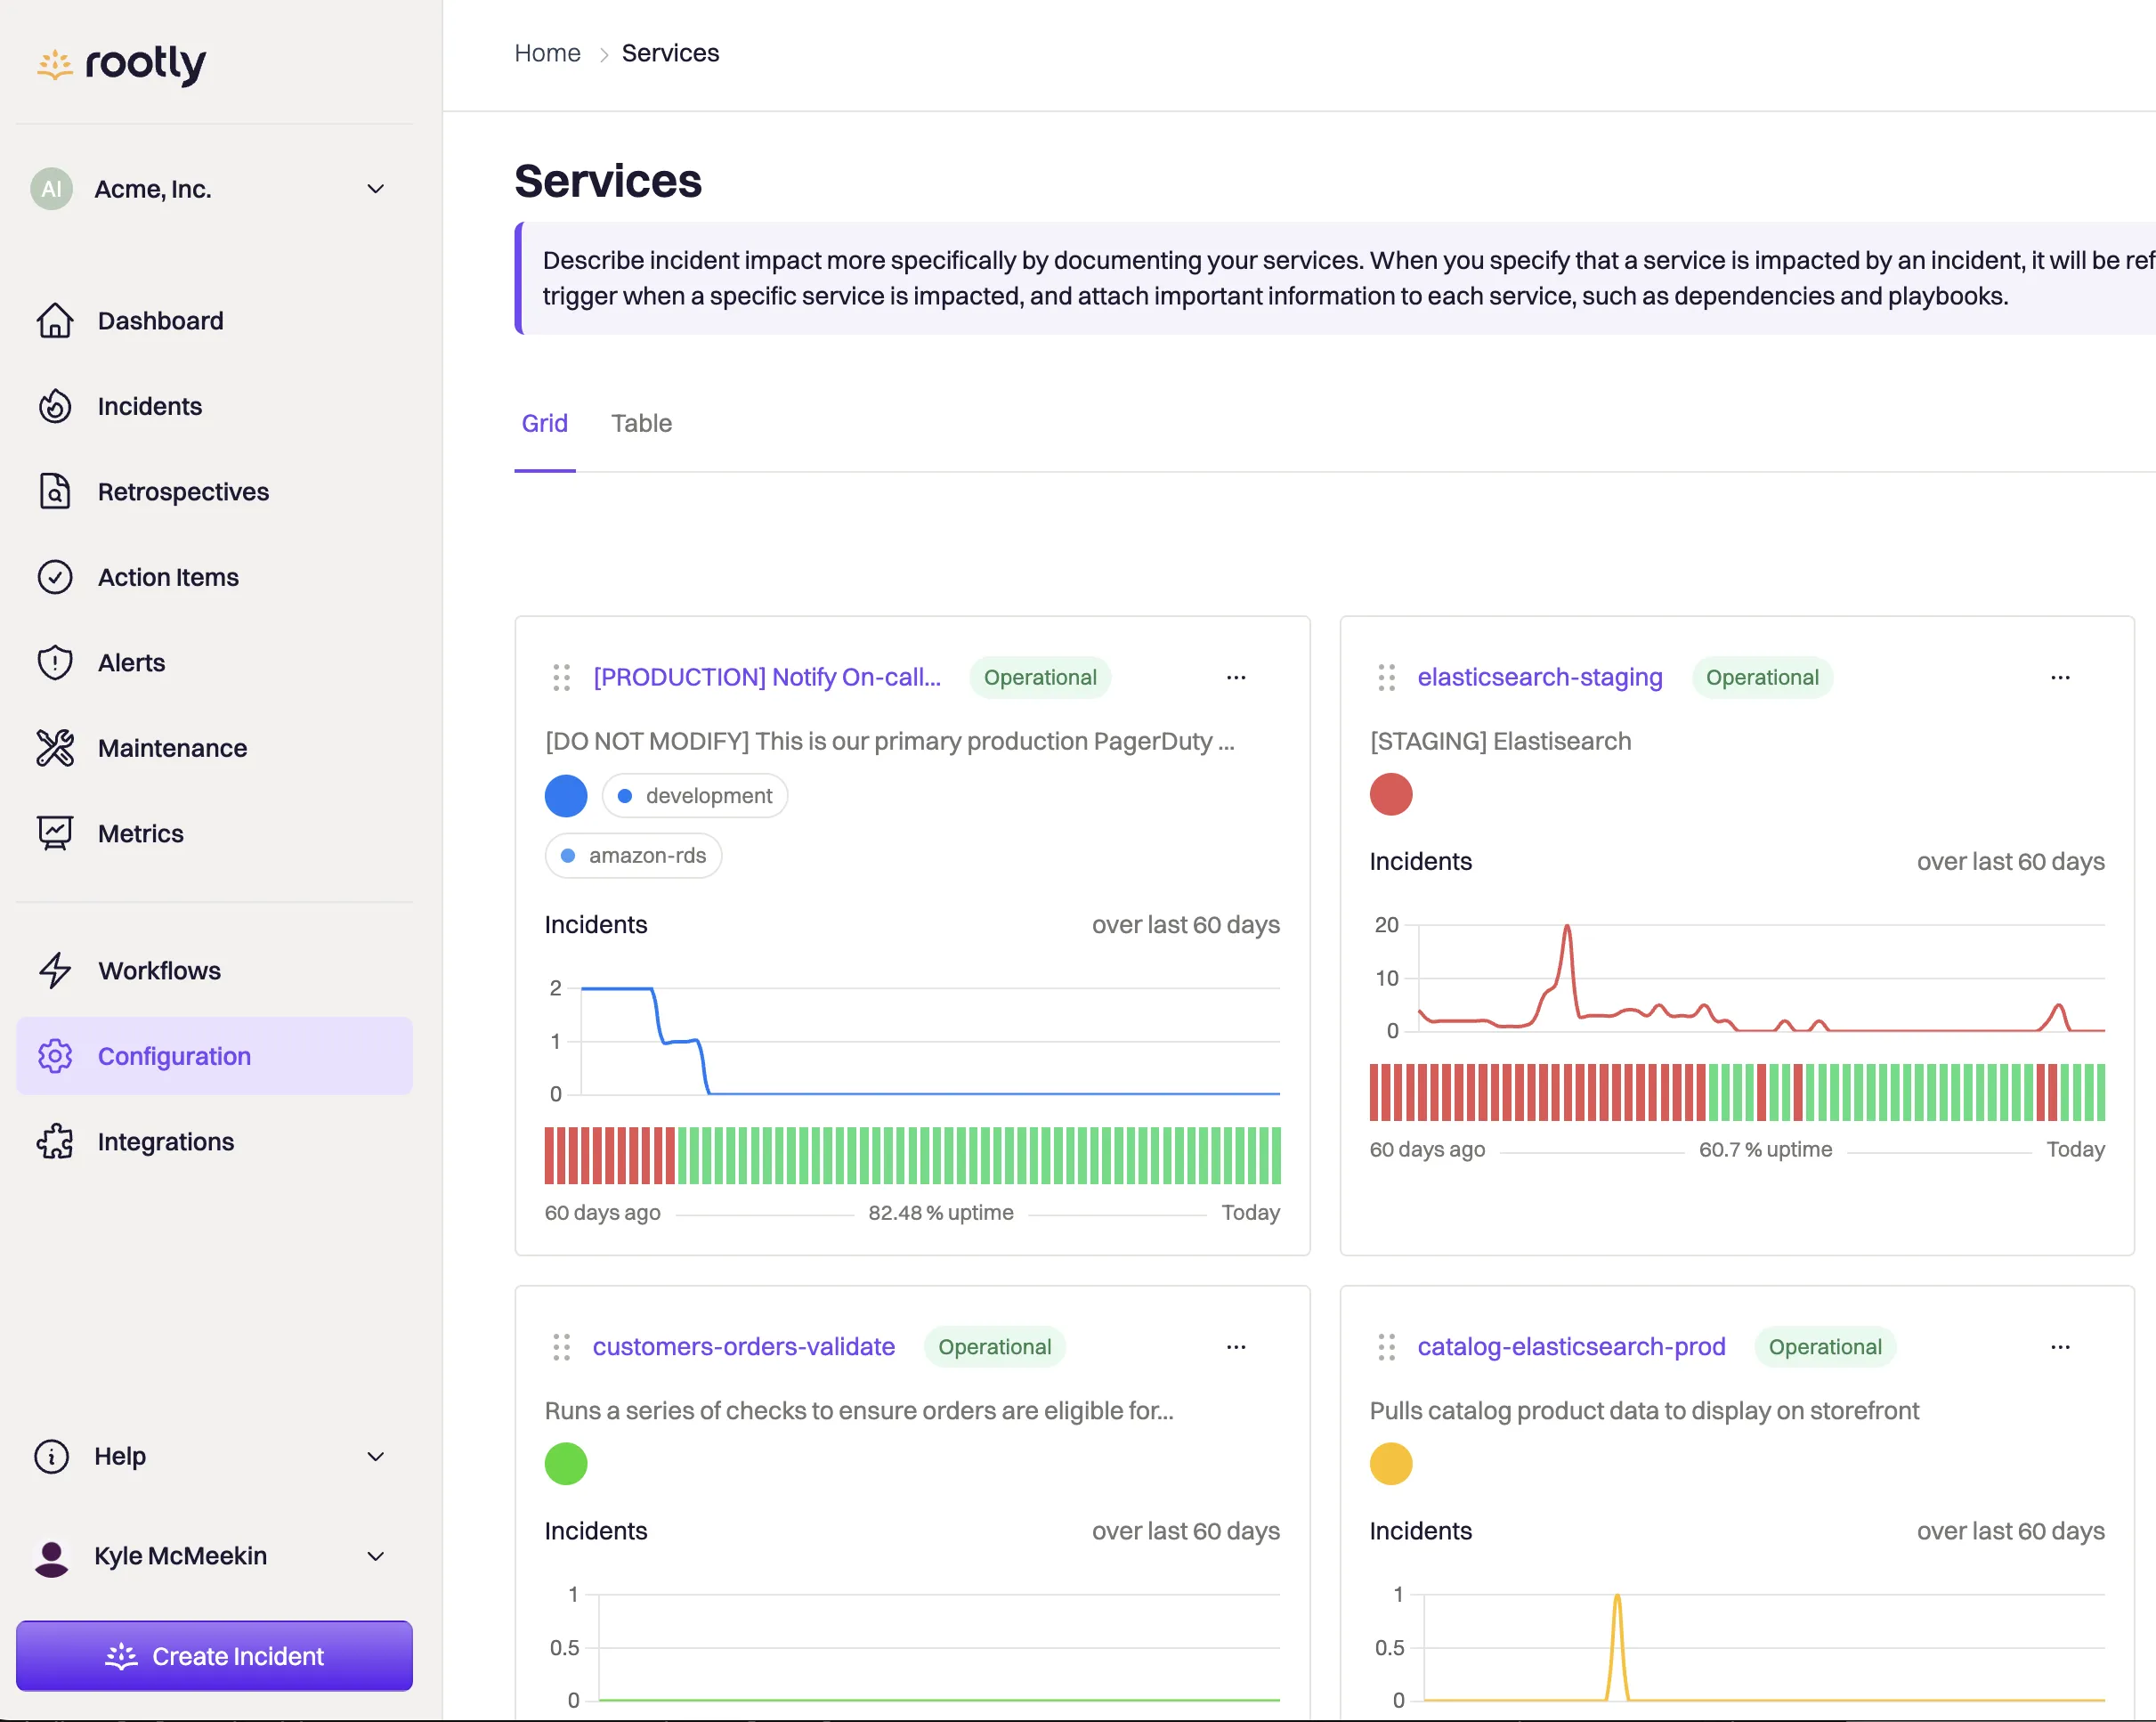
Teams im Mittelstand mit 30 bis 300 Personen, die eine Slack-native Reaktion mit einer Workflow-Engine wollen, die Jira, GitHub, Zoom und den Rest der Toolchain erreicht, und ein On-Call-Modul, das sie einzeln kaufen können. Der andere Name im r/sre-Thread zu FireHydrant.
Wichtige Funktionen
- On-Call Essentials als eigenständiges Modul mit Bereitschaftsplänen, Eskalationsrichtlinien, Alarmgruppierung und Routing sowie Live-Anrufweiterleitung.
- Rotationsfunktionen, die FireHydrant fehlen: Shadow-Rotationen für das Onboarding, Urlaubsverwaltung, Erkennung von Lücken im Plan und ein Rechner für die Bereitschaftsvergütung.
- Incident-Lebenszyklus in Slack und Teams mit automatischer Zeitleiste aus jeder Nachricht und jedem Befehl.
- AI Scribe und KI-Retrospektiven in den Essentials-Plänen enthalten.
- Workflow-Engine mit bedingter Logik über Jira, GitHub, Zoom, Datadog und 60+ Integrationen.
- Statusseite in Incident Response Essentials enthalten.
- Alarmeingang aus Alertmanager, Grafana, Datadog und Webhooks.
Warum Rootly statt FireHydrant
Nur die On-Call-Ebene kaufen. Rootly On-Call Essentials kostet 20 $ pro Nutzer und Monat, ohne Pflicht, Incident Response dazuzunehmen. FireHydrant Pro bündelt Signals mit der Lebenszyklus-Plattform für 25 $ pro Responder. Geht es nur um die Rufbereitschaft, ist Rootly 20 % günstiger und Sie zahlen nicht für Runbooks.
Ein Rotationsmodell von Leuten, die selbst Bereitschaft hatten. Shadow-Rotationen, urlaubsbewusste Planung und Lückenerkennung sind die Funktionen, die einen Bereitschaftsplan über ein ganzes Jahr ehrlich halten. FireHydrant Signals hat Bereitschaftspläne und Eskalationsrichtlinien, und dabei bleibt es.
Automatische Zeitleisten ohne Protokollführer. Rootly rekonstruiert die Zeitleiste aus Slack-Nachrichten und Befehlen. Bei FireHydrant füllt sich die Zeitleiste mit Aktionen, die über den Bot oder die Oberfläche ausgeführt werden, und der Rest wird später nachgetragen.
KI in den Basisplänen. Die KI-Funktionen von Rootly gibt es in Essentials. FireHydrant behält sie Enterprise vor.
Wo Rootly Schwächen hat
Zwei Module verdoppeln die Rechnung. On-Call und Incident Response zu je 20 $ pro Nutzer und Monat bringen ein Team mit 20 Personen für beide auf 800 $/Monat, deutlich über den 500 $/Monat von FireHydrant Pro bei vergleichbarem Umfang.
Konfigurationsaufwand. Ein Kommentator auf r/devops, der sich für incident.io statt Rootly entschieden hat, schrieb von „jeder Menge Funktionen, aber viel zu viel Konfiguration, bis es für unsere Commerce-Umgebung funktionierte“. Ein Team mit 5 Personen wird den Großteil der Workflow-Engine nicht nutzen.
Keine kostenlose Stufe. Es gibt ein Startup-Programm (bis zu 50 % Rabatt unter 100 Mitarbeitenden), aber keinen kostenlosen Plan, um es gegen die Free-Stufe von FireHydrant zu testen.
Runbooks sind Workflows. Wenn Sie an FireHydrant ein kodifiziertes Runbook pro Service geschätzt haben, das Schritt für Schritt abläuft, kommt der Workflow-Builder von Rootly auf anderem Weg dorthin und braucht länger in der Einrichtung.
Preise
Laut Preisseite von Rootly:
- On-Call Essentials: 20 $ pro Nutzer und Monat
- Incident Response Essentials: 20 $ pro Nutzer und Monat
- Enterprise für beide: individuell
- Startup-Programm: bis zu 50 % Rabatt unter 100 Mitarbeitenden, „pay what you can“ unter 25
Ein Team mit 20 Personen zahlt 400 $/Monat für On-Call Essentials, 800 $/Monat mit Incident Response.
Rootly ist die richtige Wahl, wenn
Sie eine Slack-native Reaktion mit mehr Workflow-Reichweite als bei incident.io wollen oder nur das On-Call-Modul brauchen, und zwar von einem Anbieter mit einer Lebenszyklus-Plattform, in die Sie hineinwachsen können. Lassen Sie es aus, wenn Sie weniger als 20 Personen sind oder wenn die Rechnung für zwei Module genau der Grund ist, warum Sie FireHydrant verlassen. Unser Leitfaden zu Rootly-Alternativen behandelt die umgekehrte Frage.
4. PagerDuty: am besten für Alarm-Routing im Enterprise-Umfeld
Ideal für
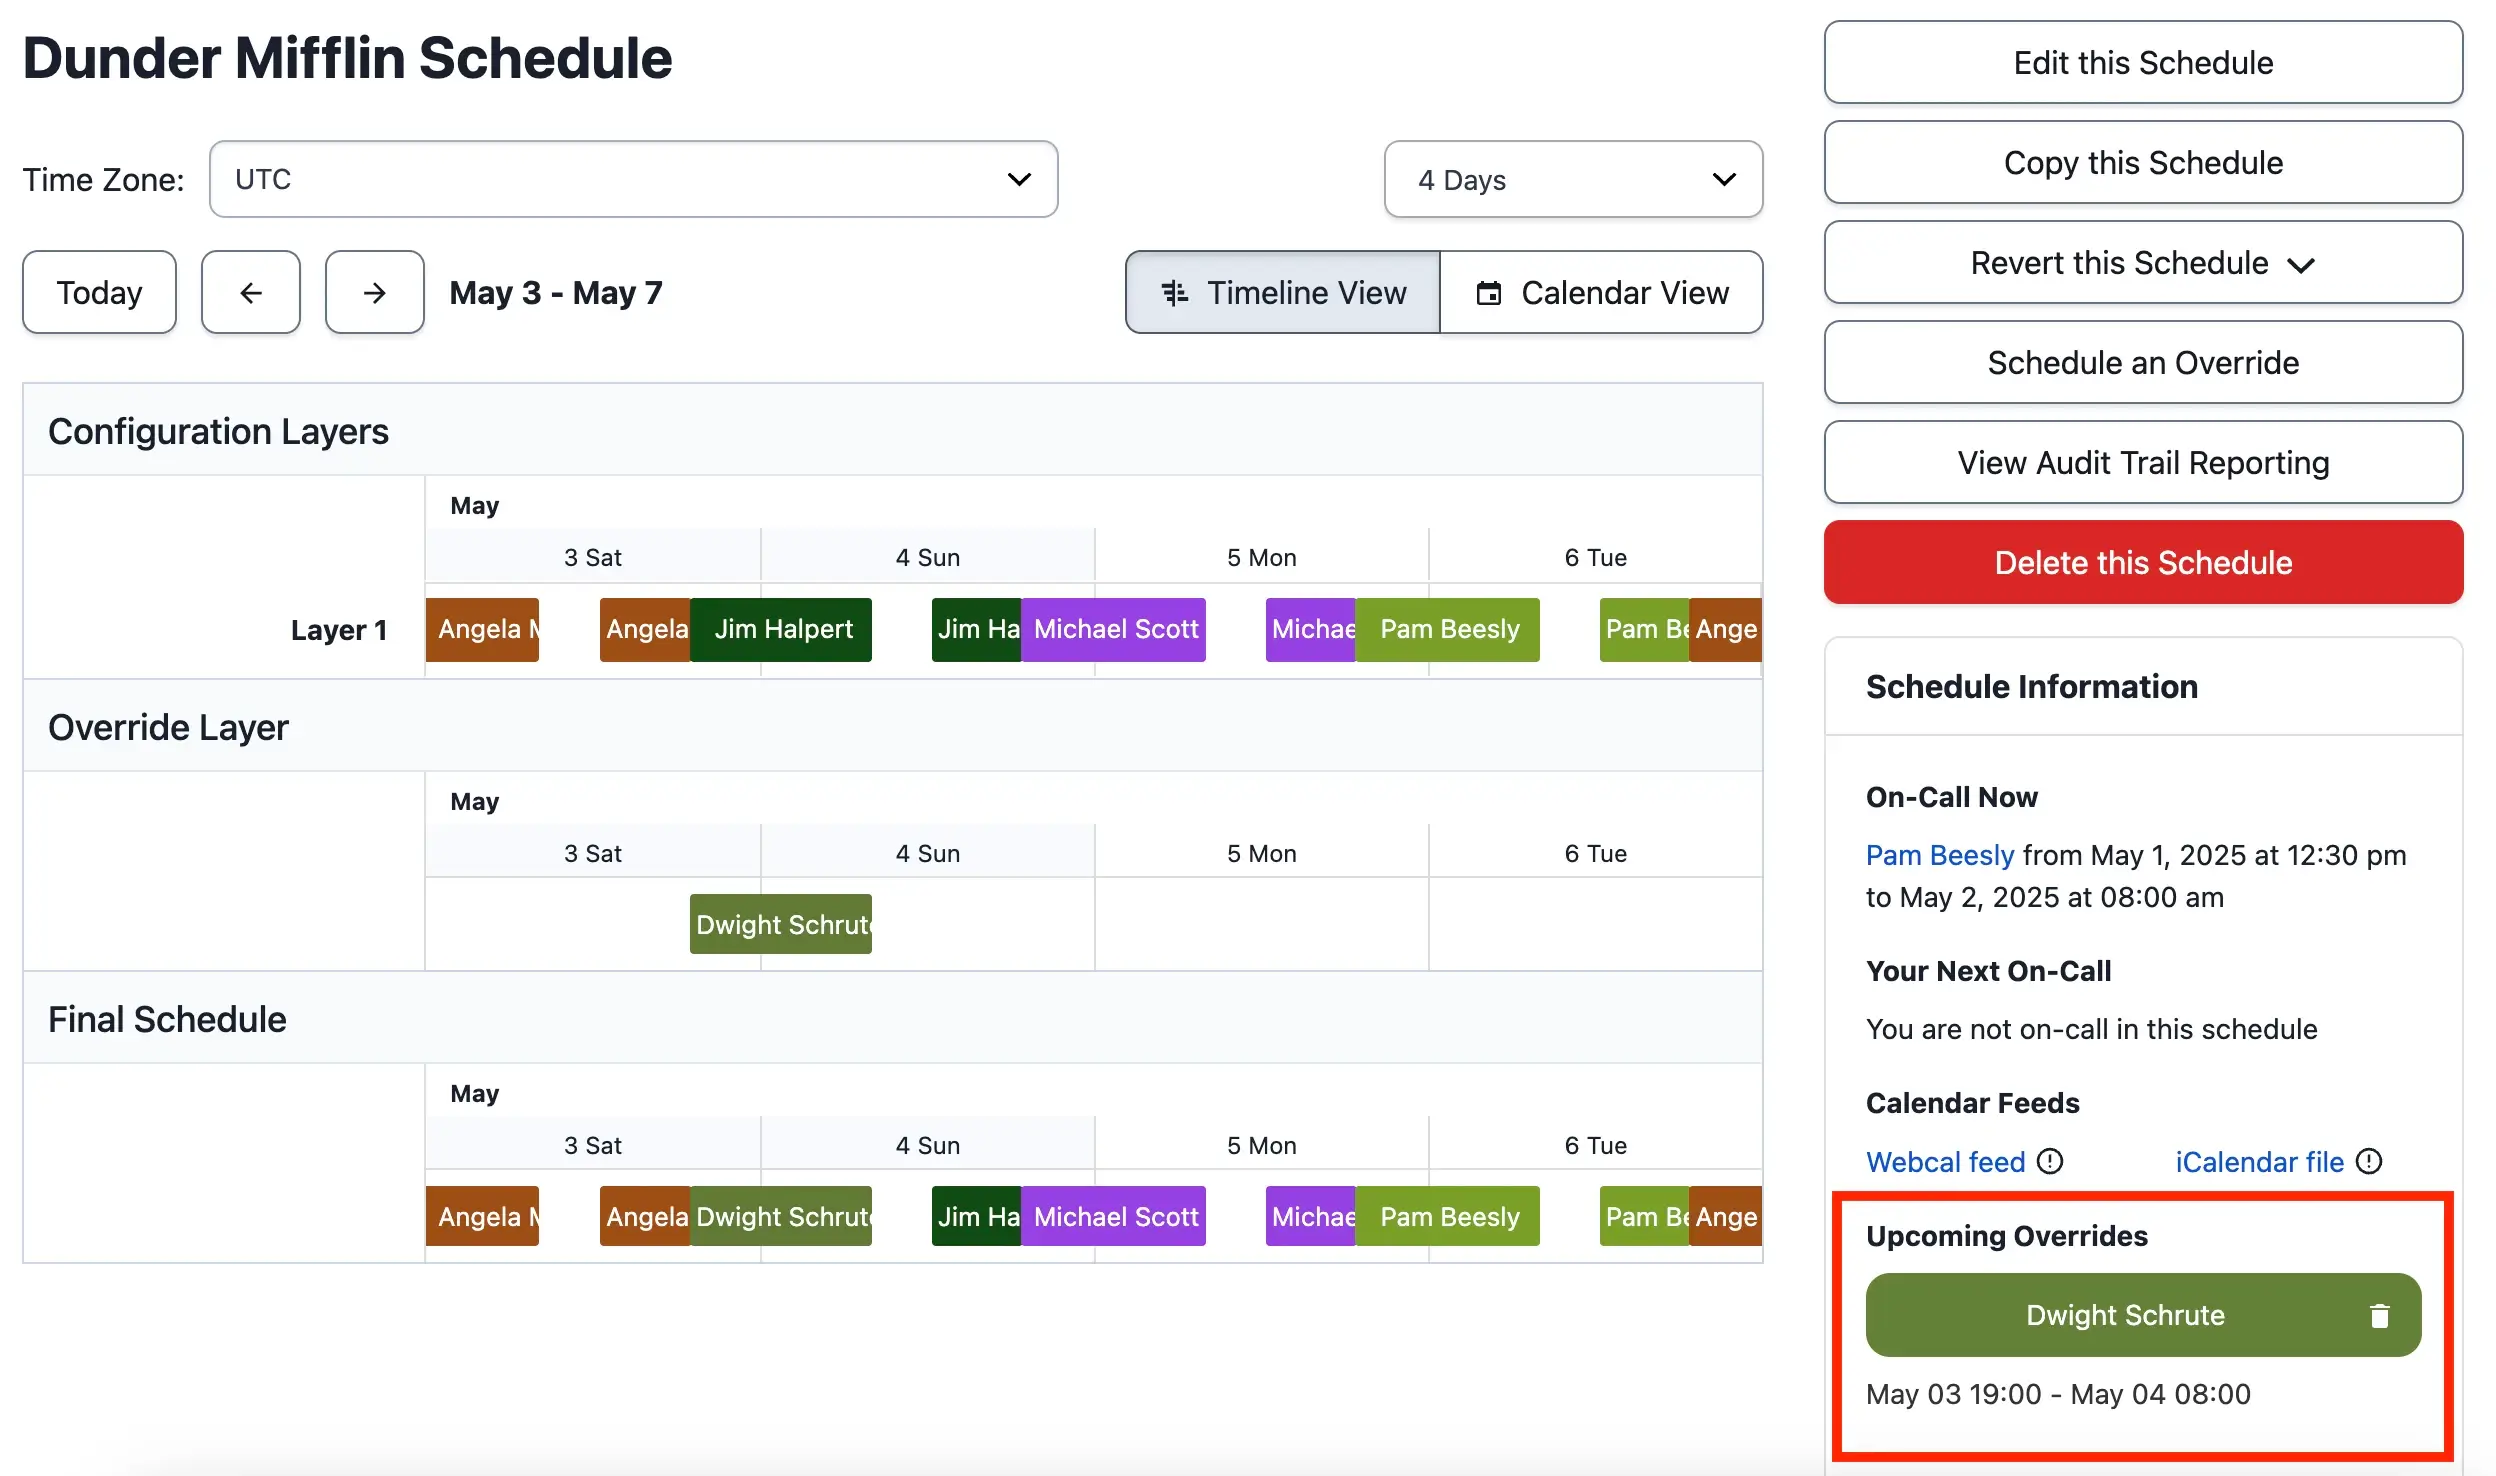
Organisationen mit mehr als 50 Entwicklern, die ein SLA des Anbieters brauchen, komplexe Bereitschaftspläne über mehrere Regionen, eine tiefe Integration mit ServiceNow oder Jira und das Budget für Preise pro Nutzer plus AIOps-Add-ons. Das Tool, gegen das FireHydrant Signals selbst positioniert, und immer noch die Rückfalloption, wenn der Einkauf nach dem Namen fragt, den er kennt.
Wichtige Funktionen
- Bereitschaftspläne, Eskalationsrichtlinien, Vertretungen und Round-Robin-Routing über beliebig viele Teams.
- Event Orchestration für bedingtes Routing, Deduplizierung und Unterdrückung, bevor jemand alarmiert wird.
- 750+ Integrationen, auch mit älteren Enterprise-Systemen, die die neueren Tools nicht erreichen.
- AIOps und Automation Actions als kostenpflichtige Add-ons für die Unterdrückung von Alarmrauschen und Runbook-Automatisierung.
- Mobile App, die Threads auf r/devops immer noch als Goldstandard zum Wecken bezeichnen.
- Terraform-Provider und eine ausgereifte API.
Warum PagerDuty statt FireHydrant
Routing-Tiefe. Follow-the-Sun-Rotationen über fünf Regionen, Eskalationsrichtlinien mit 20 Regeln und bidirektionale Synchronisation mit ServiceNow macht PagerDuty seit einem Jahrzehnt. FireHydrant Signals hat Bereitschaftspläne, Eskalationsrichtlinien und Alarmregeln, Alarmgruppierung und Live-Anrufweiterleitung sind Enterprise vorbehalten.
Integrationskatalog. Wenn „Lässt es sich mit X integrieren?“ die erste Frage in Ihrer Evaluierung ist, antwortet PagerDuty häufiger mit Ja als jeder andere. FireHydrant Pro begrenzt Sie auf 5 Integrationen.
Sicherheit im Einkauf. PagerDuty kommt schneller durch Security-Review und Rechtsabteilung als ein kleinerer Anbieter. Bei 500 Entwicklern zählt das mehr als bei 20.
Wo PagerDuty Schwächen hat
Kosten. Professional für 21 $ pro Nutzer und Monat, dann eine jährlich im Voraus fällige Gebühr für die PD Reliability Platform für AIOps, ab 2.800 $ für 10 Plätze. Ein Team mit 20 Personen zahlt 420 $/Monat auf Professional oder 1.000 $/Monat in der Plattform-Stufe Essential, und Statuspage ist ein separates Abo obendrauf. FireHydrant behauptet im eigenen Launch-Beitrag zu Signals, dass Teams beim Wechsel von PagerDuty im Schnitt 50 % sparen. Eine Zahl des Anbieters, aber eine, die zu den Beschwerden in jedem Thread auf r/devops passt.
Koordination in der Web-App. PagerDuty benachrichtigt in Slack, aber der Incident lebt in der Oberfläche von PagerDuty. Teams, die FireHydrant verlassen, weil der Incident nicht in Slack war, finden hier dasselbe Problem.
Lücken bei API und Webhooks. Nutzer in Foren bemängeln fehlende Webhook-Felder und N+1-API-Aufrufe für benutzerdefinierte Service-Felder.
Datenschutz-Voreinstellungen. Die Slack-Integration aktiviert standardmäßig die Erfassung von Chat-Nachrichten und privaten Kanälen. Prüfen Sie das bei der Einrichtung.
Preise
Laut Preisseite von PagerDuty:
- Free: bis zu 5 Nutzer, 1 Bereitschaftsplan, 1 Eskalationsrichtlinie, 100 SMS- und Anrufbenachrichtigungen pro Monat
- Professional: 21 $ pro Nutzer und Monat jährlich (25 $ monatlich)
- PD Reliability Platform, jährlich im Voraus abgerechnet: Starter 2.800 $ (10 Plätze), Essential 12.000 $ (20 Plätze), Plus 48.000 $ (50 Plätze), Ultimate individuell (500 Plätze)
- AIOps und Automation liegen in den Plattform-Stufen; zusätzliche Plätze kommen aus Credit-Paketen
Ein Team mit 20 Personen zahlt 420 $/Monat auf Professional, 1.000 $/Monat in der Plattform-Stufe Essential.
PagerDuty ist die richtige Wahl, wenn
Sie FireHydrant verlassen, weil ein Audit oder der Einkauf einen Anbieter mit Support und SLA verlangt hat, und die Breite der Integrationen wichtiger ist als der Preis. Lassen Sie es unter 50 Personen aus oder wenn eine Reaktion direkt im Chat der Grund war, warum Sie bei FireHydrant waren. Unser Leitfaden zu PagerDuty-Alternativen zeigt das Gesamtbild.
5. Grafana Cloud IRM: am besten, wenn Ihre Alarme schon aus Grafana kommen
Ideal für
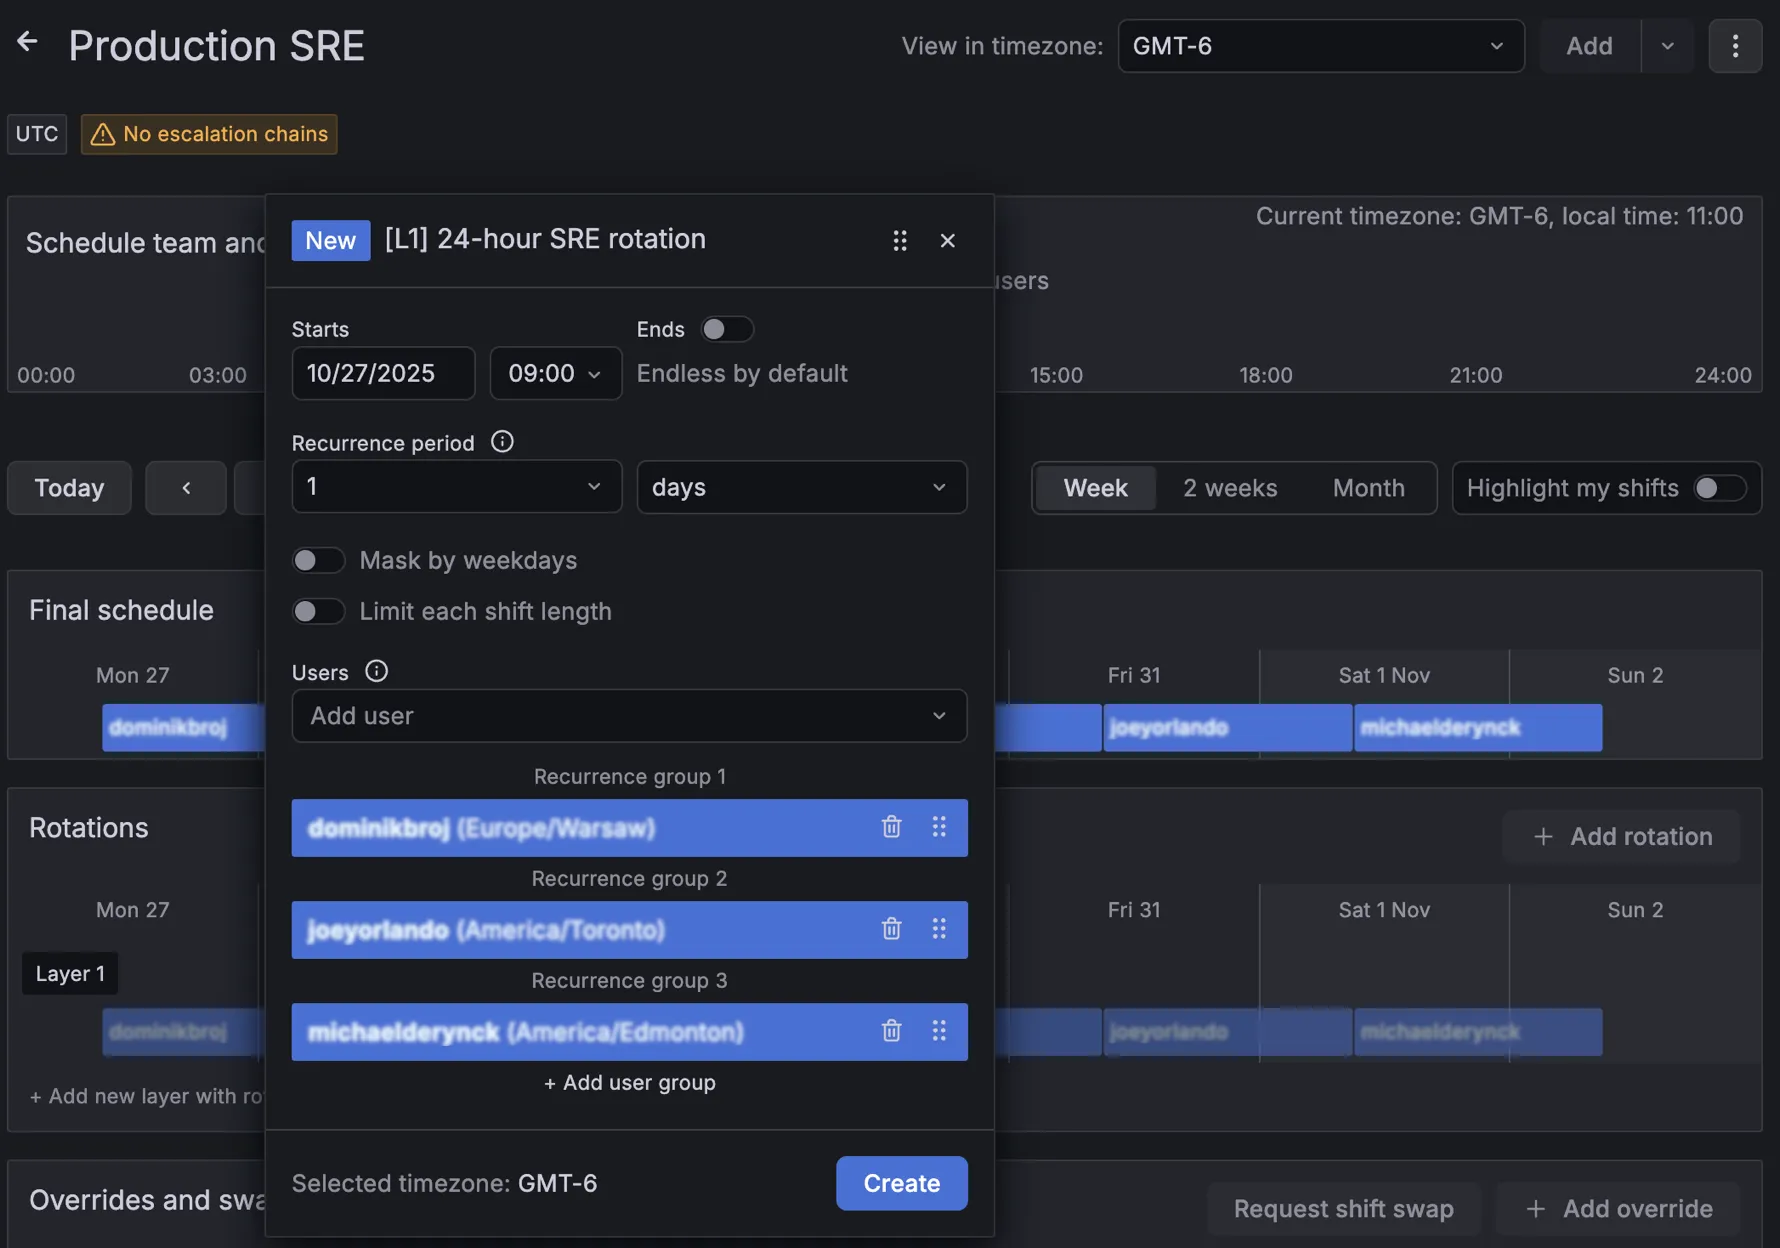
SRE-Teams, die für Grafana Cloud zahlen, ihre Alarmregeln in Grafana Alerting schreiben und wollen, dass der Alarm den Dashboard-Link und den Messwert mitbringt, ohne Webhook dazwischen. Der verwaltete Nachfolger von Grafana OnCall, das im April 2025 mit Grafana Incident zusammengelegt wurde.
Wichtige Funktionen
- Natives Alarm-Routing aus Grafana Alerting, mit Eskalationsketten, Bereitschaftsplänen, Schichten und Routen.
- ChatOps in Slack und Teams zum Quittieren, Eskalieren und Ausrufen von Incidents.
- Incident-Management in derselben App, mit Zeitleisten und Nachbetrachtung.
- Mobile App mit Push, SMS und Anruf.
- Terraform-Provider und API, dazu ein Migrationstool für Teams, die von OnCall OSS kommen.
Warum Grafana Cloud IRM statt FireHydrant
Kein Webhook zwischen Alarmregel und Alarmierung. Liegt die Alarmregel bereits in Grafana, sieht IRM sie nativ. FireHydrant Signals empfängt denselben Alarm per Webhook und verliert unterwegs den Dashboard-Kontext.
Günstiger für eine kleine Rotation. Die Plattformgebühr beträgt 19 $/Monat mit 3 enthaltenen aktiven IRM-Nutzern, danach 20 $ pro zusätzlichem aktivem Nutzer. Eine Rotation mit 10 Personen kostet 159 $/Monat, gegenüber 250 $/Monat auf FireHydrant Pro.
Ein Anbieter für Observability und Alarmierung. Für ein Team, das Grafana schon für Metriken, Logs und Traces bezahlt, ist IRM eine weitere Zeile auf einer bestehenden Rechnung statt einer neuen Anbieterprüfung.
Wo Grafana Cloud IRM Schwächen hat
„Aktiver Nutzer“ ist weit gefasst. Jede Person, die im Laufe des Monats in einem Bereitschaftsplan oder einer Eskalationskette steht, zählt, ob sie alarmiert wurde oder nicht. Eine Rotation mit 20 Personen kostet 359 $/Monat, und der Preisvorteil gegenüber FireHydrant schrumpft.
Nichts außerhalb von Grafana. Keine Uptime-Checks, keine öffentliche Statusseite, und Alarme aus anderen Quellen kommen wie überall sonst per Webhook. Ist Grafana nicht Ihre Alarmquelle, fällt der Grund für IRM weg.
Keine Runbooks und ein schlankerer Lebenszyklus. Das Incident-Management von IRM ist leichter als Runbooks, Servicekatalog und Retrospektiven-Vorlagen von FireHydrant.
Der OSS-Weg ist versperrt. Grafana OnCall OSS wurde im März 2026 archiviert, und sein Relay für SMS und Push wurde abgeschaltet. IRM gibt es nur noch als Cloud-Produkt. Unser Leitfaden zu Grafana-OnCall-Alternativen behandelt diese Migration.
Preise
Laut Preisseite von Grafana:
- Free: bis zu 3 aktive IRM-Nutzer pro Monat
- Pro: 19 $/Monat Plattformgebühr inklusive 3 aktiver IRM-Nutzer, danach 20 $ pro zusätzlichem aktivem IRM-Nutzer, mit Mengenrabatten
- Enterprise: ab einer jährlichen Zusage von 25.000 $
Eine Rotation mit 20 Personen kostet auf Pro 359 $/Monat.
Grafana Cloud IRM ist die richtige Wahl, wenn
Grafana Alerting bereits die Quelle jedes Alarms ist und Sie keine Anforderung haben, selbst zu hosten. Lassen Sie es aus, wenn Ihre Alarme von anderswo kommen, wenn Sie eine Statusseite brauchen oder wenn Sie nicht mehr jeden Entwickler in der Rotation mitzählen wollen.
6. GoAlert: am besten für Open-Source-Bereitschaftsplanung zum Selbsthosten
Ideal für
Teams, die ihre Bereitschaftsplanung aus Gründen der Datenresidenz oder interner Richtlinien auf eigenen Servern halten müssen und jemanden haben, der einen weiteren Dienst betreibt. Das einzige Open-Source-Projekt, das die Kernaufgabe von FireHydrant Signals abdeckt: Bereitschaftspläne, Rotationen und Eskalationsrichtlinien mit echter Alarmierung.
Wichtige Funktionen
- Bereitschaftspläne, Rotationen und temporäre Vertretungen mit Kalenderabonnements.
- Eskalationsrichtlinien mit wiederholten Stufen.
- Integrationen für Alertmanager, Grafana, generische Webhooks und E-Mail für eingehende Alarme.
- SMS und Anrufe über Ihr eigenes Twilio-Konto, dazu Benachrichtigungen in Slack-Kanälen.
- Ein einziges Go-Binary auf PostgreSQL, gepflegt von Target unter der Apache-2.0-Lizenz.
Warum GoAlert statt FireHydrant
Ihre Daten bleiben in Ihrer Infrastruktur. Kein Anbieter sieht Ihre Alarm-Payloads, Ihre Bereitschaftspläne oder die Telefonnummern Ihrer Responder. Für ein reguliertes Team, das FireHydrant nur mühsam durch eine Prüfung zur Datenresidenz bekam, ist die Diskussion damit beendet.
Null Lizenzkosten. Ein Team mit 20 Personen zahlt für einen kleinen Server, eine Postgres-Instanz und die Twilio-Nutzung. Gemessen an den 500 $/Monat von FireHydrant Pro finanziert das viele Entwicklerstunden für den Betrieb.
Schlanker als die Alternativen. Ein Binary und eine Datenbank. Grafana OnCall OSS brauchte Django, Celery, Redis und MySQL.
Wo GoAlert Schwächen hat
Release-Rhythmus. Das letzte Release, v0.34.1, stammt von Oktober 2024, nach v0.34.0 im August 2024 und v0.33.0 im November 2023. Das Projekt lebt, aber langsam. Lesen Sie das Commit-Log, bevor Sie Ihre Alarmierung darauf setzen.
Keine mobile App. Alarme kommen per SMS, Anruf, E-Mail oder Slack.
Kein Incident-Management, keine Runbooks, keine Statusseite. GoAlert ersetzt Signals, nicht FireHydrant. Incidents koordinieren und mit Kunden kommunizieren Sie weiterhin anderswo.
Sie haben Rufbereitschaft für das On-Call-Tool. Fällt GoAlert um 3 Uhr nachts aus, alarmiert Sie niemand darüber. Überwachen Sie es von außen, mit Hyperping oder irgendetwas anderem, das außerhalb Ihrer Infrastruktur läuft.
Preise
Kostenlos. Sie zahlen für einen Server, PostgreSQL und die Twilio-Nutzung.
GoAlert ist die richtige Wahl, wenn
Selbsthosten eine harte Anforderung ist und Slack plus Twilio als Kanäle reichen. Lautet die Anforderung „Open Source“ statt „selbst gehostet“, wägen Sie ab, ob ein langsam entwickeltes Projekt besser ist als ein verwaltetes Tool, das Sie innerhalb eines Monats verlassen können.
Direkte Vergleiche
incident.io vs FireHydrant: Was passt für Slack-native Reaktion?
incident.io wickelt den gesamten Incident in Slack oder Teams ab, mit klaren Vorgaben, und KI-Post-Mortems gibt es im Pro-Plan. FireHydrant hält den Incident in seiner eigenen Web-App, setzt auf Runbooks pro Service und einen Servicekatalog und stellt KI hinter Enterprise. Beim Preis treffen sie sich in der Mitte: Ein Team mit 20 Personen zahlt 500 $/Monat, ob auf FireHydrant Pro oder auf incident.io Team mit Rufbereitschaft. Nehmen Sie incident.io, wenn die Akzeptanz im ganzen Unternehmen das Ziel ist und der Rückstau bei Post-Mortems das Problem. Nehmen Sie FireHydrant, wenn Sie dokumentierte Runbooks haben, eine SRE-Funktion, die den Prozess verantwortet, und lieber ein Tool, das Ihnen keinen vorschreibt.
FireHydrant vs Rootly: Was passt für Rufbereitschaft und Automatisierung?
Rootly verkauft On-Call Essentials einzeln für 20 $ pro Nutzer und Monat, mit Shadow-Rotationen, Urlaubsverwaltung und Lückenerkennung. FireHydrant bündelt Signals in den Pro-Plan für 25 $ pro Responder und hat die tiefere Runbook-Engine. Der Workflow-Builder von Rootly reicht weiter in Jira, GitHub und Zoom hinein; die Runbooks von FireHydrant laufen im Fall „jeder SEV1 läuft genau so ab“ verlässlicher. Rootly hat auf PeerSpot fünfmal so viel Mindshare, was sich bei Einstellungen und bei Integrationspartnern bemerkbar macht. Nehmen Sie Rootly für Automatisierungsreichweite und ein eigenständiges On-Call-Modul. Nehmen Sie FireHydrant für Runbook-Disziplin.
Hyperping vs FireHydrant: Brauche ich eine Lebenszyklus-Plattform?
Zählen Sie die Incidents des letzten Quartals. Brauchten weniger als fünf pro Monat mehr als eine Person und einen Kanal, haben Sie für Koordination gezahlt, die Sie nicht genutzt haben. Hyperping deckt Erkennung, Alarmierung, Eskalation und Statusseite für etwa 149 $/Monat bei 20 Plätzen und jährlicher Abrechnung ab und nimmt keine Alertmanager-Webhooks an. FireHydrant deckt Alarmierung, Koordination und Runbooks für 500 $/Monat bei gleicher Größe ab und prüft nicht, ob Ihre Seite erreichbar ist. Die meisten Teams unter 30 Entwicklern brauchen die erste Liste.
Grafana Cloud IRM vs FireHydrant: Was passt für ein Grafana-Team?
Liegt jede Alarmregel in Grafana Alerting, alarmiert IRM mit angehängtem Dashboard und kostet 159 $/Monat für eine Rotation mit 10 Personen. FireHydrant empfängt denselben Alarm per Webhook, verliert den Kontext und kostet 250 $/Monat. Ab 20 Personen wird der Abstand kleiner, und Runbooks und Statusseiten von FireHydrant fallen stärker ins Gewicht. Nehmen Sie IRM, wenn Grafana die Alarmquelle ist und Sie einen einzigen Anbieter wollen. Nehmen Sie FireHydrant, wenn Alarme aus mehreren Quellen kommen oder wenn die Lebenszyklus-Funktionen der Grund für Ihre Suche sind.
PagerDuty vs FireHydrant: Was passt für große Unternehmen?
PagerDuty hat die Routing-Engine, die 750+ Integrationen und die Sicherheit im Einkauf. FireHydrant hat Runbooks, einen Servicekatalog und mit Signals ein Produkt, das PagerDuty-Kunden nach eigener Aussage im Schnitt 50 % spart. Für eine Organisation mit mehr als 200 Entwicklern und ServiceNow im Prozess: PagerDuty. Für eine, die entschieden hat, dass der Reaktionsprozess das ist, was verbessert werden muss, und mit einer Grenze von 5 Integrationen in Pro oder einem Enterprise-Angebot leben kann: FireHydrant. Viele betreiben während eines mehrjährigen Übergangs beide.
Entscheidungshilfe
Nach Teamgröße:
- Allein oder kleines Team (1 bis 10): Hyperping, oder GoAlert, wenn selbst gehostet werden muss.
- Mittelgroß (10 bis 50): Hyperping für Monitoring plus Rufbereitschaft plus Statusseite, incident.io, wenn die Reaktion in Slack stattfindet, Grafana Cloud IRM, wenn Grafana die Alarmquelle ist.
- Groß (50 bis 200): incident.io oder Rootly für eine Reaktion direkt im Chat, PagerDuty, wenn die Komplexität der Bereitschaftspläne überwiegt.
- Enterprise (200+): PagerDuty, Rootly Enterprise oder FireHydrant Enterprise selbst.
Nach Herkunft der Alarme:
- Uptime-, SSL- und Cron-Checks: Hyperping, und den separaten Monitor abschaffen.
- Grafana Alerting: Grafana Cloud IRM.
- Alertmanager, Datadog oder eine Mischung: incident.io, Rootly, PagerDuty oder GoAlert.
Nach Arbeitsweise:
- Slack-nativ, klare Vorgaben: incident.io.
- Slack-nativ, tiefe Workflow-Automatisierung: Rootly.
- Web-App zuerst, komplexes Routing: PagerDuty.
- Runbooks und Servicekatalog im Mittelpunkt: bei FireHydrant bleiben.
- Selbst gehostet: GoAlert.
Nach Budget (Team mit 20 Personen, jährliche Abrechnung):
- Unter 200 $/Monat: Hyperping Pro (etwa 149 $/Monat).
- 200 $ bis 400 $/Monat: Grafana Cloud IRM (359 $/Monat), Rootly On-Call Essentials (400 $/Monat), incident.io On-call (400 $/Monat).
- 400 $ bis 600 $/Monat: PagerDuty Professional (420 $/Monat), incident.io Team mit Rufbereitschaft (500 $/Monat), FireHydrant Pro (500 $/Monat).
- Ab 800 $/Monat: die Plattform-Stufe Essential von PagerDuty (1.000 $/Monat, 12.000 $ im Voraus abgerechnet), Rootly mit beiden Modulen (800 $/Monat), FireHydrant Enterprise.
Die vollständige Liste der FireHydrant-Alternativen, die ich betrachtet habe
Die Preise entsprechen den Angaben auf den Websites der Anbieter im September 2026 und variieren je nach Nutzung und Teamgröße.
| Name | Preis (ca. 2026) | Größte Stärke | Größte Schwäche |
|---|---|---|---|
| Hyperping | Free; Essentials 24 €/Monat; Pro 74 €/Monat; Business 249 €/Monat, Plätze inklusive | Monitoring, Rufbereitschaft und Statusseiten in einem Festpreis-Plan | Keine eingehenden Alertmanager-Webhooks; keine Runbooks |
| incident.io | Team 15 $ pro Nutzer und Monat + 10 $ On-Call; Pro 25 $ + 20 $; nur On-call 20 $ | Slack-nativer Lebenszyklus, KI-Post-Mortems in Pro | Zwei Abrechnungsposten addieren sich; von Slack abhängig |
| Rootly | On-Call 20 $ pro Nutzer und Monat; Incident Response 20 $ pro Nutzer und Monat | Workflow-Reichweite, Shadow-Rotationen, urlaubsbewusste Bereitschaftspläne | Zwei Module verdoppeln die Rechnung; keine kostenlose Stufe |
| PagerDuty | Professional 21 $ pro Nutzer und Monat; Plattform ab 2.800 $/Jahr mit AIOps | Routing-Tiefe, 750+ Integrationen, Sicherheit im Einkauf | Kosten; der Incident lebt in der Web-App |
| Grafana Cloud IRM | 19 $/Monat Plattform + 20 $ pro aktivem IRM-Nutzer; kostenlos bis 3 Nutzer | Nativer Kontext aus Grafana Alerting | Nichts außerhalb von Grafana; jedes Rotationsmitglied zählt |
| GoAlert | Kostenlos, selbst gehostet | Bereitschaftspläne, Eskalationen und Alarmierung über Twilio auf Ihren Servern | Letztes Release Oktober 2024; keine Incident-Ebene |
| FireHydrant (zum Vergleich) | Kostenlos bis 10 Responder; Pro 25 $ pro Responder und Monat; Enterprise individuell | Runbooks, Servicekatalog, Signals inklusive | KI und Analysen nur in Enterprise; SMS und Anrufe extra |
| Better Stack | Free; bezahlt ab 29 $/Monat plus Add-ons pro Responder und pro Statusseite | Monitoring, Logs und Incidents in einer ausgefeilten Oberfläche | Add-ons treiben die Rechnung nach oben |
| Squadcast (SolarWinds) | Kein kostenloser Plan; Pro 15 $ pro Nutzer und Monat; Premium 24 $ pro Nutzer und Monat (jährlich) | Günstigste glaubwürdige Rufbereitschaft mit SLO-Tracking | Roadmap nach der Übernahme unklar |
| Opsgenie (Atlassian) | In JSM enthalten | Jira-Integration | Wird im April 2027 eingestellt |
| Blameless | Vertrieb kontaktieren | Post-Mortems nach SRE-Praxis | Intransparente Preise; Dynamik hat nachgelassen |
| xMatters | Ab ~9 $ pro Nutzer und Monat; kostenlos bis 10 Nutzer | Analysen und komplexe Workflows | Veraltete Oberfläche |
| Zenduty (Xurrent IMR) | Kostenlos, dann ~5 $ pro Nutzer und Monat; bis 21 $ für Enterprise | Günstige KI-gestützte Ursachenanalyse und Post-Mortems | Weniger bekannte Marke |
| iLert | Kostenlos (eingeschränkt); Pro ~19 € pro Nutzer und Monat | In der EU gehostet, Statusseiten inklusive | Regionaler Fokus |
| Splunk On-Call (VictorOps) | Vertrieb kontaktieren | Enge Splunk-Integration | Alternde Oberfläche; eigenständig schwach |
| Jira Service Management | Kostenlos (eingeschränkt); Standard ~20 $ pro Agent und Monat; Premium ~49 $ | Atlassian-natives ITSM | Ticket zuerst, keine Reaktion in Echtzeit |
| ServiceNow | Individuell, oft 100+ $ pro Nutzer und Monat | Komplette ITSM-Suite | Lange Implementierung |
| Freshservice | Ab ~19 $ pro Agent und Monat | Benutzerfreundliches Cloud-ITSM | Auf Helpdesk ausgerichtet |
| OneUptime | Open Source; Cloud nach Nutzung | Monitoring, Statusseiten und Rufbereitschaft, selbst hostbar | Aufwendig im Betrieb; kleinere Community |
| Keep | Open Source | Alarmbündelung und Deduplizierung | Kein Tool für Bereitschaftsplanung |
| PagerTree | Ab ~10 $ pro Nutzer und Monat | Einfaches Alarm-Routing | Dünner Lebenszyklus |
| Spike.sh | Ab ~5 $/Monat | Günstige Alarmierung | Grundlegende Funktionen |
| All Quiet | Ab ~5 $ pro Nutzer und Monat | Günstige Rufbereitschaft | Neu am Markt |
| OnPage | ~12 $ pro Nutzer und Monat | Sichere Alarmierung für regulierte Branchen | Nische |
| BigPanda | Vertrieb kontaktieren | AIOps-Korrelation | Kein vollständiges Lebenszyklus-Tool |
| BMC Helix | Vertrieb kontaktieren | Enterprise-ITSM | Teuer und komplex |
Häufige Fehler beim Wechsel weg von FireHydrant
Ein paar Muster aus den Threads und aus Gesprächen mit Teams:
- Die Runbooks durch nichts ersetzen. Hat sich Ihr Team bei einem SEV1 auf die Runbooks von FireHydrant verlassen, um zu wissen, was zu tun ist, landen diese Schritte beim Wechsel zu einem reinen Alarmierungstool (Hyperping, GoAlert, PagerDuty Professional) in einem Wiki. Schreiben Sie sie vor dem Wechsel auf, nicht nach dem ersten Incident ohne sie.
- Nur den Preis pro Nutzer zählen. FireHydrant Pro für 25 $ wirkt nah an incident.io Team für 15 $, bis Sie den On-Call-Aufschlag von incident.io dazurechnen. Und der Pro-Plan von Hyperping für 74 €/Monat wirkt klein, bis Sie 10 Plätze zu je 9 € dazurechnen. Rechnen Sie das ganze Team durch, im Plan, den Sie tatsächlich nutzen, mit dem Abrechnungszeitraum, den Sie tatsächlich wählen.
- SMS und Anrufe vergessen. FireHydrant Pro verkauft sie separat, Grafana Cloud IRM enthält sie, Hyperping enthält pro Plan ein monatliches SMS-Kontingent, GoAlert rechnet über Ihr eigenes Twilio-Konto ab. Egal, welches Tool Sie wählen: Lösen Sie vor der Umstellung über jeden Kanal einen Testalarm aus.
- Den Alertmanager-Pfad verlieren. Kommen einige Ihrer Alarme aus Prometheus-Regeln, stellen Sie sicher, dass das neue Tool den Webhook annimmt. Hyperping tut das nicht; incident.io, Rootly, PagerDuty, Grafana Cloud IRM und GoAlert schon.
- An einem Tag umstellen. Betreiben Sie beide Tools zwei Wochen lang parallel. Die Threads auf r/sre sind voll von Geschichten nach dem Muster „die Demo war großartig, der Alltag weniger“, und der Parallelbetrieb ist der einzige Weg, das herauszufinden, bevor es darauf ankommt.
So nutzen Sie Hyperping für die Bereitschaftsplanung
Mit dem folgenden Ablauf verlagert ein Team seine Bereitschaftsrotation in etwa zwei Wochen weg von FireHydrant Signals, den Großteil davon im Parallelbetrieb.
1. Die Monitore anlegen, die Sie alarmieren
Legen Sie einen Monitor pro Endpunkt an, der FireHydrant bisher per Webhook erreicht hat: HTTP-Checks mit Prüfung von Statuscode und Schlüsselwörtern, SSL-Ablauf, Cron-Heartbeats für geplante Jobs und Playwright-Browser-Checks für Login- und Checkout-Flows. Wählen Sie das Prüfintervall (30 Sekunden bei Essentials und Pro) und die Regionen. Aktivieren Sie gruppierte Alarme, damit ein gemeinsamer Ausfall nur einmal alarmiert.
2. Den Bereitschaftsplan aufbauen
Öffnen Sie On-Call in der Seitenleiste und legen Sie pro Team einen Plan an. Fügen Sie eine Rotation mit ihren Mitgliedern, der Übergabezeit und der Zeitzone hinzu und vergleichen Sie die Kalendervorschau mit der FireHydrant-Rotation, die Sie ersetzen. Vertretungen liegen auf der Rotation, ein getauschter Dienst heißt also nicht, den Plan neu aufzubauen.
3. Die Eskalationsrichtlinie schreiben
Legen Sie eine Eskalationsrichtlinie mit geordneten Stufen an: Slack oder Teams nach 0 Minuten, SMS an den Bereitschaftsplan nach 5 Minuten, ein Anruf an den Plan und die Teamleitung nach weiteren 10. Weisen Sie die Richtlinie den Monitoren aus Schritt 1 zu.
4. Benachrichtigungskanäle verbinden
Fügen Sie die Integration für Slack oder Teams hinzu und bitten Sie dann jeden Responder, in seinem Profil eine Telefonnummer einzutragen und zu verifizieren. Bleibt ein Teil der Organisation während des Übergangs bei PagerDuty oder Opsgenie, fügen Sie die Integration für PagerDuty oder Opsgenie hinzu, damit Hyperping-Incidents auch dort ankommen.
5. Die Statusseite veröffentlichen
Legen Sie eine Statusseite an, hängen Sie die Monitore an und stellen Sie sie unter Ihre eigene Domain. Aktivieren Sie Abonnenten, damit Kunden das Update per E-Mail bekommen, statt beim Support nachzufragen. Ist die Seite für den internen Gebrauch, schützen Sie sie in Pro mit einem Passwort oder mit E-Mail-Zugangscodes.
6. Beide Tools parallel betreiben und umstellen
Lassen Sie FireHydrant Signals zwei Wochen lang weiter alarmieren, während Hyperping parallel läuft. Vergleichen Sie die Zeit bis zur ersten Benachrichtigung und die Zeit bis zur Quittierung, lösen Sie einen Test-Incident durch jede Eskalationsstufe aus, deaktivieren Sie dann die Eskalationsrichtlinien in FireHydrant und richten Sie die Runbooks auf Hyperping aus.
Fazit
Es gibt nicht die eine beste FireHydrant-Alternative, nur das beste Tool für die Ebene, die FireHydrant für Sie abgedeckt hat.
- Für Monitoring, Rufbereitschaft und Statusseiten in einem Festpreis-Plan: Hyperping.
- Für eine Slack-native Reaktion mit integrierter Rufbereitschaft und KI-Post-Mortems zu einem veröffentlichten Preis: incident.io.
- Für tiefere Workflow-Automatisierung und ein eigenständiges On-Call-Modul mit Shadow-Rotationen und Urlaubsverwaltung: Rootly.
- Für Enterprise-Routing, 750+ Integrationen und Sicherheit im Einkauf: PagerDuty.
- Für eine Rotation, deren Alarme schon aus Grafana kommen: Grafana Cloud IRM.
- Für Open-Source-Bereitschaftsplanung zum Selbsthosten: GoAlert.
Wenn Sie ein Monitoring wollen, das Probleme in 30 Sekunden erkennt, Bereitschaftspläne mit Eskalationsrichtlinien und eine Statusseite, die Ihre Kunden tatsächlich aufrufen, in einem Plan, der nicht für jede Neueinstellung einen neuen Posten aufmacht, dann testen Sie Hyperping kostenlos.
Weiterlesen
- Die besten incident.io-Alternativen: wenn incident.io der andere Name auf Ihrer Shortlist ist
- Die besten Rootly-Alternativen: dieselbe Evaluierung aus Sicht von Rootly
- Grafana-OnCall-Alternativen: was bei OnCall OSS eingestellt wurde und wohin es geht
- Die besten PagerDuty-Alternativen: wenn PagerDuty aus Einkaufsgründen auf der Liste steht
- Die 10 besten Tools für Bereitschaftsplanung: die Kategorie im Überblick
- Bereitschaftsplanung für kleine Teams: wenn Ihre Rotation aus 2 oder 3 Personen besteht
- Preise von Hyperping
Weiter vergleichen: Hyperping vs incident.io · Hyperping vs PagerDuty · Preise von Hyperping · Alle Vergleiche
Häufige Fragen
Was ist die beste FireHydrant-Alternative für die Bereitschaftsplanung? ▼
Für ein Team, dessen Alarme größtenteils aus Uptime-Checks kommen: Hyperping, mit Bereitschaftsplänen, Eskalationsrichtlinien, Monitoring und Statusseiten in einem Festpreis-Plan ab 24 €/Monat. Für eine Slack-native Incident-Reaktion mit integrierter Rufbereitschaft: incident.io. Für tiefere Workflow-Automatisierung und ein Rotationsmodell mit Shadow-Schichten und Urlaubsverwaltung: Rootly. Für Enterprise-Routing mit 750+ Integrationen: PagerDuty. Für Alarme, die schon aus Grafana kommen: Grafana Cloud IRM. Für einen selbst gehosteten Open-Source-Pager: GoAlert.
Was ist der beste Ersatz für FireHydrant bei der Bereitschaftsplanung? ▼
Das hängt davon ab, woher Ihre Alarme kommen. Lautet die Meldung meistens „die Seite ist down“, ersetzt Hyperping Check, Pager und Statusseite auf einmal, und ein Team mit 20 Personen zahlt bei jährlicher Abrechnung etwa 149 €/Monat. Kommen Ihre Alarme aus Prometheus, Datadog oder Grafana und brauchen Sie einen Pager, der Webhooks annimmt, sind Rootly On-Call Essentials (20 $ pro Nutzer und Monat) oder incident.io On-call (20 $ pro Nutzer und Monat) der direkte Ersatz für FireHydrant Signals. Beide nehmen diese Webhooks an.
incident.io vs FireHydrant: Was ist besser? ▼
incident.io wickelt den gesamten Incident in Slack oder Microsoft Teams ab, mit klaren Vorgaben, und die KI-Post-Mortems gibt es im Pro-Plan. FireHydrant hält den Incident in seiner eigenen Web-App, setzt auf Runbooks pro Service und einen Servicekatalog und behält KI-Zusammenfassungen, Retrospektiven und Analysen dem Enterprise-Plan vor. Teams, die schnelle Einführung und eine Reaktion direkt im Chat wollen, nehmen incident.io. Teams mit dokumentierten Runbooks und einer SRE-Funktion, die den Prozess verantwortet, nehmen FireHydrant.
FireHydrant vs Rootly: Was ist der Unterschied? ▼
Rootly ist Slack-nativ und verkauft On-Call und Incident Response als zwei Module zu je 20 $ pro Nutzer und Monat, mit Planungsfunktionen, die FireHydrant fehlen, etwa Shadow-Rotationen, Urlaubsverwaltung und Erkennung von Lücken im Plan. FireHydrant bündelt die Rufbereitschaft (Signals) in seinen Pro-Plan für 25 $ pro Responder und Monat und stellt Runbooks und einen Servicekatalog in den Vordergrund. Rootly hat mehr Mindshare (8,5 % gegenüber 1,6 % auf PeerSpot im Dezember 2025), FireHydrant die tiefere Runbook-Engine.
Was kostet FireHydrant? ▼
Laut firehydrant.com im September 2026: Free für bis zu 10 Responder mit 2 Runbooks, 1 öffentlichen Statusseite und 3 Integrationen; Pro für 25 $ pro Responder und Monat bei jährlicher Abrechnung, inklusive Signals für Rufbereitschaft und Alarmierung, aber SMS- und Sprachbenachrichtigungen werden separat verkauft; Enterprise mit individuellem Preis, und genau dort liegen KI-Funktionen, private Statusseiten, Alarmgruppierung, Incident-Analysen und Audit-Logs. Ein Team mit 20 Personen zahlt auf Pro 500 $/Monat, vor SMS und Sprache.
Gibt es eine Open-Source-Alternative zu FireHydrant? ▼
Für die Ebene der Rufbereitschaft GoAlert, gepflegt von Target unter der Apache-2.0-Lizenz: Bereitschaftspläne, Rotationen, Eskalationsrichtlinien, Webhooks von Alertmanager und Grafana sowie SMS oder Anrufe über Ihr eigenes Twilio-Konto. Es hat keine Incident-Kanäle, keine Runbooks und keine Statusseite, und das letzte Release stammt von Oktober 2024. Ein Open-Source-Projekt, das den kompletten Incident-Lebenszyklus von FireHydrant ersetzt, gibt es nicht.