Die besten Datadog-Alternativen 2026 sind Hyperping für Uptime, Statusseiten, Rufbereitschaft und Server-Monitoring zum Festpreis, New Relic für APM mit großzügigem Free-Tarif, Dynatrace für KI-gestützte Ursachenanalyse im Enterprise-Umfeld und Better Stack für Monitoring kombiniert mit Logs und Incident Response.
Ich habe mehr als 30 Tools analysiert, Hunderte Bewertungen auf G2 und Capterra gelesen, Muster aus Threads in r/devops und r/sre gesammelt und echte Preise für gängige Teamgrößen verglichen. Die Kurzfassung: Die meisten Teams verlassen Datadog wegen der Kosten, nicht wegen fehlender Funktionen. Welcher Ersatz passt, hängt davon ab, welchen Teil von Datadog Sie tatsächlich nutzen.
In diesem Leitfaden erfahren Sie:
- Welche vier Tools ich empfehle, mit ehrlichen Preisen
- Warum Teams Datadog wirklich verlassen (fast immer wegen der Kosten)
- Einen Preisvergleich für drei Teamgrößen
- Die vollständige Liste der mehr als 30 Datadog-Alternativen, die ich mir angesehen habe
Wenn Sie Uptime-Monitoring, Server-Monitoring, Statusseiten und Rufbereitschaft in einem Tool wollen, zu einem Preis, der nicht mit Ihrem Log-Volumen steigt: Hyperping deckt alle vier ab. Kostenlos testen.
Warum Sie diesem Leitfaden vertrauen können
Ich bin Léo, Gründer von Hyperping. Ich habe also ein eigenes Interesse an einem dieser Tools und sage das im ganzen Artikel offen. Hyperping deckt einen bestimmten Teil des Datadog-Stacks ab: externe Checks, Server-Monitoring, Statusseiten und Rufbereitschaft. Für tiefes APM, Distributed Tracing oder korrelierte Log-Analysen im großen Maßstab sind die anderen Tools in diesem Leitfaden besser geeignet, und das schreibe ich unten auch so.
Für diesen Leitfaden habe ich Produktanalysen zu jedem Tool gelesen, Zitate von G2, TrustRadius und Reddit gesammelt und die Kriterien mit den Threads abgeglichen, in denen Entwickler und SREs ehrlich diskutieren, was funktioniert.
Wo ich ein Tool nicht selbst testen konnte, sage ich das und stütze mich auf verifiziertes Nutzerfeedback.
Die Top-Empfehlungen im Überblick
| Am besten für | Produkt | Einstiegspreis |
|---|---|---|
| Uptime, Server-Monitoring, Statusseiten und Rufbereitschaft in einem Tool | Hyperping | 24 €/Monat |
| APM mit dem großzügigsten Free-Tarif | New Relic | Kostenlos bis 100 GB/Monat, danach 0,40 $/GB |
| KI-gestützte Ursachenanalyse für große Enterprise-Umgebungen | Dynatrace | ca. 58 $/Host/Monat Full-Stack (Host mit 8 GiB), 29 $ nur Infrastruktur |
| Monitoring plus Logs und Incident Response | Better Stack | 29 $/Monat |
Warum Teams Datadog verlassen
In den Reddit-Threads und Bewertungen, die ich gelesen habe, folgen die Beschwerden einem klaren Muster. Die Funktionen sind selten das Problem. Preis und Planbarkeit sind es.
- Ausufernde Rechnungen. Die mit Abstand häufigste Beschwerde. Custom Metrics, Log-Ingestion, indexierte Events, APM-Spans und Host-Anzahl werden jeweils separat abgerechnet und wachsen mit der Nutzung. Nutzer auf r/devops berichten von Rechnungen, die drei- bis zehnmal über dem ursprünglichen Budget liegen. Ein Thread auf r/devops beschreibt das Abrechnungsmodell so, als sei die Überberechnung gewollt.
- Undurchsichtige Abrechnung. Schwer vorherzusagen, noch schwerer zu kontrollieren. Custom Metrics auf einem Kubernetes-Cluster mit Tags hoher Kardinalität können Ihre Rechnung unbemerkt vervielfachen. Viele Teams sagen, sie bräuchten eine eigene Person nur für die Kontrolle der Datadog-Nutzung.
- Support kommt obendrauf. Premier Support wird als Prozentsatz Ihrer monatlichen Ausgaben verkauft, zusätzlich zur Plattformrechnung. Bei großem Volumen tut das weh.
- Vendor-Lock-in. Die Agents und die proprietäre Instrumentierung von Datadog machen einen Wechsel mühsam. Teams, die vor Jahren mit Datadog angefangen haben, nennen das oft als Grund, warum sie sich im Nachhinein ein OpenTelemetry-first-Tool gewünscht hätten.
- Alert Fatigue und Feinjustierung. Das Alerting ist mächtig, aber die Feinjustierung (vor allem bei Logging auf Elasticsearch-Basis) wird in Observability-Threads auf r/devops immer wieder als mühsam beschrieben.
Es gibt auch positive Stimmen. Viele Nutzer halten Datadog nach wie vor für die ausgereifteste All-in-One-Observability-Plattform am Markt. Entwickler auf r/devops nennen Datadog „GOAT“, wenn die Kosten nicht der limitierende Faktor sind. Das Muster ist eindeutig: Teams, die voll auf Datadog setzen und die Nutzung sorgfältig steuern, bleiben zufrieden. Teams, die über 100 Hosts oder hohe Log-Volumen hinauswachsen, suchen nach dem Ausgang.
Was sich die Leute von einem Ersatz wünschen, ungefähr in dieser Reihenfolge:
- Planbare Preise (Festpreis oder transparent pro Host).
- OpenTelemetry-Unterstützung, damit sie nicht wieder in einem Lock-in landen.
- Ausreichend gutes APM und Infrastruktur-Monitoring für ihren Stack.
- Statusseiten und Rufbereitschaft, ohne Statuspage.io und PagerDuty dazukaufen zu müssen.
- Pflegeleichtes Alerting, das nicht ständig nachjustiert werden muss.
Die vier Tools unten erfüllen jeweils mindestens drei dieser Punkte für eine bestimmte Art von Team.
Wie ich diese vier ausgewählt habe
Ausgangspunkt waren die mehr als 30 Tools in der Liste der Alternativen am Ende dieses Leitfadens. Gestrichen habe ich Tools, die bei mindestens einem von drei Kriterien nicht überzeugten:
- Undurchsichtige Preise. Tools, bei denen Sie erst nach einem Vertriebsgespräch eine Zahl bekommen.
- Zu eng. Tools, die nur einen kleinen Teil abdecken und die Lücke von Datadog nicht ausreichend füllen.
- Betriebsaufwand. Tools, die zwar technisch kostenlos sind, deren Betrieb aber echte Engineering-Zeit kostet, außer genau dieser Kompromiss ist der Sinn der Sache (Prometheus, SigNoz, Uptrace).
Übrig blieb eine Shortlist, in der jedes Tool für einen bestimmten Anwendungsfall klar vorne liegt. Gegenüber der vorherigen Version dieses Leitfadens habe ich eine Empfehlung ausgetauscht: AppDynamics fliegt raus, Better Stack kommt rein. AppDynamics hat starkes APM, aber die Preise sind enterprise-typisch intransparent, und das Produkt wirkt eher wie ein Cisco-Bundle als wie ein Observability-Tool von 2026. Better Stack schließt bei KMU und Mittelstand einen größeren Teil derselben Lücke, die Datadog hinterlässt, und das zu transparenten Preisen.
Preise für drei Teamgrößen
Das habe ich für drei typische Teamgrößen berechnet. Alle Beträge sind monatlich, zum Listenpreis bei jährlicher Abrechnung (sofern angeboten), Stand November 2026. Bei Hyperping ist jeder Host im Szenario eingerechnet: Server über die im Plan enthaltenen Agents hinaus kosten 2 $ pro Stück in Essentials und Pro, 1,50 $ in Business.
Startup (5 Entwickler, 20 Hosts, 1 Statusseite):
| Tool | Monatliche Kosten | Enthalten |
|---|---|---|
| Hyperping | 68 $ | Essentials: Monitoring + 20 Server (5 inklusive, 15 zusätzlich) + Rufbereitschaft + 1 Statusseite + 2 zusätzliche Nutzerplätze |
| Better Stack | ca. 170 $ | Monitore + Rufbereitschaft (5 Nutzer) + 1 Statusseite |
| New Relic | Kostenlos | Im Rahmen der kostenlosen 100 GB, 1 Full-Platform-Nutzer, der Rest mit Basic-Nutzerplätzen |
| Dynatrace | ca. 1.160 $ | 58 $/Host x 20 Hosts (Full-Stack, Hosts mit 8 GiB) |
| Datadog | ca. 460 $ | 23 $/Host x 20 Hosts (Enterprise-Tarif) |
SaaS in der Wachstumsphase (10 Entwickler, 100 Hosts, 3 Statusseiten):
| Tool | Monatliche Kosten | Enthalten |
|---|---|---|
| Hyperping | 234 $ | Pro: 250 Monitore + 100 Server (20 inklusive, 80 zusätzlich) + Rufbereitschaft + 3 Statusseiten |
| Better Stack | ca. 368 $ | Monitore + Rufbereitschaft (10 Nutzer) + 3 Statusseiten |
| New Relic | ca. 200 bis 600 $ | Daten-Ingest über die kostenlosen 100 GB hinaus, 1 Full-Platform-Nutzer und 9 Basic-Nutzerplätze |
| Dynatrace | ca. 5.800 $ | Full-Stack für 100 Hosts (58 $/Host) |
| Datadog | ca. 2.300 $+ | Pro Host plus APM plus Log-Ingest |
Enterprise (50 Entwickler, 500 Hosts, 10 Statusseiten):
| Tool | Monatliche Kosten | Enthalten |
|---|---|---|
| Hyperping | 1.209 $ (Business) | 1.000 Monitore + 500 Server (100 inklusive, 400 zusätzlich) + 50 Nutzerplätze (20 inklusive, 30 zusätzlich) + 10 Statusseiten + SAML SSO |
| Better Stack | Individuell | Enterprise-Tarif |
| New Relic | Individuell | Enterprise-Vertrag, verhandelter Pool an Nutzerplätzen plus Ingest |
| Dynatrace | ca. 29.000 $+ | 58 $/Host x 500 Hosts (Listenpreis, vor Mengenrabatten) |
| Datadog | ca. 11.500 $+ | Vor Custom Metrics und Log-Volumen |
Das Muster ist eindeutig. Hyperping ist die planbare Option: ein Planpreis plus ein fester Preis pro Server über die enthaltenen Agents hinaus, ohne Abrechnung pro GB oder pro Metrik. New Relic bleibt günstig, bis Ihr Datenvolumen wächst oder ein zweiter Entwickler einen Full-Platform-Nutzerplatz braucht: 99 $/Nutzer/Monat in Standard (bis zu 5 Nutzer) oder 349 $/Nutzer/Monat in Pro mit Jahresbindung (418,80 $ bei monatlicher Zahlung). Better Stack liegt zwischen transparentem SaaS und modularer Preisgestaltung. Dynatrace und Datadog wachsen linear mit Ihrer Flotte. Für Ihre eigene Anzahl an Servern vergleicht der Kostenrechner für Server-Monitoring Datadog, New Relic, Netdata und Hyperping nach Host-Anzahl.
1. Hyperping: die beste All-in-One-Lösung für SaaS-Teams
Ideal für
Startups, KMU und wachsende SaaS-Teams, die Uptime-Monitoring, Server-Health, Statusseiten und Bereitschaftspläne in einem Tool mit planbaren monatlichen Kosten brauchen.
Wichtige Funktionen
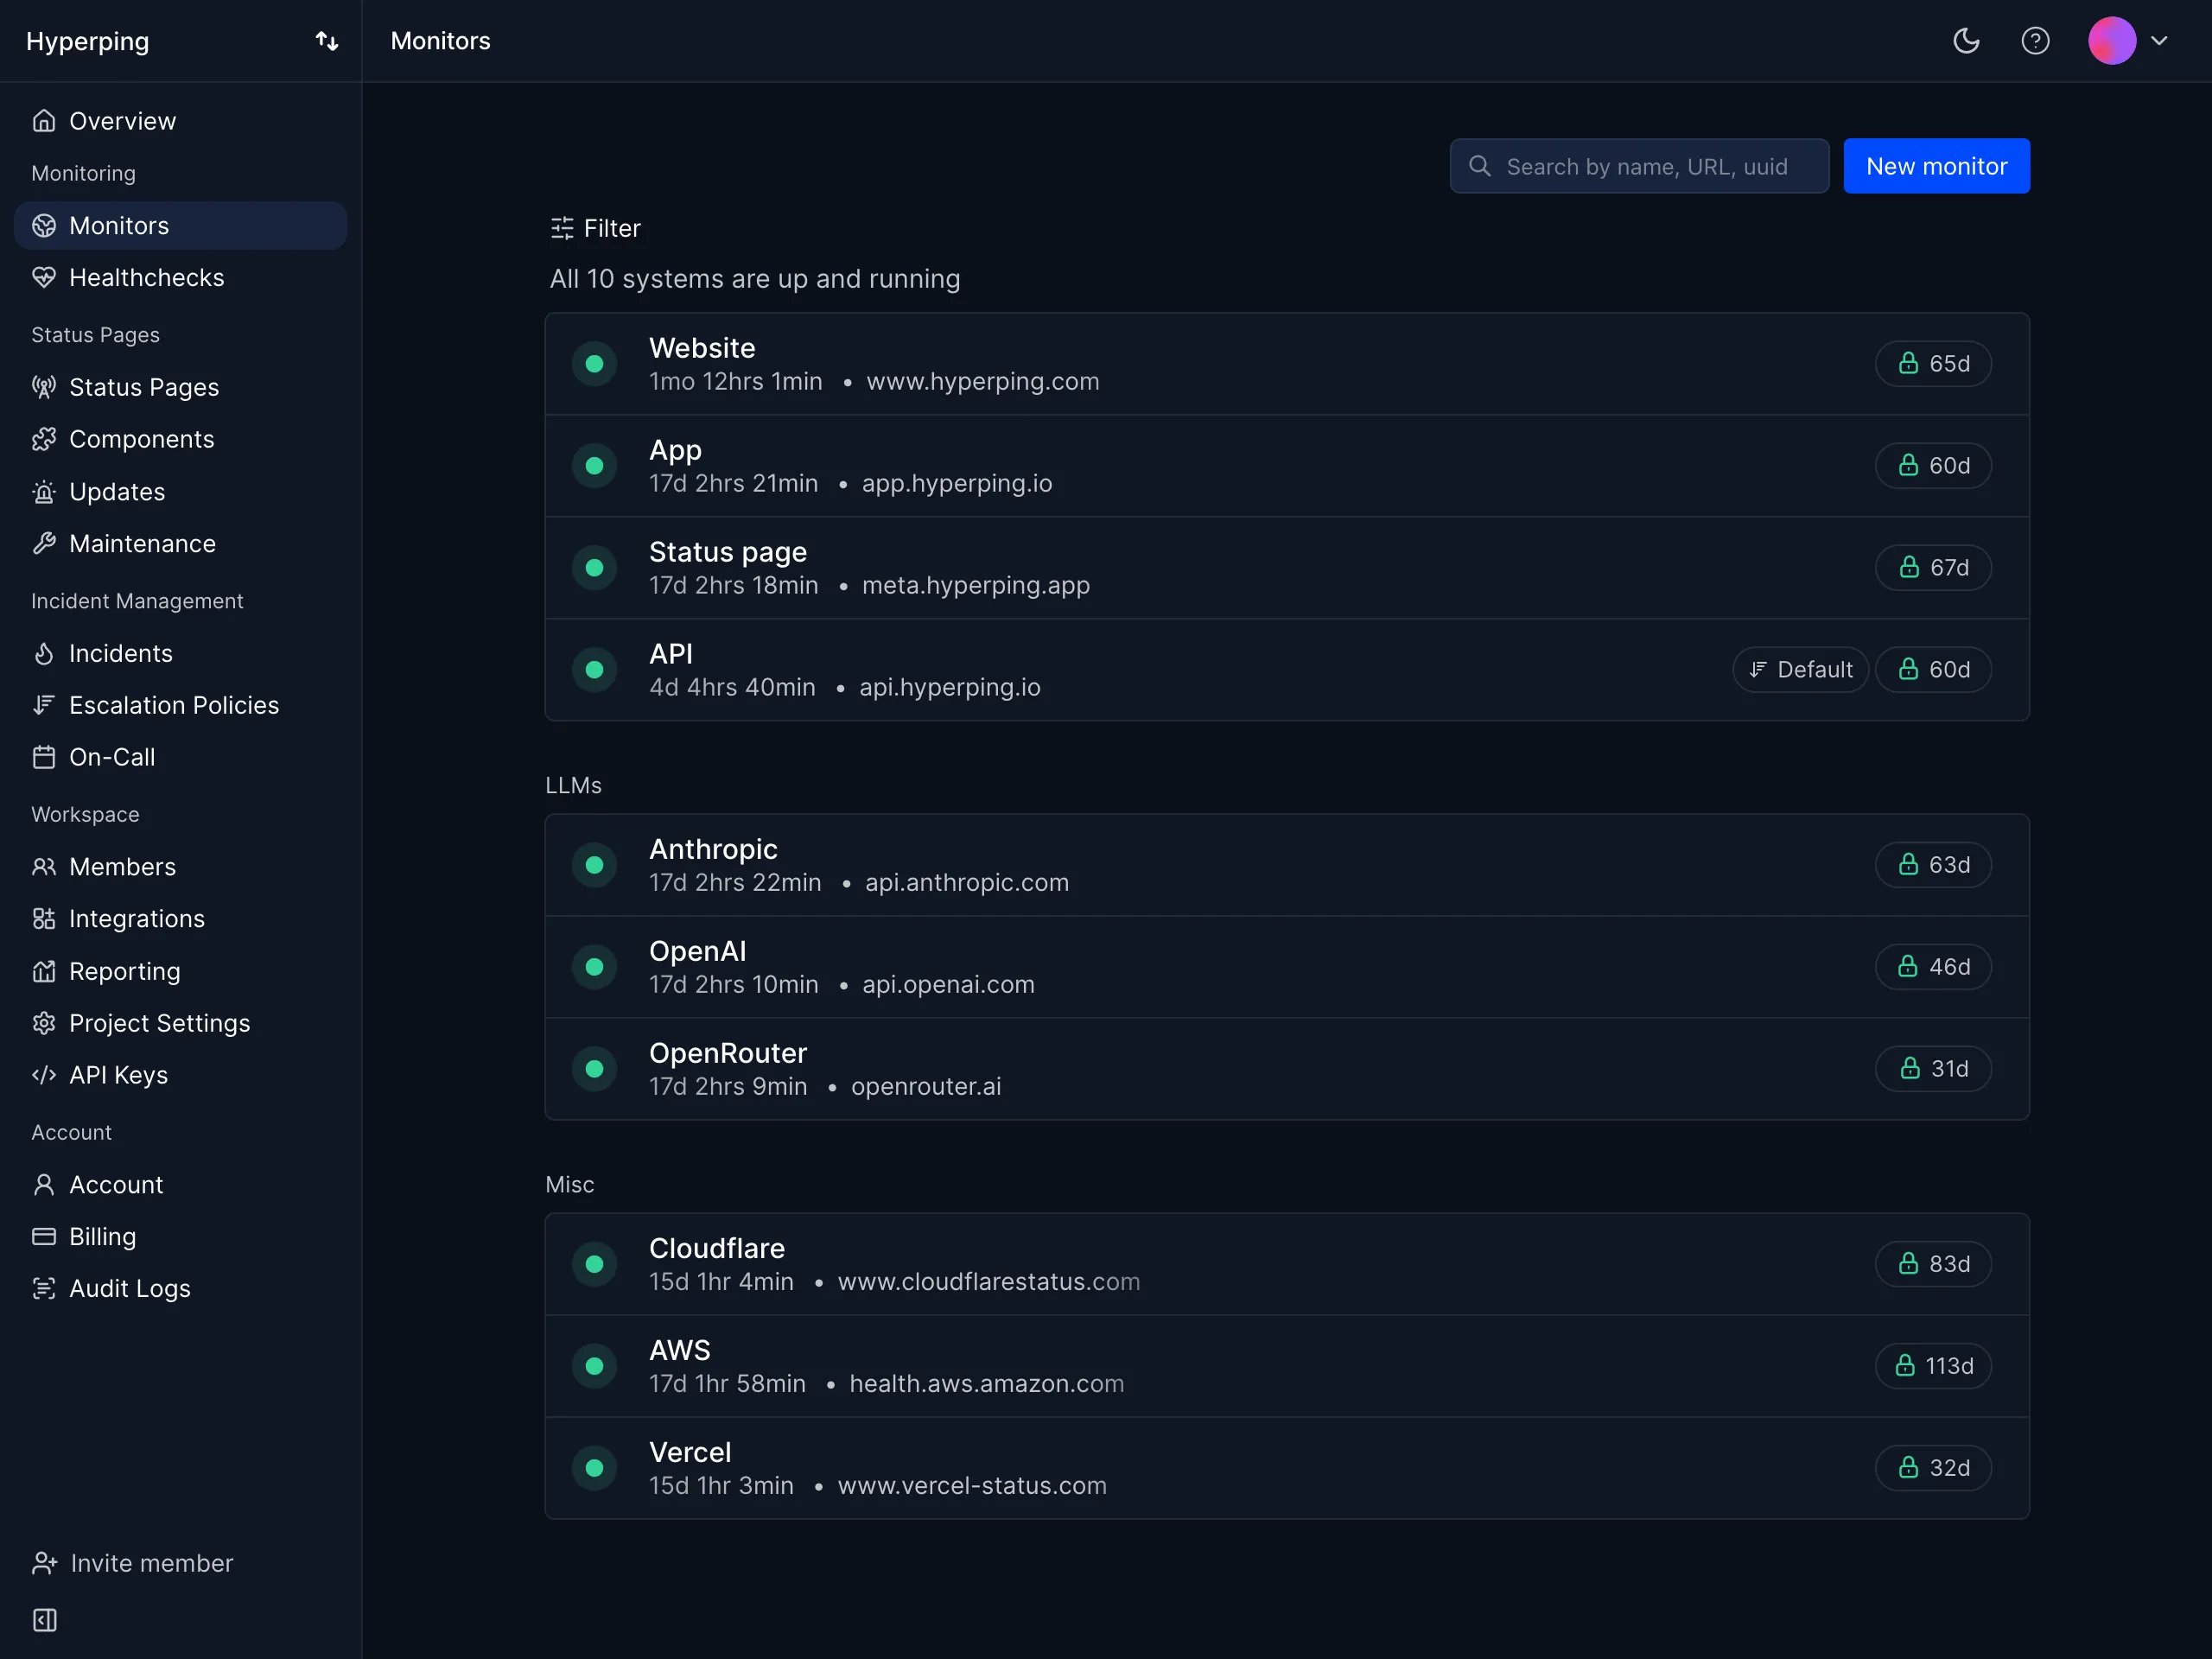
- Externes Monitoring aus 18 Regionen weltweit. Probleme aus der Sicht Ihrer Kunden erkennen, nicht nur innerhalb Ihrer VPC. HTTP-, Port-, Ping-, Keyword- und DNS-Checks im 30-Sekunden-Intervall (20 Sekunden in Business), dazu tägliche Prüfung der SSL-Zertifikate.
- Server-Monitoring mit schlankem Agent. Neu seit 2026. Installation unter Linux (systemd) oder macOS (launchd), danach gehen CPU, Arbeitsspeicher, Dateisystem, Disk-I/O, Netzwerk und Host-Metadaten alle 30 Sekunden an Ihr Dashboard. Basiert auf OpenTelemetry, mit einer Warteschlange auf der Festplatte, damit Metriken auch Ausfälle der Ingestion überstehen.
- Browser-Checks auf Basis von Playwright. End-to-End-Monitoring (synthetisches Monitoring) für Login, Checkout und andere kritische Abläufe.
- Vollwertige Statusseiten inklusive. Öffentliche und private Seiten, eigene HTTPS-Domains, White-Label-Branding, Schutz per SAML SSO, mehrsprachige Seiten, eingebettete Diagramme. 3 Seiten in Pro, 10 in Business, ohne Gebühren pro Seite innerhalb dieser Grenzen.
- Bereitschaftspläne und Eskalationsrichtlinien. Rotationen mit Zeitzonen, automatische Übergaben, mehrstufige Eskalation. Bestätigen und eskalieren direkt aus Slack, Teams oder per SMS.
- Alerting über viele Kanäle. E-Mail, SMS, Anrufe, Slack, Teams, Discord, Telegram, PagerDuty, OpsGenie, Webhooks. Automatische Wiederholung aus anderen Regionen gegen Fehlalarme.
- Hosting in der EU und DSGVO-Konformität. Zertifiziert nach DIN ISO/IEC 27001, Rechenzentren in der EU.
Warum Hyperping
Für Hyperping sprechen zwei Dinge. Erstens planbare Festpreise. Ein Setup mit 100 Monitoren, 20 Servern, 5 Nutzerplätzen und 3 Statusseiten kostet 74 $/Monat im Pro-Plan. Dasselbe Setup mit Datadog plus Statuspage.io plus PagerDuty läge über 1.000 $/Monat, noch bevor Log-Volumen dazukommt. Zweitens drei oder vier Produkte auf einer Rechnung. Monitoring, Server-Agents, Statusseiten und Bereitschaftspläne sind in jedem kostenpflichtigen Plan enthalten.
Der Server-Monitoring-Agent von 2026 schließt für KMU-Teams die wichtigste Lücke, die bisher gegenüber Datadog bestand. Sie führen einen einzigen Befehl auf einem Linux- oder macOS-Host aus, und CPU, Arbeitsspeicher, Dateisystem, Disk-I/O, Netzwerk und Host-Metadaten erscheinen innerhalb von Sekunden im Dashboard. Der Collector bettet OpenTelemetry Host Metrics ein und speichert noch nicht gesendete Batches auf der Festplatte, damit Metriken Neustarts und kurze Netzwerkaussetzer überstehen. Externe HTTP-Checks sagen Ihnen, dass eine Seite von außerhalb Ihres Netzwerks nicht mehr lädt. Der Agent sagt Ihnen, dass dem Host zwei Minuten vorher der Arbeitsspeicher ausgegangen ist. Beides greift ineinander.
Alma, ein französisches Fintech, das Millionen Buy-now-pay-later-Transaktionen abwickelt, nutzt Hyperping als unabhängiges Sicherheitsnetz neben Datadog. Ihr SRE Fabrice Gregoire hat mir erzählt:
„Hyperping hat bei uns im Unternehmen den Ruf, schneller zu reagieren als Datadog. Meistens bekommen wir die Benachrichtigung von Hyperping vor der von Datadog. Als Fallback ist das nützlich, eine schlankere Backup-Lösung fürs Monitoring.“
„Datadog rechnet pro Check ab. Ihr [Hyperping] habt ein Paket, das ist besser. Pay per Use ist lästig und teuer.“
Die vollständige Fallstudie zu Alma lesen.
Was Nutzer sagen
„Hyperping hat für uns wirklich alles verändert. Der Dienst ist zuverlässig, einfach zu bedienen und unglaublich funktionsreich.“
„Wir haben unsere Statusseite von Hyperping öffentlich gemacht, und sie wurde ein zentraler Teil unserer Verkaufsgespräche. Wir sind stolz auf unsere Uptime und finden es großartig, dass wir sie mit Interessenten teilen können.“
Zu bedenken
Hyperping ist keine vollständige Observability-Plattform. Sie bekommen kein Distributed Tracing, keine indexierte Log-Analyse und kein APM für tiefe Performance-Analysen auf Code-Ebene. Wenn Sie eine langsame Datenbankabfrage über mehrere Microservices hinweg einem bestimmten Codepfad zuordnen müssen, kombinieren Sie Hyperping mit New Relic, Datadog oder SigNoz.
Wie lange Server-Metriken gespeichert werden, hängt vom Plan ab: Daten mit 1-Minuten-Auflösung bleiben 7 Tage in Essentials, 14 Tage in Pro und 30 Tage in Business erhalten, stündliche Aggregate 6 Monate in Essentials und 13 Monate in Pro und Business. Schwellenwert-Alerts auf Metrikwerte gibt es noch nicht: Hyperping alarmiert Sie, wenn ein Server keine Daten mehr meldet, nicht wenn eine Festplatte 90 % überschreitet. Metriken pro Prozess, Pakete und Fehler pro Netzwerkschnittstelle sowie Swap-Statistiken stehen auf der Roadmap, werden vom Ingestor aber noch nicht angenommen.
Preise
- Free: 1 Nutzerplatz, 20 Monitore, 1 Server-Agent, 1 einfache Statusseite, Checks alle 5 Min.
- Essentials: 24 €/Monat bei jährlicher Zahlung (3 Nutzerplätze, 50 Monitore, 5 Server-Agents, 1 Statusseite, Checks alle 30 Sek.)
- Pro: 74 €/Monat bei jährlicher Zahlung (10 Nutzerplätze, 250 Monitore, 20 Server-Agents, 3 öffentliche oder private Statusseiten, Anruf-Alerts). Enthält Zugangscodes per E-Mail, mehrsprachige Seiten und natives SAML SSO für das Konto.
- Business: 249 €/Monat bei jährlicher Zahlung (20 Nutzerplätze, 1.000 Monitore, 100 Server-Agents, 10 Statusseiten, Checks alle 20 Sek., SAML SSO als Add-ons)
- Enterprise: Individuell
Alle kostenpflichtigen Pläne enthalten Bereitschaftspläne, Eskalationsrichtlinien und den Server-Monitoring-Agent. Bei jährlicher Abrechnung sind 2 Monate gratis. Mehr auf der vollständigen Preisseite oder im Kostenvergleich mit Datadog Server für Server, der zeigt, was 20 oder 100 Hosts jeweils kosten.
Hyperping wählen, wenn
Sie Monitoring, Server-Health, Statusseiten und Rufbereitschaft in einem Tool wollen, mit einer Rechnung, die nicht jedes Mal steigt, wenn Sie neue Services ausrollen. Besonders gut passt Hyperping zu europäischen Unternehmen, die DSGVO-Konformität brauchen, zu SaaS-Teams, die ihre Statusseite als Verkaufsargument nutzen, und zu SRE-Teams, die Hyperping als unabhängiges Sicherheitsnetz neben Datadog betreiben (siehe die Fallstudie zu Alma).
2. New Relic: am besten für APM mit großzügigem Free-Tarif
Ideal für
Mittlere bis große Engineering-Teams mit Cloud-native-, Microservice- oder Kubernetes-Workloads, die tiefes APM und Tracing ohne Preise pro Host brauchen.
Wichtige Funktionen
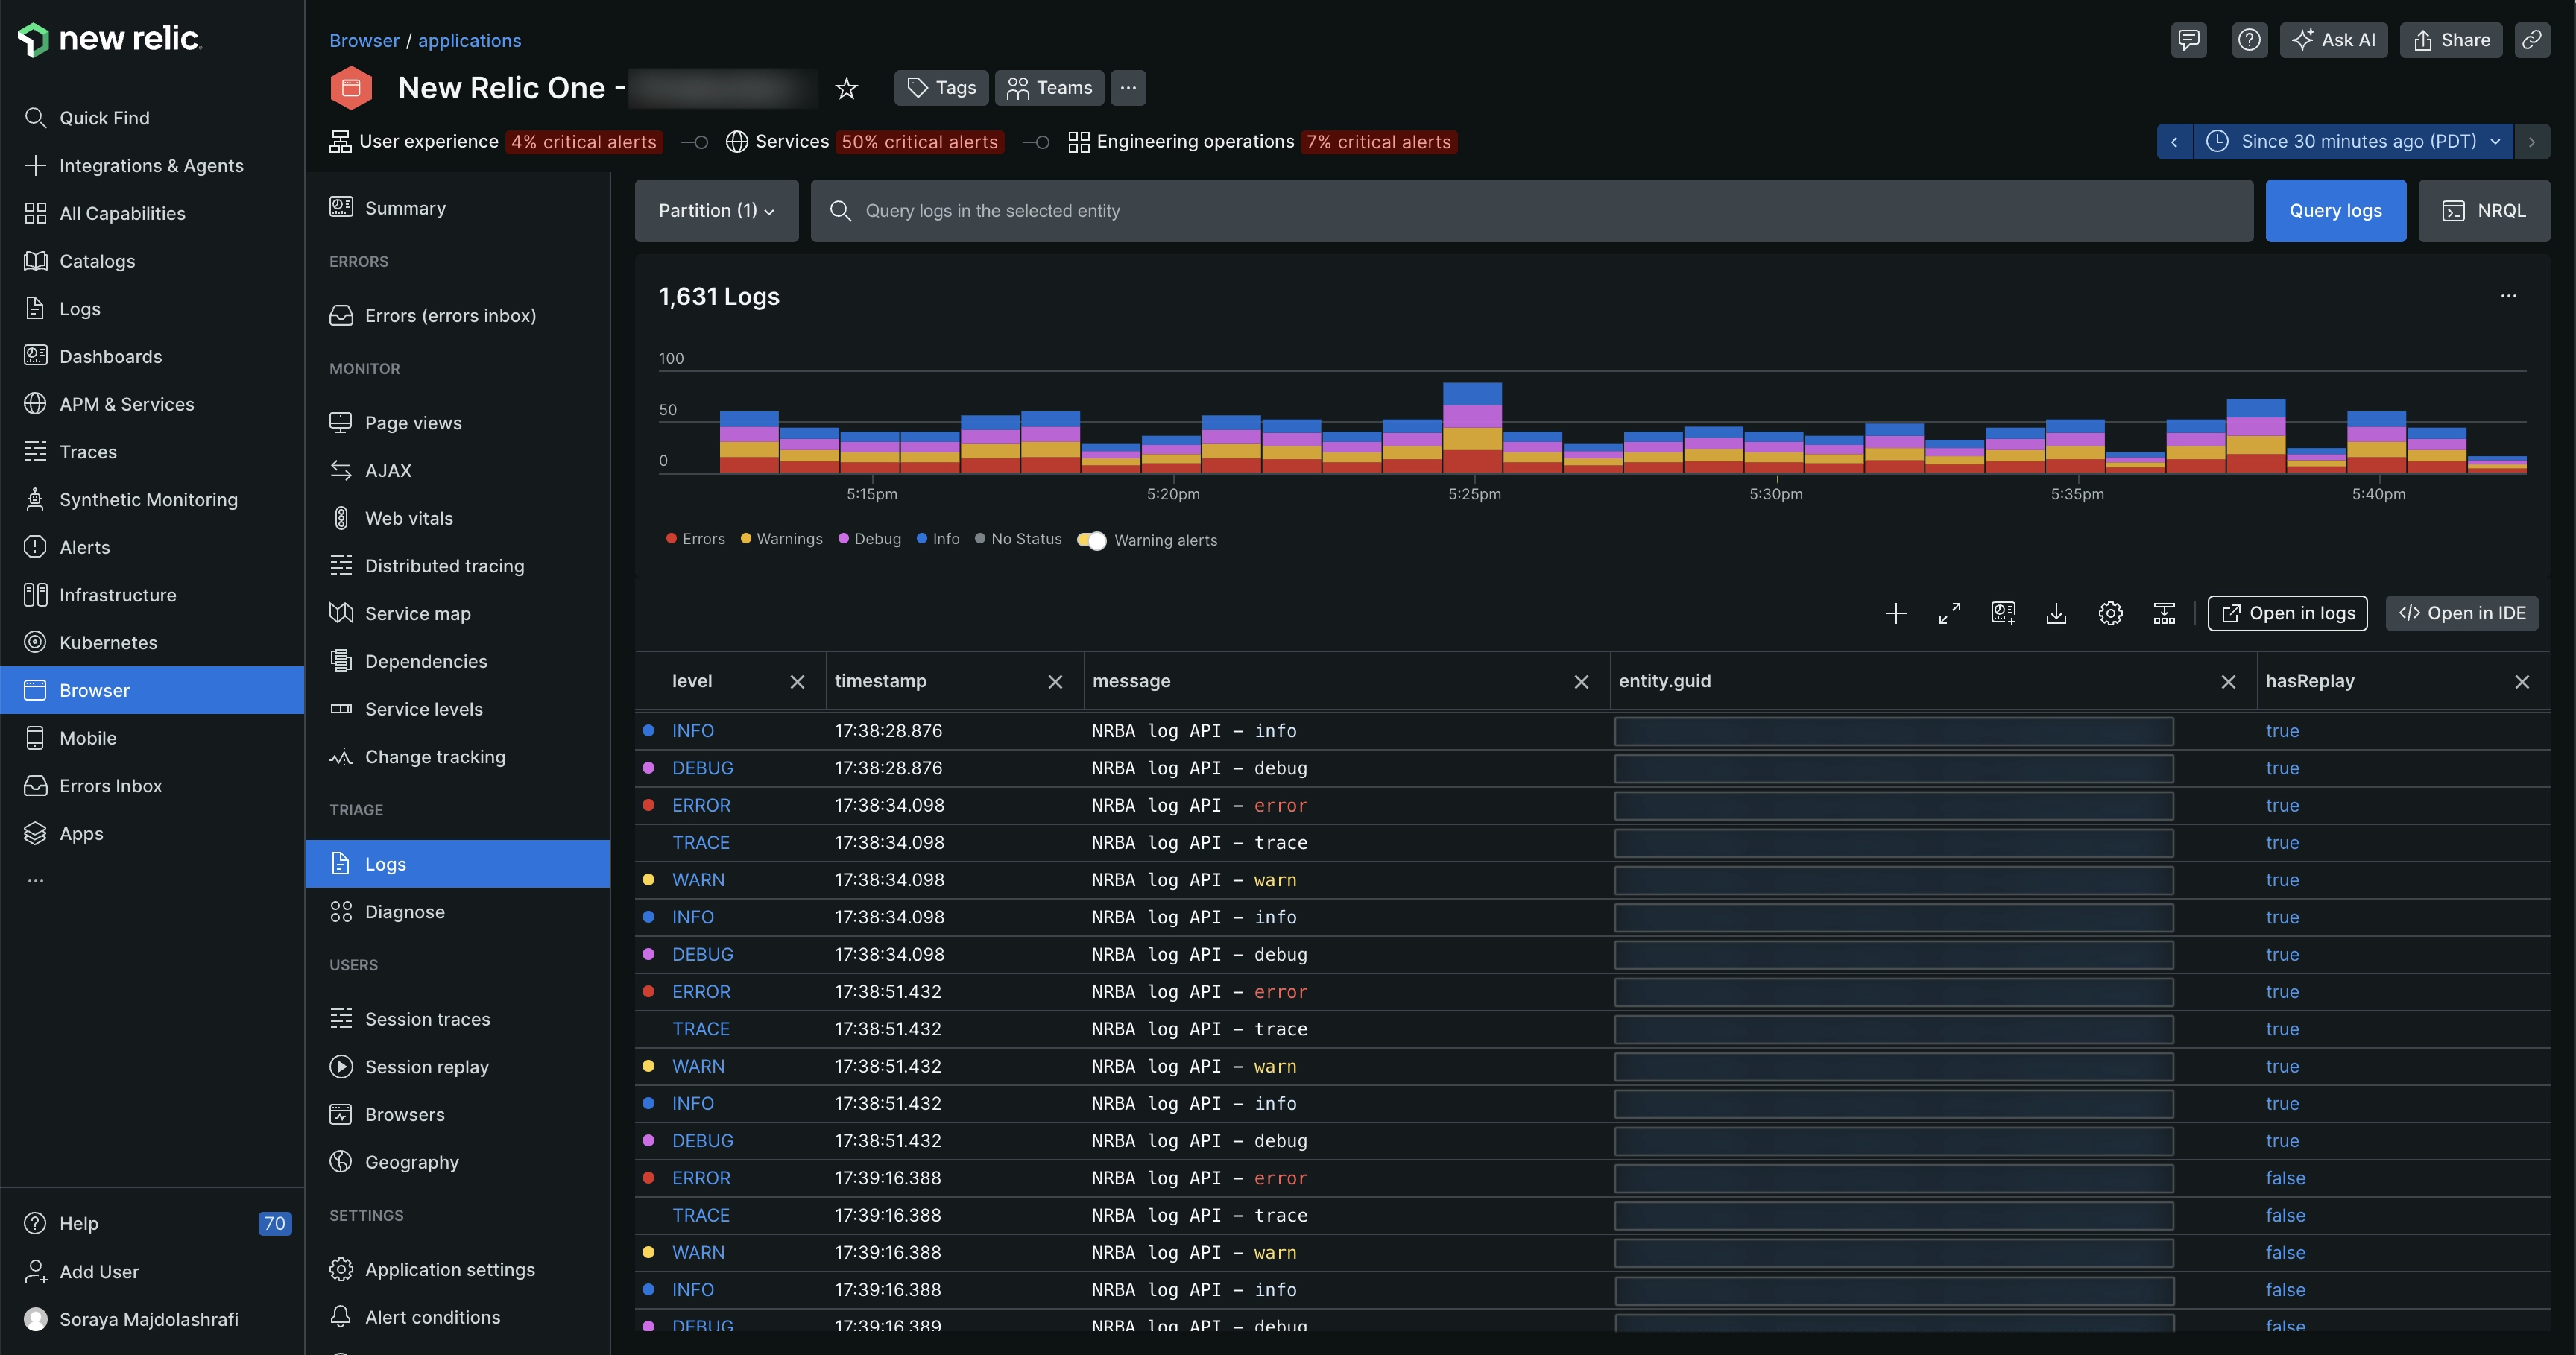
- Distributed Tracing und APM. Einblick auf Code-Ebene über Microservices hinweg, mit Auto-Instrumentierung für Java, Python, Node.js, Go, Ruby, .NET und PHP.
- Infrastruktur-Monitoring. Echtzeit-Metriken zu Hosts, Containern, Kubernetes und Cloud. Keine Gebühren pro Host, anders als bei Datadog oder Dynatrace.
- Digital Experience Monitoring. Browser-RUM, Mobile Monitoring, Session Replay und synthetische Checks, korreliert mit der Backend-Telemetrie.
- Log-Management im Kontext. Logs erfassen, parsen und in derselben Oberfläche mit Traces und Metriken korrelieren.
- New Relic AI und AIOps. Anomalieerkennung, automatische Korrelation von Incidents und Ursachenanalyse mit Bezug zu Deployments. Neu hinzugekommen sind unter anderem „New Relic Knowledge“ für kontextbezogenes Troubleshooting und Observability für KI-Agents in LLM-basierten Anwendungen.
- OpenTelemetry-first. Starke native OTel-Unterstützung plus 780+ Quickstart-Integrationen.
Warum New Relic
Der Free-Tarif ist das Hauptargument. 100 GB Daten-Ingest pro Monat, ein Full-Platform-Nutzer, unbegrenzt viele Basic-Nutzer und Zugriff auf 50+ Funktionen. Für kleine Teams oder Startups in der Frühphase deckt das oft dauerhaft alles ab. Jenseits des Free-Tarifs wird der Ingest pro GB abgerechnet (0,40 $ in Original, 0,60 $ in Data Plus), ohne Gebühren pro Host. Dieses Abrechnungsmodell ist der Hauptgrund, warum Teams auf der Flucht vor Datadog hier landen: Wenn Sie Monitoring auf Hunderten Hosts einschalten, vervielfacht sich Ihre Rechnung nicht.
Auch die Arbeit an KI-Observability ist bemerkenswert. New Relic war früh dabei mit Tracing für KI-Agents und LLM-Anwendungen, einschließlich Tracing von Halluzinationen und Korrelation der Agent-Reasoning-Schritte. Wenn Ihr Stack bereits KI-Workloads enthält, deckt dieselbe Plattform sie mit ab.
Was Nutzer sagen
„Seit wir New Relic eingeführt haben, hat sich die Art, wie wir unsere Anwendung überwachen und Performance-Probleme analysieren, enorm verbessert, weil wir neue Einblicke bekommen, die uns vorher verborgen waren. Die vielseitigen Dashboards erlauben es jedem im Team, die Metriken auszuwählen, die für seinen Bereich relevant sind.“
„Die Preisstruktur ist sprunghaft und skaliert schnell bei hohen Publikations- bzw. Populationsraten, was die Budgetplanung kompliziert macht. Außerdem sind einige erweiterte Funktionen der API nur in den höheren Plänen verfügbar.“
Das Muster in den Bewertungen: Lob für den Free-Tarif und die Tiefe des APM, verbunden mit der wiederkehrenden Warnung, dass die Ingest-Kosten bei großem Volumen unberechenbar werden können. Auch NRQL (die Abfragesprache) hat eine Lernkurve, die manche Rezensenten als steil bezeichnen.
Zu bedenken
Die Nutzerpreise für Full-Platform-Nutzerplätze steigen schnell. Der erste Full-Platform-Nutzer ist im Free-Tarif kostenlos, Core-Nutzer kosten 49 $/Nutzer/Monat für einen eingeschränkten Funktionsumfang, und Full-Platform-Nutzer kosten in Standard 10 $ für den ersten und 99 $ für jeden weiteren (maximal 5) oder 349 $/Nutzer/Monat in Pro bei jährlicher Abrechnung (418,80 $ bei monatlicher Zahlung). Für ein Team, in dem viele Entwickler vollen Zugriff brauchen, kann das an die hostbasierten Rechnungen von Datadog heranreichen.
Die Oberfläche ist dicht. Mit vielen Ebenen, Dashboards und Tools, die gleichzeitig auftauchen, beschreiben neue Nutzer sie häufig als überwältigend, bis sie ein paar Wochen damit gearbeitet haben. Einige Rezensenten berichten außerdem von Agent-Overhead in älteren Versionen.
Preise
- Free: 100 GB/Monat Ingest, 1 Full-Platform-Nutzer, unbegrenzt viele Basic-Nutzer
- Core-Nutzer: 49 $/Nutzer/Monat für einen eingeschränkten Funktionsumfang
- Full-Platform-Nutzer: Standard 10 $ für den ersten Nutzer, danach 99 $/Nutzer/Monat (max. 5); Pro 349 $/Nutzer/Monat bei jährlicher, 418,80 $ bei monatlicher Zahlung
- Daten-Ingest: 0,40 $/GB in Original, 0,60 $/GB in Data Plus, über die kostenlosen 100 GB hinaus
- Enterprise: Individuell (FedRAMP, HIPAA, erweiterte SLAs)
- Advanced Compute: nutzungsbasiertes CCU-Modell ohne bzw. mit geringen Nutzergebühren
New Relic wählen, wenn
Sie APM, Distributed Tracing und Infrastruktur-Monitoring brauchen, ohne dass sich die Rechnung pro Host vervielfacht. Der Free-Tarif allein reicht vielen kleinen Teams, und die nutzungsbasierte Abrechnung danach skaliert planbarer als die modularen Preise pro Funktion bei Datadog. Auch wenn Sie KI- oder LLM-Workloads neben klassischen Services instrumentieren, ist New Relic die richtige Wahl.
3. Dynatrace: am besten für KI-gestützte Ursachenanalyse im Enterprise-Umfeld
Ideal für
Große Unternehmen (oft 1.000+ Hosts) mit komplexen Cloud-native-, Microservice- oder Hybrid-Architekturen und erfahrenen SRE- und Plattform-Teams.
Wichtige Funktionen
- Auto-Instrumentierung mit OneAgent. Ein einziger Agent pro Host, der jeden Service, jeden Prozess und jede Abhängigkeit automatisch erkennt. Keine manuelle Instrumentierung.
- KI-Engine Davis. Korreliert Metriken, Logs, Traces und Topologie zu einer einzigen Ursache mit Hinweisen zur Behebung, statt 40 Alerts auf Ihre Bereitschaft abzuladen.
- Smartscape-Topologie. Echtzeit-Karte der Abhängigkeiten, die sich mit Ihrer Infrastruktur aktualisiert.
- Distributed Tracing mit PurePath. Tracing auf Code-Ebene über Microservices hinweg.
- Grail Data Lakehouse. Indexloser Speicher mit Schema-on-Read für Observability-, Security- und Geschäftsdaten, abfragbar mit DQL.
- Application Security inklusive. Erkennung von Schwachstellen zur Laufzeit, verknüpft mit dem tatsächlichen Verhalten der Anwendung.
Warum Dynatrace
Davis AI ist der Hauptgrund. Teams mit großen, dynamischen Umgebungen berichten von spürbar weniger Alerts und kürzerer MTTR, weil Davis zusammengehörige Signale zu einem Incident mit vorgeschlagener Ursache bündelt. Wenn Ihr Bereitschaftsteam im Rauschen untergeht, ist die KI-Schicht ihr Geld wert. OneAgent nimmt Ihnen die manuelle Instrumentierung ab, was zählt, wenn Ihre Landschaft Tausende Services umfasst, die sich täglich ändern.
Für Unternehmen in regulierten Branchen (Banken, Versicherungen, Gesundheitswesen) reduziert die Kombination aus Observability und Laufzeit-Security in einer Plattform den Tool-Wildwuchs und den Audit-Aufwand.
Was Nutzer sagen
„Das Produkt wird an alle vermarktet, von der Geschäftsführung über Designer und Marketing bis zu Entwicklern. Diese Breite treibt Innovation im ganzen Unternehmen voran und verhindert, dass Teams ihren Technologie-Stack in Silos aufteilen. Mir gefällt auch die Vision ‚erst der Geschäftsprozess, dann die Technologie‘.“
G2-Bewertung zu Dynatrace, Finanzdienstleister, Enterprise
„Eine Migration zwischen Tenants ist kaum möglich, ohne Daten zu verlieren. Die KI-Funktionen müssten in allen Bereichen des Produkts einheitlich sein. Das verbrauchsbasierte Abrechnungsmodell ist unklar, zum Beispiel was eine Abfrage tatsächlich in Geld kostet oder welchem Prozentsatz der Jahresverpflichtung sie entspricht.“
Das wiederkehrende Thema: KI und automatische Erkennung sind im Enterprise-Maßstab wirklich beeindruckend, aber die Optimierung der DPS-Einheiten (Dynatrace Platform Subscription) wird zu einer eigenen Daueraufgabe. Rezensenten beschreiben die Plattform durchweg als überwältigend für kleine Teams.
Zu bedenken
Es gibt keinen dauerhaften Free-Tarif, nur eine 15-tägige Testphase. Für Teams mit weniger als 100 Hosts ist Dynatrace überdimensioniert, und Sie bezahlen für KI-Funktionen, die für ein Chaos gebaut sind, das Sie noch gar nicht haben. Beim DPS-Preismodell sinken die Kosten pro Einheit mit wachsendem Verbrauch, im Gegenzug zahlen kleine Umgebungen einen Aufpreis.
Auch die Einrichtung ist aufwendiger als bei New Relic oder Datadog. Die Plattform hat klare Vorstellungen, und damit Davis AI Signal statt Rauschen liefert, müssen Sie Ihre Tagging- und Topologie-Konventionen an das anpassen, was Davis erwartet.
Preise
- Full-Stack-Monitoring: 58 $/Monat pro Host mit 8 GiB zum Listenpreis (abgerechnet mit 0,01 $ pro Memory-GiB-Stunde); Infrastructure Monitoring kostet 29 $/Host/Monat
- Logs, Synthetics, DEM und Security: separat abgerechnet
- Kein Free-Tarif: nur 15-tägige Testphase
- Stufen: Starter, Professional, Enterprise, gestaffelt nach Funktionsumfang und Support
Dynatrace wählen, wenn
Sie 500+ Hosts haben, ein erfahrenes SRE-Team, komplexe Microservices, bei denen automatische Erkennung und KI-Korrelation echte Engineering-Stunden sparen, und ein Budget, das Enterprise-Listenpreise verträgt. Für kleine und mittlere Teams lassen Sie es besser bleiben, ebenso wenn Sie vor allem Infrastruktur-Monitoring brauchen und kein APM und keine Security obendrauf.
4. Better Stack: am besten für Monitoring plus Logs und Incident Response
Ideal für
Engineering-Teams, die Uptime-Monitoring, Log-Management und Incident Response vereint auf einer entwicklerorientierten Plattform mit moderner Oberfläche wollen.
Wichtige Funktionen
- Uptime-Monitoring mit 30-Sekunden-Checks aus 17 Regionen weltweit. HTTP-, SSL-, DNS-, TCP-, UDP-, SMTP-, POP3-, IMAP- und Cron/Heartbeat-Monitore. Prüfung aus mehreren Regionen vor dem Alert.
- Log-Management im großen Maßstab. Speicher auf Basis von ClickHouse, SQL-ähnliche Abfragen, Echtzeit-Tailing und Aggregation, die bis zu einer Milliarde Logzeilen pro Sekunde verarbeitet.
- Incident-Management mit Rufbereitschaft. Bereitschaftspläne, Eskalationsrichtlinien, KI-gestützte Post-Mortems, Integration mit Slack und Teams.
- Statusseiten. Öffentlich und privat, mit eigenen Domains und Branding.
- OpenTelemetry-Tracing auf Basis von eBPF. Auto-Instrumentierung von Services ohne Codeänderungen.
- KI-native Incident Response. Intelligentes Zusammenführen von Alerts gegen das Rauschen, dazu Kommentare an Logs im Stil von Google Docs für das gemeinsame Troubleshooting.
Warum Better Stack
Better Stack ist für KMU und Mittelstand der direkteste Konkurrent von Datadog. Es deckt dieselbe breite Fläche ab (Uptime, Logs, Traces, Incidents, Statusseiten), zu transparenten Preisen, die bei gleichem Umfang meist nur einen Bruchteil von Datadog ausmachen. Die Oberfläche wird durchweg als modern und entwicklerorientiert gelobt, im Gegensatz zur dichten, funktionsüberladenen Oberfläche von Datadog.
Das Tracing auf eBPF-Basis ist ein echtes Unterscheidungsmerkmal für Teams, die OpenTelemetry-natives APM wollen, ohne Code manuell zu instrumentieren. Mit ClickHouse für Logs bekommen Sie die Abfrage-Performance des Log Explorers von Datadog, ohne das Preismodell pro indexiertem GB.
Was Nutzer sagen
„BetterStack Uptime ist ein hervorragendes Tool, um die Verfügbarkeit von Websites und Diensten in Echtzeit zu überwachen. Die Oberfläche ist modern, einfach zu bedienen und im Alltag angenehm. Die bereitgestellte Diagnose (Screenshots, Traceroute, Cron-Job-Monitoring) erleichtert die Behebung von Incidents enorm.“
„Der einzige Nachteil: Die Kosten können schnell steigen, wenn Sie viele Monitore haben oder erweiterte Integrationen brauchen. Außerdem bleiben einige Anpassungsmöglichkeiten (zum Beispiel bei Statusseiten) in den Einstiegsplänen eingeschränkt.“
„Der erste kostenpflichtige Tarif startet direkt bei 29 $, was für die kleinen Open-Source-Dienste, die ich betreibe, sehr happig ist.“
Das Muster in den Bewertungen: viel Lob für die Oberfläche und das gebündelte Funktionspaket, verbunden mit dem wiederkehrenden Hinweis, dass der Preis schnell steigt, sobald Sie Monitoring, Nutzerplätze für die Rufbereitschaft, Statusseiten und Logs kombinieren. Einige Nutzer bemängeln auch, dass das Dashboard ab 100+ Monitoren unübersichtlich wird.
Zu bedenken
Die modulare Preisstruktur (separate Abrechnung für Uptime-Monitore, Nutzerplätze für die Rufbereitschaft, Statusseiten und Logs) macht einen kleinen Einstieg leicht, summiert sich aber. Ein Team mit 250 Monitoren, Rufbereitschaft für 5 Entwickler, 3 Statusseiten und einfacher Log-Aufbewahrung landet bei deutlich über 250 $/Monat, während Hyperping mit vergleichbarem Monitoring und Rufbereitschaft 74 $/Monat kostet.
Self-Hosting und tiefgehende Anpassungen sind im Vergleich zu Enterprise-Tools begrenzt. Für stark regulierte Workloads kann das eine Einschränkung sein.
Preise
- Free: 10 Monitore, 1 Statusseite, begrenzte Log-Aufbewahrung
- Uptime-Monitoring: 29 $/Monat Grundpreis, steigt mit der Anzahl der Monitore
- Rufbereitschaft: ca. 29 $/Nutzer/Monat
- Statusseiten: 12 $/Monat pro zusätzlicher Seite
- Logs: ab etwa 25 $/Monat mit 30 Tagen Aufbewahrung
- Enterprise: individuell, mit unbegrenzten Endpoints und SLA
Better Stack wählen, wenn
Sie einen einzigen, entwicklerorientierten Anbieter für Monitoring, Rufbereitschaft, Logs und Incident Response mit ausgereifter, moderner Oberfläche wollen und akzeptieren, dass die Rechnung mit jedem zusätzlichen Produkt wächst. Better Stack passt gut zu SaaS-Startups, die in vollständige Observability hineinwachsen und nicht drei oder vier Einzeltools zusammenstückeln wollen.
Weitere Tools, die man kennen sollte
Einige Tools habe ich in Betracht gezogen, aber nicht in die Top vier aufgenommen. Jedes besetzt eine bestimmte Nische.
- Honeycomb. Hervorragend für Tracing mit hoher Kardinalität und abfragegetriebene Observability. Die Philosophie meidet bewusst die Fallstricke des metrikbasierten Modells von Datadog. Am besten für Teams, die verteilte Systeme debuggen und nicht im Voraus wissen, welche Fragen sie stellen müssen. Weniger Fokus auf Infrastruktur oder synthetisches Monitoring.
- SigNoz. Open Source, OpenTelemetry-nativ, mit einer Oberfläche ähnlich wie Datadog. Selbst gehostet kostenlos; die Cloud startet bei 49 $/Monat inklusive 49 $ Nutzung, mit kostenloser Testphase. Berichtete Einsparungen von 80 bis 90 % gegenüber Datadog bei großem Volumen. Jüngeres Ökosystem und weniger Enterprise-Integrationen.
- Grafana Cloud / LGTM-Stack (Loki, Mimir, Tempo, Grafana). Der Standard für Kubernetes-lastige und engineering-getriebene Teams. Großzügiger Free-Tarif, kostenpflichtig ab 19 $/Monat plus Nutzung. Der Haken: Sie bauen sich alles selbst zusammen.
- Chronosphere. Nutzungsbasierte Preise mit Fokus auf Telemetrie-Pipelines und Kostenkontrolle (berichtete Einsparungen von bis zu 80 %). Ende 2025 von Palo Alto Networks übernommen und in das breitere Security-Angebot integriert.
- Splunk Observability Cloud. Stark bei Log-Analysen und an der Schnittstelle von Security und Observability. Komplexe Preise und hohe Kosten bei großen Ingest-Volumen.
- Elastic Observability. Suchbasiertes Logging und Metriken mit starken Optionen zum Selbsthosten. Im großen Maßstab ressourcenhungrig im Betrieb.
Für Kubernetes-Teams, die sich ihren Stack selbst zusammenstellen wollen, ist Prometheus + Grafana der Standard. Kostenlos, flexibel und CNCF-Standard, aber Sie betreiben es selbst (und brauchen zusätzlich Thanos oder Mimir für die Langzeitspeicherung, Loki für Logs, Tempo für Traces).
Open-Source-Empfehlungen
Wenn Sie Engineering-Zeit haben und keine Lizenzkosten wollen:
- Prometheus + Grafana für Kubernetes- und Cloud-native-Metriken
- SigNoz oder Uptrace für OpenTelemetry-native All-in-One-Observability
- OpenObserve oder Parseable für performanten, günstigen Speicher von Logs und Metriken
- Zabbix für Infrastruktur-Monitoring on-prem und hybrid im großen Maßstab
- Uptime Kuma für einfache Uptime-Checks und eine einfache Statusseite (Homelabs und kleine Teams)
Self-Hosting ist in der Praxis selten kostenlos. Sie zahlen mit Infrastruktur, laufender Wartung, Rufbereitschaft für das Monitoring-Tool selbst und Engineering-Zeit für Upgrades. Die Rechnung geht am besten auf, wenn Sie bereits ein eigenes Plattform- oder SRE-Team haben.
Vollständige Liste der geprüften Datadog-Alternativen
Der Vollständigkeit halber hier die mehr als 30 Tools, die ich geprüft habe, bevor ich mich auf die vier Empfehlungen beschränkt habe. Die Preise sind Näherungswerte auf Basis von Marktdaten aus 2025 bis 2026 und hängen von der Nutzung ab (Hosts, aufgenommene GB, Events, Zeitreihen).
| Name | Größte Stärke | Größte Schwäche | Einstiegspreis |
|---|---|---|---|
| Hyperping | Festpreis, All-in-One für SaaS | Kein vollwertiges APM, keine Trace-Speicherung | 24 €/Monat |
| New Relic | Großzügiger Free-Tarif, starkes APM | Lernkurve bei NRQL | Kostenlos bis 100 GB/Monat |
| Dynatrace | Davis AI, automatische Erkennung mit OneAgent | Teuer, kein Free-Tarif | ca. 58 $/Host/Monat Full-Stack |
| Better Stack | Moderne Oberfläche, Logs + Incidents in einem | Modulare Preise summieren sich | 29 $/Monat |
| Datadog | Breite Integrationen, ausgereift | Kosten bei großem Volumen | ca. 15 $/Host/Monat |
| Splunk Observability | Log-Analysen, Security | Komplexe Preise | Individuell |
| Elastic Observability | Suche, Option zum Selbsthosten | Ressourcenhungrig | Kostenlos (OSS) / Cloud ab 95 $ |
| Grafana Cloud / LGTM | Visualisierung, modular | Eigener Zusammenbau nötig | Kostenlos / ab 19 $ plus Nutzung |
| SigNoz | OpenTelemetry-nativ, OSS | Junges Ökosystem | Kostenlos (OSS) / Cloud kostenpflichtig |
| Honeycomb | Tracing mit hoher Kardinalität | Weniger Fokus auf Infrastruktur | Kostenlos bis 20 Mio. Events |
| Chronosphere | Kostenkontrolle bei Telemetrie | Schwenk zu Security nach der Übernahme | Nutzungsbasiert |
| Prometheus | Standard für Kubernetes | Braucht Speicher-Add-ons | Kostenlos (OSS) |
| Zabbix | On-prem im großen Maßstab | Steile Lernkurve | Kostenlos (OSS) |
| Nagios XI / Core | Ausgereiftes Netzwerk-Monitoring | Veraltete Oberfläche, schwach bei Traces | Kostenlos / Tausende pro Jahr |
| SolarWinds Observability | Hybride IT, Netzwerk | Markenimage (SUNBURST) | Abonnement |
| AppDynamics (Cisco) | Enterprise-APM | Komplex, intransparent | Individuell |
| LogicMonitor | AIOps, Infrastruktur | Intransparente Preise | Nutzungsbasiert |
| Sumo Logic | Log-Analysen | Oberfläche wirkt veraltet | Nutzungsbasiert |
| OpenObserve | Performante OSS-Logs | Kleinere Community | Kostenlos (OSS) |
| Uptrace | OpenTelemetry-natives OSS | Weniger bekannt | Kostenlos (OSS) |
| OneUptime | Open-Source-All-in-One | Noch wenig Verbreitung im Enterprise | Kostenlos (OSS) |
| Netdata | Infrastruktur-Metriken in Echtzeit | Auf Hosts fokussiert | Kostenlos (OSS) |
| Parseable | Logs auf Object Storage | Noch in Reifung | Kostenlos (OSS) |
| HyperDX | Einheitlich, Fokus auf Developer Experience | Geringere Verbreitung | Free-Tarif + Nutzung |
| Middleware | LLM/KI-Observability | Nische | Nutzungsbasiert |
| Site24x7 | Uptime + Infrastruktur, KMU-Preise | Weniger APM-Tiefe | Abonnement |
| Groundcover | eBPF, Kubernetes | Auf K8s fokussiert | Nutzungsbasiert/pro Host |
| Dash0 | OpenTelemetry-nativ | Neu am Markt | Free-Tarif |
| Arize Phoenix | ML/LLM-Observability | Enger Fokus | Kostenlos (OSS) / kostenpflichtig |
| Kloudfuse | Einheitliche Observability | Weniger bekannt | Enterprise |
| ScienceLogic | AIOps für IT-Betrieb | Fokus auf klassischen Betrieb | Abonnement |
| ManageEngine | Breite IT-Suite | Oberfläche wirkt überladen | Gestaffelt |
| Uptime Kuma | Kostenlos, selbst gehostet | Nur eine Region, keine API | Kostenlos (OSS) |
Die Muster in dieser Liste stammen aus Analysen von 2025 bis 2026: Gartner Peer Insights, Preisseiten der Anbieter, Vergleichsartikel bei SigNoz, OneUptime, Uptrace und OpenObserve sowie Reddit-Threads in r/devops, r/sre und r/Monitoring.
So treffen Sie die Wahl
Drei Fragen decken die meisten Entscheidungen ab.
Brauchen Sie vor allem Uptime, Server-Health, Statusseiten und Rufbereitschaft? Hyperping ist die planbare Wahl zum Festpreis, und der Vergleich Hyperping vs Datadog geht den Wechsel Funktion für Funktion durch. Der Server-Agent von 2026 deckt CPU, Arbeitsspeicher, Festplatte und Netzwerk auf Linux- und macOS-Hosts ab. Statusseiten und Rufbereitschaft sind inklusive. Kein Multiplikator pro Host auf der Rechnung.
Brauchen Sie echtes APM und Distributed Tracing? New Relic, wenn Sie den großzügigsten Free-Tarif und ein OpenTelemetry-first-Design wollen. Dynatrace, wenn Sie im Enterprise-Maßstab mit Tausenden Hosts arbeiten und Davis AI die Triage von Incidents übernehmen soll.
Brauchen Sie Monitoring plus Logs und Incident Response in einem entwicklerorientierten Tool? Better Stack. Moderne Oberfläche, Logs auf ClickHouse-Basis, eBPF-Tracing. Der Haken: Die Rechnung steigt, je mehr Produkte Sie kombinieren.
Wenn Sie einen Kubernetes-Stack betreiben und Engineering-Zeit haben, bleibt Prometheus + Grafana + Loki + Tempo im großen Maßstab der günstigste Weg. Die Kosten liegen im Betrieb, nicht in Lizenzen.
Häufige Fehler beim Abschied von Datadog
Einige Muster, die mir in den Reddit-Threads immer wieder begegnet sind.
- Ein Tool wählen, das die Rechnung von heute löst, nicht den Stack von nächstem Jahr. Die meisten Teams unterschätzen, wie stark ihr Datenvolumen wächst. Ein Tool, das bei 20 Hosts günstig ist, ist es bei 200 vielleicht nicht mehr, wenn es Logs nutzungsbasiert abrechnet.
- Die Migrationskosten unterschätzen. Die proprietäre Instrumentierung von Datadog lässt sich nicht sauber zu einem neuen Anbieter mitnehmen. Planen Sie Engineering-Zeit für neu geschriebene Instrumentierung, neu angelegte Alerts und neu gebaute Dashboards ein. Ersatztools mit OpenTelemetry-first-Ansatz (New Relic, SigNoz, Uptrace) verringern diesen Aufwand, beseitigen ihn aber nicht.
- Statusseiten und Rufbereitschaft vergessen. Viele Teams ersetzen Datadog und merken dann, dass sie auch Statuspage.io und PagerDuty genutzt haben, jeweils für 200 bis 400 $/Monat. Ein gebündeltes Tool wie Hyperping oder Better Stack schließt diese Lücke. Datadog allein hat das nie getan.
- Komplett auf Open Source setzen, ohne das Personal dafür. Prometheus, Loki und Tempo sind als Software kostenlos, nicht im Betrieb. Ohne eigenen Platform Engineer verschwinden die Einsparungen in Incident-Zeit und Upgrade-Aufwand.
- „All-in-One“ als Checkliste von Funktionen behandeln. Kein Ersatz erreicht den vollen Funktionsumfang von Datadog mit demselben Feinschliff. Wählen Sie den Teil, den Sie tatsächlich täglich nutzen.
Fazit
Es gibt nicht die eine beste Datadog-Alternative, sondern nur den besten Ersatz für den Teil von Datadog, auf den Sie tatsächlich angewiesen sind.
- Für Uptime, Server-Monitoring, Statusseiten und Rufbereitschaft in einem Tool zum Festpreis: Hyperping.
- Für APM und Tracing mit einem Free-Tarif, der lange reicht: New Relic.
- Für KI-gestützte Ursachenanalyse im Enterprise-Maßstab: Dynatrace.
- Für Monitoring plus Logs und Incident Response in einem entwicklerorientierten Produkt: Better Stack.
Wenn Sie ein Tool wollen, das Probleme in 30 Sekunden von außerhalb Ihres Netzwerks erkennt, CPU und Arbeitsspeicher jedes Hosts nach einer Installation mit einer Zeile überwacht und Statusseiten und Rufbereitschaft im selben Abo bündelt, testen Sie Hyperping 14 Tage kostenlos.
Weiterlesen
- Die besten Website-Monitoring-Tools: die führenden Monitoring-Plattformen im Vergleich
- Die besten Server-Monitoring-Tools: mit Datadog, Dynatrace, Hyperping und Open-Source-Optionen
- Leitfaden zum Monitoring von Linux-Servern: CPU, Arbeitsspeicher, Festplatte und Netzwerk auf Ihren eigenen Hosts
- Alert-Schwellenwerte für Server-Monitoring: wo Sie Alerts für CPU, Arbeitsspeicher und Festplatte setzen
- Die besten Tools für Bereitschaftspläne: Monitoring mit Rufbereitschaft kombinieren
- Better Stack vs Datadog vs Hyperping: der direkte Vergleich
- Pingdom-Alternativen: falls Sie auch Pingdom prüfen
- Better-Stack-Alternativen: falls Better Stack auf Ihrer Shortlist steht
- MTTR-Leitfaden: die mittlere Zeit bis zur Behebung messen und senken
- Hyperping-Preise
Weiter vergleichen: Hyperping vs Datadog · Hyperping vs New Relic · Hyperping-Preise · Alle Vergleiche
Häufige Fragen
Was ist die beste Datadog-Alternative? ▼
Die beste Datadog-Alternative hängt davon ab, was Sie tatsächlich brauchen. Für Uptime, Statusseiten, Rufbereitschaft und Server-Monitoring in einem Tool zum Festpreis: Hyperping ab 24 €/Monat. Für vollwertiges APM mit großzügigem Free-Tarif: New Relic mit 100 GB/Monat kostenlos. Für KI-gestützte Ursachenanalyse im Enterprise-Umfeld: Dynatrace. Für Monitoring plus Logs und Incident Response: Better Stack.
Warum wechseln Teams von Datadog weg? ▼
In den Reddit-Threads und Bewertungen, die ich gelesen habe, ist der Preis der klar dominierende Grund. Die Rechnungen explodieren durch Log-Ingestion, Custom Metrics, Host-Anzahl und APM-Spans. Viele Nutzer berichten von Rechnungen, die drei- bis zehnmal so hoch ausfallen wie budgetiert. Am zweithäufigsten genannt: Vendor-Lock-in durch proprietäre Agents.
Gibt es eine kostenlose Datadog-Alternative? ▼
Ja. New Relic hat einen dauerhaft kostenlosen Tarif mit 100 GB Daten-Ingest pro Monat und einem Full-Platform-Nutzer. Prometheus plus Grafana ist vollständig Open Source. SigNoz und Uptrace sind OpenTelemetry-native Open-Source-Optionen. Auch Hyperping hat einen Free-Plan mit 20 Monitoren, einem Server-Agent und einer Statusseite.
Was ist die günstigste Datadog-Alternative? ▼
Selbst gehostet sind Prometheus plus Grafana und SigNoz kostenlos, sofern Sie die Engineering-Zeit für den Betrieb haben. Als SaaS startet Hyperping bei 24 €/Monat, inklusive Monitoring, Statusseiten, Rufbereitschaft und Server-Agents. Der Free-Tarif von New Relic reicht den meisten kleinen Teams dauerhaft.
Ist Datadog sein Geld wert? ▼
Für Teams mit 50+ Hosts und verteilten Microservices, die APM, Logs und Metriken aktiv zusammen nutzen: ja. Für Teams, die vor allem Uptime-Monitoring, Server-Health oder Statusseiten brauchen, ist Datadog überdimensioniert, und die Rechnung wächst schneller als erwartet, sobald Log-Volumen und Custom Metrics steigen.