Die besten Nagios-Alternativen 2026 sind Hyperping (gehostetes Server- und Uptime-Monitoring mit integrierter Rufbereitschaft und Statusseiten), Icinga (der direkteste Open-Source-Ersatz, dieselben Plugins), Checkmk (Kompatibilität mit Nagios-Plugins plus automatische Erkennung), Zabbix (Open-Source-Komplettlösung mit Templates) und Prometheus mit Grafana (metrikbasiertes Monitoring für Cloud-native Stacks). Außerdem stelle ich Netdata, Datadog, PRTG und LibreNMS für die Teams vor, zu denen sie besser passen.
Nagios funktioniert noch. Nagios Core 4.5.14 ist am 5. August 2026 erschienen, und viele Teams betreiben es ohne Zwischenfälle. Gewechselt wird wegen allem, was um die Checks herum liegt: handgeschriebene Objektdateien, ein Plugin, das auf jedem Host installiert und aktualisiert werden muss, eine Oberfläche, die sich seit Jahren kaum verändert hat, und eine Alarmierung, die bei „schick eine E-Mail an diesen Kontakt“ aufhört.
In diesem Leitfaden erfahren Sie:
- Warum Teams Nagios ablösen, auf Basis von Nutzerbewertungen und der Dokumentation der einzelnen Tools
- Neun Alternativen mit Preisen, Hosting-Modell, Einrichtungsaufwand und Umgang mit Alarmierung und Rufbereitschaft
- Welche Open Source sind, welche kostenlos und welche am besten mit Windows-Hosts funktionieren
- Wie Sie Alarmierung und Kundenkommunikation ohne Big-Bang-Migration aus Nagios herauslösen
Das Wichtigste in Kürze
- Icinga ist der Open-Source-Wechsel mit der geringsten Reibung: Es führt Ihre bestehenden Nagios-Plugins aus, bringt eine REST-API und Clustering mit und ist ohne Host-Limit kostenlos.
- Checkmk bleibt kompatibel mit Nagios-Plugins, ersetzt aber die handgeschriebene Konfiguration durch agentenbasierte Service-Erkennung und eine Weboberfläche. Community ist kostenlos, Pro beginnt bei 190 €/Monat bei jährlicher Abrechnung.
- Zabbix und Prometheus + Grafana sind die stärksten Open-Source-Plattformen, wenn Sie bereit sind, Ihre Checks neu aufzubauen statt sie zu portieren.
- Hyperping passt zu Teams, deren eigentliches Problem die Alarmierung ist: ein Agent für Linux, macOS und Windows, Bereitschaftspläne, Eskalationsrichtlinien und Statusseiten in einem gehosteten Tool, ab 24 €/Monat bei jährlicher Abrechnung.
- PRTG ist die richtige Wahl, wenn der Monitoring-Server selbst unter Windows laufen soll. Sein Core-Server läuft nur unter Windows.
Warum Sie diesem Leitfaden vertrauen können
Ich bin Léo, Gründer von Hyperping. Ich habe also ein Interesse an einem dieser Tools, und Hyperping steht an erster Stelle. Ich habe versucht, genau zu benennen, wo es Schwächen hat, denn es ersetzt nicht alles, was Nagios kann: Es hat kein Plugin-System, kein SNMP-Polling von Netzwerkgeräten und keine selbst gehostete Edition.
Bei den anderen Tools habe ich Preise und Lizenzen am 28. September 2026 auf der offiziellen Website des jeweiligen Anbieters geprüft, Capterra-Bewertungen zu Nagios Core und Nagios XI gelesen und die Dokumentation der Anbieter zu Alarmierung und Rufbereitschaft durchgearbeitet. Wo ich etwas nicht direkt überprüfen konnte, sage ich das.
Die besten Tools im Überblick
| Am besten für | Produkt |
|---|---|
| Gehostetes Server-Monitoring mit Rufbereitschaft und Statusseiten inklusive | Hyperping |
| Direkter Open-Source-Ersatz, der Nagios-Plugins weiterverwendet | Icinga |
| Nagios-Kompatibilität mit automatischer Erkennung und Konfiguration im Web | Checkmk |
| Kostenloses Komplett-Monitoring mit Templates und Weboberfläche | Zabbix |
| Metrikbasiertes Monitoring für Container und Cloud-native Stacks | Prometheus + Grafana |
| Metriken im Sekundentakt nahezu ohne Konfiguration | Netdata |
| Vollständige Observability mit APM, Logs und Traces | Datadog |
| Monitoring-Server unter Windows mit Netzwerksensoren | PRTG |
| Monitoring von Netzwerkgeräten per SNMP mit automatischer Erkennung | LibreNMS |
Warum Teams Nagios verlassen
Nagios begann 1999 als NetSaint und wurde in den 2000er-Jahren zum Referenz-Tool für Open-Source-Monitoring. Sein Check-Modell (ein kleines Programm ausführen, den Exit-Code lesen, bei 0, 1, 2 oder 3 alarmieren) ist so verbreitet, dass die Hälfte der Tools weiter unten es noch immer spricht. Die Kritik, die ich gefunden habe, betrifft alles andere.
Wildwuchs an Plugins auf jedem Host
Jeder Check in Nagios ist ein externes Programm. Um den Speicherplatz auf einem entfernten Linux-Host zu prüfen, installieren Sie NRPE oder NCPA auf diesem Host, verteilen check_disk samt Abhängigkeiten und halten die Versionen auf der gesamten Flotte synchron. Windows-Hosts brauchen zusätzlich NSClient++ oder NCPA. Eigene Checks landen meist als Perl-, Bash- oder Python-Skripte, die eine Person geschrieben hat und sonst niemand versteht.
Ein Capterra-Rezensent von Nagios XI beschrieb das Modell so: Man müsse eine Sammlung von Testskripten zusammenstellen, verteilen und ihre Abhängigkeiten auf jedem verwalteten Node installieren. Bei ein paar hundert Hosts wird die Plugin-Pflege zum Teilzeitjob.
Die Konfiguration steckt in Textdateien
Nagios Core definiert Hosts, Services, Kontakte, Commands und Timeperiods als Objekte in .cfg-Dateien. Einen Server hinzuzufügen heißt: seine Host- und Service-Definitionen schreiben (oder per Template erzeugen), mit nagios -v validieren und neu laden. Eine Erkennung gibt es nicht: Nichts taucht auf, bevor es jemand einträgt.
Das bemängeln Rezensenten mehr als alles andere. Aus den Capterra-Bewertungen zu Nagios Core:
„Es gibt keine automatische Erkennung, jeder Host und jeder Service muss von Hand hinzugefügt werden.“
IT-Administrator, Computerspielebranche
„Damit alles funktioniert, braucht man fortgeschrittene Kenntnisse in der Linux-Administration auf der Kommandozeile und muss Konfigurationsdateien auf der Kommandozeile bearbeiten können.“
Chief Operating Officer
Nagios XI ergänzt einen webbasierten Core Config Manager und Konfigurationsassistenten, was viel davon abnimmt. XI ist aber ein kommerzielles Produkt, und seine kostenlose Edition endet bei 7 Nodes oder 100 Services.
Eine veraltete Oberfläche ohne integrierte Graphen in Core
Die Weboberfläche von Nagios Core besteht aus CGI-Seiten, die fast so aussehen wie vor zehn Jahren. Core kann von sich aus keine Metriken grafisch darstellen: Teams schrauben PNP4Nagios, Graphite oder Grafana an, um einen CPU-Verlauf zu sehen. Ein Nagios-XI-Rezensent auf Capterra brachte es auf den Punkt: „Die UI/UX wirkt im Vergleich zu modernen SaaS-Observability-Plattformen etwas veraltet.“ XI bringt zwar Performance-Graphen mit, Rezensenten beschreiben seine Oberfläche aber trotzdem als veraltet.
Die Alarmierung endet bei Benachrichtigungen
Das ist die Lücke, die am meisten zählt, sobald ein Team Rufbereitschaft hat. Nagios-Benachrichtigungen sind Shell-Befehle (notify-service-by-email), die innerhalb von Timeperiods an Kontakte gehen. Eskalationen gibt es als Konfigurationsobjekte, aber keinen Bereitschaftskalender, keine Rotation, die Sie vom Handy aus ändern können, keine Vertretung für einen Krankheitstag und keinen Quittierungsablauf jenseits der Weboberfläche.
Deshalb hängen die meisten Nagios-Teams ein zweites Tool für die Alarmierung dran: PagerDuty, Opsgenie (das am 5. April 2027 abgeschaltet wird, siehe unseren Leitfaden zur Opsgenie-Abschaltung) oder ein selbstgebautes Skript. Und Kunden erfahren von Ausfällen trotzdem über Support-Tickets, weil Nagios keine öffentliche Statusseite hat. Das sind drei Tools, drei Konfigurationen und drei Stellen, an denen ein Alarm verloren gehen kann.
Lizenzkosten von XI bei wachsender Größe
Nagios Core ist unter GPLv2 kostenlos. Nagios XI Standard ist eine einmalige Lizenz ab 2.595 $ für 100 Nodes und 14.995 $ für 1.000 Nodes, die Enterprise-Funktionen kosten als Add-on extra (ab 4.690 $ für 100 Nodes). Laut der Preisseite von Nagios XI ist ab dem zweiten Jahr ein Wartungs- und Supportvertrag nötig, um die Premium-Funktionen zu behalten. Ein Capterra-Rezensent fasste es so zusammen: „Die Lizenzkosten sind sehr hoch.“
Schnellvergleich: Nagios-Alternativen
| Tool | Einstiegspreis | Hosting | Einrichtungsaufwand | Alarmierung und Rufbereitschaft | Windows-Hosts |
|---|---|---|---|---|---|
| Hyperping | Kostenlos; 24 €/Monat bei jährlicher Abrechnung | Gehostet (SaaS) | Gering: ein Befehl pro Host | Bereitschaftspläne, Eskalationsrichtlinien, Telefon/SMS/Slack/Teams, Statusseiten inklusive | Nativer Agent (Windows 10 / Server 2016+) |
| Icinga | Kostenlos; Subscriptions ab 2.000 $/Jahr | Selbst gehostet | Mittel bis hoch | Regelbasierte Benachrichtigungen; Pläne in Icinga Notifications (Beta) | Icinga for Windows (PowerShell) |
| Checkmk | Community kostenlos; Pro ab 190 €/Monat bei jährlicher Abrechnung | Selbst gehostet oder Cloud | Mittel | Regelbasierte Benachrichtigungen; Alarmierung über Integrationen | Nativer Agent |
| Zabbix | Kostenlos; Cloud ab 50 $/Monat | Selbst gehostet oder Cloud | Mittel bis hoch | Actions mit Eskalationsstufen; kein Bereitschaftskalender | Nativer Agent |
| Prometheus + Grafana | Kostenlos; Grafana Cloud Pro 19 $/Monat + Nutzung | Selbst gehostet oder Grafana Cloud | Hoch | Routing mit Alertmanager; Grafana IRM für Rufbereitschaft (20 $ pro aktivem Nutzer) | windows_exporter |
| Netdata | Kostenlos (5 Nodes); Business 7 $/Node/Monat bei jährlicher Abrechnung | Agent + Netdata Cloud oder On-Premises | Gering | Alarmbenachrichtigungen; keine Bereitschaftsplanung | Nativer Agent |
| Datadog | Kostenlos (5 Hosts); 15 $/Host/Monat jährlich | Gehostet (SaaS) | Gering bis mittel | Monitore + separates On-Call-Produkt (20 $/Nutzerplatz) | Nativer Agent |
| PRTG | Kostenlos (100 Sensoren); 200 $/Monat bei jährlicher Abrechnung | Selbst gehostet (Windows) oder PRTG Hosted Monitor | Mittel | Benachrichtigungs-Trigger; keine Bereitschaftsplanung | Core-Server nur unter Windows |
| LibreNMS | Kostenlos | Selbst gehostet (Linux) | Mittel | Alarmregeln an E-Mail, Slack und mehr; keine Rufbereitschaft | SNMP |
Hyperping: am besten für gehostetes Monitoring mit integrierter Rufbereitschaft und Statusseiten
Für wen Hyperping gemacht ist
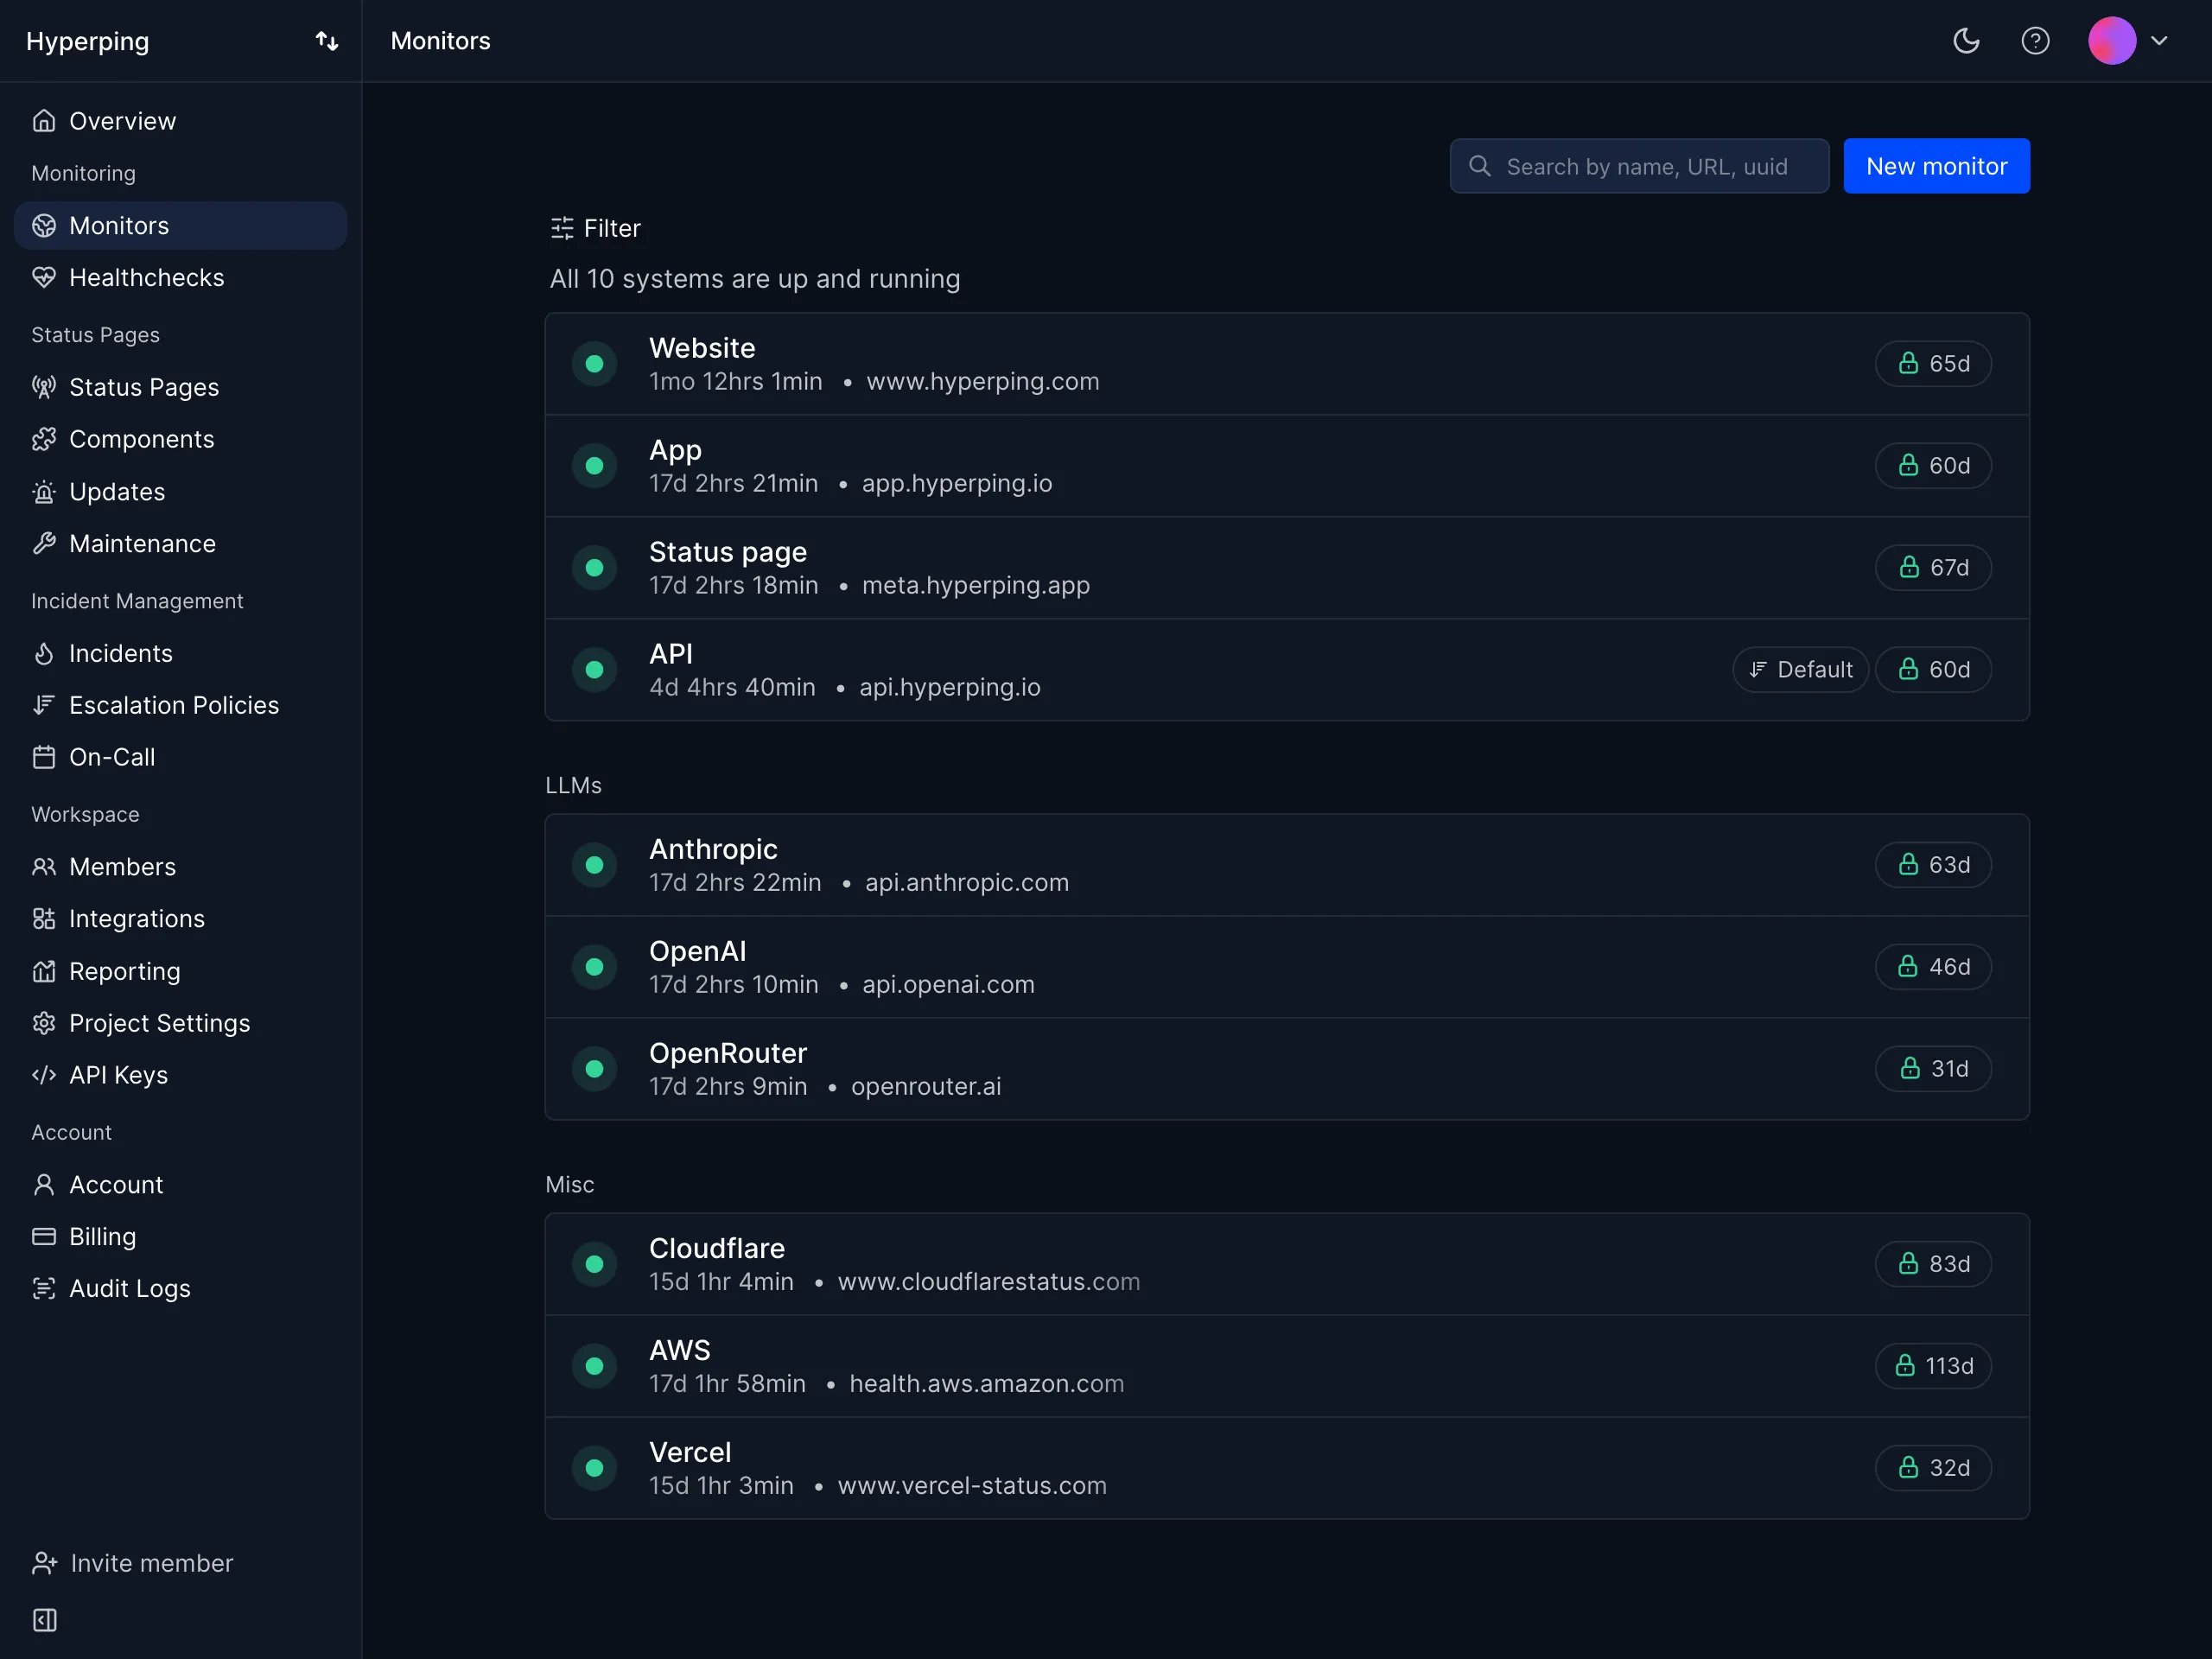
Für Teams mit einigen wenigen bis einigen hundert Servern, die den Monitoring-Server nicht mehr selbst pflegen wollen und deren größte Lücke das ist, was nach einem fehlgeschlagenen Check passiert: Wer wird alarmiert, was passiert, wenn niemand reagiert, und wie erfahren die Kunden davon?
Hyperping ist kein Eins-zu-eins-Ersatz für Nagios. Es führt keine Nagios-Plugins aus und fragt keine Switches per SNMP ab. Es deckt den Teil eines Nagios-Setups ab, den die meisten kleinen und mittleren Teams tatsächlich nutzen (lebt der Host, gehen CPU, Arbeitsspeicher oder Festplatte zur Neige, antwortet der Dienst), und ergänzt die Schicht aus Alarmierung und Statusseite, die Nagios nie hatte.
Wichtige Funktionen
- Einzeiliger Agent für Linux, macOS und Windows: Ein einziger Installationsbefehl registriert einen systemd-, launchd- oder Windows-Dienst. Er läuft auf amd64 und arm64 (unter Windows amd64), zielt auf rund 50 MB Arbeitsspeicher und braucht nur ausgehendes HTTPS. Details stehen in der Referenz zur Agent-Installation.
- Host-Metriken alle 30 Sekunden: CPU-Auslastung mit Load Average über 1, 5 und 15 Minuten, belegter und verfügbarer Arbeitsspeicher, Dateisystembelegung pro Mountpoint, Disk-I/O pro Gerät und Netzwerk-Bytes pro Interface, dazu Host-Metadaten (Betriebssystem, Kernel, CPU-Modell, Uptime). Die vollständige Liste finden Sie unter erfasste Metriken.
- Keine Konfigurationsdateien zu schreiben: Der Server erscheint etwa 30 Sekunden nach der Installation mit seinen Metriken im Dashboard. Mit Flags wie
--name,--policyund--groupregistrieren Ansible oder Terraform eine ganze Flotte vom ersten Lauf an mit der richtigen Eskalationsrichtlinie. - Offline-Erkennung, die die Bereitschaft alarmiert: Meldet sich ein Server länger als sein Offline-Schwellenwert nicht (standardmäßig 90 Sekunden, mindestens 60 Sekunden), wird ein Ausfall eröffnet, und die dem Server zugewiesene Eskalationsrichtlinie alarmiert ihre Kanäle: E-Mail, SMS, Anrufe, Slack, Teams, PagerDuty, OpsGenie, Webhooks oder einen Bereitschaftsplan. Entwarnungen gehen an dieselben Kanäle.
- Bereitschaftspläne und Eskalationsrichtlinien: Ab dem Essentials-Plan enthalten und gemeinsam genutzt von Server-Monitoring und Uptime-Monitoren. Siehe Rufbereitschaft.
- Uptime-Monitore: HTTP-, Port-, Ping- und Keyword-Checks gegen Ihre Dienste von außerhalb Ihres Netzwerks, also dieselbe Aufgabe wie
check_httpundcheck_tcpin Nagios, wenn sie auf Ihre öffentlichen Endpunkte zielen. - Statusseiten: Eine Statusseite mit eigener Domain in Essentials, drei öffentliche oder private Seiten in Pro, mit E-Mail-Abonnenten (und ab Pro SMS-Abonnenten). Siehe Statusseiten.
- Metriken überstehen kurze Netzwerkaussetzer: Der Agent puffert nicht gesendete Daten auf der Festplatte und versucht es erneut, sodass ein kurzer Ausfall der Datenannahme oder ein Neustart keine Lücken in Ihren Graphen hinterlässt.
Warum Hyperping statt Nagios?
Nichts zu hosten, zu patchen oder zu sichern
Nagios braucht einen Server, einen Webserver, eine Reihe von Plugins und jemanden, der das alles aktualisiert. Bei Hyperping ist der Agent das Einzige auf Ihren Hosts, die Monitoring-Seite wird gehostet. Fällt Ihr Nagios-Server aus, verlieren Sie Monitoring und Alarmierung gleichzeitig. Dieses Ausfallszenario entfällt.
Alarmierung und Rotationen gehören zum Produkt
In Nagios heißt eine Rotation: Kontakte und Timeperiods bearbeiten und neu laden. In Hyperping definieren Sie einen Plan und eine Eskalationsrichtlinie einmal, und Server, Uptime-Monitore und Statusseiten laufen alle darüber. Jede Stufe der Richtlinie hat ihre eigene Verzögerung und eigene Kanäle, sodass ein unbeantworteter Alarm an die nächste Person weitergeht. Unser Leitfaden zu Eskalationsrichtlinien und unser Leitfaden zu Bereitschaftsrotationen zeigen, wie Sie sie aufbauen.
Kunden erfahren von Incidents durch Sie
Nagios hat keine Statusseite. Mit Hyperping lässt sich der Incident, der Ihren Entwickler alarmiert hat, auf einer Statusseite in Ihrem Branding veröffentlichen, die Abonnenten per E-Mail benachrichtigt, ohne zweites Tool.
Wenn Ihr Nagios-Setup auf „sag mir, wenn eine Kiste stirbt, und weck die richtige Person“ geschrumpft ist und die PagerDuty-Rechnung plus die Nagios-Pflege mehr kosten, als die Checks wert sind, dann ist der Punkt erreicht, an dem es mehr Sinn ergibt, sich alarmieren zu lassen, wenn ein Server verstummt, ohne einen Monitoring-Server zu betreiben, als den Stack weiter selbst zu pflegen.
Was echte Hyperping-Nutzer sagen
„Wir haben unsere Hyperping-Statusseite öffentlich gemacht, und sie ist zu einem entscheidenden Teil unserer Verkaufsgespräche geworden. Wir sind stolz auf unsere Uptime und lieben es, dass wir sie so einfach mit Interessenten und Kunden teilen können.“
Was kostet Hyperping?
- Free: 1 Server-Monitoring-Agent, 20 Monitore mit Checks alle 5 Minuten, 1 einfache Statusseite
- Essentials: 24 €/Monat bei jährlicher Abrechnung (29 € monatlich) für 5 Server-Agents, 50 Monitore, 3 Browser-Checks, 1 Statusseite mit eigener Domain, Rufbereitschaft und Eskalationsrichtlinien, Alarme per Anruf, 3 Nutzerplätze
- Pro: 74 €/Monat bei jährlicher Abrechnung (89 € monatlich) für 20 Server-Agents, 250 Monitore, 3 öffentliche oder private Statusseiten, SMS-Abonnenten, SAML SSO für das Konto, 10 Nutzerplätze
- Business: 249 €/Monat bei jährlicher Abrechnung (299 € monatlich) für 100 Server-Agents, 1.000 Monitore, 10 Statusseiten, White-Labeling, Audit-Logs, 20 Nutzerplätze
Server-Alarmierung ist in allen kostenpflichtigen Plänen enthalten, und es gibt eine 14-tägige kostenlose Testphase. Wie lange Metriken aufbewahrt werden, hängt vom Plan ab: 7 Tage in 1-Minuten-Auflösung und 6 Monate stündlich in Essentials, bis zu 30 Tage in 1-Minuten-Auflösung und 13 Monate stündlich in Business.
Wo Hyperping an Grenzen stößt
Noch keine Schwellenwert-Alarme auf Metrikwerte. Hyperping alarmiert Sie, wenn ein Server sich nicht mehr meldet. Es alarmiert derzeit nicht, wenn die CPU 90 % überschreitet oder eine Festplatte 85 % erreicht: Sie sehen das im Dashboard, aber es eröffnet keinen Incident. Wenn die Warnungen von check_disk in Nagios zentral für Ihre Arbeit sind, lassen Sie sie vorerst weiterlaufen oder wählen Sie Checkmk oder Zabbix.
Keine Plugins oder eigenen Checks auf dem Host. Sie können Hyperping nicht auf ein Nagios-Plugin, einen RAID-Controller-Check oder ein eigenes Skript ansetzen. Der Agent erfasst einen festen Satz an Systemmetriken.
Metriken, die es heute nicht erfasst: CPU und Arbeitsspeicher pro Prozess, Swap-Nutzung, Paketfehler und Zähler für Disk-Operationen.
Kein SNMP, keine Netzwerkgeräte, keine selbst gehostete Edition. Switches, Router, Drucker und USVs liegen außerhalb des Umfangs, und Hyperping lässt sich nicht in einem Air-Gapped-Netz betreiben. Dafür passen LibreNMS, PRTG oder Zabbix besser.
Ist Hyperping das Richtige für Sie?
Wählen Sie Hyperping, wenn Ihre Flotte aus Linux-, macOS- oder Windows-Servern statt aus Netzwerkgeräten besteht, wenn sich niemand mehr um den Nagios-Server kümmern will und wenn Sie derzeit für ein separates Alarmierungs-Tool und eine Statusseite zahlen. Teams mit großen Investitionen in Plugins oder SNMP-lastigen Umgebungen sollten sich zuerst Icinga, Checkmk oder LibreNMS ansehen.
Icinga: am besten als direkter Open-Source-Ersatz
Für wen Icinga gemacht ist
Für Teams mit jahrelang gewachsener Nagios-Konfiguration und eigenen Plugins, die eine moderne Engine wollen, ohne ihre Checks neu zu schreiben. Icinga begann 2009 als Fork von Nagios, und Icinga 2 wurde mit eigener Konfigurationssprache neu gebaut, blieb aber kompatibel zur Plugin-API von Nagios.
Wichtige Funktionen
- Führt Nagios-Plugins unverändert aus: Ihre
check_*-Skripte und die Monitoring Plugins funktionieren weiter. - Saubere Konfigurations-DSL: Apply-Regeln weisen Hosts anhand von Attributen Services zu, sodass eine Regel Hunderte Service-Definitionen ersetzt.
- Icinga Director: Eine Weboberfläche für die Konfiguration, mit Importen aus CMDBs und Cloud-APIs.
- REST-API und natives Clustering: Verteiltes Monitoring über Zonen und Satelliten ohne Add-ons.
- Icinga for Windows: Ein PowerShell-basiertes Framework zur Überwachung von Windows-Hosts.
- Icinga Notifications: Eine neuere Komponente mit Plänen aus Rotationen und Eskalationen, die nach Alter oder Schweregrad eines Incidents ausgelöst werden. Mit dem Release 0.2.0 (November 2025) trug sie noch das Label Beta.
Was kostet Icinga?
Die Open-Source-Edition ist kostenlos, ohne Limit bei Hosts und Services. Kostenpflichtige Subscriptions laut Subscription-Seite von Icinga:
- Module Subscription: 2.000 $/Jahr (2.000 € in Europa) für Enterprise-Module
- Repository Subscription: 5.000 $/Jahr für Pakete für RHEL, SLES und Amazon Linux
- Support Subscription: ab 15.000 $/Jahr, inklusive Modulen und Repository-Zugang
Zu bedenken
Icinga nimmt Ihnen den größten Konfigurationsschmerz von Nagios ab, aber Sie hosten, skalieren und aktualisieren weiterhin alles selbst: den Core, die Datenbank, den Web-Stack und den Director. Benachrichtigungspläne sind erst vor Kurzem und als Beta dazugekommen, deshalb leiten die meisten Icinga-Teams Alarme weiterhin in ein separates Alarmierungs-Tool. Eine öffentliche Statusseite gibt es nicht.
Für wen sich Icinga lohnt
Wählen Sie Icinga, wenn Ihre Checks Ihr wichtigstes Kapital sind und Sie jeden einzelnen behalten wollen, aber eine bessere Engine, API und Oberfläche bekommen möchten. Es ist der kleinste Schritt weg von Nagios.
Checkmk: am besten für Nagios-Kompatibilität mit automatischer Erkennung
Für wen Checkmk gemacht ist
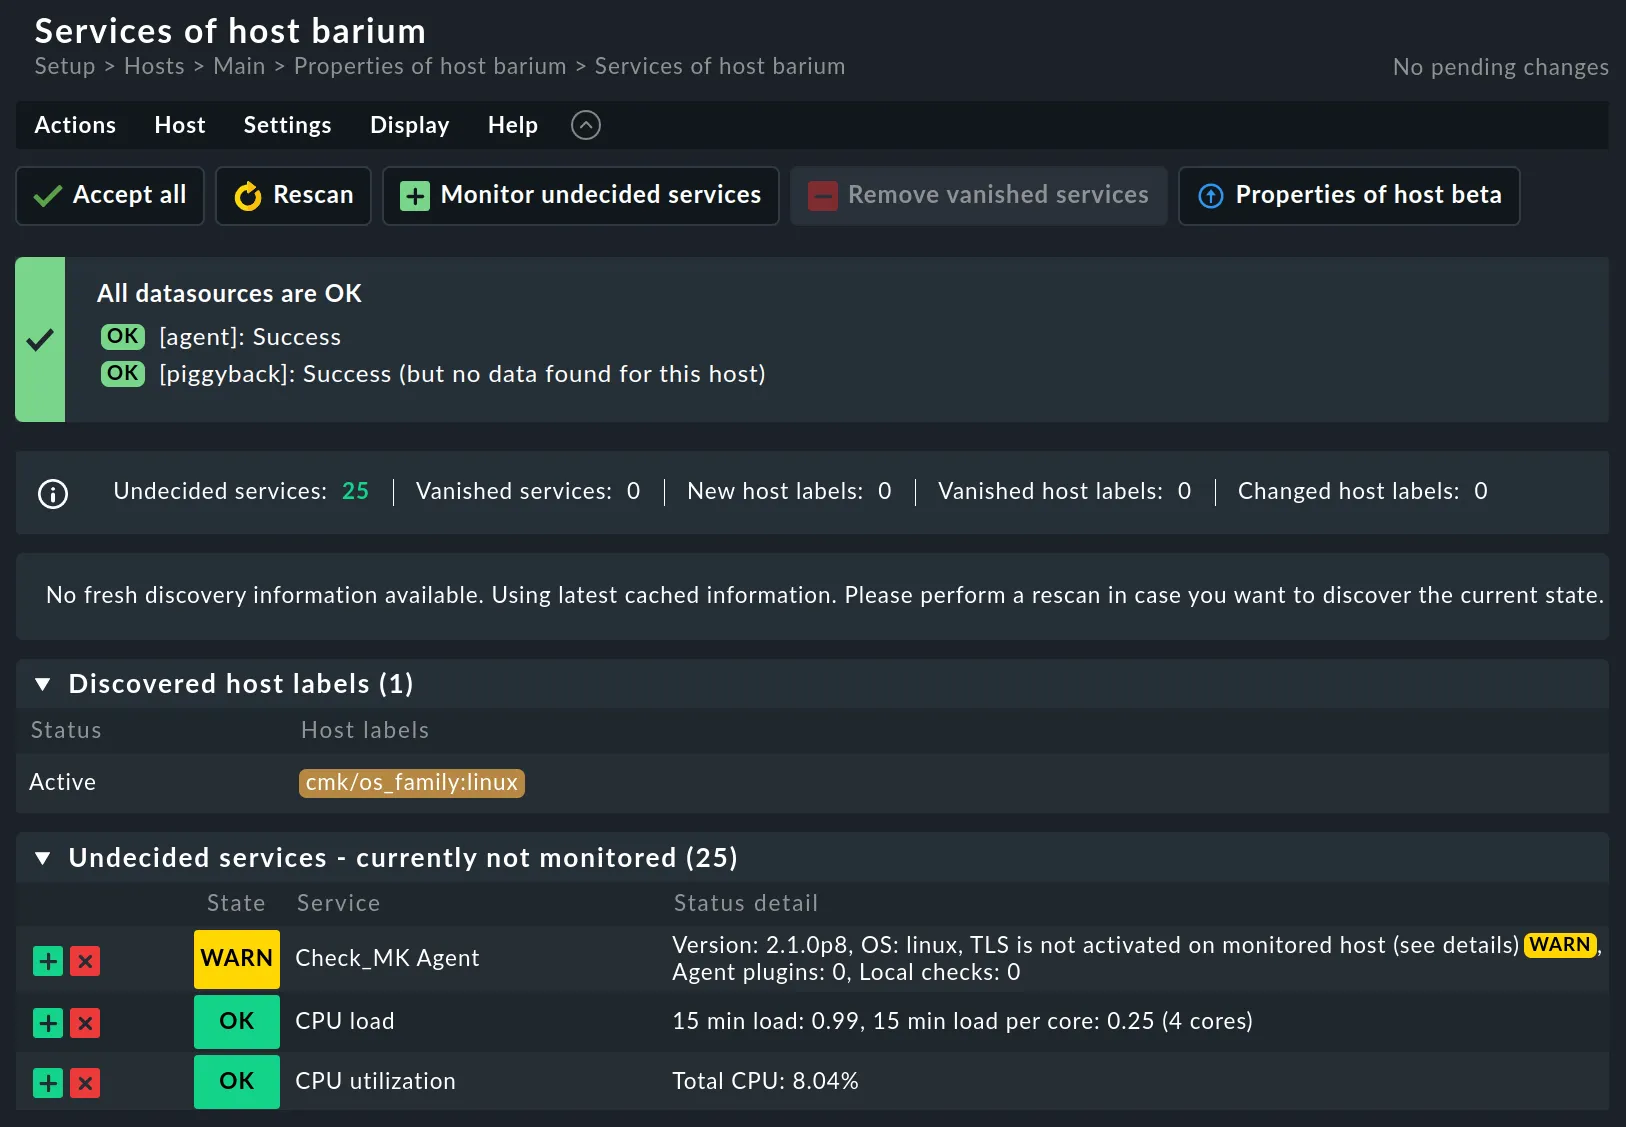
Für Ops-Teams, die das Check-Modell von Nagios mögen, aber keine Lust mehr haben, Konfiguration zu schreiben. Checkmk ist aus dem Nagios-Ökosystem hervorgegangen, und seine kostenlose Edition nutzte lange den Nagios-Core als Engine. Seine Agents erkennen die Services auf jedem Host automatisch.
Wichtige Funktionen
- Automatische Service-Erkennung: Agent installieren, Erkennung starten, und Dateisysteme, Interfaces, Dienste und Prozesse erscheinen als Checks.
- Regelbasierte Konfiguration im Web: Schwellenwerte und Benachrichtigungsregeln werden in der Oberfläche festgelegt und gelten für Ordner oder Host-Tags statt für einzelne Objekte.
- Unterstützung für Nagios-Plugins: Bestehende Plugins laufen als „klassische“ Checks neben den eigenen Checks von Checkmk.
- Native Agents für Linux und Windows, dazu SNMP für Netzwerkgeräte.
- Checkmk Cloud: Eine verwaltete SaaS-Edition, wenn Sie den Server nicht selbst betreiben wollen.
Ab Version 2.5 wurden die Editionen umbenannt: Raw heißt jetzt Community, Enterprise heißt Pro und Cloud heißt Ultimate, dazu kommt die separate gehostete Checkmk Cloud.
Was kostet Checkmk?
Laut Preisseite von Checkmk, mit Preisen pro Service (grob 30 Services pro Host):
- Community: kostenlos und Open Source, gedacht für bis zu etwa 100 Hosts
- Pro (selbst gehostet): ab 190 €/Monat bei jährlicher Abrechnung
- Ultimate (selbst gehostet): ab 275 €/Monat bei jährlicher Abrechnung
- Checkmk Cloud (SaaS): 240 €/Monat bei monatlicher Abrechnung für 1.000 Services oder 2.400 €/Jahr (etwa 200 €/Monat) bei jährlicher Abrechnung
Zu bedenken
Preise pro Service bedeuten, dass Ihre Rechnung mit der Zahl der Dinge wächst, die auf jedem Host erkannt werden, nicht nur mit der Zahl der Hosts. Der Checkmk-Server läuft nur unter Linux. Die Benachrichtigungen sind mächtig, aber regelgesteuert, und Bereitschaftsrotationen kommen weiterhin aus einer Integration wie PagerDuty oder ilert statt aus Checkmk selbst.
Für wen sich Checkmk lohnt
Wählen Sie Checkmk, wenn Sie die Nagios-Denkweise (Zustände, Checks, Schwellenwerte, Plugins) behalten wollen, mit deutlich weniger handgeschriebener Konfiguration. Für gemischte Umgebungen aus Linux, Windows und Netzwerk mit 50 bis mehreren tausend Hosts ist es der vollständigste Umstiegspfad von Nagios.
Zabbix: am besten als kostenlose Komplettplattform
Für wen Zabbix gemacht ist
Für Infrastruktur-Teams, die ein einziges Open-Source-System für Server, Netzwerkgeräte, VMs und Anwendungen wollen und bereit sind, ihr Monitoring rund um Templates neu aufzubauen, statt Nagios-Plugins einzeln zu portieren.
Wichtige Funktionen
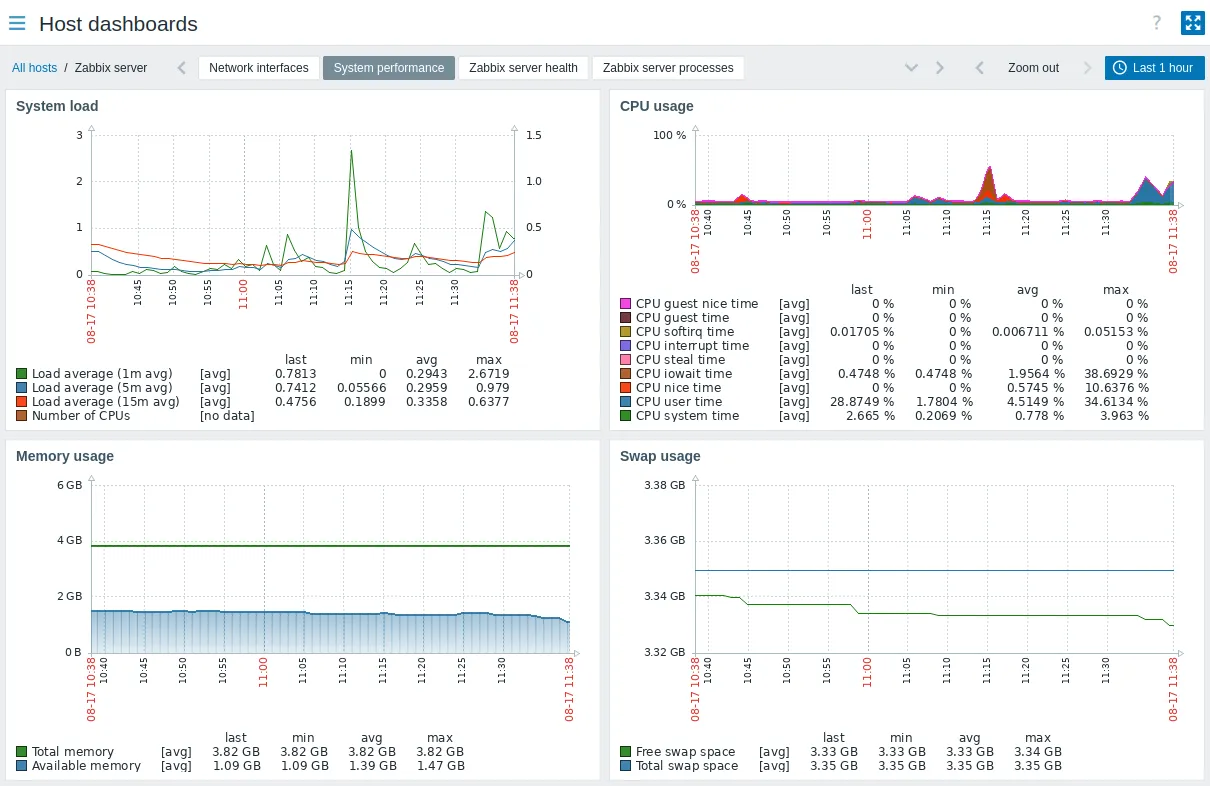
- Templates für Hunderte Geräte und Anwendungen: Linux, Windows, MySQL, VMware, Cisco und mehr, mit vordefinierten Items, Triggern und Graphen.
- Low-Level Discovery: Dateisysteme, Interfaces und Dienste auf jedem Host werden automatisch erkannt und überwacht.
- Trigger mit Ausdrücken: Bedingungen für Schwellenwerte, Trends und Anomalien, ausgewertet auf dem Server.
- Actions mit Eskalationsstufen: Eine Nachricht senden, warten, dann eine andere Gruppe benachrichtigen oder einen Remote-Befehl ausführen.
- Native Agents für Linux und Windows, dazu SNMP, IPMI und agentenlose Checks.
Was kostet Zabbix?
Zabbix ist kostenlos und Open Source: GPLv2 bis 6.4 und AGPLv3 ab Version 7.0. Zabbix Cloud beginnt bei 50 $/Monat (Nano-Tarif, 50 neue Werte pro Sekunde) und reicht bis 5.000 $/Monat, mit einer 5-tägigen Testphase. Kommerzielle Support-Subscriptions gibt es auf Anfrage bei Zabbix.
Zu bedenken
Zabbix ist datenbanklastig: Bei größerem Umfang tunen Sie MySQL oder PostgreSQL (oft mit TimescaleDB) und das Housekeeping. Das Modell aus Templates und Triggern hat seine eigene Lernkurve, und Nagios-Plugins lassen sich nicht direkt übernehmen. Eskalationen gibt es innerhalb von Actions, aber keinen Bereitschaftskalender und keine öffentliche Statusseite.
Für wen sich Zabbix lohnt
Wählen Sie Zabbix, wenn Sie ein kostenloses, selbst gehostetes Tool wollen, das Server und Netzwerkgeräte mit Schwellenwerten und Trends abdeckt, und jemanden haben, der sich um Datenbank und Templates kümmern kann.
Prometheus + Grafana: am besten für Cloud-native und Container-Stacks
Für wen Prometheus gemacht ist
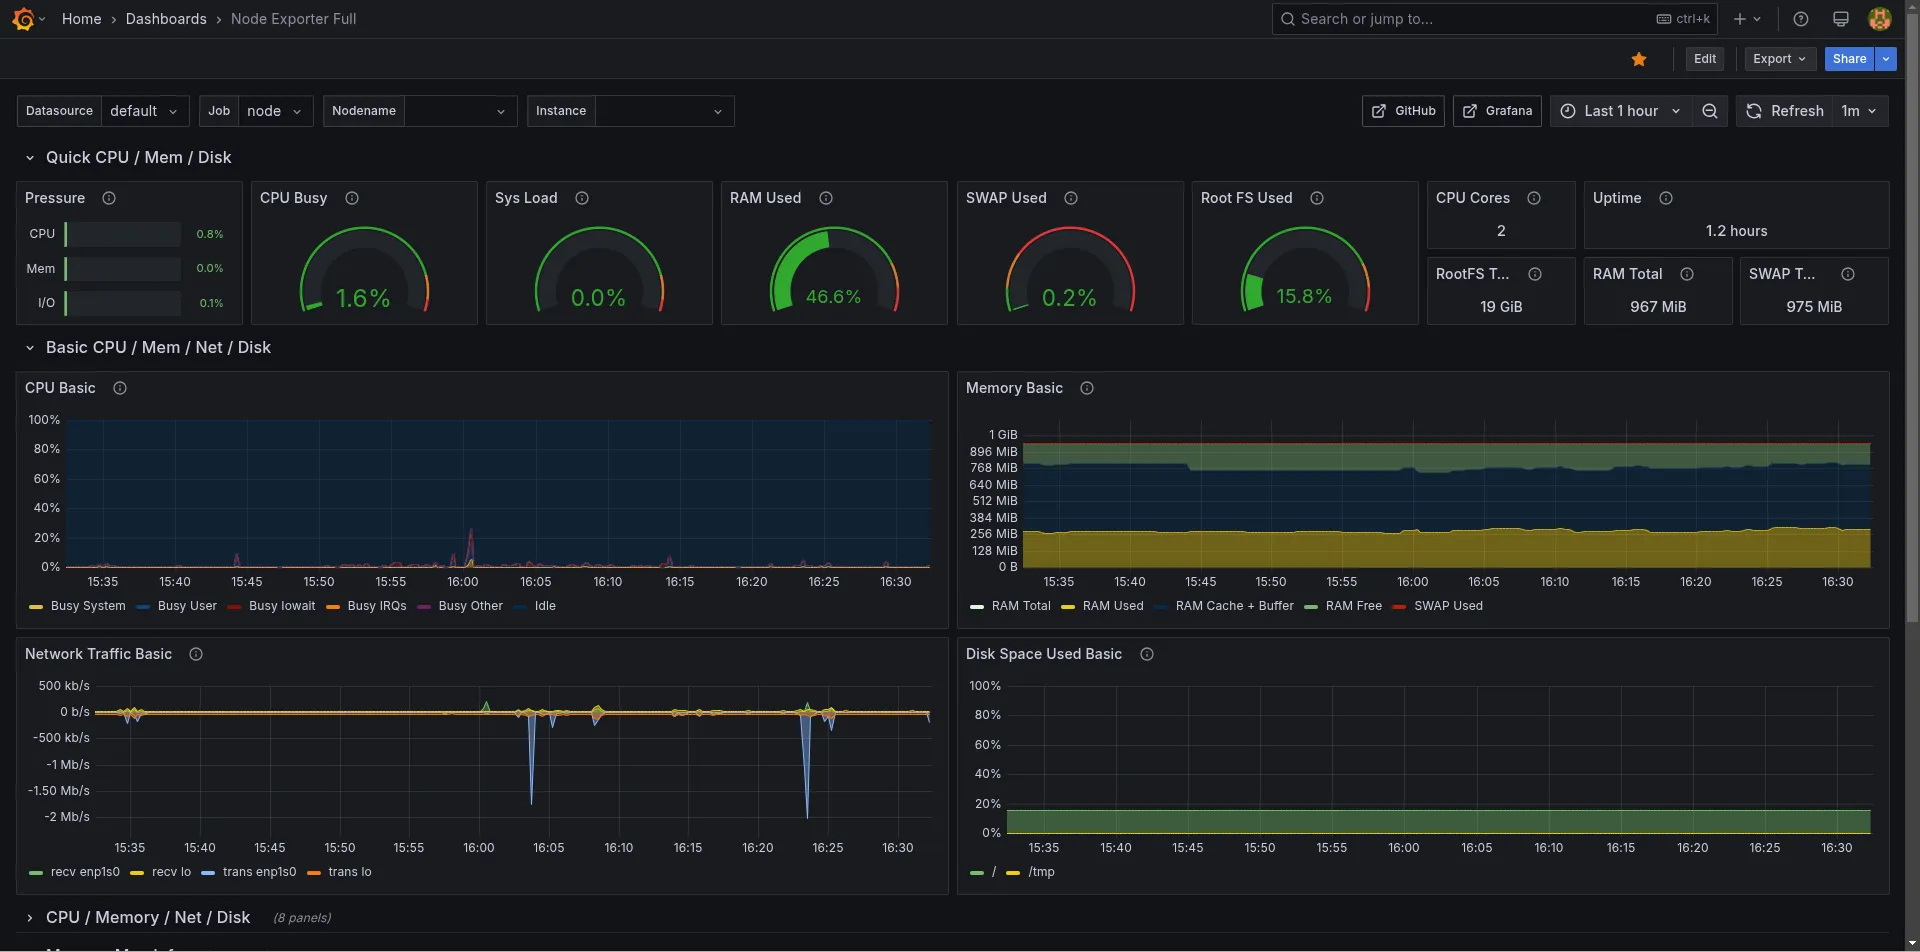
Für Teams mit Kubernetes, Containern oder Microservices, bei denen Hosts kommen und gehen und eine statische Liste von Nagios-Host-Definitionen nicht mithalten kann. Prometheus holt Metriken von Exportern und Diensten ab, Grafana visualisiert sie, und Alertmanager leitet Alarme weiter.
Wichtige Funktionen
- Pull-basierte Metriken mit Service Discovery: Ziele werden aus Kubernetes, Consul, EC2 und anderen Quellen erkannt, statt von Hand eingetragen zu werden.
- PromQL: Eine Abfragesprache, die Rohmetriken in Raten, Perzentile und Alarmbedingungen verwandelt.
- Exporter für alles:
node_exporterfür Linux-Hosts,windows_exporterfür Windows und Exporter für Datenbanken, Queues und Hardware. - Alertmanager: Gruppierung, Unterdrückung (Inhibition), Silences und Routing an Empfänger.
- Grafana-Dashboards: Der De-facto-Standard für die Visualisierung von Metriken.
Was kostet es?
Prometheus (Apache 2.0) und Grafana (AGPLv3) lassen sich kostenlos selbst hosten. Grafana Cloud hat einen Free-Tarif mit 10.000 aktiven Metrik-Serien, 50 GB Logs, 3 aktiven Nutzern und 14 Tagen Aufbewahrung. Der Pro-Tarif kostet 19 $/Monat Plattformgebühr plus Nutzung. Die Rufbereitschaft steckt in Grafana IRM: kostenlos für 3 aktive IRM-Nutzer, danach 20 $ pro aktivem IRM-Nutzer und Monat.
Zu bedenken
Das ist ein Stack, kein Produkt. Sie betreiben und skalieren Prometheus (plus Thanos, Mimir oder VictoriaMetrics für die Langzeitspeicherung), pflegen Exporter und schreiben PromQL für jeden Alarm. Prometheus ist für Metriken gebaut, deshalb brauchen Checks vom Typ „antwortet dieser Dienst?“ den Blackbox-Exporter. Alertmanager leitet Alarme weiter, hat aber weder Pläne noch eine Eskalation an eine zweite Person, weshalb Grafana IRM separat verkauft wird.
Für wen sich Prometheus + Grafana lohnt
Wählen Sie diesen Stack, wenn Ihre Workloads in Containern laufen, Ihre Entwickler schon PromQL lesen und Sie metrikbasiertes Monitoring wollen, das dynamischer Infrastruktur folgt. Für eine statische Flotte von VMs ist es meist mehr Maschinerie, als das Problem verlangt. Einen direkten Vergleich finden Sie unter Datadog vs. Grafana Cloud.
Netdata: am besten für Metriken im Sekundentakt fast ohne Einrichtung
Für wen Netdata gemacht ist
Für Entwickler, die etwas installieren und sofort detaillierte Metriken eines Hosts sehen wollen, ohne eine Zeile Konfiguration zu schreiben. Der Agent von Netdata erkennt Dienste automatisch und erfasst jede Sekunde Metriken.
Wichtige Funktionen
- Erfassung im Sekundentakt mit Tausenden automatisch erkannten Metriken auf jedem Host.
- Dashboards ohne Konfiguration für den Host und die Anwendungen, die der Agent findet.
- Integrierte ML-Anomalieerkennung auf jeder Metrik.
- Nativer Windows-Agent neben Linux, macOS und Containern.
- Hunderte vorkonfigurierte Alarme, die mit dem Agent ausgeliefert werden.
Was kostet Netdata?
Laut Preisseite von Netdata:
- Community: kostenlos, begrenzt auf 5 aktive verbundene Nodes und 1 eigenes Dashboard pro Room
- Homelab: 90 $/Jahr mit unbegrenzten Nodes im Rahmen einer Fair-Use-Regel
- Business: 7 $/Node/Monat bei jährlicher Abrechnung (8,75 $ monatlich), mit RBAC, SSO, unbegrenzten Dashboards und Netdata AI
- Enterprise: individuelle Preise ab 500 Nodes, mit On-Premises-Option
Zu bedenken
Der Agent selbst steht unter GPLv3, das volle Erlebnis gibt es aber erst in Netdata Cloud, und die Grenze von 5 Nodes im Free-Tarif ist für einen Nagios-Ersatz knapp. Unter Windows ist laut Netdata-Dokumentation das lokale Dashboard im kostenlosen Community-Tarif gesperrt, Sie sehen die Daten also in Netdata Cloud. Alarme benachrichtigen Kanäle, aber es gibt weder Bereitschaftsplanung noch Statusseite.
Für wen sich Netdata lohnt
Wählen Sie Netdata, wenn Sie zur Fehlersuche tiefe Echtzeit-Einblicke in einzelne Hosts wollen und mit einem Abo pro Node leben können, sobald Sie mehr als 5 Nodes haben.
Datadog: am besten für vollständige Observability

Für wen Datadog gemacht ist
Für Engineering-Organisationen, die Infrastrukturmetriken, APM, Distributed Tracing, Logs und synthetisches Monitoring an einem Ort zusammenführen müssen und das Budget für Preise pro Host, pro GB und pro Nutzerplatz haben.
Wichtige Funktionen
- Infrastruktur-Monitoring mit über 1.000 Integrationen und 15 Monaten Metrik-Aufbewahrung in Pro.
- APM, Logs, RUM und synthetisches Monitoring auf derselben Plattform.
- Datadog On-Call für Pläne und Eskalationen, abgerechnet pro Nutzerplatz.
- Status Pages als Teil der Incident-Response-Suite von Datadog.
- Native Agents für Linux, Windows, macOS und Container.
Was kostet Datadog?
Laut Preisseite von Datadog:
- Free: bis zu 5 Hosts mit 1 Tag Metrik-Aufbewahrung
- Infrastructure Pro: 15 $/Host/Monat bei jährlicher Abrechnung, 18 $ bei Abrechnung nach Bedarf
- Infrastructure Enterprise: 23 $/Host/Monat bei jährlicher Abrechnung, 27 $ bei Abrechnung nach Bedarf
- On-Call: 20 $/Nutzerplatz/Monat im Jahresvertrag, zusätzlich zur Infrastruktur
Zu bedenken
Datadog ersetzt Nagios und mehrere andere Tools auf einmal, aber die Rechnung ist die Summe aus Hosts, Custom Metrics, Log-Ingestion und Indexierung, synthetischen Läufen und Nutzerplätzen. Teams, die vom kostenlosen Nagios Core kommen, können den Sprung für ein „ist der Host gesund?“-Monitoring oft schwer rechtfertigen. Unser Vergleich Hyperping vs. Datadog und unser Leitfaden zu Datadog-Alternativen gehen auf die Zahlen ein.
Für wen sich Datadog lohnt
Wählen Sie Datadog, wenn Sie APM und Logs neben Host-Metriken brauchen und Ihr Team sie auch wirklich nutzt. Wenn Sie nur Host-Zustand und Alarmierung brauchen, bezahlen Sie viel Plattform, die Sie nie anfassen.
PRTG: am besten für einen Monitoring-Server unter Windows
Für wen PRTG gemacht ist
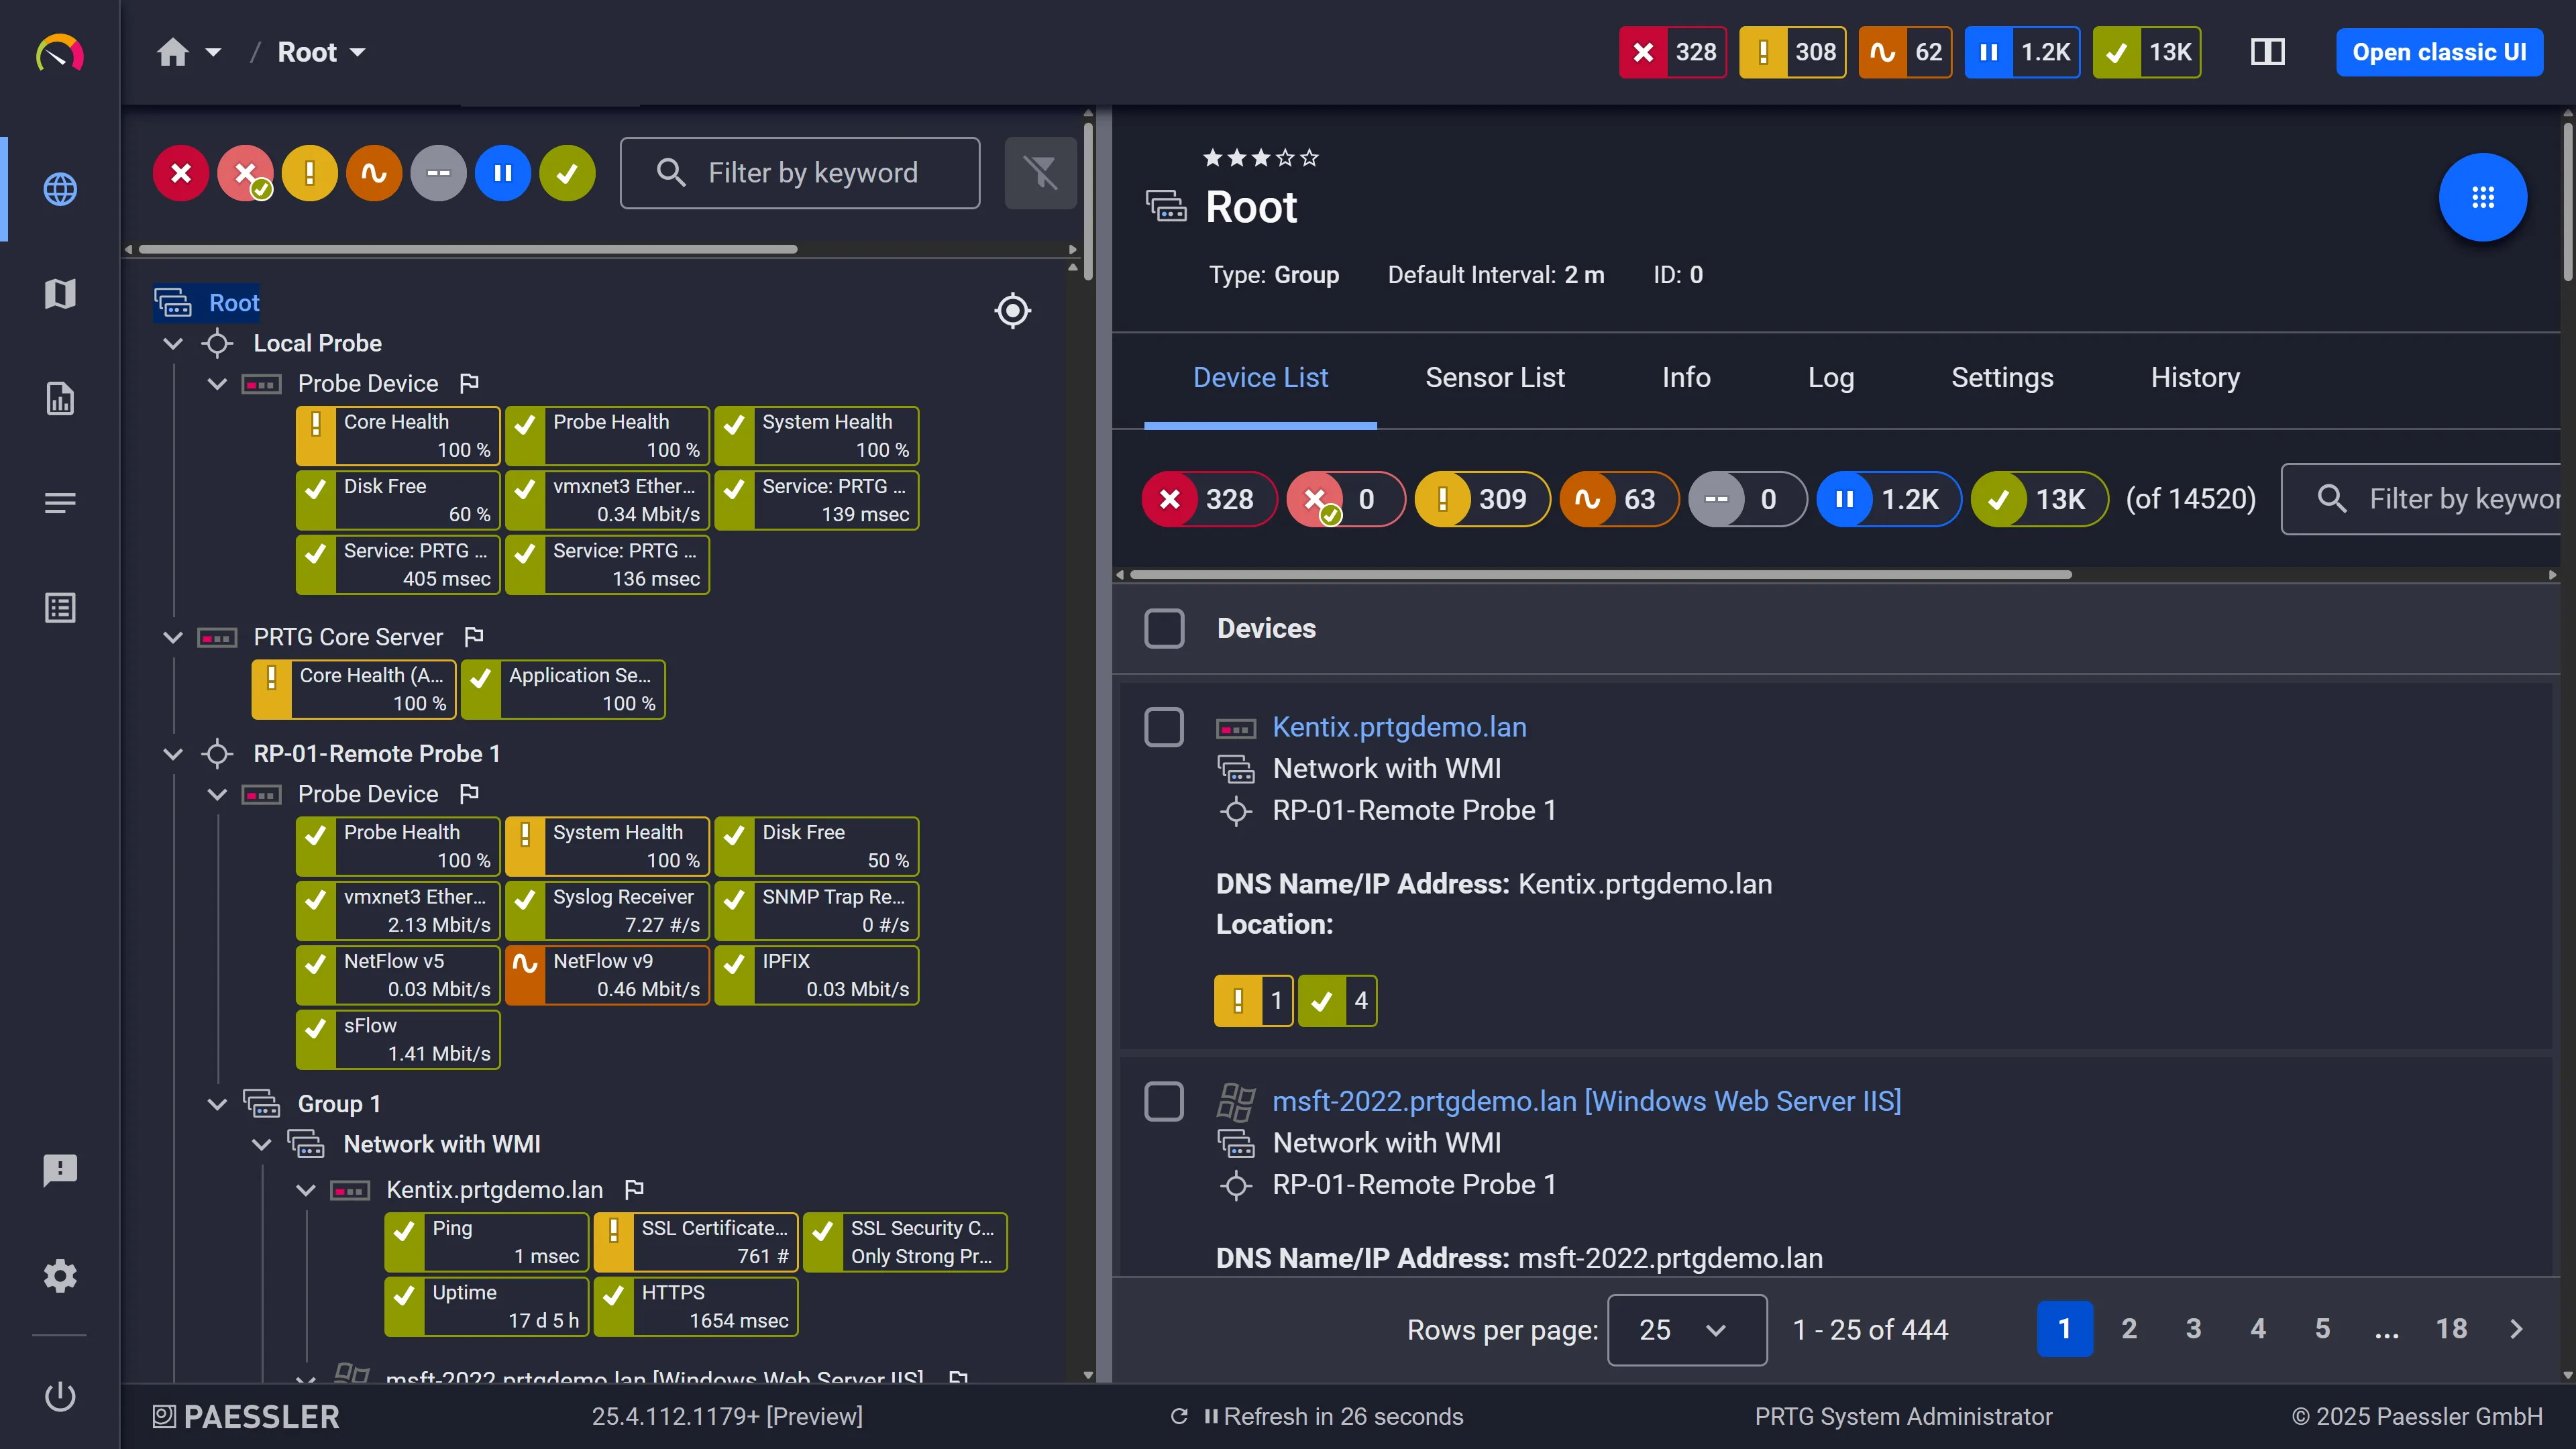
Für Windows-zentrierte IT-Abteilungen, die einen Monitoring-Server auf Windows Server installieren wollen, mit einer GUI für alles und starker Netzwerkabdeckung (SNMP, NetFlow, WMI).
Wichtige Funktionen
- Sensorbasiertes Modell: Jede Metrik eines Geräts (CPU, ein Port, ein Dienst) ist ein Sensor, mit vordefinierten Sensortypen.
- Automatische Erkennung von Geräten in einem Netzwerkbereich.
- Agentenloses Windows-Monitoring über WMI und Leistungsindikatoren.
- Maps und Dashboards, erstellt in der Weboberfläche.
- Remote Probes, darunter eine plattformübergreifende Probe für Linux, um entfernte Standorte zu überwachen.
Was kostet PRTG?
Laut Preisseite von Paessler, alle Abos bei jährlicher Abrechnung:
- Freeware: bis zu 100 Sensoren (etwa 10 Geräte)
- PRTG 500: 200 $/Monat (500 Sensoren, rund 50 Geräte)
- PRTG 1000: 358 $/Monat
- PRTG 2500: 742 $/Monat
- PRTG 10000: 1.642 $/Monat
Ab 1.000 Geräten verweist Paessler auf PRTG Enterprise Monitor. Eine gehostete Version, PRTG Hosted Monitor, gibt es ebenfalls.
Zu bedenken
Der Core-Server von PRTG läuft nur unter Windows (Windows Server 2016 bis 2025, Windows 10 und 11). Die Sensorzählung summiert sich schnell: Ein Server mit CPU, Arbeitsspeicher, Festplatte, Netzwerk und ein paar Diensten kann 10 Sensoren belegen. Benachrichtigungs-Trigger können eskalieren, indem sie wiederholen oder andere Kontakte ansprechen, aber es gibt weder Bereitschaftsplanung noch öffentliche Statusseite.
Für wen sich PRTG lohnt
Wählen Sie PRTG, wenn Ihr Team Windows-Infrastruktur betreibt, alles über eine GUI konfigurieren will und neben Servern viel Netzwerk-Equipment überwacht.
LibreNMS: am besten für Netzwerk-Monitoring per SNMP
Für wen LibreNMS gemacht ist
Für Netzwerk-Teams, die Nagios vor allem zur Überwachung von Switches, Routern, Firewalls und Access Points genutzt haben und automatische Erkennung und Graphen pro Port wollen, ohne Service-Definitionen zu schreiben.
Wichtige Funktionen
- Automatische Netzwerkerkennung über CDP, FDP, LLDP, OSPF, BGP, SNMP und ARP.
- Breite Herstellerunterstützung für Netzwerk-Betriebssysteme, mit Graphen zu Traffic, Fehlern pro Port und Gerätezustand.
- Alarmregeln mit Transports zu E-Mail, Slack, IRC und vielen weiteren Kanälen.
- Verteiltes Polling für große Netzwerke.
- Docker-Images für eine schnellere Einrichtung.
Was kostet LibreNMS?
LibreNMS ist kostenlos und Open Source unter GPLv3. Eine kostenpflichtige Edition gibt es nicht. Support kommt aus der Community.
Zu bedenken
LibreNMS konzentriert sich auf Netzwerkgeräte. Es kann Server per SNMP überwachen und führt Nagios-Plugins über eine Services-Integration aus, ist aber nicht die naheliegende Wahl für Alarmierung auf Anwendungs- oder Host-Ebene. Sie hosten es selbst unter Linux, und es gibt weder Bereitschaftsplanung noch Statusseite.
Für wen sich LibreNMS lohnt
Wählen Sie LibreNMS, wenn der Großteil Ihrer Nagios-Konfiguration aus Switches und Routern bestand. Kombinieren Sie es für Ihre Hosts mit einem serverorientierten Tool.
Open-Source-Alternativen zu Nagios
Wenn Open Source eine Voraussetzung ist, unterscheiden sich die Optionen vor allem in der Lizenz und darin, wie viel Ihrer Nagios-Arbeit Sie mitnehmen können:
| Tool | Lizenz | Nutzt Nagios-Plugins weiter? | Stärke |
|---|---|---|---|
| Icinga 2 | GPLv2 | Ja, unverändert | Direkter Ersatz mit API und Clustering |
| Checkmk Community | GPLv2 | Ja, als klassische Checks | Automatische Erkennung und regelbasierte Konfiguration |
| Zabbix | AGPLv3 (7.0+) | Nicht direkt (über externe Skripte) | Komplettlösung mit Templates und Triggern |
| Prometheus + Grafana | Apache 2.0 / AGPLv3 | Nein (stattdessen Exporter) | Metriken für dynamische, containerisierte Stacks |
| LibreNMS | GPLv3 | Teilweise, über Services | Netzwerkerkennung und Graphen per SNMP |
| Netdata-Agent | GPLv3 | Nein | Host-Metriken im Sekundentakt ohne Konfiguration |
Bei allen sollten Sie zwei Dinge einplanen. Erstens hängt die Verfügbarkeit Ihres Monitorings dann an Ihnen: Fallen der Monitoring-Server, seine Datenbank oder sein Netzwerkpfad aus, wird niemand alarmiert. Zweitens bringt keines dieser Projekte eine öffentliche Statusseite mit, und nur Icinga (als Beta) und Grafana (als kostenpflichtiges Cloud-Add-on) bieten Bereitschaftspläne. Planen Sie ein Budget für ein Alarmierungs-Tool ein, auch wenn das Monitoring kostenlos ist.
Kostenlose Nagios-Alternativen
„Kostenlos“ bedeutet hier zwei verschiedene Dinge: kostenlose Software, die Sie selbst hosten, oder ein gehosteter Free-Tarif mit Grenzen.
Kostenlos selbst zu hosten, ohne Host-Limit: Icinga 2, Zabbix, Prometheus + Grafana und LibreNMS. Checkmk Community ist ebenfalls kostenlos, gedacht für bis zu etwa 100 Hosts. Die Kosten sind der Server, der Speicher und die Arbeitsstunden.
Gehostete Free-Tarife:
- Hyperping Free: 1 Server-Agent, 20 Monitore mit Checks alle 5 Minuten, 1 einfache Statusseite
- Netdata Community: 5 aktive Nodes
- Datadog: 5 Hosts mit 1 Tag Metrik-Aufbewahrung
- Grafana Cloud Free: 10.000 aktive Serien, 3 Nutzer, 14 Tage Aufbewahrung, 3 IRM-Nutzer
- PRTG Freeware: 100 Sensoren (selbst gehostet unter Windows)
- Nagios XI Free: 7 Nodes oder 100 Services
Für eine Handvoll Server haben Sie mit einem gehosteten Free-Tarif in wenigen Minuten ein Monitoring. Darüber hinaus sind die Open-Source-Tools nur in der Lizenz kostenlos.
Nagios-Alternativen für Windows
Windows taucht in Suchanfragen auf zwei Arten auf: den Monitoring-Server unter Windows betreiben oder Windows-Hosts überwachen.
Den Monitoring-Server unter Windows betreiben. Nagios Core läuft nicht unter Windows, ebenso wenig der Core von Icinga, der Server von Checkmk, der Zabbix-Server oder LibreNMS (alle Linux). PRTG ist die wichtigste Option, deren Server für Windows gebaut ist, und läuft auch nur dort. Gehostete Tools (Hyperping, Datadog, Netdata Cloud, Grafana Cloud) umgehen die Frage, weil kein Server zu installieren ist.
Windows-Hosts überwachen. Mit Nagios heißt das: NSClient++ oder NCPA auf jeder Maschine plus Plugins auf der Nagios-Seite. Die Alternativen sind einfacher:
- Hyperping: Der Agent wird unter Windows 10 oder Windows Server 2016 und neuer aus einem PowerShell-Fenster mit Administratorrechten als Windows-Dienst installiert. Er meldet CPU, Arbeitsspeicher, jeden Laufwerksbuchstaben, Disk-I/O und Netzwerk und leitet einen Load Average aus der Länge der Prozessor-Warteschlange ab, da Windows keinen hat. Siehe die Hinweise zur Windows-Installation und die Ankündigung des Windows-Server-Monitorings.
- Checkmk und Zabbix: native Windows-Agents mit Service-Erkennung und Windows-Templates.
- Datadog und Netdata: native Windows-Agents (das lokale Dashboard von Netdata ist im Free-Tarif gesperrt).
- Prometheus:
windows_exporterstellt Metriken aus WMI und Leistungsindikatoren bereit. - PRTG: agentenloses Monitoring über WMI und Leistungsindikatoren.
Welche Nagios-Alternative sollten Sie wählen?
- Sie haben Hunderte eigene Nagios-Plugins und wollen sie behalten: Icinga.
- Sie wollen Checks im Nagios-Stil, ohne Konfiguration zu schreiben: Checkmk.
- Sie wollen ein kostenloses Tool für Server und Netzwerkgeräte, mit Schwellenwerten: Zabbix.
- Ihre Infrastruktur besteht aus Kubernetes und Containern: Prometheus + Grafana.
- Sie überwachen vor allem Switches und Router: LibreNMS, oder PRTG, wenn Sie vor allem mit Windows arbeiten.
- Sie brauchen auch APM, Logs und Traces: Datadog.
- Sie wollen Host-Zustand, Uptime-Checks, Rufbereitschaft und eine Statusseite, ohne einen Monitoring-Server zu betreiben: Hyperping.
Viele Teams landen bei zwei Tools: einem Open-Source-Tool für tiefe Checks und Netzwerkgeräte und einem gehosteten Tool für Alarmierung und Kundenkommunikation, damit ein Ausfall des Monitoring-Servers nicht auch die Alarmierung verstummen lässt.
So ersetzen Sie die Nagios-Alarmierung durch Hyperping
Sie müssen nicht alles auf einmal migrieren. Am besten funktioniert es, zuerst Host-Erreichbarkeit, Service-Checks, Alarmierung und Statuskommunikation umzuziehen und Nagios für die Checks weiterlaufen zu lassen, die Hyperping nicht abdeckt, bis Sie entschieden haben, was mit ihnen passiert.
1. Den Agent auf Ihren Servern installieren
Klicken Sie in der Ansicht Servers auf New server und kopieren Sie den Installationsbefehl. Führen Sie ihn auf jedem Linux- oder macOS-Host mit sudo aus, unter Windows in einem PowerShell-Fenster mit Administratorrechten. Für eine ganze Flotte übergeben Sie --name, --policy und --group (oder die entsprechenden Umgebungsvariablen) aus Ansible oder Terraform. Jeder Host erscheint innerhalb von etwa 30 Sekunden online, mit CPU, Arbeitsspeicher, Festplatte, Netzwerk und Systeminfos.
2. Eine Eskalationsrichtlinie zuweisen und den Offline-Schwellenwert einstellen
Öffnen Sie das Panel Alerting des Servers, hängen Sie eine Eskalationsrichtlinie an und legen Sie den Offline-Schwellenwert fest: lang genug, um einen kurzen Netzwerkaussetzer zu überstehen, und kurz genug, dass Sie bei einem echten Ausfall rechtzeitig alarmiert werden. Standard sind 90 Sekunden. Testen Sie es, indem Sie den Agent auf einem unkritischen Host stoppen und prüfen, ob der Alarm ankommt. Die Dokumentation zur Server-Alarmierung beschreibt die Details.
3. Externe Nagios-Checks als Monitore neu anlegen
Listen Sie die Services mit check_http, check_tcp und check_ping auf, die Nagios gegen Ihre öffentlichen Endpunkte ausführt, und legen Sie sie als HTTP-, Port-, Ping- oder Keyword-Monitore neu an. Leiten Sie sie über dieselben Eskalationsrichtlinien, damit ein toter Host und ein fehlerhafter Endpunkt dieselbe Person alarmieren.
4. Bereitschaftspläne einrichten
Ersetzen Sie die Nagios-Kontakte und Timeperiods durch einen Bereitschaftsplan und lassen Sie die Stufen Ihrer Eskalationsrichtlinie darauf zeigen. Spätere Stufen können nach der von Ihnen festgelegten Verzögerung eine Vertretung oder die Teamleitung alarmieren.
5. Eine Statusseite veröffentlichen
Nehmen Sie die Dienste, die Ihren Kunden wichtig sind, in eine Statusseite unter Ihrer eigenen Domain auf. Wird ein Incident eröffnet, veröffentlichen Sie ein Update, und die Abonnenten erhalten es per E-Mail.
6. Beide parallel betreiben, dann Nagios abschalten
Lassen Sie Nagios ein bis zwei Wochen weiterlaufen. Vergleichen Sie, was jedes Tool erkannt hat und wie schnell die richtige Person alarmiert wurde. Entfernen Sie dann die Nagios-Checks, die Hyperping jetzt abdeckt, und entscheiden Sie, ob der Rest (Schwellenwert-Checks, SNMP, eigene Plugins) eine kleinere Instanz von Nagios, Checkmk oder Zabbix rechtfertigt.
So testen Sie diese Tools
- Hyperping: Free-Plan und 14-tägige Testphase
- Icinga: Kostenloser Download; Director und die Module von Icinga Web sind ebenfalls kostenlos
- Checkmk: Community ist kostenlos; 30-tägige Testphasen für Pro, Ultimate und Checkmk Cloud
- Zabbix: Kostenloser Download; 5-tägige Testphase für Zabbix Cloud
- Grafana Cloud: Free-Tarif ohne zeitliche Begrenzung
- Netdata: Kostenlos für 5 Nodes
- Datadog: Kostenlos für 5 Hosts, dazu eine kostenlose Testphase der bezahlten Pläne
- PRTG: 30 Tage uneingeschränkt testen, danach Freeware für 100 Sensoren
Testen Sie bei der Bewertung den gesamten Weg vom Fehler bis zum Menschen: Beenden Sie einen Dienst auf einem Testhost und messen Sie, wie lange es dauert, bis das Telefon der richtigen Person klingelt, nicht nur, bis ein Dashboard rot wird.
Weiterführende Artikel
- Leitfaden zum Linux-Server-Monitoring: CPU, Arbeitsspeicher, Festplatte und Netzwerk auf Ihren Hosts
- Leitfaden zu Eskalationsrichtlinien: wie Sie festlegen, wer wann alarmiert wird
- Bereitschaftsrotationen: einen Plan aufbauen, der niemanden ausbrennt
- Die besten PagerDuty-Alternativen: wenn Sie nur die Alarmierungsschicht ersetzen wollen
- Agentenbasiertes Monitoring: was ein Agent sieht, das externe Checks nicht sehen können
Weitere Vergleiche: Hyperping vs. Netdata · Hyperping vs. Datadog · Preise von Hyperping · Alle Vergleiche
Häufige Fragen
Was ist die beste Alternative zu Nagios? ▼
Das hängt davon ab, welcher Teil von Nagios Ihnen Probleme macht. Icinga ist der direkteste Ersatz, weil es dieselben Check-Plugins mit einer saubereren Konfigurationssprache ausführt. Checkmk bleibt plugin-kompatibel, ergänzt aber eine agentenbasierte automatische Erkennung und eine Konfiguration im Web. Liegt das Problem eher bei Alarmierung, Rotationen und Kundenkommunikation als bei den Checks, übernimmt Hyperping Alarmierung und Statusseite, mit einem gehosteten Agent, Bereitschaftsplänen und Statusseiten ab 24 €/Monat.
Was sind die besten Open-Source-Alternativen zu Nagios? ▼
Icinga 2 (GPLv2), Checkmk Community (GPLv2, früher Raw Edition), Zabbix (AGPLv3 seit 7.0), Prometheus mit Grafana (Apache 2.0 und AGPLv3), LibreNMS (GPLv3) und der Netdata-Agent (GPLv3). Icinga und Checkmk verwenden Nagios-Plugins weiter, damit sind sie die einfachsten Migrationen. Bei Zabbix und Prometheus bauen Sie Ihre Checks von Grund auf neu.
Gibt es eine kostenlose Alternative zu Nagios? ▼
Ja. Icinga 2, Checkmk Community, Zabbix, Prometheus und LibreNMS lassen sich ohne Host-Limit kostenlos selbst hosten, Sie bezahlen allerdings mit Serverzeit und Wartung. Gehostete Gratis-Tarife sind kleiner: Hyperping Free umfasst 1 Server-Agent und 20 Monitore, Netdata Community 5 Nodes, der Free-Tarif von Datadog 5 Hosts mit 1 Tag Aufbewahrung und PRTG Freeware 100 Sensoren.
Was ist eine gute Nagios-Alternative für Windows? ▼
Nagios Core selbst läuft nicht unter Windows, Windows-Hosts werden über Agents wie NSClient++ oder NCPA überwacht. PRTG ist das wichtigste Tool, dessen Server unter Windows läuft (der Core-Server läuft sogar nur unter Windows). Um Windows-Hosts von einem Linux-Server oder einem gehosteten Dienst aus zu überwachen, liefern Hyperping, Checkmk, Zabbix, Netdata und Datadog native Windows-Agents mit, Prometheus nutzt windows_exporter.
Wird Nagios 2026 noch gepflegt? ▼
Ja. Nagios Core 4.5.14 ist am 5. August 2026 mit Sicherheitskorrekturen erschienen, und Nagios XI wird von Nagios Enterprises verkauft und unterstützt. Teams wechseln selten, weil Nagios nicht mehr funktioniert. Sie wechseln wegen des Konfigurationsaufwands, der Plugin-Pflege auf jedem Host und weil Bereitschaftspläne und Statusseiten fehlen.
Ist Icinga besser als Nagios? ▼
Für die meisten Teams ja. Icinga entstand 2009 als Fork von Nagios, und Icinga 2 wurde mit eigener Konfigurationssprache, REST-API, nativem Clustering und moderner Weboberfläche neu geschrieben, führt aber weiterhin Nagios-kompatible Plugins aus. Der Haken: Sie hosten und pflegen weiterhin alles selbst, auch die Benachrichtigungsschicht.
Was kostet Nagios XI im Vergleich zu den Alternativen? ▼
Nagios XI Standard ist eine einmalige Lizenz ab 2.595 $ für 100 Nodes. Ab dem zweiten Jahr ist ein Wartungs- und Supportvertrag nötig, um die Premium-Funktionen zu behalten. Checkmk Pro beginnt bei 190 €/Monat bei jährlicher Abrechnung, PRTG 500 kostet 200 $/Monat bei jährlicher Abrechnung, Datadog Infrastructure Pro 15 $ pro Host und Monat im Jahresvertrag, und Hyperping Essentials 24 $/Monat bei jährlicher Abrechnung für 5 Server-Agents, 50 Monitore, Rufbereitschaft und eine Statusseite.