Die besten Better-Stack-Alternativen sind Hyperping für Uptime-Checks, Rufbereitschaft und Statusseiten mit Nutzerplätzen im Plan, UptimeRobot für viele günstige Verfügbarkeits-Checks, Datadog für APM und Traces neben Ihren Checks, PagerDuty für Rufbereitschaft über viele Teams hinweg, incident.io für Incident Response in Slack, Axiom für große Log-Volumen bei kleiner Rechnung und OneUptime für eine selbst gehostete Open-Source-Version des gesamten Stacks.
Ich habe 66 Produkte analysiert und sieben in die engere Wahl genommen. Better Stack verkauft mehrere Produkte unter einem Login: Uptime- und Heartbeat-Checks, Rufbereitschaft und Incidents, Statusseiten sowie Telemetrie (Logs, Traces, Metriken, Error Tracking und Session Replay). Jedes Tool auf der Shortlist ersetzt mindestens einen dieser Bereiche. Reine Statusseiten-Tools, weitere On-Call-Tools und der Rest des Observability-Markts folgen weiter unten.
Die Preise habe ich im Oktober 2026 geprüft. Der Vergleichsmaßstab ist die Responder-Lizenz von Better Stack für 29 $ im Monat bei jährlicher Abrechnung (34 $ monatlich) für jede Person, die alarmiert wird. Sie umfasst Rufbereitschaft, Incidents, Statusseiten sowie unbegrenzte Anrufe und SMS, mit 10 Monitoren pro Konto und 21 $ im Monat für jeweils 50 weitere. Hyperping Essentials kostet 24 € im Monat für 50 Monitore mit 30 Sekunden Intervall, inklusive 3 Nutzerplätzen, Rufbereitschaft und einer Statusseite.
| Tool | Am besten für | Einstiegspreis | Größte Einschränkung |
|---|---|---|---|
| Hyperping | Checks, Rufbereitschaft und Statusseiten mit Nutzerplätzen im Plan | Kostenlos; 24 €/Monat | Keine Traces oder APM; Logs im Alpha |
| UptimeRobot | Viele günstige Verfügbarkeits-Checks | Kostenlos; Solo 12 $/Monat | Keine Bereitschaftspläne oder Eskalation |
| Datadog | Checks neben APM, Traces und Logs | 15 $/Host/Monat; 5 $ pro 10.000 API-Runs | Jedes Produkt wird separat abgerechnet |
| PagerDuty | Rufbereitschaft über viele Teams hinweg | Kostenlos bis 5 Nutzer; 21 $/Nutzer/Monat | Prüft selbst nichts; Abrechnung pro Nutzer |
| incident.io | Incident Response in Slack oder Teams | Kostenlos; 25 $/Nutzer/Monat mit On-Call | Prüft selbst nichts; Abrechnung pro Nutzer |
| Axiom | Große Log-Volumen bei kleiner Rechnung | Kostenlos 500 GB; 25 $/Monat | Keine Uptime-Checks, keine Rufbereitschaft, keine Statusseite |
| OneUptime | Den gesamten Stack selbst hosten | Selbst gehostet kostenlos; 20 $/Nutzer/Monat + 1 $/Monitor | Aufwendig im Betrieb; Checks im Minutentakt |
Warum Sie diesem Vergleich vertrauen können
Ich bin Léo, Gründer von Hyperping. Ja, ich habe also ein Interesse an einem dieser Tools. Ich habe aber oft genug erlebt, dass Teams sich für einen Wettbewerber entschieden haben, weil er besser passte, und ich werde nicht so tun, als wäre es anders. Mein Ziel ist nicht, Sie davon zu überzeugen, dass Hyperping immer die Antwort ist. Ich möchte Ihnen helfen zu verstehen, welches Tool Ihr Problem tatsächlich löst.
Im Oktober 2026 habe ich die Preisseite und die Doku von Better Stack durchgesehen, dazu G2-Bewertungen, Reddit-Threads in r/devops und r/selfhosted, Hacker News sowie die Preisseiten und Dokus aller Tools auf dieser Liste.
Warum Teams Better Stack verlassen
Klären Sie zuerst, welchen Teil von Better Stack Sie ersetzen wollen. Better Stack begann als Uptime-Monitor mit Statusseiten und Logtail für Logs. Heute nennt sich das Unternehmen „the AI SRE observability stack“ und verkauft Uptime, Rufbereitschaft, Incidents, Statusseiten, Logs, Traces, Metriken, Error Tracking, Session Replay und einen KI-SRE-Agenten, der nach Tokens abgerechnet wird. G2-Rezensenten mögen die Oberfläche und dass alles an einem Ort liegt. Die Kritik betrifft den Preis für kleine Teams, die Add-ons und die Einarbeitung auf der Telemetrie-Seite.
| Wofür Sie Better Stack nutzen | Wenn Sie bleiben | Schauen Sie sich an |
|---|---|---|
| 10 Monitore und eine Statusseite, niemand in Bereitschaft | Der kostenlose Plan reicht, mit 3-Minuten-Checks | UptimeRobot, Hyperping |
| Uptime und Rufbereitschaft für ein Team ab 5 Personen | 29 $ pro Person in Bereitschaft, plus zusätzliche Monitore | Hyperping |
| Eine private, White-Label- oder SSO-Statusseite | 42 $ bis 208 $ im Monat pro Seite und Option | Hyperping |
| Logs in großen Mengen, über Monate aufbewahrt | Niedrige Preise pro GB, SQL, beliebige Aufbewahrung | Axiom, oder bleiben |
| APM und verteilte Traces | Traces gibt es, das APM ist schlanker als bei Datadog | Datadog |
| Rufbereitschaft für viele Teams mit komplexem Routing | Pläne und Eskalation pro Responder | PagerDuty |
| Ein formaler Incident-Prozess in Slack | Slack-Workflows kosten 9 $ pro Responder | incident.io |
| Alles auf eigenen Servern betreiben | Nicht möglich | OneUptime |
Die Rechnung wächst mit jeder Person in der Bereitschaft
Der günstigste bezahlte Einstieg bei Better Stack ist eine Responder-Lizenz für 29 $ im Monat. Jede weitere Person in der Rotation kostet noch einmal 29 $, fünf Personen also 145 $ im Monat, bevor Sie Monitore über die ersten 10 hinaus hinzufügen. Teammitglieder, die nur Logs lesen, sind kostenlos, das ist fair. Aber wer nachts angerufen werden soll, braucht eine Lizenz. Aus einer G2-Bewertung vom März 2026: „Die Preise können sich für kleine Teams oder einzelne Entwickler etwas hoch anfühlen.“
Die Statusseiten-Extras kosten mehr als die Statusseite
Eine Statusseite ist inklusive, jede weitere öffentliche Seite kostet 12 $ im Monat. Danach wird jede Option pro Seite berechnet: Passwortschutz kostet 42 $, White-Label, SSO, IP-Allowlisting und der E-Mail-Versand von Ihrer eigenen Domain jeweils 208 $. Eine private Seite hinter SSO ohne den Better-Stack-Footer kostet 416 $ im Monat zusätzlich zu Ihren Lizenzen. Hyperping enthält private Seiten in Pro und White-Label in Business, und SSO für Statusseiten kostet in Business 49 € im Monat pro Identity Provider.
Ich wollte doch nur Uptime und Rufbereitschaft
Der Großteil der jüngsten Arbeit bei Better Stack fließt in Telemetrie und den KI-SRE: eBPF-Tracing, Error Tracking, Session Replay, Importe aus Datadog und Grafana sowie KI-Preise pro Token. Wenn Sie wegen Monitoren, Alarmierung und Statusseite gekommen sind, zahlen Sie für ein Produkt, dessen Roadmap in eine andere Richtung zeigt. Die Uptime-Checks sind nach wie vor gut, aber sie stehen nicht mehr im Mittelpunkt des Unternehmens.
Logs und SQL brauchen Einarbeitung
Die Log-Preise von Better Stack sind niedrig, schwer tun sich die Leute bei den Abfragen. Aus einer G2-Bewertung vom September 2024: „Metriken aus Logs einzurichten ist nicht benutzerfreundlich, und SQL für komplexe Analysen ist in der Theorie eine nette Idee, macht die Sache in der Praxis aber kompliziert.“ Eine Ein-Stern-Bewertung vom Mai 2025 berichtete von Log-Seiten, die 2 bis 5 Minuten zum Laden brauchten. Das ist allerdings ein einzelner Bericht und kein Muster.
Better-Stack-Alternativen im Vergleich
Die größte Trennlinie verläuft zwischen Tools, die Ihre Website prüfen und jemanden alarmieren, und Tools, die nur eines von beidem tun.
| Funktion | Better Stack | Hyperping | UptimeRobot | Datadog | PagerDuty | incident.io | Axiom | OneUptime |
|---|---|---|---|---|---|---|---|---|
| Uptime-Checks | 30 s in bezahlten Plänen | 30 s; 20 s in Business | 30 s Team; 15 s Scale | Synthetische API-Tests, pro Run | Nein | Nein | Nein | 1 Minute |
| Browser-Checks | Playwright, 1 $ pro 100 Min. | Playwright, 3 bis 25 je nach Plan | Nein | Browser-Tests, pro Run | Nein | Nein | Nein | Playwright, 5 Min. |
| Cron-Heartbeats | 10, dann 17 $ pro 10 | Ja | Ja | Nein | Nein | Nein | Nein | Ja |
| Rufbereitschaft und Eskalation | Pro Responder | In bezahlten Plänen enthalten | Nein | On-Call, 20 $ pro Nutzerplatz | Ja | Add-on für 10 $ bis 20 $ pro Nutzer | Nein | Ab Growth |
| Statusseiten | 1 inklusive, weitere 12 $ | 1, 3 oder 10 je nach Plan | 1 kostenlos; 100 in Team | Mit Incident Management | Externe Seite in bezahlten Plänen | 1 öffentliche in jedem Plan | Nein | Unbegrenzt ab Growth |
| Logs | Ja, pro GB | Alpha, 5 bis 50 GB je nach Plan | Nein | Ja, pro GB und pro Event | Nein | Nein | Ja, 1 TB für 25 $ | Ja, 0,10 $/GB für 15 Tage |
| Traces und APM | Ja | Nein | Nein | Ja | Nein | Nein | Ja | Ja |
| Server-Metriken | Ja, OpenTelemetry | Agent: CPU, Arbeitsspeicher, Festplatte, Netzwerk | Nein | Ja | Nein | Nein | Ja | Ja |
| Self-Hosting möglich | Nein | Nein | Nein | Nein | Nein | Nein | Nein | Ja |
Better-Stack-Alternativen: Preise im Vergleich
Better Stack rechnet pro Responder und pro Add-on ab. Die anderen rechnen nach Plan, nach Nutzer, nach Host und Run oder nach Datenmenge ab.
| Tool | Kostenloser Plan | Erster bezahlter Plan | Was enthalten ist | Abrechnung nach | Achtung bei |
|---|---|---|---|---|---|
| Better Stack | 10 Monitore mit 3 Min., 1 Statusseite, 3 GB Logs | Responder, 29 $/Monat | Rufbereitschaft, Incidents, Statusseiten, unbegrenzte Anrufe und SMS | Responder, plus Add-ons | Statusseiten-Optionen kosten 42 $ bis 208 $ pro Seite |
| Hyperping | 20 Monitore mit 5 Min., 1 Statusseite | Essentials, 24 €/Monat | 50 Monitore mit 30 s, 3 Nutzerplätze, Rufbereitschaft, 3 Browser-Checks | Plan | 1 Statusseite und 1 Bereitschaftsplan in Essentials |
| UptimeRobot | 50 Monitore mit 5 Min. | Solo, 12 $/Monat | 10 Monitore mit 60 s, 3 Statusseiten | Monitor | Solo hat weniger Monitore als Free |
| Datadog | 5 Hosts Infrastruktur, keine Synthetics | 15 $/Host/Monat, plus Nutzung | Infrastruktur-Metriken; Synthetics und Logs separat | Host, Run, GB, Event, Nutzerplatz | On-Call und Incident Management pro Nutzerplatz |
| PagerDuty | Bis 5 Nutzer, 1 Bereitschaftsplan | Professional, 21 $/Nutzer/Monat | Bereitschaftspläne, Eskalation, SMS und Anrufe | Nutzer | Jede Person im Bereitschaftsplan ist ein zahlender Nutzer |
| incident.io | On-Call für ein Team, 1 Statusseite | Team, 15 $/Nutzer/Monat + 10 $ On-Call | Incidents in Slack, Rufbereitschaft, Statusseite | Nutzer | On-Call ist in jedem bezahlten Plan ein Add-on |
| Axiom | 500 GB, 1 Nutzer, 3 Monitore | Axiom Cloud, 25 $/Monat | 1 TB Ingest, 100 GB-Stunden Abfragen | Aufgenommene GB, Abfrage-Compute | Abfragen und Monitore stoppen am Ausgabelimit |
| OneUptime | Selbst gehostet; Cloud nur mit manuellen Monitoren | Growth, 20 $/Nutzer/Monat | Rufbereitschaft, unbegrenzte Statusseiten, API | Nutzer, Monitor, SMS, GB | 1 $ pro Monitor; SMS und Anrufe je 0,10 $ |
Was 5 Personen in Bereitschaft und 100 Monitore kosten
Angenommen, fünf Entwickler teilen sich die Bereitschaftsrotation, Sie überwachen 100 Endpunkte alle 30 Sekunden und veröffentlichen eine Statusseite auf Ihrer eigenen Domain. Das ist ein typisches Better-Stack-Setup. Hier meine Schätzung auf Basis der öffentlichen Preise, bei jährlicher Abrechnung.
| Tool | Was es abdeckt | Monatliche Kosten | Hinweis |
|---|---|---|---|
| Hyperping | Pro: 250 Monitore, 10 Nutzerplätze, 3 Statusseiten | 74 $ | Rufbereitschaft, Alarme per Anruf und 10 Browser-Checks inklusive |
| UptimeRobot + PagerDuty | Team (39 $) + Professional für 5 (105 $) | 144 $ | Zwei Tools, die verbunden werden müssen |
| incident.io + UptimeRobot | Team mit On-Call für 5 (125 $) + Team (39 $) | 164 $ | Incident-Channels in Slack, zwei Tools |
| Better Stack | 5 Responder (145 $) + 100 zusätzliche Monitore (42 $) | 187 $ | Unbegrenzte Anrufe und SMS |
| OneUptime | Growth für 5 Nutzer (100 $) + 100 Monitore (100 $) | 200 $ | Checks jede Minute; SMS und Anrufe je 0,10 $ |
| Datadog | 100 API-Tests jede Minute + On-Call für 5 | Rund 2.260 $ | 4,3 Millionen Runs im Monat; Statusseite kostet extra |
| Axiom | Passt nicht | Keine Uptime-Checks und keine Rufbereitschaft |
Hyperping ist der günstigste Weg, dieses Setup in einem einzigen Tool zu betreiben, vor allem weil die Nutzerplätze im Plan enthalten sind. Die Rechnung sieht anders aus, wenn nur eine Person Bereitschaft hat: Ein Better-Stack-Responder mit 100 Monitoren kostet 71 $ im Monat, etwa so viel wie Hyperping Pro. Kommt eine passwortgeschützte oder SSO-Statusseite dazu, steigt Better Stack um 42 $ bis 208 $ im Monat, während Hyperping Pro private Seiten bereits enthält.
Better Stack vs Hyperping
Beide Produkte prüfen Ihre Endpunkte, alarmieren die Person in Bereitschaft und aktualisieren aus demselben Incident heraus eine Statusseite. Better Stack geht weiter in Richtung Telemetrie: Logs, Traces, Metriken, Error Tracking und Session Replay. Hyperping konzentriert sich auf den Ausfall selbst und nimmt die Nutzerplätze und die Statusseiten-Optionen in den Plan auf.
| Funktion | Better Stack | Hyperping |
|---|---|---|
| Kostenloser Plan | 10 Monitore und Heartbeats, 3-Minuten-Checks | 20 Monitore, 5-Minuten-Checks, 1 Server-Agent |
| Wofür Sie zahlen | Jeden Responder, 29 $/Monat | Den Plan: 3, 10 oder 20 Nutzerplätze inklusive |
| 100 Monitore mit 30 s | 1 Responder + 42 $ für zusätzliche Monitore, 71 $/Monat | Pro, 74 $/Monat |
| Bestätigung von Ausfällen | Mehrstufige Incident-Verifizierung | Erneute Prüfung aus anderen Regionen, bevor jemand alarmiert wird |
| Anrufe und SMS | Unbegrenzt für Responder | Anrufe inklusive; 20, 75 oder 200 SMS im Monat |
| Browser-Checks | Playwright, 1 $ pro 100 Minuten, bis 30 s | Playwright: 3, 10 oder 25 inklusive, alle 5 Minuten |
| Statusseiten | 1 inklusive, 12 $ pro weiterer Seite | 1, 3 oder 10 je nach Plan |
| Private Statusseite | 42 $ pro Seite für ein Passwort, 208 $ für SSO | Passwort, Google SSO und E-Mail-Codes in Pro |
| White-Label | 208 $ pro Seite | Business |
| Server-Metriken | OpenTelemetry-Metriken, Abrechnung pro GB | Agent: 5, 20 oder 100 Server je nach Plan |
| Logs | 0,10 $ bis 0,15 $/GB, SQL, beliebige Aufbewahrung | Alpha: 5, 20 oder 50 GB inklusive, dann 0,25 $/GB, 30 Tage |
| Traces, APM, RUM | Ja | Nein |
| KI | KI-SRE, Abrechnung pro Token | Ask Hyperping (Alpha): 10 Fragen und 3 Untersuchungen im Monat, oder unbegrenzt mit eigenem Key |
| Konto-SSO und Audit | Okta oder Azure 5 $/Nutzer; Audit-Logs 208 $/Monat | SAML SSO in Pro; Audit-Logs in Business |
| Datenstandort | Telemetrie standardmäßig in der EU gespeichert | Rechenzentren in der EU |
Wenn eine Person Bereitschaft hat und Sie Logs, Traces und Fehler im selben Tool wie Ihre Monitore wollen, ist Better Stack das bessere Produkt. Hyperping ist besser, sobald mehrere Personen in der Rotation sind, wenn die Statusseite privat oder White-Label sein muss oder wenn Sie gar keine Telemetrie-Preise auf der Rechnung haben wollen.
Hyperping: am besten für Checks, Rufbereitschaft und Statusseiten mit Nutzerplätzen im Plan
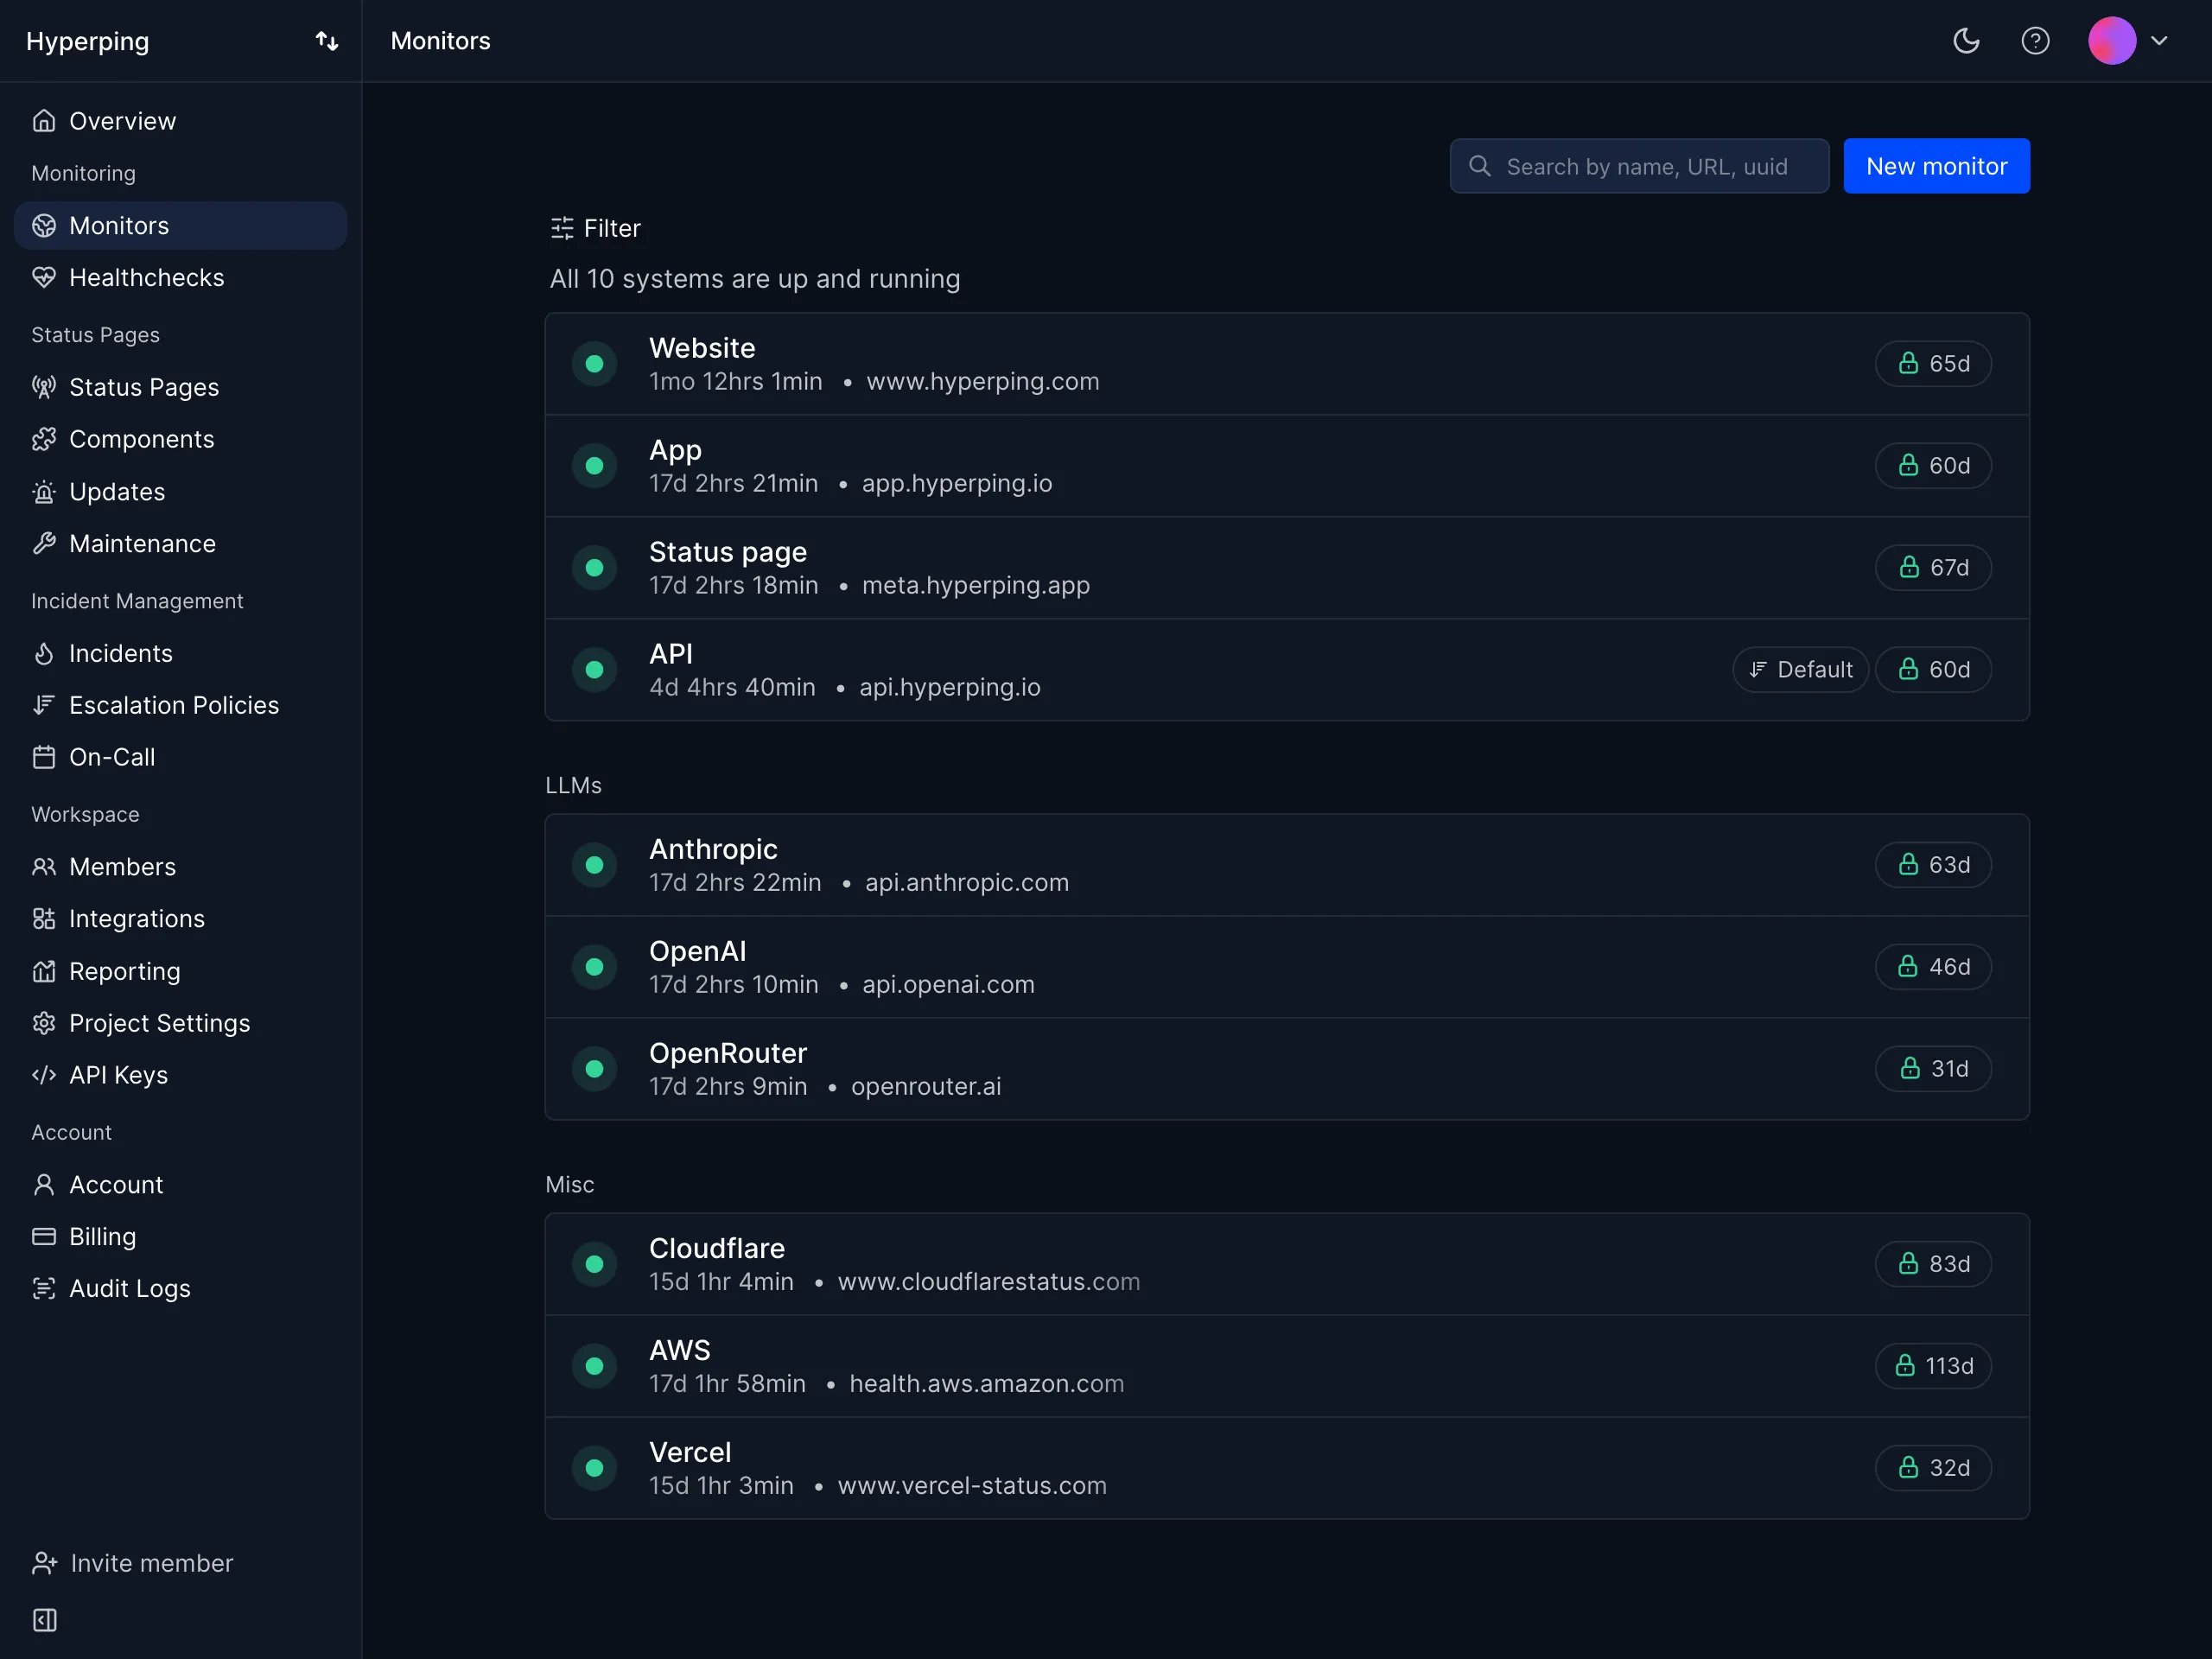
Hyperping prüft Ihre Websites, APIs und Server aus 18 Regionen, prüft jeden Fehler aus einer anderen Region nach, bevor jemand alarmiert wird, steuert die Bereitschaftsrotation und aktualisiert Ihre Statusseite aus demselben Incident. Nutzerplätze sind in jedem Plan enthalten.
| Am besten für | Einstiegspreis | Größte Einschränkung |
|---|---|---|
| Teams, in denen sich mehrere Personen Bereitschaft und Statusseite teilen | Kostenlos, dann 24 €/Monat | Keine Traces oder APM; Logs im Alpha |
Für wen Hyperping gemacht ist
SRE- und DevOps-Teams, deren Kunden merken, wenn das Produkt ausfällt, und die für die Innensicht bereits Datadog, Grafana oder Sentry haben. Meist ein SaaS-Produkt mit öffentlicher Website, ein paar Dutzend API-Endpunkten, Cron-Jobs und einer Statusseite, bei dem sich drei bis zwanzig Entwickler in der Bereitschaft abwechseln. Wenn Sie vor allem wegen der Logs und Traces zu Better Stack gekommen sind, ersetzt Hyperping die Hälfte für Monitoring und Rufbereitschaft, nicht die Telemetrie-Hälfte.
Wichtige Funktionen
- Uptime-Checks. HTTP, Keyword, Ping, Port, DNS und SSL aus 18 Regionen, alle 30 Sekunden oder alle 20 in Business.
- Bestätigung aus mehreren Regionen. Ein fehlgeschlagener Check wird aus Ihren anderen Regionen wiederholt, bevor ein Incident eröffnet wird.
- Playwright-Browser-Checks. 3 in Essentials, 10 in Pro, 25 in Business.
- Cron-Heartbeats. Alarme, wenn sich ein Backup oder ein geplanter Job nicht meldet.
- Rufbereitschaft und Eskalation. Rotationen über Zeitzonen hinweg, Overrides und mehrstufige Eskalation per Slack, SMS oder Anruf.
- Statusseiten. Öffentlich oder privat, auf Ihrer Domain, mit Abonnenten, Wartungsfenstern und mehreren Sprachen in Pro.
- Server-Monitoring. Ein Agent, mit einer Zeile installiert, meldet CPU, Arbeitsspeicher, Dateisystem, Festplatten-I/O und Netzwerk von Linux- und macOS-Hosts, mit Schwellenwert-Alarmen.
- Logs (Alpha). OpenTelemetry, Syslog, HTTP sowie Vercel- oder Heroku-Drains, mit Live Tail, Log-Alarmen, die Incidents eröffnen, und den Log-Zeilen kurz vor jedem Incident direkt im Incident.
- Ask Hyperping (Alpha). Eine KI, die Fragen zu Ihren Monitoren und Incidents beantwortet und bei einem Alarm die Ursache untersucht, in der App oder in Slack. Dazu gibt es einen MCP-Server für Claude, Cursor und andere KI-Tools.
Warum Hyperping statt Better Stack?
Nutzerplätze sind im Plan enthalten. Better Stack berechnet 29 $ für jede Person in der Bereitschaft. Hyperping Pro enthält 10 Nutzerplätze mit Rufbereitschaft für 74 $ im Monat, der vierte oder fünfte Entwickler in der Rotation ändert die Rechnung also nicht.
Private und White-Label-Statusseiten ohne Add-ons pro Seite. Passwortschutz, Google SSO und E-Mail-Zugangscodes gibt es in Pro. White-Label gibt es in Business, wofür Better Stack 208 $ im Monat pro Seite verlangt.
Weniger Fehlalarme. Jeder Fehler wird aus einer anderen Region nachgeprüft, bevor jemand einen Anruf bekommt. Kunden wie Alma sagen, dass die Alarme sie früher erreichen als die ihrer anderen Tools.
Was Nutzer sagen
Alma nutzt Datadog und behält Hyperping als Prüfung von außen. Ihr SRE Fabrice Gregoire:
„Hyperping hat bei uns im Unternehmen den Ruf, reaktiver zu sein als Datadog. Meist bekommen wir die Benachrichtigungen von Hyperping vor denen von Datadog.“
„Wir haben unsere Hyperping-Statusseite öffentlich gemacht, und sie wurde ein zentraler Teil unserer Verkaufsgespräche.“
Was kostet Hyperping?
- Free: 20 Monitore, 5-Minuten-Checks, 1 Server-Agent, 1 gehostete Statusseite
- Essentials: 24 €/Monat (29 € bei monatlicher Zahlung) für 50 Monitore, 30-Sekunden-Checks, 3 Nutzerplätze, 1 Bereitschaftsplan, 1 Statusseite, 3 Browser-Checks, 5 Server-Agenten, 5 GB Logs
- Pro: 74 €/Monat (89 € bei monatlicher Zahlung) für 250 Monitore, 10 Nutzerplätze, 3 Bereitschaftspläne, 3 öffentliche oder private Statusseiten, 10 Browser-Checks, 20 Server-Agenten, 20 GB Logs, SAML SSO
- Business: 249 €/Monat (299 € bei monatlicher Zahlung) für 1.000 Monitore, 20-Sekunden-Checks, 20 Nutzerplätze, unbegrenzte Bereitschaftspläne, 10 White-Label-Statusseiten, 25 Browser-Checks, 100 Server-Agenten, 50 GB Logs, Audit-Logs
- Extras: Nutzerplätze ab 7 €/Monat, Logs für 0,25 €/GB über dem Kontingent, sobald die nutzungsbasierte Abrechnung startet, SSO für Statusseiten für 49 €/Monat pro Identity Provider in Business
Fünf Personen in Bereitschaft mit 100 Monitoren passen in Pro für 74 €/Monat.
Wo Hyperping an Grenzen stößt
Es gibt keine Traces, kein APM, kein Error Tracking und kein Session Replay, was Better Stack, Datadog und OneUptime abdecken. Die Logs sind im Alpha-Stadium, die Suche reicht nur 30 Tage zurück, und 0,25 $ pro GB sind mehr als die 0,10 $ bis 0,15 $ von Better Stack. Browser-Checks laufen alle 5 Minuten, während Better Stack Playwright bis hinunter auf 30 Sekunden ausführt. Logs und Ask Hyperping sind auf reinen EU-Konten nicht verfügbar. Wenn immer nur eine Person Bereitschaft hat, kostet Better Stack ungefähr gleich viel.
Ist Hyperping das Richtige für Sie?
Wählen Sie Hyperping, wenn Ihre Better-Stack-Rechnung vor allem aus Responder-Lizenzen und Statusseiten-Add-ons besteht und Ihre Logs und Traces woanders liegen oder liegen können. Bleiben Sie bei Better Stack, wenn die Telemetrie der Hauptgrund ist, warum Sie dafür zahlen.
Sie wechseln? Der Migrationsleitfaden für Better Stack beschreibt, wie Sie Monitore und Heartbeats über die API exportieren und per API oder Terraform neu anlegen.
UptimeRobot: am besten für viele günstige Verfügbarkeits-Checks
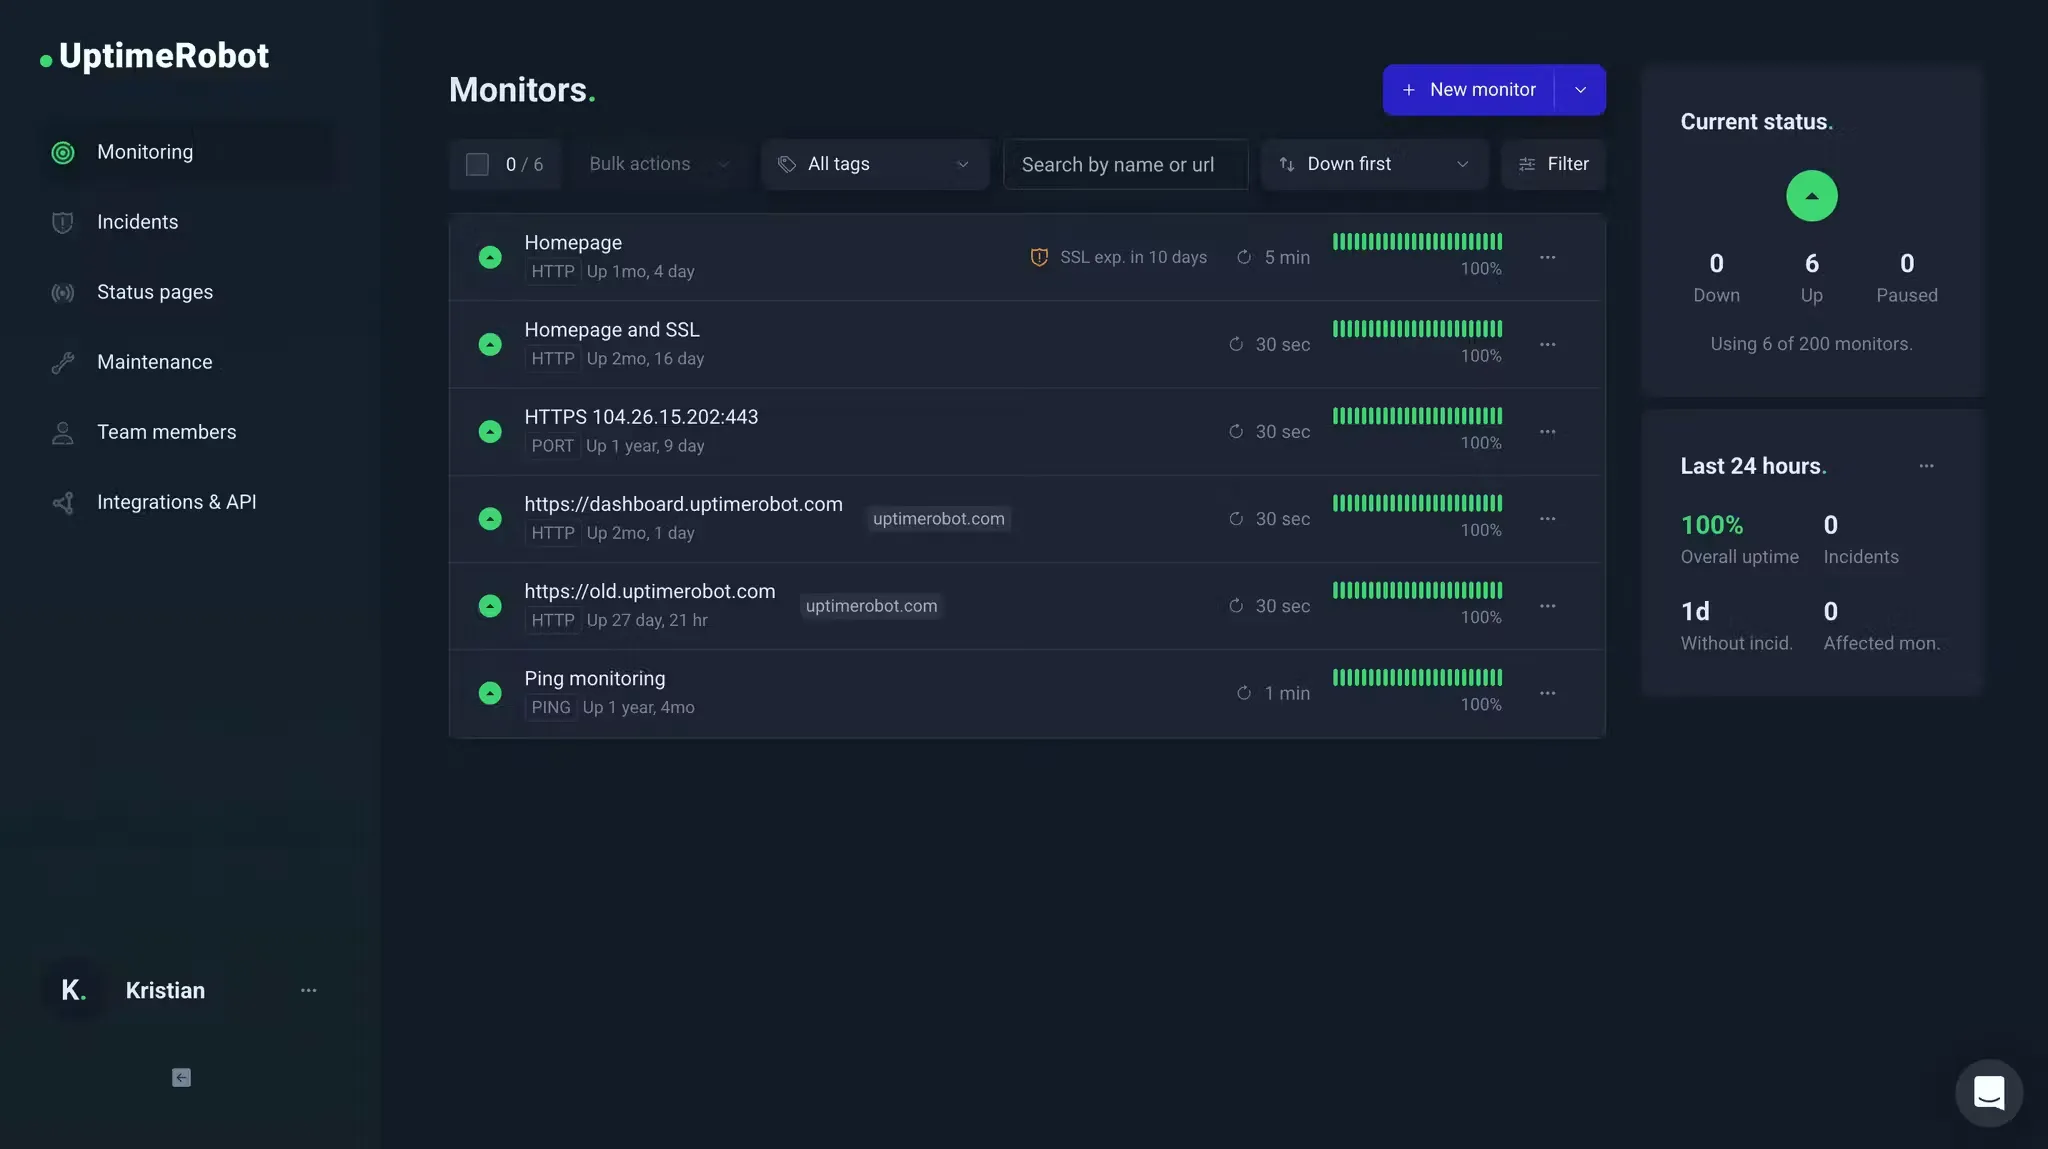
UptimeRobot gibt es seit 2010 und nennt mehr als 3,4 Millionen Nutzer. Der kostenlose Plan hat 50 Monitore mit 5-Minuten-Intervall, fünfmal so viele wie die 10 von Better Stack.
| Am besten für | Einstiegspreis | Größte Einschränkung |
|---|---|---|
| Entwickler und Agenturen, die viele URLs überwachen | Kostenlos; Solo 12 $/Monat | Keine Bereitschaftspläne oder Eskalation |
Für wen UptimeRobot gemacht ist
Einzelentwickler, kleine Teams und Agenturen, die den kostenlosen Plan von Better Stack oder einen einzelnen Responder vor allem für Uptime-Checks und eine Statusseite nutzen, ohne dass jemand formell Bereitschaft hat. Meist Dutzende URLs, ein paar JSON-Health-Endpunkte und Statusseiten für Kunden.
Wichtige Funktionen
- Kostenloser Plan. 50 Monitore mit 5-Minuten-Intervall.
- Monitor-Typen. HTTP, Keyword, Ping, Port, UDP, DNS, SSL, Domain-Ablauf, Cron und API-Checks auf JSON-Felder.
- Intervalle. 60 Sekunden in Solo, 30 Sekunden in Team, 15 Sekunden in Scale.
- Statusseiten. 3 in Solo, 100 in Team, unbegrenzt in Scale.
- Alarme. E-Mail, mobile App, Slack, Teams, Webhooks und PagerDuty in Team.
Warum UptimeRobot statt Better Stack?
Mehr kostenlose Monitore. Better Stack Free hat 10 Monitore mit 3-Minuten-Checks. UptimeRobot Free hat 50.
Statusseiten im Hunderterpack. Team enthält 100 Statusseiten für 39 $ im Monat bei jährlicher Abrechnung. Bei Better Stack kämen 100 Seiten allein an Gebühren für zusätzliche Seiten auf 1.188 $ im Monat.
Schnellere Checks. Scale prüft alle 15 Sekunden. Better Stack hört bei 30 auf.
Was Nutzer sagen
Gelobt wird vor allem, wie einfach die Einrichtung ist. Aus einer G2-Bewertung vom Juli 2026:
„Mir gefällt, dass UptimeRobot sehr intuitiv und sehr einfach einzurichten ist. Ich bekomme rechtzeitig E-Mail-Benachrichtigungen und dazu die wöchentlichen Zusammenfassungen.“
Was kostet UptimeRobot?
Stand 6. Nov. 2026 (USD):
- Free: 50 Monitore, 5-Minuten-Checks
- Solo: 12 $/Monat bei jährlicher Abrechnung (13 $ monatlich) für 10 Monitore, 60-Sekunden-Checks, 3 Statusseiten
- Team: 39 $/Monat bei jährlicher Abrechnung (46 $ monatlich) für 100 Monitore, 30-Sekunden-Checks, 3 Nutzerplätze, 100 Statusseiten
- Scale: 79 $/Monat bei jährlicher Abrechnung (98 $ monatlich) für 200 Monitore, 15-Sekunden-Checks, unbegrenzte Statusseiten
Hundert Monitore mit 30 Sekunden brauchen Team für 39 $/Monat bei jährlicher Abrechnung.
Wo UptimeRobot an Grenzen stößt
Es gibt keine Bereitschaftspläne, keine Eskalationsrichtlinien, keine Browser-Checks und keine Logs. Wenn nachts jemand reagieren muss, kombinieren Sie es mit PagerDuty oder wechseln zu Hyperping. Langjährige Nutzer erinnern sich an Planänderungen: Im Juli 2025 wurde ein Nutzer auf r/selfhosted von einem Legacy-Plan für 8 $ auf einen Team-Plan für 34 $ umgestellt.
Ist UptimeRobot das Richtige für Sie?
Wählen Sie UptimeRobot, wenn Sie Better Stack für Checks und Statusseiten genutzt haben und niemand Bereitschaft hat. Wenn die Rotation der Grund ist, warum Sie bei Better Stack sind, ersetzt UptimeRobot allein das nicht.
Datadog: am besten für Checks neben APM, Traces und Logs

Datadog ist die komplette Observability-Suite: Infrastruktur, APM, Logs, Synthetics, RUM, Security, On-Call und Incident Management, alles über gemeinsame Tags verknüpft. Jedes Produkt hat seinen eigenen Zähler.
| Am besten für | Einstiegspreis | Größte Einschränkung |
|---|---|---|
| Teams, denen die Telemetrie von Better Stack nicht mehr reicht | 15 $/Host/Monat; 5 $ pro 10.000 API-Runs | Jedes Produkt wird separat abgerechnet |
Für wen Datadog gemacht ist
Plattform- und SRE-Teams mit vielen Services, oft auf Kubernetes, die eine Anfrage über ein Dutzend Services verfolgen und von einem langsamen Trace direkt zu dessen Logs und Host springen müssen. Ein Team, das von Better Stack zu Datadog wechselt, will meist tieferes APM, nicht günstigere Uptime-Checks.
Wichtige Funktionen
- APM und Traces. Traces auf Code-Ebene mit Service Maps.
- Infrastruktur. Host-, Container- und Cloud-Metriken über den Datadog Agent und mehr als 1.000 Integrationen.
- Logs. Alles aufnehmen, indexieren, was Sie durchsuchen, den Rest archivieren.
- Synthetics. API-Tests, pro Run abgerechnet, und Browser-Tests, pro 1.000 Runs abgerechnet.
- On-Call und Incident Management. Alarmierung für 20 $ pro Nutzerplatz und Incidents mit Statusseiten für 30 $ pro Nutzerplatz, beides in Jahresplänen.
Warum Datadog statt Better Stack?
Tieferes APM. Better Stack hat eBPF-Tracing, aber APM, Profiling und Service Maps von Datadog gehen bei verteilten Systemen weiter.
Mehr Integrationen. Über 1.000, sodass fast alles in Ihrem Stack ohne Eigenentwicklung Metriken und Logs liefert.
Ein Ort für die Korrelation. Ein fehlgeschlagener synthetischer Test verlinkt auf den Trace, die Logs und die Host-Metriken.
Was Nutzer sagen
Aus einer G2-Bewertung vom Juli 2026:
„Eine der größten Stärken von Datadog ist, dass es Logs, Metriken, Traces und Alarme auf einer einzigen Plattform zusammenführt.“
Und die wiederkehrende Kritik, aus einer G2-Bewertung vom April 2026:
„Datadog ist teuer, und die Kosten können schneller steigen, als Sie erwarten.“
Was kostet Datadog?
Preise mit Jahresvertrag:
- Infrastructure: 15 $/Host/Monat (Pro) oder 23 $ (Enterprise); kostenlos für bis zu 5 Hosts mit 1 Tag Aufbewahrung
- APM: 31 $/Host/Monat
- Synthetische API-Tests: 5 $ pro 10.000 Runs
- Synthetische Browser-Tests: 12 $ pro 1.000 Runs
- Logs: 0,10 $/GB aufgenommen, plus 1,06 $ bis 2,50 $ pro Million indexierter Events
- On-Call: 20 $ pro Nutzerplatz; Incident Management 30 $ pro Nutzerplatz
Hundert API-Tests jede Minute ergeben 4,3 Millionen Runs im Monat, also rund 2.160 $ vor On-Call.
Wo Datadog an Grenzen stößt
Für Uptime-Checks ist es teuer: Bei einem Check pro Minute kosten 100 API-Tests mehr als alle anderen Setups in der Kostentabelle zusammen. Die Rechnungen sind schwer vorherzusagen, und die Kosten sind die häufigste Kritik in aktuellen G2-Bewertungen. Wenn Sie von Better Stack Monitore, Alarmierung und eine Statusseite brauchen, ist Datadog der falsche Tausch.
Ist Datadog das Richtige für Sie?
Wählen Sie Datadog, wenn Traces und APM der Grund sind, warum Ihnen Better Stack nicht mehr reicht, und jemand im Team die Rechnung verantwortet. Viele Datadog-Kunden betreiben trotzdem ein separates Uptime-Tool für Prüfungen von außen und die Statusseite. Wenn Sie nur Host-Metriken und Uptime brauchen, zeigt der Vergleich Hyperping vs Datadog, worauf Sie verzichten.
PagerDuty: am besten für Rufbereitschaft über viele Teams hinweg
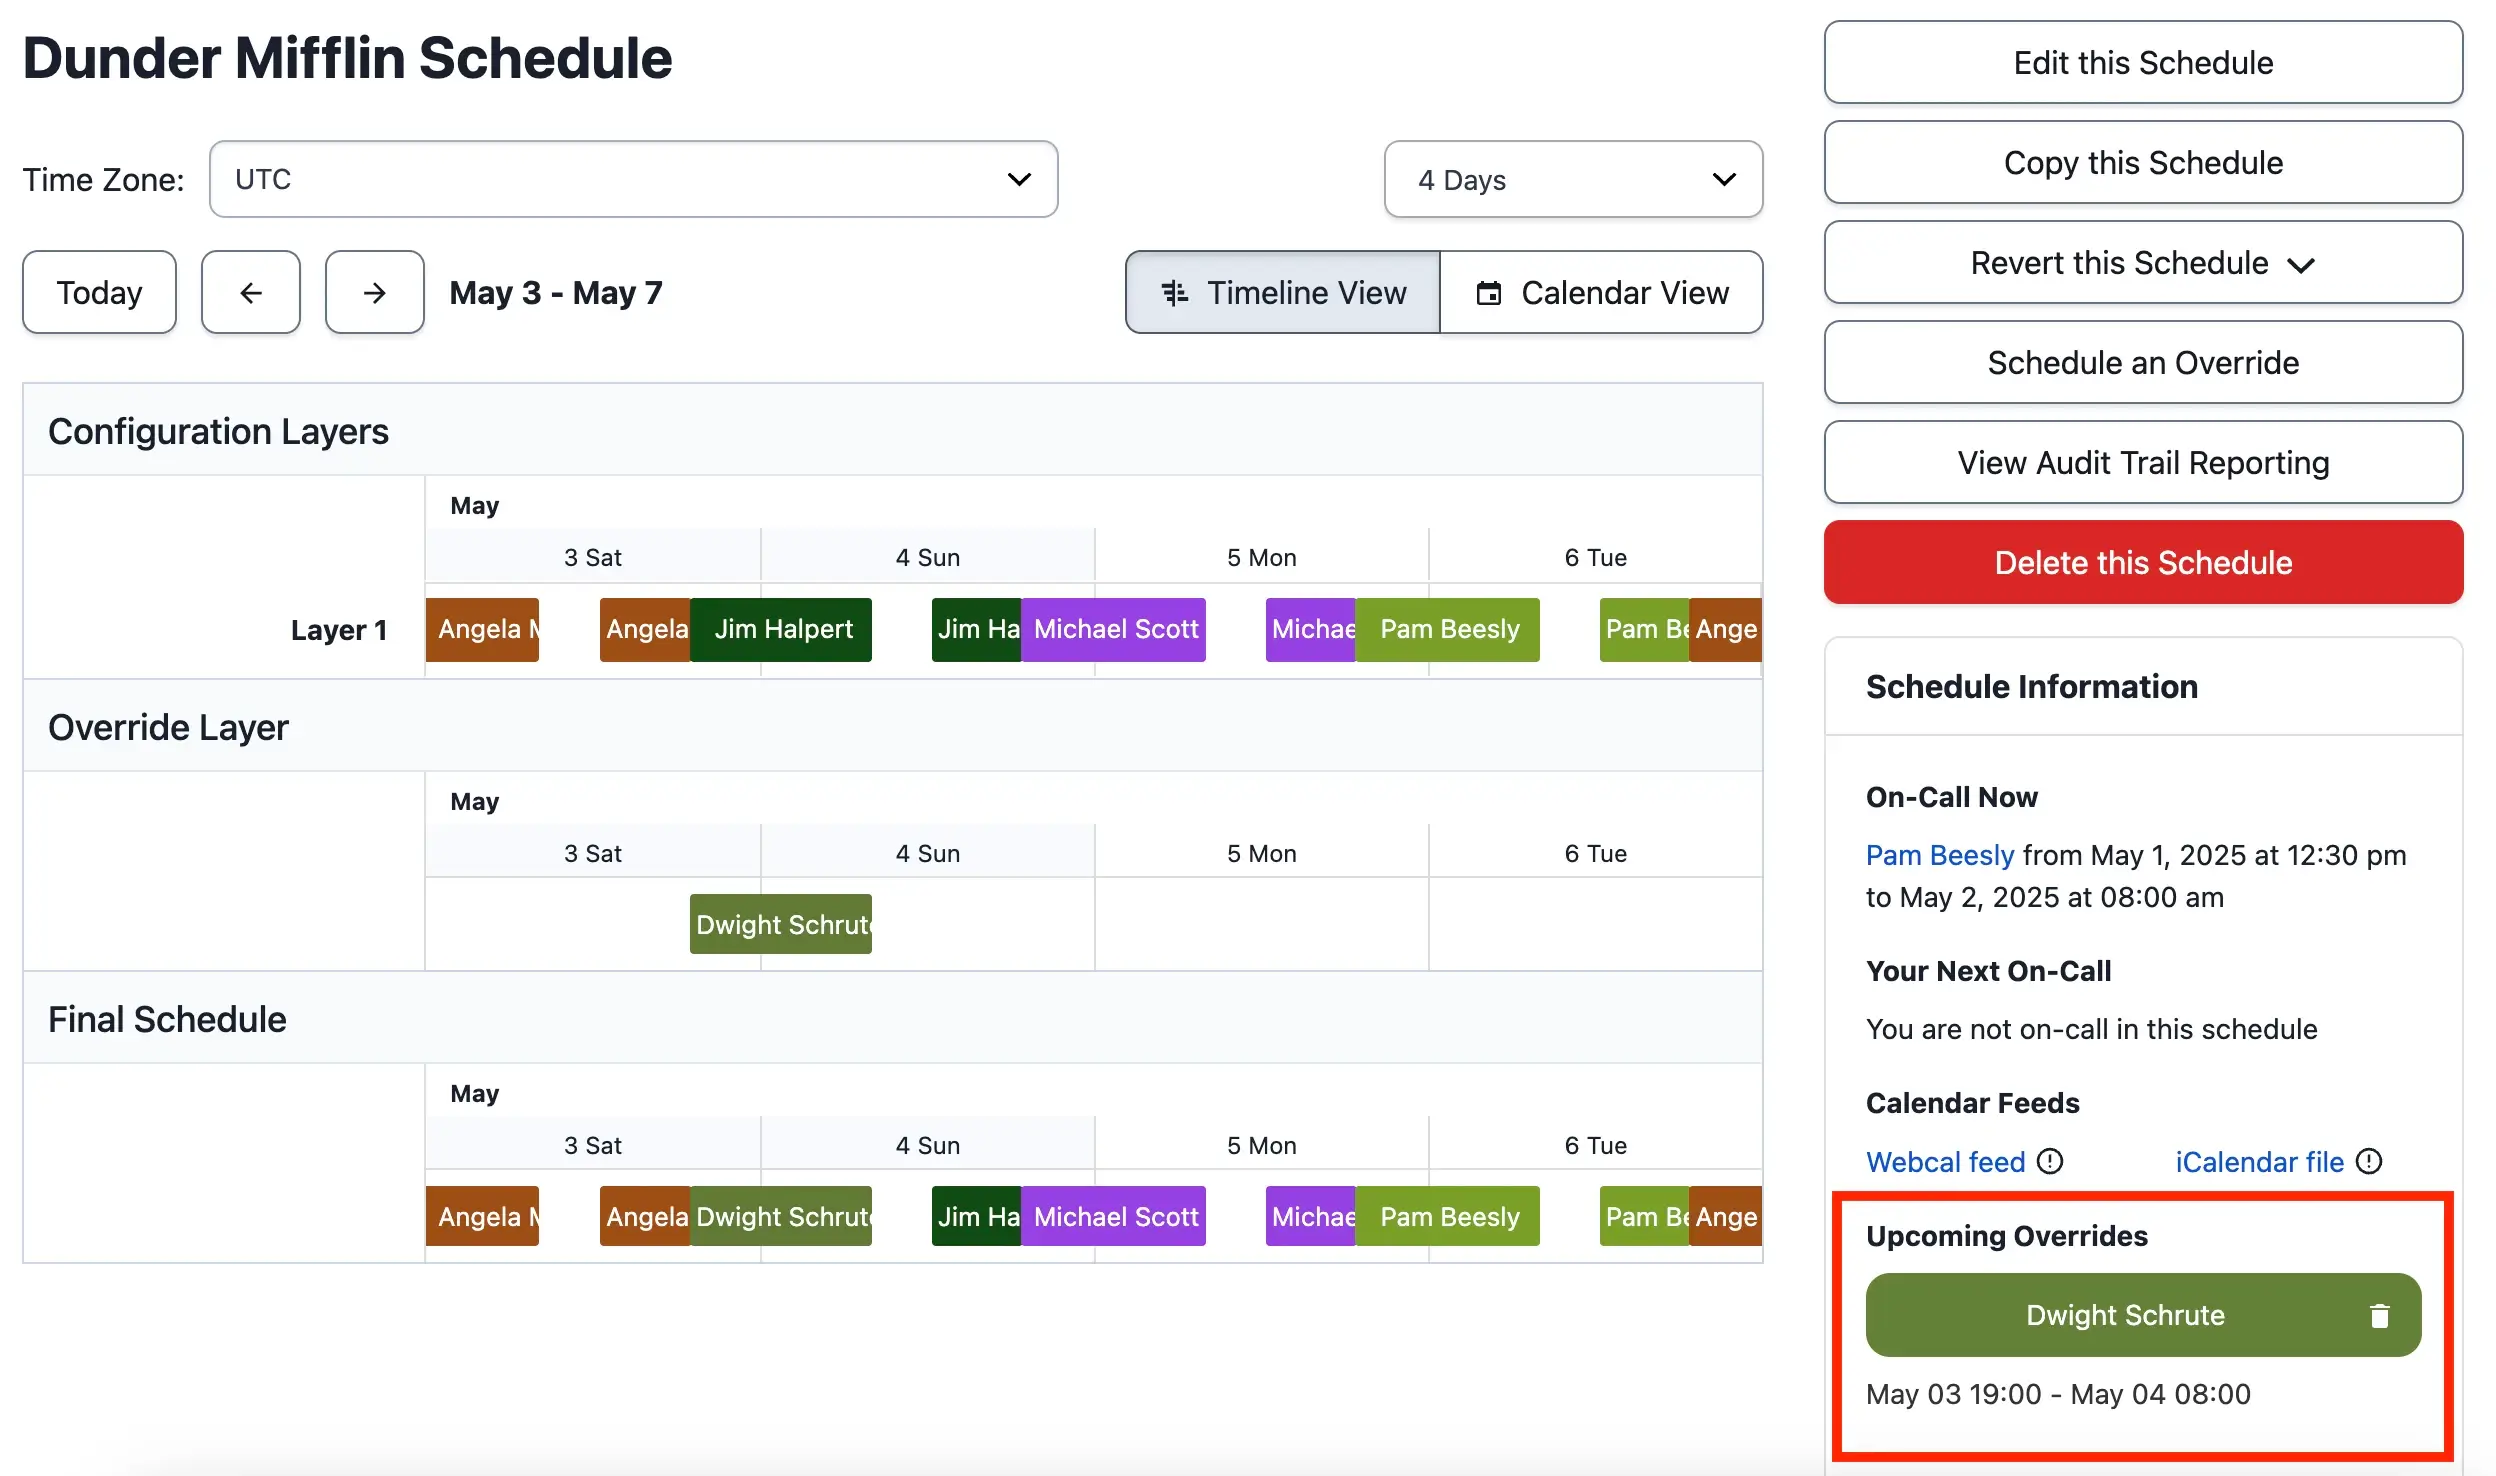
PagerDuty ist das On-Call-Tool, an dem sich die meisten anderen messen lassen: Bereitschaftspläne, Eskalation, Event-Routing und mehr als 700 Integrationen. Es prüft Ihre Websites nicht, ersetzt also die Alarmierung von Better Stack, nicht die Monitore.
| Am besten für | Einstiegspreis | Größte Einschränkung |
|---|---|---|
| Rufbereitschaft über viele Teams hinweg | Kostenlos bis 5 Nutzer; 21 $/Nutzer/Monat | Prüft selbst nichts; Abrechnung pro Nutzer |
Für wen PagerDuty gemacht ist
Größere Engineering-Organisationen mit vielen Teams, Follow-the-Sun-Rotationen und Alarmen aus einem Dutzend Monitoring-Tools. Wenn Ihrer Rufbereitschaft bei Better Stack einfache Rotationen nicht mehr reichen oder Alarme Routing-Regeln durchlaufen müssen, bevor jemand alarmiert wird, ist PagerDuty genau dafür gebaut.
Wichtige Funktionen
- Bereitschaftspläne. Mehrschichtige Rotationen, Overrides, Shadowing und Follow-the-Sun.
- Eskalationsrichtlinien. Mehrere Stufen, wiederholt, bis jemand quittiert.
- Event Orchestration. Routing- und Unterdrückungsregeln, bevor aus einem Alarm ein Incident wird.
- AIOps. Gruppierung von Alarmen und Unterdrückung von Alarmrauschen, als Add-on verkauft.
- Statusseiten. Eine externe Seite mit bis zu 250 Abonnenten in Professional.
Warum PagerDuty statt Better Stack?
Routing für viele Teams. Event Orchestration und Service-Abhängigkeiten verarbeiten Alarme aus vielen Quellen über viele Teams hinweg, wofür die Eskalationsrichtlinien von Better Stack nicht ausgelegt sind.
Es nimmt Alarme von überall an. Mit mehr als 700 Integrationen sitzt PagerDuty über allen Monitoren, die Sie betreiben, einschließlich Better Stack selbst.
Was Nutzer sagen
Die Alarmierung wird gelobt, die Abrechnung kritisiert. Aus einer G2-Bewertung vom Juli 2026:
„Die Abrechnung ist irreführend und teuer. Die Oberfläche erweckt den Eindruck, die Nutzerplätze würden automatisch zugewiesen, und die Anzahl lässt sich nicht einfach reduzieren.“
Was kostet PagerDuty?
- Free: bis 5 Nutzer, 1 Bereitschaftsplan, 1 Eskalationsrichtlinie, 100 SMS- und Anrufbenachrichtigungen im Monat
- Professional: 21 $/Nutzer/Monat (25 $ monatlich)
- PD Reliability Platform: jährlich im Voraus abgerechnet, mit AIOps und Automatisierung. Starter 2.800 $ (10 Nutzerplätze), Essential 12.000 $ (20 Nutzerplätze), Plus 48.000 $ (50 Nutzerplätze), Ultimate auf Anfrage (500 Nutzerplätze). Zusätzliche Nutzerplätze kommen aus Credit-Paketen
Fünf Personen in Professional kosten 105 $ im Monat, noch ohne Monitoring-Tool.
Wo PagerDuty an Grenzen stößt
Es hat keine Uptime-Checks, Sie zahlen also weiterhin für einen Monitor. Jede Person in einem Bereitschaftsplan ist ein zahlender Nutzer, und die nützlichen Extras stecken in Plattform-Stufen, die jährlich im Voraus abgerechnet werden. Kleine Teams empfinden die Einrichtung von Services, Richtlinien und Bereitschaftsplänen als schwerfällig.
Ist PagerDuty das Richtige für Sie?
Wählen Sie PagerDuty, wenn sich die Rufbereitschaft über viele Teams und Alarmquellen erstreckt und Sie für die Checks ein separates Tool behalten. Für ein Team mit ein paar Dutzend Monitoren decken Hyperping oder Better Stack die Rufbereitschaft günstiger ab.
incident.io: am besten für Incident Response in Slack oder Teams
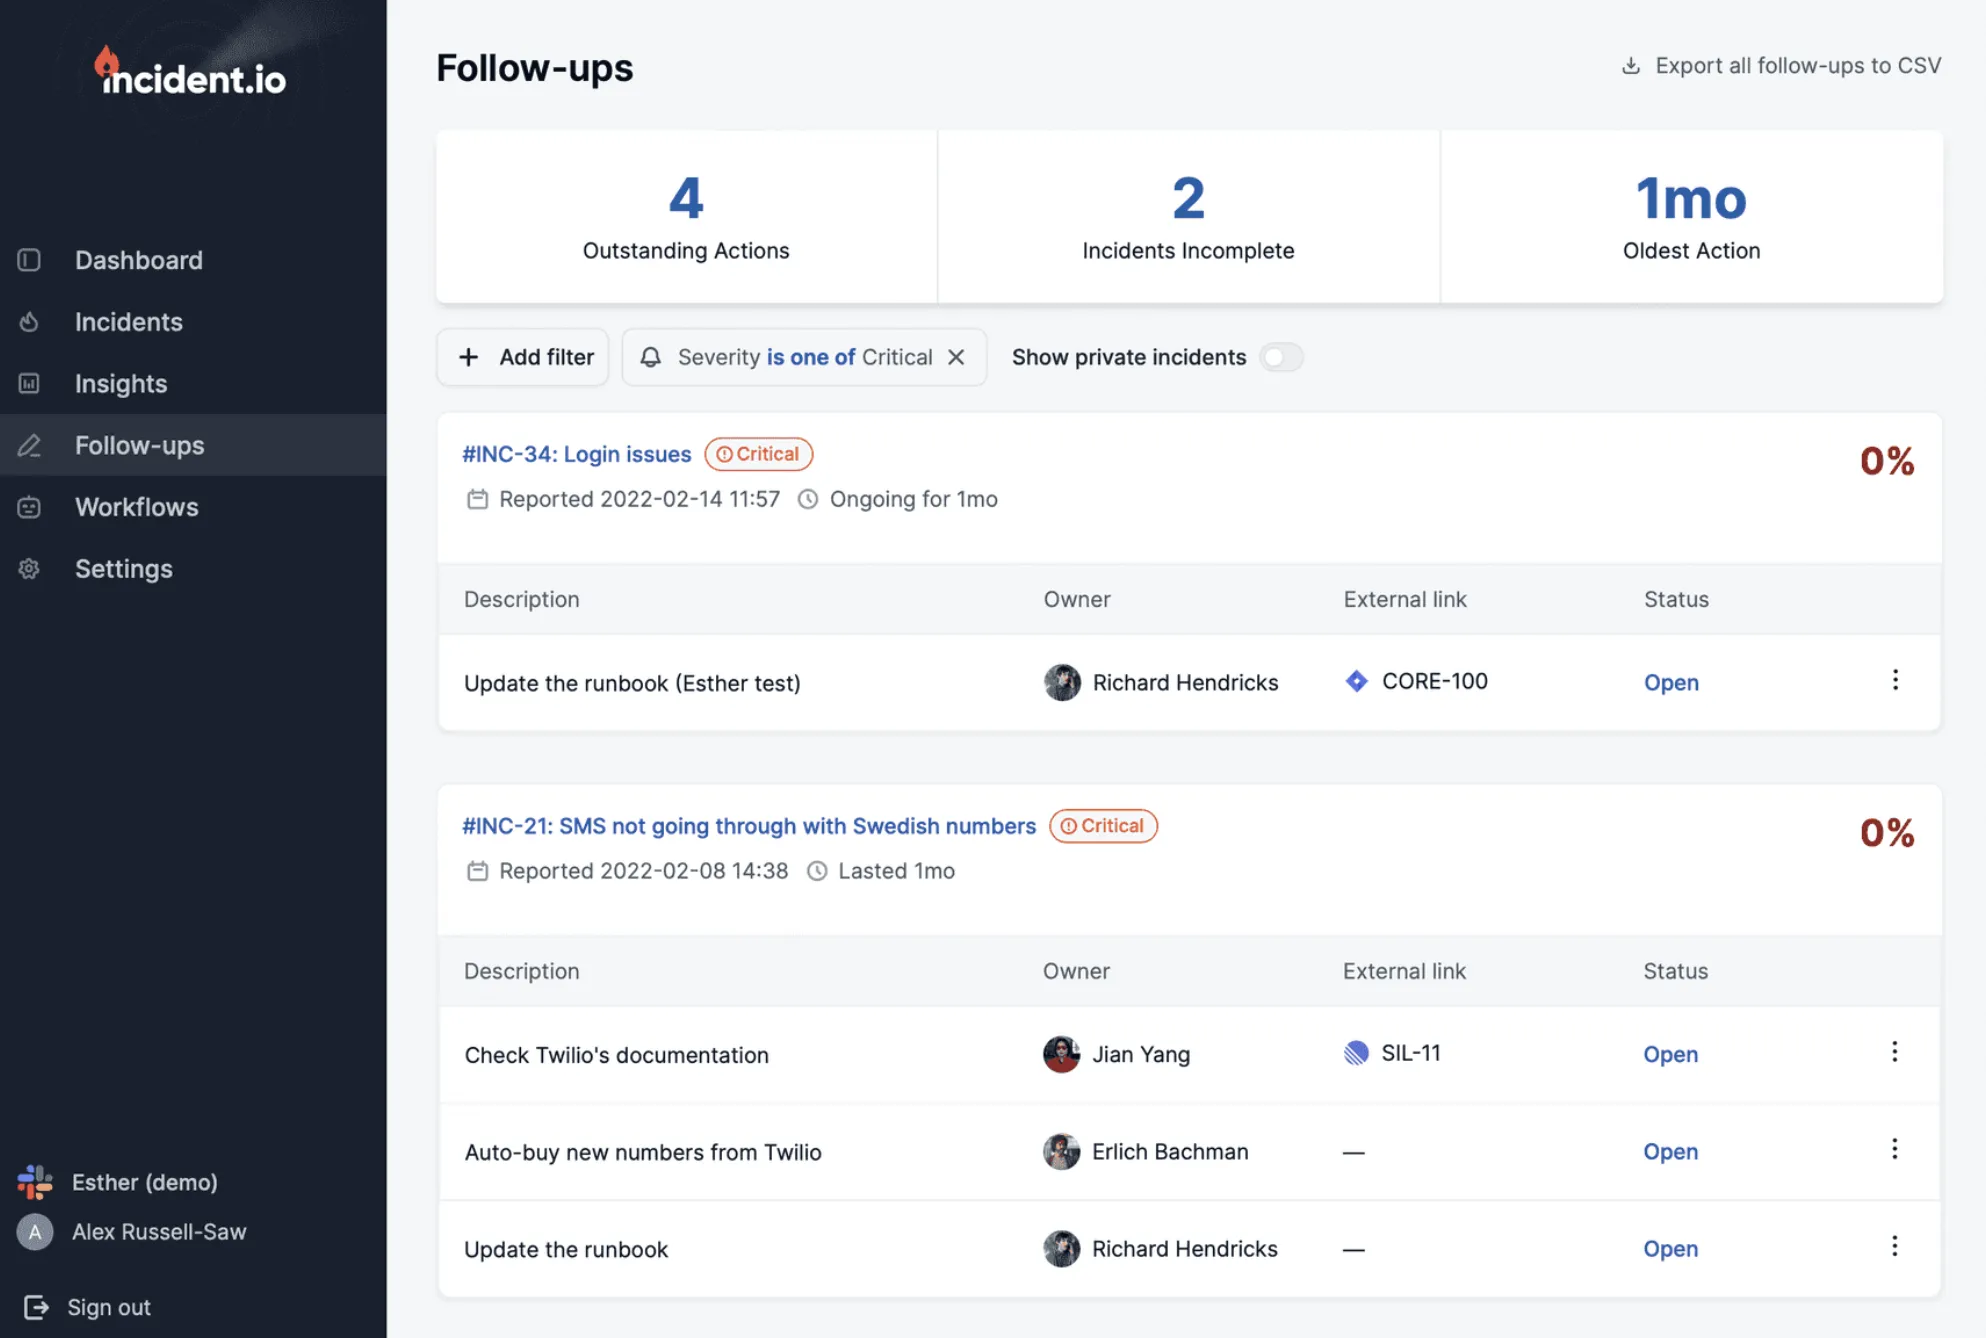
incident.io wickelt Incidents direkt in Slack oder Microsoft Teams ab: ein Channel pro Incident, Rollen, Updates, Post-Mortems und eine KI, die die Ursache untersucht. Rufbereitschaft und Statusseiten sind Teil des Produkts. Wie PagerDuty prüft es Ihre Websites nicht.
| Am besten für | Einstiegspreis | Größte Einschränkung |
|---|---|---|
| Incident Response in Slack oder Teams | Kostenlos; 25 $/Nutzer/Monat mit On-Call | Prüft selbst nichts; Abrechnung pro Nutzer |
Für wen incident.io gemacht ist
Engineering-Teams mit so vielen Incidents, dass sie einen Prozess brauchen: Wer leitet, wer informiert die Kunden, und was passiert im Post-Mortem. Sie arbeiten ohnehin in Slack und wollen den Incident dort abwickeln.
Wichtige Funktionen
- Incidents in Slack und Teams. Channels, Rollen, eigene Felder und Timelines.
- Rufbereitschaft. Bereitschaftspläne, Overrides, Shadow-Rotationen und Live-Anrufweiterleitung.
- Statusseiten. 1 öffentliche Seite in jedem Plan, interne Seiten ab Team, unbegrenzt in Enterprise.
- Workflows. Automatisierungen, die je nach Schweregrad oder Incident-Typ laufen.
- KI. Scribe schreibt in Calls mit, und Untersuchungen suchen nach der Ursache.
Warum incident.io statt Better Stack?
Der Incident-Prozess ist das Produkt. Die Channel- und Thread-Workflows von Better Stack kosten 9 $ pro Responder zusätzlich zur Lizenz. incident.io ist darauf ausgelegt, den Incident zu führen, von der Meldung bis zum Post-Mortem.
Ein kostenloser Plan mit Rufbereitschaft. Basic enthält On-Call für ein Team und eine Statusseite.
Was Nutzer sagen
Aus einer G2-Bewertung vom August 2026:
„Ich liebe es, dass incident.io komplett in Slack integriert ist. Es fühlt sich an wie ein Kollege, der einen durch Incidents führt.“
Was kostet incident.io?
- Basic: kostenlos, On-Call für ein Team, 1 Statusseite, 2 Integrationen
- Team: 15 $/Nutzer/Monat (19 $ monatlich), plus 10 $/Nutzer für On-Call
- Pro: 25 $/Nutzer/Monat, plus 20 $/Nutzer für On-Call
- Nur On-Call: 20 $/Nutzer/Monat
Fünf Personen in Team mit On-Call kosten 125 $ im Monat, noch ohne Monitoring-Tool.
Wo incident.io an Grenzen stößt
Es gibt keine Uptime-Checks, es braucht also einen Monitor davor. On-Call ist in jedem bezahlten Plan ein Add-on, der tatsächliche Preis liegt also bei 25 $ bis 45 $ pro Nutzer. Ein G2-Rezensent schrieb im Juli 2026, es „kann zu laut werden und am Ende auch falsch konfiguriert sein“.
Ist incident.io das Richtige für Sie?
Wählen Sie incident.io, wenn Ihnen der Incident-Prozess wichtiger ist als die Monitore und Sie es mit Alarmen aus Hyperping, UptimeRobot oder Datadog versorgen. Bei ein paar Incidents im Monat ist es mehr Prozess, als Sie brauchen.
Axiom: am besten für große Log-Volumen bei kleiner Rechnung
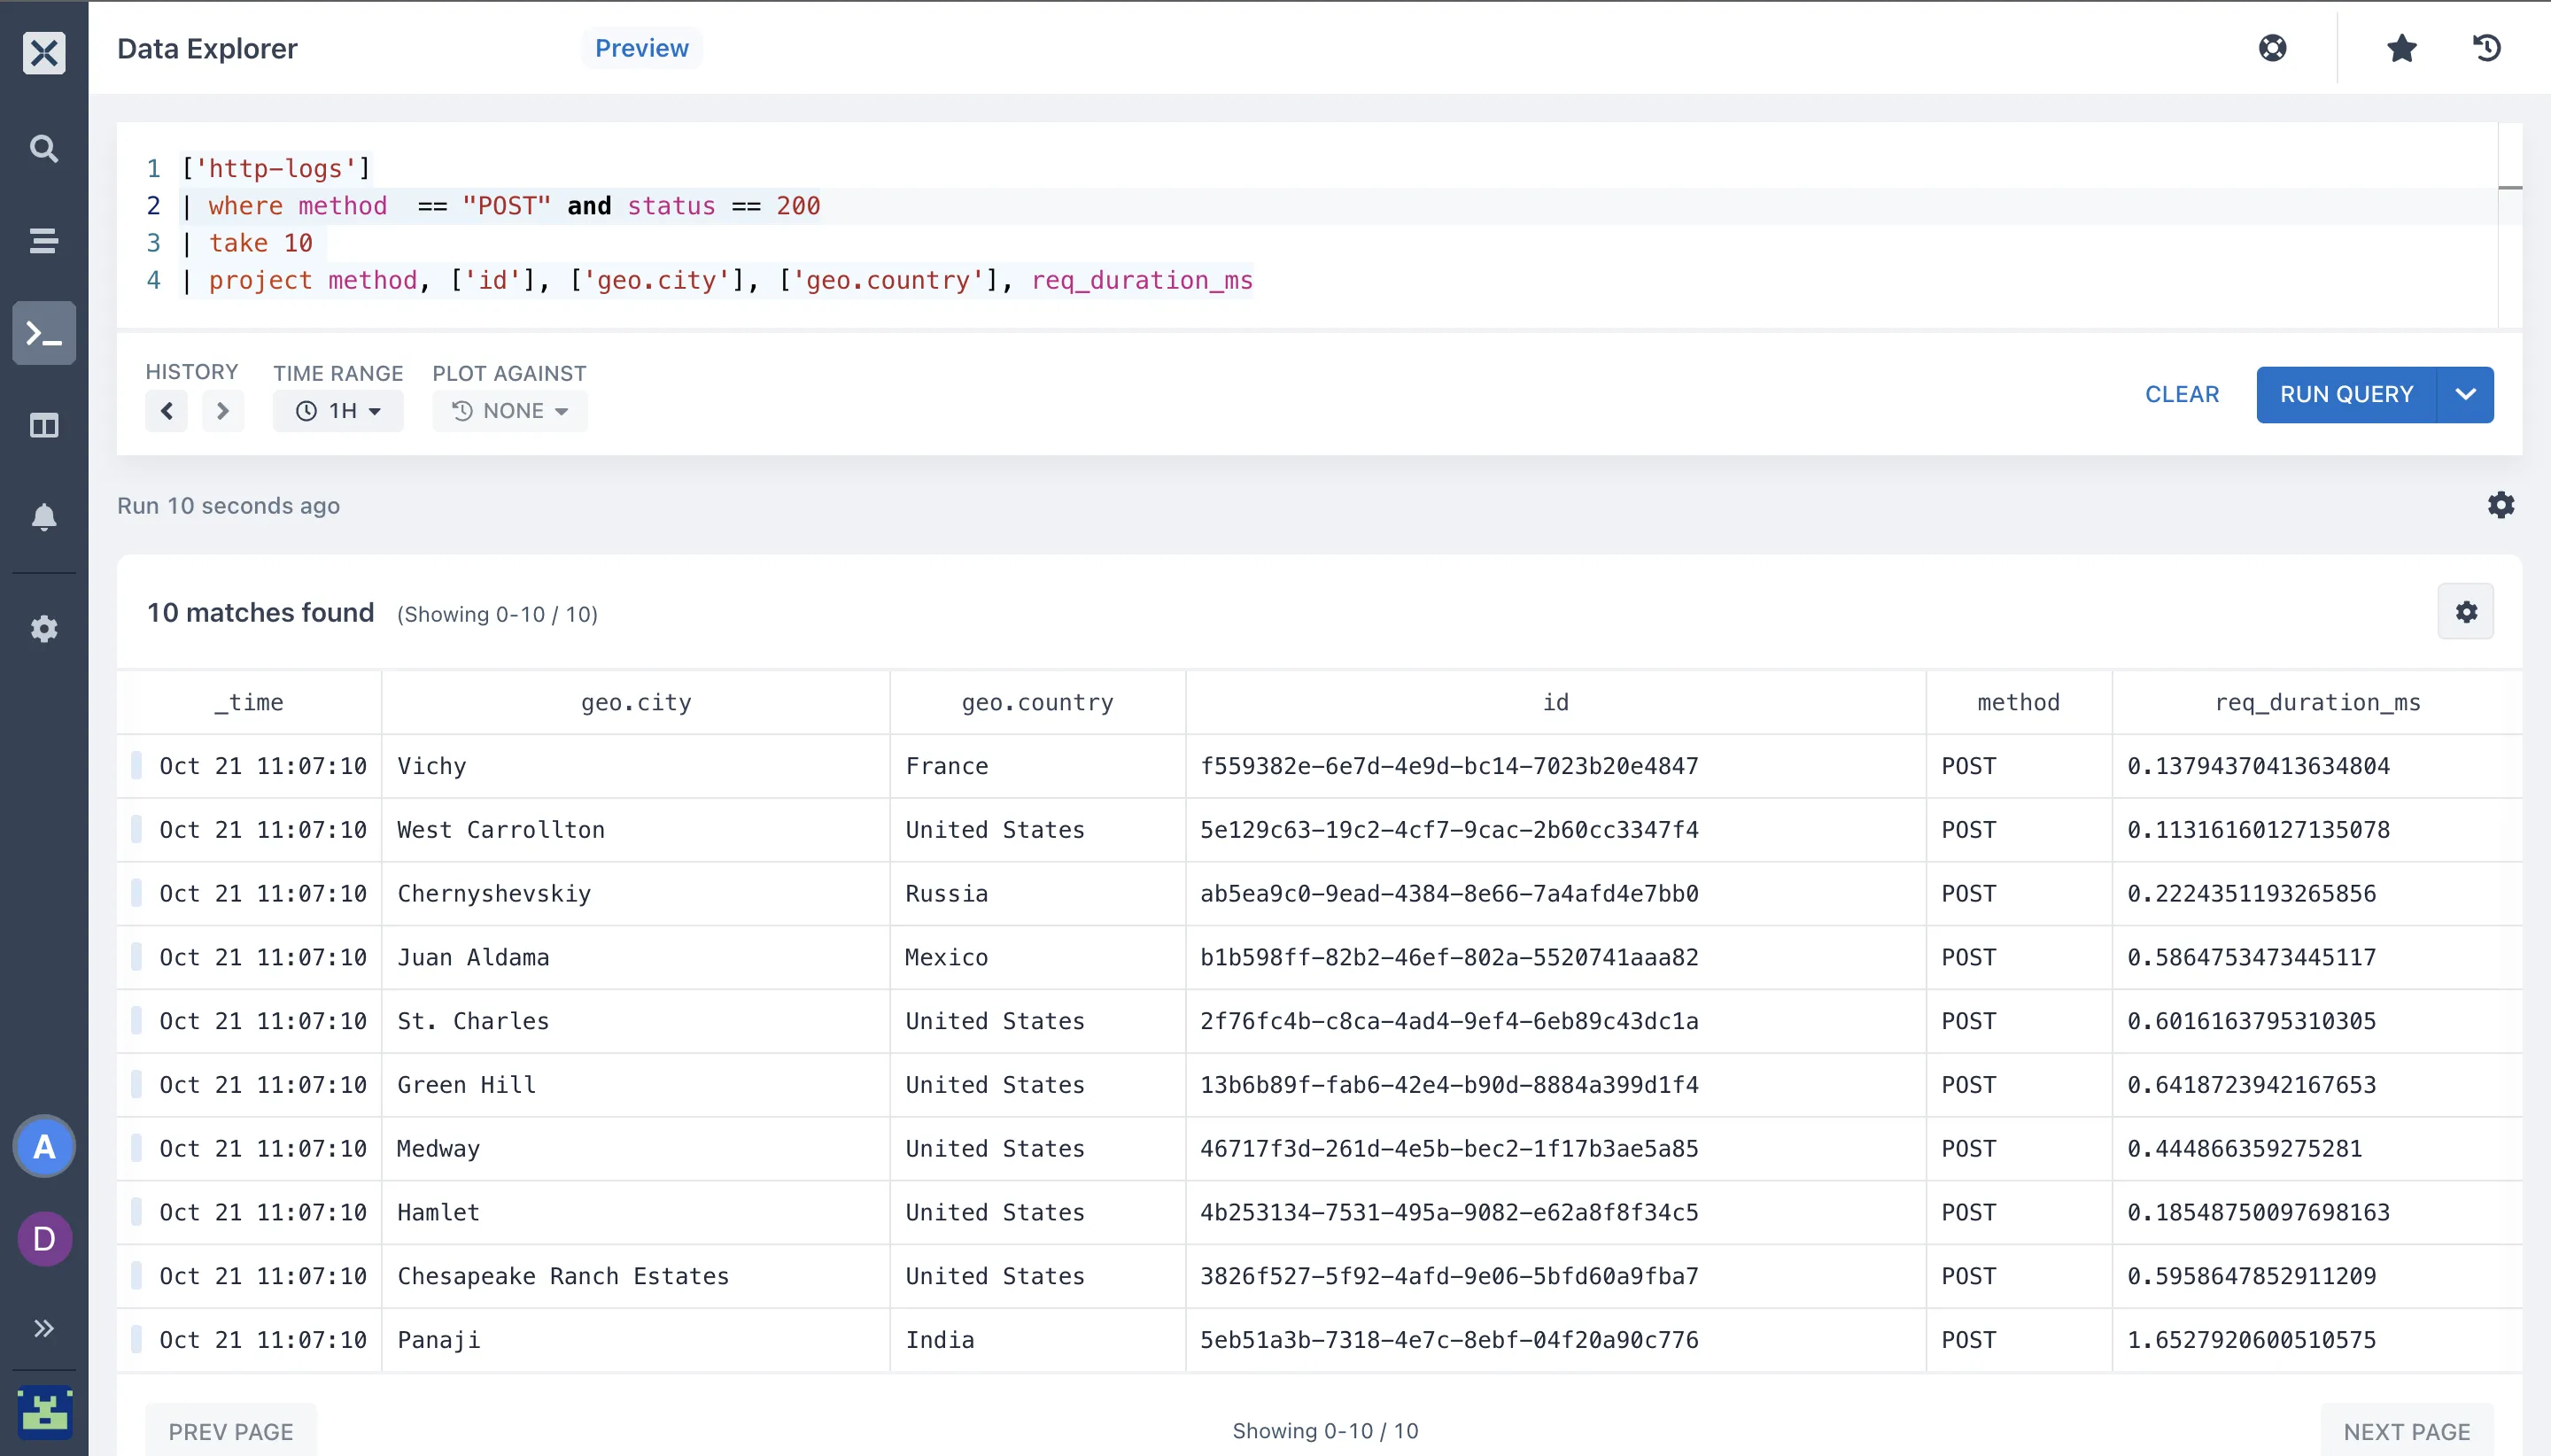
Axiom speichert Logs, Traces und Events komprimiert und rechnet Ingest und Abfragezeit getrennt ab. Es ersetzt die Telemetrie-Seite von Better Stack, nicht die Monitore oder die Alarmierung.
| Am besten für | Einstiegspreis | Größte Einschränkung |
|---|---|---|
| Große Log-Volumen bei kleiner Rechnung | Kostenlos 500 GB; 25 $/Monat | Keine Uptime-Checks, keine Rufbereitschaft, keine Statusseite |
Für wen Axiom gemacht ist
Entwickler und kleine Plattform-Teams, die Hunderte GB im Monat senden, oft aus Vercel, Cloudflare oder AWS Lambda, und Logs monatelang ohne Sampling aufbewahren wollen. Es gibt Axiom nur in der Cloud.
Wichtige Funktionen
- Ingest. OpenTelemetry, HTTP, Syslog, Vector, Fluent Bit, CloudWatch und Endpunkte, die mit Elasticsearch, Splunk und Loki kompatibel sind.
- Vercel. Eine Marketplace-Integration mit fertigem Dashboard und Monitoren.
- APL. Eine Abfragesprache mit Pipes, mit Query-Builder und Abfragen, die aus normaler Sprache erzeugt werden.
- Monitore. Alarme für Schwellenwerte, Treffer, Anomalien und fehlende Daten, an Slack, PagerDuty oder Opsgenie.
- Aufbewahrung. Beliebig lang, alte Daten bleiben durchsuchbar.
Warum Axiom statt Better Stack?
1 TB im Monat für 25 $. Better Stack ist bei kleinen Mengen pro GB günstig, aber ab ein paar hundert GB kostet das inklusive Terabyte von Axiom weniger.
Logs so lange behalten, wie Sie wollen. Die Aufbewahrung wird pro Dataset ohne Obergrenze festgelegt, und alte Daten müssen nicht erst rehydriert werden.
Was Nutzer sagen
Aus einem Hacker-News-Kommentar vom September 2025:
„Axiom will 60 $/Monat, wenn man ihnen ein Terabyte Logs schickt. Das ist praktisch nichts im Vergleich zu den Kosten von Entwicklern, die ohne detaillierte Logs Probleme debuggen müssen.“
Was kostet Axiom?
- Personal: kostenlos, 500 GB im Monat, 30 Tage Aufbewahrung, 1 Nutzer, 3 Monitore
- Axiom Cloud: 25 $/Monat mit 1 TB Ingest und 100 GB-Stunden Abfrage-Compute, danach 0,12 $/GB und 0,20 $ pro GB-Stunde
- Add-ons: SSO 100 $/Monat, RBAC 50 $/Monat
Wo Axiom an Grenzen stößt
Es gibt keine Uptime-Checks, keine Rufbereitschaft, keine Incidents und keine Statusseiten, es ersetzt also nur einen Teil von Better Stack. Abfrage-Compute ist ein zweiter Zähler, und am Ausgabelimit stoppen Abfragen und Monitore. Der kostenlose Plan hat einen Nutzer, und unabhängige Bewertungen gibt es kaum.
Ist Axiom das Richtige für Sie?
Wählen Sie Axiom, wenn Logs Ihr größter Posten bei Better Stack sind und Sie Monitore und Rufbereitschaft in einem anderen Tool behalten. Viele Teams kombinieren es mit Hyperping oder PagerDuty.
OneUptime: am besten, um den gesamten Stack selbst zu hosten
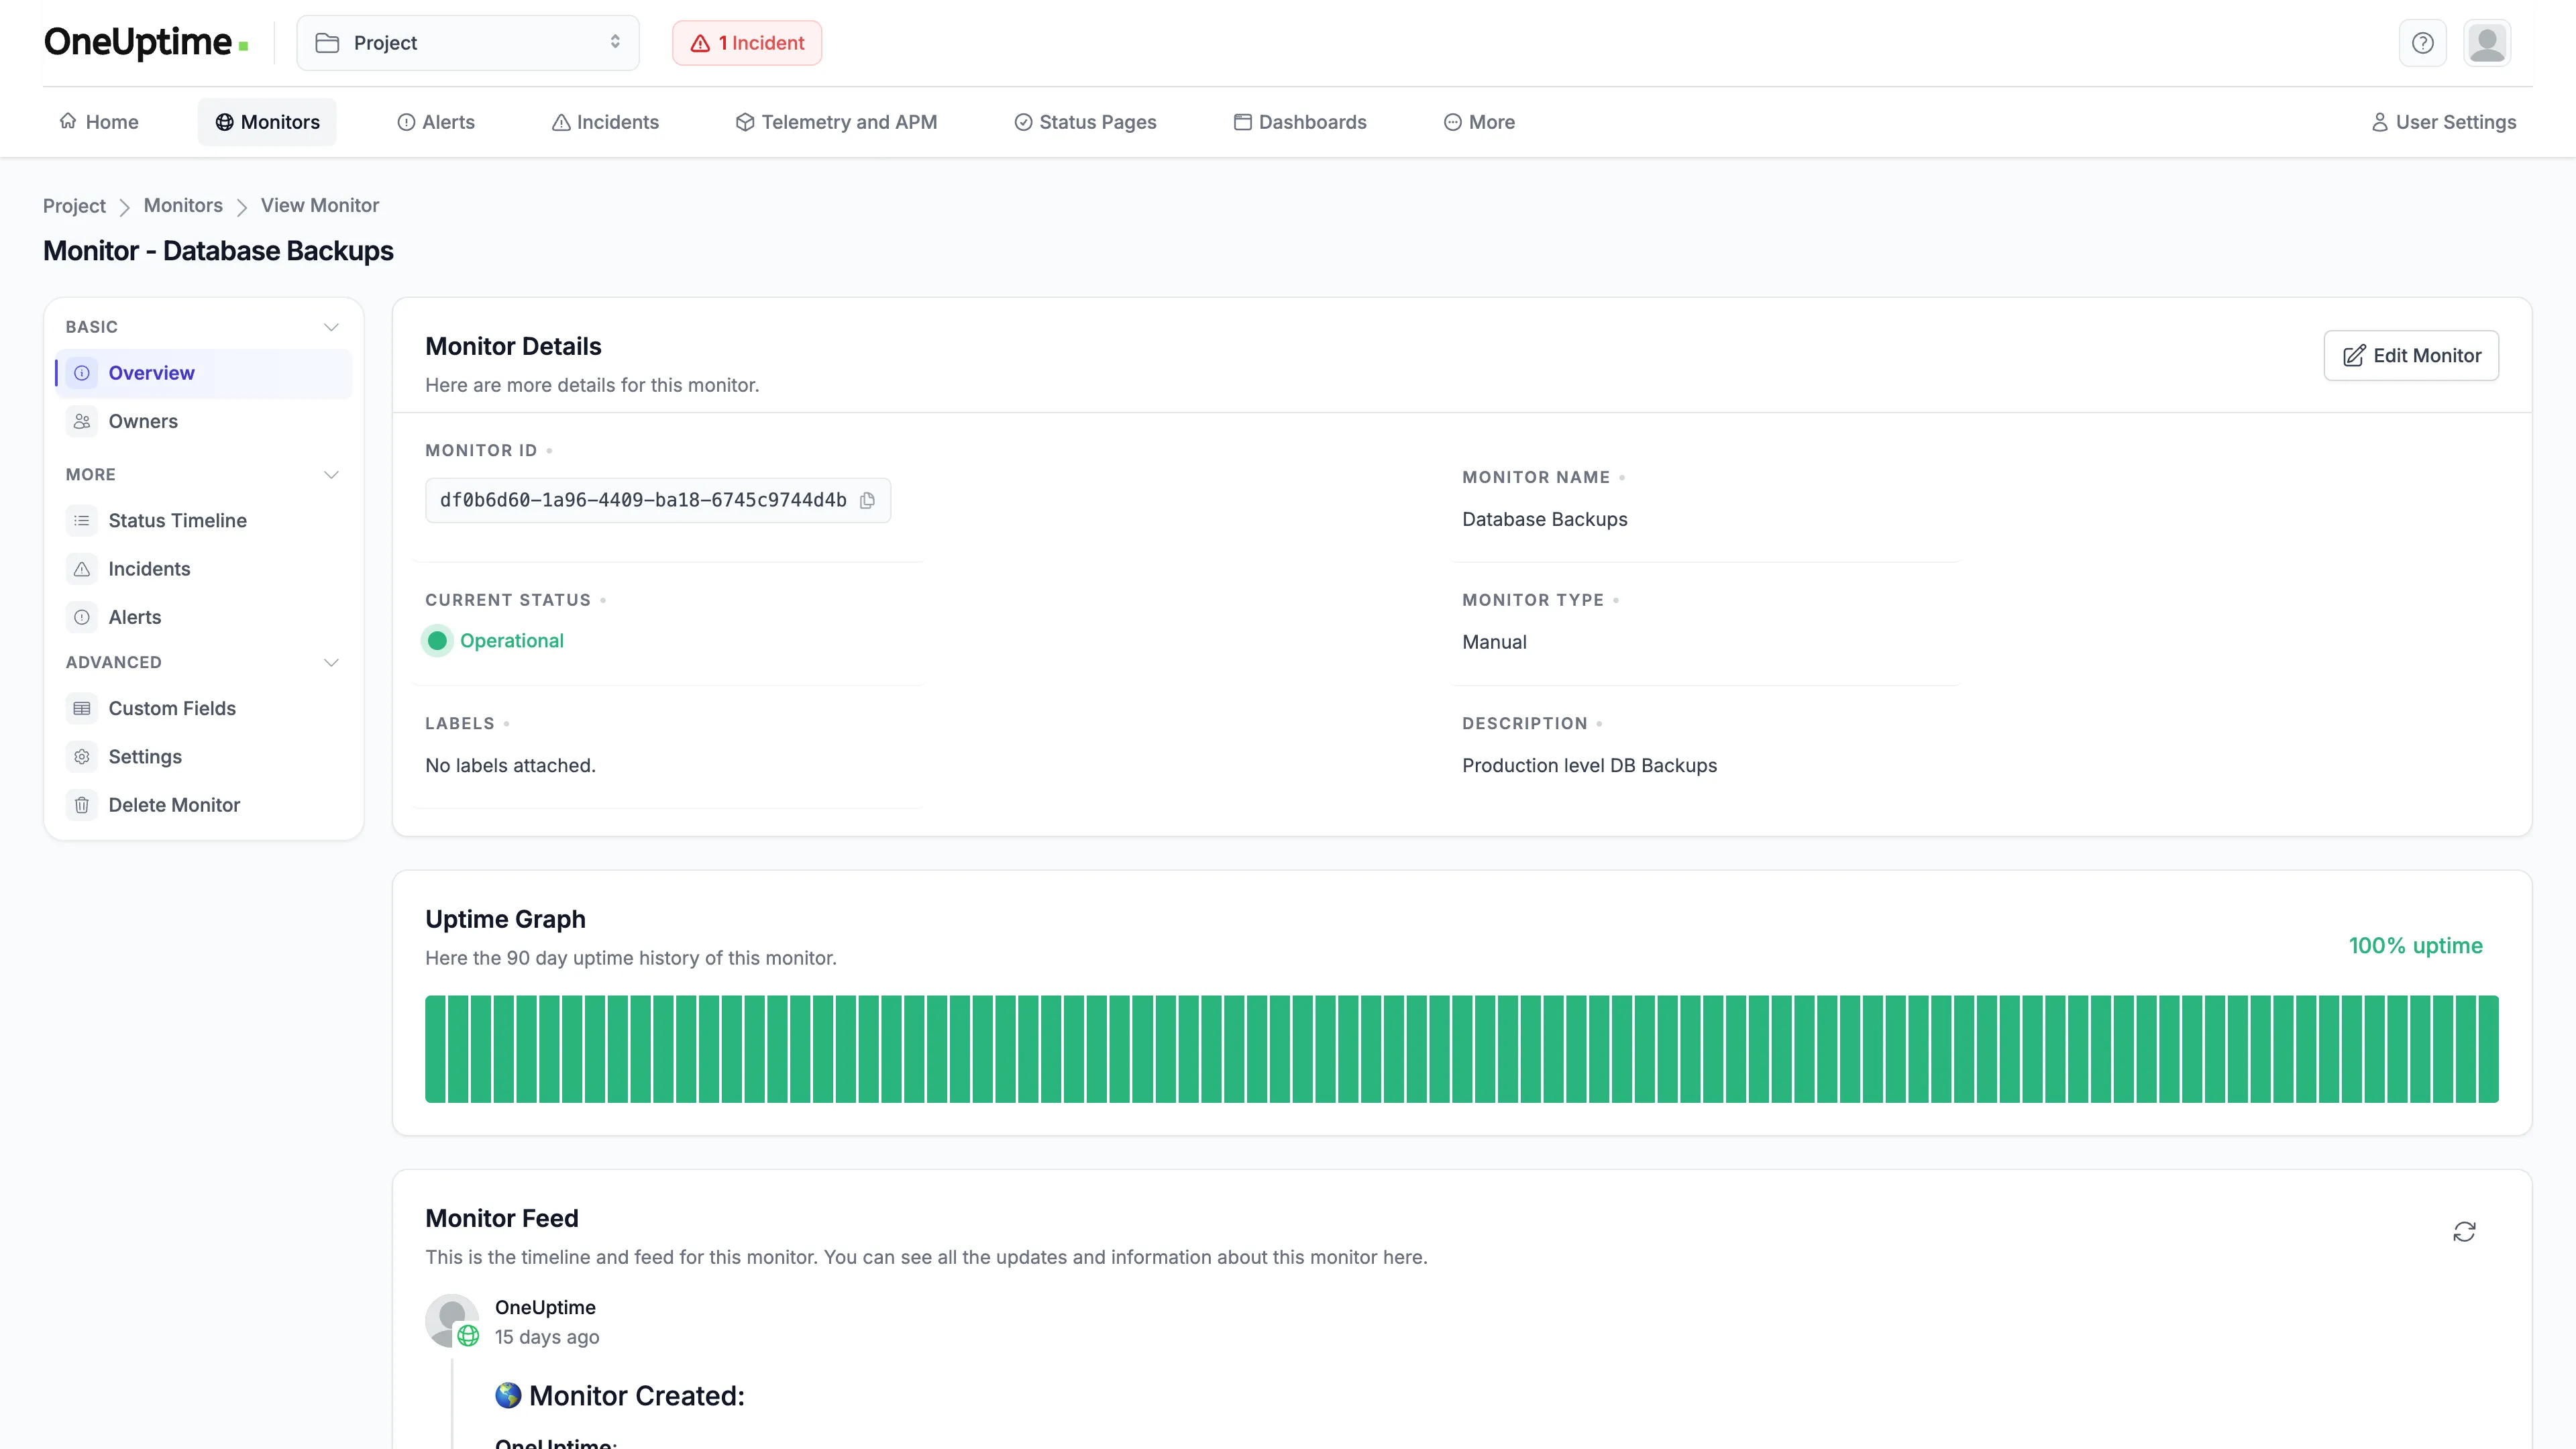
OneUptime ist eine Open-Source-Plattform, die fast alles abdeckt, was Better Stack verkauft: Monitore, Statusseiten, Rufbereitschaft, Incidents, Logs, Traces, Metriken und Error Tracking. Die Community Edition ist unter Apache 2.0 kostenlos, wenn Sie sie selbst betreiben, und OneUptime Cloud rechnet pro Nutzer plus 1 $ pro Monitor ab.
| Am besten für | Einstiegspreis | Größte Einschränkung |
|---|---|---|
| Den gesamten Stack selbst hosten | Selbst gehostet kostenlos; Growth 20 $/Nutzer/Monat + 1 $/Monitor | Aufwendig im Betrieb; Checks bestenfalls jede Minute |
Für wen OneUptime gemacht ist
Teams, die den Funktionsumfang von Better Stack auf eigenen Servern wollen, oft wegen Datenresidenz oder abgeschotteter Netze, und jemanden haben, der PostgreSQL, ClickHouse und ein Dutzend Container betreiben kann. Ein Großteil der Community kommt aus r/selfhosted, wo Leute von Uptime Kuma aufsteigen.
Wichtige Funktionen
- Monitore. Website, API, Ping, Port, SSL, DNS, Heartbeat, Playwright, eigenes JavaScript, SQL, Kubernetes, Docker, SNMP und mehr. Die längste Liste auf dieser Seite.
- Eigene Probes. Checks aus einem privaten Netzwerk oder einer VPC heraus ausführen.
- Rufbereitschaft. Rotationen, Overrides und Eskalationsrichtlinien, in der Cloud ab Growth.
- Statusseiten. Unbegrenzte öffentliche und private Seiten und Abonnenten ab Growth.
- Telemetrie. OpenTelemetry-Logs, Traces, Metriken, Exceptions und RUM auf ClickHouse.
- KI. Incident-Analyse und vorgeschlagene Fix-Pull-Requests, oder Sie bringen Ihr eigenes Modell mit.
Warum OneUptime statt Better Stack?
Sie können es selbst betreiben. Better Stack gibt es nur in der Cloud. Die Community Edition von OneUptime enthält Monitoring, Rufbereitschaft, Statusseiten, Telemetrie und SSO.
Statusseiten ohne Add-ons pro Seite. Growth enthält unbegrenzte Statusseiten und Abonnenten, während Better Stack 12 $ für jede weitere Seite berechnet.
Telemetrie auf Ihren eigenen Festplatten. Logs und Traces bleiben auf Ihren Servern, um den Preis der Hardware.
Was Nutzer sagen
Aus einem Kommentar auf r/selfhosted vom Februar 2024:
„Wow, das sieht großartig aus. Wie Better Stack, aber nicht unbezahlbar für Hobbyisten und kleine Teams“
Der Speicherbedarf ist die wiederkehrende Kritik. Aus einem Kommentar auf r/selfhosted vom März 2025:
„Sehr cooles Produkt! Mein einziges Problem ist, wie speicherhungrig es ist! Im Leerlauf liege ich bei 10 GB.“
Was kostet OneUptime?
- Community Edition: kostenlos, selbst gehostet, Apache 2.0
- Free (Cloud): 1 Statusseite, nur manuelle Monitore; jeder automatisierte Check kostet 1 $/Monat
- Growth: 20 $/Nutzer/Monat (22 $ monatlich), mit Rufbereitschaft, unbegrenzten Statusseiten und API-Zugriff
- Scale: 84 $/Nutzer/Monat (99 $ monatlich), mit SSO und White-Label-Statusseiten
- Nutzung: 1 $ pro Monitor und Monat, 0,10 $ pro SMS oder Anrufminute, 0,10 $ pro GB Telemetrie bei 15 Tagen Aufbewahrung
Fünf Nutzer mit 100 Monitoren kosten in Growth 200 $ im Monat, noch ohne SMS und Anrufe.
Wo OneUptime an Grenzen stößt
Self-Hosting ist aufwendig: Das empfohlene Docker-Setup braucht 16 GB RAM, 8 Kerne und 400 GB Speicherplatz, und GitHub-Issues aus 2025 und 2026 berichten von Upgrades mit fehlgeschlagenen Migrationen und in einem Fall von Statusseiten-Abonnenten, die nach einem Update Tausende E-Mails bekamen. Checks laufen höchstens jede Minute. In der Cloud ist jeder, der Monitore verwaltet, ein zahlender Nutzer, jeder Monitor kostet 1 $, und das OneUptime-Branding zu entfernen erfordert Scale für 84 $ pro Nutzer. Es gibt nur drei G2-Bewertungen.
Ist OneUptime das Richtige für Sie?
Wählen Sie OneUptime, wenn Ihnen der Betrieb auf eigenen Servern wichtiger ist als die Zeit, die die Wartung kostet. Wenn Sie es lieber nicht selbst betreiben, kosten die Cloud-Pläne für dasselbe Team mehr als Better Stack.
Direktvergleiche
Better Stack vs UptimeRobot
UptimeRobot gewinnt beim kostenlosen Plan, mit 50 Monitoren gegenüber 10 bei Better Stack, und bei den Statusseiten, mit 100 in Team für 39 $ im Monat bei jährlicher Abrechnung. Better Stack gewinnt, sobald jemand alarmiert werden muss: Es hat Bereitschaftspläne, Eskalation sowie unbegrenzte Anrufe und SMS, und UptimeRobot hat nichts davon. Wählen Sie UptimeRobot für günstige Checks ohne Bereitschaft, und Better Stack oder Hyperping, wenn Ausfälle einen Verantwortlichen brauchen.
Better Stack vs Datadog
Beide verkaufen Logs, Traces, Metriken, Uptime und Rufbereitschaft. Better Stack ist pro GB Logs deutlich günstiger und einfacher zu kalkulieren, Datadog hat das tiefere APM, mehr Integrationen und ausgereiftere Werkzeuge für große verteilte Systeme. Bei Uptime-Checks kosten die pauschalen Monitore von Better Stack einen Bruchteil der Synthetics von Datadog, die pro Run abgerechnet werden. Wählen Sie Better Stack für den gesamten Stack eines Startups auf einer Rechnung, und Datadog, wenn Ihnen APM-Tiefe wichtiger ist als die Kosten.
Better Stack vs PagerDuty
Die Responder-Lizenz von Better Stack (29 $) kostet mehr als PagerDuty Professional (21 $), enthält aber die Monitore, die Statusseite sowie unbegrenzte Anrufe und SMS. PagerDuty alarmiert nur, das aber in viel größerem Maßstab, mit Event-Routing und mehr als 700 Integrationen. Wählen Sie Better Stack, wenn Sie ein Tool für ein einzelnes Team wollen, und PagerDuty, wenn sich die Rufbereitschaft über viele Teams und Tools erstreckt.
Better Stack vs incident.io
Beide wickeln Incidents in Slack ab und enthalten Rufbereitschaft und Statusseiten. incident.io ist um den Incident-Prozess herum gebaut, mit Rollen, Workflows und Post-Mortems, hat aber weder Monitore noch Telemetrie. Better Stack enthält Monitore und Logs und berechnet 9 $ pro Responder für seine vollständigen Slack-Workflows. Wählen Sie incident.io, wenn der Prozess das Problem ist, und Better Stack, wenn es um die Erkennung geht.
Welches Tool sollten Sie wählen?
| Käufer oder Situation | Empfohlenes Tool | Grund |
|---|---|---|
| Mehrere Personen in Bereitschaft, Monitore und eine Statusseite | Hyperping | Nutzerplätze, Rufbereitschaft und Statusseiten im Plan |
| Private, SSO- oder White-Label-Statusseiten | Hyperping | Private Seiten in Pro, White-Label in Business |
| Viele Checks, niemand in Bereitschaft | UptimeRobot | 50 kostenlose Monitore, 100 Statusseiten in Team |
| Eine Person in Bereitschaft, will Logs und Traces im selben Tool | Better Stack | Ein Responder reicht; Telemetrie ist pro GB günstig |
| APM und verteilte Traces | Datadog | Das tiefste APM in dieser Liste, mit Budgetverantwortlichem |
| Rufbereitschaft über viele Teams und Alarmquellen | PagerDuty | Routing, Bereitschaftspläne und mehr als 700 Integrationen |
| Ein formaler Incident-Prozess in Slack | incident.io | Darauf ausgelegt, den Incident zu führen |
| Hunderte GB Logs im Monat | Axiom | 1 TB für 25 $, beliebige Aufbewahrung |
| Alles auf eigenen Servern | OneUptime | Open Source, deckt alles von Monitoren bis Traces ab |
Wenn Ihre Better-Stack-Rechnung vor allem aus Responder-Lizenzen besteht, schauen Sie sich zuerst Hyperping an. Wenn es vor allem Telemetrie ist, schauen Sie sich Axiom für Logs oder Datadog für APM an und lassen Sie Monitoring und Rufbereitschaft dort, wo sie am günstigsten sind.
Wenn Sie bereits für PagerDuty oder incident.io zahlen, brauchen Sie keine Rufbereitschaft aus einem weiteren Tool. Kombinieren Sie es mit UptimeRobot für günstige Checks oder mit Hyperping für Checks mit Statusseiten, und schicken Sie die Alarme an das Alarmierungstool, das Sie schon haben.
Weitere ernstzunehmende Optionen
Weitere Tools für Uptime- und synthetisches Monitoring
| Tool | Größte Stärke | Größte Einschränkung | Gut für |
|---|---|---|---|
| Checkly | Playwright- und API-Checks als Code, in Git | Abrechnung pro Run; keine Rufbereitschaft | Entwickler, die Checks in der CI wollen |
| Pingdom | Transaktions-Checks und Real User Monitoring | Kein kostenloser Plan; veraltete Statusseiten | Websites, bei denen Ladezeiten zählen |
| StatusCake | Uptime-, Pagespeed-, SSL- und Domain-Checks | Keine Rufbereitschaft | Viele günstige Basis-Checks |
| Uptime.com | Mehr als 80 Prüfstandorte, Checks mit echtem Browser, SLA-Berichte | Erweiterte Checks kosten extra | Ops-Teams mit SLA-Reporting |
| Oh Dear | SSL, defekte Links, Lighthouse und Cron pro Website | Preis pro Website; kein kostenloser Plan | Agenturen in der EU |
| OnlineOrNot | 30-Sekunden-Checks, Browser-Checks und Rufbereitschaft | Zusätzliche Statusseiten kosten je 24 $/Monat | Kleine SaaS-Teams |
| Pulsetic | Statusseiten in jedem Plan | Keine Rufbereitschaft, keine Browser-Checks | Agenturen mit vielen Kundenseiten |
| Phare | Unternehmen aus der EU, nutzungsbasierte Preise, unbegrenzte Mitglieder | Keine Bereitschaftspläne | EU-Teams mit kleinem Budget |
| Cronitor | Cron-Job-Monitoring plus Uptime | Preis pro Monitor und pro Nutzer | Teams mit vielen geplanten Jobs |
| Site24x7 | Websites, Server, APM und Logs in einer Suite | Überladene Konsole, verwirrende Add-ons | Teams, die eine günstige Komplettsuite wollen |
Statusseiten-Tools
| Tool | Größte Stärke | Größte Einschränkung | Gut für |
|---|---|---|---|
| Instatus | Schnelle Seiten, jetzt mit einfachen Monitoren und Rufbereitschaft | Monitoring ist einfach | Zuerst eine Statusseite, dann Checks |
| Atlassian Statuspage | Benachrichtigungen für Abonnenten, Jira-Anbindung | Kein Monitoring; private Seiten ab 79 $/Monat | Unternehmen, die schon Atlassian nutzen |
| Statuspal | Unbegrenzte Statusseiten | Ab 46 $/Monat, wenige Bewertungen | Teams mit vielen Produkten |
| StatusGator | Zeigt Statusseiten von Anbietern neben Ihrer eigenen | Ein Nutzer in Starter | Teams, die von vielen SaaS-Anbietern abhängen |
| Hund | Checks in jede Komponente eingebaut | Komponentenpakete summieren sich | Teams, die Wahl beim Hosting wollen |
On-Call- und Incident-Tools
| Tool | Größte Stärke | Größte Einschränkung | Gut für |
|---|---|---|---|
| Rootly | Slack-Automatisierung und Retros | Kein kostenloser Plan; 40 $/Nutzer mit On-Call | Teams, die Incidents formalisieren |
| FireHydrant | Runbooks und Retros, kostenlos für 10 Responder | SMS und Anrufe kosten extra | Teams, die Runbooks wollen |
| Grafana Cloud IRM | Rufbereitschaft neben Grafana-Alarmen | Abrechnung pro Nutzer im Bereitschaftsplan | Teams, die schon Grafana nutzen |
| ilert | Hosting in der EU, Heartbeats, Opsgenie-Migration | Mindestens 3 Nutzer in Pro | EU-Teams, die Opsgenie verlassen |
| SolarWinds Incident Response (Squadcast) | Rufbereitschaft plus Incident-Workflows | Kein kostenloser Plan; starre Workflows | Mittelgroße Ops-Teams |
| Xurrent IMR (Zenduty) | Alarmierung im Stil von PagerDuty ab 6 $/Nutzer | Wenige unabhängige Bewertungen | Kleine Teams mit kleinem Budget |
| All Quiet | Niedriger Preis pro Nutzer, Statusseiten in Pro | Wenige Bewertungen | Kleine Teams |
| Splunk On-Call | Mobile Alarmierung mit Alarmkontext aus Splunk | Gilt als im Wartungsmodus | Bestehende Splunk-Kunden |
Observability- und Log-Suiten
| Tool | Größte Stärke | Größte Einschränkung | Gut für |
|---|---|---|---|
| Grafana Cloud | Loki, Tempo, k6-Checks und IRM, 50 GB kostenlos | LogQL braucht Einarbeitung | Teams, die schon Prometheus nutzen |
| New Relic | 100 GB im Monat kostenlos, APM inklusive | Volle Plattform-Nutzerplätze sind teuer | Kleine Teams, die APM wollen |
| Sentry | Fehler, Traces, Logs sowie Cron- und Uptime-Monitore | Einfache Log-Suche, maximal 30 Tage | Teams, die Anwendungsfehler debuggen |
| SigNoz | OpenTelemetry-Logs und -Traces, keine Gebühren pro Nutzerplatz | Aufwendig selbst zu hosten; schwache Alarmierung | Teams mit OpenTelemetry |
| Honeycomb | Abfragen mit hoher Kardinalität auf Events | Abrechnung pro Event | Teams, die mit Traces debuggen |
| Dash0 | OpenTelemetry-nativ, keine Grundgebühr | Kein kostenloser Plan, junges Produkt | Teams, die mit OpenTelemetry anfangen |
| Elastic Observability | Volltextsuche, auch selbst verwaltet möglich | Tuning kostet Engineering-Zeit | Teams, die Elasticsearch kennen |
| Dynatrace | KI-Ursachenanalyse, Synthetics, RUM | Kein kostenloser Plan, Jahresbindung | Große Unternehmen |
| Splunk | Suche über unordentliche Daten, Tiefe bei Security | Nur auf Anfrage, eines der teuersten | Security- und Compliance-Teams |
| Sematext | Logs, Infrastruktur und Synthetics, niedrige Preise | Berichte über Ausfälle und eine langsame Oberfläche | Kleine Teams mit kleinem Budget |
Open Source und selbst gehostet
| Tool | Größte Stärke | Größte Einschränkung | Gut für |
|---|---|---|---|
| Uptime Kuma | Kostenlos, viele Check-Typen, Statusseiten | Ein Knoten; fällt er aus, fallen auch die Checks aus | Homelabs und kleine Teams |
| Gatus | Checks in YAML definiert, in Git | Sie hosten es; keine Rufbereitschaft | Teams, die Konfiguration als Code wollen |
| Upptime | Läuft auf GitHub Actions, kein Server | Checks bestenfalls alle 5 Minuten | Nebenprojekte |
| GoAlert | Kostenlose Rufbereitschaft mit SMS und Anrufen über Twilio | Sie betreiben die Alarmierung selbst | Self-Hoster, die Rufbereitschaft brauchen |
| Healthchecks.io | Cron-Heartbeats, selbst hostbar | Nur Heartbeats | Cron-Jobs überwachen |
Freshping wurde 2026 eingestellt, Highlight.io hat im Februar 2026 geschlossen, und der Support für Opsgenie endet im April 2027. Deshalb habe ich alle drei weggelassen.
So testen Sie eine Better-Stack-Alternative
Jedes Tool auf der Shortlist hat einen kostenlosen Plan oder eine Testphase:
- Hyperping: 20 Monitore im kostenlosen Plan, dazu 14 Tage Test der bezahlten Pläne, ohne Kreditkarte
- UptimeRobot: 50 Monitore mit 5-Minuten-Intervall im kostenlosen Plan
- Datadog: 14 Tage Test der gesamten Plattform, ohne Kreditkarte
- PagerDuty: kostenloser Plan für bis zu 5 Nutzer, dazu 14 Tage Test
- incident.io: kostenloser Basic-Plan mit On-Call für ein Team
- Axiom: kostenloser Personal-Plan mit 500 GB im Monat, für einen Nutzer
- OneUptime: kostenlos selbst zu hosten, dazu 14 Tage Test von Growth
- Better Stack: Lassen Sie Ihren aktuellen Plan weiterlaufen, während Sie testen
Dann machen Sie absichtlich etwas kaputt:
- Legen Sie Ihre fünf wichtigsten Monitore neu an, mit denselben Intervallen und Regionen wie bei Better Stack.
- Blockieren Sie einen Prüfstandort und schauen Sie, ob das Tool den Ausfall aus einer anderen Region bestätigt, bevor es jemanden alarmiert.
- Ignorieren Sie einen Alarm. Prüfen Sie, wer als Nächstes angerufen wird, wie lange das dauert und wie das Quittieren die Eskalation stoppt.
- Veröffentlichen Sie Ihre Statusseite so, wie Ihre Kunden sie heute sehen: eigene Domain, privater Zugang, SSO oder White-Label. Notieren Sie, was jede Option kostet.
- Wenn Sie die Logs von Better Stack nutzen, schicken Sie eine Woche lang dieselben Logs an beide Tools und vergleichen Sie die Rechnung und die Zeit, bis Sie eine bestimmte Zeile finden.
- Rechnen Sie Ihr genaues Setup durch: Monitore, Personen in Bereitschaft, Statusseiten-Extras, Playwright-Checks und Log-Volumen.
- Lassen Sie beide Tools eine Woche lang auf denselben Endpunkten laufen, bevor Sie Better Stack kündigen.
Geben Sie jedem Monitor einen Verantwortlichen. Ein Alarm, dem in Better Stack niemand vertraut hat, wird auch im neuen Tool stummgeschaltet.
Weiterführende Artikel
- Von Better Stack zu Hyperping migrieren: Monitore und Heartbeats exportieren und neu anlegen
- Hyperping vs Better Stack: Vergleich Funktion für Funktion
- Preise von Better Stack: Responder-Lizenzen, Add-ons und Telemetriekosten
- UptimeRobot vs Better Stack
- Better Stack vs Datadog vs Hyperping
- Die besten Log-Management-Tools: wenn Sie die Logs ersetzen wollen
- Die besten PagerDuty-Alternativen
- Die besten Tools für Bereitschaftspläne
- Statusseiten: öffentliche und private Seiten auf Ihrer Domain
- Preise von Hyperping: Monitore, Nutzerplätze, Statusseiten und Logs je nach Plan
Weiter vergleichen: Hyperping vs Better Stack · Hyperping vs UptimeRobot · Preise von Hyperping · Alle Vergleiche
Häufige Fragen
Was sind die besten Better-Stack-Alternativen? ▼
Das hängt davon ab, welchen Teil von Better Stack Sie nutzen. Hyperping passt für Uptime-Checks, Rufbereitschaft und Statusseiten mit Nutzerplätzen im Plan. UptimeRobot passt für günstige Verfügbarkeits-Checks. Datadog passt für Teams, die APM und Traces brauchen. PagerDuty passt für Rufbereitschaft über viele Teams hinweg. incident.io passt für Incident Response direkt in Slack. Axiom passt für große Log-Volumen. OneUptime passt für Teams, die alles selbst hosten wollen.
Warum wechseln Teams von Better Stack weg? ▼
Die üblichen Gründe: die Responder-Lizenz für 29 $ für jede Person in der Bereitschaft, Zusatzoptionen für Statusseiten, die pro Seite berechnet werden (White-Label, SSO und IP-Allowlisting kosten jeweils 208 $ im Monat), und ein Produkt, das sich Richtung Logs, Traces und KI-SRE bewegt hat, obwohl das Team nur Uptime und Rufbereitschaft wollte. Rezensenten nennen außerdem die Einarbeitung in SQL und Logs-to-Metrics.
Better Stack vs Hyperping: Was ist besser? ▼
Better Stack, wenn Sie Logs, Traces, Error Tracking und Uptime von einem Anbieter wollen und nur ein oder zwei Personen Bereitschaft haben. Hyperping, wenn das ganze Team in der Bereitschaft rotiert oder Sie private, White-Label- oder SSO-Statusseiten brauchen: 5 Personen in Bereitschaft mit 100 Monitoren kosten bei Hyperping Pro 74 $ im Monat, bei Better Stack rund 187 $, jeweils bei jährlicher Abrechnung. Hyperping hat weder Traces noch APM, und die Logs sind im Alpha-Stadium.
Was ist die günstigste Better-Stack-Alternative mit Rufbereitschaft? ▼
Hyperping Essentials kostet 24 € im Monat bei jährlicher Abrechnung, für 50 Monitore mit 30 Sekunden Intervall, 3 Nutzerplätze, Bereitschaftspläne, Eskalation und Alarme per Anruf. Better Stack beginnt bei 29 $ im Monat für einen einzigen Responder. PagerDuty und incident.io haben ebenfalls kostenlose Pläne mit Rufbereitschaft für bis zu 5 Nutzer, aber keines der beiden prüft Ihre Website. Sie brauchen also zusätzlich ein Monitoring-Tool.
Gibt es eine Open-Source-Alternative zu Better Stack? ▼
Ja. OneUptime kommt Better Stack als Open-Source-Lösung am nächsten: Monitore, Statusseiten, Rufbereitschaft, Incidents, Logs und Traces, kostenlos selbst zu hosten unter Apache 2.0. Planen Sie 16 GB RAM ein und jemanden, der sich um Upgrades kümmert. Nur für Uptime und Statusseiten sind Uptime Kuma und Gatus deutlich schlanker, aber keines der beiden hat Rufbereitschaft.
Kann ich von Better Stack zu Hyperping migrieren? ▼
Ja. Der Migrationsleitfaden unter /docs/migrate/from-betterstack beschreibt, wie Sie Monitore und Heartbeats über die Better Stack API exportieren, sie in Hyperping per API oder Terraform neu anlegen, beide Tools parallel betreiben und dann umstellen.