Die besten incident.io-Alternativen 2026 sind Rootly für KI-native Incident Response in Slack mit tieferer Workflow-Automatisierung, FireHydrant für ausgereifte Enterprise-Runbooks, Hyperping für Monitoring, Rufbereitschaft und Statusseiten zum Pauschalpreis, PagerDuty für tiefgehendes Enterprise-Alerting, Squadcast für DevOps-Teams mit knappem Budget und Better Stack für Monitoring, Logs und Incidents in einer Plattform.
Ich habe über 25 Tools analysiert, Muster aus Threads in r/sre, r/devops und r/incidentio herausgearbeitet, in denen Entwickler incident.io direkt mit Rootly, FireHydrant und PagerDuty vergleichen, und die echten Preise für typische Teamgrößen gegenübergestellt. incident.io ist ein starkes Produkt. Die meisten Teams, die nach Alternativen suchen, sind mit dem Tool an sich nicht unzufrieden. Sie wollen einen anderen Kompromiss: mehr Flexibilität, weniger Abhängigkeit von Slack, eine breitere Abdeckung als reine Chat-Koordination oder ein Tool, das sie beim Mindestbetrag des Pro-Plans nicht überrascht.
Das erfahren Sie in diesem Guide:
- Warum Teams wirklich Alternativen zu incident.io prüfen (selten, weil „incident.io schlecht ist“)
- Die sechs Tools, die ich empfehlen würde, mit ehrlichen Preisen und echten Kompromissen
- Einen Preisvergleich für typische Teamgrößen
- Die vollständige Liste der über 25 incident.io-Alternativen, die ich mir angesehen habe
Wenn Sie Monitoring wollen, das Probleme in 30 Sekunden erkennt, Bereitschaftspläne mit intelligenten Eskalationen und Statusseiten, die Ihre Kunden wirklich aufrufen, und das alles zum monatlichen Pauschalpreis mit enthaltenen Nutzerplätzen und kostenpflichtigen zusätzlichen Nutzerplätzen, testen Sie Hyperping kostenlos.
Das Wichtigste in Kürze
- Rootly ist die direkteste Alternative, wenn Sie Chat-native Response mit mehr Workflow-Tiefe wollen. Ab ca. 20 $ pro Nutzer/Monat für Incident Response Essentials, mit separaten Preisstufen pro Nutzer für On-Call und AI SRE.
- FireHydrant passt am besten zu Teams, die ausgereifte Runbooks und einen Servicekatalog wollen. Kostenlos für bis zu 10 Responder, danach Pro für 25 $ pro Responder/Monat bei jährlicher Abrechnung; KI und private Statusseiten gibt es nur in Enterprise.
- Hyperping bietet das beste Preis-Leistungs-Verhältnis, wenn Ihr Engpass Erkennung, Rufbereitschaft und Statusseiten sind und nicht die Chat-native Koordination. 24 €/Monat pauschal, Nutzerplätze inklusive, zusätzliche Nutzerplätze werden separat berechnet.
- PagerDuty ist der etablierte Platzhirsch mit der tiefsten Alerting-Engine und über 700 Integrationen. 21 $ pro Nutzer/Monat in Professional, dazu eine PD-Reliability-Platform-Gebühr, jährlich im Voraus bezahlt, ab 2.800 $ für 10 Nutzerplätze. Dort steckt AIOps.
- Squadcast (heute SolarWinds Incident Response) ist die günstigste ernstzunehmende Option, mit Pro für 15 $ pro Nutzer/Monat bei jährlicher Abrechnung und einer 14-tägigen Testphase (kein kostenloser Plan).
- Better Stack bündelt Monitoring, Logs und Incidents in einer modernen Oberfläche ab 29 $/Monat, aber Gebühren pro Responder und pro Add-on können sich summieren.
Warum Sie diesem Guide vertrauen können
Ich bin Léo, Gründer von Hyperping. Ja, ich habe ein Eigeninteresse an einem dieser Tools. Mein Ziel ist nicht, Sie davon zu überzeugen, dass Hyperping immer die Antwort ist. Das ist es selten. Incident-Management ist eine breite Kategorie, und Hyperping deckt einen bestimmten Ausschnitt davon ab: Erkennung, Rufbereitschaft und Statusseiten. Für tiefe Slack-native Response oder KI-gestützte Post-Mortems passen die Tools unten besser, und das sage ich auch.
Für diesen Guide habe ich Produktanalysen zu jedem Tool gelesen, Zitate von G2 gesammelt und die Kriterien mit Reddit-Threads abgeglichen, in denen SREs aus der Praxis erzählen, was funktioniert und was nicht. Die wichtigsten Threads:
- My experience after testing both Rootly and incident.io (r/sre)
- Incident management tools comparison (r/sre)
- Anyone here using AI RCA tools like incident.io (r/sre)
- Best PagerDuty alternatives in 2026 (r/devops)
- r/incidentio
Wo ich ein Tool nicht selbst testen konnte, habe ich das gesagt und mich auf verifiziertes Nutzerfeedback gestützt.
Die besten Tools auf einen Blick
| Am besten für | Produkt |
|---|---|
| Slack-native Response mit tieferer Workflow-Automatisierung | Rootly |
| Ausgereifte Enterprise-Runbooks und strukturierte Workflows | FireHydrant |
| Monitoring + Rufbereitschaft + Statusseiten zum Pauschalpreis | Hyperping |
| Tiefgehendes Enterprise-Alerting mit dem größten Integrationskatalog | PagerDuty |
| DevOps-Teams mit knappem Budget, die solides On-Call brauchen | Squadcast |
| Monitoring, Logs und Incidents in einer Plattform | Better Stack |
Warum Teams nach incident.io-Alternativen suchen
incident.io bekommt einige der besten Bewertungen in der Kategorie. In den r/sre-Threads, die ich gelesen habe, loben Teams die ausgefeilte Slack-Integration, die durchdachten Standardabläufe und die KI-generierten Post-Mortems. Wer Alternativen prüft, tut das meist, weil das Tool nicht passt, nicht weil es versagt.
- Überraschungen bei der Preistransparenz. Der beworbene Team-Plan für ca. 15 $ pro Nutzer/Monat ist die Schlagzeile, aber die echte Rechnung enthält ein Add-on pro On-Call-Nutzer (ca. 10 $ pro Nutzer/Monat) und eine effektive Untergrenze für den Pro-Plan, die mehrere Threads in r/incidentio bei mindestens rund 4.000 $/Jahr ansetzen. Teams, die ihre Rechnung anhand des öffentlichen Preises pro Nutzer kalkuliert haben, erleben eine böse Überraschung.
- Grenzen bei der Anpassung. Das deutlichste Beschwerdemuster im r/sre-Thread Rootly vs incident.io: incident.io gibt viel vor. Teams mit komplexer Bedingungslogik (mehr als zwei Verzweigungen), eigenen Eskalationsprozessen oder ungewöhnlichen Incident-Lebenszyklen stoßen an Grenzen. Ein Nutzer fasste es so zusammen: „Es fühlte sich an, als wäre es für den Incident-Prozess von jemand anderem gebaut, nicht für unseren.“
- Abhängigkeit von Slack. Microsoft Teams wird unterstützt, hinkt Slack beim Funktionsumfang aber durchgehend hinterher. Für Organisationen, die Teams als zentrales Chat-Tool nutzen, löst sich ein Großteil der Vorteile in Luft auf.
- On-Call als Add-on. incident.io startete ursprünglich als reines Response-Tool. On-Call kam später dazu und ist bis heute ein separat bezahltes Modul. Teams, die beides in einer Preisstufe wollen, finden die Rechnung im Vergleich zu Rootly oder FireHydrant wenig schmeichelhaft.
- „Wir brauchen eigentlich nur Erkennung und On-Call.“ Viele Teams, die sich incident.io ansehen, merken, dass sie gar kein Problem mit der Koordination im Chat haben. Sie haben ein Problem mit Erkennung und Alarmierung, und ein Response-Orchestrator ist dafür die falsche Ebene.
- KI-Funktionen wirken noch unausgereift. Der r/sre-Thread zu KI-RCA ist voller pragmatischer Skepsis: KI-Zusammenfassungen helfen bei der lästigen Dokumentation, aber die Hinweise zur Ursache sind so uneinheitlich, dass Teams sich noch nicht darauf verlassen.
Ein wiederkehrendes Thema in r/sre: Kein einzelnes Tool löst jede Ebene des Incident-Lebenszyklus. Viele Teams kombinieren ein Erkennungstool (Hyperping, Datadog, Prometheus) mit einem Response-Tool (incident.io, Rootly, FireHydrant) und einer Statusseite (Hyperping, Statuspage). Das Ziel ist nicht das eine Tool für alles, sondern das richtige Tool für jede Ebene mit möglichst wenig Überschneidung.
Warum es diese 6 Tools in die Auswahl geschafft haben
Ich habe mir über 25 Tools angesehen, darunter Blameless, OpsGenie, Grafana OnCall, xMatters, Zenduty, iLert, Splunk On-Call, ServiceNow, Jira Service Management, Freshservice, GoAlert, BigPanda, Spike.sh und PagerTree. Viele sind aus konkreten Gründen herausgefallen:
- Auslaufmodell. OpsGenie wird im April 2027 abgeschaltet. Wer heute evaluiert, sollte den Nachfolger evaluieren, nicht das Tool, das ersetzt wird.
- Zu eng. Spike.sh, GoAlert und PagerTree sind in Ordnung für Teams, die nur einfache Alarmierung brauchen, aber ihnen fehlen die Funktionen für den Lebenszyklus (Timelines, Post-Mortems, Statusseiten), die in r/sre-Threads immer wieder genannt werden.
- Zuerst Service-Desk. Jira Service Management, ServiceNow und Freshservice sind in erster Linie ITSM-Tools und erst in zweiter Linie Incident-Response-Tools. Sie sind auf Tickets ausgelegt, nicht auf das Koordinationsproblem um 2 Uhr nachts, das incident.io löst.
- Intransparente Preise. Tools, für die man immer noch ein Vertriebsgespräch braucht, um eine Zahl zu bekommen (BigPanda, Moogsoft, BMC Helix), habe ich ausgeschlossen, weil eine Bewertung im Blindflug keinen Sinn ergibt.
- Am besten als Teil eines anderen Stacks. Grafana OnCall ist hervorragend, wenn Sie bereits Grafana einsetzen, auch wenn die OSS-Version archiviert ist; der Guide zu Grafana-OnCall-Alternativen erklärt, was das ändert. Splunk On-Call (VictorOps) ist am besten, wenn Sie bereits Splunk nutzen; wenn Sie davon weggehen, finden Sie hier die VictorOps-Alternativen. Keines der beiden taugt allein als Ersatz für incident.io.
- Stark, aber weniger dringlich. Blameless hat bei Post-Mortems und SRE-Praktiken einiges zu bieten, aber Dynamik und Entwicklungstempo sind hinter den Chat-nativen Tools zurückgeblieben. Gut zu kennen, steht 2026 aber auf den meisten Shortlists nicht ganz oben.
Jedes der sechs Tools unten besetzt einen bestimmten Anwendungsfall, den incident.io nicht so gut abdeckt, oder deckt denselben Anwendungsfall zu einem anderen Preis ab.
Funktionsvergleich
| Funktion | Rootly | FireHydrant | Hyperping | PagerDuty | Squadcast | Better Stack |
|---|---|---|---|---|---|---|
| Preismodell | Pro Nutzer (pro Modul) | Pro Nutzer (gestaffelt) | Pauschalpreis | Pro Nutzer + Add-ons | Pro Nutzer | Stufe + pro Responder + Add-ons |
| Integriertes Monitoring | Nein | Nein | Ja | Nein | Nein | Ja |
| Bereitschaftspläne | Ja (separates Modul) | Ja | Ja | Ja | Ja | Ja |
| Slack-nativer Workflow | Gesamter Lebenszyklus | Gesamter Lebenszyklus | Benachrichtigungen | Benachrichtigungen | Benachrichtigungen | Benachrichtigungen |
| Microsoft Teams | Vollständig | Vollständig | Benachrichtigungen | Vollständig | Vollständig | Vollständig |
| Tiefe der Workflow-Engine | Tief (Low-Code) | Starke Runbooks | Entfällt | Stark (Web) | Premium-Stufe | Begrenzt |
| KI-Post-Mortems | Ja | Ja (Enterprise) | Nein | Add-on | Premium | Begrenzt |
| Integrierte Statusseiten | Ja | Ja | Ja | Add-on (Statuspage) | Ja | Ja (Gebühr pro Seite) |
| Alarmierung per Anruf | Ja | Über Integration | Ja | Ja | Ja | Ja |
| Kostenlose Stufe | Nur Testphase | Ja (10 Responder) | Ja | Bis zu 5 Nutzer | Nein (Testphase) | Ja |
| Hosting | USA | USA | EU (DSGVO) | USA | USA | USA/EU |
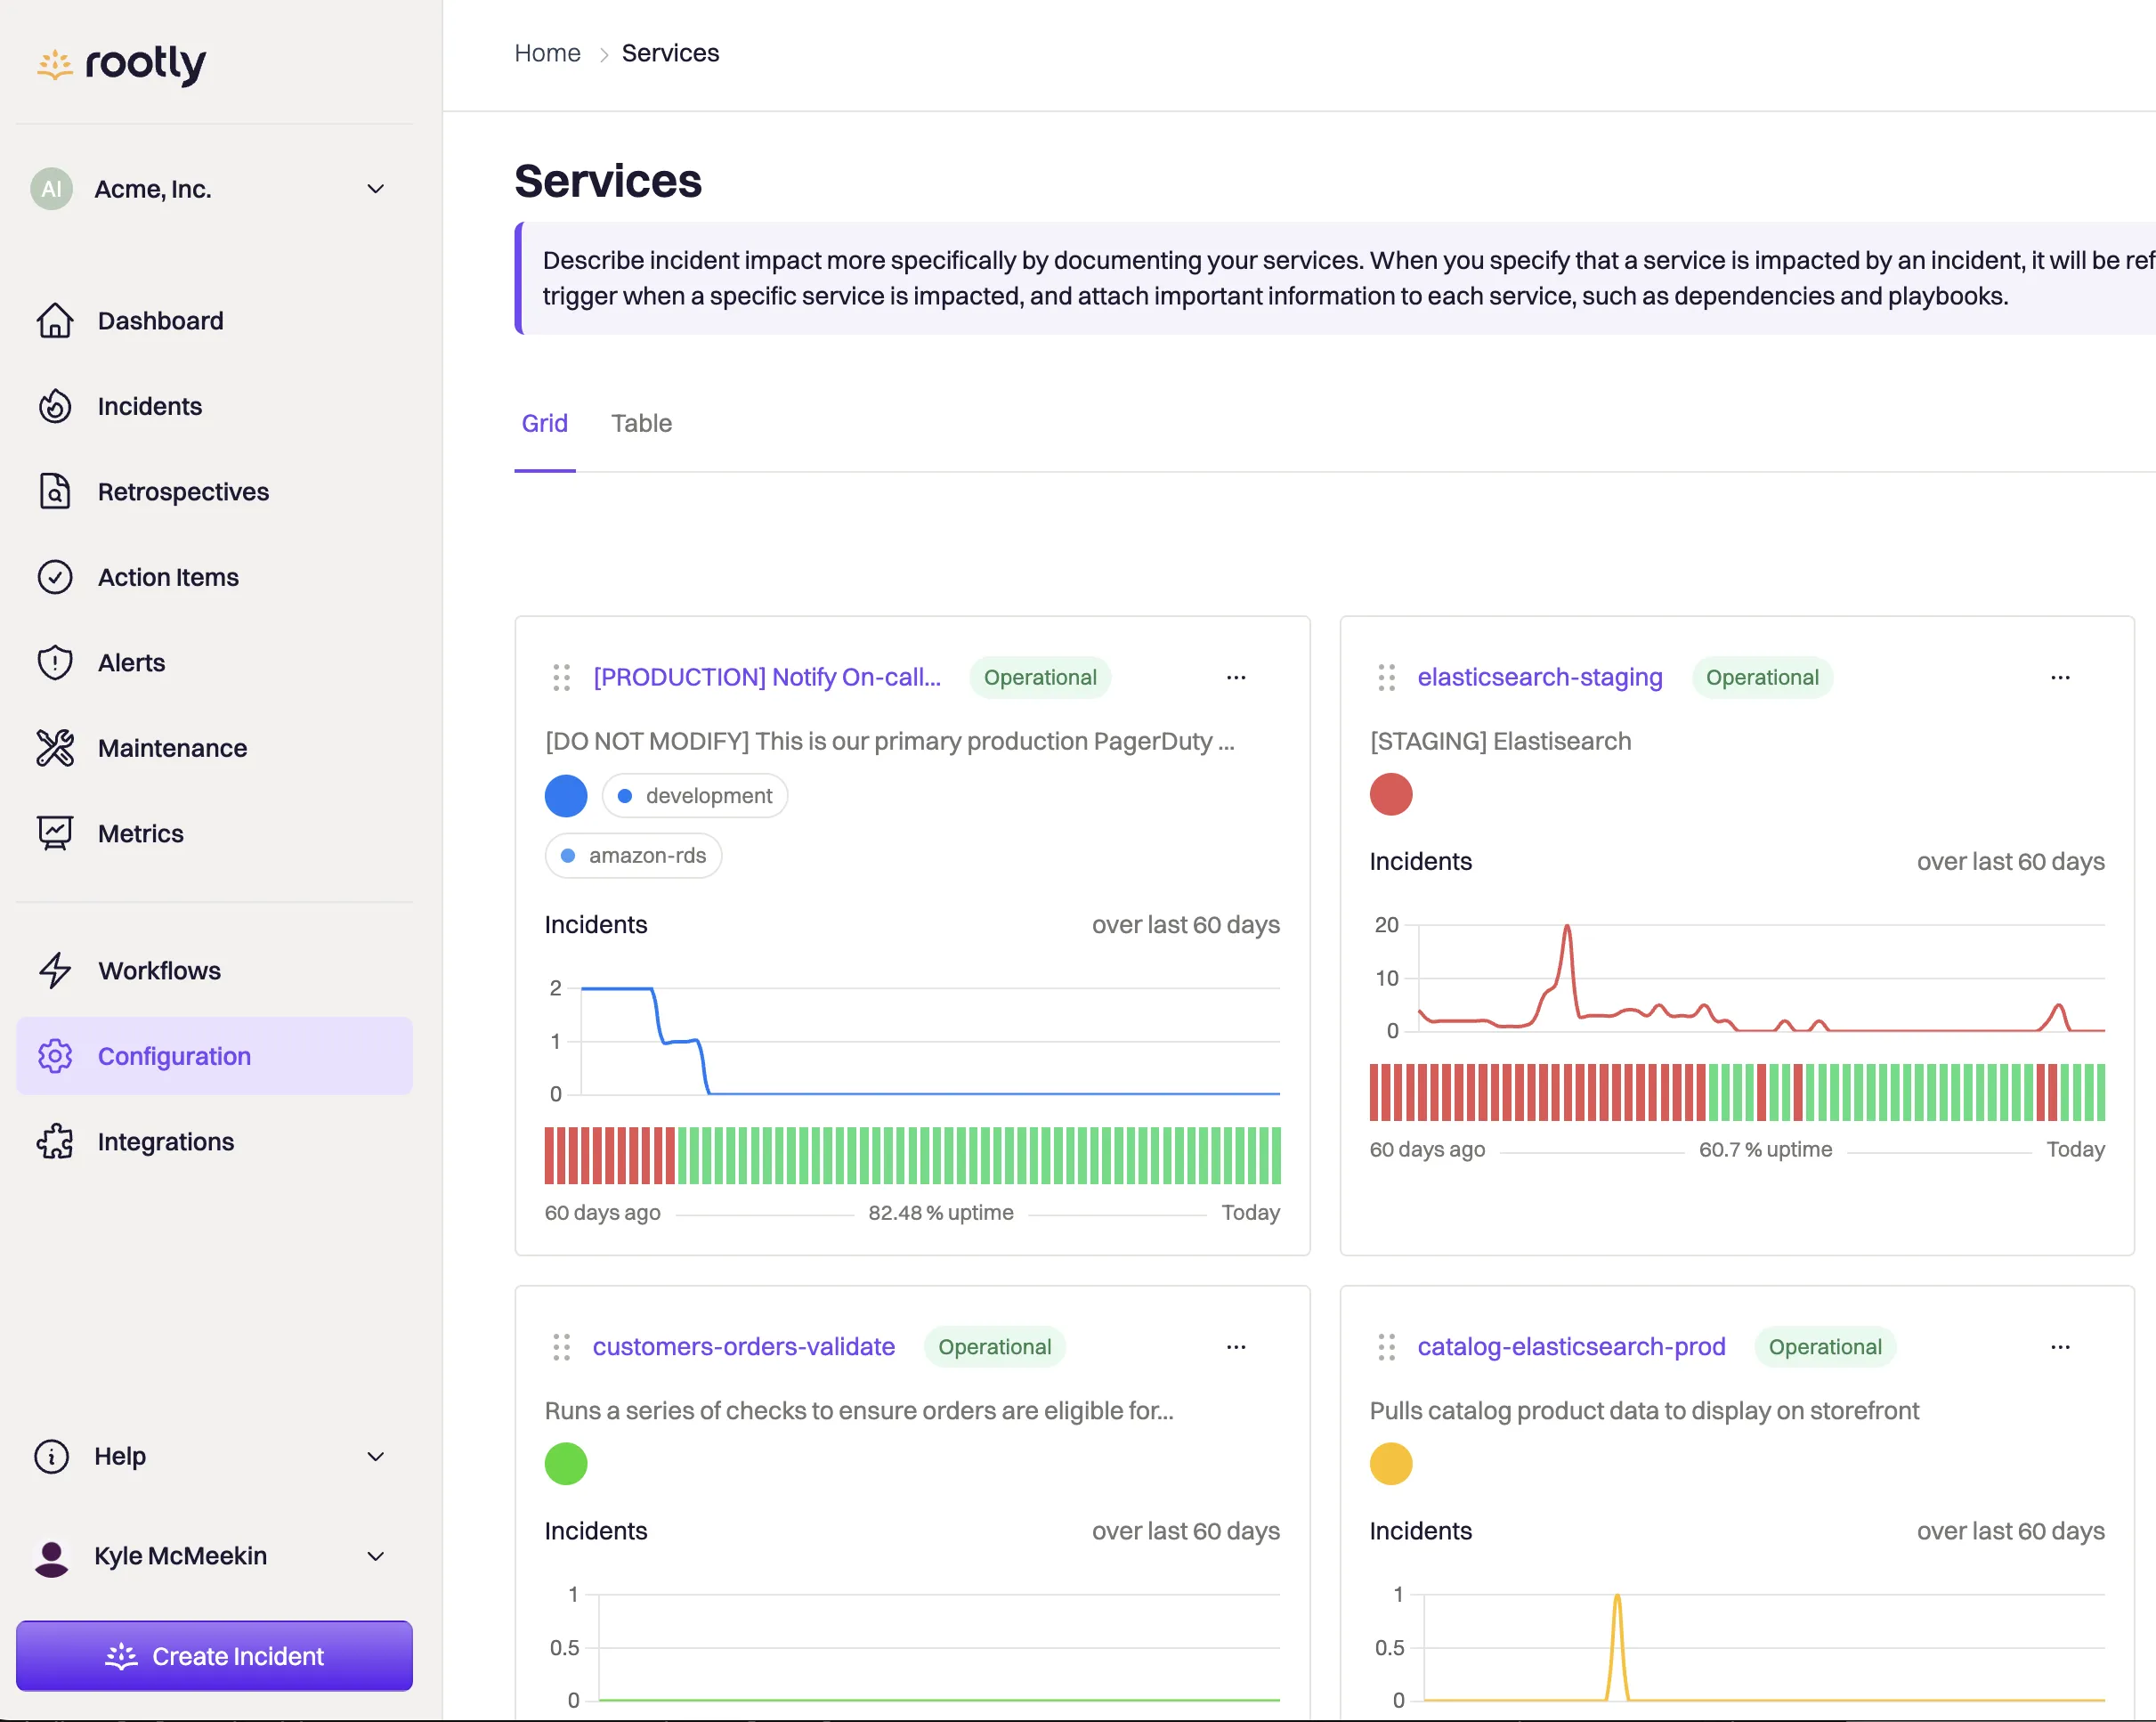
1. Rootly: die direkteste Alternative zu incident.io
Ideal für
Schnell wachsende Engineering-Teams im Mittelstand und in Großunternehmen, die bereits auf Slack oder Microsoft Teams standardisiert sind und KI-native Incident Response mit tiefer Automatisierung über Jira, GitHub, Zoom und den restlichen Dev-Stack wollen. Der am häufigsten genannte direkte Vergleich mit incident.io in r/sre-Threads.
Wichtige Funktionen
- Native Workflows in Slack und Teams. Incidents direkt im Chat ausrufen, verwalten und schließen, mit automatisch angelegten Channels, Huddles und Transkription.
- Workflow-Engine für Low-Code-Automatisierung. Incident-gesteuerte Abläufe über Ihren ganzen Stack bauen, ohne Glue-Code zu schreiben.
- KI-Zusammenfassungen, vorgeschlagene Responder und Hinweise zur Behebung. Von Anfang an um KI herum gebaut statt nachträglich ergänzt.
- Vollständige Verwaltung der Rufbereitschaft. Bereitschaftspläne, Eskalationsrichtlinien, Vertretungen und mobile Apps. Als separates Modul pro Nutzer verkauft statt im Paket.
- Automatisierte Retrospektiven mit MTTR/MTTA-Tracking und Zuweisung von Folgeaufgaben.
- Statusseiten, öffentlich und privat.
- Enterprise-Sicherheit. SSO, SCIM, RBAC, Audit-Logs, SOC 2, DSGVO, CCPA.
Warum Rootly statt incident.io
Workflow-Tiefe. Der deutlichste Unterschied im r/sre-Thread Rootly vs incident.io: Rootlys Low-Code-Workflow-Builder reicht weiter in Jira, GitHub und den restlichen Dev-Stack hinein. Teams mit komplexer Bedingungslogik, teamübergreifenden Eskalationen oder eigenen Prozessen stoßen seltener an Grenzen. incident.io gibt mehr vor; Rootly lässt sich stärker konfigurieren.
Kein Frust à la „für den Prozess von jemand anderem gebaut“. Wo incident.io-Nutzer über festgelegte Standardabläufe klagen, die nicht zu ihrem Workflow passen, loben Rootly-Nutzer, dass sie ihre eigenen abbilden können.
Kundenlogos im großen Maßstab. Cisco, NVIDIA, Figma, Squarespace und Canva setzen Rootly ein. Gerade die Konfigurationstiefe zieht große Engineering-Organisationen mit etablierten Prozessen an.
Wo Rootly Schwächen hat
Aufwand für die Konfiguration. Das ist die Kehrseite von „flexibel“. Ein Kommentator in r/devops, der sich für incident.io statt Rootly entschieden hat, beschrieb Rootly als „jede Menge Funktionen, aber viel zu viel Konfiguration, bis es für unsere Commerce-Umgebung funktioniert hat“. Teams, die Best Practices fertig eingebaut haben wollen, bekommen von incident.io mehr.
Kosten pro Nutzer addieren sich über die Module. Incident Response, On-Call und AI SRE werden als separate Preisstufen pro Nutzer berechnet. Bei jeweils ca. 20 $ pro Nutzer/Monat wird der komplette Stack schneller teuer als der gebündelte Pro-Plan von incident.io.
Weniger transparente Limits je Stufe. G2-Bewertungen merken an, dass man für die genauen Obergrenzen bei Workflows, Runbooks und Statusseiten in der Regel ein Vertriebsgespräch braucht.
Ecken und Kanten in UI/UX. Manche Nutzer berichten von Problemen mit dem Neuladen der Seite und mühsamer Suche in benutzerdefinierten Feldern während eines Incidents. Kleinigkeiten, aber um 3 Uhr nachts zählen sie.
Preise
- Incident Response Essentials: ca. 20 $ pro Nutzer/Monat
- On-Call Essentials: ca. 20 $ pro Nutzer/Monat
- AI SRE / Enterprise: individuell, mit Paketrabatten bei kombinierten Modulen
- 14-tägige kostenlose Testphase; Startup-Rabatte von bis zu ca. 50 % für junge Unternehmen
Typische jährliche Ausgaben: 15.000 $ bis 60.000 $, je nach Teamgröße und Stufe.
Wählen Sie Rootly, wenn
Ihr Engineering-Team in Slack oder Teams lebt, Sie eine komplexe Toolchain automatisieren wollen und KI-native Response mit Workflows suchen, die zu Ihren eigenen Prozessen passen statt zu denen von jemand anderem. Lassen Sie es weg, wenn Sie Best Practices fertig eingebaut wollen (dafür passt incident.io besser) oder wenn das Budget die harte Grenze ist.
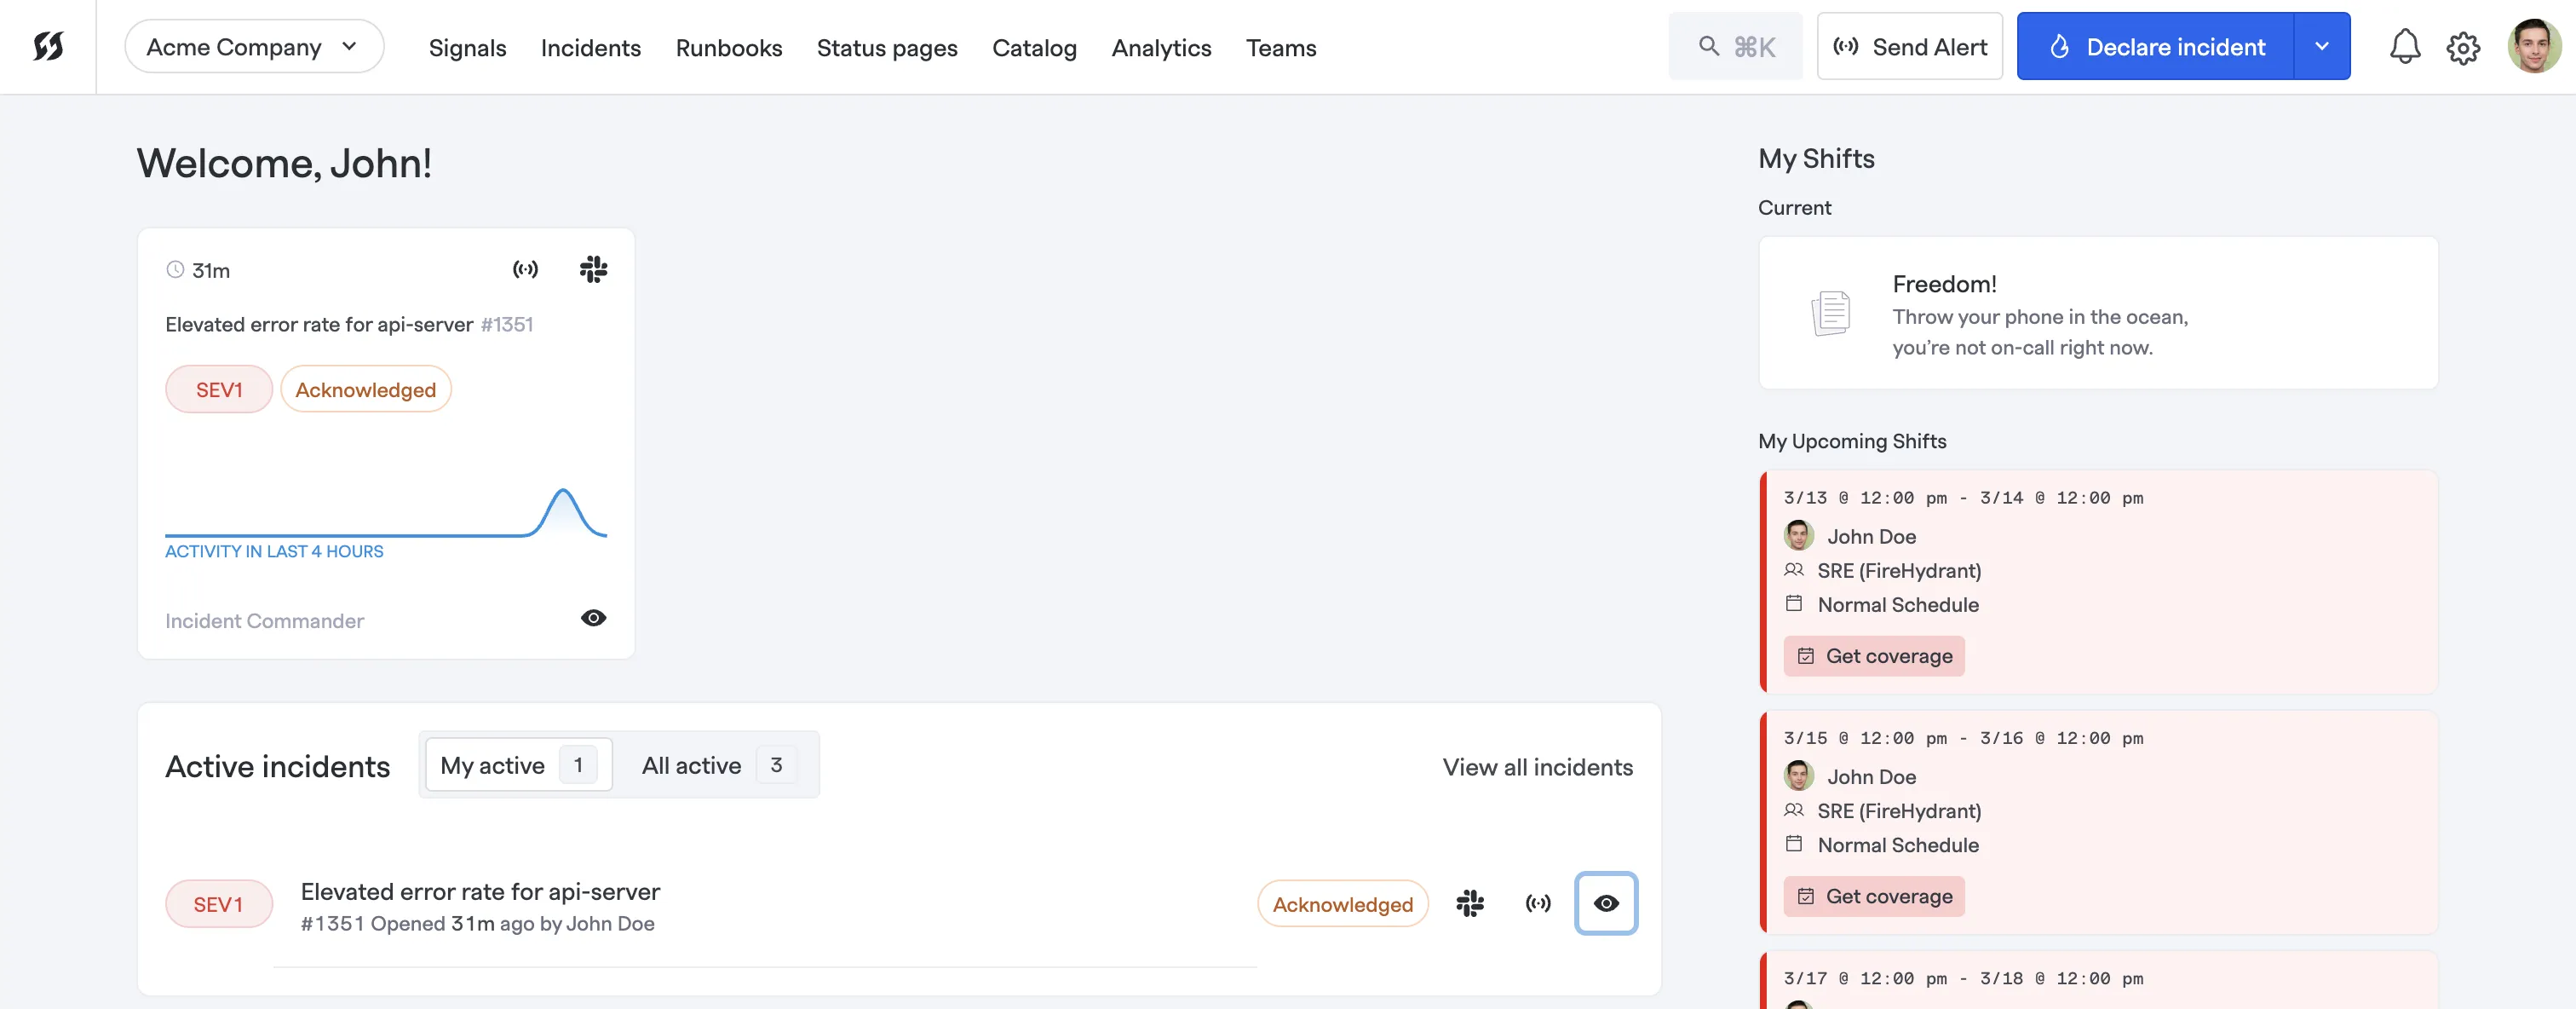
2. FireHydrant: am besten für ausgereifte Enterprise-Runbooks
Ideal für
Engineering-Teams im Mittelstand und in Großunternehmen, die Slack-native Response mit stärkeren Runbooks und einem besseren Servicekatalog als bei incident.io wollen. Der dritte Name, der in r/sre-Threads zur Evaluierung regelmäßig neben incident.io und Rootly auftaucht.
Wichtige Funktionen
- Nativer Lebenszyklus in Slack und Teams mit automatisch angelegten Channels, Rollenzuweisung und strukturierter Response.
- Starke Runbook-Engine. FireHydrant investiert viel in festgeschriebene, wiederholbare Runbooks, die parallel zu den menschlichen Respondern laufen.
- Strukturierte Analyse nach dem Incident. Vorlagen, Blameless-Kultur als Standard und Nachverfolgung von Folgeaufgaben mit Verantwortlichen und Fälligkeitsdaten.
- Servicekatalog. Services, Verantwortliche und Abhängigkeiten abbilden. Incidents übernehmen den Katalog automatisch.
- KI-Funktionen in Enterprise. FireHydrant AI (Zusammenfassungen, Transkripte, Triage, Retros) ist im Enterprise-Plan enthalten, statt als separates Modul verkauft zu werden.
- Statusseiten. Öffentlich und privat, mit Stakeholder-Kommunikation direkt im Response-Ablauf.
Warum FireHydrant statt incident.io
Runbooks als vollwertige Objekte. incident.io hat Runbooks, aber bei FireHydrant gehen sie tiefer. Teams mit ausgereiften, dokumentierten Playbooks können diese hier sauberer übertragen.
Servicekatalog im Zentrum. Der Servicekatalog von FireHydrant verknüpft Incidents standardmäßig mit Services und Verantwortlichen. incident.io unterstützt das auch, aber bei FireHydrant steht das Modell stärker im Mittelpunkt des Produkts.
Transparentere Preisgestaltung für KI. Während incident.io KI-Funktionen in höheren Stufen und On-Call als separates Add-on anbietet, bündelt FireHydrant seine KI im Enterprise-Plan.
Wo FireHydrant Schwächen hat
KI und private Statusseiten nur in Enterprise. Pro kostet 25 $ pro Responder/Monat bei jährlicher Abrechnung; Teams, die FireHydrant AI wollen, landen beim individuell bepreisten Enterprise-Plan.
Weniger Marketingpräsenz als incident.io und Rootly. Gespräche mit dem Einkauf können länger dauern.
Jahresverträge sind üblich. Die öffentlichen Preise gelten pro Monat, aber echte Abschlüsse laufen oft über Jahresverträge.
Gibt weniger vor als incident.io. Teams, die gezielt die klugen Standards von incident.io wollten, finden FireHydrant einen halben Schritt konfigurationslastiger.
Preise
- Free: bis zu 10 Responder, öffentliche Statusseiten, Kernfunktionen des Incident-Managements
- Pro: 25 $ pro Responder/Monat bei jährlicher Abrechnung, On-Call (Signals), öffentliche Statusseiten, SSO
- Enterprise: individuelle Preise, FireHydrant AI, private Statusseiten
Wählen Sie FireHydrant, wenn
Sie eine ausgereifte, Runbook-zentrierte Incident-Response-Plattform mit einem Servicekatalog im Zentrum wollen und KI lieber im Paket als separat bezahlt. Lassen Sie es weg, wenn das Budget die harte Grenze ist oder wenn genau die klaren Vorgaben von incident.io Sie überhaupt erst zu dieser Kategorie gebracht haben.
3. Hyperping: am besten, wenn Ihr Engpass Erkennung, Rufbereitschaft und Statusseiten sind
Ideal für
Startups, KMU und wachsende SaaS-Teams, die Uptime-Monitoring, Bereitschaftspläne, Eskalationsrichtlinien und gepflegte Statusseiten in einem Tool wollen, ohne Rechnungen pro Nutzer, die mit jeder Neueinstellung wachsen. Oft die richtige Antwort, wenn Teams bei der Evaluierung von incident.io merken, dass sie gar kein Koordinationsproblem im Chat haben.
Wichtige Funktionen
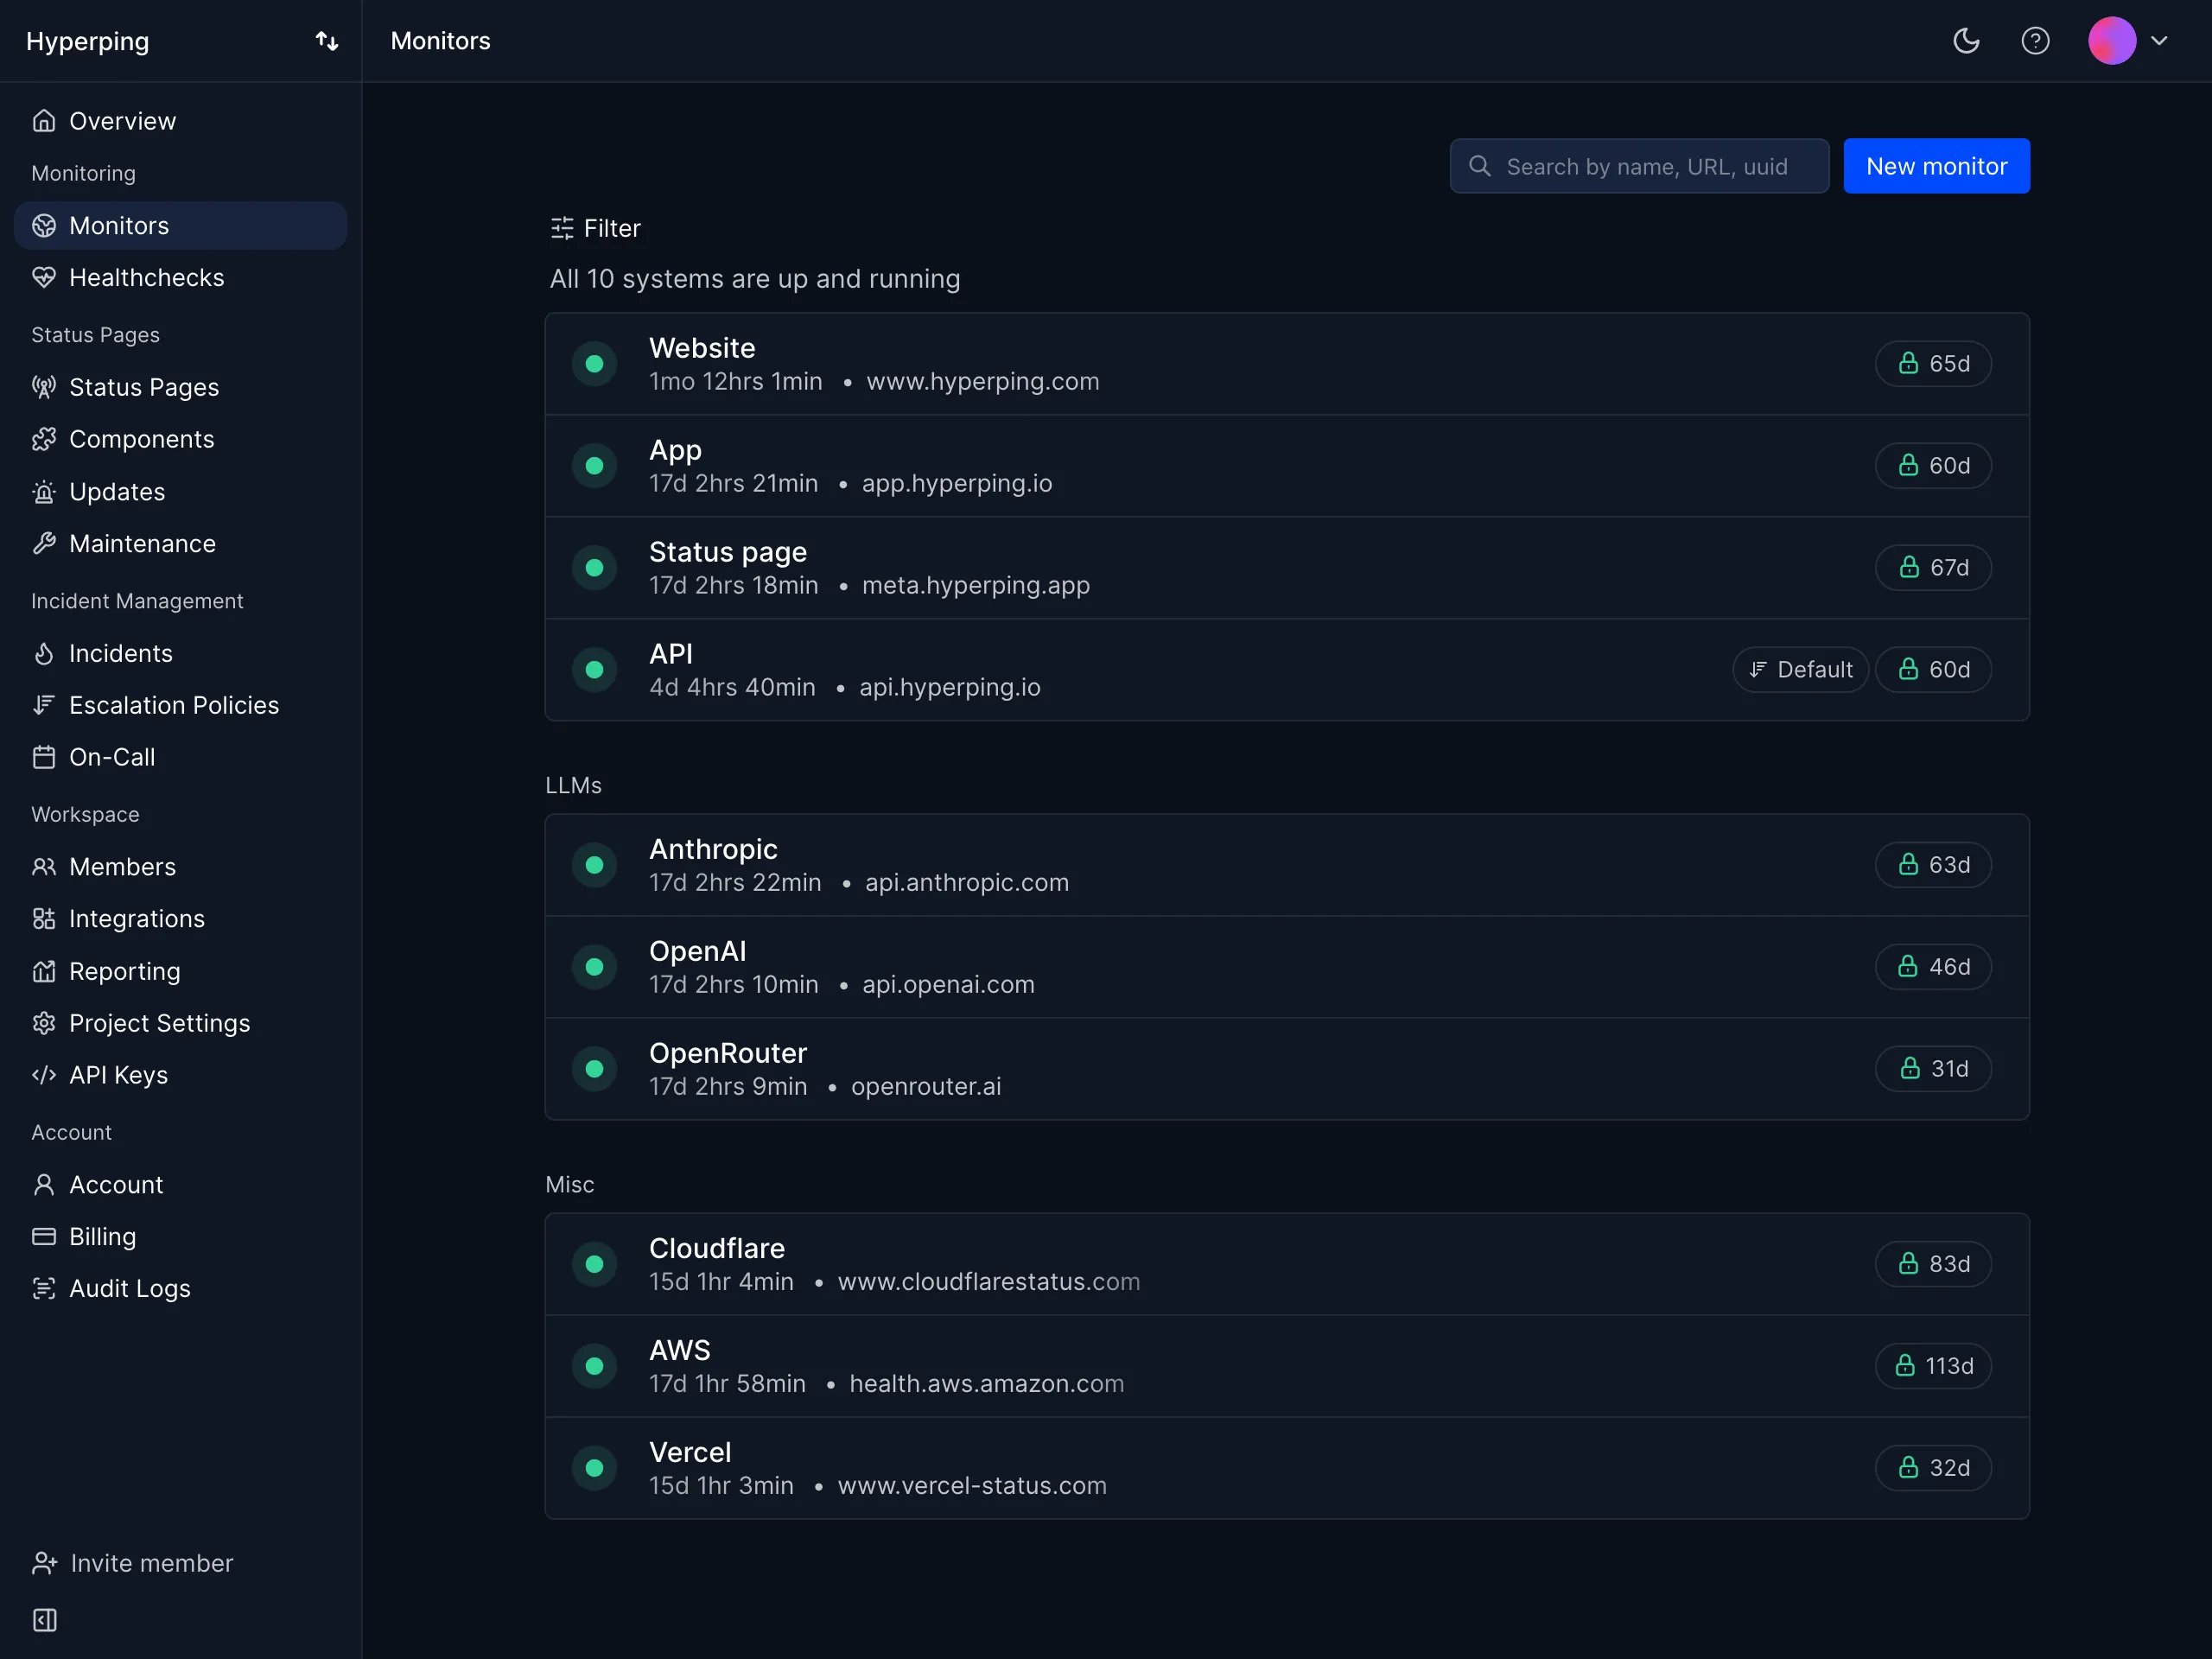
- Externes Monitoring aus 18 Regionen weltweit. Probleme aus Sicht Ihrer Kunden erkennen, nicht nur aus Ihrer VPC heraus.
- Bereitschaftspläne und Eskalationsrichtlinien. Rotationen mit Zeitzonen, automatische Übergaben, mehrstufige Eskalation. In jedem kostenpflichtigen Plan enthalten, nicht als separates Modul verkauft.
- Automatische Wiederholung vor dem Alarm. Fehler werden aus mehreren Regionen bestätigt, bevor jemand geweckt wird, was Fehlalarme deutlich reduziert.
- Alarmierung über viele Kanäle. Slack, Teams, Discord, Telegram, PagerDuty, OpsGenie, SMS, Sprachanrufe, Webhooks.
- Statusseiten im eigenen Branding inklusive. Öffentliche und private Seiten, eigene Domains, White-Label-Branding, SSO-Schutz, mehrsprachig. 3 Seiten in Pro, 10 in Business, ohne Gebühren pro Seite innerhalb dieser Limits.
- Synthetisches Monitoring mit Playwright. End-to-End-Browser-Checks für Login, Checkout und andere kritische Abläufe.
- Agent für Server-Monitoring. Schlanker Agent für Linux und macOS, der CPU, Arbeitsspeicher, Festplatte und Netzwerk misst, auf Basis von OpenTelemetry.
- Hosting in der EU. DSGVO-konform, alle Daten liegen in Rechenzentren in der EU.
Warum Hyperping statt incident.io
Anderes Problem, anderes Tool. incident.io ist eine Koordinationsplattform. Hyperping deckt Erkennung, Alarmierung und Kundenkommunikation ab. Viele Teams, die incident.io evaluieren, suchen eigentlich Letzteres und brauchen Ersteres gar nicht. Ein 20-köpfiges Team hat selten genug Incidents, um einen Chat-nativen Response-Orchestrator zu rechtfertigen.
Planbare Pauschalpreise, keine Mindestbeträge wie beim Pro-Plan. Ein 20-köpfiges Team kostet auf Hyperping Pro 179 $/Monat oder bei jährlicher Abrechnung etwa 149,17 $/Monat, einschließlich 10 zusätzlicher Nutzerplätze zu den 10 enthaltenen. Dasselbe Team kostet auf incident.io Team mit On-Call rund 500 $/Monat. Keine der Stufen von incident.io enthält Monitoring oder Statusseiten im selben Plan, die müssten Sie also zusätzlich kaufen.
Drei Tools in einem. Monitoring, Rufbereitschaft und Statusseiten sind in jeder kostenpflichtigen Stufe enthalten. Das ersetzt UptimeRobot + Statuspage.io + ein Alarmierungstool (für ein kleines Team schnell über 200 $ zusammen).
Zehn Nutzerplätze inklusive in Pro. Das neunte und zehnte Teammitglied passen noch in den Basisplan. Jeder weitere Nutzerplatz kostet 9 €/Monat oder 90 €/Jahr.
Wo Hyperping Schwächen hat
Hyperping ist keine Slack-native Incident-Response-Plattform. Sie bekommen keine umfangreichen Incident-Channels mit Rollenzuweisung, keine KI-generierten Post-Mortems und keine automatisch erfassten Timelines. Für Teams mit mehr als 20 Incidents im Monat, die das volle Erlebnis von incident.io oder Rootly wollen, deckt Hyperping Erkennung und Rufbereitschaft ab, orchestriert die Response selbst aber nicht.
Integriertes APM oder Distributed Tracing gibt es ebenfalls nicht. Für interne Observability kombinieren Sie Hyperping mit Datadog, New Relic oder Prometheus.
Was Nutzer sagen
„Hyperping hat in unserem Unternehmen den Ruf, schneller zu reagieren als Datadog. Meist bekommen wir die Benachrichtigung von Hyperping vor der von Datadog. Es ist nützlich als Rückfallebene, als leichtere Backup-Monitoring-Lösung.“
„Wir haben unsere Hyperping-Statusseite öffentlich gemacht, und sie ist zu einem zentralen Teil unserer Verkaufsgespräche geworden. Wir sind stolz auf unsere Uptime und lieben es, sie mit Interessenten teilen zu können.“
Preise
- Free: 1 Nutzerplatz, 20 Monitore, 1 Server-Agent, 1 einfache Statusseite
- Essentials: 24 €/Monat für 50 Monitore, 1 Statusseite, 3 Browser-Checks, 3 Nutzerplätze
- Pro: 74 €/Monat bei jährlicher Abrechnung für 250 Monitore, 3 öffentliche oder private Statusseiten, 10 Browser-Checks, Alarmierung per Sprachanruf, 10 Nutzerplätze. Inklusive Zugangscodes per E-Mail, mehrsprachiger Seiten und nativem SAML-SSO für das Konto.
- Business: 249 €/Monat bei jährlicher Abrechnung für 1.000 Monitore, 10 Statusseiten, Checks unter 30 Sekunden, 25 Browser-Checks, 20 Nutzerplätze
Alle kostenpflichtigen Pläne enthalten Bereitschaftspläne und Eskalationsrichtlinien.
Wählen Sie Hyperping, wenn
Sie merken, dass Sie eigentlich Monitoring, Rufbereitschaft und eine Statusseite brauchen und keinen Chat-nativen Response-Orchestrator. Besonders stark für Teams unter 30 Personen, die genug von der Abrechnung pro Nutzer haben, für europäische Unternehmen, die DSGVO-Konformität und Datenhosting in der EU brauchen, und für SRE-Teams, die ein unabhängiges Sicherheitsnetz neben Datadog wollen (siehe die Fallstudie von Alma).
4. PagerDuty: am besten für tiefgehendes Enterprise-Alerting
Ideal für
Große Unternehmen mit komplexen Bereitschaftsplänen, hohen Anforderungen an die ITSM-Integration (ServiceNow, Jira) und dem Budget, um Preise pro Nutzer plus AIOps-Add-ons zu stemmen. Die übliche Ausweichlösung, wenn das festgelegte Chat-native Modell von incident.io nicht passt.
Wichtige Funktionen
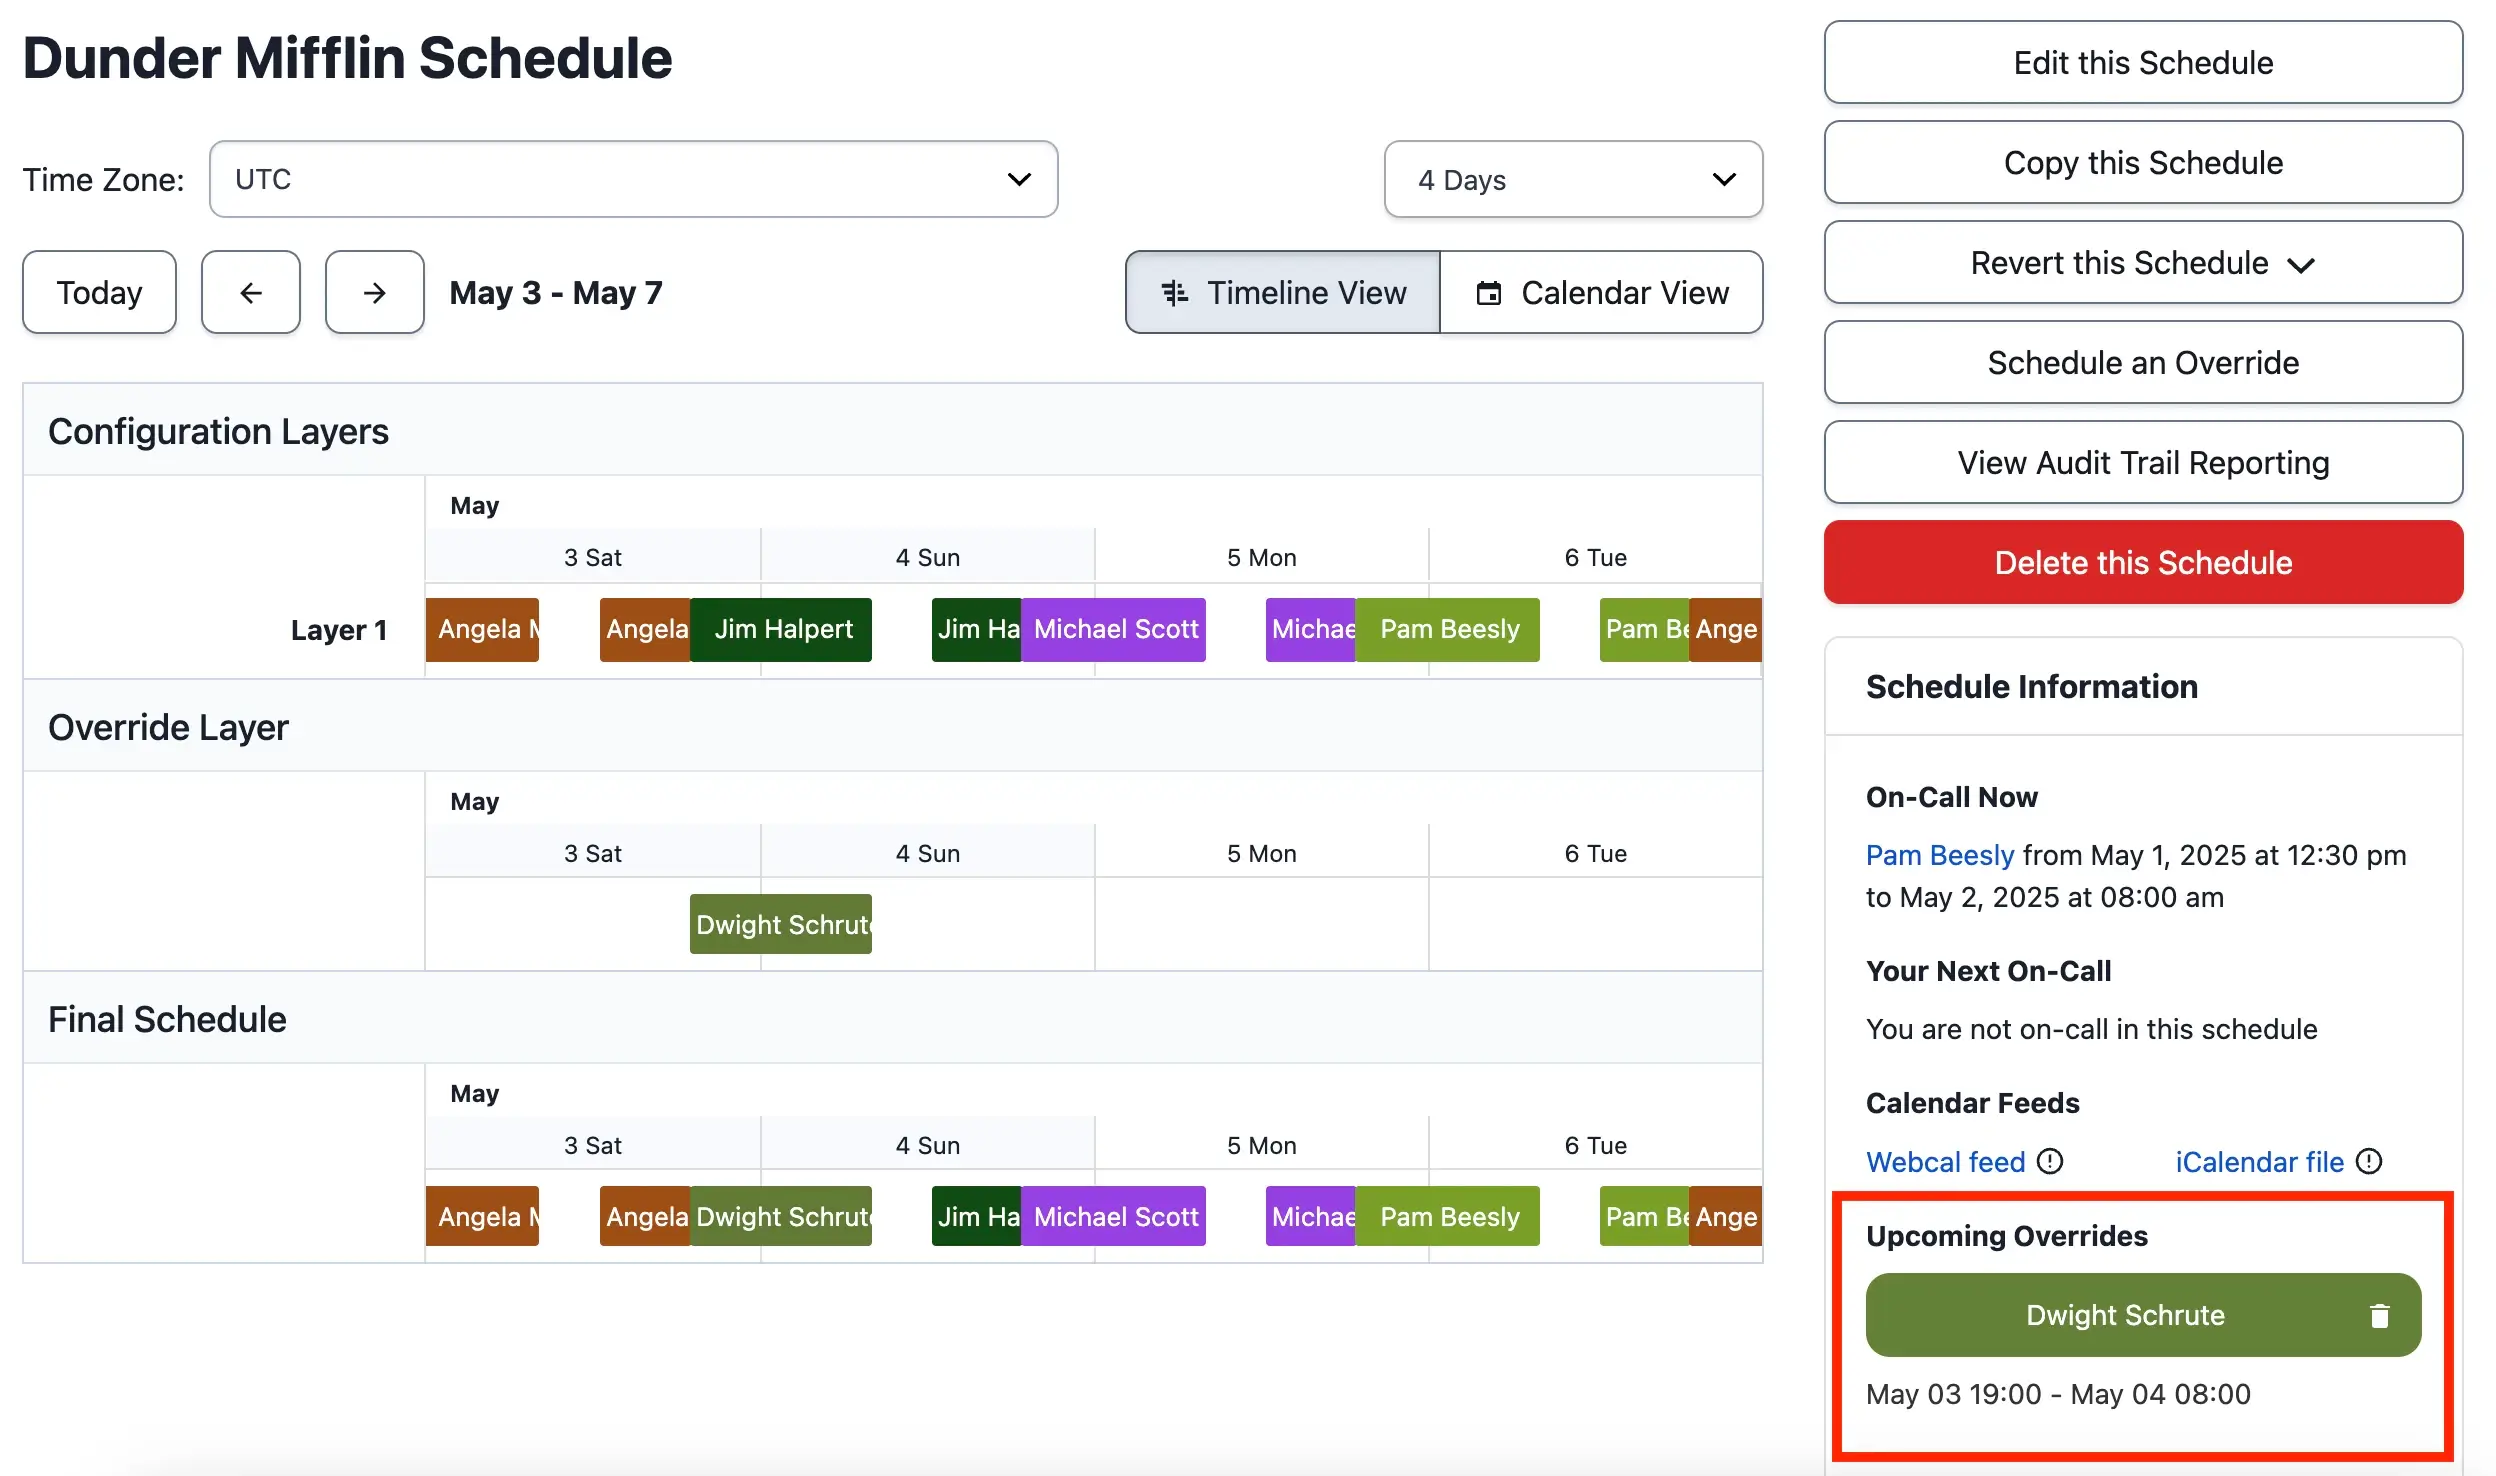
- Ausgereifte Alerting- und Routing-Engine. Event Orchestration bewältigt komplexe Bedingungslogik, mit der neuere Tools noch nicht mithalten.
- Über 700 Integrationen. Der umfangreichste Katalog aller Tools in dieser Liste, einschließlich älterer Enterprise-Systeme.
- AIOps-Add-ons. Unterdrückung von Alarmrauschen, Gruppierung von Alarmen, automatisierte Incident-Workflows.
- Zuverlässige mobile Alarmierung. Mehrere r/devops-Threads nennen die mobile App von PagerDuty den Goldstandard, wenn es darum geht, Leute um 3 Uhr nachts zuverlässig zu wecken.
- Multi-Cloud-Architektur. PagerDuty hat viel investiert, um nicht mit auszufallen, wenn AWS oder Azure ausfallen.
Warum PagerDuty statt incident.io
Tiefe beim Alerting und Routing. Wenn Sie Follow-the-Sun-Rotationen über fünf Regionen, Eskalationsrichtlinien mit 20 Regeln und eine ServiceNow-Integration haben, die in beide Richtungen funktionieren muss, ist die Planungs- und Routing-Engine von PagerDuty immer noch leistungsfähiger als das On-Call-Add-on von incident.io. incident.io denkt zuerst an die Response, PagerDuty zuerst an die Alarmierung.
Sicherheit beim Einkauf. „Für den Kauf von PagerDuty ist noch niemand gefeuert worden“ ist keine Floskel. In großen, konservativen Organisationen kommt PagerDuty schneller durch den Einkauf als jede der modernen Alternativen.
Integrationskatalog. Über 700 Integrationen, darunter ältere Enterprise-Systeme, die der Katalog von incident.io nicht abdeckt.
Den vollständigen direkten Vergleich finden Sie unter PagerDuty vs incident.io.
Wo PagerDuty Schwächen hat
Kosten. 21 $ pro Nutzer/Monat in Professional, dazu eine PD-Reliability-Platform-Gebühr, jährlich im Voraus bezahlt, für AIOps und Automation, von 2.800 $ für 10 Nutzerplätze bis 48.000 $ für 50. Bei einer Engineering-Organisation mit 50 Personen sind das 12.600 $ im Jahr mit Professional oder 48.000 $ im Jahr mit der Plattformstufe Plus.
Koordination in der Web-App. PagerDuty benachrichtigt in Slack, aber der eigentliche Incident lebt in der Weboberfläche. Teams, die Chat-native Response wollen, berichten durchweg von besserer Akzeptanz bei incident.io.
Lücken bei API und Webhooks. Forennutzer bemängeln immer wieder fehlende Felder (Beschreibung aus Webhooks entfernt, Lösungsnotizen nicht verfügbar) und N+1-API-Aufrufe für benutzerdefinierte Service-Felder.
Rückschritte in der mobilen App. Neuere Updates haben beim Wischen zum Schließen einen zusätzlichen Bestätigungs-Tap eingeführt, über den sich Entwickler in Rufbereitschaft regelmäßig beschweren.
Datenschutz-Standards. Die Slack-Integration von PagerDuty aktiviert „Chat message ingestion“ und „Private channel ingestion“ standardmäßig. Das sollten Sie bei der Einrichtung prüfen.
Preise
- Professional: 21 $ pro Nutzer/Monat (jährlich)
- PD Reliability Platform, jährlich im Voraus bezahlt: Starter 2.800 $ (10 Nutzerplätze), Essential 12.000 $ (20 Nutzerplätze), Plus 48.000 $ (50 Nutzerplätze), Ultimate individuell (500 Nutzerplätze)
- AIOps und Automation stecken in den Plattformstufen; zusätzliche Nutzerplätze kommen aus Credit-Paketen
- Kostenlose Stufe begrenzt auf 5 Nutzer, 1 Bereitschaftsplan, 1 Eskalationsrichtlinie und 100 SMS-/Anrufbenachrichtigungen pro Monat
Wählen Sie PagerDuty, wenn
Sie mehr als 200 Entwickler sind, komplexe Planung über mehrere Regionen haben, tiefe ITSM-Integrationen brauchen und die Preise pro Nutzer nicht der Engpass sind. Lassen Sie es weg, wenn Sie weniger als 50 Personen sind (die Rechnung pro Nutzer geht dann nicht auf) oder wenn Sie ein Chat-natives Erlebnis wollen.
5. Squadcast: am besten für DevOps-Teams mit knappem Budget
Ideal für
Kleine bis mittelgroße DevOps- und SRE-Teams, die solide Bereitschaftspläne, Alarm-Routing und grundlegendes Incident-Management zum niedrigsten ernstzunehmenden Preis pro Nutzer brauchen. Die richtige Antwort, wenn incident.io vom Konzept her überdimensioniert ist.
Wichtige Funktionen
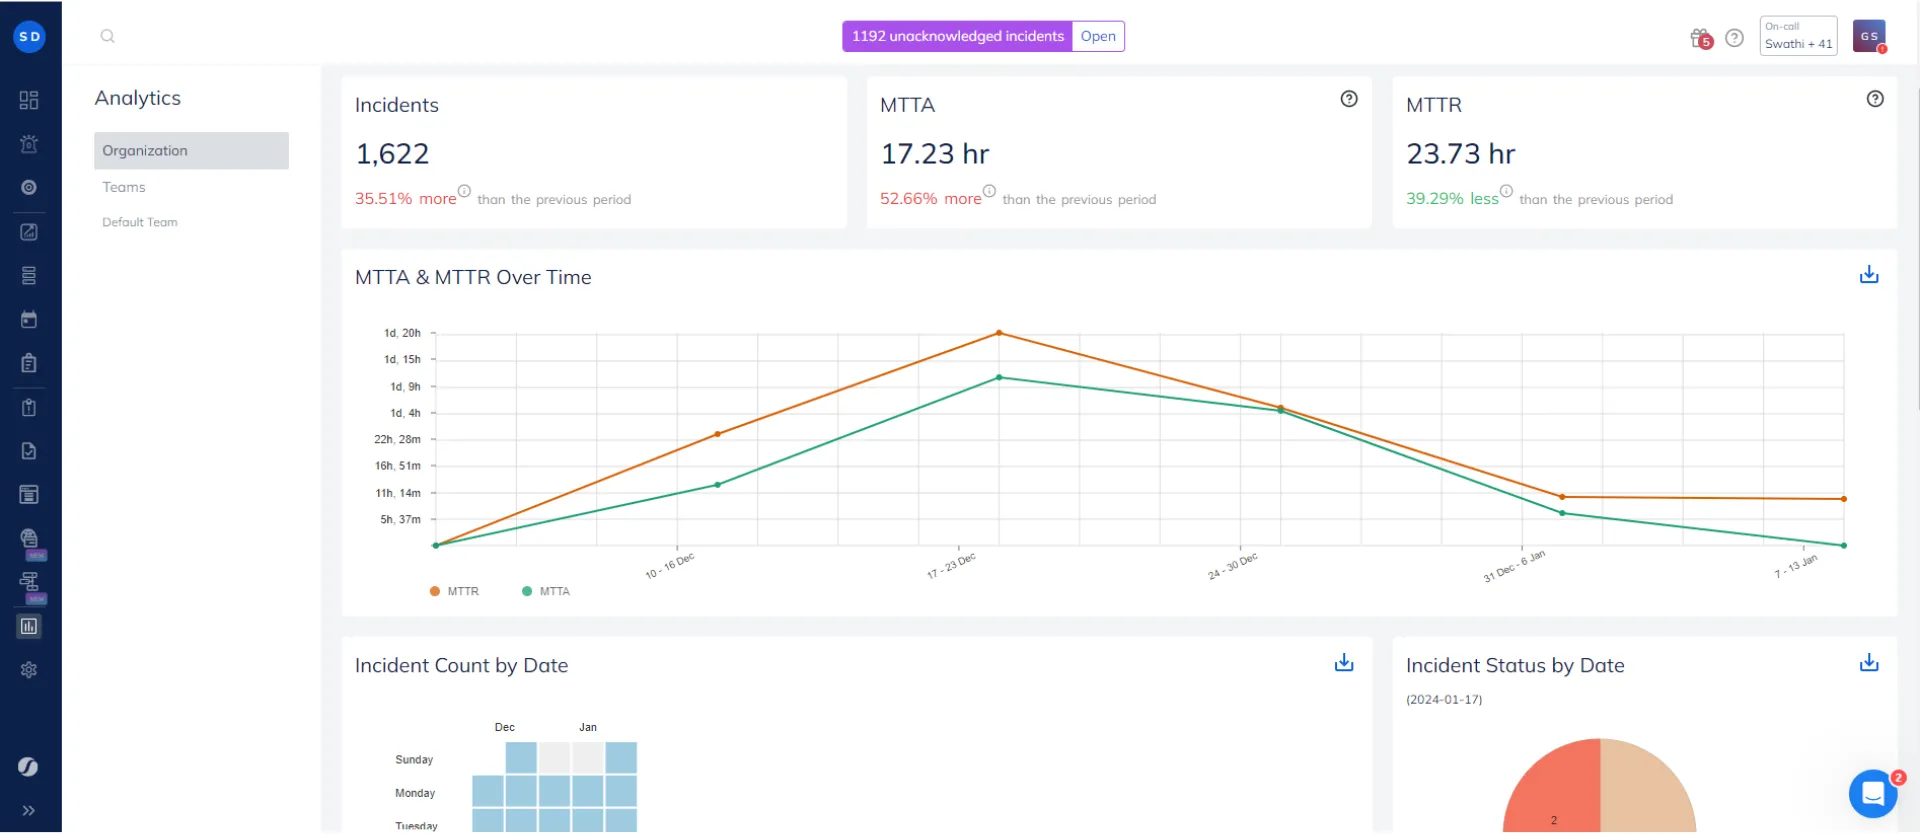
- Bereitschaftspläne mit Rotationen, Vertretungen und zeitbasiertem Routing
- Eskalationsrichtlinien mit Deduplizierung und Unterdrückung von Alarmrauschen
- SRE-Workflows einschließlich SLO/SLA-Tracking, Error Budgets und Reliability-Automatisierung
- Über 175 Integrationen mit Datadog, Prometheus, Grafana, Jira, Slack, Teams
- Statusseiten inklusive
- Kostenlose Stufe für bis zu 5 Nutzer mit E-Mail/Push und 100 kostenlosen SMS/Anrufen für das gesamte Konto
Warum Squadcast statt incident.io
Die günstigste ernstzunehmende Alternative. Pro für 15 $ pro Nutzer/Monat (jährliche Abrechnung) ist etwa 40 % günstiger als die effektiven Kosten pro Nutzer bei incident.io, sobald das On-Call-Add-on dazukommt. Für ein 20-köpfiges Team sind das 3.600 $/Jahr gegenüber über 6.000 $/Jahr.
Schnelle Einrichtung. Mehrere G2-Bewertungen berichten, dass sie in Stunden statt Tagen startklar waren.
SRE-Praktiken eingebaut. SLOs, Error Budgets und Reliability-Tracking sind Teil des Produkts, statt über eigene Dashboards nachgerüstet zu werden.
Wo Squadcast Schwächen hat
Weniger Slack-nativ als incident.io oder Rootly. Squadcast ist in erster Linie ein Tool für Alarmierung und Rufbereitschaft, mit Incident Response obendrauf. Der Lebenszyklus im Chat ist flacher.
Weniger Enterprise-Funktionen. An die KI-Post-Mortems und den Feinschliff der Workflows von incident.io kommt es nicht heran.
Unsicherheit nach der Übernahme. SolarWinds hat Squadcast gekauft und umbenannt. Teams in r/devops mahnen zu gesunder Vorsicht, was die langfristige Klarheit der Roadmap angeht.
Bekanntheit beim Einkauf. „Wir haben uns für Squadcast entschieden“ führt im Enterprise-Einkauf zu einem längeren Gespräch als „wir haben uns für incident.io entschieden“.
Preise
- Testphase: 14 Tage, begrenzt auf 100 Anruf- und SMS-Benachrichtigungen (kein kostenloser Plan mehr)
- Pro: 15 $ pro Nutzer/Monat (jährlich), Rufbereitschaft, Eskalationen, SMS/Anrufe, Unterdrückung von Alarmrauschen
- Premium: 24 $ pro Nutzer/Monat (jährlich), dazu Statusseiten, Runbooks, Workflows, SLO-Tracking
- Enterprise: individuell, mit KI-Zusammenfassungen, bidirektionaler ServiceNow-Synchronisierung, SSO
Wählen Sie Squadcast, wenn
Das Budget die wichtigste Einschränkung ist, Ihre Bereitschaftsplanung überschaubar ist und Sie ein Tool wollen, das die wichtigsten 80 % der On-Call-Ebene von incident.io zu einem Bruchteil des Preises abdeckt. Lassen Sie es weg, wenn Sie tiefe KI-native Response oder den vollständigen Lebenszyklus im Chat brauchen.
6. Better Stack: am besten für Monitoring, Logs und Incidents in einer Plattform
Ideal für
Startups und wachsende SaaS-Teams, die Monitoring, Log-Management und Incident Response in einer gepflegten, modernen Oberfläche wollen und nichts dagegen haben, nutzungsbasierte Add-ons im Blick zu behalten.
Wichtige Funktionen
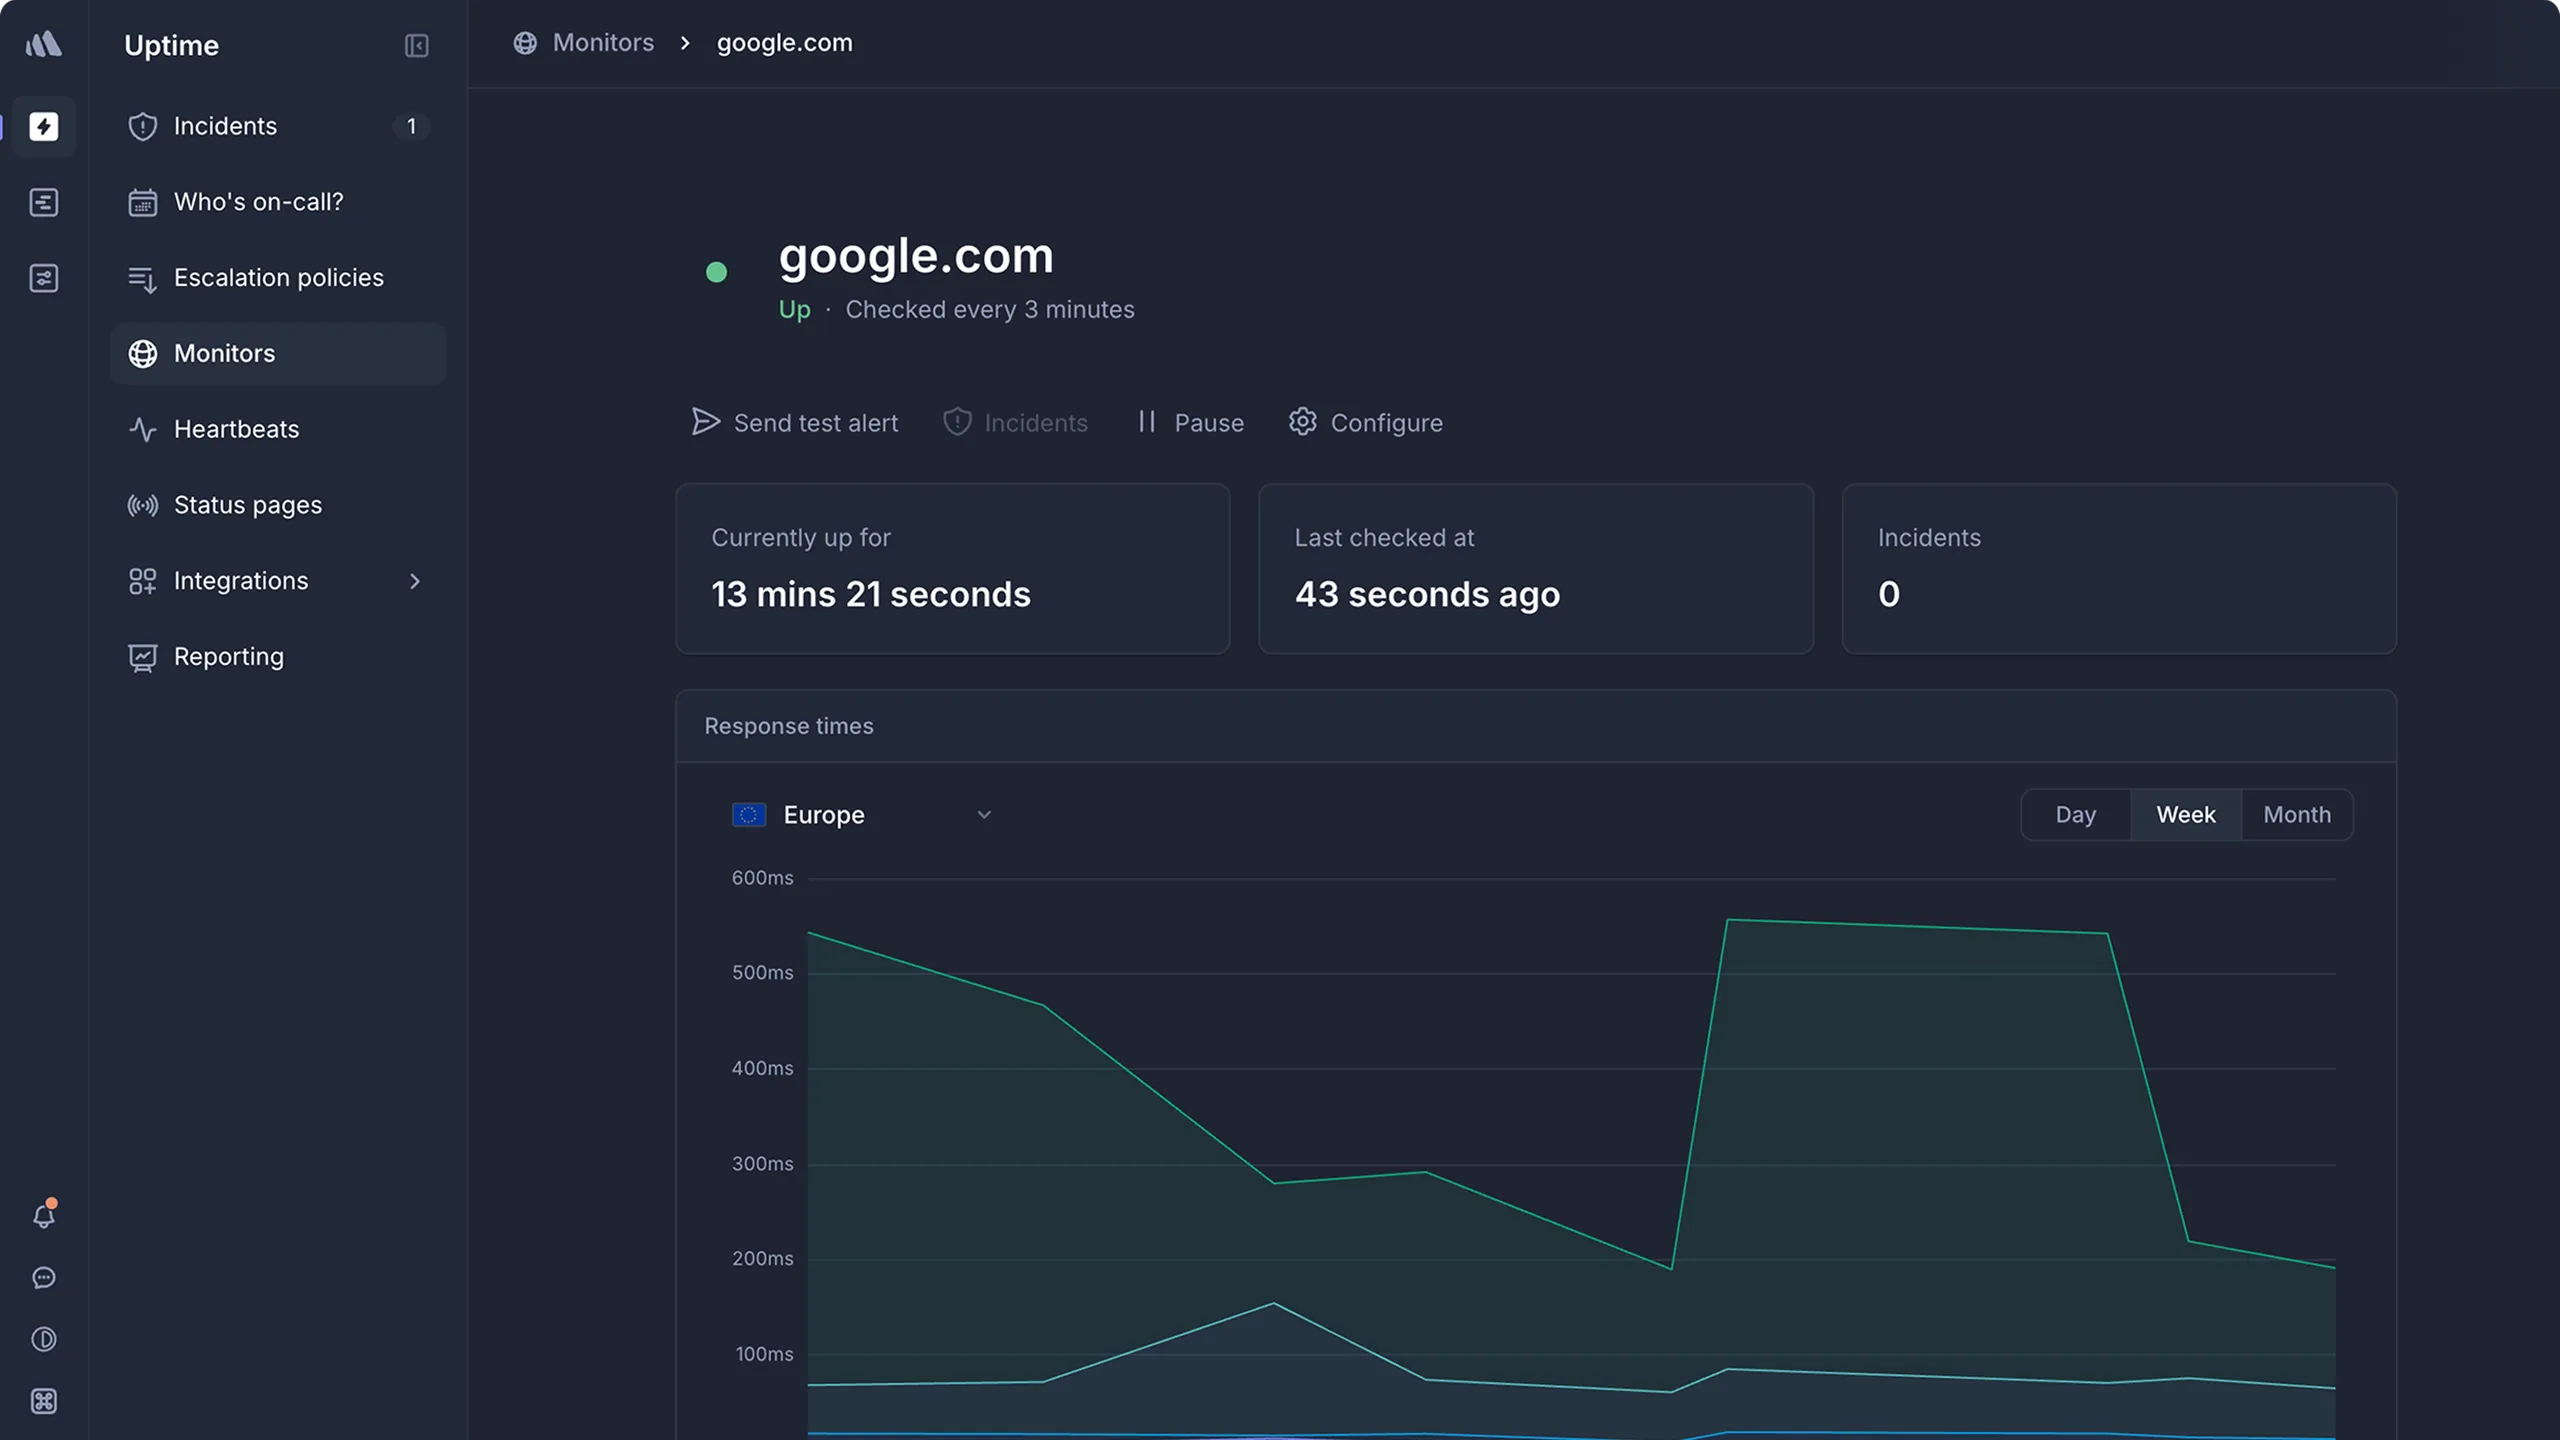
- Uptime-Monitoring mit Checks von mehreren Standorten weltweit
- Log-Management mit strukturierter Suche und Alarmierung
- Bereitschaftspläne und Eskalation mit Alarmen über mehrere Kanäle
- Statusseiten im eigenen Branding mit eigenen Domains
- Moderne Oberfläche, in G2-Bewertungen durchweg gelobt
- eBPF-basiertes OpenTelemetry-Tracing für automatische Instrumentierung
- Terraform- und API-Unterstützung für Infrastructure-as-Code-Workflows
Warum Better Stack statt incident.io
Drei Ebenen in einer Plattform. Monitoring, Logs und Incidents unter einem Dach, also eine SaaS-Rechnung und eine zu pflegende Integration weniger. incident.io geht davon aus, dass Sie Erkennung und Observability selbst mitbringen.
Ausgefeilte Oberfläche. Das ist der in Bewertungen am häufigsten gelobte Punkt. Vom Feinschliff her mit incident.io vergleichbar, aber mit der Monitoring-Ebene inklusive.
Großzügige kostenlose Stufe. Damit können Sie die Plattform ohne Verpflichtung ausprobieren.
Wo Better Stack Schwächen hat
Überraschungen durch Preise pro Responder. 29 $/Monat ist die Schlagzeile, aber zusätzliche Responder (je 29 $), mehr Monitore (21 $ pro 50) und zusätzliche Statusseiten (je 12 $) summieren sich schneller, als das Marketing vermuten lässt.
Weniger ausgereifter Lebenszyklus als bei incident.io oder Rootly. Rufbereitschaft und Incidents sind solide, aber bei KI-gestützten Post-Mortems und der Tiefe der Chat-nativen Workflows liegt es zurück.
Eingeschränkte Anpassung in den Einstiegsstufen. Vor allem die Gestaltung der Statusseiten ist in den kleineren Plänen begrenzt.
Preise
- Kostenlose Stufe mit einfachem Monitoring und eingeschränkten Funktionen
- Kostenpflichtige Pläne ab 29 $/Monat, in höheren Stufen mit Preisen pro Responder
- Add-ons: mehr Monitore, mehr Statusseiten, Log-Aufbewahrung, alles separat berechnet
Wählen Sie Better Stack, wenn
Sie Monitoring + Logs + Incidents in einem Tool wollen, Wert auf eine moderne Oberfläche legen und kein Problem damit haben, nutzungsbasierte Add-ons im Blick zu behalten. Lassen Sie es weg, wenn Sie die Planbarkeit eines Pauschalpreises wollen (dafür passt Hyperping besser) oder den vollständigen Chat-nativen Incident-Lebenszyklus (dafür passen Rootly oder FireHydrant besser).
Direkte Vergleiche
Rootly vs incident.io: welches Slack-native Tool?
Das ist der am häufigsten genannte direkte Vergleich in r/sre-Threads. Rootly lässt sich stärker konfigurieren und hat eine tiefere Workflow-Automatisierung über Jira, GitHub und den restlichen Dev-Stack. incident.io gibt mehr vor und ist schneller einsatzbereit, mit den stärksten KI-Post-Mortems. Wenn Sie eine komplexe Toolchain haben und darum herum automatisieren wollen: Rootly. Wenn Sie Best Practices fertig eingebaut wollen: incident.io.
FireHydrant vs incident.io: was für Enterprise-Runbooks?
Die Runbook-Engine und der Servicekatalog von FireHydrant sind tiefer und stehen im Zentrum des Produkts. Die Stärke von incident.io sind klare Standardabläufe und KI-Post-Mortems. FireHydrant bündelt KI in Enterprise; incident.io verteilt sie über mehrere Stufen und ein On-Call-Add-on. Für Teams, deren wichtigste Anforderung festgeschriebene, wiederholbare Playbooks und ein zentraler Servicekatalog sind: FireHydrant. Für Teams, die den Feinschliff von incident.io wollen: incident.io.
Hyperping vs incident.io: brauche ich überhaupt eine Response-Plattform?
Wenn Sie weniger als 5 Incidents im Monat haben, lautet die ehrliche Antwort wahrscheinlich: nein. Hyperping deckt Erkennung, Alarmierung, Eskalation und Statusseiten zum Pauschalpreis ab, mit enthaltenen Nutzerplätzen und zusätzlichen Nutzerplätzen, die pro Nutzerplatz berechnet werden. incident.io ist für Teams gebaut, die mehr als 10 Incidents im Monat haben und Orchestrierung brauchen. Für die meisten Teams unter 30 Entwicklern liegt der eigentliche Engpass auf der Ebene von Erkennung und Alarmierung.
Squadcast vs incident.io: was für Teams mit knappem Budget?
Squadcast deckt für 15 $ pro Nutzer/Monat die Ebene von Rufbereitschaft und grundlegender Incident Response ab, etwa 40 % günstiger als die effektiven Kosten von incident.io, sobald das On-Call-Add-on dazukommt. Der Preis dafür: keine KI-Post-Mortems, ein flacherer Lebenszyklus im Chat und weniger Feinschliff bei den Workflows. Für die meisten Teams unter 50 Entwicklern, bei denen das Budget die harte Grenze ist, ist Squadcast die wirtschaftlich bessere Wahl.
PagerDuty vs incident.io: was für Großunternehmen?
Die Alerting-Engine und der Integrationskatalog von PagerDuty sind immer noch ausgereifter. Die Chat-native Response und die KI-Post-Mortems von incident.io sind moderner. Für Organisationen, bei denen Tiefe beim Alerting und Sicherheit beim Einkauf am meisten zählen: PagerDuty. Für Organisationen, die entschieden haben, dass Chat-native Response die Zukunft ist, und modernisieren wollen: incident.io.
Entscheidungshilfe
Nach Teamgröße:
- Einzelperson oder kleines Team (1 bis 10): Hyperping oder Squadcast (14-tägige Testphase).
- Mittelgroß (10 bis 50): Hyperping für Monitoring + Rufbereitschaft + Statusseiten, Rootly oder FireHydrant für den Slack-nativen Lebenszyklus.
- Groß (50 bis 200): Rootly oder FireHydrant für Chat-native Response, PagerDuty, wenn die Komplexität der Bereitschaftsplanung im Vordergrund steht.
- Enterprise (über 200): PagerDuty, FireHydrant Enterprise oder Rootly Enterprise.
Nach Workflow:
- Slack-nativ, tiefe Workflow-Automatisierung: Rootly.
- Slack-nativ, tiefe Runbooks und Servicekatalog: FireHydrant.
- Slack-nativ, klare Standardabläufe: incident.io selbst (die Alternative ist, zu bleiben).
- Zuerst Web-App, komplexes Routing: PagerDuty.
- Eigentlich nur solides On-Call nötig: Squadcast oder Hyperping.
- Monitoring soll inklusive sein: Hyperping oder Better Stack.
Nach Budget (20-köpfiges Team):
- 100 $ bis 300 $/Monat: Hyperping Pro, Squadcast Pro, Better Stack mit wenigen Add-ons.
- 300 $ bis 1.000 $/Monat: FireHydrant Pro oder Rootly Incident Response.
- Über 1.000 $/Monat: die Plattformstufe Essential von PagerDuty (12.000 $/Jahr für 25 Nutzerplätze), FireHydrant Enterprise, Rootly Enterprise.
Vollständige Liste der incident.io-Alternativen, die ich geprüft habe
Der Vollständigkeit halber hier die größere Auswahl an Tools für Incident-Management und Rufbereitschaft, die ich mir angesehen habe, bevor ich mich auf die sechs Favoriten beschränkt habe. Die Preise sind Näherungswerte für 2026 und hängen von Nutzung und Teamgröße ab.
| Name | Preise (ca. 2026) | Größte Stärke | Größte Schwäche |
|---|---|---|---|
| Rootly | ab ca. 20 $ pro Nutzer/Monat und Modul | Tiefe Automatisierung in Slack/Teams, gesamter Lebenszyklus, KI-Retrospektiven | Preise pro Modul summieren sich; vom Chat abhängig |
| FireHydrant | Free (10 Responder); Pro 25 $ pro Responder/Monat (jährlich); Enterprise individuell | Starke Runbooks, strukturierte Workflows, Analyse nach dem Incident | Preissprung zwischen den Stufen; oft Jahresverträge |
| Hyperping | Kostenlose Basisversion; ab ca. 24 €/Monat pauschal | Integriertes Monitoring + Statusseiten + Rufbereitschaft zum Pauschalpreis | Keine Chat-native Response-Plattform |
| PagerDuty | Professional 21 $ pro Nutzer/Monat; Plattform ab 2.800 $/Jahr mit AIOps | Ausgereiftes Enterprise-Alerting, Rufbereitschaft, über 700 Integrationen, AIOps | Teure Add-ons; komplexe, veraltete Oberfläche; steile Lernkurve |
| Squadcast | Pro 15 $ pro Nutzer/Monat; Premium 24 $ pro Nutzer/Monat (jährlich) | Günstig und auf SRE ausgerichtet (Rufbereitschaft, SLOs, Post-Mortems) | Weniger bekannt als die Marktführer |
| Better Stack | Kostenlose Stufe; kostenpflichtig ab ca. 29 $/Monat (nutzungsbasiert) | All-in-one: Monitoring + Incidents + Statusseiten; moderne Oberfläche | Modulare Preise summieren sich |
| Opsgenie (Atlassian) | Nicht mehr erhältlich (Verkaufsende 4. Juni 2025) | Alerting/Rufbereitschaft mit Jira-Integration, für Bestandskunden | Abschaltung am 5. April 2027; Kunden wechseln zu Jira Service Management |
| xMatters | ab ca. 9 $ pro Nutzer/Monat (kostenlos bis 10 Nutzer); darüber individuell | Tiefe Analysen, ML-Erkenntnisse, komplexe Workflows | Veraltete Oberfläche; steilere Lernkurve |
| Jira Service Management | Free (eingeschränkt); Standard ca. 20 $ pro Agent/Monat; Premium ca. 49 $ pro Agent/Monat | Nahtlose Atlassian/Jira-Integration für ticketbasiertes ITSM | Auf Tickets ausgerichtet, keine Echtzeit-Response für SREs |
| ServiceNow | Individuell für Enterprise (oft über 100 $ pro Nutzer/Monat) | Umfassende ITSM-Suite, Automatisierung, Compliance | Sehr komplex, teuer, lange Einführung |
| Splunk On-Call (VictorOps) | Über den Vertrieb (nutzungsbasiert) | Enge Integration mit Splunk Observability | Veraltete Oberfläche; als eigenständiges Tool wenig attraktiv |
| Freshservice | ab ca. 19 $ pro Agent/Monat | Benutzerfreundliches Cloud-ITSM mit KI-Automatisierung | Eher Helpdesk; weniger auf SRE spezialisiert |
| Zenduty (Xurrent IMR) | Kostenlos, dann ca. 5 $ pro Nutzer/Monat (Starter); bis 21 $ in Enterprise | Günstig und KI-gestützt (RCA, Post-Mortems), gute Integrationen | Weniger bekannte Marke; einige Lücken für Enterprise |
| iLert | Free (eingeschränkt); Pro ca. 19 € pro Nutzer/Monat; Enterprise ab ca. 49 $ | EU-freundlich, KI-first, Statusseiten, stackübergreifend | Regionaler Fokus kann die globale Wahrnehmung schmälern |
| PagerTree | ab ca. 10 $ pro Nutzer/Monat oder pauschal; kostenlose Basisversion | Einfaches, schlankes Alarm-Routing und Rufbereitschaft für kleine Teams | Begrenzte Automatisierung und Lebenszyklus-Funktionen |
| Spike.sh | ab ca. 5 $/Monat | Einfache, günstige Incident Response | Grundfunktionen; nicht für Enterprise-Anforderungen |
| Grafana OnCall / IRM | Kostenlose Stufe; kostenpflichtig ca. 20 $ pro Nutzer + Nutzung | Native Integration mit Grafana/Observability, Open-Source-Wurzeln | Am besten mit dem Grafana-Stack; allein weniger stark |
| Blameless | Individuell (über den Vertrieb) | Auf SRE-Praktiken ausgerichtet, strukturierte Post-Mortems | Dynamik hinter den Chat-nativen Tools zurückgeblieben |
| BigPanda | Enterprise (über den Vertrieb) | Starke AIOps-Korrelation von Alarmen und Unterdrückung von Alarmrauschen | Teuer; eher AIOps als vollständiger Incident-Lebenszyklus |
| Moogsoft | Enterprise (über den Vertrieb) | AIOps für die Unterdrückung von Alarmrauschen und Gruppierung | Komplex; höhere Kosten bei großem Umfang |
| OnPage | ca. 12 $ pro Nutzer/Monat | Sichere Alarmierung für Gesundheitswesen und regulierte Branchen | Nischenfokus; weniger breite SRE-Funktionen |
| ManageEngine ServiceDesk Plus | Über den Vertrieb / ab günstigeren Stufen | Günstige ITSM-Suite mit Incident-Modulen | Veraltete Oberfläche; eher klassisches ITSM |
| InvGate Service Management | Starter ca. 17 $ pro Agent/Monat; Pro ca. 40 $ | Gut nutzbare No-Code-Workflows, ITAM-Integration | In reinen SRE-Kreisen weniger bekannt |
| BMC Helix | Enterprise (über den Vertrieb) | KI-gestütztes Enterprise-ITSM | Teure und komplexe Einführung |
| NinjaOne | Variiert (auf MSPs ausgerichtet) | Patch-Management + Incident Response | Eher Endpoint/RMM als Kern-Incident-Management |
| GoAlert | Kostenlos (OSS) | Einfache Open-Source-Bereitschaftsplanung für On-Call | Aufwand für Self-Hosting; minimale Lebenszyklus-Funktionen |
| All Quiet | ab ca. 5 $ pro Nutzer/Monat | Günstige Alternative für Rufbereitschaft | Kleinerer Funktionsumfang; neuer Anbieter |
Die Muster in dieser Liste stammen aus Analysen von 2025 bis 2026 auf Gartner Peer Insights, Preisseiten der Anbieter, Vergleichsartikeln und Reddit-Threads in r/sre, r/devops, r/incidentio und r/SaaS.
Häufige Fehler beim Wechsel weg von incident.io
Ein paar Muster, die mir in den Reddit-Threads immer wieder begegnet sind:
- incident.io durch Rootly ersetzen, ohne den Aufwand für die Workflow-Migration zu testen. Die Tiefe von Rootly ist wertvoll, aber festgelegte incident.io-Workflows in den Low-Code-Builder von Rootly zu übertragen, ist echte Arbeit. Prüfen Sie vor der Migration, welche Workflows Sie tatsächlich nutzen.
- Zu einem Tool wechseln, dem die KI-Post-Mortems fehlen, auf die Sie sich tatsächlich verlassen haben. Wenn die automatisch erstellten Post-Mortems von incident.io die tragende Funktion waren, kommen FireHydrant Enterprise (FireHydrant AI) und Rootly AI SRE am nächsten heran. PagerDuty und Squadcast liegen hier zurück.
- Statusseiten und Erkennung vergessen. Viele Teams ersetzen incident.io durch ein anderes Response-Tool und merken dann, dass sie auch einen separaten Uptime-Monitor und eine Statusseite genutzt haben. Ein Komplettpaket wie Hyperping oder Better Stack schließt diese Lücke.
- Nach der Checkliste der KI-Funktionen auswählen. KI-Post-Mortems, KI-Zusammenfassungen und von KI vorgeschlagene Responder sind alles echte Funktionen, ihre Qualität schwankt aber stark. Der r/sre-Thread zu KI-RCA ist voller pragmatischer Skepsis. Lassen Sie vor der Entscheidung einen parallelen POC mit drei bis fünf echten Incidents laufen.
- „Slack-nativ“ als Ja-oder-Nein-Frage behandeln. „Slack-nativ“ bedeutet bei Rootly, FireHydrant und incident.io sehr Unterschiedliches. Schicken Sie während eines POC echte Responder durch den Chat-Ablauf. Power-User und Entwickler in ihrer ersten Rufbereitschaft werden Ihnen unterschiedliches Feedback geben.
Fazit
Die eine beste incident.io-Alternative gibt es nicht, nur das beste Tool für einen bestimmten Platz in Ihrem Stack.
- Für Slack-native Response mit tieferer Workflow-Automatisierung: Rootly.
- Für ausgereifte Enterprise-Runbooks mit einem Servicekatalog im Zentrum: FireHydrant.
- Für Monitoring, Rufbereitschaft und Statusseiten in einem Tool zum Pauschalpreis: Hyperping.
- Für tiefgehendes Enterprise-Alerting und den breitesten Integrationskatalog: PagerDuty.
- Für DevOps-Teams mit knappem Budget, die nur solides On-Call brauchen: Squadcast.
- Für Monitoring, Logs und Incidents vereint in einer ausgefeilten Oberfläche: Better Stack.
Wenn Sie Monitoring wollen, das Probleme in 30 Sekunden erkennt, Bereitschaftspläne mit intelligenten Eskalationen und Statusseiten, die Ihre Kunden wirklich aufrufen, und das alles zum monatlichen Pauschalpreis mit enthaltenen Nutzerplätzen und kostenpflichtigen zusätzlichen Nutzerplätzen, testen Sie Hyperping kostenlos.
Weiterlesen
- Die besten Incident-Management-Tools: der breitere Guide zur Kategorie mit 6 Tools
- Die besten Rootly-Alternativen: falls Rootly ebenfalls auf Ihrer Shortlist steht
- Die besten FireHydrant-Alternativen für Bereitschaftspläne: falls FireHydrant der andere Name auf Ihrer Shortlist ist
- Die besten PagerDuty-Alternativen: falls PagerDuty ebenfalls auf Ihrer Shortlist steht
- Die besten Tools für Bereitschaftspläne: mit Fokus auf die On-Call-Ebene
- Die beste Statusseiten-Software: die Ebene der Kundenkommunikation, die die meisten Response-Tools auslassen
- Hyperping Preise
Weiter vergleichen: Hyperping vs incident.io · Hyperping vs PagerDuty · Hyperping Preise · Alle Vergleiche
Häufige Fragen
Was ist die beste incident.io-Alternative? ▼
Die eine beste incident.io-Alternative gibt es nicht. Für Slack-native Incident Response mit tieferer Workflow-Automatisierung: Rootly. Für ausgereifte Enterprise-Runbooks mit einem Servicekatalog im Zentrum: FireHydrant. Für Monitoring, Rufbereitschaft und Statusseiten in einem Tool zum Pauschalpreis: Hyperping. Für tiefgehendes Enterprise-Alerting und über 700 Integrationen: PagerDuty. Für DevOps-Teams mit knappem Budget: Squadcast. Für Monitoring, Logs und Incidents in einer Plattform: Better Stack.
Warum suchen Teams nach incident.io-Alternativen? ▼
In den Reddit-Threads, die ich gelesen habe, dominieren diese Gründe: Überraschungen beim Preis (die effektive Untergrenze des Pro-Plans liegt deutlich über dem öffentlichen Preis pro Nutzer, sobald On-Call dazukommt), festgelegte Standardabläufe, die Teams mit eigenen Prozessen frustrieren, Grenzen bei der Anpassung komplexer Bedingungslogik und die Abhängigkeit von Slack als Hauptoberfläche. Teams, die vor allem Microsoft Teams nutzen, berichten außerdem, dass der Funktionsumfang dort hinterherhinkt.
Ist Rootly besser als incident.io? ▼
Das hängt davon ab, was Sie wollen. Rootly lässt sich stärker konfigurieren und hat eine tiefere Workflow-Engine über Jira, GitHub, Zoom und den restlichen Dev-Stack. incident.io gibt mehr vor, ist schneller einsatzbereit und bietet die stärksten KI-Post-Mortems. Teams mit komplexer Toolchain wählen Rootly. Teams, die Best Practices fertig eingebaut haben wollen, wählen incident.io.
Was ist die günstigste incident.io-Alternative? ▼
Squadcast (heute SolarWinds Incident Response) Pro für 15 $ pro Nutzer und Monat bei jährlicher Abrechnung ist das günstigste ernstzunehmende Incident-Management-Tool mit echten On-Call-Funktionen. Hyperping beginnt bei 24 €/Monat zum Pauschalpreis, mit enthaltenen Nutzerplätzen und kostenpflichtigen zusätzlichen Nutzerplätzen, und umfasst Monitoring, Rufbereitschaft, Eskalationsrichtlinien und Statusseiten. Für die meisten Teams unter 30 Personen ist Hyperping der günstigste Weg zur Komplettlösung.
Lohnt sich incident.io? ▼
Für Teams, die wirklich in Slack leben, mehr als 10 Incidents im Monat haben und einen einheitlichen Prozess wollen, ohne Entwickler in eine separate Web-App zu zwingen: ja. Für Microsoft-Teams-Unternehmen, kleine Teams mit wenigen Incidents im Monat oder Teams, deren Engpass die Erkennung und nicht die Koordination ist, lassen sich das On-Call-Add-on und die Mindestbeträge des Pro-Plans kaum rechtfertigen.