De beste alternatieven voor incident.io in 2026 zijn Rootly voor AI-native respons in Slack met diepere workflowautomatisering, FireHydrant voor volwassen enterprise-runbooks, Hyperping voor monitoring, piketdienst en statuspagina’s tegen een vaste prijs, PagerDuty voor diepgaande enterprise-alerting, Squadcast voor DevOps-teams die op hun budget letten, en Better Stack voor monitoring, logs en incidenten op één plek.
Ik heb 25+ tools geanalyseerd, patronen verzameld uit threads op r/sre, r/devops en r/incidentio waarin engineers incident.io rechtstreeks vergelijken met Rootly, FireHydrant en PagerDuty, en de echte prijzen bij gangbare teamgroottes naast elkaar gelegd. incident.io is een sterk product. De meeste teams die naar alternatieven kijken, zijn niet ontevreden over de tool zelf. Ze willen een andere afweging: meer flexibiliteit, minder afhankelijkheid van Slack, een bredere dekking dan alleen chat-native respons, of een tool die hen niet verrast met het minimumbedrag van het Pro-abonnement.
In deze gids lees je:
- Waarom teams echt alternatieven voor incident.io bekijken (het is zelden “incident.io is slecht”)
- De zes tools die ik zou aanraden, met eerlijke prijzen en echte afwegingen
- Een prijsvergelijking bij gangbare teamgroottes
- De volledige lijst van 25+ alternatieven voor incident.io die ik heb bekeken
Wil je monitoring die problemen binnen 30 seconden opmerkt, piketplanning met slimme escalaties en statuspagina’s die je klanten echt bekijken, allemaal tegen een vast maandbedrag met seats inbegrepen en betaalde extra seats? Probeer Hyperping gratis.
Belangrijkste punten
- Rootly is het meest directe alternatief als je chat-native respons wilt met meer diepgang in workflows. Vanaf ca. $ 20/gebruiker/mnd voor Incident Response Essentials, met aparte niveaus per gebruiker voor On-Call en AI SRE.
- FireHydrant sluit het best aan voor teams die volwassen runbooks en een servicecatalogus willen. Gratis tot 10 responders, daarna Pro voor $ 25/responder/mnd bij jaarlijkse betaling; AI en privé-statuspagina’s zitten in Enterprise.
- Hyperping biedt de meeste waarde als je knelpunt bij detectie, piketdienst en statuspagina’s ligt en niet bij chat-native respons. € 24/mnd tegen een vaste prijs, seats inbegrepen en extra seats apart gefactureerd.
- PagerDuty is de gevestigde speler met de diepste alerting-engine en 700+ integraties. $ 21/gebruiker/mnd op Professional, daarna een PD Reliability Platform-fee die per jaar vooraf wordt gefactureerd, vanaf $ 2.800 voor 10 seats. Daar zit AIOps.
- Squadcast (nu SolarWinds Incident Response) is de goedkoopste geloofwaardige optie, met Pro voor $ 15/gebruiker/mnd bij jaarlijkse betaling en een proefperiode van 14 dagen (geen gratis abonnement).
- Better Stack bundelt monitoring, logs en incidenten in één moderne interface vanaf $ 29/mnd, maar de kosten per responder en per add-on kunnen flink oplopen.
Waarom je deze gids kunt vertrouwen
Ik ben Léo, oprichter van Hyperping. Ja, ik heb belang bij een van deze tools. Mijn doel is niet om je ervan te overtuigen dat Hyperping altijd het antwoord is. Dat is het zelden. Incidentbeheer is een brede categorie, en Hyperping dekt daar een specifiek deel van: detectie, piketdienst en statuspagina’s. Voor diepgaande Slack-native respons of AI-gestuurde postmortems passen de tools hieronder beter, en dat zeg ik ook.
Voor deze gids las ik productanalyses van elke tool, haalde ik citaten van G2 en legde ik de criteria naast Reddit-threads waarin SRE’s uit de praktijk delen wat werkt en wat niet. De belangrijkste threads waarop ik leunde:
- Mijn ervaring na het testen van zowel Rootly als incident.io (r/sre)
- Vergelijking van tools voor incidentbeheer (r/sre)
- Gebruikt iemand hier AI-tools voor RCA zoals incident.io? (r/sre)
- Beste PagerDuty-alternatieven in 2026 (r/devops)
- r/incidentio
Waar ik een tool niet zelf kon testen, heb ik dat gezegd en me gebaseerd op geverifieerde feedback van gebruikers.
Topkeuzes in één oogopslag
| Het beste voor | Product |
|---|---|
| Slack-native respons met diepere workflowautomatisering | Rootly |
| Volwassen enterprise-runbooks en gestructureerde workflows | FireHydrant |
| Monitoring + piketdienst + statuspagina’s tegen een vaste prijs | Hyperping |
| Diepgaande enterprise-alerting met de grootste integratiecatalogus | PagerDuty |
| DevOps-teams met een krap budget die degelijke piketdienst nodig hebben | Squadcast |
| Monitoring, logs en incidenten op één plek | Better Stack |
Waarom teams naar alternatieven voor incident.io zoeken
incident.io krijgt een van de sterkste reviews in de categorie. In de r/sre-threads die ik las, prijzen teams de gepolijste Slack-integratie, de uitgesproken standaardinstellingen en de door AI gegenereerde postmortems. De redenen om alternatieven te bekijken gaan meestal over de match, niet over falen.
- Verrassingen rond prijstransparantie. Het geadverteerde Team-abonnement van ca. $ 15/gebruiker/mnd is het kopbedrag, maar de echte rekening bevat een add-on per gebruiker met piketdienst (ca. $ 10/gebruiker/mnd) en een effectieve ondergrens voor het Pro-abonnement die verschillende r/incidentio-threads rond de $ 4.000 per jaar als minimum schatten. Teams die hun rekening op het publieke bedrag per gebruiker hebben gebaseerd, worden daarmee overvallen.
- Grenzen aan maatwerk. Het duidelijkste klachtenpatroon in de r/sre-thread over Rootly vs incident.io: incident.io is uitgesproken. Teams met complexe voorwaardelijke logica (meer dan twee vertakkingen), eigen escalatieprocessen of ongebruikelijke levenscycli van incidenten lopen tegen muren aan. Eén reviewer vatte het zo samen: “Het voelde alsof het ontworpen was voor het incidentproces van iemand anders, niet voor het onze.”
- Afhankelijkheid van Slack. Er is ondersteuning voor Microsoft Teams, maar die loopt qua functies steevast achter op Slack. Voor organisaties die Teams als belangrijkste chatkanaal gebruiken, verdampt een groot deel van het onderscheidend vermogen.
- Piketdienst als add-on. incident.io begon als tool voor alleen respons. Piketdienst werd er later aan vastgeschroefd en is nog altijd een aparte betaalde module. Teams die één niveau willen dat beide dekt, vinden de rekensom ongunstig vergeleken met Rootly of FireHydrant.
- “We hebben eigenlijk alleen detectie en piketdienst nodig.” Veel teams die naar incident.io kijken, merken dat ze helemaal geen probleem hebben met chat-native coördinatie. Ze hebben een probleem met detectie en oproepen, en een orchestrator voor respons is dan de verkeerde laag.
- AI-functies voelen nog vroeg. De r/sre-thread over AI-RCA staat vol nuchtere scepsis: AI-samenvattingen helpen bij het documentatiewerk, maar de hints over de oorzaak zijn zo wisselend dat teams er nog niet op vertrouwen.
Een terugkerend thema op r/sre: geen enkele tool lost elke laag van de levenscyclus van een incident op. Veel teams combineren een detectietool (Hyperping, Datadog, Prometheus) met een responsetool (incident.io, Rootly, FireHydrant) en een statuspagina (Hyperping, Statuspage). Het doel is niet één tool die alles doet, maar de juiste tool per laag met zo weinig mogelijk overlap.
Waarom deze 6 tools de selectie haalden
Ik heb 25+ tools bekeken, waaronder Blameless, OpsGenie, Grafana OnCall, xMatters, Zenduty, iLert, Splunk On-Call, ServiceNow, Jira Service Management, Freshservice, GoAlert, BigPanda, Spike.sh en PagerTree. Veel vielen om specifieke redenen af:
- Wordt uitgefaseerd. OpsGenie wordt in april 2027 stopgezet. Wie vandaag evalueert, moet de vervanger evalueren, niet de tool die vervangen wordt.
- Te smal. Spike.sh, GoAlert en PagerTree zijn prima voor teams die alleen basale oproepen nodig hebben, maar ze missen de functies voor de hele levenscyclus (tijdlijnen, postmortems, statuspagina’s) die steeds terugkomen in r/sre-threads.
- Eerst een servicedesk. Jira Service Management, ServiceNow en Freshservice zijn in de eerste plaats ITSM-tools en pas daarna tools voor incidentrespons. Ze zijn geoptimaliseerd voor tickets, niet voor het coördinatieprobleem om 2 uur ’s nachts dat incident.io oplost.
- Ondoorzichtige prijzen. Tools waarvoor je nog altijd een salesgesprek nodig hebt om een bedrag te krijgen (BigPanda, Moogsoft, BMC Helix) vallen af, omdat blind evalueren geen optie is.
- Op hun best als onderdeel van een andere stack. Grafana OnCall is uitstekend als je al Grafana draait, al is de OSS-versie gearchiveerd en legt de gids met Grafana OnCall-alternatieven uit wat dat verandert. Splunk On-Call (VictorOps) is het beste als je al Splunk draait; stap je ervan over, bekijk dan de VictorOps-alternatieven. Geen van beide staat op zichzelf als vervanger van incident.io.
- Sterk, maar minder urgent. Blameless heeft een serieus verhaal rond postmortems en SRE-praktijken, maar momentum en ontwikkeltempo blijven achter bij de chat-native kopgroep. Goed om te kennen, maar in 2026 niet bovenaan de meeste shortlists.
De zes tools hieronder hebben elk een specifieke use case waarin incident.io minder sterk is, of ze bedienen dezelfde use case tegen een andere prijs.
Functievergelijking
| Functie | Rootly | FireHydrant | Hyperping | PagerDuty | Squadcast | Better Stack |
|---|---|---|---|---|---|---|
| Prijsmodel | Per gebruiker (per module) | Per gebruiker (in niveaus) | Vaste prijs | Per gebruiker + add-ons | Per gebruiker | Tier + per responder + add-ons |
| Ingebouwde monitoring | Nee | Nee | Ja | Nee | Nee | Ja |
| Piketplanning | Ja (aparte module) | Ja | Ja | Ja | Ja | Ja |
| Slack-native workflow | Volledige levenscyclus | Volledige levenscyclus | Meldingen | Meldingen | Meldingen | Meldingen |
| Ondersteuning Microsoft Teams | Volledig | Volledig | Meldingen | Volledig | Volledig | Volledig |
| Diepte workflow-engine | Diep (low-code) | Sterke runbooks | n.v.t. | Sterk (web) | Premium-niveau | Beperkt |
| AI-postmortems | Ja | Ja (Enterprise) | Nee | Add-on | Premium | Beperkt |
| Ingebouwde statuspagina’s | Ja | Ja | Ja | Add-on (Statuspage) | Ja | Ja (kosten per pagina) |
| Meldingen via telefoonoproep | Ja | Via integratie | Ja | Ja | Ja | Ja |
| Gratis abonnement | Alleen proefperiode | Ja (10 responders) | Ja | Tot 5 gebruikers | Nee (proefperiode) | Ja |
| Hosting | VS | VS | EU (AVG) | VS | VS | VS/EU |
1. Rootly: het meest directe alternatief voor incident.io
Perfect voor
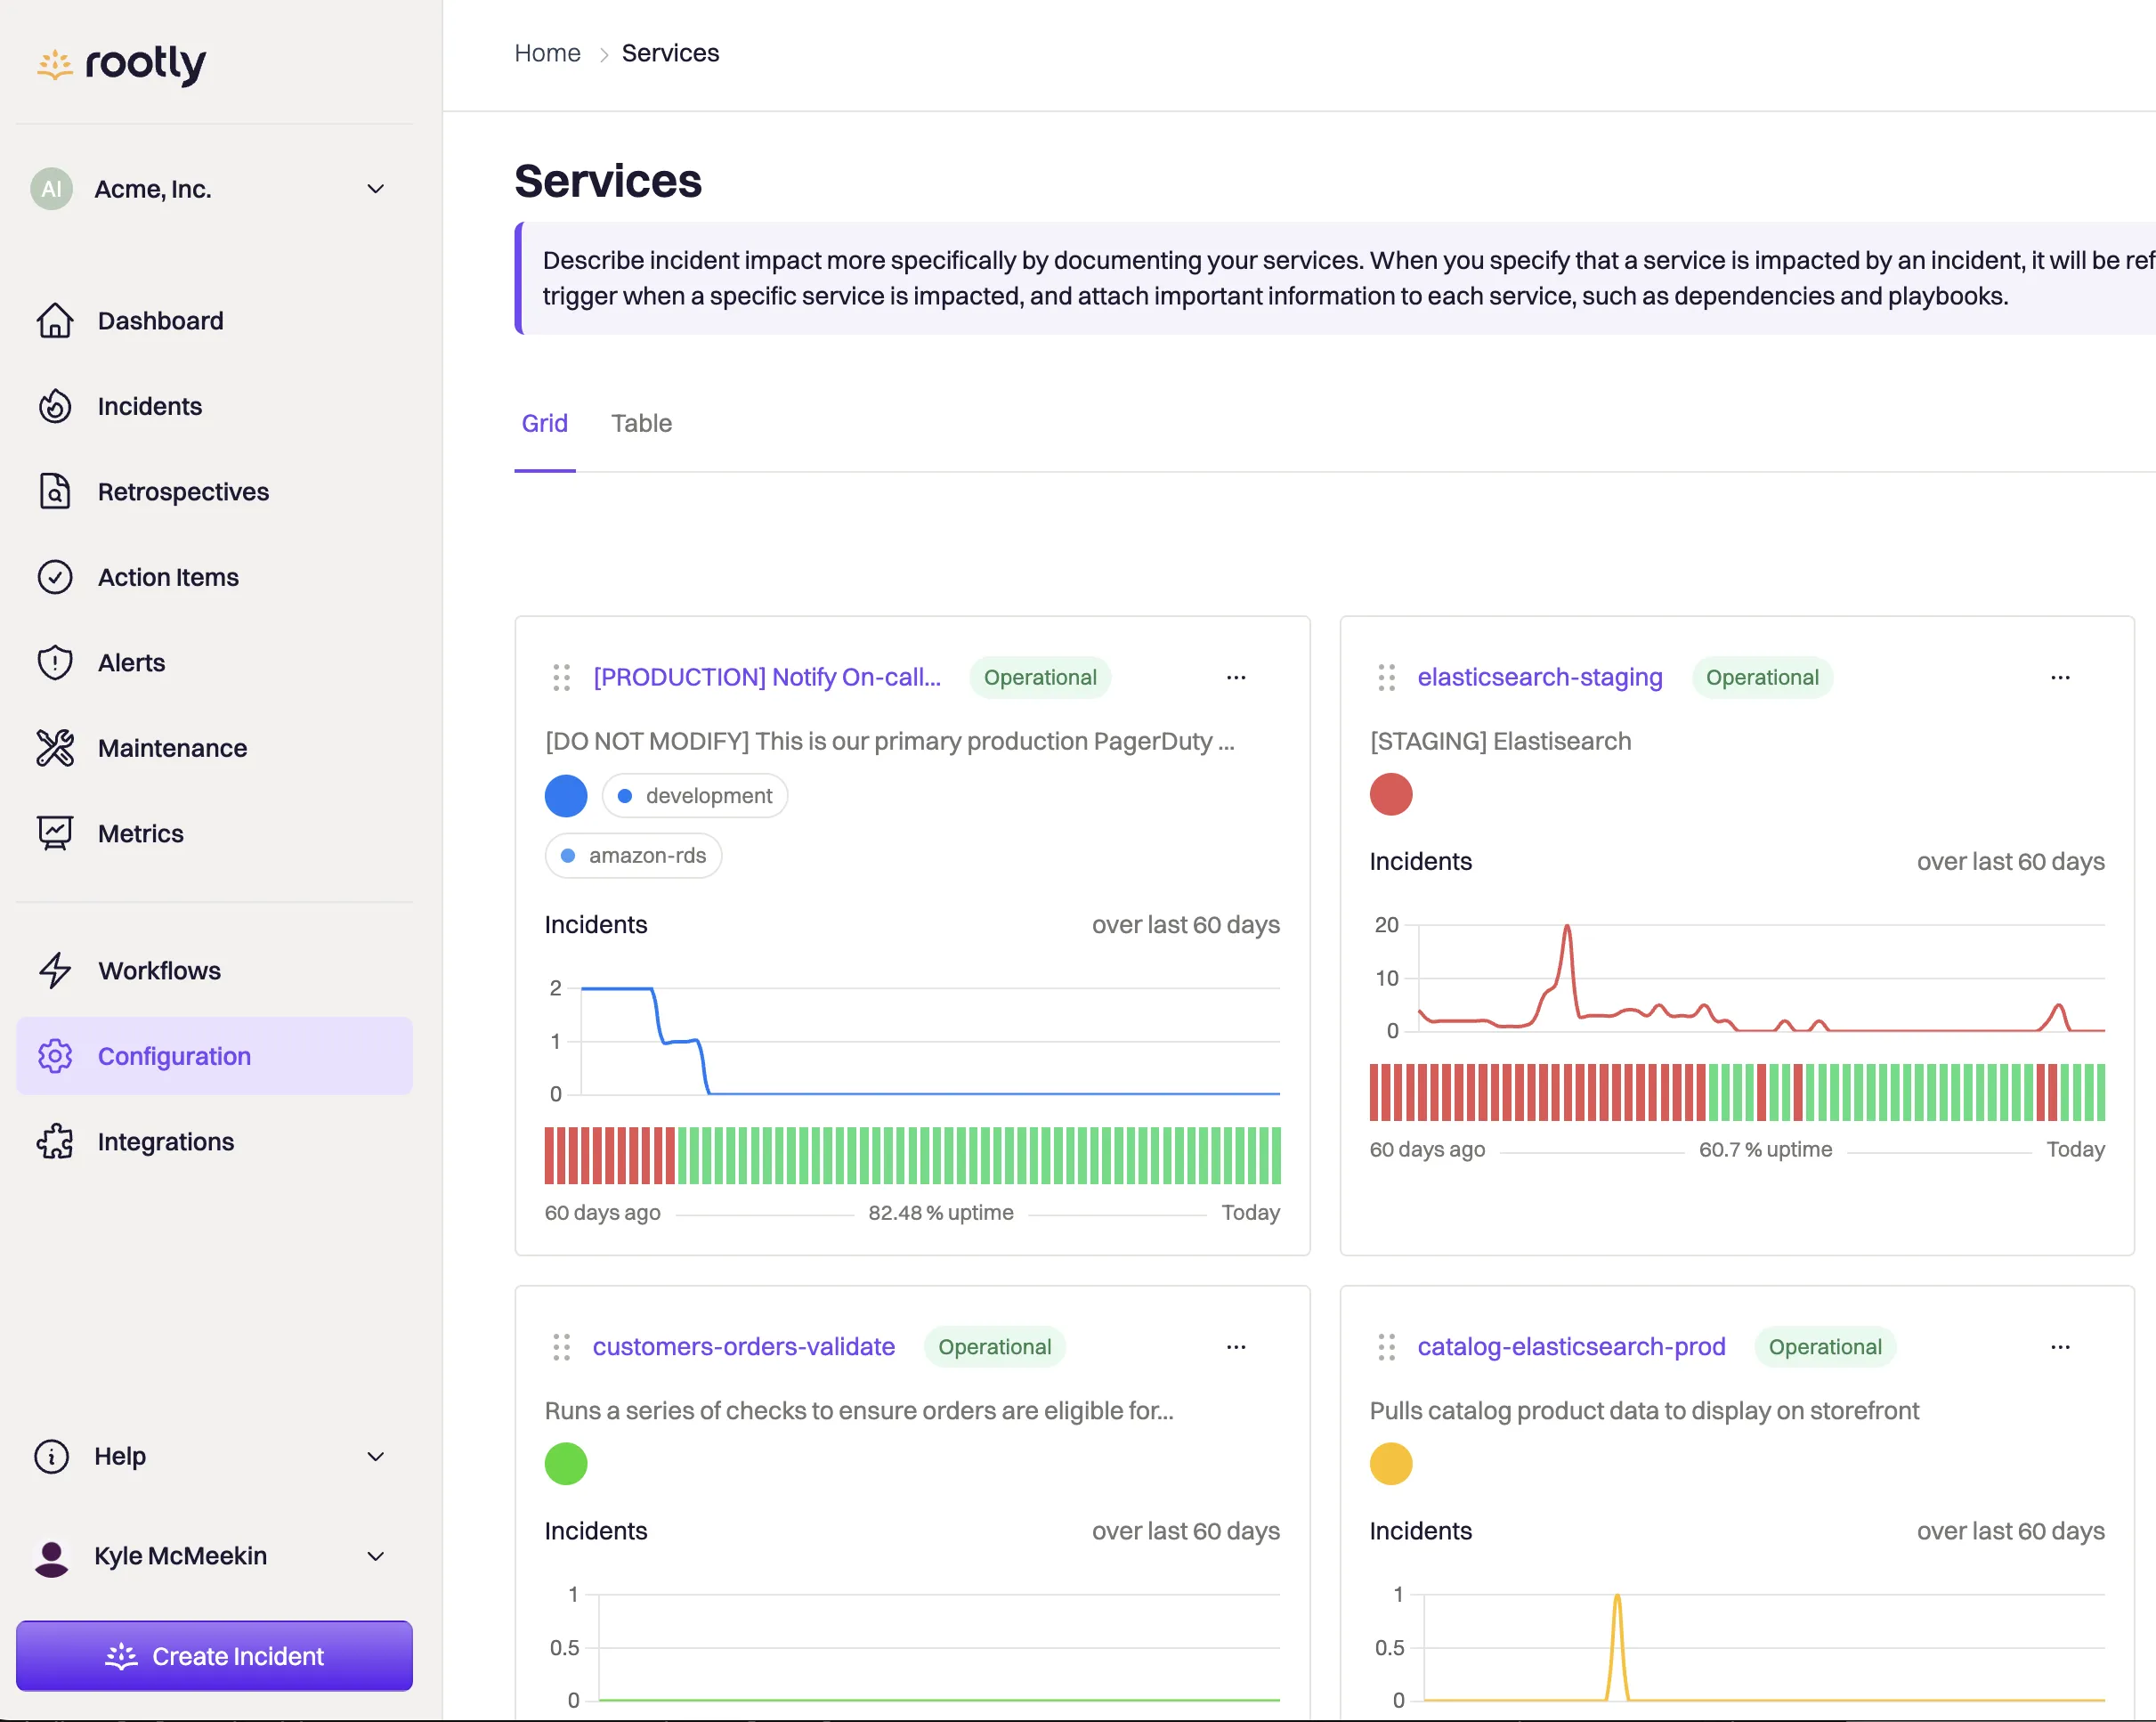
Snelgroeiende engineeringteams in de middenmarkt en enterprise die al standaard op Slack of Microsoft Teams werken en AI-native incidentrespons willen, met diepe automatisering over Jira, GitHub, Zoom en de rest van de dev-stack. De vaakst genoemde rechtstreekse concurrent van incident.io in r/sre-threads.
Opvallende functies
- Workflows native in Slack en Teams. Incidenten uitroepen, beheren en oplossen vanuit de chat, met automatisch aangemaakte kanalen, huddles en transcriptie.
- Workflow-engine voor low-code automatisering. Bouw flows rond incidenten over je hele stack zonder lijmcode te schrijven.
- AI-samenvattingen, voorgestelde responders en hints voor herstel. Vanaf dag één rond AI gebouwd, niet achteraf toegevoegd.
- Volledig piketbeheer. Roosters, escalatiebeleid, overrides en mobiele apps. Verkocht als aparte module per gebruiker in plaats van gebundeld.
- Geautomatiseerde retrospectives met MTTR/MTTA-tracking en toewijzing van vervolgtaken.
- Statuspagina’s, publiek en privé.
- Enterprise-beveiliging. SSO, SCIM, RBAC, auditlogs, SOC 2, AVG, CCPA.
Waarom Rootly kiezen boven incident.io
Diepte van de workflows. Het duidelijkste contrast in de r/sre-thread over Rootly vs incident.io: de low-code workflowbuilder van Rootly reikt verder in Jira, GitHub en de rest van de dev-stack. Teams met complexe voorwaardelijke logica, escalaties over meerdere teams of eigen processen lopen tegen minder muren aan. incident.io is uitgesprokener; Rootly is beter configureerbaar.
Geen frustratie over een tool “ontworpen voor het proces van iemand anders”. Waar reviewers van incident.io klagen over uitgesproken standaardinstellingen die niet bij hun workflow passen, prijzen gebruikers van Rootly juist dat ze hun eigen proces kunnen modelleren.
Klantlogo’s op schaal. Cisco, NVIDIA, Figma, Squarespace en Canva draaien op Rootly. Juist die configuratiediepte trekt grote engineeringorganisaties met gevestigde processen aan.
Waar Rootly tekortschiet
Kosten van configuratie. Dit is de keerzijde van “flexibel”. Een reageerder op r/devops die incident.io boven Rootly verkoos, omschreef het als “massa’s functies, maar er was veel te veel configuratie nodig om het werkend te krijgen voor onze commerce-omgeving.” Teams die best practices kant-en-klaar willen, halen meer uit incident.io.
Kosten per gebruiker stapelen zich op over modules. Incident Response, On-Call en AI SRE hebben elk een eigen prijs per gebruiker. Bij ca. $ 20/gebruiker/mnd per module loopt de volledige stack sneller op dan het gebundelde Pro-abonnement van incident.io.
Minder transparante limieten per niveau. Reviews op G2 merken op dat je voor de exacte limieten op workflows, runbooks en statuspagina’s meestal een salesgesprek nodig hebt.
Ruwe randjes in UI/UX. Sommige gebruikers melden dat pagina’s verversen en dat zoeken in custom fields tijdens incidenten moeizaam gaat. Kleine dingen, maar om 3 uur ’s nachts doen ze ertoe.
Prijzen
- Incident Response Essentials: ca. $ 20/gebruiker/mnd
- On-Call Essentials: ca. $ 20/gebruiker/mnd
- AI SRE / Enterprise: op maat, met bundelkorting als je modules combineert
- Gratis proefperiode van 14 dagen; startupkorting tot ca. 50% voor bedrijven in een vroege fase
Typische jaarlijkse uitgaven: $ 15.000 tot $ 60.000, afhankelijk van teamgrootte en niveau.
Kies Rootly als
Je engineeringteam in Slack of Teams leeft, je een complexe toolchain hebt om omheen te automatiseren, en je AI-native respons wilt met workflows die bij je eigen processen passen in plaats van bij die van iemand anders. Sla het over als je best practices kant-en-klaar wilt (daar past incident.io beter) of als je budget de beperkende factor is.
2. FireHydrant: het beste voor volwassen enterprise-runbooks
Perfect voor
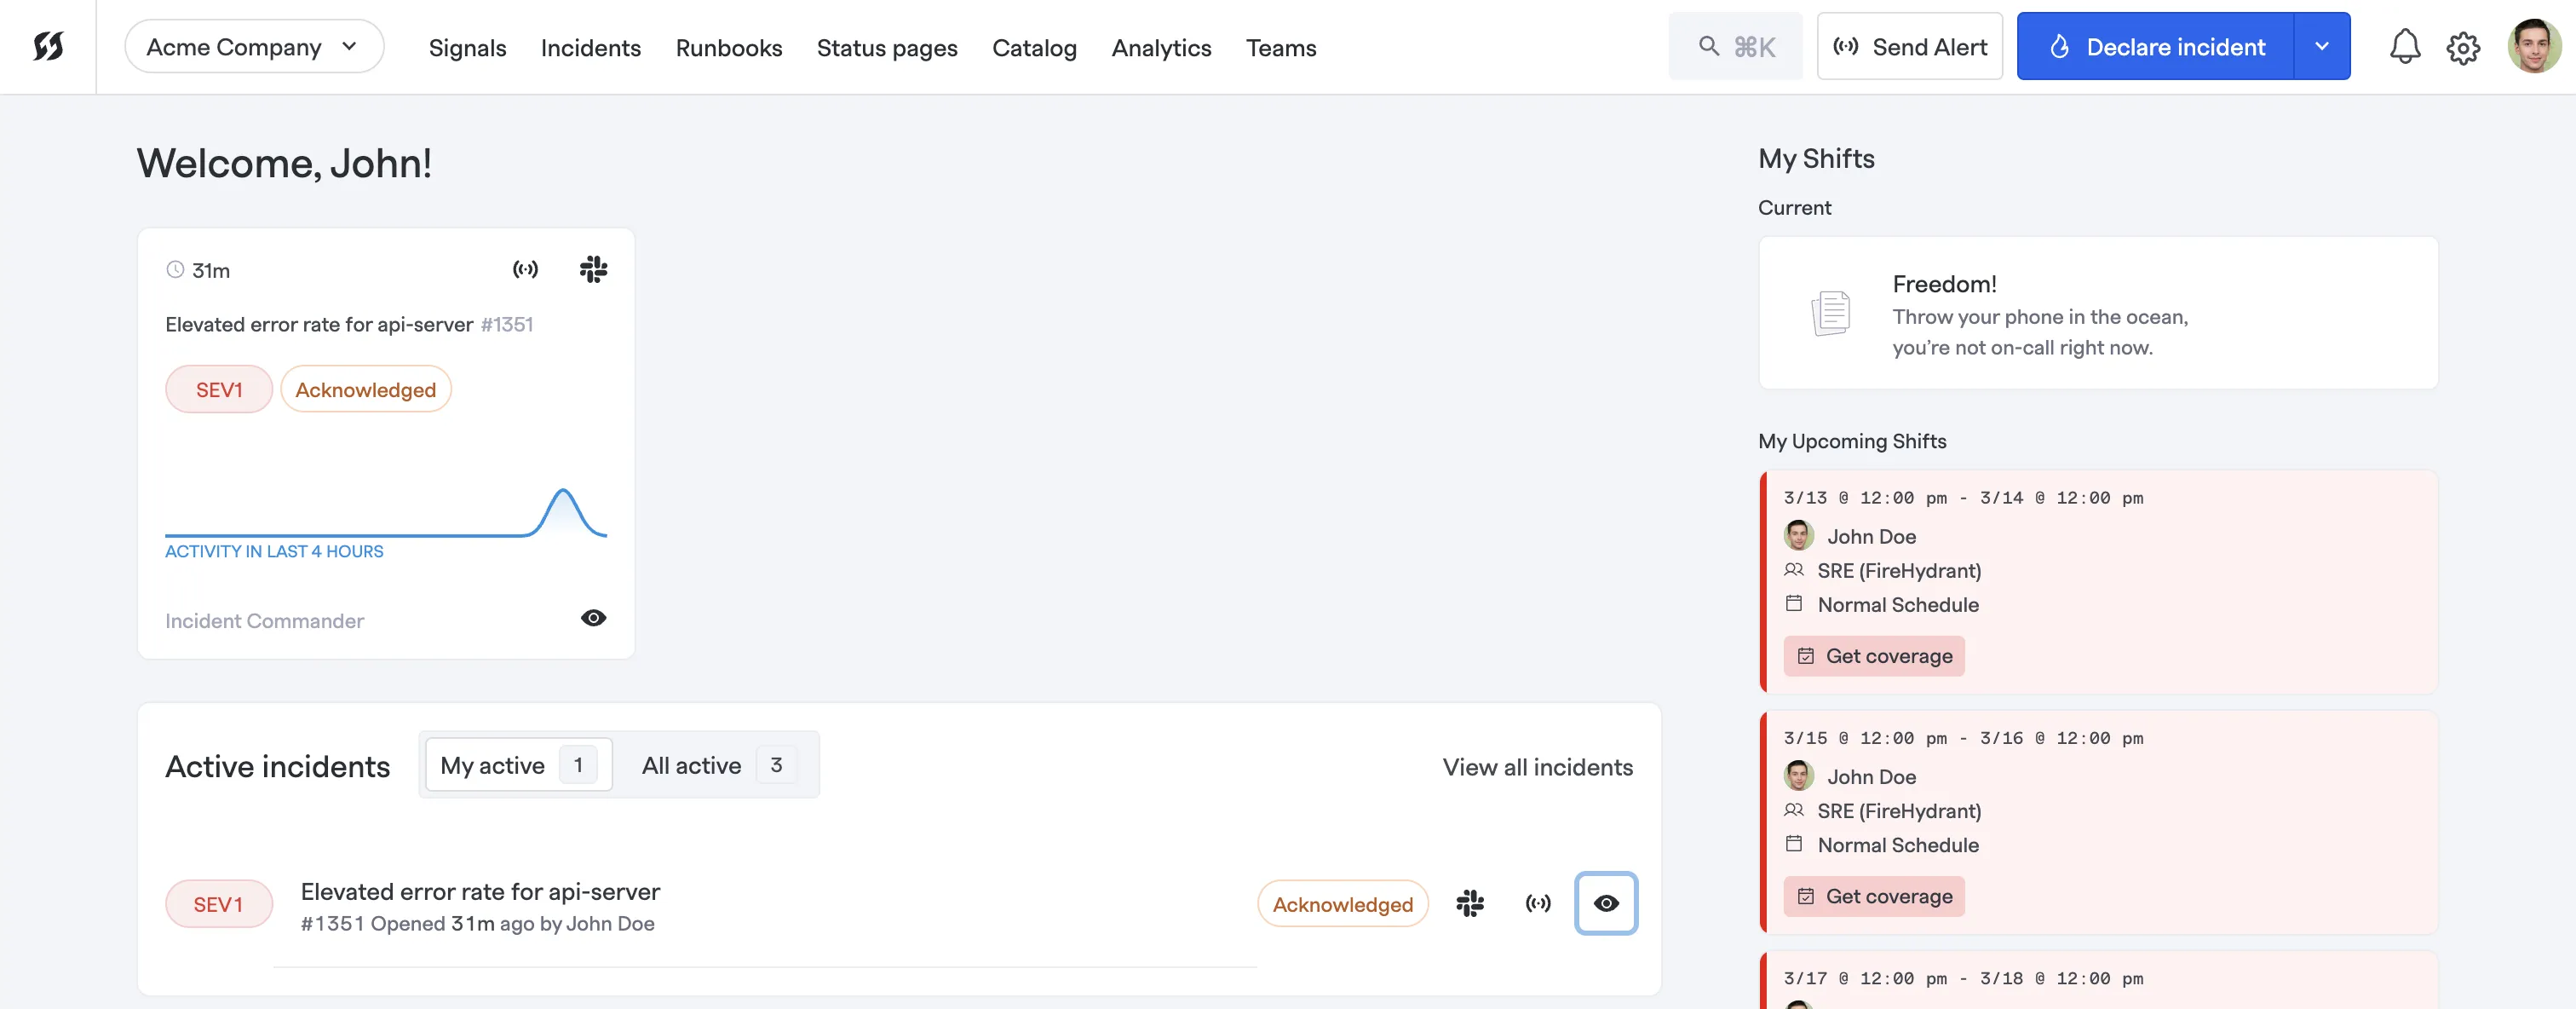
Engineeringteams in de middenmarkt en enterprise die Slack-native respons willen met sterkere runbooks en een sterkere servicecatalogus dan incident.io biedt. De derde naam die steevast opduikt naast incident.io en Rootly in r/sre-threads waarin tools worden geëvalueerd.
Opvallende functies
- Levenscyclus native in Slack en Teams met automatisch aangemaakte kanalen, toewijzing van rollen en een gestructureerde respons.
- Sterke runbook-engine. FireHydrant investeert flink in vastgelegde, herhaalbare runbooks die naast de menselijke responders worden uitgevoerd.
- Gestructureerde analyse na een incident. Sjablonen, standaardinstellingen in een blameless cultuur en opvolging van acties met verantwoordelijken en deadlines.
- Servicecatalogus. Breng services, eigenaren en afhankelijkheden in kaart. Incidenten erven de catalogus automatisch.
- AI-functies in Enterprise. FireHydrant AI (samenvattingen, transcripties, triage, retro’s) zit in het Enterprise-abonnement in plaats van in een aparte module.
- Statuspagina’s. Publiek en privé, met communicatie naar stakeholders ingebouwd in de responseflow.
Waarom FireHydrant kiezen boven incident.io
Runbooks als volwaardige objecten. incident.io heeft runbooks, maar FireHydrant gaat daarin verder. Teams met volwassen, gedocumenteerde playbooks zetten die hier soepeler over.
De servicecatalogus als middelpunt. De servicecatalogus van FireHydrant koppelt incidenten standaard aan services en eigenaren. incident.io ondersteunt dit ook, maar bij FireHydrant staat het model centraler in het product.
Transparantere prijsopbouw voor AI. Waar incident.io AI-functies in de hogere niveaus toevoegt en piketdienst als aparte add-on verkoopt, bundelt FireHydrant zijn AI in het Enterprise-abonnement.
Waar FireHydrant tekortschiet
AI en privé-statuspagina’s alleen in Enterprise. Pro kost $ 25/responder/mnd bij jaarlijkse betaling; teams die FireHydrant AI willen, komen uit bij Enterprise met een prijs op maat.
Minder marketingzichtbaarheid dan incident.io en Rootly. Inkoopgesprekken kunnen langer duren.
Jaarcontracten zijn gebruikelijk. De publieke prijzen staan per maand, maar echte deals gaan vaak gepaard met een jaarlijkse verplichting.
Minder uitgesproken dan incident.io. Teams die juist de slimme standaardinstellingen van incident.io wilden, zullen FireHydrant een halve stap configuratie-intensiever vinden.
Prijzen
- Free: tot 10 responders, publieke statuspagina’s, basis-incidentbeheer
- Pro: $ 25/responder/mnd bij jaarlijkse betaling, piketdienst (Signals), publieke statuspagina’s, SSO
- Enterprise: prijs op maat, FireHydrant AI, privé-statuspagina’s
Kies FireHydrant als
Je een volwassen platform voor incidentrespons wilt dat rond runbooks draait, met een servicecatalogus als middelpunt en AI gebundeld in plaats van apart geprijsd. Sla het over als budget de beperkende factor is, of als juist de uitgesproken standaardinstellingen van incident.io je in eerste instantie naar deze categorie trokken.
3. Hyperping: het beste als je knelpunt bij detectie, piketdienst en statuspagina’s ligt
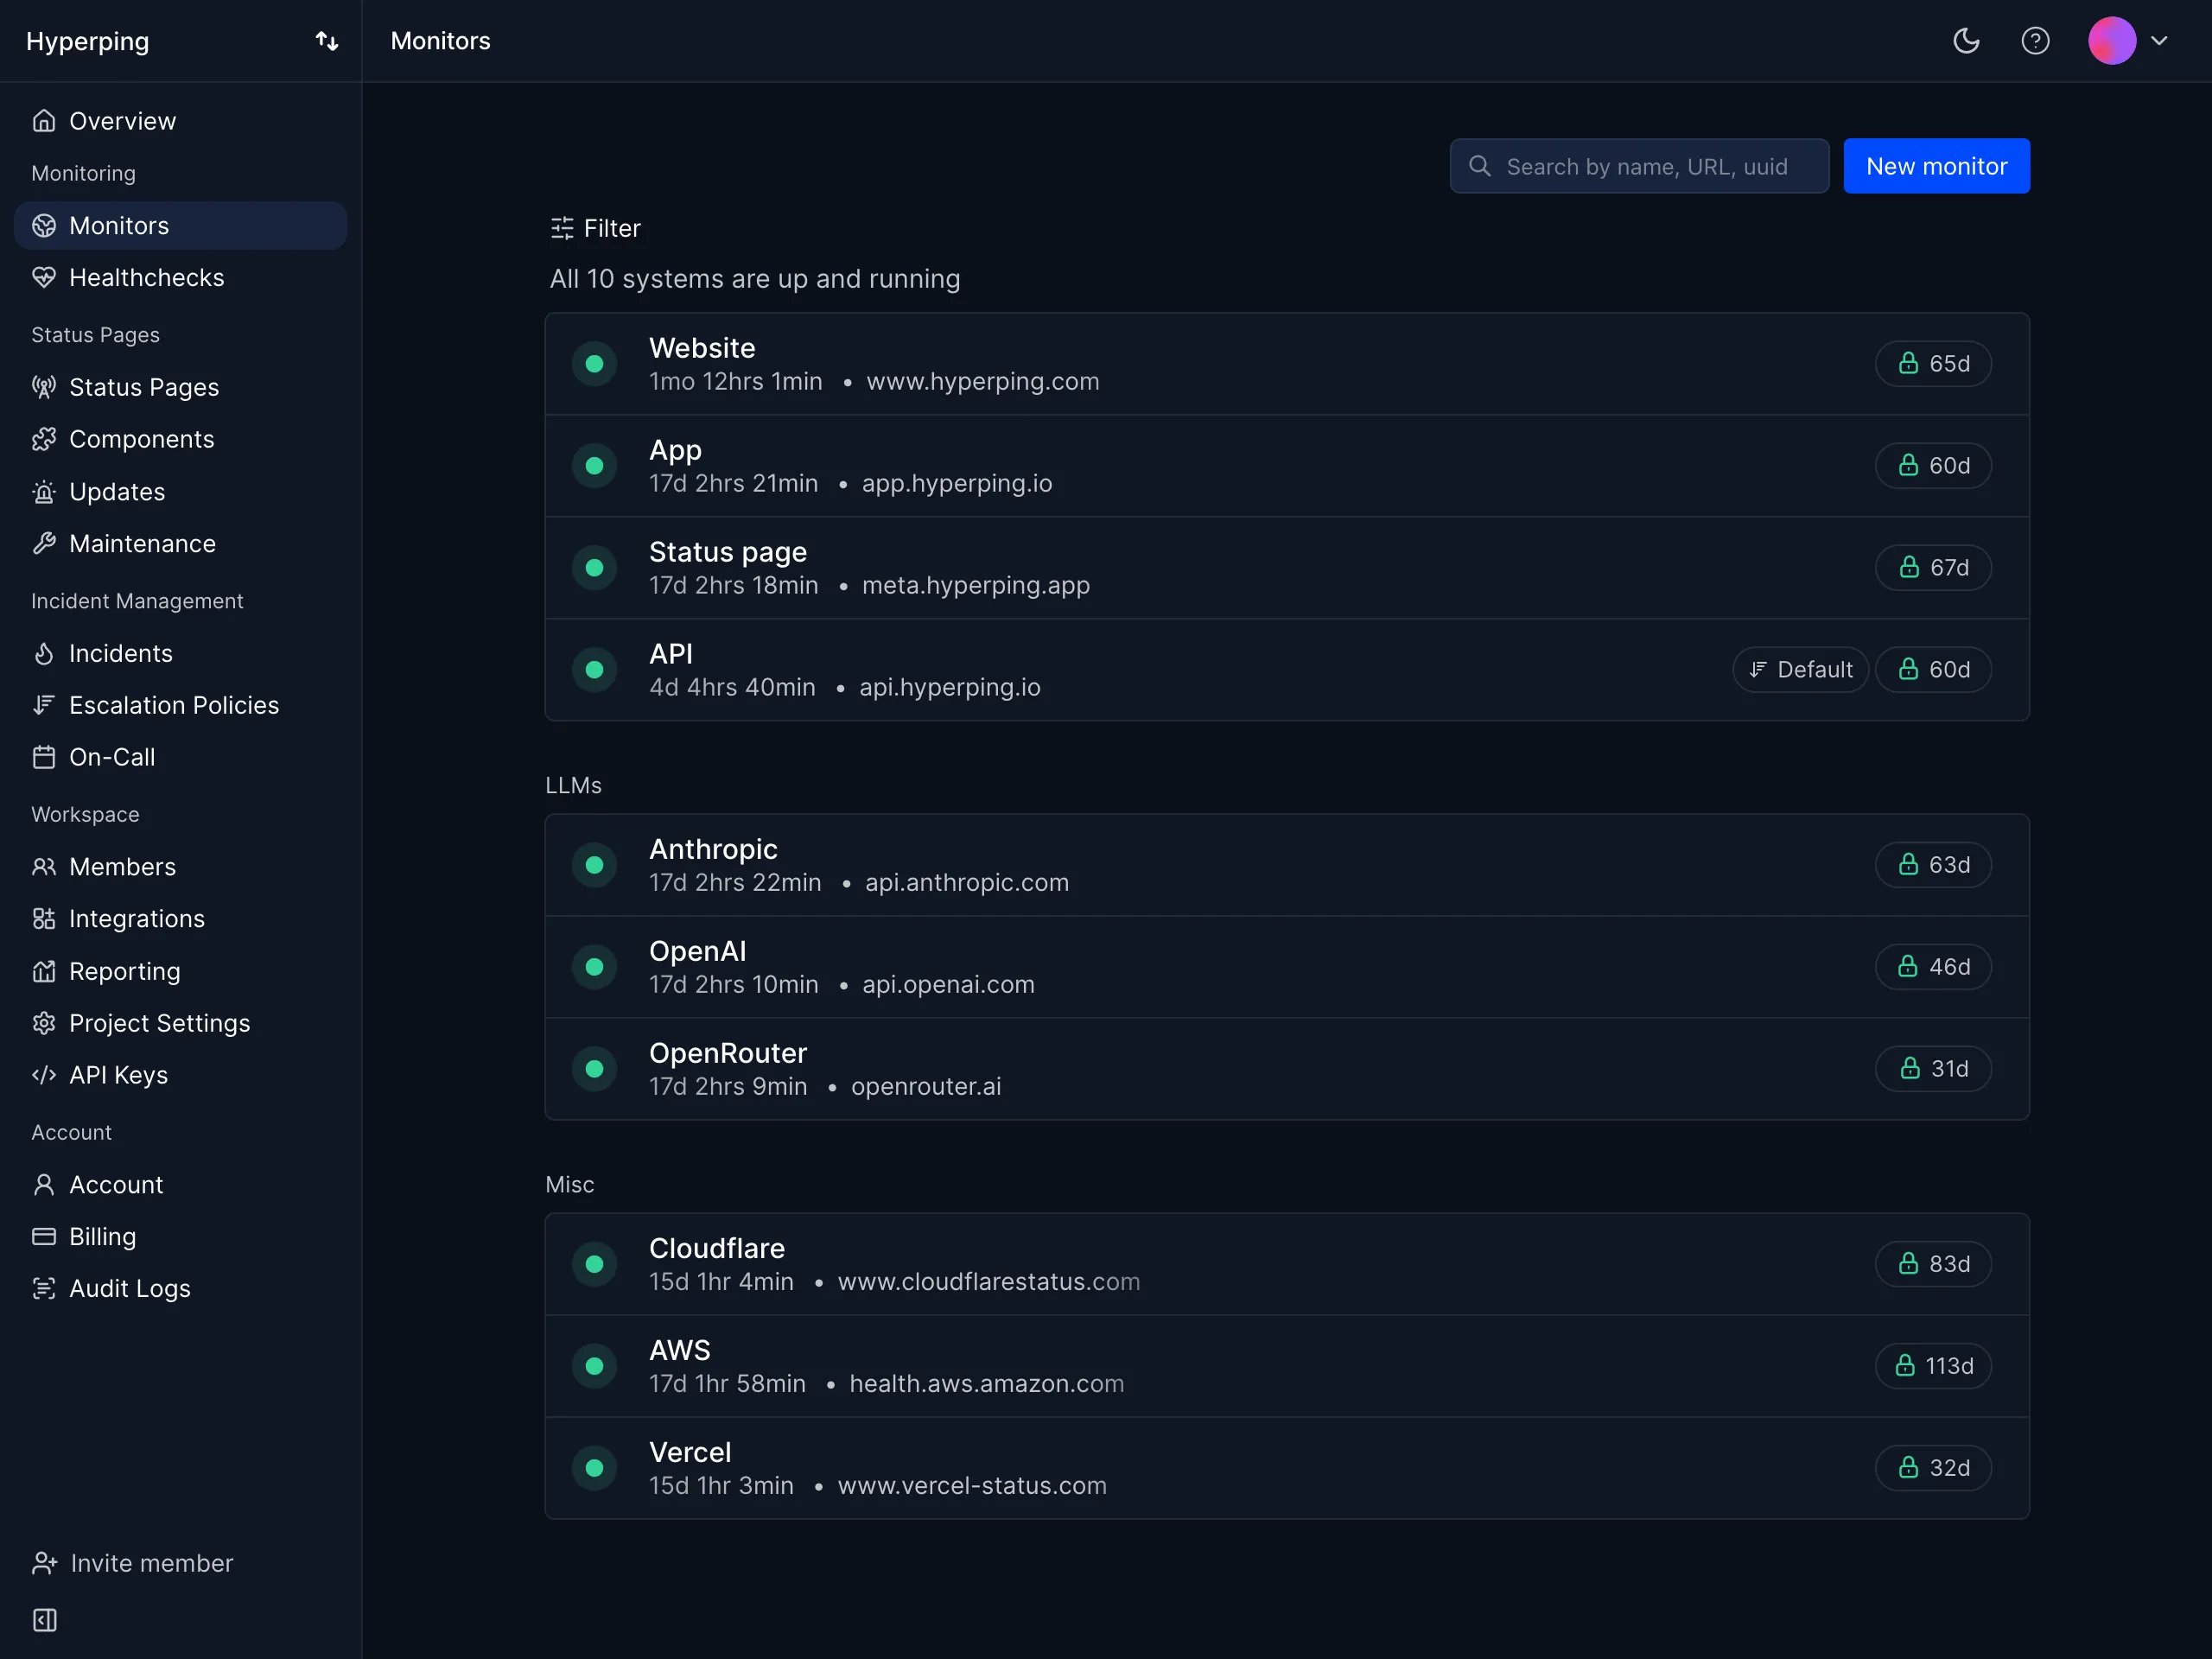
Perfect voor
Startups, mkb-bedrijven en groeiende SaaS-teams die uptime-monitoring, piketplanning, escalatiebeleid en verzorgde statuspagina’s in één tool willen, zonder rekeningen per gebruiker die bij elke nieuwe collega groeien. Vaak het juiste antwoord als teams die incident.io evalueren beseffen dat ze helemaal geen probleem met chat-native coördinatie hebben.
Opvallende functies
- Externe monitoring vanuit 18 regio’s wereldwijd. Zie problemen vanuit het perspectief van je klanten, niet alleen van binnen je VPC.
- Piketplanning en escalatiebeleid. Roosters die rekening houden met tijdzones, automatische overdrachten, escalatie in meerdere stappen. Inbegrepen in elk betaald abonnement, niet verkocht als aparte module.
- Automatisch opnieuw controleren vóór een melding. Bevestigt storingen vanuit meerdere regio’s voordat iemand wordt gewekt, wat het aantal valse meldingen flink verlaagt.
- Meldingen via meerdere kanalen. Slack, Teams, Discord, Telegram, PagerDuty, OpsGenie, sms, telefoonoproepen, webhooks.
- Statuspagina’s in je eigen huisstijl inbegrepen. Publieke en privépagina’s, eigen domeinen, white-label branding, SSO-beveiliging, meertalig. 3 pagina’s op Pro, 10 op Business, zonder kosten per pagina binnen die limieten.
- Synthetische monitoring met Playwright. End-to-end browserchecks voor inloggen, afrekenen en andere kritieke gebruikersflows.
- Agent voor servermonitoring. Lichtgewicht agent voor Linux en macOS voor CPU-, geheugen-, schijf- en netwerkmetrics, gebouwd op OpenTelemetry.
- Hosting in de EU. AVG-conform, alle gegevens opgeslagen in datacenters in de EU.
Waarom Hyperping kiezen boven incident.io
Ander probleem, andere tool. incident.io is een coördinatieplatform. Hyperping doet detectie, oproepen en communicatie met klanten. Veel teams die incident.io evalueren, zijn eigenlijk op zoek naar dat laatste en hebben het eerste niet nodig. Een team van 20 mensen draait zelden genoeg incidenten om een chat-native orchestrator voor respons te rechtvaardigen.
Voorspelbare vaste prijs, geen minimumbedragen zoals bij een Pro-abonnement. Een team van 20 mensen op Hyperping Pro kost $ 179 per maand, of ongeveer $ 149,17 per maand bij jaarlijkse betaling, inclusief 10 extra seats bovenop de 10 inbegrepen seats. Hetzelfde team op incident.io Team met piketdienst zit rond de $ 500 per maand. Geen enkel niveau van incident.io bevat monitoring of statuspagina’s in hetzelfde abonnement, dus die koop je er nog apart bij.
Drie tools in één. Monitoring, piketdienst en statuspagina’s zitten in elk betaald abonnement. Dat vervangt UptimeRobot + Statuspage.io + een tool voor oproepen (voor een klein team samen al snel $ 200+).
Tien seats inbegrepen op Pro. Het negende en tiende teamlid passen binnen het basisabonnement. Extra seats kosten € 9 per maand of € 90 per jaar per seat.
Waar Hyperping tekortschiet
Hyperping is geen Slack-native platform voor incidentrespons. Je krijgt geen rijke incidentkanalen met toewijzing van rollen, door AI gegenereerde postmortems of automatisch vastgelegde tijdlijnen. Voor teams met 20+ incidenten per maand die de volledige ervaring van incident.io of Rootly willen, dekt Hyperping detectie en piketdienst, maar stopt het voordat de respons zelf georkestreerd wordt.
Er is ook geen geïntegreerde APM of distributed tracing. Voor interne observability combineer je Hyperping met Datadog, New Relic of Prometheus.
Wat gebruikers zeggen
“Binnen ons bedrijf staat Hyperping erom bekend dat het sneller reageert dan Datadog. Meestal krijgen we de meldingen van Hyperping eerder dan die van Datadog. Het is handig als vangnet, een lichtere back-up voor monitoring.”
“We hebben onze statuspagina van Hyperping openbaar gemaakt en die werd een cruciaal onderdeel van onze salespitches. We zijn trots op onze uptime en vinden het geweldig dat we die met prospects kunnen delen.”
Prijzen
- Free: 1 seat, 20 monitors, 1 serveragent, 1 basis-statuspagina
- Essentials: € 24 per maand voor 50 monitors, 1 statuspagina, 3 browserchecks, 3 seats
- Pro: € 74 per maand bij jaarlijkse betaling voor 250 monitors, 3 publieke of privé-statuspagina’s, 10 browserchecks, meldingen via telefoonoproep, 10 seats. Inclusief toegangscodes per e-mail, meertalige pagina’s en native SAML SSO voor je account.
- Business: € 249 per maand bij jaarlijkse betaling voor 1.000 monitors, 10 statuspagina’s, controles onder de 30 seconden, 25 browserchecks, 20 seats
Alle betaalde abonnementen bevatten piketplanning en escalatiebeleid.
Kies Hyperping als
Je beseft dat je eigenlijk monitoring, piketdienst en een statuspagina nodig hebt, en geen chat-native orchestrator voor respons. Vooral sterk voor teams onder de 30 die genoeg hebben van facturatie per gebruiker, Europese bedrijven die AVG-compliance en hosting in de EU nodig hebben, en SRE-teams die naast Datadog een onafhankelijk vangnet willen (zie de case study van Alma).
4. PagerDuty: het beste voor diepgaande enterprise-alerting
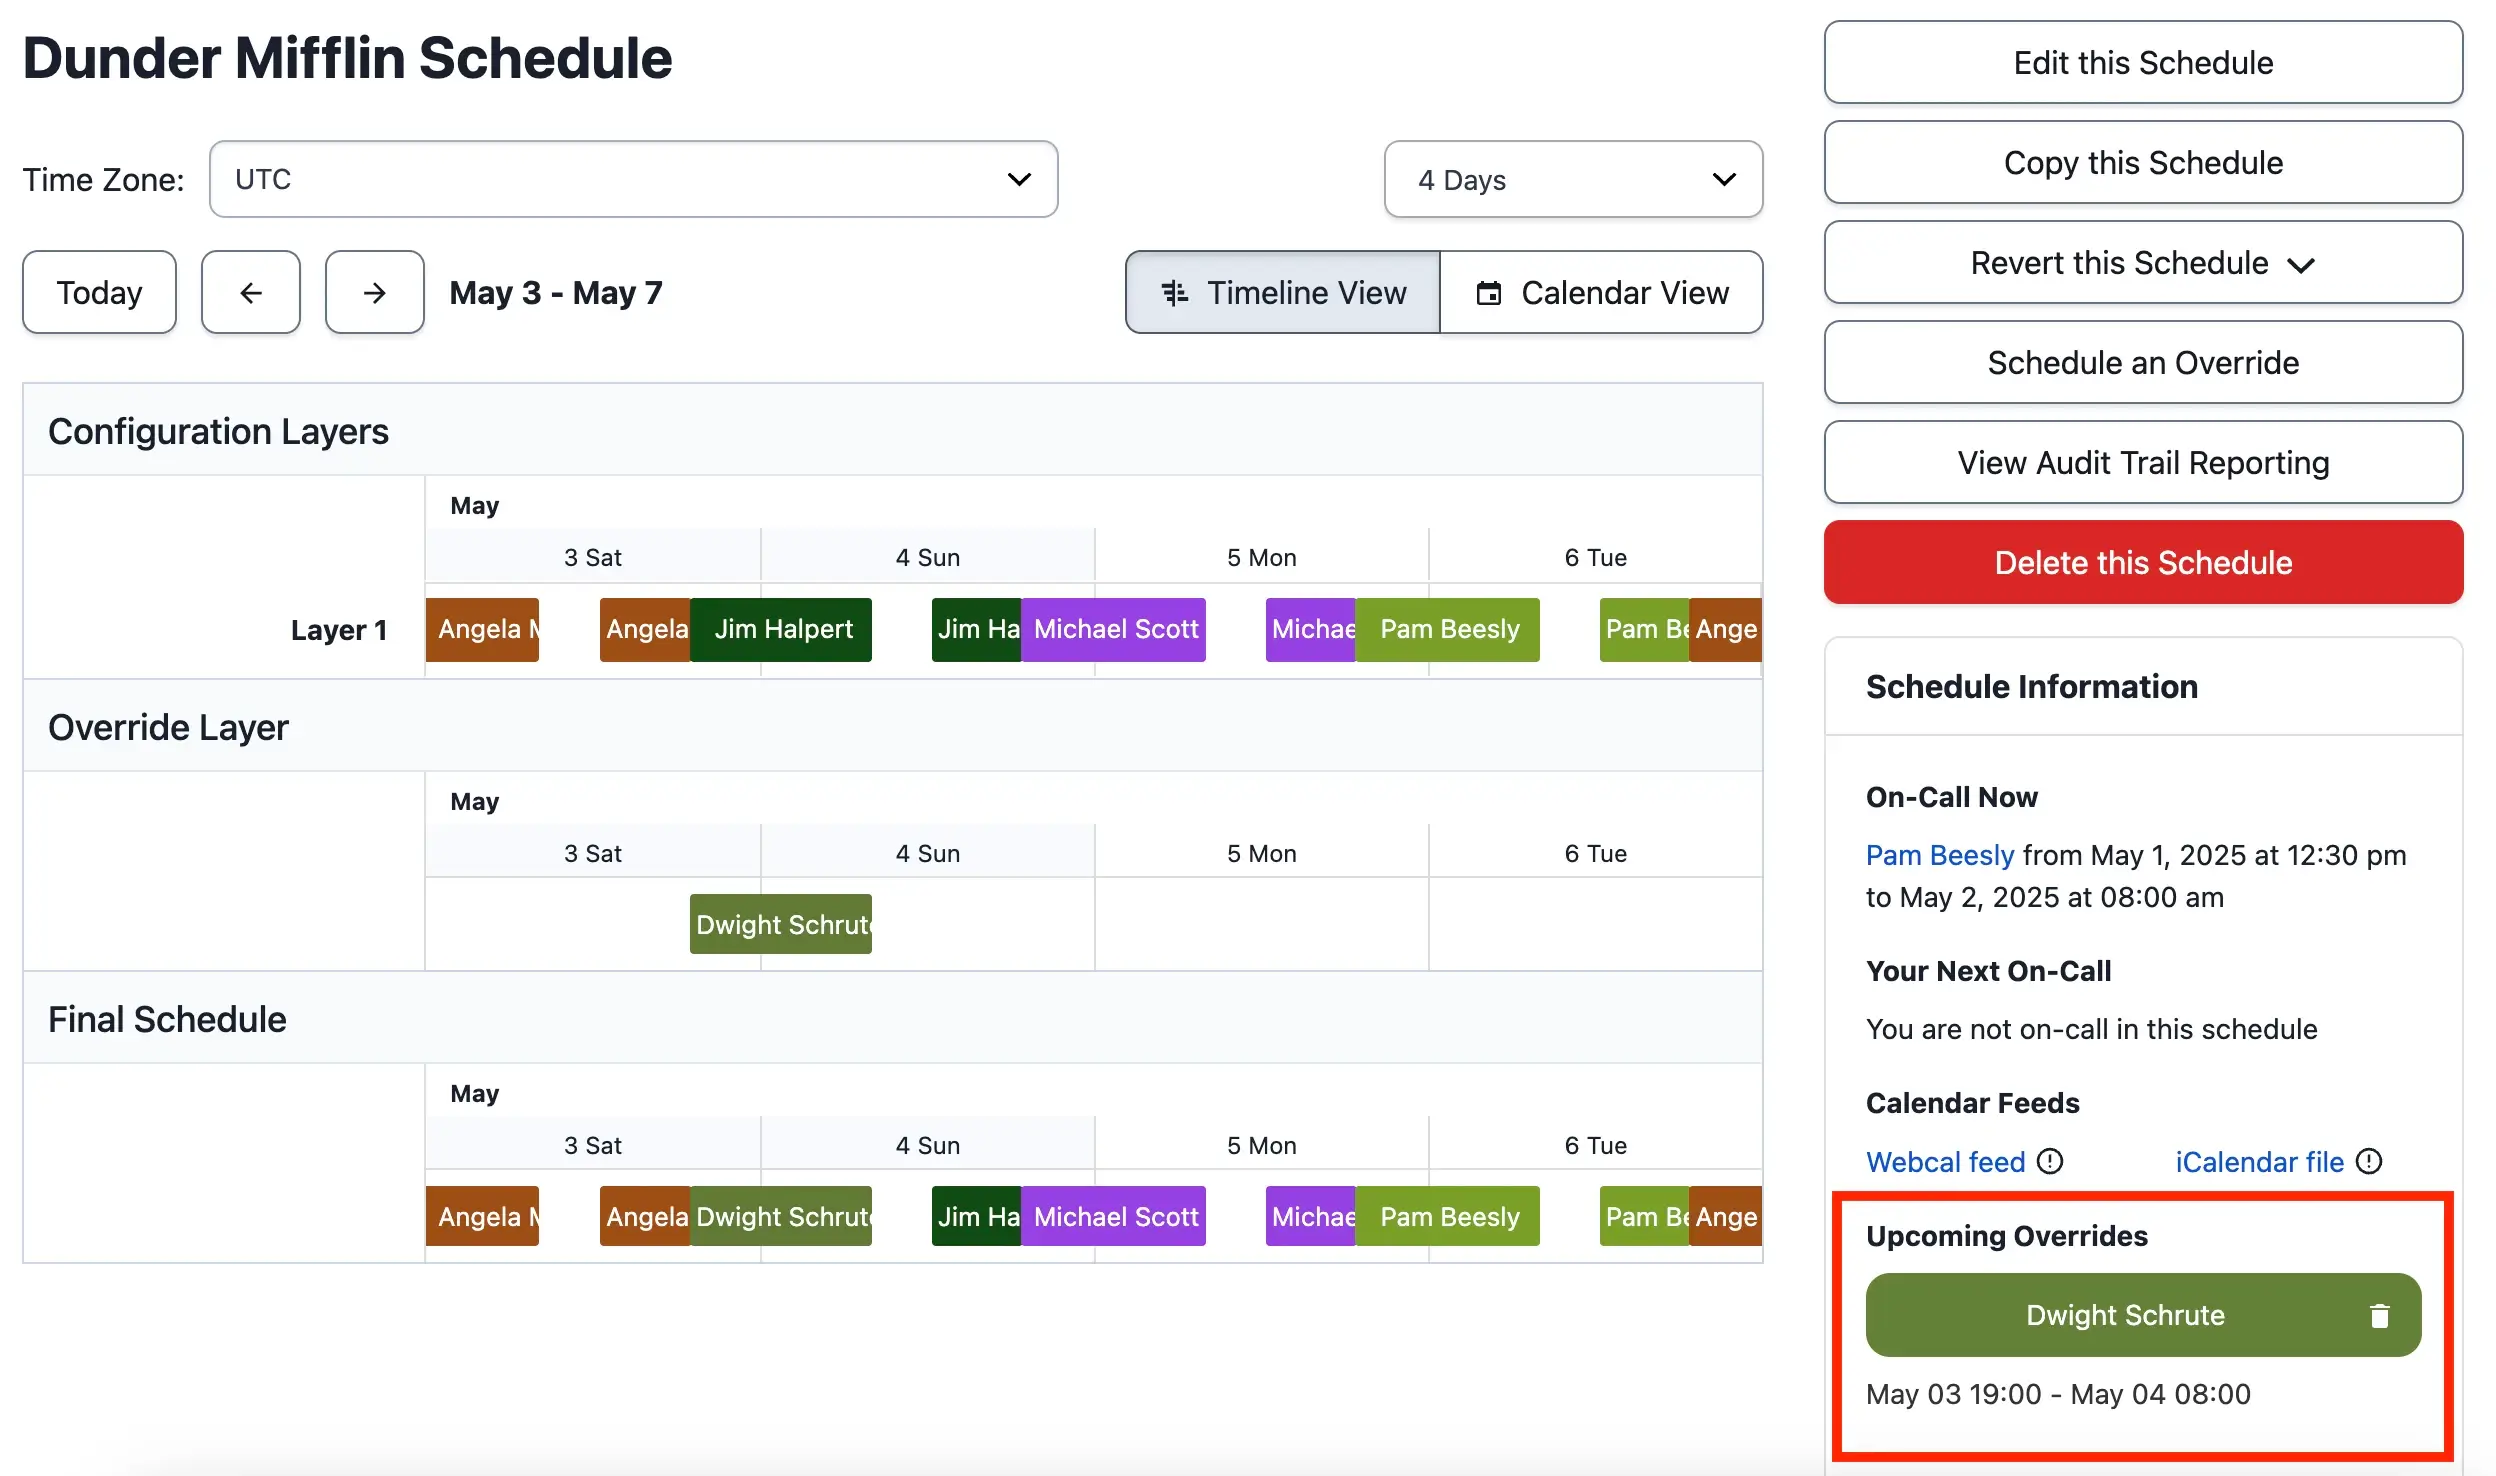
Perfect voor
Grote ondernemingen met complexe piketroosters, zware eisen aan ITSM-integratie (ServiceNow, Jira) en het budget om prijzen per gebruiker plus AIOps-add-ons op te vangen. De standaard terugvaloptie als het uitgesproken chat-native model van incident.io niet past.
Opvallende functies
- Volwassen engine voor alerting en routering. Event Orchestration kan complexe voorwaardelijke logica aan waar nieuwere tools nog niet aan tippen.
- 700+ integraties. De grootste catalogus van alle tools in deze lijst, inclusief oudere enterprise-systemen.
- AIOps-add-ons. Ruisonderdrukking, groeperen van alerts, geautomatiseerde incidentworkflows.
- Betrouwbare mobiele oproepen. Meerdere r/devops-threads noemen de mobiele app van PagerDuty de gouden standaard om mensen om 3 uur ’s nachts betrouwbaar wakker te krijgen.
- Multi-cloud-architectuur. PagerDuty heeft flink geïnvesteerd om niet plat te gaan wanneer AWS of Azure dat doet.
Waarom PagerDuty kiezen boven incident.io
Diepgang in alerting en routering. Heb je follow-the-sun-roosters over vijf regio’s, escalatiebeleid met 20 regels en een ServiceNow-integratie die in beide richtingen moet werken, dan is de plannings- en routeringsengine van PagerDuty nog altijd krachtiger dan de piket-add-on van incident.io. incident.io draait eerst om respons; PagerDuty draait eerst om oproepen.
Comfort bij inkoop. “Niemand is ooit ontslagen omdat hij PagerDuty kocht” klopt echt. In grote, behoudende organisaties komt PagerDuty sneller door de inkoop dan welk modern alternatief ook.
Integratiecatalogus. 700+ integraties, inclusief oudere enterprise-systemen waar de catalogus van incident.io niet bij komt.
Voor de volledige vergelijking, zie PagerDuty vs incident.io.
Waar PagerDuty tekortschiet
Kosten. $ 21/gebruiker/mnd op Professional, daarna een PD Reliability Platform-fee die per jaar vooraf wordt gefactureerd voor AIOps en Automation, van $ 2.800 voor 10 seats tot $ 48.000 voor 50. Voor een engineeringorganisatie van 50 mensen kom je uit op $ 12.600 per jaar op Professional, of $ 48.000 per jaar op het Plus-niveau van het platform.
Coördinatie rond de webapp. PagerDuty stuurt meldingen naar Slack, maar het incident zelf leeft in hun webinterface. Teams die chat-native respons willen, melden consequent een betere adoptie met incident.io.
Gaten in API en webhooks. Gebruikers op het forum wijzen keer op keer op ontbrekende velden (beschrijving verwijderd uit webhooks, notities over de oplossing niet beschikbaar) en N+1-API-calls voor custom fields van services.
Achteruitgang in de mobiele app. Recente updates voegden een extra bevestigingstik toe aan swipe-to-resolve, waar engineers met piketdienst regelmatig over klagen.
Standaardinstellingen voor privacy. De Slack-integratie van PagerDuty zet “Chat message ingestion” en “Private channel ingestion” standaard aan. Het loont om dat tijdens de setup na te lopen.
Prijzen
- Professional: $ 21/gebruiker/mnd (jaarlijks)
- PD Reliability Platform, per jaar vooraf gefactureerd: Starter $ 2.800 (10 seats), Essential $ 12.000 (20 seats), Plus $ 48.000 (50 seats), Ultimate op maat (500 seats)
- AIOps en Automation zitten in de platformtiers; extra seats komen uit creditpakketten
- Gratis abonnement beperkt tot 5 gebruikers, 1 rooster, 1 escalatiebeleid en 100 sms-/telefoonmeldingen per maand
Kies PagerDuty als
Je 200+ engineers hebt, complexe planning over meerdere regio’s draait, diepe ITSM-integraties nodig hebt en prijzen per gebruiker niet het knelpunt zijn. Sla het over als je onder de 50 mensen zit (de rekensom per gebruiker gaat dan niet op) of als je een chat-native ervaring wilt.
5. Squadcast: het beste voor DevOps-teams met een krap budget
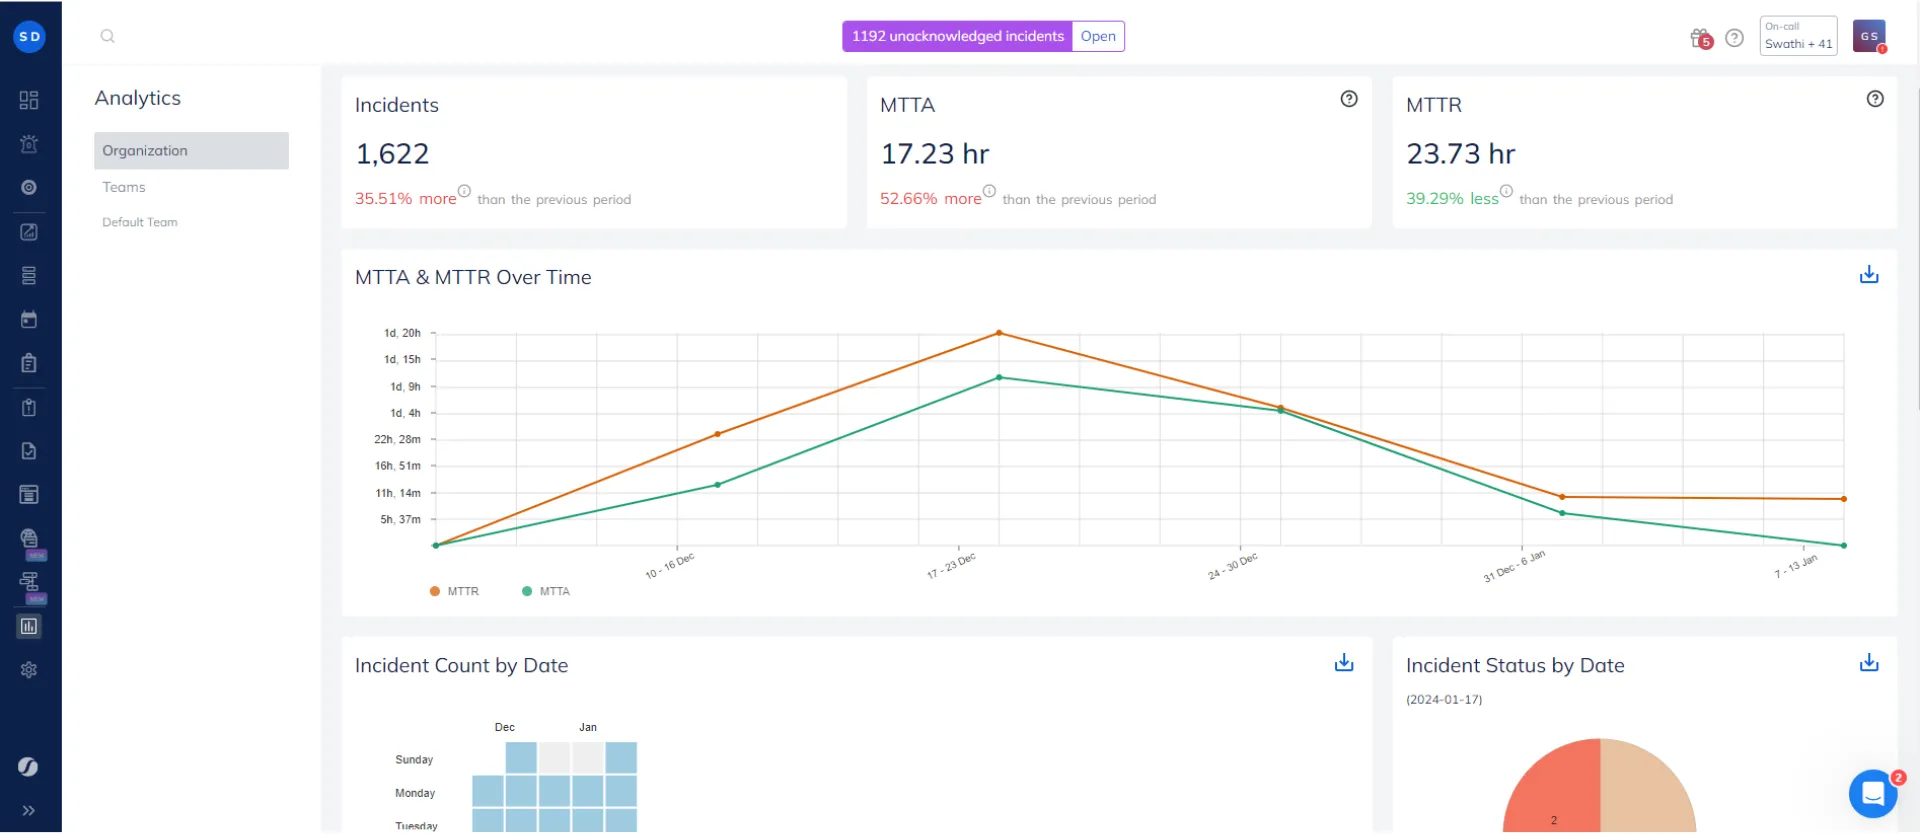
Perfect voor
Kleine tot middelgrote DevOps- en SRE-teams die degelijke piketplanning, routering van alerts en basis-incidentbeheer nodig hebben tegen de laagste geloofwaardige prijs per gebruiker. Het juiste antwoord als incident.io conceptueel overkill is.
Opvallende functies
- Piketplanning met roosters, overrides en routering op basis van tijd
- Escalatiebeleid met deduplicatie en ruisonderdrukking
- SRE-workflows, inclusief SLO/SLA-tracking, error budgets en automatisering van betrouwbaarheid
- 175+ integraties met Datadog, Prometheus, Grafana, Jira, Slack, Teams
- Statuspagina’s inbegrepen
- Gratis abonnement tot 5 gebruikers met e-mail/push en 100 gratis sms-/spraakmeldingen voor het hele account
Waarom Squadcast kiezen boven incident.io
Het goedkoopste geloofwaardige alternatief. Pro voor $ 15/gebruiker/mnd (bij jaarlijkse betaling) is ongeveer 40% goedkoper dan de effectieve kosten per gebruiker van incident.io zodra de piket-add-on meetelt. Voor een team van 20 mensen is dat $ 3.600 per jaar tegenover $ 6.000+ per jaar.
Snelle setup. Meerdere reviewers op G2 melden dat ze binnen uren aan de slag waren, niet dagen.
SRE-praktijken ingebouwd. SLO’s, error budgets en tracking van betrouwbaarheid zitten in het product zelf, in plaats van dat je ze met eigen dashboards moet aanvullen.
Waar Squadcast tekortschiet
Minder Slack-native dan incident.io of Rootly. Squadcast is in de eerste plaats een tool voor oproepen en piketdienst, met incidentrespons daarbovenop. De chat-native levenscyclus is minder diep.
Minder enterprise-functies. AI-postmortems en een afwerking van workflows op het niveau van incident.io haalt het niet.
Onzekerheid na de overname. SolarWinds kocht Squadcast en gaf het een nieuwe naam. Teams op r/devops raden gezonde voorzichtigheid aan over de helderheid van de roadmap op lange termijn.
Naamsbekendheid bij inkoop. “We hebben voor Squadcast gekozen” vraagt bij enterprise-inkoop een langer gesprek dan “we hebben voor incident.io gekozen”.
Prijzen
- Trial: 14 dagen, met een limiet van 100 telefoon- en sms-meldingen (geen gratis abonnement meer)
- Pro: $ 15/gebruiker/mnd (jaarlijks), piketdienst, escalaties, sms/spraak, ruisonderdrukking
- Premium: $ 24/gebruiker/mnd (jaarlijks), voegt statuspagina’s, runbooks, workflows en SLO-tracking toe
- Enterprise: op maat, met AI-samenvattingen, bidirectionele synchronisatie met ServiceNow, SSO
Kies Squadcast als
Budget de belangrijkste beperking is, je planningsbehoeften eenvoudig zijn en je een tool wilt die de kern van 80% van de piketlaag van incident.io doet voor een fractie van de prijs. Sla het over als je diepe AI-native respons of een volledige chat-native levenscyclus nodig hebt.
6. Better Stack: het beste voor monitoring, logs en incidenten op één plek
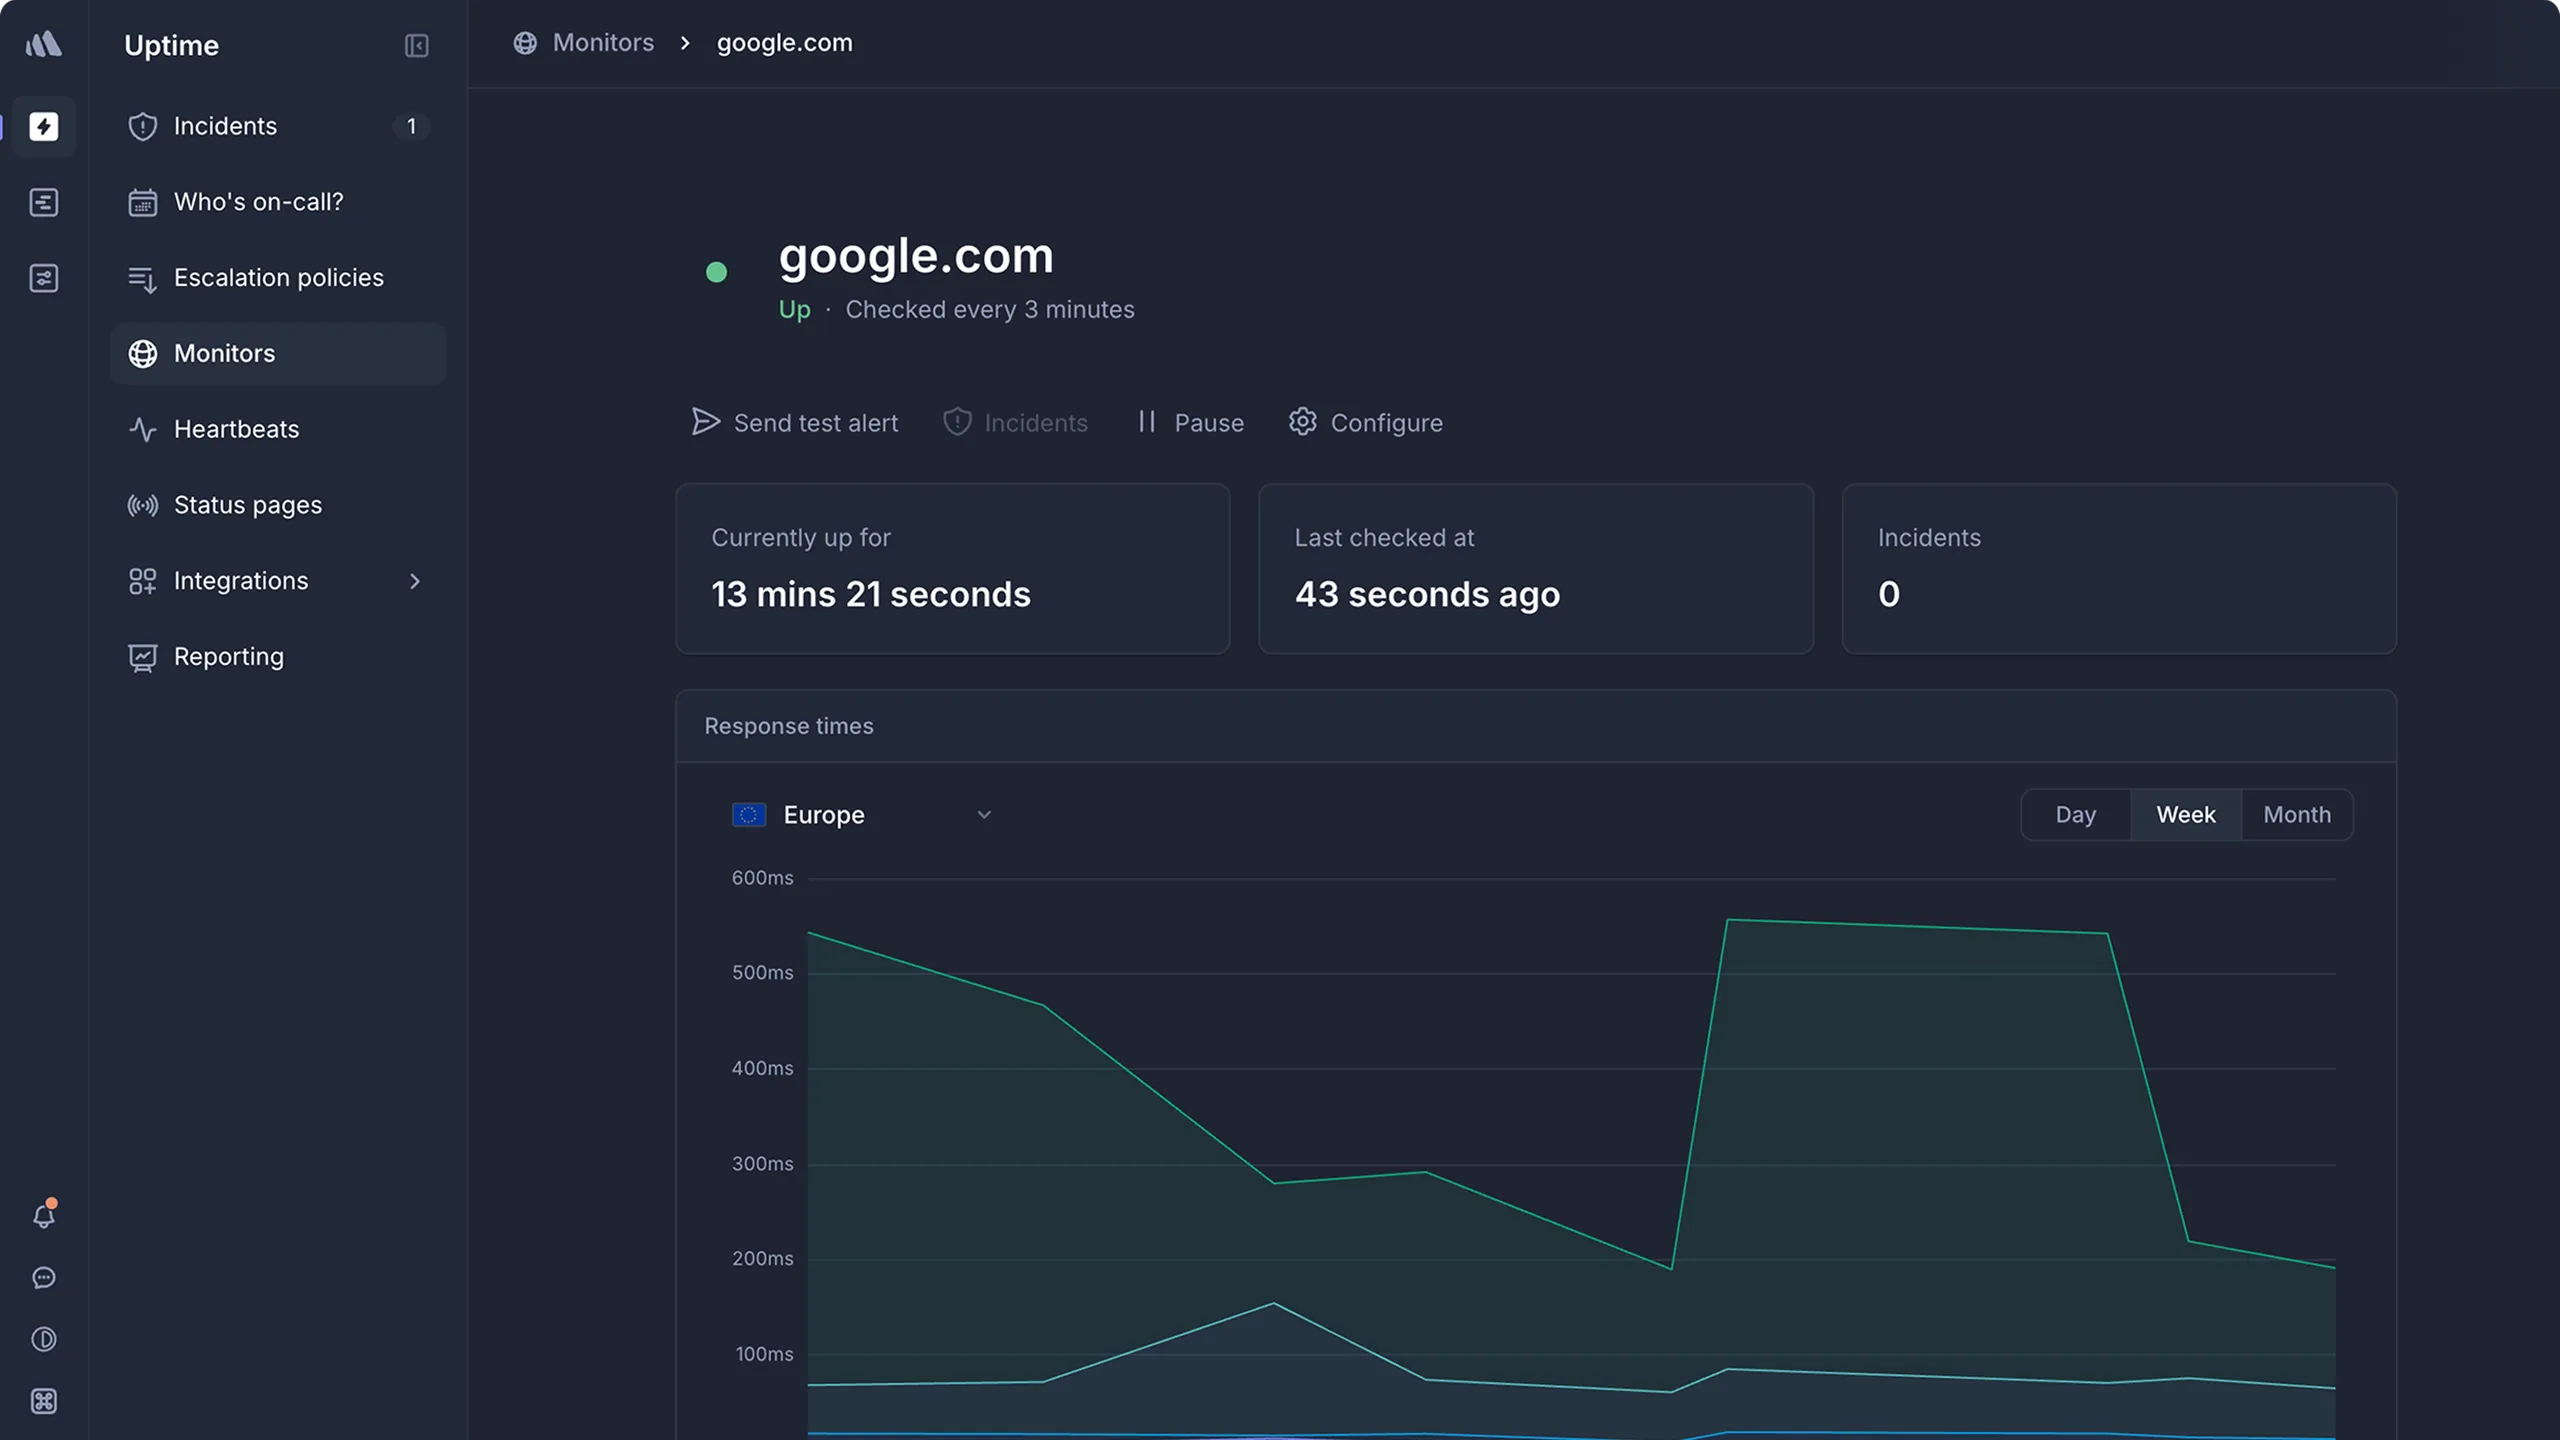
Perfect voor
Startups en groeiende SaaS-teams die monitoring, logbeheer en incidentrespons in één verzorgde, moderne interface willen, en het geen probleem vinden om add-ons op basis van verbruik bij te houden.
Opvallende functies
- Uptime-monitoring met controles vanaf meerdere locaties wereldwijd
- Logbeheer met gestructureerd zoeken en alerting
- Piketplanning en escalatie met meldingen via meerdere kanalen
- Statuspagina’s in je eigen huisstijl met eigen domeinen
- Moderne interface die in reviews op G2 steevast wordt geprezen
- OpenTelemetry-tracing op basis van eBPF voor automatische instrumentatie
- Ondersteuning voor Terraform en API voor infra-as-code-workflows
Waarom Better Stack kiezen boven incident.io
Drie lagen in één platform. Monitoring, logs en incidenten onder één dak: één SaaS-rekening en één integratie minder om te onderhouden. incident.io gaat ervan uit dat je je eigen detectie en observability meebrengt.
Verzorgde interface. Dit is het vaakst geprezen aspect in de reviews. Qua afwerking vergelijkbaar met incident.io, maar met de monitoringlaag erbij.
Ruim gratis abonnement. Je kunt het platform uitproberen zonder je vast te leggen.
Waar Better Stack tekortschiet
Verrassingen door prijzen per responder. $ 29/mnd is het kopbedrag, maar extra responders ($ 29 per stuk), meer monitors ($ 21 per 50) en extra statuspagina’s ($ 12 per stuk) lopen sneller op dan de marketing doet vermoeden.
Minder volwassen levenscyclus dan incident.io of Rootly. Piketdienst en incidenten zijn degelijk, maar AI-gestuurde postmortems en de diepte van chat-native workflows blijven achter.
Beperkt maatwerk in de instaptiers. Vooral het aanpassen van statuspagina’s is in de lagere abonnementen beperkt.
Prijzen
- Gratis abonnement met basismonitoring en beperkte functies
- Betaalde abonnementen vanaf $ 29/mnd, met prijzen per responder in de hogere niveaus
- Add-ons: meer monitors, meer statuspagina’s en logretentie worden allemaal apart geprijsd
Kies Better Stack als
Je monitoring + logs + incidenten in één tool wilt, een moderne interface belangrijk vindt en het prima vindt om add-ons op basis van verbruik bij te houden. Sla het over als je de voorspelbaarheid van een vaste prijs wilt (daar past Hyperping beter) of een volledige chat-native levenscyclus voor incidenten (daar passen Rootly of FireHydrant beter).
Directe vergelijkingen
Rootly vs incident.io: welke Slack-native tool?
Dit is de vaakst genoemde rechtstreekse vergelijking in r/sre-threads. Rootly is beter configureerbaar en heeft diepere workflowautomatisering over Jira, GitHub en de rest van de dev-stack. incident.io is uitgesprokener en sneller in gebruik te nemen zonder extra werk, met de sterkste AI-postmortems. Heb je een complexe toolchain en wil je daaromheen automatiseren: Rootly. Wil je best practices kant-en-klaar: incident.io.
FireHydrant vs incident.io: welke voor enterprise-runbooks?
De runbook-engine en de servicecatalogus van FireHydrant gaan dieper en staan centraler in het product. De kracht van incident.io zit in uitgesproken standaardinstellingen en AI-postmortems. FireHydrant bundelt AI in Enterprise; incident.io spreidt het over niveaus en een piket-add-on. Voor teams voor wie vastgelegde, herhaalbare playbooks en een centrale servicecatalogus de belangrijkste eis zijn: FireHydrant. Voor teams die de afwerking van incident.io willen: incident.io.
Hyperping vs incident.io: heb ik überhaupt een responseplatform nodig?
Draai je minder dan 5 incidenten per maand, dan is het eerlijke antwoord waarschijnlijk nee. Hyperping dekt detectie, oproepen, escalatie en statuspagina’s tegen een vaste prijs, met seats inbegrepen en extra seats per seat gefactureerd. incident.io is gemaakt voor het team dat 10+ incidenten per maand draait en orkestratie nodig heeft. Voor de meeste teams onder de 30 engineers zit het knelpunt eigenlijk in de laag van detectie en oproepen.
Squadcast vs incident.io: welke voor teams met een krap budget?
Squadcast dekt voor $ 15/gebruiker/mnd de piketlaag en basis-incidentrespons voor ongeveer 40% minder dan de effectieve kosten van incident.io zodra de piket-add-on meetelt. De keerzijde: geen AI-postmortems, een minder diepe levenscyclus in de chat en minder afwerking in de workflows. Voor de meeste teams onder de 50 engineers waar budget de beperkende factor is, is Squadcast de betere businesscase.
PagerDuty vs incident.io: welke voor grote ondernemingen?
De alerting-engine en de integratiecatalogus van PagerDuty zijn nog altijd volwassener. De chat-native respons en de AI-postmortems van incident.io zijn moderner. Voor organisaties waar diepgang in alerting en comfort bij inkoop het zwaarst wegen: PagerDuty. Voor organisaties die besloten hebben dat chat-native respons de toekomst is en willen moderniseren: incident.io.
Beslissingskader
Op teamgrootte:
- Solo of klein team (1 tot 10): Hyperping of Squadcast (proefperiode van 14 dagen).
- Middelgroot (10-50): Hyperping voor monitoring + piketdienst + statuspagina’s, Rootly of FireHydrant voor een Slack-native levenscyclus.
- Groot (50-200): Rootly of FireHydrant voor chat-native, PagerDuty als de complexiteit van de planning de doorslag geeft.
- Enterprise (200+): PagerDuty, FireHydrant Enterprise of Rootly Enterprise.
Op workflow:
- Slack-native, diepe workflowautomatisering: Rootly.
- Slack-native, diepe runbooks en servicecatalogus: FireHydrant.
- Slack-native, uitgesproken standaardinstellingen: incident.io zelf (het alternatief is blijven).
- Eerst de webapp, complexe routering: PagerDuty.
- Vooral degelijke piketdienst nodig: Squadcast of Hyperping.
- Monitoring erbij gebundeld: Hyperping of Better Stack.
Op budget (team van 20 mensen):
- $ 100 tot $ 300 per maand: Hyperping Pro, Squadcast Pro, Better Stack met een paar add-ons.
- $ 300 tot $ 1.000 per maand: FireHydrant Pro of Rootly Incident Response.
- $ 1.000+ per maand: de Essential-platformtier van PagerDuty ($ 12.000 per jaar voor 25 seats), FireHydrant Enterprise, Rootly Enterprise.
Volledige lijst van alternatieven voor incident.io die ik heb bekeken
Voor de volledigheid: dit is de bredere set tools voor incidentbeheer en piketdienst die ik heb bekeken voordat ik het terugbracht tot de zes keuzes. De prijzen zijn bij benadering, stand 2026, en variëren met gebruik en teamgrootte.
| Naam | Prijs (ca. 2026) | Grootste kracht | Grootste zwakte |
|---|---|---|---|
| Rootly | ca. $ 20+/gebruiker/mnd per module | Diepe automatisering in Slack/Teams, volledige levenscyclus, AI-retrospectives | Prijs per module stapelt op; afhankelijk van chat |
| FireHydrant | Gratis (10 responders); Pro $ 25/responder/mnd (jaarlijks); Enterprise op maat | Sterke runbooks, gestructureerde workflows, analyse na incidenten | Grote prijssprong tussen niveaus; vaak jaarcontracten |
| Hyperping | Gratis basis; vanaf ca. € 24/mnd tegen een vaste prijs | Geïntegreerde monitoring + statuspagina’s + piketdienst tegen een vaste prijs | Geen chat-native responseplatform |
| PagerDuty | Professional $ 21/gebruiker/mnd; platform vanaf $ 2.800/jaar met AIOps | Volwassen enterprise-alerting, piketdienst, 700+ integraties, AIOps | Dure add-ons; complexe/verouderde UI; steile leercurve |
| Squadcast | Pro $ 15/gebruiker/mnd; Premium $ 24/gebruiker/mnd (jaarlijks) | Betaalbaar en gericht op SRE (piketdienst, SLO’s, postmortems) | Minder naamsbekendheid dan de marktleiders |
| Better Stack | Gratis abonnement; betaald vanaf ca. $ 29/mnd (op basis van verbruik) | Alles-in-één monitoring + incidenten + statuspagina’s; moderne UI | Modulaire prijzen lopen op |
| Opsgenie (Atlassian) | Niet meer te koop (einde verkoop 4 juni 2025) | Alerting/piketdienst met Jira-integratie, voor bestaande klanten | Stopt op 5 april 2027; klanten stappen over naar Jira Service Management |
| xMatters | Vanaf ca. $ 9/gebruiker/mnd (gratis tot 10 gebruikers); hoger op maat | Diepe analytics, ML-inzichten, complexe workflows | Gedateerde interface; steilere leercurve |
| Jira Service Management | Gratis (beperkt); Standard ca. $ 20/agent/mnd; Premium ca. $ 49/agent/mnd | Naadloze Atlassian/Jira-integratie voor ITSM op basis van tickets | Gericht op tickets, niet op realtime SRE-respons |
| ServiceNow | Enterprise op maat (vaak $ 100+/gebruiker/mnd) | Uitgebreide ITSM-suite, automatisering, compliance | Zeer complex, duur, lange implementatie |
| Splunk On-Call (VictorOps) | Neem contact op met sales (op basis van verbruik) | Nauwe integratie met Splunk-observability | Verouderde UI; minder aantrekkelijk als losse tool |
| Freshservice | Vanaf ca. $ 19/agent/mnd | Gebruiksvriendelijke cloud-ITSM met AI-automatisering | Meer helpdesk; minder gespecialiseerd in SRE |
| Zenduty (Xurrent IMR) | Gratis, daarna ca. $ 5/gebruiker/mnd (Starter); tot $ 21 Enterprise | Betaalbaar en AI-gedreven (RCA, postmortems), goede integraties | Minder bekend merk; enkele gaten voor enterprise |
| iLert | Gratis (beperkt); Pro ca. € 19/gebruiker/mnd; Enterprise ca. $ 49+ | EU-vriendelijk, AI-first, statuspagina’s, over de hele stack | Regionale focus kan de wereldwijde perceptie beperken |
| PagerTree | Vanaf ca. $ 10/gebruiker/mnd of vast bedrag; gratis basis | Eenvoudige, lichte routering van alerts en piketdienst voor kleine teams | Beperkte geavanceerde automatisering/levenscyclus |
| Spike.sh | Vanaf ca. $ 5/mnd | Eenvoudige incidentrespons voor een klein budget | Basisfuncties; niet voor enterprise-behoeften |
| Grafana OnCall / IRM | Gratis abonnement; betaald ca. $ 20/gebruiker + verbruik | Native integratie met Grafana/observability, open-source wortels | Op zijn best met de Grafana-stack; minder als losse tool |
| Blameless | Op maat (neem contact op met sales) | Gericht op SRE-praktijken, gestructureerde postmortems | Momentum bleef achter bij de chat-native kopgroep |
| BigPanda | Enterprise (neem contact op met sales) | Sterke AIOps-correlatie van alerts en ruisonderdrukking | Duur; meer AIOps dan een volledige incidentlevenscyclus |
| Moogsoft | Enterprise (neem contact op met sales) | AIOps voor ruisonderdrukking en groepering | Complex; hogere kosten op grote schaal |
| OnPage | ca. $ 12/gebruiker/mnd | Beveiligde oproepen voor de zorg en gereguleerde sectoren | Nichefocus; minder brede SRE-functies |
| ManageEngine ServiceDesk Plus | Neem contact op met sales / vanaf lagere niveaus | Betaalbare ITSM-suite met incidentmodules | Gedateerde UI; meer traditionele ITSM |
| InvGate Service Management | Starter ca. $ 17/agent/mnd; Pro ca. $ 40 | Bruikbare no-code workflows, ITAM-integratie | Minder bekend in pure SRE-kringen |
| BMC Helix | Enterprise (neem contact op met sales) | AI-gestuurde enterprise-ITSM | Duur en complex om te implementeren |
| NinjaOne | Wisselend (gericht op MSP’s) | Patchbeheer + incidentrespons | Meer endpoint/RMM dan kern-incidentbeheer |
| GoAlert | Gratis OSS | Eenvoudige open-source piketplanning | Overhead van self-hosting; minimale levenscyclusfuncties |
| All Quiet | Vanaf ca. $ 5/gebruiker/mnd | Budgetvriendelijk alternatief voor piketdienst | Kleinere functieset; nieuwe speler |
De patronen in deze lijst komen uit analyses van 2025-2026 op Gartner Peer Insights, prijspagina’s van leveranciers, vergelijkingsartikelen en Reddit-threads op r/sre, r/devops, r/incidentio en r/SaaS.
Veelgemaakte fouten bij het verlaten van incident.io
Een paar patronen die ik steeds weer zag in de Reddit-threads:
- incident.io vervangen door Rootly zonder de migratiekosten van workflows te testen. De diepgang van Rootly is waardevol, maar uitgesproken workflows van incident.io overzetten naar de low-code builder van Rootly is echt werk. Breng eerst in kaart welke workflows je echt gebruikt, voordat je migreert.
- Overstappen naar een tool zonder de AI-postmortems waar je eigenlijk op leunde. Als de automatisch gegenereerde postmortems van incident.io de dragende functie waren, dan komen FireHydrant Enterprise (FireHydrant AI) en Rootly AI SRE het dichtst in de buurt. PagerDuty en Squadcast lopen hier achter.
- Statuspagina’s en detectie vergeten. Veel teams vervangen incident.io door een andere responsetool en merken dan dat ze ook een aparte uptime-monitor en statuspagina gebruikten. Een gebundelde tool als Hyperping of Better Stack dicht dat gat.
- Kiezen op basis van een checklist met AI-functies. AI-postmortems, AI-samenvattingen en door AI voorgestelde responders zijn allemaal echte functies, maar de werkelijke kwaliteit verschilt sterk. De r/sre-thread over AI-RCA staat vol nuchtere scepsis. Draai een parallelle POC op drie tot vijf echte incidenten voordat je beslist.
- “Slack-native” zien als een simpele ja/nee. “Slack-native” betekent iets heel anders bij Rootly, FireHydrant en incident.io. Laat echte responders tijdens een POC door de chatflow gaan. Power users en engineers die voor het eerst piketdienst draaien, geven verschillende feedback.
Conclusie
Er is niet één beste alternatief voor incident.io, alleen de beste tool voor een specifieke plek in je stack.
- Voor Slack-native respons met diepere workflowautomatisering: Rootly.
- Voor volwassen enterprise-runbooks met de servicecatalogus als middelpunt: FireHydrant.
- Voor monitoring, piketdienst en statuspagina’s in één tool met een vaste prijs: Hyperping.
- Voor diepgaande enterprise-alerting en de breedste integratiecatalogus: PagerDuty.
- Voor DevOps-teams met een krap budget die alleen degelijke piketdienst nodig hebben: Squadcast.
- Voor monitoring, logs en incidenten op één plek in een verzorgde interface: Better Stack.
Wil je monitoring die problemen binnen 30 seconden opmerkt, piketplanning met slimme escalaties en statuspagina’s die je klanten echt gaan bekijken, allemaal tegen een vast maandbedrag met seats inbegrepen en betaalde extra seats? Probeer Hyperping gratis.
Verder lezen
- Beste tools voor incidentbeheer: bredere gids over de categorie, met 6 tools
- Beste Rootly-alternatieven: als Rootly ook op je shortlist staat
- Beste FireHydrant-alternatieven voor piketplanning: als FireHydrant de andere naam op je shortlist is
- Beste PagerDuty-alternatieven: als PagerDuty ook op je shortlist staat
- Beste tools voor piketplanning: gericht op de laag van de piketdienst
- Beste software voor statuspagina’s: de laag van klantcommunicatie die de meeste responsetools overslaan
- Prijzen van Hyperping
Blijf vergelijken: Hyperping vs incident.io · Hyperping vs PagerDuty · Prijzen van Hyperping · Alle vergelijkingen
Veelgestelde vragen
Wat is het beste alternatief voor incident.io? ▼
Er is niet één beste alternatief voor incident.io. Voor Slack-native respons met diepere workflowautomatisering: Rootly. Voor volwassen enterprise-runbooks met een servicecatalogus als middelpunt: FireHydrant. Voor monitoring, piketdienst en statuspagina’s in één tool met een vaste prijs: Hyperping. Voor diepgaande enterprise-alerting en 700+ integraties: PagerDuty. Voor DevOps-teams die op hun budget letten: Squadcast. Voor monitoring, logs en incidenten in één platform: Better Stack.
Waarom zoeken teams naar alternatieven voor incident.io? ▼
In de Reddit-threads die ik las, komen steeds dezelfde redenen terug: verrassingen in de prijs (de effectieve ondergrens van het Pro-abonnement ligt een flink stuk boven de publieke prijs per gebruiker zodra piketdienst erbij komt), uitgesproken standaardinstellingen die teams met eigen processen frustreren, grenzen aan het maatwerk bij complexe voorwaardelijke logica, en de afhankelijkheid van Slack als hoofdkanaal. Teams die Microsoft Teams als belangrijkste chattool gebruiken, melden ook dat de functies daar achterlopen.
Is Rootly beter dan incident.io? ▼
Dat hangt af van wat je zoekt. Rootly is beter configureerbaar, met een diepere workflow-engine over Jira, GitHub, Zoom en de rest van de dev-stack. incident.io is uitgesprokener, sneller in gebruik te nemen zonder extra werk, en heeft de sterkste AI-postmortems. Teams met een complexe toolchain kiezen Rootly. Teams die best practices kant-en-klaar willen, kiezen incident.io.
Wat is het goedkoopste alternatief voor incident.io? ▼
Squadcast (nu SolarWinds Incident Response) Pro voor $ 15 per gebruiker per maand bij jaarlijkse betaling is de goedkoopste geloofwaardige tool voor incidentbeheer met echte piketfuncties. Hyperping begint bij € 24 per maand tegen een vaste prijs, met seats inbegrepen en betaalde extra seats, en bevat monitoring, piketdienst, escalatiebeleid en statuspagina’s. Voor de meeste teams onder de 30 mensen is Hyperping de goedkoopste alles-in-één-route.
Is incident.io de prijs waard? ▼
Voor teams die echt in Slack leven, 10+ incidenten per maand draaien en een consistent proces willen zonder engineers naar een aparte webapp te dwingen: ja. Voor organisaties op Microsoft Teams, kleine teams met een paar incidenten per maand, of teams waar het knelpunt bij detectie ligt en niet bij coördinatie, zijn de piket-add-on en de minimumbedragen van het Pro-abonnement lastig te verantwoorden.