De beste Nagios-alternatieven in 2026 zijn Hyperping (gehoste server- en uptime-monitoring met ingebouwde piketdienst en statuspagina’s), Icinga (de meest directe open source vervanger, met dezelfde plugins), Checkmk (compatibel met Nagios-plugins, plus automatische discovery), Zabbix (alles-in-één open source monitoring met templates) en Prometheus met Grafana (metrics-first monitoring voor cloud-native stacks). Ik bespreek ook Netdata, Datadog, PRTG en LibreNMS, voor de teams waarvoor die beter passen.
Nagios werkt nog steeds. Nagios Core 4.5.14 verscheen op 5 augustus 2026, en genoeg teams draaien het zonder problemen. Mensen stappen over vanwege alles rond de checks: objectbestanden die je met de hand schrijft, een plugin die je op elke host moet installeren en bijwerken, een interface die in jaren nauwelijks is veranderd en een alarmeringslaag die ophoudt bij "stuur een e-mail naar dit contact".
In deze gids lees je:
- Waarom teams Nagios vervangen, op basis van reviews en de documentatie van elke tool
- Negen alternatieven met prijzen, hostingmodel, installatiewerk en hoe elk ervan alarmering en piketdienst regelt
- Welke open source zijn, welke gratis zijn en welke het best werken met Windows-hosts
- Hoe je het oproepen en de communicatie met klanten van Nagios loshaalt zonder big-bang-migratie
Belangrijkste conclusies
- Icinga is de open source overstap met de minste wrijving: het draait je bestaande Nagios-plugins, voegt een REST API en clustering toe en is gratis voor een onbeperkt aantal hosts.
- Checkmk blijft compatibel met Nagios-plugins, maar vervangt handgeschreven configuratie door service discovery via agents en een webinterface. Community is gratis, Pro begint bij € 190 per maand bij jaarlijkse facturatie.
- Zabbix en Prometheus + Grafana zijn de sterkste open source platforms als je bereid bent je checks vanaf nul opnieuw op te bouwen in plaats van ze over te zetten.
- Hyperping past bij teams waarvan het echte probleem het oproepen is: een agent voor Linux, macOS en Windows, piketroosters, escalatiebeleid en statuspagina’s in één gehoste tool, vanaf € 24 per maand bij jaarlijkse facturatie.
- PRTG is de keuze als je de monitoringserver zelf op Windows wilt draaien. De core server werkt alleen op Windows.
Waarom je deze gids kunt vertrouwen
Ik ben Léo, oprichter van Hyperping. Ik heb dus belang bij een van deze tools, en Hyperping staat bovenaan. Ik heb geprobeerd precies te zijn over waar het tekortschiet, want het vervangt niet alles wat Nagios doet: er is geen pluginsysteem, geen SNMP-polling van netwerkapparatuur en geen self-hosted editie.
Voor de andere tools heb ik op 28 sep 2026 de prijzen en licenties op de officiële site van elke leverancier gecontroleerd, Capterra-reviews van Nagios Core en Nagios XI gelezen en de documentatie van de leveranciers over alarmering en piketdienst doorgenomen. Waar ik iets niet zelf kon verifiëren, zeg ik dat.
De beste keuzes in één oogopslag
| Beste voor | Product |
|---|---|
| Gehoste servermonitoring met piketdienst en statuspagina’s inbegrepen | Hyperping |
| Open source vervanger die Nagios-plugins hergebruikt | Icinga |
| Nagios-compatibiliteit met automatische discovery en configuratie via het web | Checkmk |
| Gratis alles-in-één monitoring met templates en een webinterface | Zabbix |
| Metrics-first monitoring voor containers en cloud-native stacks | Prometheus + Grafana |
| Metrics per seconde met vrijwel geen configuratie | Netdata |
| Volledige observability met APM, logs en traces | Datadog |
| Monitoringserver op Windows met netwerksensoren | PRTG |
| Monitoring van netwerkapparatuur via SNMP met automatische discovery | LibreNMS |
Waarom teams Nagios verlaten
Nagios begon in 1999 als NetSaint en werd in de jaren 2000 dé open source monitoringtool. Het checkmodel (draai een klein programma, lees de exitcode, alarmeer op 0, 1, 2 of 3) is zo wijdverbreid dat de helft van de tools hieronder het nog steeds spreekt. De klachten die ik vond, gaan over al het andere.
Plugins op elke host
Elke check in Nagios is een extern programma. Wil je de schijfruimte op een Linux-host op afstand controleren, dan installeer je NRPE of NCPA op die host, rol je check_disk en de afhankelijkheden uit en houd je de versies gelijk over de hele vloot. Windows-hosts hebben daarbovenop NSClient++ of NCPA nodig. Eigen checks worden meestal Perl-, Bash- of Python-scripts die één persoon heeft geschreven en niemand anders begrijpt.
Op Capterra beschreef een reviewer van Nagios XI het model zo: je moet een verzameling testscripts samenstellen, ze verspreiden en hun afhankelijkheden op elke beheerde node installeren. Vermenigvuldig dat met een paar honderd hosts en pluginonderhoud wordt een parttimebaan.
Configuratie staat in tekstbestanden
Nagios Core definieert hosts, services, contacts, commands en timeperiods als objecten in .cfg-bestanden. Een server toevoegen betekent de host- en servicedefinities schrijven (of uit een template genereren), nagios -v draaien om te valideren en herladen. Er is geen discovery: niets verschijnt totdat iemand het toevoegt.
Reviewers noemen dit vaker dan wat ook. Uit Capterra-reviews van Nagios Core:
"Er is geen functie voor automatische discovery, elke host en service moet handmatig worden toegevoegd."
IT-beheerder, gamesindustrie
"Om alles werkend te krijgen heb je gevorderde kennis nodig van Linux-beheer via de commandline en moet je configuratiebestanden vanaf de commandline kunnen aanpassen."
Chief operating officer
Nagios XI voegt een webgebaseerde Core Config Manager en configuratiewizards toe, wat veel hiervan wegneemt. Maar XI is een commercieel product, en de gratis editie stopt bij 7 nodes of 100 services.
Een gedateerde interface zonder ingebouwde grafieken in Core
De webinterface van Nagios Core bestaat uit CGI-pagina’s die er nog grotendeels uitzien als tien jaar geleden. Core heeft geen eigen grafieken voor metrics: teams plakken er PNP4Nagios, Graphite of Grafana aan om een CPU-trend te zien. Een reviewer van Nagios XI op Capterra zei het zonder omwegen: "De UI/UX voelt wat gedateerd vergeleken met moderne SaaS-platforms voor observability." XI heeft wel prestatiegrafieken, al noemen reviewers de interface nog steeds gedateerd.
Alarmering houdt op bij notificaties
Dit is het gat dat het zwaarst weegt zodra een team piketdienst draait. Notificaties in Nagios zijn shellcommando’s (notify-service-by-email) die tijdens timeperiods naar contacts worden gestuurd. Escalaties bestaan als configuratieobjecten, maar er is geen piketkalender, geen rooster dat je vanaf je telefoon aanpast, geen vervanging bij een ziektedag en geen bevestigingsflow buiten de webinterface.
Daarom koppelen de meeste Nagios-teams een tweede tool voor het oproepen: PagerDuty, Opsgenie (dat op 5 april 2027 stopt, zie onze gids over het einde van Opsgenie) of een zelfgeschreven script. En klanten horen nog steeds via supporttickets over storingen, want Nagios heeft geen openbare statuspagina. Dat zijn drie tools, drie configuraties en drie plekken waar een alarm zoek kan raken.
Licentiekosten van XI op schaal
Nagios Core is gratis onder GPLv2. Nagios XI Standard is een eenmalige licentie vanaf $ 2.595 voor 100 nodes en $ 14.995 voor 1.000 nodes, met de Enterprise-functies als add-on (vanaf $ 4.690 voor 100 nodes). Volgens de prijspagina van Nagios XI is een onderhouds- en supportcontract verplicht om de premiumfuncties na het eerste jaar te behouden. Eén reviewer op Capterra vatte het samen: "De licentiekosten zijn erg hoog."
Snelle vergelijking: Nagios-alternatieven
| Tool | Startprijs | Hosting | Installatiewerk | Alarmering en piketdienst | Windows-hosts |
|---|---|---|---|---|---|
| Hyperping | Gratis; € 24 per maand bij jaarlijkse facturatie | Gehost (SaaS) | Laag: één commando per host | Piketroosters, escalatiebeleid, telefoon/sms/Slack/Teams, statuspagina’s inbegrepen | Native agent (Windows 10 / Server 2016+) |
| Icinga | Gratis; abonnementen vanaf $ 2.000 per jaar | Self-hosted | Gemiddeld tot hoog | Notificaties op basis van regels; roosters in Icinga Notifications (bèta) | Icinga for Windows (PowerShell) |
| Checkmk | Gratis Community; Pro vanaf € 190 per maand bij jaarlijkse facturatie | Self-hosted of Cloud | Gemiddeld | Notificaties op basis van regels; oproepen via integraties | Native agent |
| Zabbix | Gratis; Cloud vanaf $ 50 per maand | Self-hosted of Cloud | Gemiddeld tot hoog | Actions met escalatiestappen; geen piketkalender | Native agent |
| Prometheus + Grafana | Gratis; Grafana Cloud Pro $ 19 per maand + verbruik | Self-hosted of Grafana Cloud | Hoog | Routering via Alertmanager; Grafana IRM voor piketdienst ($ 20 per actieve gebruiker) | windows_exporter |
| Netdata | Gratis (5 nodes); Business $ 7 per node per maand bij jaarlijkse facturatie | Agent + Netdata Cloud of on-prem | Laag | Alarmnotificaties; geen piketroosters | Native agent |
| Datadog | Gratis (5 hosts); $ 15 per host per maand bij jaarcontract | Gehost (SaaS) | Laag tot gemiddeld | Monitors + apart On-Call-product ($ 20 per seat) | Native agent |
| PRTG | Gratis (100 sensoren); $ 200 per maand bij jaarlijkse facturatie | Self-hosted (Windows) of PRTG Hosted Monitor | Gemiddeld | Notification triggers; geen piketroosters | Core server alleen op Windows |
| LibreNMS | Gratis | Self-hosted (Linux) | Gemiddeld | Alertregels naar e-mail, Slack en meer; geen piketdienst | SNMP |
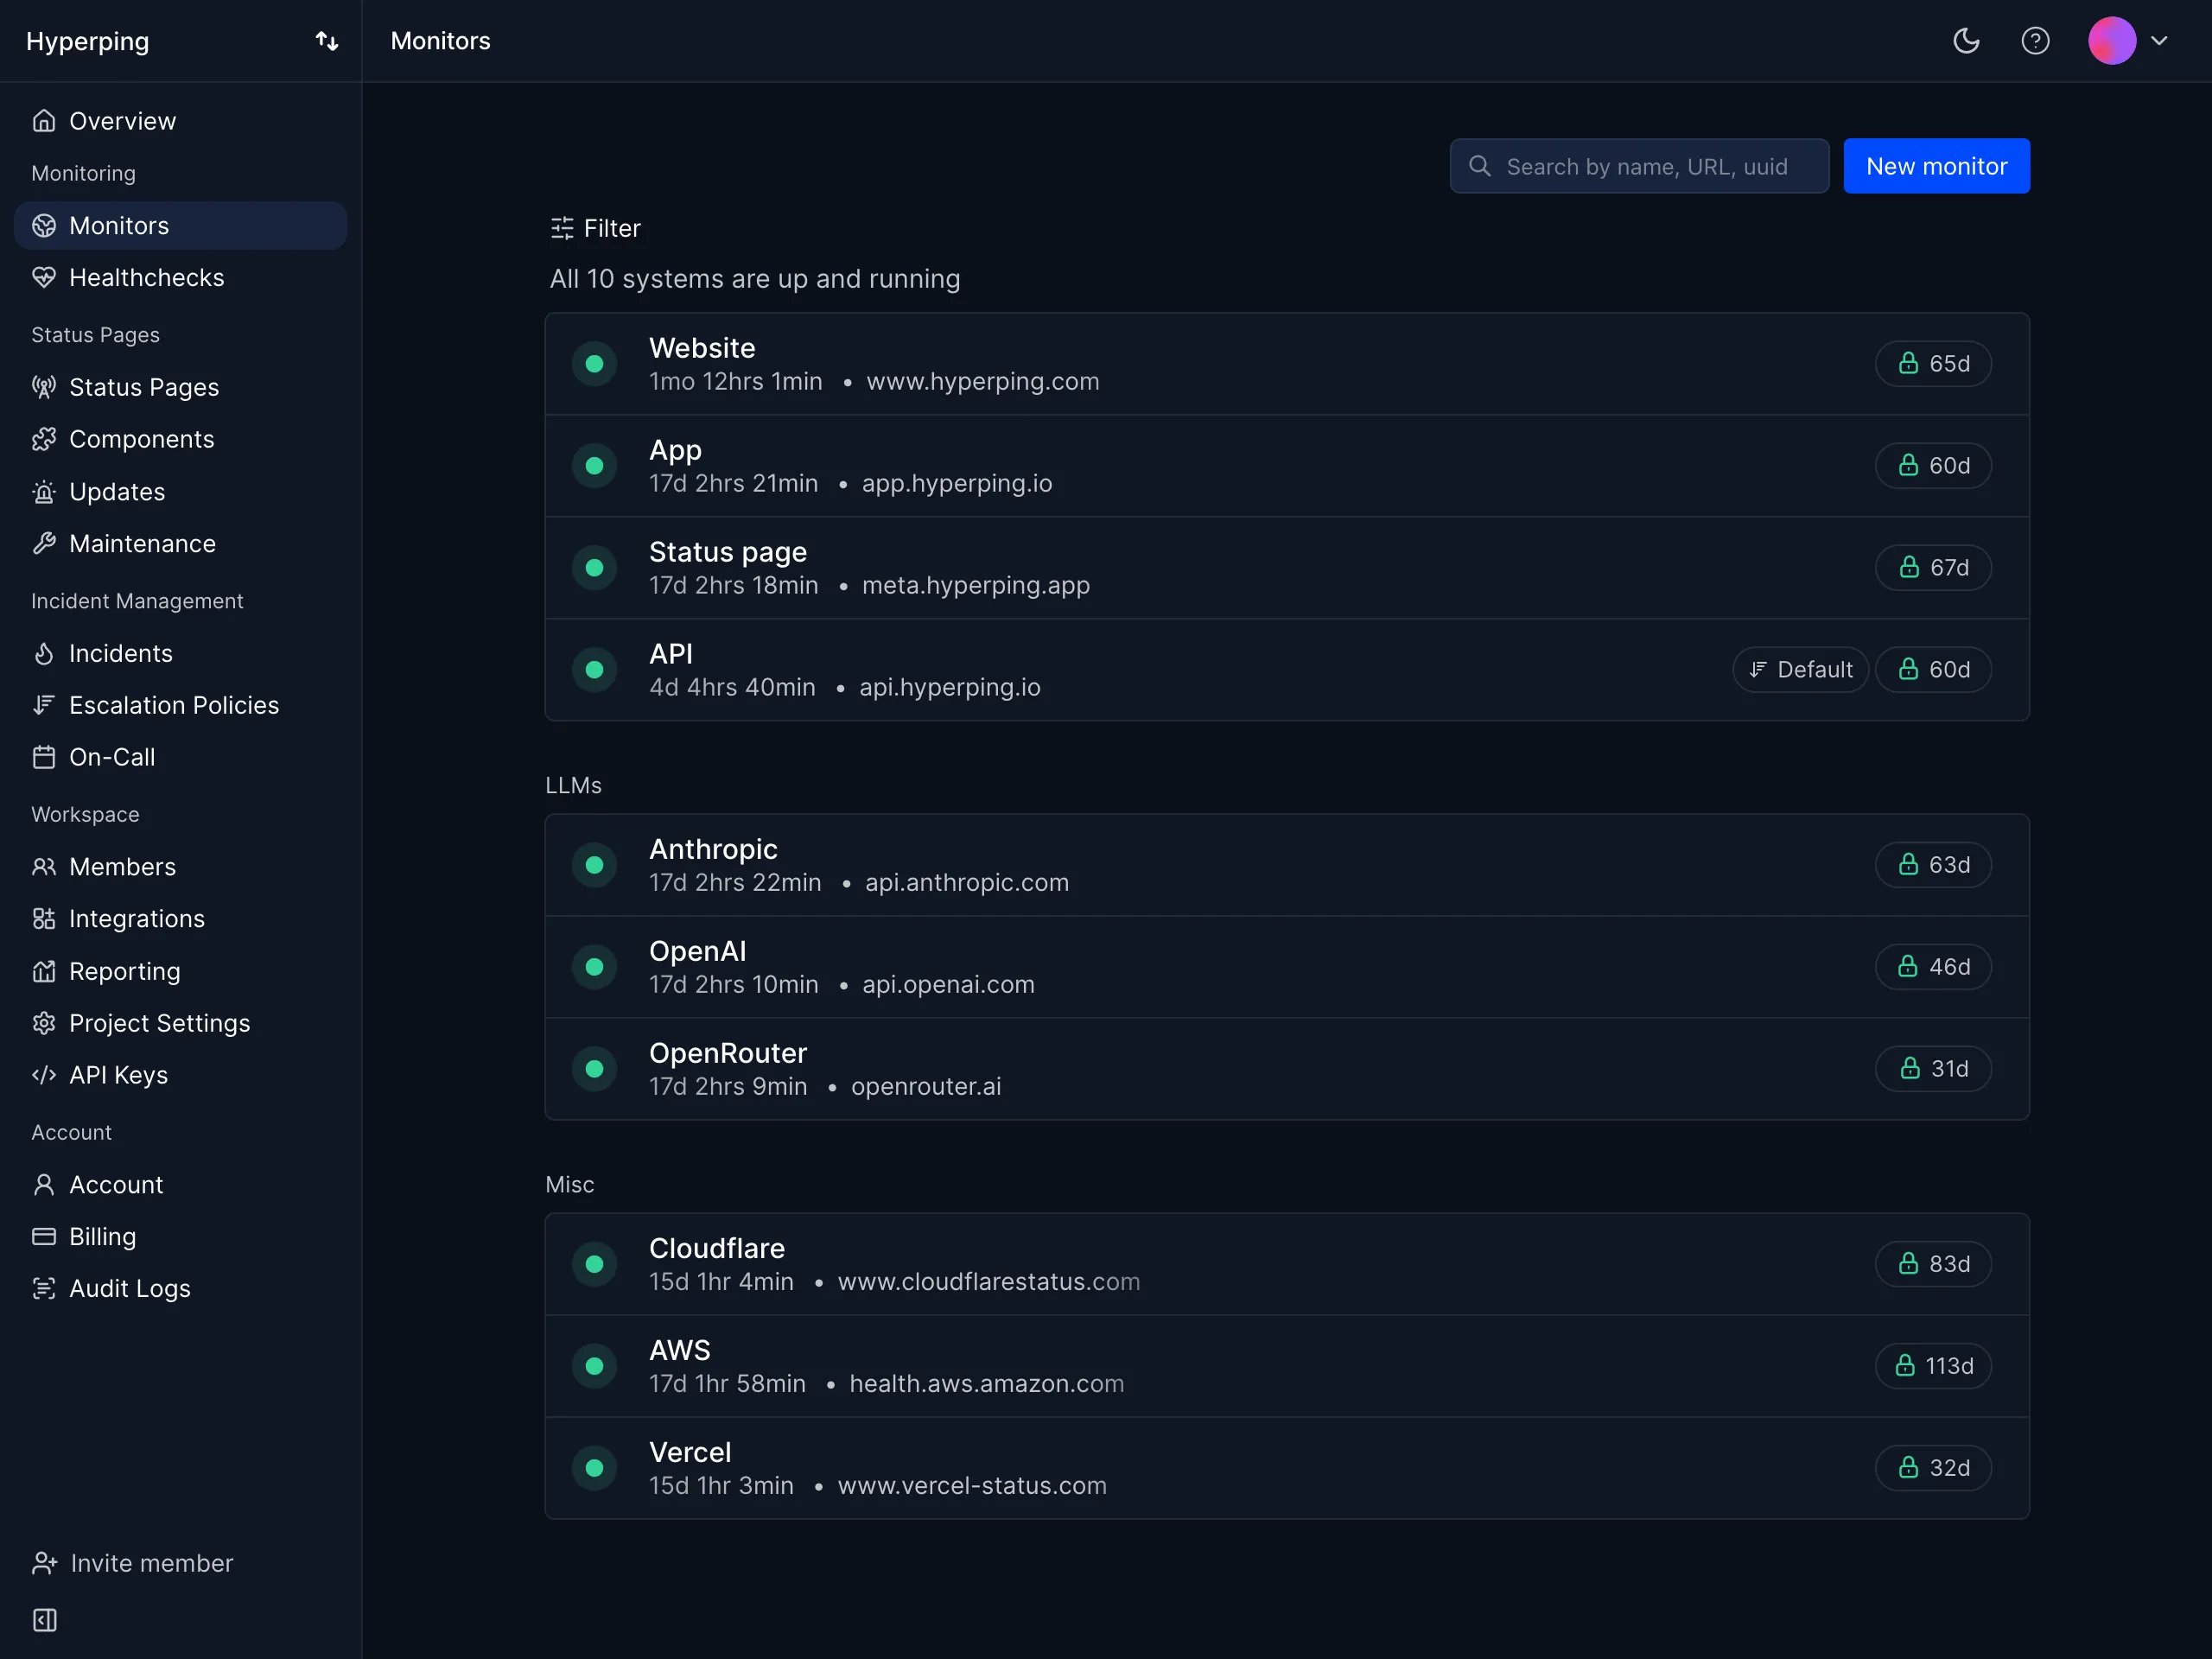
Hyperping: het best voor gehoste monitoring met ingebouwde piketdienst en statuspagina’s
Voor wie Hyperping is gemaakt
Teams met een paar tot een paar honderd servers die de monitoringserver zelf niet langer willen onderhouden, en bij wie het grootste gat zit in wat er gebeurt nadat een check faalt: wie wordt opgeroepen, wat gebeurt er als die niet reageert en hoe horen klanten ervan.
Hyperping is geen één-op-één-vervanger van Nagios. Het draait geen Nagios-plugins en pollt geen switches via SNMP. Het dekt het deel van een Nagios-setup dat de meeste kleine en middelgrote teams echt gebruiken (leeft de host nog, raakt de CPU, het geheugen of de schijf vol, antwoordt de dienst) en voegt de laag voor oproepen en statuspagina’s toe die Nagios nooit had.
Opvallende functies
- Agent van één regel voor Linux, macOS en Windows: één installatiecommando registreert een systemd-, launchd- of Windows-service. De agent draait op amd64 en arm64 (amd64 op Windows), mikt op ongeveer 50 MB geheugen en heeft alleen uitgaand HTTPS nodig. De details staan in de installatiereferentie van de agent.
- Hostmetrics elke 30 seconden: CPU-gebruik met load averages over 1, 5 en 15 minuten, gebruikt en beschikbaar geheugen, bestandssysteemgebruik per mountpoint, schijf-I/O per apparaat en netwerkbytes per interface, plus hostmetadata (OS, kernel, CPU-model, uptime). De volledige lijst staat bij verzamelde metrics.
- Geen configuratiebestanden om te schrijven: de server verschijnt met zijn metrics in het dashboard, ongeveer 30 seconden na de installatie. Met flags als
--name,--policyen--groupkan Ansible of Terraform een hele vloot inschrijven met meteen het juiste escalatiebeleid. - Offlinedetectie die de piketdienst oproept: stopt een server langer met rapporteren dan zijn offlinedrempel (standaard 90 seconden, minimaal 60 seconden), dan wordt er een storing geopend en waarschuwt het escalatiebeleid van die server zijn kanalen: e-mail, sms, telefoonoproepen, Slack, Teams, PagerDuty, OpsGenie, webhooks of een piketrooster. Herstelmeldingen gaan naar dezelfde kanalen.
- Piketroosters en escalatiebeleid: inbegrepen vanaf het Essentials-abonnement, gedeeld tussen servermonitoring en uptime-monitors. Zie piketdienst.
- Uptime-monitors: HTTP-, poort-, ping- en keyword-checks op je diensten van buiten je netwerk, hetzelfde werk als Nagios
check_httpencheck_tcpgericht op je publieke endpoints. - Statuspagina’s: één statuspagina met eigen domein in Essentials, drie openbare of privépagina’s in Pro, met abonnees via e-mail (en via sms vanaf Pro). Zie statuspagina’s.
- Metrics overleven netwerkhaperingen: de agent zet niet-verstuurde data in een wachtrij op schijf en probeert opnieuw, zodat een korte ingest-storing of een reboot geen gaten in je grafieken achterlaat.
Waarom Hyperping kiezen in plaats van Nagios?
Niets te hosten, te patchen of te back-uppen
Nagios heeft een server nodig, een webserver, een set plugins en iemand die ze bijwerkt. Bij Hyperping is de agent het enige op je hosts, en de monitoringkant wordt gehost. Valt je Nagios-machine uit, dan verlies je monitoring en alarmering tegelijk. Dat risico verdwijnt.
Oproepen en roosters zitten in het product
In Nagios betekent een rooster: contacts en timeperiods aanpassen en herladen. In Hyperping definieer je één keer een rooster en een escalatiebeleid, en servers, uptime-monitors en statuspagina’s lopen er allemaal doorheen. Elke stap van het beleid heeft een eigen vertraging en eigen kanalen, dus een oproep waarop niemand reageert, gaat door naar de volgende persoon. Onze gids over escalatiebeleid en gids over piketroosters leggen uit hoe je ze opzet.
Klanten horen het van jou
Nagios heeft geen statuspagina. Met Hyperping kan het incident waarvoor je engineer is opgeroepen, op een statuspagina in je eigen huisstijl verschijnen die abonnees mailt, zonder tweede tool.
Is je Nagios-setup gekrompen tot "laat me weten wanneer een machine uitvalt en maak de juiste persoon wakker", en kosten de PagerDuty-rekening plus het onderhoud van Nagios meer dan de checks waard zijn? Dan is het logischer om opgeroepen te worden wanneer een server stilvalt, zonder zelf een monitoringserver te draaien dan de stack zelf te blijven onderhouden.
Wat Hyperping-gebruikers zeggen
"We hebben onze Hyperping-statuspagina openbaar gemaakt en die werd een cruciaal onderdeel van onze salespitches. We zijn trots op onze uptime en vinden het geweldig dat we die zo makkelijk met prospects en klanten kunnen delen."
Wat kost Hyperping?
- Free: 1 agent voor servermonitoring, 20 monitors met checks om de 5 minuten, 1 eenvoudige statuspagina
- Essentials: € 24 per maand bij jaarlijkse facturatie (€ 29 maandelijks) voor 5 serveragents, 50 monitors, 3 browserchecks, 1 statuspagina met eigen domein, piketdienst en escalatiebeleid, telefonische meldingen, 3 seats
- Pro: € 74 per maand bij jaarlijkse facturatie (€ 89 maandelijks) voor 20 serveragents, 250 monitors, 3 openbare of privéstatuspagina’s, abonnees via sms, SAML SSO voor het account, 10 seats
- Business: € 249 per maand bij jaarlijkse facturatie (€ 299 maandelijks) voor 100 serveragents, 1.000 monitors, 10 statuspagina’s, white labeling, auditlogs, 20 seats
Serveralarmering zit in alle betaalde abonnementen, en je kunt 14 dagen gratis proberen. De bewaartermijn van metrics hangt af van het abonnement: 7 dagen met een resolutie van 1 minuut en 6 maanden per uur in Essentials, tot 30 dagen per minuut en 13 maanden per uur in Business.
Waar Hyperping tekortschiet
Nog geen drempelalarmen op metricwaarden. Hyperping roept je op wanneer een server stopt met rapporteren. Het alarmeert op dit moment niet wanneer de CPU boven 90% komt of een schijf op 85% zit: dat zie je in het dashboard, maar het opent geen incident. Zijn waarschuwingen van Nagios check_disk de kern van hoe je werkt, laat ze dan voorlopig draaien of kies Checkmk of Zabbix.
Geen plugins of eigen checks op de host. Je kunt Hyperping niet op een Nagios-plugin, een check van een RAID-controller of een eigen script richten. De agent verzamelt een vaste set systeemmetrics.
Metrics die het vandaag niet binnenhaalt: CPU en geheugen per proces, swapgebruik, pakketfouten en aantallen schijfoperaties.
Geen SNMP, geen netwerkapparaten, geen self-hosted editie. Switches, routers, printers en UPS’en vallen erbuiten, en je kunt Hyperping niet binnen een air-gapped netwerk draaien. Daar passen LibreNMS, PRTG of Zabbix beter.
Is Hyperping iets voor jou?
Kies Hyperping als je vloot uit Linux-, macOS- of Windows-servers bestaat en niet uit netwerkapparatuur, als niemand de Nagios-machine nog wil beheren en als je nu betaalt voor een aparte tool voor oproepen en een statuspagina. Teams met veel investering in plugins of met veel SNMP-apparatuur kijken beter eerst naar Icinga, Checkmk of LibreNMS.
Icinga: het best als open source vervanger
Voor wie Icinga is gemaakt
Teams met jaren aan Nagios-configuratie en eigen plugins die een moderne engine willen zonder hun checks te herschrijven. Icinga begon in 2009 als fork van Nagios, en Icinga 2 werd opnieuw gebouwd met een eigen configuratietaal, terwijl het compatibel bleef met de plugin-API van Nagios.
Opvallende functies
- Draait Nagios-plugins ongewijzigd: je
check_*-scripts en Monitoring Plugins blijven werken. - Overzichtelijkere configuratie-DSL: apply-regels wijzen services toe aan hosts op basis van attributen, zodat één regel honderden servicedefinities vervangt.
- Icinga Director: een webinterface voor configuratie, met imports uit CMDB’s en cloud-API’s.
- REST API en native clustering: gedistribueerde monitoring over zones en satellites, zonder add-ons.
- Icinga for Windows: een framework op basis van PowerShell om Windows-hosts te monitoren.
- Icinga Notifications: een nieuwer onderdeel met roosters opgebouwd uit rotaties, en escalaties op basis van de leeftijd of ernst van een incident. Bij release 0.2.0 (november 2025) had het nog het label bèta.
Wat kost Icinga?
De open source editie is gratis voor een onbeperkt aantal hosts en services. Betaalde abonnementen volgens de abonnementspagina van Icinga:
- Module subscription: $ 2.000 per jaar (€ 2.000 in Europa) voor de enterprisemodules
- Repository subscription: $ 5.000 per jaar voor pakketten voor RHEL, SLES en Amazon Linux
- Support subscription: vanaf $ 15.000 per jaar, inclusief modules en toegang tot de repository
Aandachtspunten
Icinga haalt de ergste configuratiepijn van Nagios weg, maar je host, schaalt en upgradet nog steeds alles zelf: de core, de database, de webstack en Director. Notificatieroosters zijn er pas sinds kort en in bèta, dus de meeste Icinga-teams sturen alarmen nog door naar een aparte tool voor oproepen. Een openbare statuspagina is er niet.
Voor wie Icinga interessant is
Kies Icinga als je checks je belangrijkste bezit zijn en je ze allemaal wilt houden, met een betere engine, API en interface. Het is de kleinste stap weg van Nagios.
Checkmk: het best voor Nagios-compatibiliteit met automatische discovery
Voor wie Checkmk is gemaakt
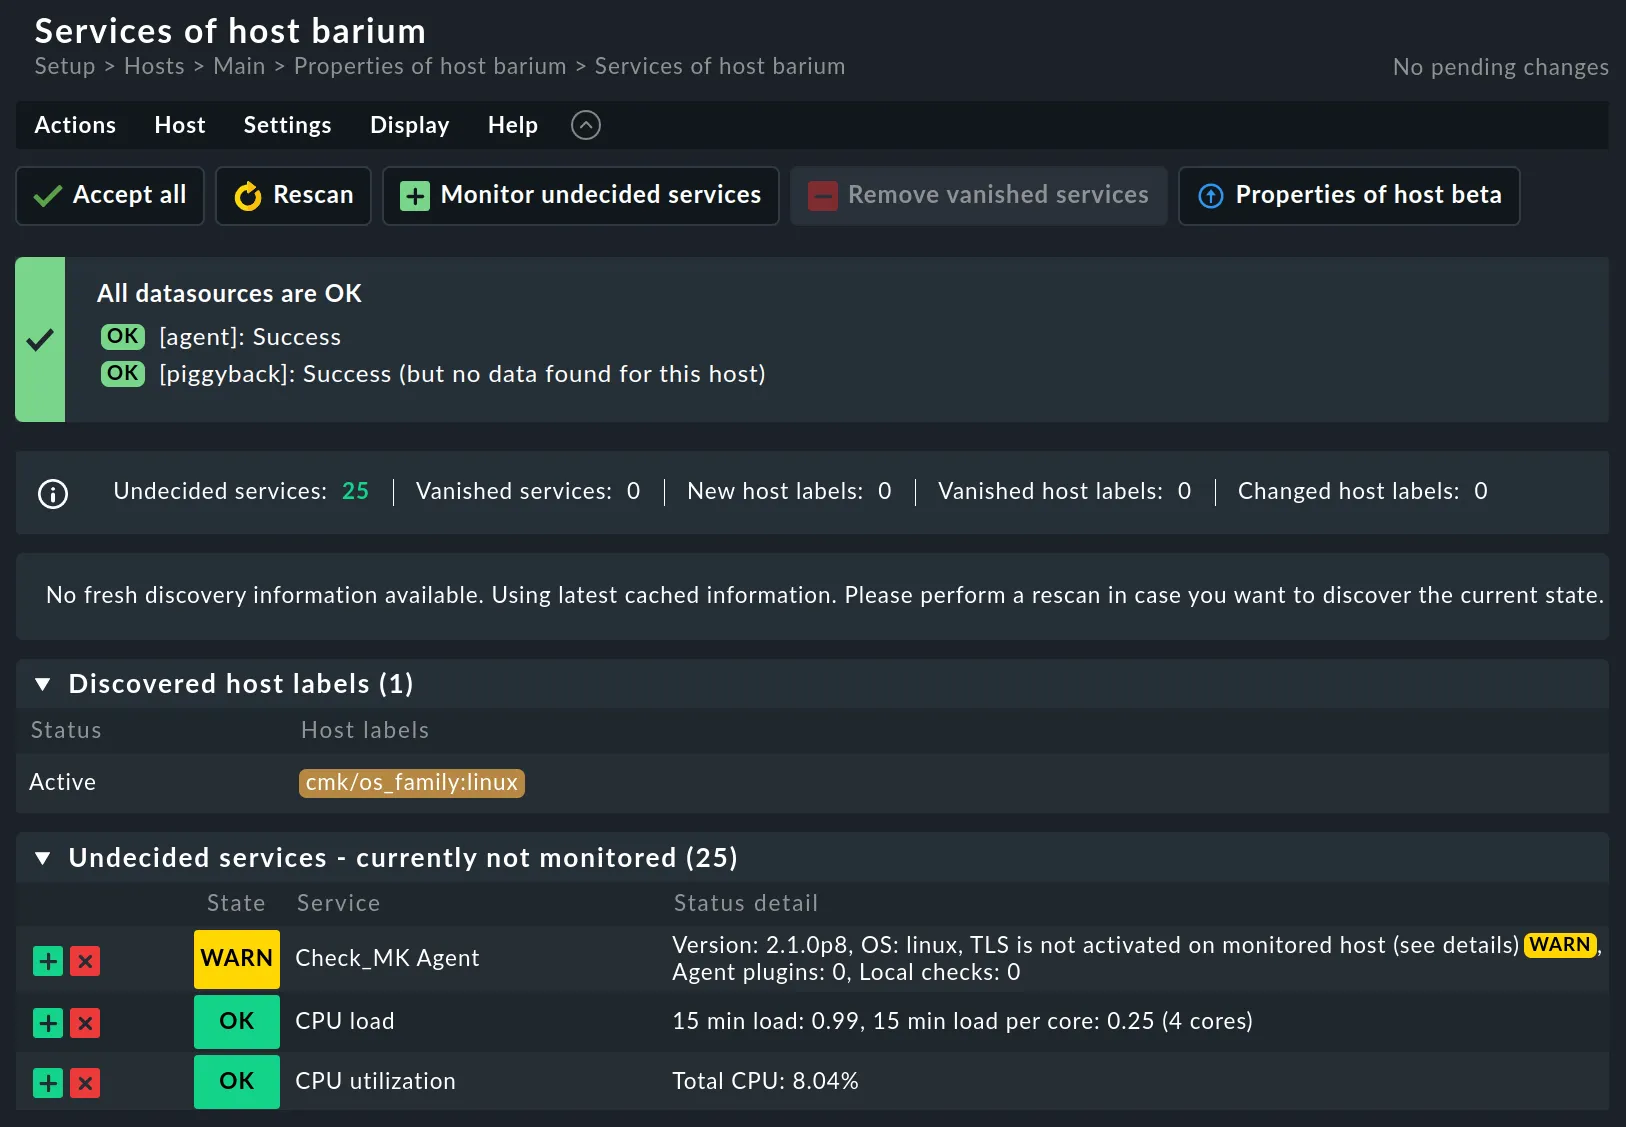
Ops-teams die het checkmodel van Nagios waarderen, maar genoeg hebben van config schrijven. Checkmk is voortgekomen uit het Nagios-ecosysteem, en de gratis editie gebruikt al lang de Nagios-core als engine. De agents ontdekken de services op elke host automatisch.
Opvallende functies
- Automatische service discovery: installeer de agent, start de discovery, en bestandssystemen, interfaces, services en processen verschijnen als checks.
- Configuratie via het web op basis van regels: drempels en notificatieregels stel je in de interface in, en ze gelden voor mappen of host-tags in plaats van voor losse objecten.
- Ondersteuning voor Nagios-plugins: bestaande plugins draaien als "classical" checks naast de eigen checks van Checkmk.
- Native agents voor Linux en Windows, plus SNMP voor netwerkapparaten.
- Checkmk Cloud: een beheerde SaaS-editie als je de server niet zelf wilt draaien.
Vanaf versie 2.5 hebben de edities een nieuwe naam: Raw heet nu Community, Enterprise heet Pro en Cloud heet Ultimate, met daarnaast een aparte gehoste Checkmk Cloud.
Wat kost Checkmk?
Volgens de prijspagina van Checkmk, met prijzen per service (ongeveer 30 services per host):
- Community: gratis en open source, bedoeld voor tot ongeveer 100 hosts
- Pro (self-hosted): vanaf € 190 per maand bij jaarlijkse facturatie
- Ultimate (self-hosted): vanaf € 275 per maand bij jaarlijkse facturatie
- Checkmk Cloud (SaaS): € 240 per maand bij maandelijkse facturatie voor 1.000 services, of € 2.400 per jaar (ongeveer € 200 per maand) bij jaarlijkse facturatie
Aandachtspunten
Prijzen per service betekenen dat je rekening meegroeit met het aantal dingen dat op elke host wordt ontdekt, niet alleen met het aantal hosts. De Checkmk-server draait alleen op Linux. Notificaties zijn krachtig maar gebaseerd op regels, en piketroosters komen nog steeds uit een integratie zoals PagerDuty of ilert, niet uit Checkmk zelf.
Voor wie Checkmk interessant is
Kies Checkmk als je de Nagios-manier van denken wilt houden (states, checks, drempels, plugins) met veel minder handgeschreven configuratie. Voor gemengde omgevingen met Linux, Windows en netwerkapparatuur, van 50 tot enkele duizenden hosts, is het de meest complete upgrade vanaf Nagios.
Zabbix: het best als gratis alles-in-één platform
Voor wie Zabbix is gemaakt
Infrastructuurteams die één open source systeem willen voor servers, netwerkapparaten, VM’s en applicaties, en bereid zijn hun monitoring opnieuw op te bouwen rond templates in plaats van Nagios-plugins één voor één over te zetten.
Opvallende functies
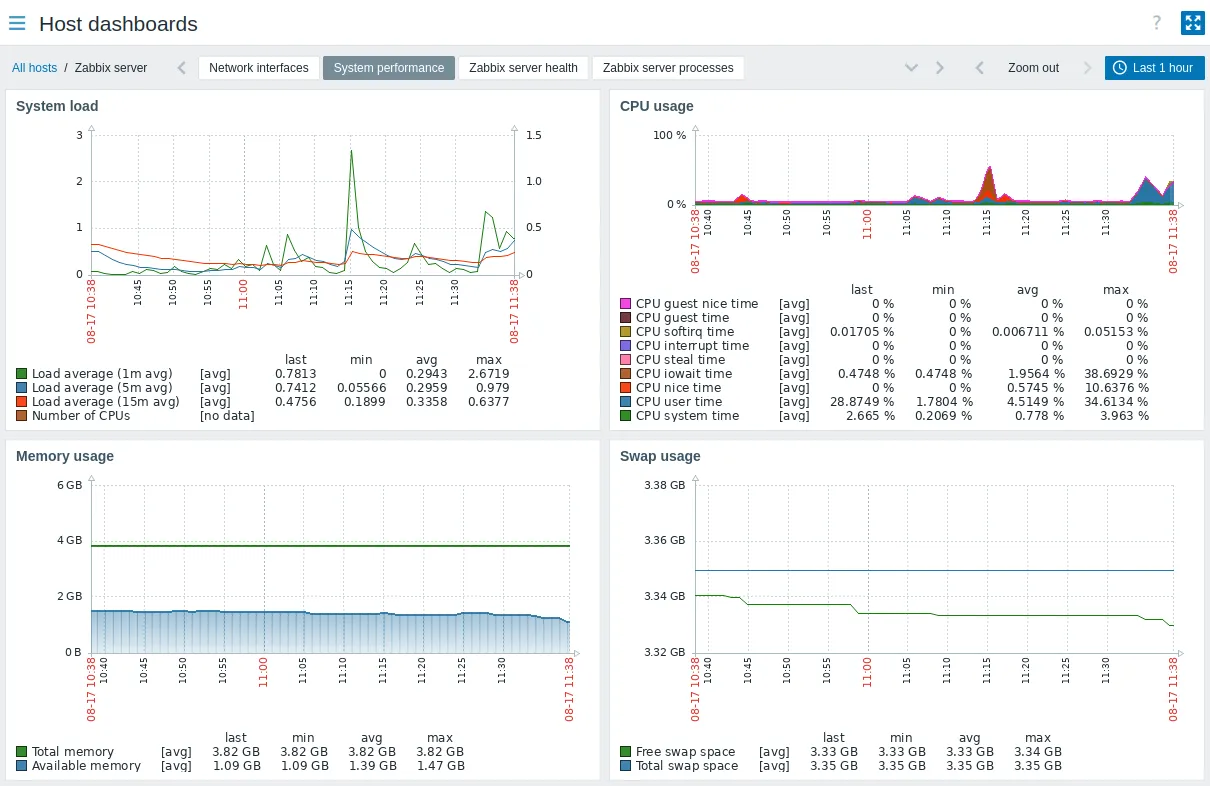
- Templates voor honderden apparaten en applicaties: Linux, Windows, MySQL, VMware, Cisco en meer, met vooraf gedefinieerde items, triggers en grafieken.
- Low-level discovery: bestandssystemen, interfaces en services op elke host worden automatisch ontdekt en gemonitord.
- Triggers met expressies: voorwaarden voor drempels, trends en afwijkingen, geëvalueerd op de server.
- Actions met escalatiestappen: stuur een bericht, wacht, waarschuw dan een andere groep of voer een commando op afstand uit.
- Native agents voor Linux en Windows, plus SNMP, IPMI en agentless checks.
Wat kost Zabbix?
Zabbix is gratis en open source: GPLv2 tot en met 6.4, en AGPLv3 vanaf versie 7.0. Zabbix Cloud begint bij $ 50 per maand (Nano-niveau, 50 nieuwe waarden per seconde) en loopt op tot $ 5.000 per maand, met een proefperiode van 5 dagen. Voor commerciële supportabonnementen maakt Zabbix een offerte.
Aandachtspunten
Zabbix leunt zwaar op de database: op schaal ga je MySQL of PostgreSQL tunen (vaak met TimescaleDB) en de housekeeping afstellen. Het model van templates en triggers heeft een eigen leercurve, en Nagios-plugins gaan niet zomaar mee. Escalaties bestaan binnen actions, maar er is geen piketkalender en geen openbare statuspagina.
Voor wie Zabbix interessant is
Kies Zabbix als je één gratis, zelf gehoste tool wilt die servers en netwerkapparatuur afdekt met drempels en trends, en je iemand hebt die de database en de templates kan beheren.
Prometheus + Grafana: het best voor cloud-native stacks en containers
Voor wie Prometheus is gemaakt
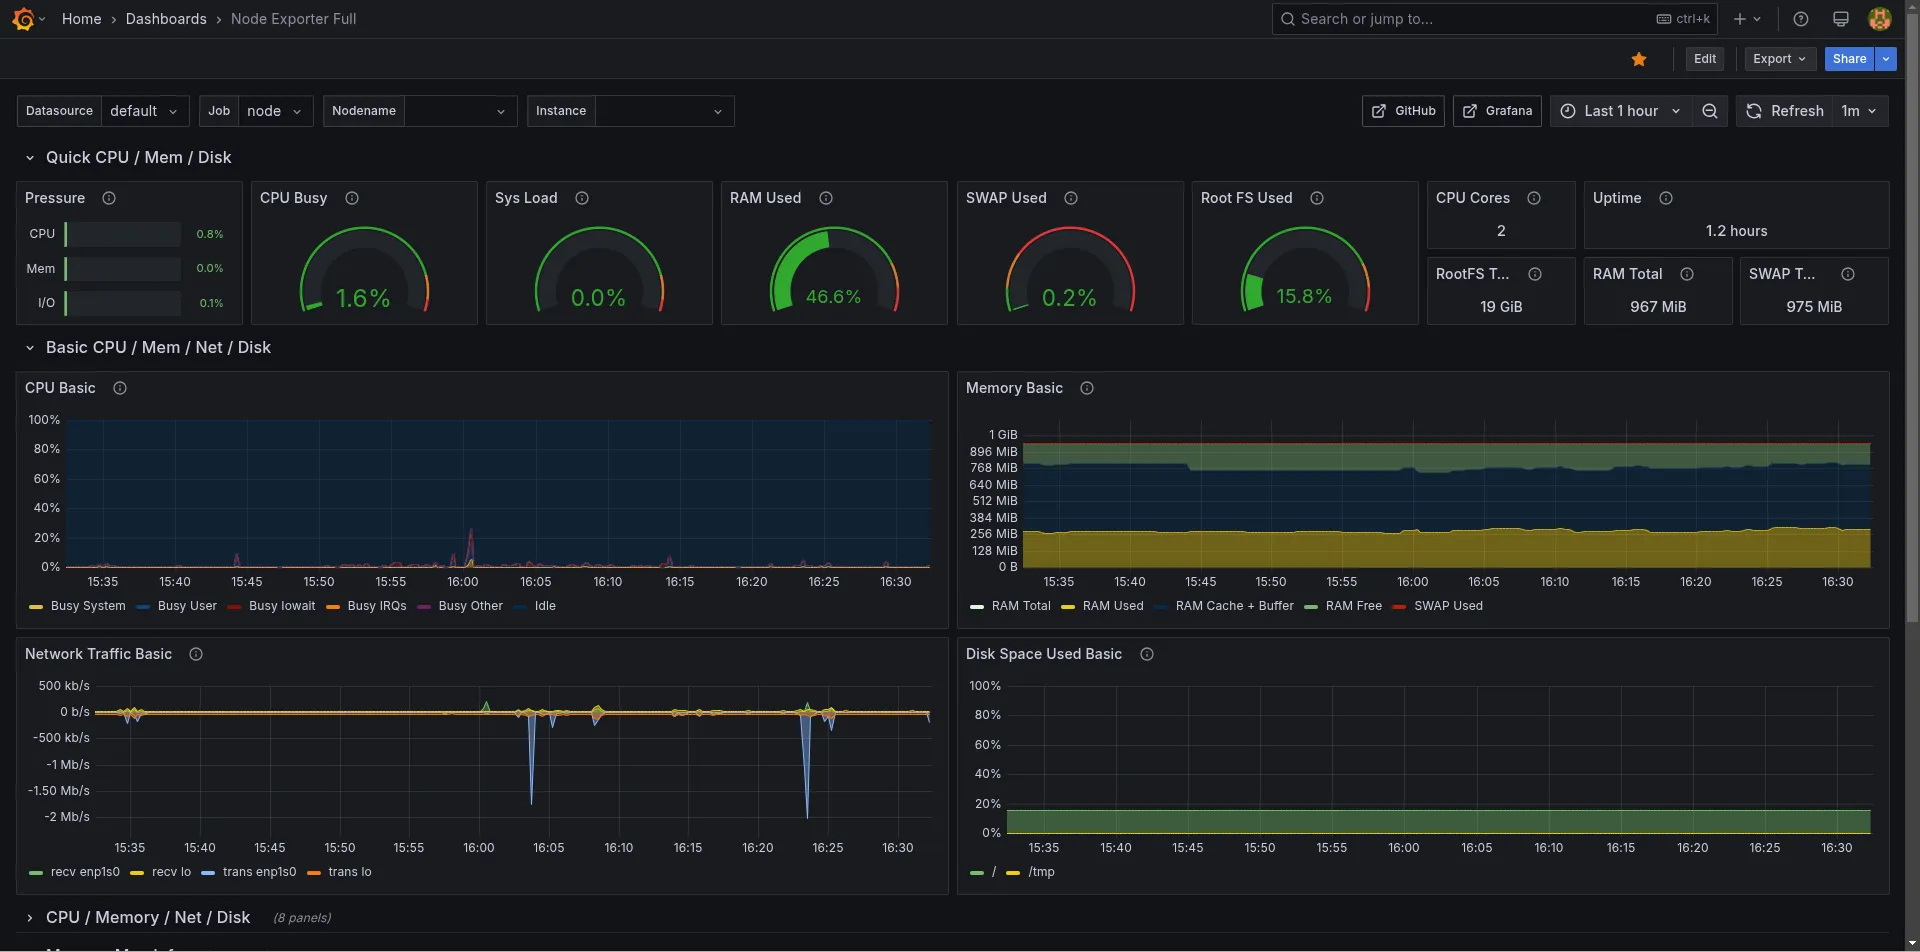
Teams die Kubernetes, containers of microservices draaien, waar hosts komen en gaan en een statische lijst met Nagios-hostdefinities het niet bijhoudt. Prometheus haalt metrics op bij exporters en services, Grafana visualiseert ze en Alertmanager routeert de alarmen.
Opvallende functies
- Pull-based metrics met service discovery: targets worden ontdekt via Kubernetes, Consul, EC2 en andere bronnen in plaats van met de hand opgesomd.
- PromQL: een querytaal die ruwe metrics omzet in rates, percentielen en alarmvoorwaarden.
- Exporters voor alles:
node_exportervoor Linux-hosts,windows_exportervoor Windows, en exporters voor databases, queues en hardware. - Alertmanager: groeperen, inhibition, silences en routering naar receivers.
- Grafana-dashboards: de feitelijke standaard voor het visualiseren van metrics.
Wat kost het?
Prometheus (Apache 2.0) en Grafana (AGPLv3) zijn gratis om zelf te hosten. Grafana Cloud heeft een gratis niveau met 10.000 actieve metricreeksen, 50 GB logs, 3 actieve gebruikers en 14 dagen retentie. Het Pro-niveau kost $ 19 per maand aan platformkosten plus verbruik. On-call zit in Grafana IRM: gratis voor 3 actieve IRM-gebruikers, daarna $ 20 per actieve IRM-gebruiker per maand.
Aandachtspunten
Dit is een stack, geen product. Je draait en schaalt Prometheus (plus Thanos, Mimir of VictoriaMetrics voor opslag op lange termijn), onderhoudt exporters en schrijft PromQL voor elk alarm. Prometheus is gebouwd voor metrics, dus voor checks als "antwoordt deze dienst nog" heb je de blackbox exporter nodig. Alertmanager routeert alarmen, maar heeft geen roosters en geen escalatie naar een tweede persoon. Daarom verkoopt Grafana IRM apart.
Voor wie Prometheus + Grafana interessant is
Kies het als je workloads in containers draaien, je engineers PromQL al lezen en je metrics-first monitoring wilt die met dynamische infrastructuur meebeweegt. Voor een statische vloot VM’s is het meestal meer machinerie dan het probleem vraagt. Voor een directe vergelijking, zie Datadog vs Grafana Cloud.
Netdata: het best voor metrics per seconde met nauwelijks installatiewerk
Voor wie Netdata is gemaakt
Engineers die iets willen installeren en meteen gedetailleerde metrics van een host willen zien, zonder configuratie te schrijven. De agent van Netdata detecteert services automatisch en verzamelt elke seconde metrics.
Opvallende functies
- Verzameling per seconde, met duizenden automatisch gedetecteerde metrics op elke host.
- Dashboards zonder configuratie voor de host en de applicaties die de agent vindt.
- Ingebouwde anomaliedetectie met ML op elke metric.
- Native Windows-agent naast Linux, macOS en containers.
- Honderden vooraf ingestelde alarmen die met de agent worden meegeleverd.
Wat kost Netdata?
Volgens de prijspagina van Netdata:
- Community: gratis, beperkt tot 5 actieve verbonden nodes en 1 eigen dashboard per room
- Homelab: $ 90 per jaar met een onbeperkt aantal nodes onder een fair-usebeleid
- Business: $ 7 per node per maand bij jaarlijkse facturatie ($ 8,75 maandelijks), met RBAC, SSO, een onbeperkt aantal dashboards en Netdata AI
- Enterprise: prijs op maat boven 500 nodes, met een on-premises optie
Aandachtspunten
De agent zelf is GPLv3, maar de volledige ervaring zit in Netdata Cloud, en de limiet van 5 nodes in het gratis niveau is krap voor een Nagios-vervanger. Op Windows is volgens de documentatie van Netdata het lokale dashboard vergrendeld in het gratis Community-niveau, dus bekijk je je data in Netdata Cloud. Alarmen gaan naar kanalen, maar er zijn geen piketroosters en geen statuspagina.
Voor wie Netdata interessant is
Kies Netdata als je diep, realtime inzicht wilt in afzonderlijke hosts om problemen op te lossen, en je een abonnement per node geen probleem vindt zodra je boven 5 nodes uitkomt.
Datadog: het best voor volledige observability

Voor wie Datadog is gemaakt
Engineeringorganisaties die infrastructuurmetrics, APM, distributed tracing, logs en synthetics op één plek gecorreleerd willen zien, en het budget hebben voor prijzen per host, per GB en per seat.
Opvallende functies
- Infrastructuurmonitoring met meer dan 1.000 integraties en 15 maanden retentie van metrics in Pro.
- APM, logs, RUM en synthetics op hetzelfde platform.
- Datadog On-Call voor roosters en escalaties, verkocht per seat.
- Status Pages als onderdeel van de Incident Response-suite van Datadog.
- Native agents voor Linux, Windows, macOS en containers.
Wat kost Datadog?
Volgens de prijspagina van Datadog:
- Free: tot 5 hosts met 1 dag retentie van metrics
- Infrastructure Pro: $ 15 per host per maand bij jaarlijkse facturatie, $ 18 on demand
- Infrastructure Enterprise: $ 23 per host per maand bij jaarlijkse facturatie, $ 27 on demand
- On-Call: $ 20 per seat per maand met een jaarabonnement, bovenop de infrastructuur
Aandachtspunten
Datadog vervangt Nagios en nog een paar tools tegelijk, maar de rekening is de som van hosts, custom metrics, ingest en indexering van logs, synthetische runs en seats. Teams die van het gratis Nagios Core komen, vinden die sprong vaak moeilijk te verantwoorden voor monitoring van het type "is de host gezond". Onze vergelijking Hyperping vs Datadog en gids met Datadog-alternatieven gaan in op de cijfers.
Voor wie Datadog interessant is
Kies Datadog als je APM en logs naast hostmetrics nodig hebt en je team die ook echt gebruikt. Heb je alleen hostgezondheid en alarmering nodig, dan betaal je voor een groot platform waarvan je het meeste niet aanraakt.
PRTG: het best voor een monitoringserver op Windows
Voor wie PRTG is gemaakt
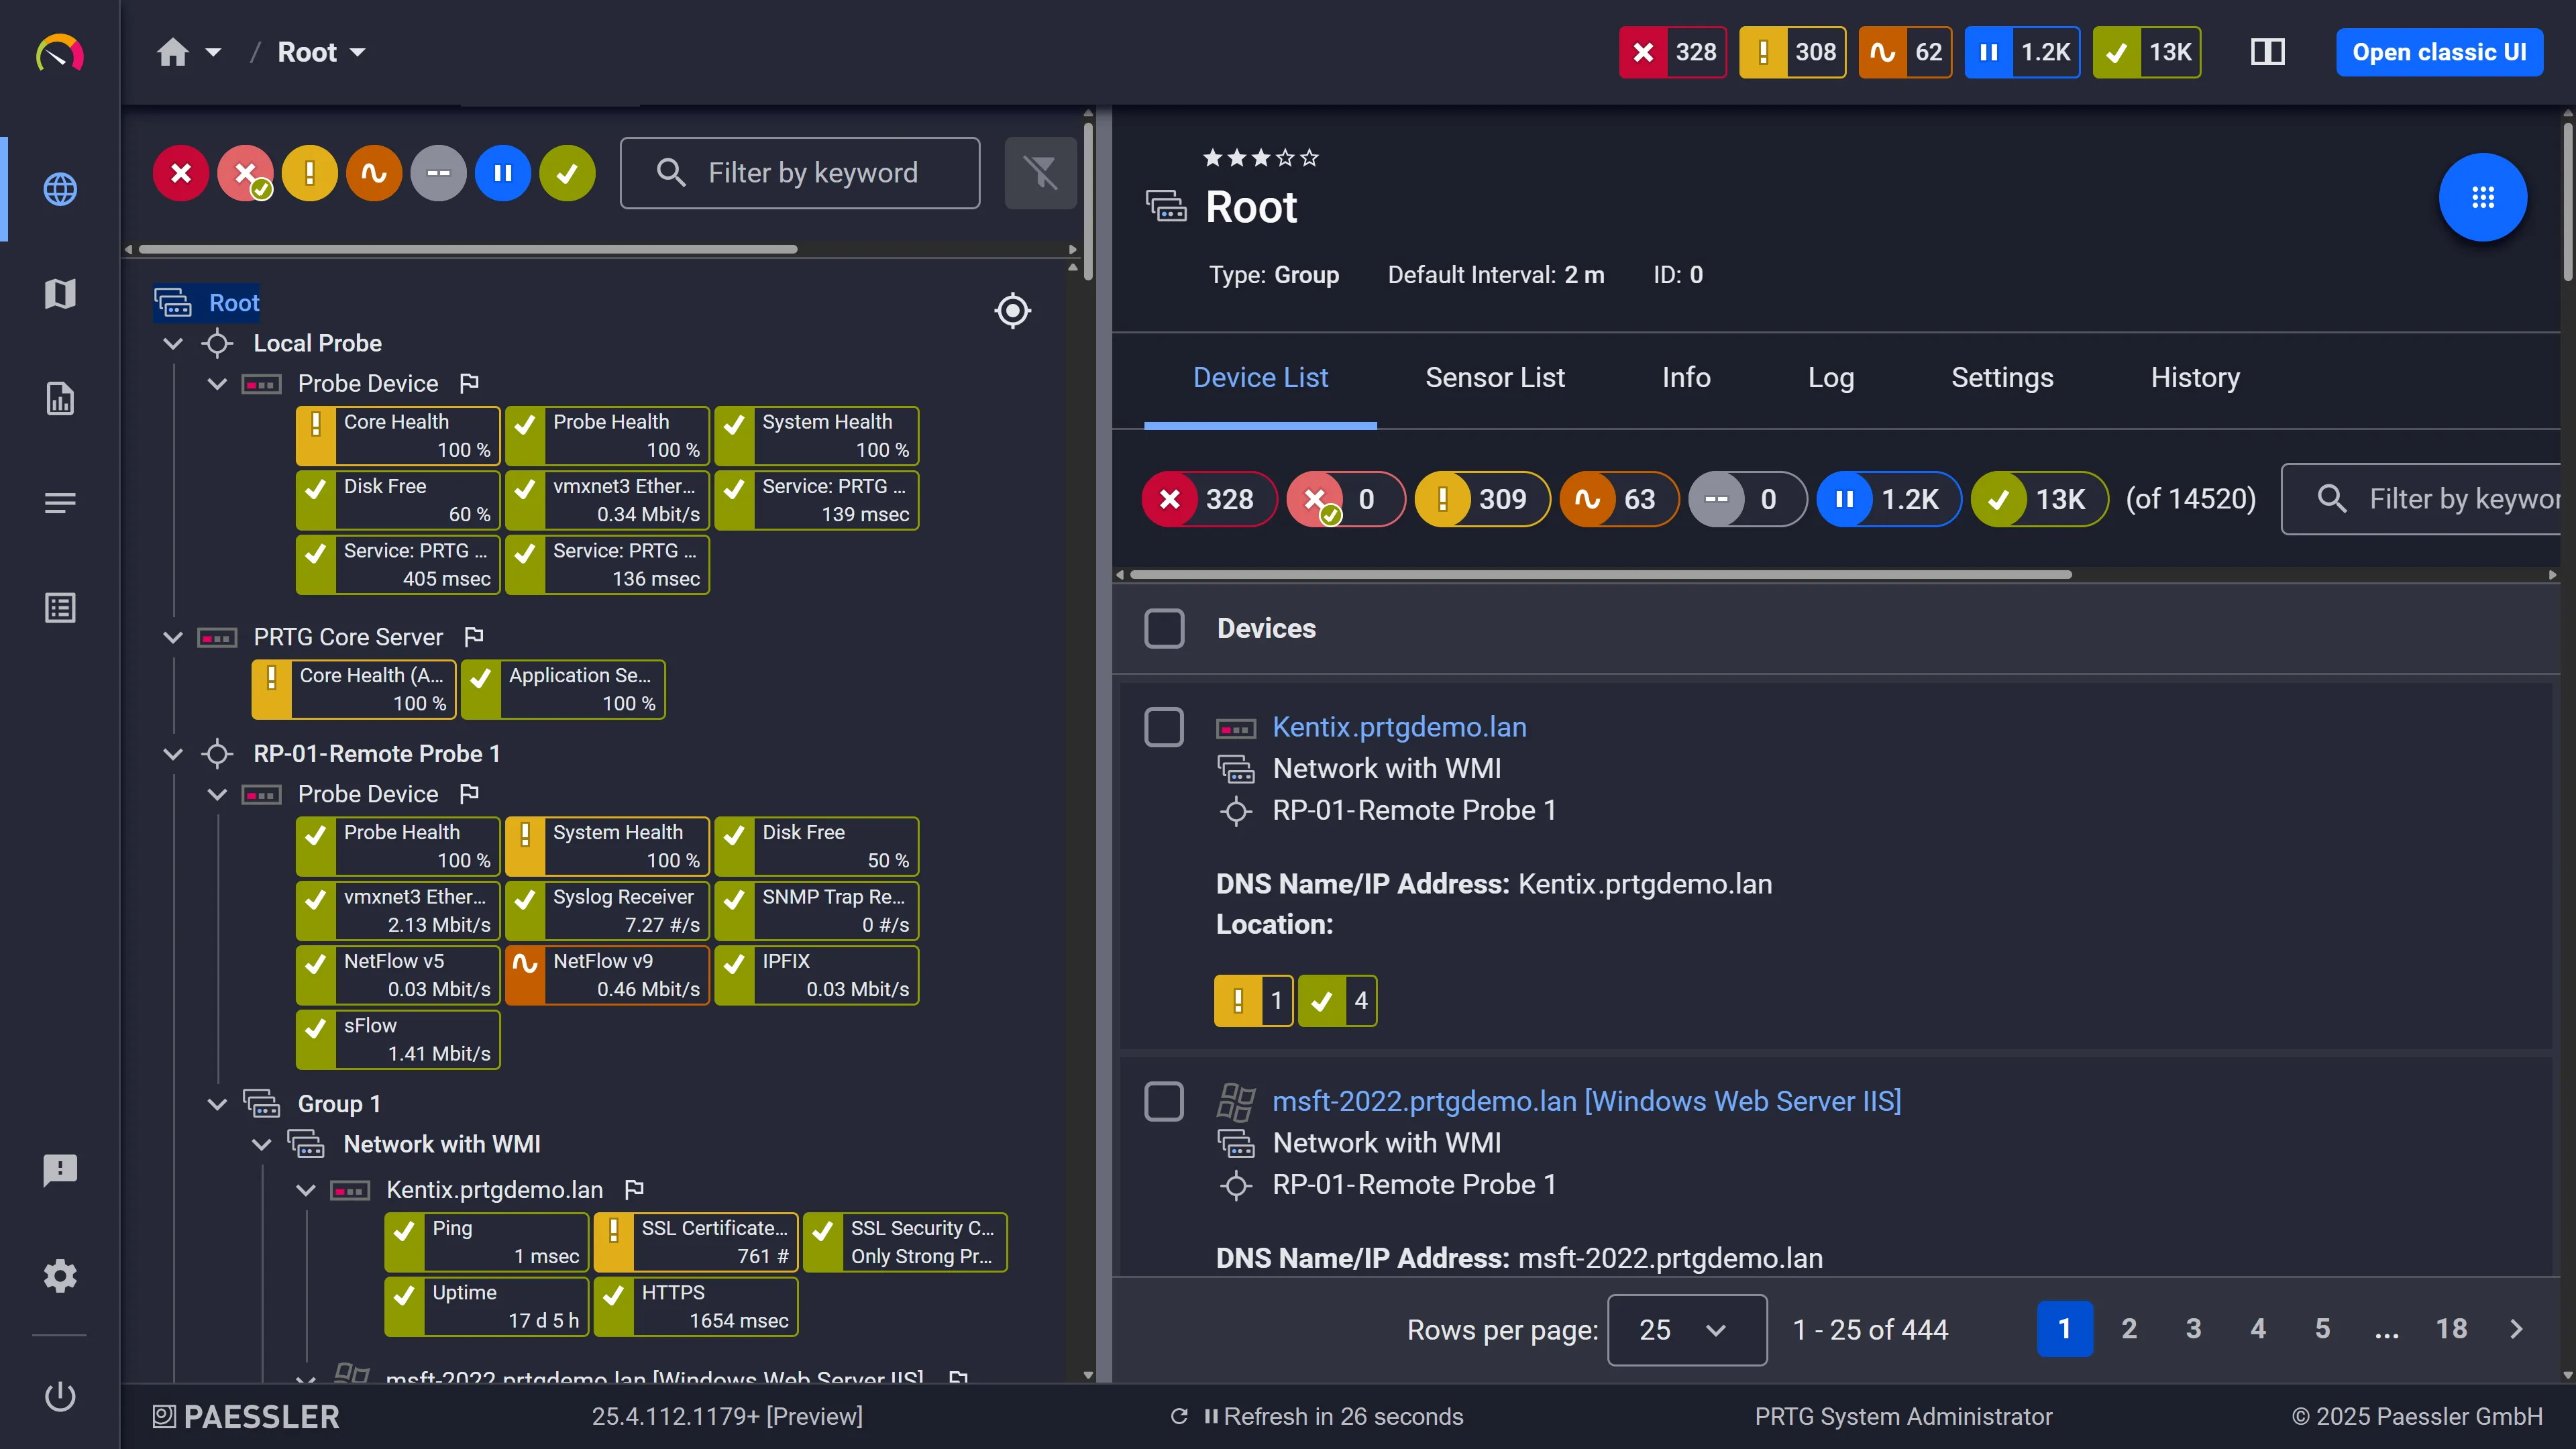
IT-afdelingen die rond Windows draaien en een monitoringserver willen die ze op Windows Server kunnen installeren, met een GUI voor alles en sterke netwerkdekking (SNMP, NetFlow, WMI).
Opvallende functies
- Model op basis van sensoren: elke metric op een apparaat (CPU, een poort, een service) is een sensor, met vooraf gedefinieerde sensortypes.
- Automatische discovery van apparaten in een netwerkbereik.
- Agentless Windows-monitoring via WMI en performance counters.
- Kaarten en dashboards die je in de webinterface bouwt.
- Remote probes, waaronder een multiplatform-probe voor Linux, om externe locaties te monitoren.
Wat kost PRTG?
Volgens de prijspagina van Paessler, alle abonnementen jaarlijks gefactureerd:
- Freeware: tot 100 sensoren (ongeveer 10 apparaten)
- PRTG 500: $ 200 per maand (500 sensoren, rond de 50 apparaten)
- PRTG 1000: $ 358 per maand
- PRTG 2500: $ 742 per maand
- PRTG 10000: $ 1.642 per maand
Boven 1.000 apparaten verwijst Paessler je naar PRTG Enterprise Monitor. Er is ook een gehoste versie, PRTG Hosted Monitor.
Aandachtspunten
De core server van PRTG draait alleen op Windows (Windows Server 2016 tot en met 2025, Windows 10 en 11). Het aantal sensoren loopt snel op: één server met CPU, geheugen, schijf, netwerk en een paar services kan 10 sensoren gebruiken. Notification triggers kunnen escaleren door te herhalen of andere contacten te waarschuwen, maar er zijn geen piketroosters en geen openbare statuspagina.
Voor wie PRTG interessant is
Kies PRTG als je team Windows-infrastructuur draait, alles via een GUI wil configureren en naast servers veel netwerkapparatuur monitort.
LibreNMS: het best voor netwerkmonitoring via SNMP
Voor wie LibreNMS is gemaakt
Netwerkteams die Nagios vooral gebruikten om switches, routers, firewalls en access points in de gaten te houden, en automatische discovery en grafieken per poort willen zonder servicedefinities te schrijven.
Opvallende functies
- Automatische netwerkdiscovery via CDP, FDP, LLDP, OSPF, BGP, SNMP en ARP.
- Brede ondersteuning van leveranciers voor netwerkbesturingssystemen, met grafieken van verkeer en fouten per poort en van de gezondheid van apparaten.
- Alertregels met transports naar e-mail, Slack, IRC en veel andere kanalen.
- Gedistribueerde polling voor grote netwerken.
- Docker-images voor een snellere installatie.
Wat kost LibreNMS?
LibreNMS is gratis en open source onder GPLv3. Er is geen betaalde editie. Support komt van de community.
Aandachtspunten
LibreNMS richt zich op netwerkapparaten. Het kan servers via SNMP monitoren en draait Nagios-plugins via een services-integratie, maar het is niet de natuurlijke keuze voor alarmering op applicatie- of hostniveau. Je host het zelf op Linux, en er zijn geen piketroosters en geen statuspagina.
Voor wie LibreNMS interessant is
Kies LibreNMS als je Nagios-configuratie vooral uit switches en routers bestond. Combineer het met een tool die op servers gericht is voor je hosts.
Open source alternatieven voor Nagios
Is open source een vereiste, dan verschillen de opties vooral in licentie en in hoeveel van je Nagios-werk je kunt meenemen:
| Tool | Licentie | Hergebruikt Nagios-plugins? | Sterk in |
|---|---|---|---|
| Icinga 2 | GPLv2 | Ja, ongewijzigd | Directe vervanger met API en clustering |
| Checkmk Community | GPLv2 | Ja, als classical checks | Automatische discovery en configuratie op basis van regels |
| Zabbix | AGPLv3 (7.0+) | Niet direct (via externe scripts) | Alles-in-één met templates en triggers |
| Prometheus + Grafana | Apache 2.0 / AGPLv3 | Nee (in plaats daarvan exporters) | Metrics voor dynamische stacks met containers |
| LibreNMS | GPLv3 | Deels, via services | Netwerkdiscovery en grafieken via SNMP |
| Netdata-agent | GPLv3 | Nee | Hostmetrics per seconde zonder configuratie |
Bij elk van deze tools moet je met twee dingen rekening houden. Ten eerste ben jij verantwoordelijk voor de uptime van je monitoring: valt de monitoringserver, de database of het netwerkpad ernaartoe uit, dan wordt niemand opgeroepen. Ten tweede heeft geen van deze projecten een openbare statuspagina, en alleen Icinga (in bèta) en Grafana (als betaalde cloud-add-on) bieden piketroosters. Reken op een tool voor oproepen, ook als de monitoring gratis is.
Gratis Nagios-alternatieven
"Gratis" betekent hier twee verschillende dingen: gratis software die je zelf host, of een gehost gratis abonnement met limieten.
Gratis zelf te hosten, zonder limiet op hosts: Icinga 2, Zabbix, Prometheus + Grafana en LibreNMS. Checkmk Community is ook gratis, bedoeld voor tot ongeveer 100 hosts. Wat het kost: de server, de opslag en de uren.
Gehoste gratis abonnementen:
- Hyperping Free: 1 serveragent, 20 monitors met checks om de 5 minuten, 1 eenvoudige statuspagina
- Netdata Community: 5 actieve nodes
- Datadog: 5 hosts met 1 dag retentie van metrics
- Grafana Cloud Free: 10.000 actieve reeksen, 3 gebruikers, 14 dagen retentie, 3 IRM-gebruikers
- PRTG Freeware: 100 sensoren (zelf gehost op Windows)
- Nagios XI Free: 7 nodes of 100 services
Voor een handvol servers heb je met een gehost gratis abonnement binnen enkele minuten monitoring. Daarboven zijn de open source tools alleen qua licentie gratis.
Nagios-alternatieven voor Windows
Windows komt in zoekopdrachten op twee manieren terug: de monitoringserver op Windows draaien, of Windows-hosts monitoren.
De monitoringserver op Windows draaien. Nagios Core draait niet op Windows, en de core van Icinga, de server van Checkmk, de Zabbix-server en LibreNMS evenmin (allemaal Linux). PRTG is de belangrijkste optie waarvan de server voor Windows is gebouwd, en het draait alleen daar. Gehoste tools (Hyperping, Datadog, Netdata Cloud, Grafana Cloud) omzeilen de vraag, want er is geen server om te installeren.
Windows-hosts monitoren. Met Nagios betekent dat NSClient++ of NCPA op elke machine plus plugins aan de kant van Nagios. De alternatieven zijn eenvoudiger:
- Hyperping: de agent installeert zich als Windows-service vanuit een PowerShell-venster als Administrator op Windows 10 of Windows Server 2016 en later. Hij rapporteert CPU, geheugen, elke stationsletter, schijf-I/O en netwerk, en leidt een load average af uit de lengte van de processorwachtrij, omdat Windows er zelf geen heeft. Zie de installatie-instructies voor Windows en de aankondiging van Windows-servermonitoring.
- Checkmk en Zabbix: native Windows-agents met service discovery en Windows-templates.
- Datadog en Netdata: native Windows-agents (het lokale dashboard van Netdata is vergrendeld in het gratis niveau).
- Prometheus:
windows_exporterstelt metrics uit WMI en performance counters beschikbaar. - PRTG: agentless monitoring via WMI en performance counters.
Welk Nagios-alternatief moet je kiezen?
- Je hebt honderden eigen Nagios-plugins en wilt ze houden: Icinga.
- Je wilt checks in Nagios-stijl zonder config te schrijven: Checkmk.
- Je wilt één gratis tool voor servers en netwerkapparatuur, met drempels: Zabbix.
- Je infrastructuur bestaat uit Kubernetes en containers: Prometheus + Grafana.
- Je monitort vooral switches en routers: LibreNMS, of PRTG als je een Windows-omgeving hebt.
- Je hebt ook APM, logs en traces nodig: Datadog.
- Je wilt hostgezondheid, uptime-checks, piketdienst en een statuspagina zonder zelf een monitoringserver te draaien: Hyperping.
Veel teams komen uit op twee tools: een open source tool voor diepgaande checks en netwerkapparatuur, en een gehoste tool voor oproepen en communicatie met klanten, zodat een storing van de monitoringserver niet ook de pager stillegt.
Zo vervang je de alarmering van Nagios door Hyperping
Je hoeft niet alles in één keer te migreren. Wat het best werkt: verplaats eerst de beschikbaarheid van hosts, de servicechecks, het oproepen en de statuscommunicatie, en laat Nagios draaien voor de checks die Hyperping niet afdekt, totdat je hebt besloten wat je ermee doet.
1. Installeer de agent op je servers
Klik in de weergave Servers op New server en kopieer het installatiecommando. Voer het uit op elke Linux- of macOS-host met sudo, of in een PowerShell-venster als Administrator op Windows. Voor een hele vloot geef je --name, --policy en --group (of de bijbehorende omgevingsvariabelen) mee vanuit Ansible of Terraform. Elke host verschijnt binnen ongeveer 30 seconden als online, met CPU, geheugen, schijf, netwerk en systeeminformatie.
2. Koppel een escalatiebeleid en stel de offlinedrempel af
Open het paneel Alerting van de server, koppel een escalatiebeleid en stel de offlinedrempel in: lang genoeg om een netwerkhapering te overbruggen, kort genoeg dat je opgeroepen wilt worden. De standaard is 90 seconden. Test het door de agent op een niet-kritieke host te stoppen en te controleren of de oproep binnenkomt. De documentatie over serveralarmering behandelt de details.
3. Bouw je externe Nagios-checks na als monitors
Maak een lijst van de services check_http, check_tcp en check_ping die Nagios op je publieke endpoints uitvoert, en bouw ze na als HTTP-, poort-, ping- of keyword-monitors. Laat ze via hetzelfde escalatiebeleid lopen, zodat een dode host en een falend endpoint dezelfde persoon oproepen.
4. Stel piketroosters in
Vervang de contacts en timeperiods van Nagios door een piketrooster en laat de stappen van je escalatiebeleid ernaar verwijzen. Latere stappen kunnen, na de vertraging die je instelt, een tweede persoon of de teamlead oproepen.
5. Publiceer een statuspagina
Zet de diensten die klanten belangrijk vinden op een statuspagina op je eigen domein. Wordt er een incident geopend, plaats dan een update: abonnees krijgen die per e-mail.
6. Draai beide naast elkaar en zet Nagios daarna uit
Laat Nagios een tot twee weken doordraaien. Vergelijk wat elk van beide heeft opgemerkt en hoe snel de juiste persoon werd opgeroepen. Verwijder daarna de Nagios-checks die Hyperping nu afdekt, en beslis of wat overblijft (drempelchecks, SNMP, eigen plugins) een kleinere instantie van Nagios, Checkmk of Zabbix rechtvaardigt.
Zo test je deze tools
- Hyperping: gratis abonnement en 14 dagen proefperiode
- Icinga: gratis download; de modules Director en Icinga Web zijn ook gratis
- Checkmk: Community is gratis; proefperiodes van 30 dagen voor Pro, Ultimate en Checkmk Cloud
- Zabbix: gratis download; proefperiode van 5 dagen voor Zabbix Cloud
- Grafana Cloud: gratis niveau, zonder tijdslimiet
- Netdata: gratis voor 5 nodes
- Datadog: gratis voor 5 hosts, plus een gratis proefperiode van de betaalde abonnementen
- PRTG: proefperiode van 30 dagen zonder beperkingen, daarna freeware voor 100 sensoren
Test bij je evaluatie het hele pad van storing tot mens: zet een service op een testhost uit en meet hoelang het duurt tot de telefoon van de juiste persoon overgaat, niet alleen tot een dashboard rood kleurt.
Verder lezen
- Gids voor Linux-servermonitoring: CPU, geheugen, schijf en netwerk op je hosts
- Gids over escalatiebeleid: hoe je bepaalt wie wanneer wordt opgeroepen
- Piketroosters: een rooster opzetten waar mensen niet aan opbranden
- De beste PagerDuty-alternatieven: als je alleen de laag voor oproepen wilt vervangen
- Agent-based monitoring: wat een agent ziet dat externe checks niet zien
Verder vergelijken: Hyperping vs Netdata · Hyperping vs Datadog · Prijzen van Hyperping · Alle vergelijkingen
Veelgestelde vragen
Wat is het beste alternatief voor Nagios? ▼
Dat hangt af van welk deel van Nagios pijn doet. Icinga is de meest directe vervanger, omdat het dezelfde checkplugins draait met een overzichtelijkere configuratietaal. Checkmk blijft compatibel met de plugins, maar voegt automatische discovery via agents en configuratie via een webinterface toe. Zit de pijn niet in de checks maar in alarmering, roosters en communicatie met klanten, dan neemt Hyperping het oproepen en de statuspagina over met een gehoste agent, piketroosters en statuspagina’s vanaf € 24 per maand.
Wat zijn de beste open source alternatieven voor Nagios? ▼
Icinga 2 (GPLv2), Checkmk Community (GPLv2, voorheen Raw Edition), Zabbix (AGPLv3 sinds 7.0), Prometheus met Grafana (Apache 2.0 en AGPLv3), LibreNMS (GPLv3) en de Netdata-agent (GPLv3). Icinga en Checkmk hergebruiken Nagios-plugins, waardoor de migratie daar het eenvoudigst is. Bij Zabbix en Prometheus bouw je je checks vanaf nul opnieuw op.
Is er een gratis alternatief voor Nagios? ▼
Ja. Icinga 2, Checkmk Community, Zabbix, Prometheus en LibreNMS kun je gratis zelf hosten zonder limiet op het aantal hosts, al betaal je wel in servertijd en onderhoud. Gehoste gratis abonnementen zijn kleiner: Hyperping Free bevat 1 serveragent en 20 monitors, Netdata Community dekt 5 nodes, de gratis versie van Datadog dekt 5 hosts met 1 dag retentie en PRTG Freeware dekt 100 sensoren.
Wat is een goed Nagios-alternatief voor Windows? ▼
Nagios Core zelf draait niet op Windows: Windows-hosts worden gemonitord via agents zoals NSClient++ of NCPA. PRTG is de belangrijkste tool waarvan de server op Windows draait (de core server werkt alleen op Windows). Wil je Windows-hosts monitoren vanaf een Linux-server of een gehoste dienst, dan leveren Hyperping, Checkmk, Zabbix, Netdata en Datadog allemaal native Windows-agents, en Prometheus gebruikt windows_exporter.
Wordt Nagios in 2026 nog onderhouden? ▼
Ja. Nagios Core 4.5.14 verscheen op 5 augustus 2026 met beveiligingsfixes, en Nagios XI wordt verkocht en ondersteund door Nagios Enterprises. Teams vertrekken zelden omdat Nagios niet meer werkt. Ze vertrekken vanwege het configuratiewerk, het pluginonderhoud op elke host en het ontbreken van ingebouwde piketroosters en statuspagina’s.
Is Icinga beter dan Nagios? ▼
Voor de meeste teams wel. Icinga begon in 2009 als fork van Nagios, en Icinga 2 werd herschreven met een eigen configuratietaal, een REST API, native clustering en een moderne webinterface, terwijl het nog steeds Nagios-compatibele plugins draait. Het nadeel: je host en onderhoudt nog altijd alles zelf, ook de notificatielaag.
Wat kost Nagios XI vergeleken met de alternatieven? ▼
Nagios XI Standard is een eenmalige licentie vanaf $ 2.595 voor 100 nodes, met een verplicht onderhouds- en supportcontract na het eerste jaar om de premiumfuncties te behouden. Checkmk Pro begint bij € 190 per maand bij jaarlijkse facturatie, PRTG 500 kost $ 200 per maand bij jaarlijkse facturatie, Datadog Infrastructure Pro kost $ 15 per host per maand met een jaarabonnement, en Hyperping Essentials kost $ 24 per maand bij jaarlijkse facturatie voor 5 serveragents, 50 monitors, piketdienst en een statuspagina.