Meine Auswahl an Checkly-Alternativen: Hyperping (Playwright-Checks + Rufbereitschaft + Statusseiten zum Festpreis), Better Stack (Monitoring + Logs + Incidents), Datadog (Synthetics innerhalb einer vollständigen Observability-Plattform), Uptime.com (synthetisches Monitoring ohne Code + SLA-Reporting) und Cronitor (Cron-Job- + Uptime-Monitoring). Ich habe mir über 30 Tools angesehen und sie anhand von Bewertungen auf G2 und Capterra, eigener Produktrecherche und Gesprächen mit Engineering-Teams auf diese fünf eingegrenzt.
Checkly ist ein wirklich gutes Produkt. Der Monitoring-as-Code-Workflow, die CLI und die Playwright-Integration werden in Bewertungen durchweg gelobt. Die meisten Teams, die wechseln, tun das aus einem von vier Gründen: eine Abrechnung pro Lauf, die gründliches Testen bestraft, ein Modulbaukasten, bei dem Statusseiten und Ursachenanalyse extra kosten, keine integrierte Rufbereitschaft oder ein Code-first-Workflow, der alle außer Entwicklern außen vor lässt.
In diesem Ratgeber erfahren Sie:
- Warum Teams Checkly verlassen (auf Basis echter Nutzerstimmen, nicht von Spekulation)
- Fünf Alternativen, die konkrete Probleme lösen, bei denen Checkly passen muss
- Ehrliche Preisvergleiche mit echten Zahlen
- Welches Tool zu Teamgröße, technischer Reife und Budget passt
Wenn Sie Playwright-Browser-Checks ohne Zählung der Läufe wollen, Uptime-Monitoring, das Probleme in 30 Sekunden erkennt, Bereitschaftsplanung mit Eskalationsrichtlinien und Statusseiten in einem einzigen Festpreis-Tarif, dann liefert Hyperping genau das. Vereinbaren Sie eine Demo, um zu sehen, wie es funktioniert.
Das Wichtigste in Kürze
- Hyperping enthält Playwright-Browser-Checks, Uptime-Monitoring, Rufbereitschaft und Statusseiten in Festpreis-Tarifen ab 24 €/Monat, ohne Abrechnung pro Lauf.
- Better Stack vereint Uptime-Monitoring, Log-Management und Incident Response. Vom fehlgeschlagenen Check zu den zugehörigen Logs kommen Sie so auf einer einzigen Plattform.
- Datadog bettet synthetisches Monitoring in eine vollständige Observability-Suite ein (APM, Traces, Logs) und rechnet pro Testlauf ab: 12 $ pro 1.000 Browser-Testläufe.
- Uptime.com bietet einen visuellen Editor ohne Code für Transaktions-Checks, dazu über 30 Check-Typen und SLA-Reporting, ab 7 $/Monat.
- Cronitor ist die stärkste Wahl für Teams, die von Checkly vor allem die Heartbeat-Checks nutzen: zeitplanbewusstes Cron-Monitoring ab 2 $ pro Monitor.
Warum Sie diesem Ratgeber vertrauen können
Ich bin Léo, Gründer von Hyperping. Ja, ich habe also ein Interesse an einem dieser Tools. Ich habe aber auch erlebt, wie sich Teams für Wettbewerber entschieden haben, weil diese tatsächlich besser passten. Mein Ziel ist nicht, Sie davon zu überzeugen, dass Hyperping immer die Antwort ist. Ich möchte Ihnen helfen zu verstehen, welches Tool Ihr Problem wirklich löst.
Ich habe Dutzende Bewertungen auf G2 und Capterra ausgewertet, Plattformen selbst getestet, die Preisseite von Checkly im Detail studiert und mit Engineering-Teams über ihre Erfahrungen gesprochen. Wo ich etwas nicht direkt testen konnte, habe ich mich auf verifizierte Nutzerstimmen und dokumentierte Quellen gestützt.
Die Auswahl auf einen Blick
| Am besten für | Produkt |
|---|---|
| Playwright-Checks + Rufbereitschaft + Statusseiten, Festpreis | Hyperping |
| Monitoring + Logs + Incident-Management in einer Plattform | Better Stack |
| Synthetics innerhalb einer vollständigen Observability-Plattform | Datadog |
| Synthetisches Monitoring ohne Code + SLA-Nachweis | Uptime.com |
| Monitoring von Cron-Jobs und Hintergrundaufgaben | Cronitor |
Warum Teams nach Checkly-Alternativen suchen
Checkly wird auf G2 stark bewertet, und die Rezensenten mögen durchweg die Playwright-Integration und den Monitoring-as-Code-Workflow. Die Kritik sammelt sich an anderer Stelle: wie die Nutzung abgerechnet wird, was extra kostet und wer im Team das Tool überhaupt bedienen kann.
Abrechnung pro Lauf bestraft gründliches Testen
Checkly rechnet synthetisches Monitoring nach Check-Läufen ab. Der Team-Tarif enthält 12.000 Browser-Check-Läufe pro Monat, danach kosten weitere 1.000 Läufe 4 $ im Voraus (oder 6,25 $ als Überschreitung). Wiederholungen zählen als Läufe. Jeder parallele Standort zählt als Lauf. Ein Check alle 10 Minuten von drei Standorten aus verbraucht bereits über 13.000 Läufe im Monat, und das ist ein einziger Check. Die Aufschlüsselung der Checkly-Preise zeigt, wie sich Läufe, Regionen und Wiederholungen in jedem Tarif summieren.
Nutzer spüren das unmittelbar. Ein G2-Rezensent schrieb: „Man hat das Gefühl, für jeden Atemzug der eigenen App zur Kasse gebeten zu werden.“ Ein anderer beschrieb die praktische Folge: „Die größte Einschränkung sind die starren Nutzungskontingente, die es uns nicht erlauben, unsere gesamte Testsuite bei jedem Branch- oder Staging-Deployment auszuführen.“
Die Module summieren sich
Checkly bepreist Erkennung, Statusseiten und Ursachenanalyse als getrennte Module. Der Team-Tarif kostet 64 $/Monat für das Monitoring, dazu 30 $/Monat für Statusseiten und 39 $/Monat für die KI-gestützte Ursachenanalyse. Das sind 133 $/Monat vor jeder Überschreitung bei den Läufen, und White-Label-Statusseiten gibt es trotzdem nur in Enterprise.
Mehrere Rezensenten erwähnen außerdem die Lücke zwischen den Tarifen. Einer formulierte es so: „Das Preismodell könnte etwas flexibler sein, es gibt nicht genug Optionen zwischen den Tarifen, und das schränkt uns ziemlich ein, weil unsere Nutzung zwischen zwei Stufen liegt.“ Ein anderer merkte an: „Hochskalieren geht nur mit einem Enterprise-Tarif, und damit umzugehen macht keinen Spaß.“
Keine integrierte Rufbereitschaft und kein Incident-Management
Checkly erkennt Probleme und verschickt Alarme, aber die Frage, wer reagiert, wird an externe Tools wie PagerDuty, incident.io oder Rootly ausgelagert. Es gibt keine Bereitschaftsrotation, keine Eskalation, wenn die zuerst alarmierte Person nicht quittiert, und die Incident-Kommunikation auf Statusseiten ist begrenzt. Ein Rezensent aus einem Großunternehmen meinte: „Die Funktionen für Dashboard/Statusseite und Incidents/geplante Wartungen könnten umfangreicher sein, damit die Kommunikation mit Endnutzern während eines Ausfalls besser wird.“
Für ein Team, das Erkennung und Reaktion an einem Ort haben will, heißt das: ein zweites Abo und ein zweites Tool, das konfiguriert werden muss.
Code-first-Monitoring schließt einen Teil des Teams aus
Checks in TypeScript mit Playwright zu schreiben ist die zentrale Stärke von Checkly und zugleich sein Filter. Rezensenten, die nicht hauptberuflich entwickeln, merken das: „Manchmal wirkt es etwas zu technisch, gerade für Nicht-Entwickler. Fortgeschrittene Checks einzurichten oder manche Begriffe wirklich zu verstehen, kann dauern.“ Selbst Teams mit vielen Entwicklern erwähnen, dass „die Lernkurve für Teams, die zum ersten Mal Tests in Code schreiben, steil sein kann“.
Wenn Leute aus Support, QA oder Ops Checks anlegen oder ändern sollen, wird ein reiner Code-Workflow zum Engpass.
Eingeschränkte Datenresidenz in der EU
Bei Checkly können Sie nicht wählen, wo die Monitoring-Daten gespeichert werden. Mehrere europäische Rezensenten weisen darauf hin: „Die Optionen zur Datenresidenz sind begrenzt. Für Teams mit strengen Compliance-Anforderungen (vor allem in der EU) wäre mehr Kontrolle darüber, wo die Monitoring-Daten liegen, ein großes Plus.“ Ein anderer schrieb schlicht: „Da wir in der EU sitzen, würde ich gern den Speicherort der Daten wählen können.“
Schnellvergleich: Checkly-Alternativen
| Tool | Einstiegspreis | Am besten für | Größte Einschränkung |
|---|---|---|---|
| Hyperping | 24 €/Monat (50 Monitore) | Playwright-Checks + Rufbereitschaft + Statusseiten, eine Rechnung | Keine vollständige Observability-Plattform |
| Better Stack | Kostenlos; bezahlt ab 29 $/Monat | Monitoring + Logs + Incidents in einer Plattform | Modulare Preise summieren sich |
| Datadog | 12 $ pro 1.000 Browser-Testläufe | Synthetics verknüpft mit APM, Traces und Logs | Kosten schwer vorherzusagen |
| Uptime.com | 7 $/Monat (10 Checks) | Synthetische Checks ohne Code und SLA-Reporting | Keine Bereitschaftsplanung, keine Eskalation |
| Cronitor | Kostenlos; 2 $ pro Monitor | Cron-Jobs und Hintergrundaufgaben | Keine Playwright-Browser-Checks |
Hyperping: Am besten für Playwright-Checks mit Rufbereitschaft und Statusseiten inklusive
Für wen Hyperping gedacht ist
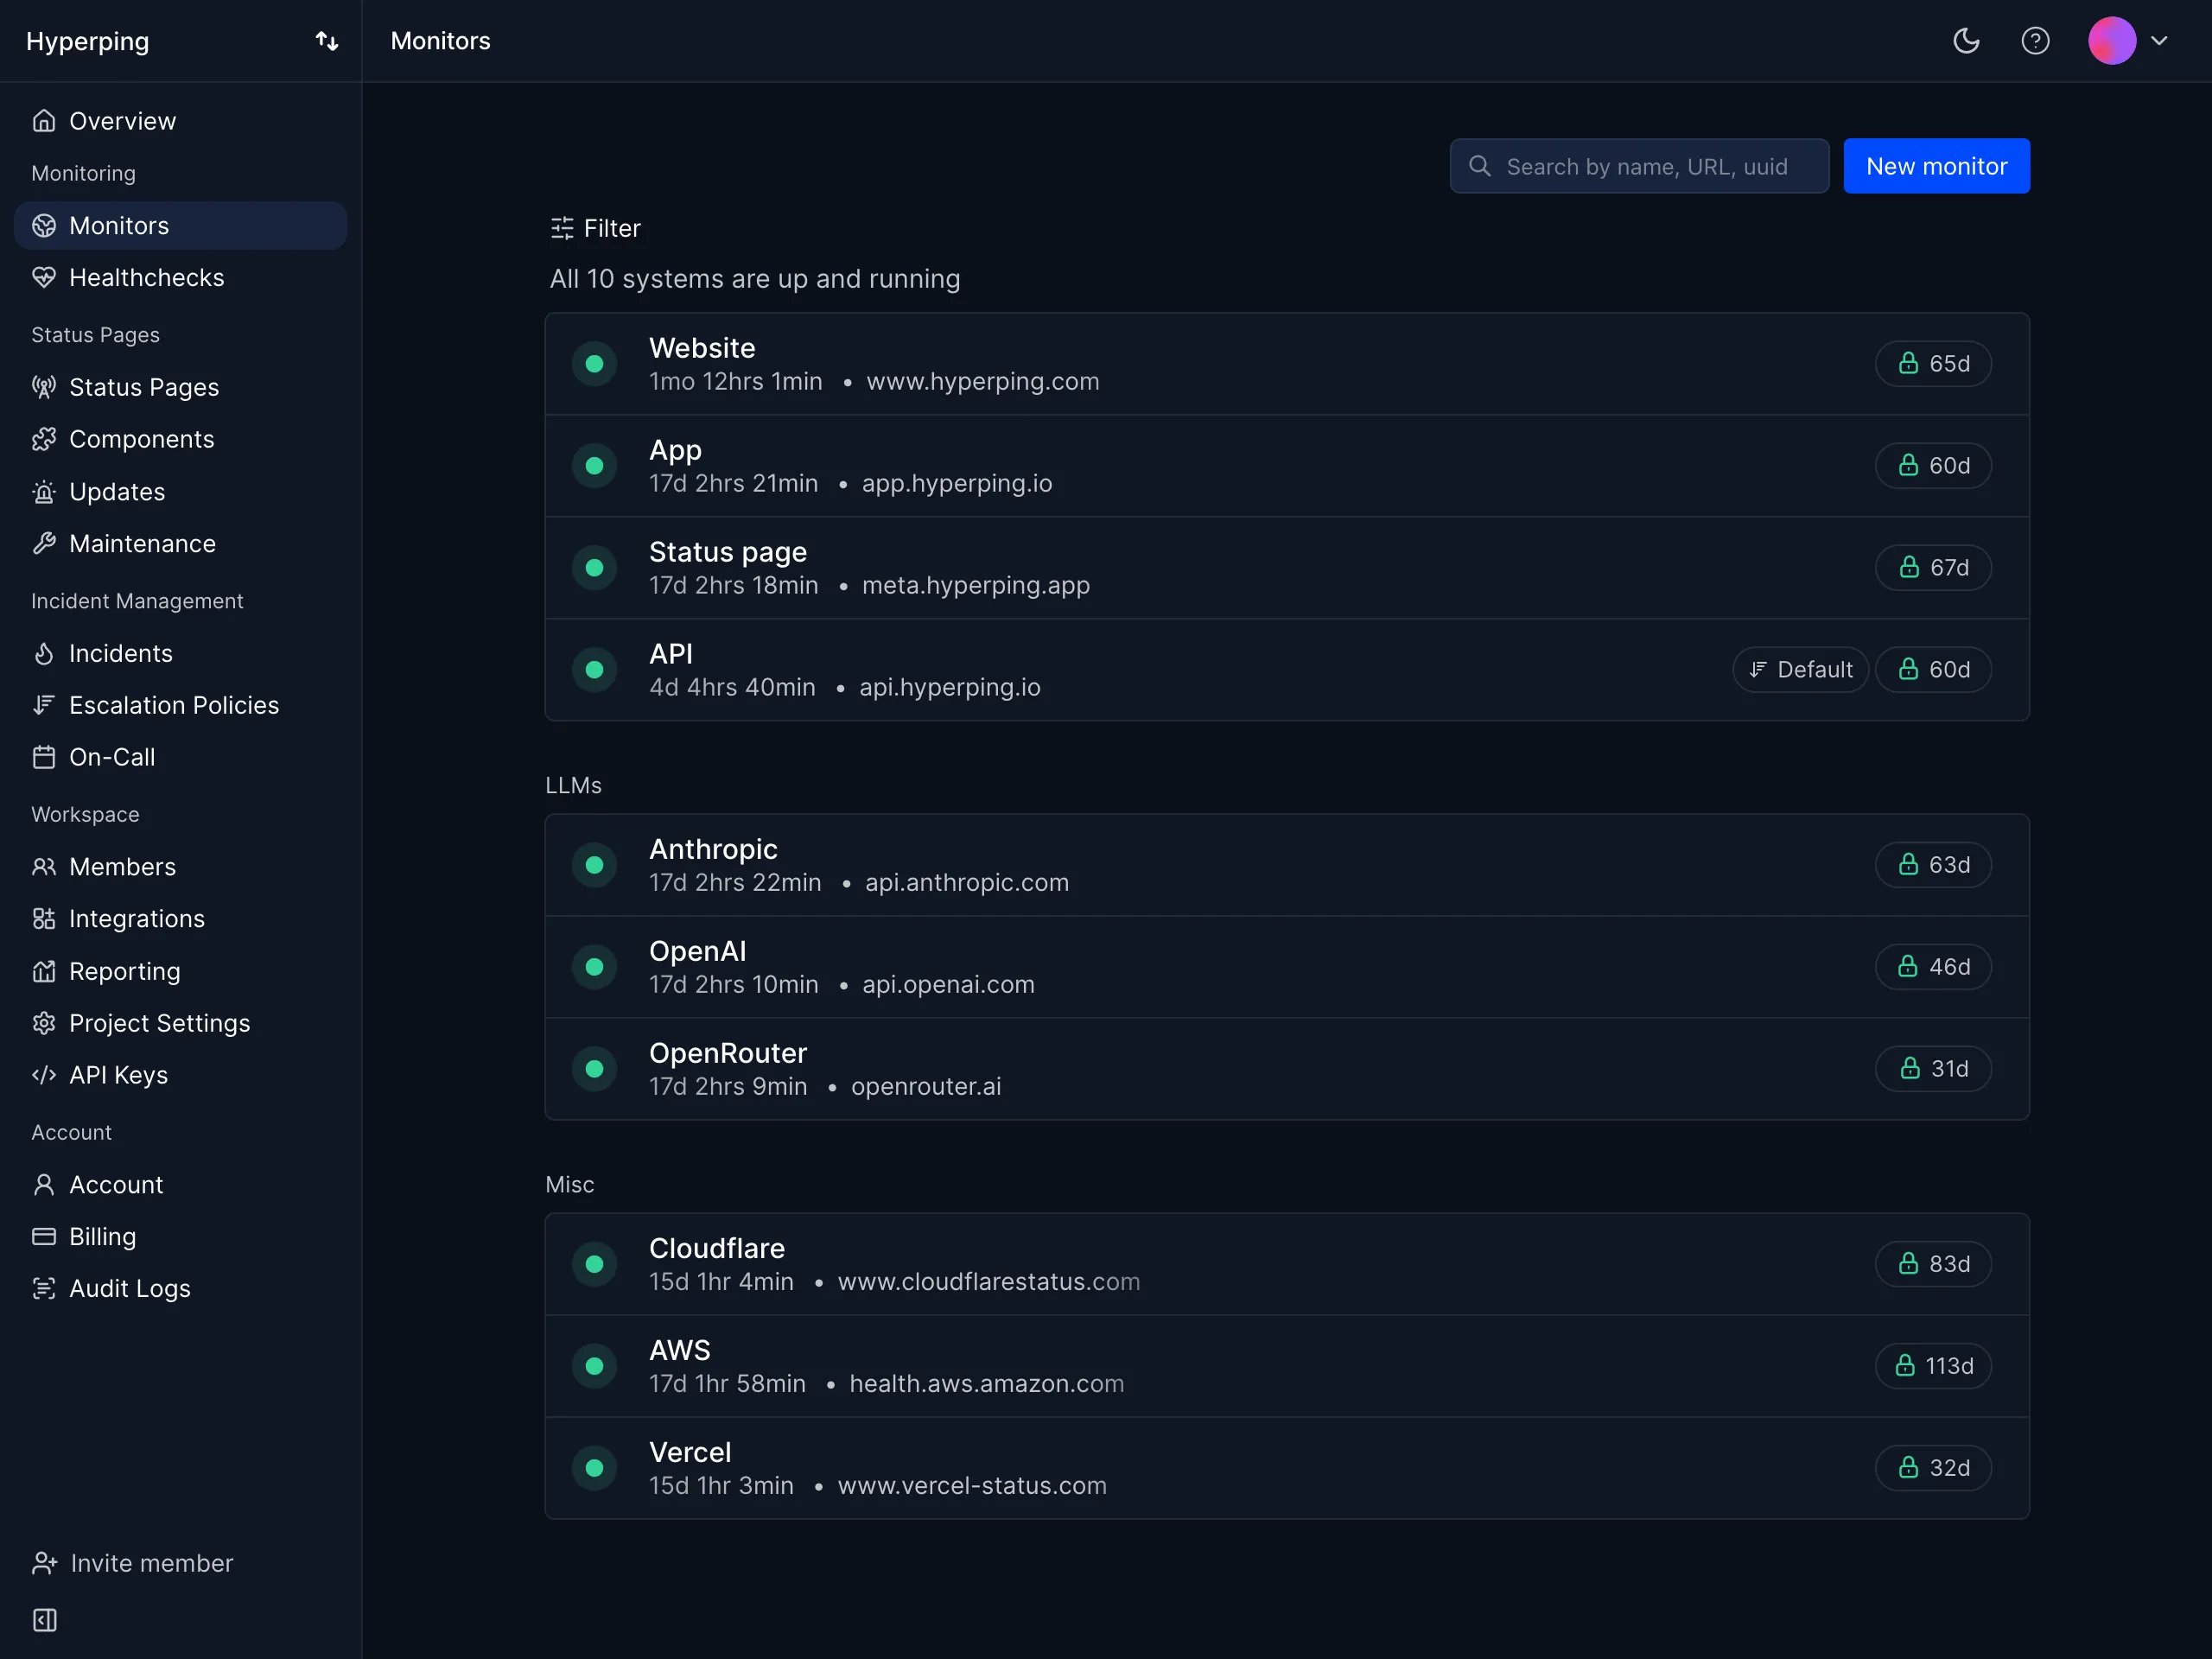
Für Teams, die den Playwright-basierten Ansatz von Checkly mögen, aber den Rest des Incident-Workflows (Bereitschaftsplanung, Eskalationsrichtlinien, Statusseiten) im selben Tarif haben wollen, ohne einen Laufzähler im Blick behalten zu müssen. Hyperping konzentriert sich darauf, das Wesentliche hervorragend zu machen, statt jede denkbare Funktion hinzuzufügen.
Nach den Bewertungen und Gesprächen, die ich ausgewertet habe, spricht Hyperping Teams an, denen Einfachheit und planbare Preise wichtig sind. Besonders beliebt ist es bei europäischen Unternehmen, weil Hyperping ein französisches Unternehmen mit Hosting in der EU ist. Das beantwortet direkt die Kritik an der Datenresidenz in den Checkly-Bewertungen.
Wichtige Funktionen
- Playwright-Browser-Checks ohne Zählung der Läufe: Schreiben Sie dieselben Playwright-Skripte, die Sie auf Checkly ausführen würden. Sie zahlen für eine Anzahl von Checks, nicht dafür, wie oft sie laufen.
- Schutz vor Fehlalarmen aus mehreren Regionen: Ein Fehler in einer Region löst eine Gegenprüfung aus anderen Regionen aus, bevor ein Alarm verschickt wird. Bei Checkly verbrauchen Wiederholungen und parallele Standorte abrechenbare Läufe, bei Hyperping ist die Gegenprüfung kostenlos.
- Bereitschaftsplanung und Eskalationsrichtlinien: Rotationen mit Zeitzonen, mehrstufige Eskalation und Quittierungen sind eingebaut. Checkly überlässt das PagerDuty, incident.io oder Rootly.
- Statusseiten inklusive: Eigene Domains, private Seiten, SSO und Benachrichtigungen für Abonnenten, statt eines separaten Moduls für 30 $/Monat.
- Uptime-Monitoring im 30-Sekunden-Intervall: HTTP-, TCP-, DNS-, ICMP- und Heartbeat-Checks aus 19 Regionen weltweit, dazu tägliche Prüfungen der SSL-Zertifikate.
- Monitoring as Code: Ein Terraform-Provider für Teams, die Checks zusammen mit ihrer Infrastruktur verwalten.
- Hosting in Europa: DSGVO-konforme Infrastruktur, alle Daten liegen in Rechenzentren in der EU.
Warum Hyperping statt Checkly?
Ein Tarif statt drei Modulen
Der vollständige Team-Stack von Checkly (Detect + Communicate + Resolve) kommt vor Überschreitungen bei den Läufen auf 133 $/Monat, und für die Rufbereitschaft brauchen Sie trotzdem ein externes Tool. Hyperping Pro deckt Monitoring, Browser-Checks, Statusseiten, Bereitschaftsplanung und Incident-Management in einem einzigen Tarif für 74 $/Monat ab.
Browser-Checks, die Sie nicht rationieren müssen
Das wiederkehrende Thema in Checkly-Bewertungen ist die Angst vor dem Kontingent: Teams verzichten auf Checks in Staging oder senken die Frequenz, um unter den Laufgrenzen zu bleiben. Die Browser-Checks von Hyperping laufen nach ihrem Zeitplan, ohne Zählung. Fehlalarme zu vermeiden oder öfter zu prüfen, treibt die Rechnung also nie in die Höhe.
Erkennung und Reaktion im selben Tool
Schlägt ein Check in Hyperping fehl, folgt der Alarm Ihrer Eskalationsrichtlinie, bis jemand quittiert: per Anruf, SMS, Slack, Teams oder Push. Anrufe sind unbegrenzt. Es gibt keine Übergabe zwischen einem Monitoring-Tool und einem separaten Alarmierungstool und kein zweites Abo mit Preis pro Nutzerplatz.
Einen Preisvergleich Zeile für Zeile finden Sie im Vergleich Hyperping vs. Checkly.
Was Hyperping-Nutzer tatsächlich sagen
„Hyperping hat für uns wirklich alles verändert. Der Dienst ist zuverlässig, einfach zu bedienen und unglaublich funktionsreich. Ich finde es großartig, dass er unsere Website ständig prüft und uns sofort alarmiert, wenn es ein Problem gibt.“
„Wir haben unsere Hyperping-Statusseite öffentlich gemacht, und sie ist zu einem zentralen Teil unserer Verkaufsgespräche geworden. Wir sind stolz auf unsere Verfügbarkeit und finden es toll, dass wir sie so einfach mit Interessenten und Kunden teilen können.“
Was kostet Hyperping?
- Essentials: 24 €/Monat für 50 Monitore, 3 Browser-Checks, 1 Statusseite, 3 Nutzerplätze
- Pro: 74 €/Monat bei jährlicher Abrechnung für 250 Monitore, 10 Browser-Checks, 3 öffentliche oder private Statusseiten, 10 Nutzerplätze. Enthält Zugangscodes per E-Mail, mehrsprachige Seiten und natives SAML-SSO für das Konto.
- Business: 249 €/Monat bei jährlicher Abrechnung für 1.000 Monitore, 25 Browser-Checks, 10 Statusseiten, Checks alle 20 Sekunden, 20 Nutzerplätze, Priority-Support und mehr
Alle kostenpflichtigen Tarife enthalten Bereitschaftsplanung, Eskalationsrichtlinien und Alarme per Anruf. Es gibt einen kostenlosen Tarif (20 Monitore und eine Statusseite) und eine 14-tägige Testphase für die bezahlten Tarife.
Wo Hyperping an Grenzen stößt
Hyperping will keine vollständige Observability-Plattform sein. Es gibt kein Log-Management, kein APM und kein Distributed Tracing, und keine KI-gestützte Ursachenanalyse wie das Resolve-Modul von Checkly. Wenn Ihr Workflow auf der Checkly-CLI aufbaut und Checks bei jedem Commit aus der CI deployt werden, ist das Monitoring-as-Code-Tooling von Checkly tiefer: Hyperping bietet Terraform und eine API, aber kein Gegenstück zu npx checkly deploy.
Auch die Browser-Checks werden in Playwright-Code geschrieben. Wie bei Checkly ist die synthetische Seite also auf Entwickler ausgerichtet. Teams, die Checks per Klick aufzeichnen möchten, sollten sich weiter unten Uptime.com ansehen.
Ist Hyperping das Richtige für Sie?
Wählen Sie Hyperping, wenn Sie beim Playwright-basierten synthetischen Monitoring bleiben, aber nicht mehr pro Lauf bezahlen wollen, und wenn Sie Rufbereitschaft und Statusseiten lieber inklusive haben, als drei Tools zu integrieren. Besonders stark ist es für SaaS-Teams, die kritische Abläufe wie Checkout oder Login überwachen, und für europäische Unternehmen, die Datenresidenz in der EU brauchen.
Better Stack: Am besten für Monitoring, Logs und Incidents in einer Plattform
Für wen Better Stack gedacht ist
Für Engineering-Teams, die Uptime-Monitoring, Log-Management und Incident Response auf einer einzigen Plattform vereinen wollen. Better Stack spielt seine Stärken aus, wenn Sie ohne Toolwechsel von „Check fehlgeschlagen“ zu „das sagen die Logs“ kommen wollen. Genau dieses Problem versucht Checkly mit seinem separaten KI-Modul zur Ursachenanalyse für 39 $/Monat zu lösen.
Nach dem, was ich aus den G2-Bewertungen herausgelesen habe, liegt die Stärke von Better Stack in der ausgefeilten Developer Experience. Nutzer loben durchweg die moderne Oberfläche und die schnelle Einrichtung. Ein Rezensent schrieb, es habe „wahrscheinlich die schönste Oberfläche, mit der Sie je arbeiten werden“.
Wichtige Funktionen
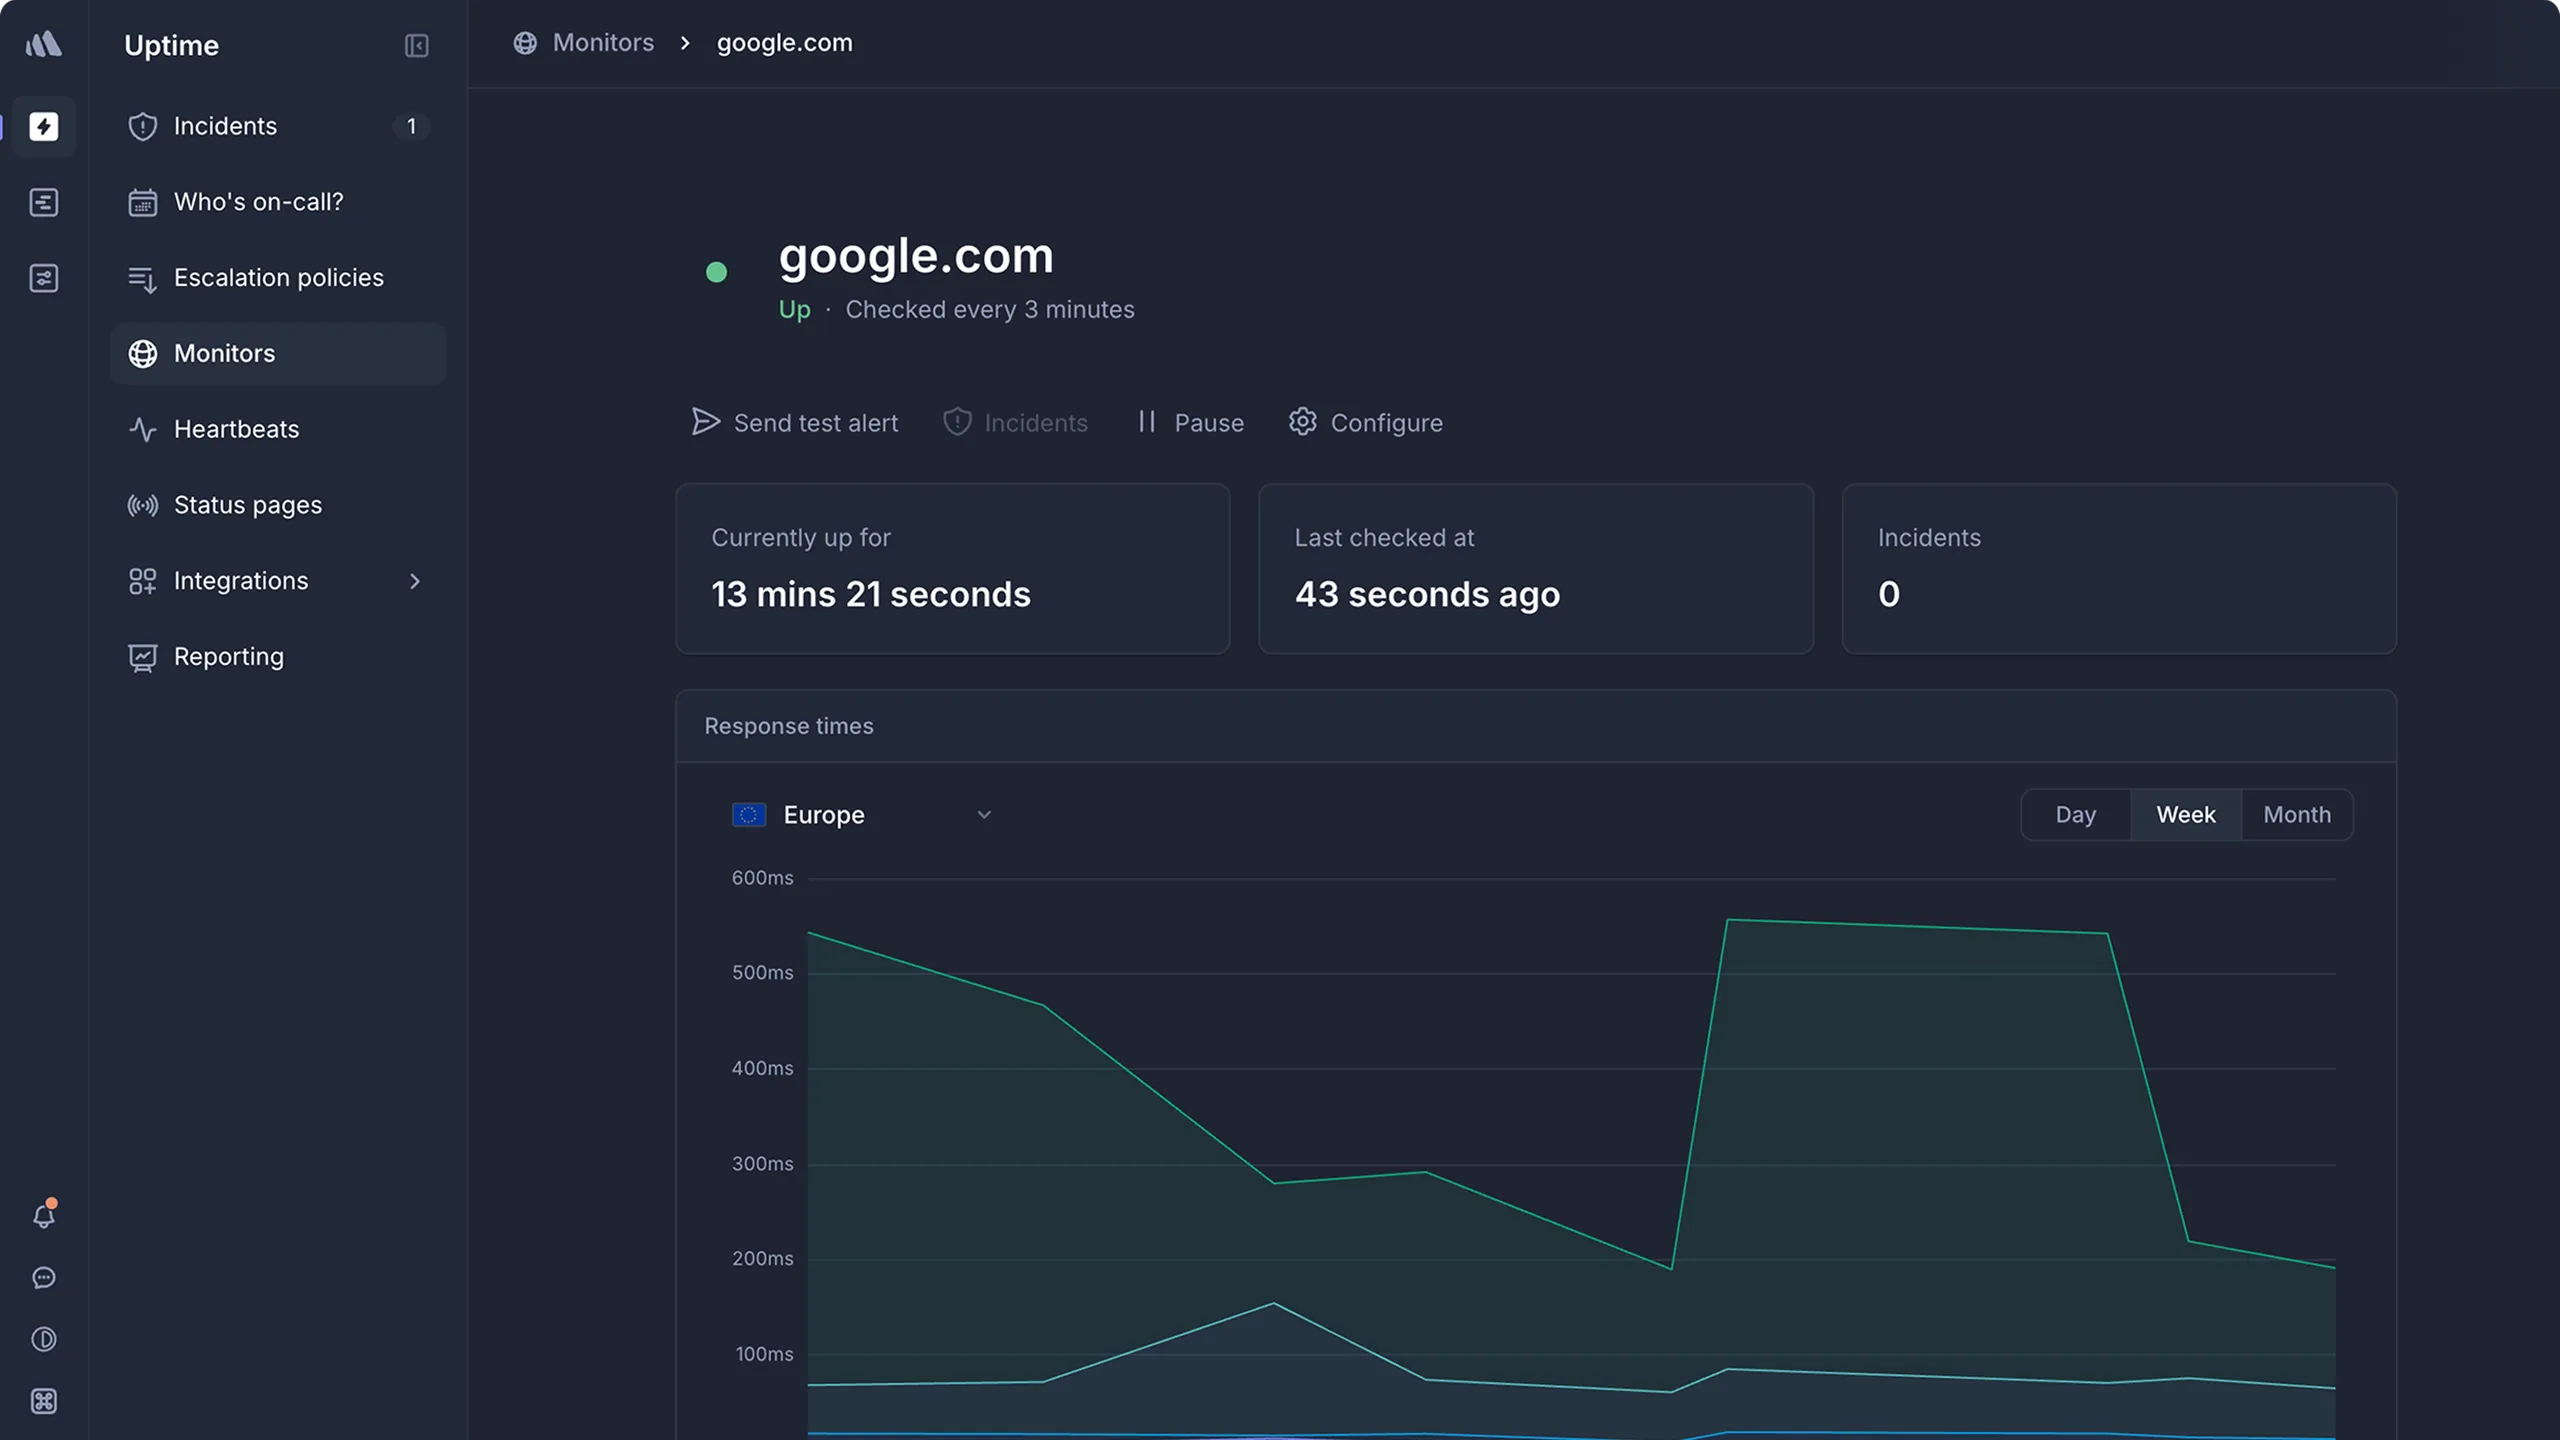
- Synthetisches Monitoring auf Basis von Playwright: Browserbasierte Transaktions-Checks zum Testen von Nutzerabläufen, mit demselben Framework wie bei Checkly.
- Uptime-Checks alle 30 Sekunden: Gegengeprüft aus mindestens drei geografischen Regionen, um Fehlalarme zu minimieren.
- Integriertes Log-Management: SQL-ähnliche Abfragen auf einem Speicher, der auf ClickHouse basiert. Schlägt ein Check fehl, liegen die passenden Logs auf derselben Plattform.
- Incident-Management: Bereitschaftsplanung, Eskalationsrichtlinien und KI-gestützte Post-Mortems sind eingebaut.
- Alarmierung über mehrere Kanäle: Anruf, SMS, Slack, Teams, E-Mail und Push-Benachrichtigungen mit Unterdrückung von Alarmrauschen.
- Statusseiten: Öffentliche und private Seiten mit Kommunikation im eigenen Branding.
Warum Better Stack statt Checkly?
Kontext zur Ursache ohne separates Modul
Checkly meldet Ihnen, dass ein Check fehlgeschlagen ist, und verkauft die KI-gestützte Ursachenanalyse als Add-on für 12 bis 39 $/Monat. Better Stack legt Ihre Anwendungslogs direkt neben das Monitoring. Einen Fehler zu untersuchen heißt dort, Logs im selben Tab abzufragen, statt in ein anderes Tool zu springen oder für ein weiteres Modul zu zahlen.
Incident Response ist Teil des Produkts
Better Stack enthält Bereitschaftsrotationen, Eskalationsrichtlinien und Incident-Management über Slack. Bei Checkly liegt diese gesamte Ebene in PagerDuty oder incident.io, mit zusätzlichen Kosten pro Nutzer.
Kostenloser Tarif ohne harte Laufgrenze
Der kostenlose Tarif von Better Stack enthält 10 Monitore, eine Statusseite und einfaches Logging. Der Hobby-Tarif von Checkly begrenzt Browser-Checks hart auf 1.000 Läufe pro Monat. Ein einziger Check im 30-Minuten-Takt von einem Standort aus überschreitet das bereits.
Was G2-Nutzer über Better Stack sagen
„BetterStack Uptime ist ein hervorragendes Tool, um die Verfügbarkeit von Websites und Diensten in Echtzeit zu überwachen. Die Oberfläche ist modern, einfach zu bedienen und im Alltag angenehm. Ich schätze, dass ich schnell Monitore einrichten, Alarme über mehrere Kanäle erhalten und professionelle Statusseiten mit Kunden teilen kann.“
„Es lässt sich schnell und einfach als externes Monitoring-Tool einsetzen, und es gibt einen kostenlosen Tarif. So können Unternehmen die Verfügbarkeit und Funktion ihrer Systeme testen, ohne sich finanziell groß festzulegen.“
G2-Bewertungen zu Better Stack
Was kostet Better Stack?
Better Stack nutzt ein modulares Preismodell, das sich über die Produkte hinweg summiert:
- Kostenloser Tarif: 10 Monitore, 1 Statusseite, begrenzte Aufbewahrung der Logs
- Monitore: 21 $/Monat pro 50 zusätzliche Monitore
- On-Call-Responder: 29 $ pro Nutzer und Monat
- Statusseiten: 12 $/Monat pro Seite + erweiterte Add-ons
- Heartbeat-Monitore: 17 $/Monat pro 10 Stück
Der Sprung vom kostenlosen zum bezahlten Tarif ist deutlich. Ein G2-Rezensent merkte an: „Der erste bezahlte Tarif beginnt bei 29 $, das ist für die kleinen Open-Source-Dienste, die ich betreibe, sehr happig.“
Wo Better Stack an Grenzen stößt
Wieder ein modulares Preismodell. Wenn Sie Checkly verlassen, weil sich die Module stapeln, hat Better Stack dasselbe strukturelle Problem: Gebühren pro Responder, pro Monitor-Paket und pro Statusseite machen die Gesamtkosten schwer vorhersehbar. Ein kleines Team landet schneller als erwartet bei 100 bis 200 $/Monat.
Keine nativen Metriken, kein Distributed Tracing. Better Stack kann Logs und Uptime gut, bietet aber nicht die Infrastrukturmetriken oder die APM-Tiefe von Datadog.
Grenzen beim Dashboard im großen Maßstab. Nutzer mit vielen Monitoren berichten von eingeschränkter Übersicht, und es gibt kein gemeinsames Dashboard, das den Status über mehrere Teams hinweg zeigt.
Diese Abwägungen behandle ich ausführlicher im Ratgeber zu Better-Stack-Alternativen.
Ist Better Stack das Richtige für Sie?
Wählen Sie Better Stack, wenn Ihnen bei Checkly vor allem der Kontext fehlt: Sie wollen den fehlgeschlagenen Check, die Logs dahinter und den Incident-Workflow in einem Produkt. Rechnen Sie aber damit, dass die Kosten steigen, sobald Sie Monitore, Responder und Statusseiten hinzufügen.
Datadog: Am besten für Synthetics innerhalb einer vollständigen Observability-Plattform

Für wen Datadog gedacht ist
Für Organisationen, denen eigenständiges synthetisches Monitoring nicht mehr reicht und die Browser-Tests mit Infrastrukturmetriken, APM-Traces und Logs verknüpfen wollen. Datadog spielt seine Stärken aus, wenn Sie von „der Login-Check ist fehlgeschlagen“ zu „das ist der verantwortliche Service, und das ist die Codezeile“ kommen müssen.
Nach dem, was ich aus den G2-Bewertungen herausgelesen habe, liegt die Stärke von Datadog in der Observability von Ende zu Ende. Teams entscheiden sich dafür, wenn es nicht reicht zu wissen, dass etwas ausgefallen ist, und sie in einem verteilten System verstehen müssen, warum.
Wichtige Funktionen
- Synthetisches Monitoring mit Test-Recorder: Browser-Tests lassen sich durch Aufzeichnen einer Sitzung erstellen, ganz ohne Code, und die Schritte bleiben danach editierbar. API-Tests decken HTTP, SSL, DNS, TCP und mehrstufige Abläufe ab.
- Metriken, Logs und Traces vereint: Schlägt ein synthetischer Test fehl, springen Sie direkt zum Backend-Trace genau dieser Anfrage und zu den Logs, die sie erzeugt hat.
- Über 650 Integrationen: Fertige Unterstützung für AWS, Azure, GCP, Kubernetes, Datenbanken und CI/CD-Tools.
- KI-gestützte Anomalieerkennung: Watchdog macht Anomalien in Metriken automatisch sichtbar und korreliert sie über Services hinweg.
- Real User Monitoring (RUM): Echte Nutzersitzungen mit Core Web Vitals, Session Replay und Frontend-Fehlern direkt neben Ihren synthetischen Daten.
Warum Datadog statt Checkly?
Vom Symptom zur Ursache auf einer Plattform
Checkly erkennt Ausfälle und hat vor Kurzem eine KI-gestützte Ursachenanalyse als kostenpflichtiges Modul ergänzt. Datadog verbindet den fehlgeschlagenen Browser-Test mit dem Trace, dem Pod und der Logzeile. Ein G2-Rezensent brachte es auf den Punkt: „Datadog hat in einem einzigen Paket die vielen verschiedenen Tools ersetzt, auf die unser Unternehmen angewiesen war. Früher haben wir Sentry, einen selbst gehosteten ELK-Stack, Grafana, Jaeger und OpsGenie genutzt.“
Synthetics, die Ihr ganzes Team erstellen kann
Mit dem Recorder für Browser-Tests von Datadog erstellen Leute aus QA und Support Tests, indem sie sich durch einen Ablauf klicken. Das entschärft die Kritik „zu technisch für Nicht-Entwickler“, die in Checkly-Bewertungen auftaucht. Entwickler können Tests weiterhin über Terraform und die API verwalten.
Monitoring, das mit dem Rest Ihres Stacks wächst
Wenn Sie Datadog bereits für Infrastruktur oder APM nutzen, bedeuten Synthetics einen Anbieter weniger, eine einzige Alarmierungspipeline und Dashboards, die synthetische Ergebnisse mit allem anderen kombinieren.
Was G2-Nutzer über Datadog sagen
„Am meisten gefällt mir an Datadog, dass Metriken, Logs und Traces an einem Ort zusammenkommen. Das Dashboard ist sehr intuitiv, und Echtzeit-Monitoring für Anwendungen und Infrastruktur ist schnell eingerichtet.“
„Die fertigen Integrationen mit AWS, Azure und Kubernetes sind ein großes Plus und sparen viel Einrichtungszeit.“
Was kostet Datadog?
Datadog rechnet nutzungsbasiert ab, und Synthetics werden wie bei Checkly pro Lauf berechnet:
- Synthetische API-Tests: 5 $ pro 10.000 Testläufe/Monat
- Synthetische Browser-Tests: 12 $ pro 1.000 Testläufe/Monat
- Infrastructure Monitoring: 15 $ pro Host und Monat (Pro)
- APM: 31 $ pro Host und Monat (Pro)
- Log Management: 0,10 $/GB aufgenommene Daten, plus Kosten für die Indexierung
Eine 14-tägige kostenlose Testphase bietet vollen Zugriff. Beachten Sie, dass Browser-Tests pro Lauf etwa doppelt so viel kosten wie der Überschreitungstarif von Checkly. Beim reinen Preis für Synthetics gewinnt Datadog daher selten, es gewinnt bei der Korrelation.
Wo Datadog an Grenzen stößt
Unvorhersehbare Preise sind die beständigste Kritik in den Bewertungen. Durch Log-Ingestion, Custom Metrics und APM-Spans können die Kosten aus dem Ruder laufen. Ein Rezensent merkte an: „Die Preise können schnell steigen, vor allem wenn man mehrere Funktionen wie Log-Management, APM und Custom Metrics aktiviert.“
Überdimensioniert für rein synthetisches Monitoring. Wenn Sie nur Browser-Checks, Uptime-Monitoring und eine Statusseite brauchen, ist die Plattform von Datadog (samt Lernkurve) weit mehr, als die Aufgabe verlangt.
Statusseiten stehen nicht im Mittelpunkt. Die Incident-Kommunikation gegenüber Kunden ist schwächer als bei spezialisierten Tools. Die meisten Datadog-Kunden kombinieren es mit einem separaten Statusseiten-Produkt.
Wenn die Preise von Datadog Ihr Problem sind, habe ich einen eigenen Ratgeber zu Datadog-Alternativen geschrieben.
Ist Datadog das Richtige für Sie?
Wählen Sie Datadog, wenn Sie als Team im Mittelstand oder in einem Großunternehmen verteilte Systeme betreiben und synthetische Checks mit Metriken, Traces und Logs verknüpfen wollen. Stellen Sie sich darauf ein, Zeit in das Erlernen der Plattform zu investieren und die Kosten genau im Auge zu behalten.
Uptime.com: Am besten für synthetisches Monitoring ohne Code und SLA-Nachweis
Für wen Uptime.com gedacht ist
Für Teams, die Transaktionen überwachen wollen, ohne Playwright-Code zu schreiben. Der visuelle Editor von Uptime.com baut mehrstufige synthetische Checks (Login, Formulare, Funnels) per Zeigen und Klicken. Damit ist es die naheliegende Wahl, wenn die Verantwortlichen für das Monitoring keine Entwickler sind.
Nach dem, was ich aus den Bewertungen herausgelesen habe, liegen die Stärken von Uptime.com in der Vielfalt der Check-Typen und im Fokus auf SLA-Compliance: Kunden die Verfügbarkeit mit unabhängigen Daten von mehreren Standorten weltweit nachweisen.
Wichtige Funktionen
- Synthetisches Monitoring ohne Code: Ein visueller Editor, mit dem sich Transaktions-Checks ohne Skripte erstellen lassen. Das ist die direkte Antwort an Checkly-Rezensenten, denen die Plattform „etwas zu technisch, gerade für Nicht-Entwickler“ war.
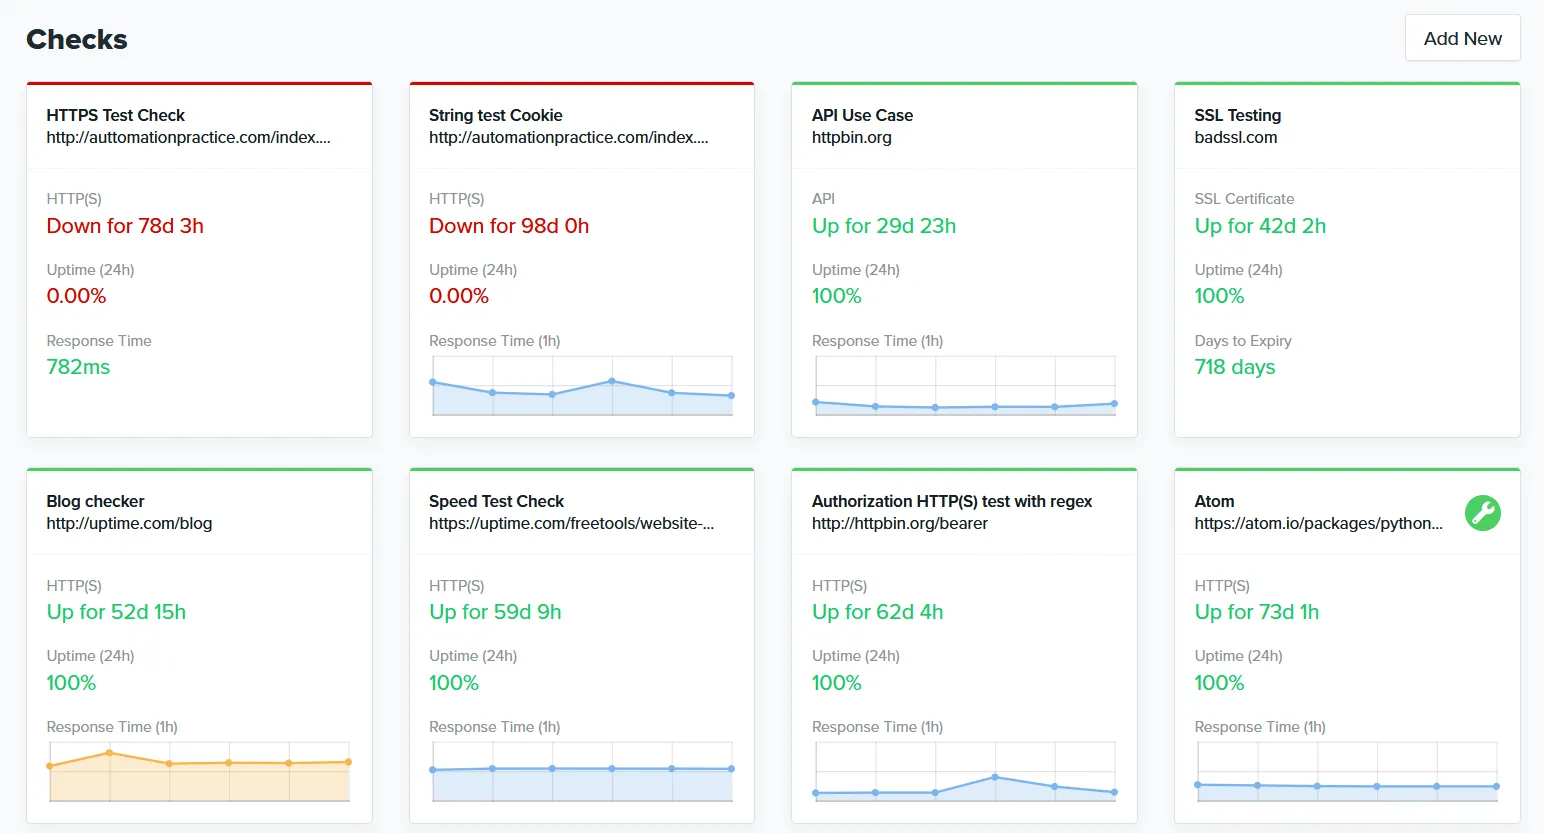
- Über 30 Check-Typen: HTTPS, Ping, DNS, SSL/Zertifikat, TCP/UDP, Whois/Domain, API-Monitoring, Transaktions-Monitoring, Seitengeschwindigkeit, Heartbeat-Monitoring und mehr.
- Über 80 Monitoring-Standorte weltweit: Dazu private Standort-Probes, um interne Anwendungen hinter Firewalls zu überwachen.
- Erweiterte Alarmlogik: Konfigurierbare Gegenprüfung, die Fehlalarme reduzieren soll.
- SLA-Reporting und Statusseiten: Öffentliche, private und SLA-Seiten für die Incident-Kommunikation.
- Mobile Apps: Native Apps für iOS und Android, die Checkly nicht anbietet.
Warum Uptime.com statt Checkly?
Synthetische Checks, die jeder im Team bauen kann
Die Checks von Checkly sind TypeScript und Playwright. Die Transaktions-Checks von Uptime.com entstehen in einem visuellen Editor. QA, Support und Ops können sie also anlegen und pflegen, ohne Entwicklungsumgebung und ohne Code-Review.
Alle Funktionen in jeder Preisstufe
Checkly stellt automatische Wiederholungen, alle 22 Standorte und private Standorte erst ab dem Team-Tarif bereit, Statusseiten und RCA sind separate Module. Uptime.com enthält alle Funktionen in jeder Stufe. Sie wählen nur die Anzahl der Checks und SMS-Alarme.
Unabhängiger SLA-Nachweis
Wenn Sie Synthetics betreiben, um Kunden die Einhaltung Ihrer SLAs nachzuweisen, ist das Reporting von Uptime.com genau dafür gebaut, mit Domain-Health-Checks und SLA-Statusseiten.
Was G2-Nutzer über Uptime.com sagen
„Am meisten schätze ich die Flexibilität, praktisch alles anlegen und überwachen und den Status auf einem selbst erstellten Statusbildschirm anzeigen zu können. Dass ich 1-Minuten-Monitore von vielen verschiedenen Standorten in den USA anlegen kann, um Netzwerkprobleme von einem echten Problem zu unterscheiden, ist eine herausragende Funktion.“
„Einfach zu bedienende Oberfläche, einfach zu integrieren, automatische Anrufe sehr wirksam. Der Kundensupport hat sehr schnell reagiert, mein Feedback an die Entwickler weitergegeben und sich regelmäßig mit Neuigkeiten gemeldet.“
Was kostet Uptime.com?
Uptime.com berechnet nach Anzahl der Checks statt nach festen Tarifen:
- 7 $/Monat: 10 einfache Checks, 1 erweiterter Check, 25 SMS-Alarme
- 30 $/Monat: 50 einfache Checks, 5 erweiterte Checks, 75 SMS-Alarme
- 60 $/Monat: 100 einfache Checks, 10 erweiterte Checks, 100 SMS-Alarme
- 600 $/Monat: 1.000 einfache Checks, 100 erweiterte Checks, 1.500 SMS-Alarme
Alle Funktionen sind in jeder Stufe enthalten. Die Einheit, auf die Sie achten sollten, sind die erweiterten Checks (Transaktionen): Sie entsprechen den Browser-Checks von Checkly.
Wo Uptime.com an Grenzen stößt
Kein Monitoring as Code. Wenn Sie Checkly wegen des Workflows mit CLI und Git gewählt haben, ist Uptime.com ein Rückschritt: Der visuelle Editor ist die Hauptoberfläche, und Rezensenten aus Umgebungen mit viel Terraform erwähnen niedrige Rate Limits der API.
Begrenztes Incident-Management. Es gibt weder Bereitschaftsplanung noch eine Verwaltung von Eskalationsrichtlinien. Für die Abläufe der Incident Response brauchen Sie ein separates Tool.
Manche Nutzer berichten von verzögerten Alarmen. Rezensenten auf Capterra haben in bestimmten Konfigurationen verspätete Alarme festgestellt.
Ist Uptime.com das Richtige für Sie?
Wählen Sie Uptime.com, wenn Sie genau den Code-first-Workflow hinter sich lassen wollen. Es passt zu Teams, in denen Nicht-Entwickler das Monitoring verantworten, und zu SRE-Teams, die einen unabhängigen SLA-Nachweis brauchen. Wenn Sie weiter Playwright schreiben, aber die Zählung der Läufe loswerden wollen, passt Hyperping besser.
Cronitor: Am besten für das Monitoring von Cron-Jobs und Hintergrundaufgaben
Für wen Cronitor gedacht ist
Für Teams, die Checkly hauptsächlich für Heartbeat-Monitoring nutzen: Cron-Jobs, Hintergrund-Worker und geplante Aufgaben hinter Abrechnung, Datenpipelines und Backups. Cronitor ist genau für diese Aufgabe gebaut, während Heartbeats bei Checkly eine Nebenfunktion sind.
Nach dem, was ich aus den Bewertungen herausgelesen habe, liegt die Stärke von Cronitor darin, unsichtbare geplante Prozesse sichtbar zu machen. Nutzer beschreiben es als Tool, das „kleine Probleme abfängt, bevor sie zu großen werden“. Teams bei Johnson & Johnson, Reddit, Square und monday.com vertrauen darauf.
Wichtige Funktionen
- Zeitplanbewusstes Cron-Monitoring: Cronitor weiß, wann ein Job laufen und wie lange er dauern sollte, und alarmiert bei fehlenden, langsamen oder fehlschlagenden Läufen, mit konfigurierbaren Karenzzeiten. Die Heartbeat-Checks von Checkly bestätigen, dass ein Ping angekommen ist, analysieren aber kein Timing.
- Job-Timing und Anomalieerkennung: Alarme, wenn Jobs nicht starten, zu lange laufen oder ausbleiben.
- Uptime-Monitoring: Checks für Websites und APIs, in den Business-Tarifen bis hinunter zu einer Frequenz von 30 Sekunden.
- Statusseiten: Einfache, gebrandete und private Varianten mit Benachrichtigungen für Abonnenten.
- Entwicklerfreundliche Einrichtung: Jobs pingen eine URL per curl oder wget, ohne Agent-Installation. Bestehende Crontabs lassen sich automatisch importieren.
Warum Cronitor statt Checkly?
Gebaut für geplante Aufgaben
Checkly behandelt Heartbeats als einen Check-Typ unter vielen, ohne Timing-Analyse. Cronitor versteht Cron-Ausdrücke, erwartete Laufzeiten und Toleranzen. So erkennt es nicht nur einen Job, der nie gepingt hat, sondern auch einen, der zwar lief, aber dreimal so lange wie üblich gebraucht hat.
Preise, die zu einfachen Anforderungen passen
Wenn Sie den Team-Tarif von Checkly vor allem bezahlen, um Cron-Jobs und eine Handvoll Endpunkte zu überwachen, fahren Sie mit Cronitor für 2 $ pro Monitor in der Regel deutlich günstiger.
Was Nutzer über Cronitor sagen
„Wir überwachen zahlreiche automatisierte Prozesse mit Cronitor, und es hat uns geholfen, kleine Probleme abzufangen, bevor sie zu großen wurden.“
„Wir empfehlen es sehr, vor allem kleineren Unternehmen ohne eigenes DevOps-Team. Auch ein relativ kleines IT-Team kann damit eine Vielzahl unterschiedlicher Systeme und Prozesse überwachen, sowohl on-prem als auch in der Cloud.“
Capterra-Bewertungen zu Cronitor
Was kostet Cronitor?
- Free (Hacker): 5 Monitore, einfaches Cron-/Heartbeat- und Website-Monitoring, einfache Statusseite, Prüfintervall von 5 Minuten, 1 Nutzer
- Business: 2 $ pro Monitor, Checks alle 30 Sekunden, weitere Nutzer für 5 $ pro Nutzer und Monat, erweiterte Statusseiten und SSO als Add-ons
- Enterprise: Individuelle Preise, Checks alle 5 Sekunden, erweitertes SSO/SCIM, dedizierter Support
Für die bezahlten Tarife gibt es eine 14-tägige kostenlose Testphase.
Wo Cronitor an Grenzen stößt
Keine Browser-Checks. Cronitor hat überhaupt kein Playwright und kein synthetisches Transaktions-Monitoring. Wenn Browser-Checks ein Grund sind, warum Sie Checkly nutzen, ersetzt Cronitor nur die Hälfte mit Heartbeats und Uptime.
Keine Bereitschaftsplanung und keine Eskalationsrichtlinien. Wie Checkly leitet Cronitor Alarme weiter, verwaltet aber nicht, wer Bereitschaft hat.
Preise pro Monitor summieren sich. Teams mit Hunderten von Jobs berichten von steigenden Kosten. Ein Capterra-Rezensent merkte an: „Wenn Sie viele Crons haben, ist es vielleicht nicht ideal, weil sich die Kosten jetzt nach der Anzahl Ihrer Crons richten.“
Ist Cronitor das Richtige für Sie?
Wählen Sie Cronitor, wenn geplante Jobs Ihre eigentliche Monitoring-Last sind und Browser-Checks keine Rolle spielen. Einen breiteren Blick auf diese Kategorie bietet der Überblick über die besten Tools für Cron-Job-Monitoring.
DIY-Alternative: Playwright in GitHub Actions
Weil Checkly-Checks schlichtes Playwright sind, überlegen manche Teams, sie kostenlos in der CI auszuführen: ein GitHub-Actions-Workflow mit Cron-Trigger, der die Testsuite alle paar Minuten startet und bei einem Fehler alarmiert.
Das funktioniert, und für ein Nebenprojekt reicht es vielleicht. Die Nachteile zeigen sich im Produktionseinsatz: Die Runner sind geteilt und unzuverlässig, Sie jagen also Fehlalarmen hinterher, ohne Gegenprüfung aus mehreren Regionen, die sie herausfiltert. Geplante Workflows auf ausgelasteten Runnern können Minuten zu spät starten oder ganz übersprungen werden. Alarm-Routing, Eskalation, Dashboards und Statusseite gibt es nur, wenn Sie sie selbst bauen. Und häufige Zeitpläne verbrauchen in privaten Repos schnell Ihre Actions-Minuten.
Wenn Sie für einfache Uptime-Checks den Weg des Self-Hostings gehen wollen, ist Uptime Kuma die ausgereifte Open-Source-Option. Es hat aber keine Playwright-basierten Browser-Checks, und Sie sind selbst für die Monitoring-Infrastruktur verantwortlich.
Alle analysierten Checkly-Alternativen
Der Vollständigkeit halber hier das breitere Feld, das ich mir über die Auswahl hinaus angesehen habe:
| Name | Preise (Schätzung 2026) | Größte Stärke | Größte Schwäche |
|---|---|---|---|
| Hyperping | Ab 24 €/Monat | Playwright-Checks zum Festpreis. Browser-Checks, Rufbereitschaft und Statusseiten ohne Zählung der Läufe. | Keine vollständige Observability. Kein Log-Management, kein APM. |
| Better Stack | Kostenlos; bezahlt ab 29 $/Monat | Eine Plattform. Monitoring + Logs + Incidents mit moderner Oberfläche. | Preissprünge. Modulare Preise summieren sich nach dem kostenlosen Tarif schnell. |
| Datadog | 12 $ pro 1.000 Browser-Läufe | Tiefe Observability. Synthetics verknüpft mit Metriken, Logs und Traces. | Komplexe Kosten. Nutzungsbasierte Abrechnung führt zu unvorhersehbaren Rechnungen. |
| Uptime.com | Ab 7 $/Monat | Synthetics ohne Code. Visueller Transaktionseditor, über 30 Check-Typen, SLA-Reporting. | Kein Incident-Management. Braucht ein separates On-Call-Tool. |
| Cronitor | Kostenlos; 2 $ pro Monitor | Cron-Monitoring. Zeitplanbewusste Checks für Hintergrundjobs. | Keine Browser-Checks. Ersetzt nur Heartbeats und Uptime. |
| New Relic | Kostenloser Tarif; 49 $ pro Nutzer und Monat | Synthetics inklusive. Browser- und Skript-Checks innerhalb einer vollständigen APM-Plattform. | Steile Lernkurve. Die Kosten steigen mit der Datenaufnahme. |
| Grafana Cloud | Kostenlos; nutzungsbasiert | k6 und synthetisches Monitoring. Passt gut zu Teams, die schon mit Grafana-Dashboards arbeiten. | Komplexität. Braucht DevOps-Know-how, um die Teile zusammenzusetzen. |
| Pingdom | Ab 18 $/Monat | RUM + Transaktionen. Real User Monitoring mit über 100 Probes weltweit. | Preise bei Wachstum. Die Kosten steigen jenseits von 10 Monitoren stark. |
| Site24x7 | Ab ca. 9 $/Monat | Preis-Leistung. RUM, APM, Server- und Netzwerk-Monitoring zu niedrigem Preis. | Veraltete Oberfläche. Überladen und schwer zu navigieren. |
| UptimeRobot | Kostenlos; Solo ab 12 $/Monat (jährlich, Stand 6. Nov. 2026) | Großzügiger kostenloser Tarif. 50 kostenlose Monitore für einfache Uptime-Checks. | Keine Synthetics. Keine Browser-Checks, keine Bereitschaftsplanung. |
| StatusCake | Kostenlos; 24,49 $/Monat | Monitoring der Seitengeschwindigkeit. Lighthouse-Daten in den Standardtarifen. | Langsamere Entwicklung. Seltenere Funktionsupdates. Siehe den Ratgeber zu StatusCake-Alternativen. |
| Uptime Kuma | Kostenlos (selbst gehostet) | Freiheit durch Self-Hosting. Keine Abo-Kosten, ausgereifte Oberfläche. | Sie sind der SPoF. Kein globales Probe-Netzwerk, keine Browser-Checks. |
| Dynatrace | 0,08 $/Stunde pro Host | KI-Automatisierung. Automatische Erkennung mit Analyse in Echtzeit. | Premium-Preise. Überdimensioniert für rein synthetisches Monitoring. |
| Instatus | Kostenlos; 20 $/Monat | Fokus auf Statusseiten. Schöne Seiten zu niedrigen Kosten. | Kein synthetisches Monitoring. Braucht externe Checks. |
| Pulsetic | Kostenlos; 19 $/Monat | Einfache Uptime-Checks. Ansprechende Statusseiten und Badges zu niedrigem Preis. | Begrenzte Tiefe. Keine Synthetics, keine Verwaltung der Rufbereitschaft. |
So testen Sie diese Tools
Alle fünf Tools der Auswahl bieten Testphasen oder kostenlose Tarife:
- Hyperping: Kostenloser Tarif und 14-tägige Testphase für alle bezahlten Tarife
- Better Stack: Kostenloser Tarif mit Monitoring, Logging und einer Statusseite
- Datadog: 14-tägige kostenlose Testphase mit vollem Zugriff auf die Plattform
- Uptime.com: Tarife ab 7 $/Monat, alle Funktionen inklusive
- Cronitor: Kostenloser Tarif mit 5 Monitoren plus 14-tägige Testphase für die bezahlten Tarife
So bewerten Sie sie:
- Portieren Sie einen echten Playwright-Check von Checkly auf das Kandidaten-Tool (Hyperping und Better Stack übernehmen die Skripte nahezu unverändert) und vergleichen Sie den Einrichtungsaufwand.
- Lassen Sie beide Tools parallel laufen, mindestens eine Woche lang, um Erkennungsgenauigkeit und Fehlalarmquote zu vergleichen.
- Testen Sie die Alarmierung von Anfang bis Ende: Erreicht ein Ausfall die richtige Person, über den richtigen Kanal, schnell genug? Und greift die Eskalation, wenn niemand quittiert?
- Rechnen Sie Ihre echte Nutzung gegen die Preise: Multiplizieren Sie Prüffrequenz, Standorte und Wiederholungen, um zu sehen, was ein Monat bei Tools mit Abrechnung pro Lauf tatsächlich kostet.
- Prüfen Sie die Statusseite: Unterstützt sie Ihre Domain, Ihr Branding und Benachrichtigungen für Abonnenten ohne Zusatzmodul?
So nutzen Sie Hyperping für Playwright-Browser-Monitoring
Wenn Sie Ihre Playwright-Checks von Checkly wegholen, sieht der Ablauf in Hyperping so aus.
1. Browser-Check anlegen
Legen Sie in Hyperping neben Ihren Uptime-Monitoren einen Browser-Check an. Jeder Check ist ein Playwright-Skript, das nach Zeitplan auf der Infrastruktur von Hyperping läuft, mit Video-Replay und Traces bei einem Fehler.
2. Playwright-Skript schreiben oder einfügen
Übernehmen Sie Ihren bestehenden Playwright-Code aus Checkly oder schreiben Sie ein neues Skript für den Ablauf, der Ihnen wichtig ist. Die Standard-Assertions von Playwright funktionieren unverändert. Falls Sie Anregungen brauchen: Ich habe 10 Ideen für End-to-End-Tests mit Playwright gesammelt und einen Leitfaden zu Playwright selbst geschrieben.
3. Regionen und Frequenz wählen
Wählen Sie die Regionen, aus denen Ihr Check läuft. Schlägt ein Check in einer Region fehl, prüft Hyperping aus anderen Regionen gegen, bevor es alarmiert, und diese Gegenprüfung wird nie auf ein Kontingent angerechnet.
4. Alarme über eine Eskalationsrichtlinie leiten
Verknüpfen Sie den Check mit einem Bereitschaftsplan und einer Eskalationsrichtlinie. Ausfälle erreichen die diensthabende Person per Anruf, SMS, Slack oder Teams und werden automatisch eskaliert, wenn niemand quittiert.
5. Ergebnisse auf einer Statusseite veröffentlichen
Fügen Sie den Check einer Statusseite hinzu, damit Ihre Kunden den Zustand echter Nutzerabläufe wie Login und Checkout sehen und nicht nur die Verfügbarkeit einzelner Endpunkte.
Weiterführende Artikel
- Vergleich Hyperping vs. Checkly mit vollständiger Preistabelle
- Playwright-Leitfaden und Ideen für End-to-End-Tests
- Die besten UptimeRobot-Alternativen, wenn Sie einfachere Uptime-Tools vergleichen
- Uptime-Monitoring-Hub mit all unseren Ressourcen zum Monitoring
Weiter vergleichen: Hyperping vs. Checkly · Hyperping vs. Pingdom · Hyperping-Preise · Alle Vergleiche
Häufige Fragen
Welche Checkly-Alternativen sind die besten? ▼
Die stärksten Checkly-Alternativen sind Hyperping (Playwright-Browser-Checks plus Rufbereitschaft und Statusseiten zum Festpreis), Better Stack (Monitoring, Logs und Incident-Management in einer Plattform), Datadog (synthetisches Monitoring innerhalb einer vollständigen Observability-Plattform), Uptime.com (synthetische Checks ohne Code und SLA-Reporting) und Cronitor (Cron-Job- und Uptime-Monitoring).
Warum verlassen Teams Checkly? ▼
Die häufigsten Gründe: eine Abrechnung pro Lauf, die häufiges oder gründliches Testen bestraft, ein modulares Preismodell, bei dem Statusseiten und KI-gestützte Ursachenanalyse extra kosten, keine integrierte Bereitschaftsplanung und keine Eskalationsrichtlinien sowie ein Code-first-Workflow, der weniger technische Kolleginnen und Kollegen außen vor lassen kann.
Welche Checkly-Alternativen unterstützen Playwright? ▼
Hyperping und Better Stack führen Browser-Checks beide mit Playwright aus, bestehende Checkly-Testskripte lassen sich also mit wenig Aufwand übernehmen. Datadog setzt statt auf Playwright auf einen eigenen Recorder für Browser-Tests. Uptime.com nutzt für Transaktions-Checks einen visuellen Editor ohne Code.
Gibt es eine Checkly-Alternative ohne Abrechnung pro Lauf? ▼
Ja. Bei Hyperping sind Playwright-Browser-Checks in den Festpreis-Tarifen enthalten, ohne dass Läufe gezählt werden. Sie zahlen für eine Anzahl von Checks, nicht dafür, wie oft sie laufen, und die Gegenprüfung von Fehlern aus mehreren Regionen verbraucht kein zusätzliches Kontingent.
Was ist die günstigste Checkly-Alternative? ▼
Das hängt davon ab, was Sie überwachen. Cronitor beginnt bei 2 $ pro Monitor für Cron- und Uptime-Checks. Uptime.com beginnt bei 7 $/Monat für 10 Checks. Hyperping beginnt bei 24 €/Monat, enthält dafür aber 50 Monitore, 3 Playwright-Browser-Checks, eine Statusseite und Bereitschaftsplanung und ersetzt damit gleich mehrere Checkly-Module.
Kann ich Playwright-Monitoring selbst betreiben, statt für Checkly zu zahlen? ▼
Sie können Playwright-Tests in GitHub Actions per Cron-Trigger einplanen und bekommen so kostenlos ein einfaches synthetisches Monitoring. Die Nachteile sind allerdings real: keine Gegenprüfung aus mehreren Regionen, kein Alarm-Routing und keine Eskalation, instabile Runner, die Fehlalarme erzeugen, und Sie warten alles selbst.