Ma short-list d’alternatives à Checkly : Hyperping (vérifications Playwright + astreinte + pages de statut pour un prix fixe), Better Stack (monitoring + logs + incidents), Datadog (monitoring synthétique au sein d’une observabilité complète), Uptime.com (monitoring synthétique sans code + rapports SLA) et Cronitor (monitoring des tâches cron + disponibilité). J’ai examiné plus de 30 outils et n’en ai gardé que ces cinq, en m’appuyant sur les avis G2 et Capterra, sur l’étude des produits et sur des échanges avec des équipes d’ingénierie.
Checkly est un vrai bon produit. Son approche monitoring as code, sa CLI et son intégration Playwright sont saluées avis après avis. La plupart des équipes qui partent le font pour l’une de ces quatre raisons : une facturation à l’exécution qui pénalise les tests poussés, un empilement de modules où les pages de statut et l’analyse de cause racine coûtent en plus, l’absence de gestion d’astreinte intégrée, ou une approche code-first qui laisse de côté ceux qui ne développent pas.
Dans ce guide, vous verrez :
- Pourquoi des équipes quittent Checkly (d’après de vrais retours d’utilisateurs, pas des suppositions)
- Cinq alternatives qui règlent des problèmes précis que Checkly ne règle pas
- Des comparaisons de prix honnêtes, chiffres à l’appui
- Quel outil convient à la taille de votre équipe, à votre maturité technique et à votre budget
Si vous voulez des vérifications navigateur Playwright sans comptage des exécutions, un monitoring de disponibilité qui détecte les problèmes en 30 secondes, des plannings d’astreinte avec politiques d’escalade et des pages de statut, le tout dans une seule offre à prix fixe, c’est exactement ce que propose Hyperping. Planifiez une démo pour voir comment ça fonctionne.
Points clés
- Hyperping inclut les vérifications navigateur Playwright, le monitoring de disponibilité, l’astreinte et les pages de statut dans des offres à prix fixe dès 24 €/mois, sans facturation à l’exécution.
- Better Stack réunit monitoring de disponibilité, gestion des logs et réponse aux incidents : d’une vérification en échec, vous passez aux logs correspondants sans quitter la plateforme.
- Datadog intègre le monitoring synthétique à une suite d’observabilité complète (APM, traces, logs), facturé à l’exécution : 12 $ pour 1 000 exécutions de tests navigateur.
- Uptime.com propose un éditeur visuel sans code pour les vérifications de transactions, 30+ types de vérifications et des rapports SLA, dès 7 $/mois.
- Cronitor est le meilleur choix pour les équipes qui utilisent surtout les vérifications heartbeat de Checkly, avec un monitoring cron qui connaît vos planifications, dès 2 $/moniteur.
Pourquoi vous pouvez faire confiance à ce guide
Je suis Léo, fondateur de Hyperping. Oui, j’ai donc un intérêt dans l’un de ces outils. Mais j’ai vu des équipes choisir un concurrent quand il leur convenait vraiment mieux. Mon but n’est pas de vous convaincre qu’Hyperping est toujours la réponse, c’est de vous aider à comprendre quel outil règle réellement votre problème.
J’ai analysé des dizaines d’avis G2 et Capterra, testé moi-même les plateformes, épluché la page de tarifs de Checkly et discuté avec des équipes d’ingénierie de leur expérience. Quand je ne pouvais pas tester quelque chose directement, je me suis fié aux retours d’utilisateurs vérifiés et aux sources documentées.
La short-list en un coup d’œil
| Idéal pour | Produit |
|---|---|
| Vérifications Playwright + astreinte + pages de statut, prix fixe | Hyperping |
| Monitoring + logs + gestion des incidents réunis | Better Stack |
| Monitoring synthétique au sein d’une plateforme d’observabilité complète | Datadog |
| Monitoring synthétique sans code + vérification des SLA | Uptime.com |
| Monitoring des tâches cron et des tâches de fond | Cronitor |
Pourquoi des équipes cherchent une alternative à Checkly
Checkly est bien noté sur G2, et les avis apprécient constamment l’intégration Playwright et l’approche monitoring as code. Les reproches se concentrent ailleurs : la façon dont l’usage est facturé, ce qui coûte en plus, et qui dans l’équipe peut vraiment s’en servir.
La facturation à l’exécution pénalise les tests poussés
Checkly facture le monitoring synthétique à l’exécution. L’offre Team inclut 12 000 exécutions de vérifications navigateur par mois, puis 4 $ par tranche de 1 000 prépayée (ou 6,25 $ en dépassement). Les nouvelles tentatives comptent comme des exécutions. Chaque région en parallèle compte comme une exécution. Une vérification toutes les 10 minutes depuis trois régions consomme déjà plus de 13 000 exécutions par mois, et pour une seule vérification. Le détail des tarifs de Checkly montre comment exécutions, régions et nouvelles tentatives s’additionnent sur chaque offre.
Les utilisateurs le ressentent directement. Un utilisateur sur G2 écrit : « On a l’impression d’être facturé pour chaque respiration de son application. » Un autre décrit la conséquence concrète : « La principale limite, ce sont les quotas d’usage rigides, qui ne nous permettent pas d’exécuter toute notre suite de tests à chaque déploiement de branche ou de staging. »
Les modules s’additionnent
Checkly vend la détection, les pages de statut et l’analyse de cause racine sous forme de modules séparés. L’offre Team coûte 64 $/mois pour le monitoring, plus 30 $/mois pour les pages de statut, plus 39 $/mois pour l’analyse de cause racine par IA. Soit 133 $/mois avant tout dépassement d’exécutions, et les pages de statut en marque blanche exigent toujours Enterprise.
Plusieurs avis pointent aussi l’écart entre les offres. L’un le formule ainsi : « Le modèle tarifaire mériterait un peu plus de souplesse : il n’y a pas assez d’options entre les offres, ce qui est assez limitant puisque notre usage tombe entre deux paliers. » Un autre note : « Monter en charge n’est possible qu’avec une offre Enterprise, et ce n’est pas une partie de plaisir. »
Pas d’astreinte ni de gestion des incidents intégrées
Checkly détecte les problèmes et envoie des alertes, mais la gestion de qui intervient est confiée à des outils externes comme PagerDuty, incident.io ou Rootly. Pas de rotation d’astreinte, pas d’escalade si le premier intervenant n’accuse pas réception, et la communication d’incident sur les pages de statut reste limitée. Comme le note un utilisateur en entreprise : « Les fonctions de tableau de bord/page de statut et d’incidents/maintenances planifiées pourraient être plus riches, pour mieux informer les utilisateurs finaux pendant une panne. »
Pour une équipe qui veut la détection et la réponse au même endroit, cela veut dire un deuxième abonnement et un deuxième outil à configurer.
Le monitoring code-first exclut une partie de l’équipe
Écrire ses vérifications en TypeScript avec Playwright, c’est la grande force de Checkly, et aussi son filtre. Les utilisateurs qui ne développent pas à plein temps le remarquent : « Parfois, c’est un peu trop technique, surtout pour ceux qui ne sont pas développeurs. Mettre en place des vérifications avancées ou bien comprendre une partie de la terminologie peut prendre du temps. » Même des équipes très orientées développement signalent que « la courbe d’apprentissage peut être raide pour les équipes qui débutent dans l’écriture de tests en code ».
Si le support, la QA ou les ops doivent créer ou modifier des vérifications, un workflow 100 % code devient un goulot d’étranglement.
Une résidence des données dans l’UE limitée
Checkly ne vous laisse pas choisir où sont stockées les données de monitoring. Plusieurs utilisateurs européens le signalent : « Les options de résidence des données sont limitées. Pour les équipes soumises à des exigences de conformité strictes (surtout dans l’UE), mieux maîtriser l’emplacement de stockage des données de monitoring serait un gros plus. » Un autre écrit simplement : « J’aimerais pouvoir choisir les zones de stockage des données, puisque je suis basé dans l’UE. »
Comparatif rapide : les alternatives à Checkly
| Outil | Prix de départ | Idéal pour | Principale limite |
|---|---|---|---|
| Hyperping | 24 €/mois (50 moniteurs) | Vérifications Playwright + astreinte + pages de statut, une seule facture | Pas une plateforme d’observabilité complète |
| Better Stack | Gratuit ; payant dès 29 $/mois | Monitoring + logs + incidents réunis | La tarification par modules s’additionne |
| Datadog | 12 $ pour 1 000 exécutions de tests navigateur | Monitoring synthétique corrélé à l’APM, aux traces et aux logs | Des coûts difficiles à prévoir |
| Uptime.com | 7 $/mois (10 vérifications) | Vérifications synthétiques sans code et rapports SLA | Pas de plannings d’astreinte ni d’escalade |
| Cronitor | Gratuit ; 2 $/moniteur | Tâches cron et tâches de fond | Pas de vérifications navigateur Playwright |
Hyperping : idéal pour des vérifications Playwright avec astreinte et pages de statut incluses
À qui s’adresse Hyperping
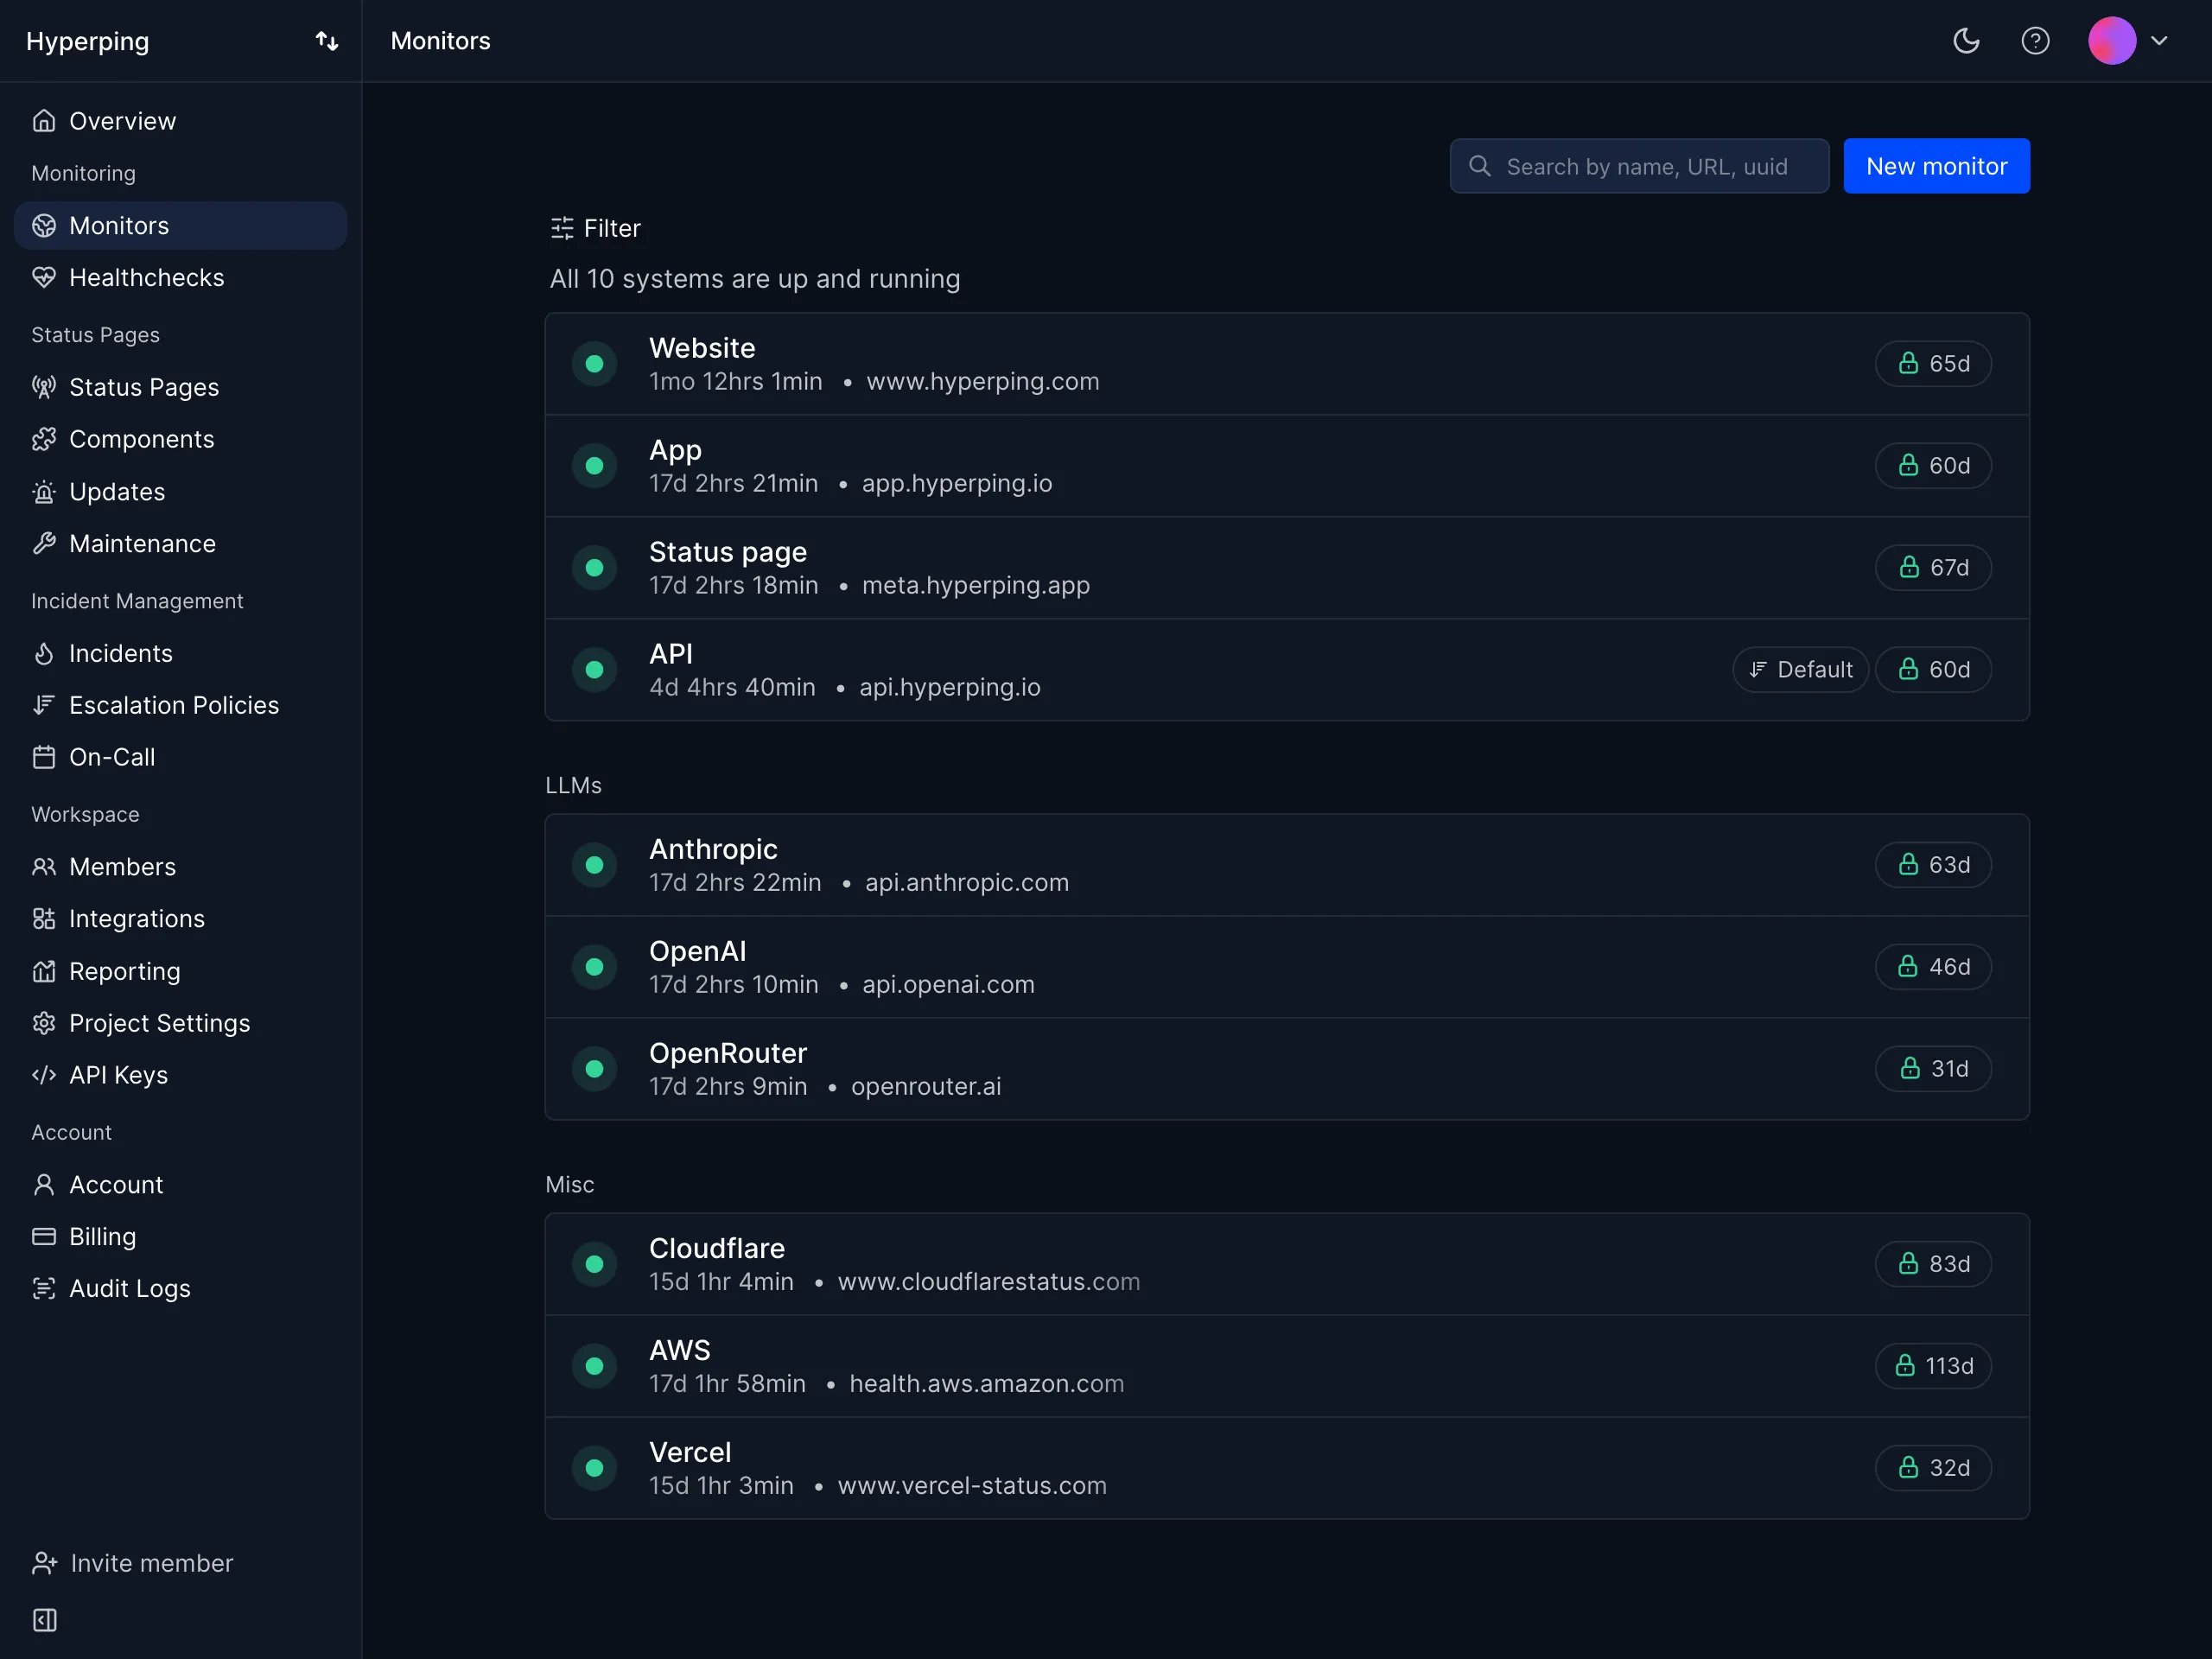
Aux équipes qui aiment l’approche Playwright de Checkly mais veulent le reste du workflow d’incident (plannings d’astreinte, politiques d’escalade, pages de statut) dans la même offre, sans surveiller un compteur d’exécutions. Hyperping se concentre sur l’essentiel, très bien fait, plutôt que d’empiler toutes les fonctionnalités possibles.
D’après les avis et les échanges que j’ai analysés, Hyperping séduit les équipes qui tiennent à la simplicité et à des prix prévisibles. Il est particulièrement apprécié des entreprises européennes : c’est une société française avec un hébergement dans l’UE, ce qui répond directement aux plaintes sur la résidence des données dans les avis Checkly.
Fonctionnalités notables
- Vérifications navigateur Playwright sans comptage des exécutions : écrivez les mêmes scripts Playwright que sur Checkly. Vous payez un nombre de vérifications, pas leur fréquence.
- Protection multirégion contre les faux positifs : un échec dans une région déclenche une revérification depuis d’autres régions avant toute alerte. Sur Checkly, nouvelles tentatives et régions en parallèle consomment des exécutions facturables ; sur Hyperping, la vérification est gratuite.
- Plannings d’astreinte et politiques d’escalade : rotations qui tiennent compte des fuseaux horaires, escalade en plusieurs étapes et accusés de réception intégrés. Checkly délègue tout cela à PagerDuty, incident.io ou Rootly.
- Pages de statut incluses : domaines personnalisés, pages privées, SSO et notifications aux abonnés, au lieu d’un module séparé à 30 $/mois.
- Monitoring de disponibilité toutes les 30 secondes : vérifications HTTP, TCP, DNS, ICMP et heartbeat depuis 19 régions dans le monde, plus une vérification quotidienne des certificats SSL.
- Monitoring as code : un provider Terraform pour les équipes qui gèrent leurs vérifications avec leur infrastructure.
- Hébergement européen : une infrastructure conforme au RGPD, avec toutes les données stockées dans des data centers de l’UE.
Pourquoi choisir Hyperping plutôt que Checkly ?
Une seule offre au lieu de trois modules
La pile Team complète de Checkly (Detect + Communicate + Resolve) atteint 133 $/mois avant les dépassements d’exécutions, et l’astreinte exige toujours un outil externe. Hyperping Pro couvre le monitoring, les vérifications navigateur, les pages de statut, les plannings d’astreinte et la gestion des incidents dans une seule offre à 74 $/mois.
Des vérifications navigateur sans rationnement
Le thème qui revient dans les avis Checkly, c’est l’angoisse du quota : des équipes renoncent aux vérifications en staging ou réduisent la fréquence pour rester sous les limites d’exécutions. Les vérifications navigateur de Hyperping tournent selon leur planification, sans comptage : éviter les faux positifs ou vérifier plus souvent ne gonfle jamais la facture.
Détection et réponse dans le même outil
Quand une vérification Hyperping échoue, l’alerte suit votre politique d’escalade jusqu’à ce que quelqu’un en accuse réception, par appel vocal, SMS, Slack, Teams ou notification push. Les appels vocaux sont illimités. Pas de passage de relais entre un outil de monitoring et un outil d’alerte séparé, et pas de second abonnement facturé au siège.
Pour une comparaison des prix ligne par ligne, voyez le comparatif Hyperping vs Checkly.
Ce qu’en disent les utilisateurs de Hyperping
« Hyperping a complètement changé la donne pour nous. Le service est fiable, simple à utiliser et incroyablement riche en fonctionnalités. J’adore qu’il vérifie en permanence notre site et nous alerte immédiatement au moindre problème. »
« Nous avons rendu notre page de statut Hyperping publique et elle est devenue un élément clé de nos argumentaires commerciaux. Nous sommes fiers de notre disponibilité et nous aimons pouvoir la montrer aussi facilement à nos prospects et à nos clients. »
Combien coûte Hyperping ?
- Essentials : 24 €/mois pour 50 moniteurs, 3 vérifications navigateur, 1 page de statut, 3 sièges
- Pro : 74 €/mois en facturation annuelle pour 250 moniteurs, 10 vérifications navigateur, 3 pages de statut publiques ou privées, 10 sièges. Comprend les codes d’accès par e-mail, les pages multilingues et le SSO SAML natif du compte.
- Business : 249 €/mois en facturation annuelle pour 1 000 moniteurs, 25 vérifications navigateur, 10 pages de statut, des vérifications toutes les 20 secondes, 20 sièges, un support prioritaire, et plus encore
Toutes les offres payantes incluent les plannings d’astreinte, les politiques d’escalade et les alertes par appel vocal. Une offre gratuite (20 moniteurs et une page de statut) et un essai de 14 jours sur les offres payantes sont disponibles.
Les limites de Hyperping
Hyperping ne cherche pas à être une plateforme d’observabilité complète. Pas de gestion des logs, pas d’APM ni de tracing distribué, et pas d’analyse de cause racine par IA comme le module Resolve de Checkly. Si votre workflow repose sur la CLI Checkly, avec des vérifications déployées depuis la CI à chaque commit, l’outillage monitoring as code de Checkly va plus loin : Hyperping propose Terraform et une API, mais pas d’équivalent à npx checkly deploy.
Les vérifications navigateur s’écrivent elles aussi en code Playwright : comme chez Checkly, le volet synthétique s’adresse aux développeurs. Les équipes qui veulent enregistrer leurs vérifications en quelques clics devraient regarder Uptime.com, plus bas.
Hyperping est-il fait pour vous ?
Choisissez Hyperping si vous voulez garder un monitoring synthétique basé sur Playwright sans plus payer à l’exécution, et si vous préférez avoir l’astreinte et les pages de statut incluses plutôt qu’intégrer trois outils. Il est particulièrement adapté aux équipes SaaS qui surveillent des parcours critiques comme le paiement ou la connexion, et aux entreprises européennes qui ont besoin que leurs données restent dans l’UE.
Better Stack : idéal pour réunir monitoring, logs et incidents
À qui s’adresse Better Stack
Aux équipes d’ingénierie qui veulent le monitoring de disponibilité, la gestion des logs et la réponse aux incidents sur une seule plateforme. Better Stack fonctionne bien quand vous voulez passer de « la vérification a échoué » à « voilà ce que disent les logs » sans changer d’outil, soit le problème que le module séparé d’analyse de cause racine par IA de Checkly tente de résoudre avec une option à 39 $/mois.
D’après les avis G2 que j’ai rassemblés, la force de Better Stack est une expérience développeur soignée. Les utilisateurs saluent constamment l’interface moderne et la rapidité de mise en place. Un avis la décrit comme « sans doute la plus belle interface avec laquelle vous aurez jamais à travailler ».
Fonctionnalités notables
- Monitoring synthétique basé sur Playwright : des vérifications de transactions dans le navigateur pour tester les parcours utilisateurs, avec le même framework sous-jacent que Checkly.
- Vérifications de disponibilité toutes les 30 secondes : confirmées depuis au moins trois régions géographiques pour limiter les faux positifs.
- Gestion des logs intégrée : requêtes de type SQL sur un stockage propulsé par ClickHouse. Quand une vérification échoue, les logs utiles sont sur la même plateforme.
- Gestion des incidents : plannings d’astreinte, politiques d’escalade et post-mortems assistés par IA intégrés.
- Alertes multicanal : appel vocal, SMS, Slack, Teams, e-mail et notifications push, avec réduction du bruit.
- Pages de statut : pages publiques et privées, à vos couleurs.
Pourquoi choisir Better Stack plutôt que Checkly ?
Le contexte de la cause racine sans module séparé
Checkly vous dit qu’une vérification a échoué et vend l’analyse de cause racine par IA comme une option à 12-39 $/mois. Better Stack place les logs de votre application à côté de votre monitoring : enquêter sur un échec revient à interroger les logs dans le même onglet, au lieu de sauter vers un autre outil ou de payer un module de plus.
La réponse aux incidents fait partie du produit
Better Stack inclut les rotations d’astreinte, les politiques d’escalade et une gestion des incidents dans Slack. Avec Checkly, toute cette couche vit dans PagerDuty ou incident.io, avec un coût supplémentaire par utilisateur.
Une offre gratuite sans plafond strict d’exécutions
L’offre gratuite de Better Stack comprend 10 moniteurs, une page de statut et des logs de base. L’offre Hobby de Checkly plafonne strictement les vérifications navigateur à 1 000 exécutions par mois, ce qu’une seule vérification toutes les 30 minutes depuis une seule région dépasse déjà.
Ce qu’en disent les utilisateurs sur G2
« BetterStack Uptime est un excellent outil pour surveiller en temps réel la disponibilité des sites et des services. Son interface est moderne, simple à utiliser et agréable au quotidien. J’apprécie de pouvoir configurer rapidement des moniteurs, recevoir des alertes multicanal et partager des pages de statut professionnelles avec mes clients. »
« Il se déploie vite et facilement comme outil de monitoring externe, avec une offre gratuite. Les organisations peuvent ainsi tester la disponibilité et le bon fonctionnement de leurs systèmes sans engagement financier important. »
Combien coûte Better Stack ?
Better Stack applique une tarification par modules qui s’additionne d’un produit à l’autre :
- Offre gratuite : 10 moniteurs, 1 page de statut, rétention des logs limitée
- Moniteurs : 21 $/mois par lot de 50 moniteurs supplémentaires
- Intervenants d’astreinte : 29 $/mois par utilisateur
- Pages de statut : 12 $/mois par page + options avancées
- Moniteurs heartbeat : 17 $/mois par lot de 10
Le saut entre le gratuit et le payant est important. Un utilisateur sur G2 note : « Le premier palier payant démarre à 29 $, ce qui est très cher pour les petits services open source que je fais tourner. »
Les limites de Better Stack
Une tarification par modules, encore. Si vous quittez Checkly parce que les modules s’empilent, Better Stack a le même défaut de structure : frais par intervenant, par lot de moniteurs et par page de statut rendent le coût total difficile à prévoir. Une petite équipe peut atteindre 100-200 $/mois plus vite que prévu.
Pas de métriques natives ni de tracing distribué. Better Stack gère bien les logs et la disponibilité, mais n’offre pas la profondeur de Datadog en métriques d’infrastructure ou en APM.
Des tableaux de bord limités à grande échelle. Les utilisateurs qui gèrent beaucoup de moniteurs signalent une visibilité limitée, et il n’existe pas de tableau de bord unifié montrant l’état de plusieurs équipes.
J’ai détaillé ces compromis dans le guide des alternatives à Better Stack.
Better Stack est-il fait pour vous ?
Choisissez Better Stack si ce qui vous manque le plus dans Checkly, c’est le contexte : vous voulez la vérification en échec, les logs qui l’expliquent et le workflow d’incident dans un seul produit. Sachez que les coûts peuvent grimper à mesure que vous ajoutez moniteurs, intervenants et pages de statut.
Datadog : idéal pour le monitoring synthétique au sein d’une plateforme d’observabilité complète

À qui s’adresse Datadog
Aux organisations qui ont dépassé le stade du monitoring synthétique isolé et veulent des tests navigateur corrélés aux métriques d’infrastructure, aux traces APM et aux logs. Datadog fonctionne bien quand vous devez passer de « la vérification de connexion a échoué » à « voilà le service et la ligne de code exacts en cause ».
D’après les avis G2 que j’ai rassemblés, la force de Datadog est l’observabilité de bout en bout. Les équipes le choisissent quand savoir qu’un service est en panne ne suffit plus et qu’il faut comprendre pourquoi, à l’échelle d’un système distribué.
Fonctionnalités notables
- Monitoring synthétique avec enregistreur de tests : les tests navigateur se créent en enregistrant une session, sans code, et leurs étapes restent modifiables ensuite. Les tests d’API couvrent HTTP, SSL, DNS, TCP et les parcours en plusieurs étapes.
- Métriques, logs et traces réunis : quand un test synthétique échoue, vous pouvez basculer vers la trace backend de cette requête précise et vers les logs qu’elle a produits.
- 650+ intégrations : prise en charge native d’AWS, Azure, GCP, Kubernetes, des bases de données et des outils de CI/CD.
- Détection d’anomalies par IA : Watchdog fait remonter automatiquement les anomalies dans les métriques et les corrèle entre services.
- Real User Monitoring (RUM) : les vraies sessions utilisateurs avec Core Web Vitals, replay de session et erreurs frontend, à côté de vos données synthétiques.
Pourquoi choisir Datadog plutôt que Checkly ?
Du symptôme à la cause sur une seule plateforme
Checkly détecte les échecs et a récemment ajouté l’analyse de cause racine par IA sous forme de module payant. Datadog relie le test navigateur en échec à la trace, au pod et à la ligne de log. Un utilisateur sur G2 le résume bien : « Datadog a remplacé, en un seul package, la dépendance de notre organisation à de nombreux outils différents. Nous utilisions Sentry, une stack ELK auto-hébergée, Grafana, Jaeger, OpsGenie. »
Des tests synthétiques que toute l’équipe peut créer
L’enregistreur de tests navigateur de Datadog permet à la QA et au support de créer des tests en cliquant à travers un parcours, ce qui répond au reproche « trop technique pour les non-développeurs » qui revient dans les avis Checkly. Les développeurs peuvent toujours gérer les tests via Terraform et l’API.
Un monitoring qui suit le reste de votre stack
Si vous utilisez déjà Datadog pour l’infrastructure ou l’APM, y ajouter le monitoring synthétique, c’est un fournisseur de moins, un seul pipeline d’alertes et des tableaux de bord qui mêlent résultats synthétiques et tout le reste.
Ce qu’en disent les utilisateurs sur G2
« Ce que je préfère dans Datadog, c’est qu’il réunit métriques, logs et traces au même endroit. Le tableau de bord est très intuitif, et il est facile de mettre en place un monitoring en temps réel des applications et de l’infrastructure. »
« Les intégrations natives avec AWS, Azure et Kubernetes sont un énorme atout et font gagner beaucoup de temps de configuration. »
Combien coûte Datadog ?
La tarification de Datadog dépend de l’usage, et le monitoring synthétique est facturé à l’exécution, comme chez Checkly :
- Tests d’API synthétiques : 5 $ pour 10 000 exécutions de tests/mois
- Tests navigateur synthétiques : 12 $ pour 1 000 exécutions de tests/mois
- Infrastructure Monitoring : 15 $/hôte/mois (Pro)
- APM : 31 $/hôte/mois (Pro)
- Log Management : 0,10 $/Go ingéré, plus les coûts d’indexation
Un essai gratuit de 14 jours donne un accès complet. Notez que les tests navigateur coûtent à peu près deux fois le tarif de dépassement de Checkly par exécution : Datadog gagne donc rarement sur le seul prix du synthétique. Il gagne sur la corrélation.
Les limites de Datadog
L’imprévisibilité des prix est le reproche le plus constant dans les avis. Les coûts peuvent s’envoler avec l’ingestion de logs, les métriques personnalisées et les spans APM. Un utilisateur note : « La facture peut grimper vite, surtout quand on active plusieurs fonctionnalités comme la gestion des logs, l’APM et les métriques personnalisées. »
Démesuré pour le seul monitoring synthétique. Si vous n’avez besoin que de vérifications navigateur, de monitoring de disponibilité et d’une page de statut, la plateforme Datadog (et sa courbe d’apprentissage) dépasse de loin le besoin.
Les pages de statut ne sont pas sa priorité. La communication d’incident envers les clients est plus faible que dans les outils dédiés ; la plupart des équipes sous Datadog l’associent à un produit de page de statut séparé.
Si c’est le prix de Datadog qui vous gêne, j’ai écrit un guide dédié aux alternatives à Datadog.
Datadog est-il fait pour vous ?
Choisissez Datadog si vous êtes une équipe mid-market ou grand compte qui exploite des systèmes distribués et que vous voulez des vérifications synthétiques corrélées aux métriques, aux traces et aux logs. Préparez-vous à investir du temps pour apprendre la plateforme et à surveiller les coûts de près.
Uptime.com : idéal pour le monitoring synthétique sans code et la vérification des SLA
À qui s’adresse Uptime.com
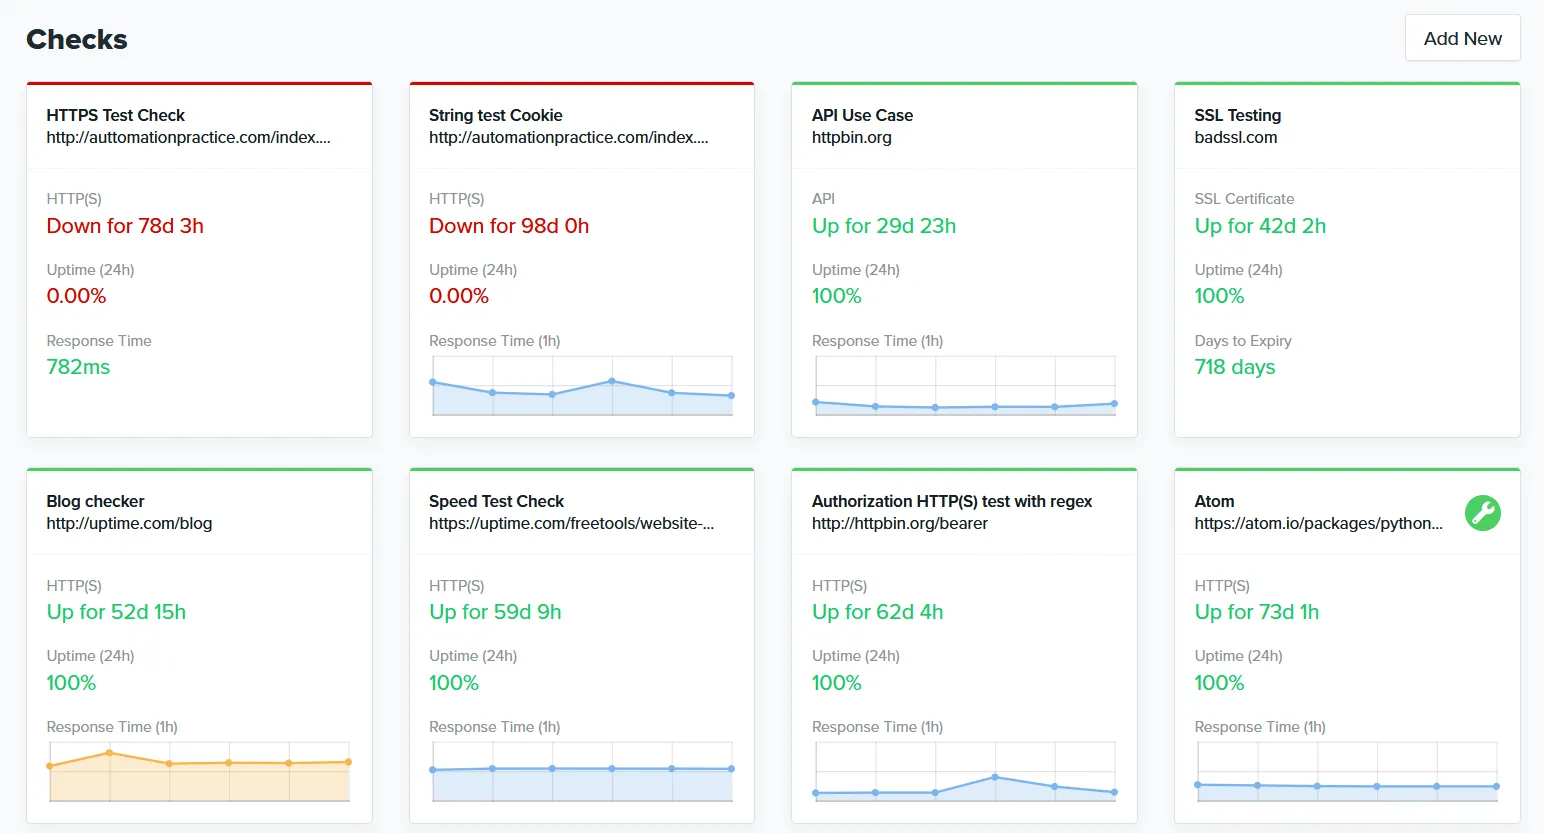
Aux équipes qui veulent un monitoring de transactions sans écrire de code Playwright. L’éditeur visuel d’Uptime.com construit des vérifications synthétiques en plusieurs étapes (connexion, formulaires, tunnels) par pointer-cliquer, ce qui en fait le choix naturel quand les responsables du monitoring ne sont pas développeurs.
D’après les avis que j’ai rassemblés, les forces d’Uptime.com sont l’étendue de ses types de vérifications et son accent sur la conformité aux SLA : prouver la disponibilité aux clients avec des données indépendantes issues de nombreuses régions dans le monde.
Fonctionnalités notables
- Monitoring synthétique sans code : un éditeur visuel pour créer des vérifications de transactions sans script. C’est la réponse directe aux utilisateurs de Checkly qui trouvaient la plateforme « un peu trop technique, surtout pour ceux qui ne sont pas développeurs ».
- 30+ types de vérifications : HTTPS, ping, DNS, SSL/certificat, TCP/UDP, Whois/domaine, monitoring d’API, monitoring de transactions, vitesse de page, monitoring heartbeat, et d’autres.
- 80+ régions de monitoring dans le monde : plus des sondes en emplacement privé pour surveiller les applications internes derrière un pare-feu.
- Logique d’alerte avancée : une vérification configurable conçue pour réduire les faux positifs.
- Rapports SLA et pages de statut : pages publiques, privées et de type SLA pour la communication d’incident.
- Applications mobiles : des applications natives iOS et Android, ce que Checkly ne propose pas.
Pourquoi choisir Uptime.com plutôt que Checkly ?
Des vérifications synthétiques que tout le monde dans l’équipe peut créer
Les vérifications Checkly sont du TypeScript et du Playwright. Celles d’Uptime.com se construisent dans un éditeur visuel : la QA, le support et les ops peuvent les créer et les maintenir sans environnement de développement ni revue de code.
Toutes les fonctionnalités à tous les prix
Checkly réserve les nouvelles tentatives automatiques, ses 22 régions et les emplacements privés à l’offre Team, avec les pages de statut et la RCA en modules séparés. Uptime.com inclut toutes les fonctionnalités à chaque palier ; vous ne choisissez que le nombre de vérifications et d’alertes SMS.
Une vérification indépendante des SLA
Si vous faites du synthétique pour prouver à vos clients que vous respectez vos SLA, les rapports d’Uptime.com sont conçus exactement pour cela, avec des vérifications de santé des domaines et des pages de statut de type SLA.
Ce qu’en disent les utilisateurs sur G2
« Ce que j’apprécie le plus, c’est la souplesse : pouvoir créer et surveiller pratiquement n’importe quoi et afficher l’état sur un écran de statut conçu soi-même. Pouvoir créer des moniteurs à 1 minute depuis de nombreuses régions des États-Unis pour distinguer un problème réseau d’un vrai incident est une fonctionnalité remarquable. »
« Interface facile à utiliser, simple à intégrer, appels téléphoniques automatiques très efficaces. Le support client a été très réactif, a transmis mes retours à leurs développeurs et m’a tenu régulièrement informé. »
Combien coûte Uptime.com ?
Uptime.com facture au nombre de vérifications plutôt qu’avec des offres fixes :
- 7 $/mois : 10 vérifications basiques, 1 vérification avancée, 25 alertes SMS
- 30 $/mois : 50 vérifications basiques, 5 vérifications avancées, 75 alertes SMS
- 60 $/mois : 100 vérifications basiques, 10 vérifications avancées, 100 alertes SMS
- 600 $/mois : 1 000 vérifications basiques, 100 vérifications avancées, 1 500 alertes SMS
Toutes les fonctionnalités sont incluses à chaque palier. Les vérifications avancées (transactions) sont l’unité à surveiller : ce sont l’équivalent des vérifications navigateur de Checkly.
Les limites d’Uptime.com
Pas de monitoring as code. Si c’est le workflow CLI et Git de Checkly qui vous l’a fait choisir, Uptime.com est un retour en arrière : l’éditeur visuel est l’interface principale, et des utilisateurs dans des environnements très Terraform signalent des limites de débit d’API basses.
Une gestion des incidents limitée. Pas de plannings d’astreinte ni de gestion des politiques d’escalade. Il vous faudra un outil séparé pour vos workflows de réponse aux incidents.
Certains utilisateurs signalent des alertes en retard. Des avis Capterra mentionnent des alertes retardées dans certaines configurations.
Uptime.com est-il fait pour vous ?
Choisissez Uptime.com si l’approche code-first est précisément ce que vous cherchez à quitter. Il convient aux équipes où ce sont des non-développeurs qui gèrent le monitoring, et aux équipes SRE qui ont besoin d’une vérification indépendante des SLA. Si vous voulez continuer à écrire du Playwright sans le comptage des exécutions, Hyperping vous conviendra mieux.
Cronitor : idéal pour le monitoring des tâches cron et des tâches de fond
À qui s’adresse Cronitor
Aux équipes qui utilisent surtout Checkly pour le monitoring heartbeat : tâches cron, workers en arrière-plan et tâches planifiées derrière la facturation, les pipelines de données et les sauvegardes. Cronitor est conçu précisément pour cela, alors que les heartbeats ne sont qu’une fonction annexe chez Checkly.
D’après les avis que j’ai rassemblés, la force de Cronitor est de rendre visibles des processus planifiés qui, sinon, passent inaperçus. Les utilisateurs le décrivent comme un outil qui « repère les petits problèmes avant qu’ils ne deviennent gros ». Des équipes de Johnson & Johnson, Reddit, Square et monday.com lui font confiance.
Fonctionnalités notables
- Monitoring cron qui connaît vos planifications : Cronitor sait quand une tâche doit s’exécuter et combien de temps elle doit durer, et alerte en cas d’exécution manquante, lente ou en échec, avec des délais de grâce configurables. Les vérifications heartbeat de Checkly confirment qu’un ping est arrivé, sans analyser les durées.
- Suivi des durées et détection d’anomalies : alertes quand une tâche ne démarre pas, dure trop longtemps ou disparaît.
- Monitoring de disponibilité : vérifications de sites et d’API jusqu’à toutes les 30 secondes sur les offres Business.
- Pages de statut : options basique, à vos couleurs et privée, avec notifications aux abonnés.
- Mise en place pensée pour les développeurs : les tâches pinguent une URL via curl ou wget, sans agent à installer. Les crontabs existantes peuvent être importées automatiquement.
Pourquoi choisir Cronitor plutôt que Checkly ?
Conçu pour les tâches planifiées
Checkly traite les heartbeats comme un type de vérification parmi d’autres, sans analyse des durées. Cronitor comprend les expressions cron, les durées attendues et les tolérances : il repère une tâche qui s’est exécutée mais a pris trois fois plus de temps que d’habitude, et pas seulement une tâche qui n’a jamais pingué.
Des prix adaptés aux besoins simples
Si vous payez l’offre Team de Checkly surtout pour surveiller des tâches cron et une poignée d’endpoints, la tarification à 2 $/moniteur de Cronitor reviendra en général bien moins cher.
Ce qu’en disent les utilisateurs de Cronitor
« Nous surveillons de nombreux processus automatisés avec Cronitor, et il nous a aidés à repérer de petits problèmes avant qu’ils ne deviennent gros. »
« Nous le recommandons vivement, surtout aux petites entreprises sans équipe DevOps dédiée. Il permet à une équipe IT relativement réduite de surveiller toute une variété de systèmes et de processus, sur site comme dans le cloud. »
Combien coûte Cronitor ?
- Free (Hacker) : 5 moniteurs, monitoring cron/heartbeat de base + monitoring de sites, page de statut basique, vérifications toutes les 5 minutes, 1 utilisateur
- Business : 2 $/moniteur, vérifications toutes les 30 secondes, utilisateurs supplémentaires à 5 $/utilisateur/mois, pages de statut avancées et SSO en options
- Enterprise : prix sur mesure, vérifications toutes les 5 secondes, SSO/SCIM avancés, support dédié
Un essai gratuit de 14 jours est proposé sur les offres payantes.
Les limites de Cronitor
Pas de vérifications navigateur. Cronitor n’a ni Playwright ni monitoring de transactions synthétiques. Si les vérifications navigateur font partie des raisons pour lesquelles vous utilisez Checkly, Cronitor ne remplace que la moitié heartbeat et disponibilité.
Pas de plannings d’astreinte ni de politiques d’escalade. Comme Checkly, Cronitor achemine les alertes mais ne gère pas qui est d’astreinte.
La tarification par moniteur s’additionne. Les équipes qui ont des centaines de tâches voient les coûts grimper. Un utilisateur sur Capterra note : « Si vous avez beaucoup de crons, ce n’est peut-être pas idéal, puisque le coût dépend désormais du nombre de crons. »
Cronitor est-il fait pour vous ?
Choisissez Cronitor si votre besoin de monitoring, ce sont les tâches planifiées, et non les vérifications navigateur. Pour un tour plus large de cette catégorie, voyez les meilleurs outils de monitoring des tâches cron.
L’alternative maison : Playwright dans GitHub Actions
Comme les vérifications Checkly sont du Playwright standard, certaines équipes envisagent de les faire tourner gratuitement en CI : un workflow GitHub Actions avec un déclencheur cron, qui lance la suite de tests toutes les quelques minutes et alerte en cas d’échec.
Ça marche, et pour un projet perso, cela peut suffire. Les compromis apparaissent en production : les runners sont partagés et instables, vous courez donc après des faux positifs sans vérification multirégion pour les filtrer. Les workflows planifiés sur des runners chargés peuvent démarrer avec plusieurs minutes de retard, voire être sautés. Pas de routage des alertes, d’escalade, de tableaux de bord ni de page de statut, à moins de les construire vous-même. Et des planifications fréquentes consomment vite les minutes Actions sur les dépôts privés.
Si vous voulez la voie auto-hébergée pour des vérifications de disponibilité de base, Uptime Kuma est l’option open source la plus aboutie, mais elle n’a pas de vérifications navigateur basées sur Playwright, et l’infrastructure de monitoring elle-même devient votre responsabilité.
Toutes les alternatives à Checkly analysées
Pour être complet, voici le reste du terrain que j’ai examiné au-delà de la short-list :
| Nom | Prix (estimation 2026) | Principale force | Principale faiblesse |
|---|---|---|---|
| Hyperping | Dès 24 €/mois | Vérifications Playwright à prix fixe. Vérifications navigateur, astreinte et pages de statut sans comptage des exécutions. | Pas une observabilité complète. Pas de gestion des logs ni d’APM. |
| Better Stack | Gratuit ; payant dès 29 $/mois | Plateforme unifiée. Monitoring + logs + incidents avec une interface moderne. | Sauts de prix. La tarification par modules grimpe vite au-delà de l’offre gratuite. |
| Datadog | 12 $ pour 1 000 exécutions navigateur | Observabilité poussée. Monitoring synthétique corrélé aux métriques, aux logs et aux traces. | Coûts complexes. La facturation à l’usage donne des factures imprévisibles. |
| Uptime.com | Dès 7 $/mois | Synthétique sans code. Éditeur visuel de transactions, 30+ types de vérifications, rapports SLA. | Pas de gestion des incidents. Exige un outil d’astreinte séparé. |
| Cronitor | Gratuit ; 2 $/moniteur | Monitoring cron. Des vérifications qui connaissent la planification des tâches de fond. | Pas de vérifications navigateur. Ne remplace que les heartbeats et la disponibilité. |
| New Relic | Offre gratuite ; 49 $/utilisateur/mois | Synthétique inclus. Vérifications navigateur et scriptées au sein d’une plateforme APM complète. | Courbe d’apprentissage raide. Les coûts montent avec l’ingestion de données. |
| Grafana Cloud | Gratuit ; à l’usage | k6 et monitoring synthétique. Très adapté aux équipes déjà sur les tableaux de bord Grafana. | Complexité. Il faut des compétences DevOps pour assembler les briques. |
| Pingdom | Dès 18 $/mois | RUM + transactions. Real User Monitoring avec 100+ sondes dans le monde. | Prix à grande échelle. Les coûts bondissent au-delà de 10 moniteurs. |
| Site24x7 | Dès ~9 $/mois | Bon rapport qualité-prix. RUM, APM, monitoring serveur et réseau à petit prix. | Interface datée. Une interface chargée, difficile à parcourir. |
| UptimeRobot | Gratuit ; Solo dès 12 $/mois (en annuel, tarif affiché au 6 nov. 2026) | Offre gratuite généreuse. 50 moniteurs gratuits pour des vérifications de disponibilité de base. | Pas de synthétique. Ni vérifications navigateur ni plannings d’astreinte. |
| StatusCake | Gratuit ; 24,49 $/mois | Monitoring de la vitesse des pages. Données Lighthouse dans les offres standard. | Développement plus lent. Nouvelles fonctionnalités moins fréquentes. Voir le guide des alternatives à StatusCake. |
| Uptime Kuma | Gratuit (auto-hébergé) | La liberté de l’auto-hébergement. Aucun abonnement, avec une interface soignée. | Le SPoF, c’est vous. Pas de réseau mondial de sondes, pas de vérifications navigateur. |
| Dynatrace | 0,08 $/heure par hôte | Automatisation par IA. Découverte automatique avec analyse en temps réel. | Tarifs premium. Démesuré pour le seul monitoring synthétique. |
| Instatus | Gratuit ; 20 $/mois | Centré sur les pages de statut. De belles pages pour pas cher. | Pas de monitoring synthétique. Exige des vérifications externes. |
| Pulsetic | Gratuit ; 19 $/mois | Vérifications de disponibilité simples. Pages de statut et badges soignés à petit prix. | Profondeur limitée. Ni synthétique ni gestion de l’astreinte. |
Comment tester ces outils
Les cinq outils de la short-list proposent un essai ou une offre gratuite :
- Hyperping : offre gratuite et essai de 14 jours sur toutes les offres payantes
- Better Stack : offre gratuite avec monitoring, logs et une page de statut
- Datadog : essai gratuit de 14 jours avec accès complet à la plateforme
- Uptime.com : offres dès 7 $/mois, toutes fonctionnalités incluses
- Cronitor : offre gratuite avec 5 moniteurs, plus un essai de 14 jours sur les offres payantes
Pour les évaluer :
- Portez une vraie vérification Playwright de Checkly vers l’outil candidat (Hyperping et Better Stack acceptent les scripts presque tels quels) et comparez le temps de mise en place.
- Faites tourner les deux outils en parallèle pendant au moins une semaine pour comparer la précision de détection et le taux de faux positifs.
- Testez le workflow d’alerte de bout en bout : un échec atteint-il la bonne personne, par le bon canal, assez vite, et l’escalade fonctionne-t-elle quand personne n’accuse réception ?
- Confrontez votre usage réel aux tarifs : multipliez fréquence de vérification, régions et nouvelles tentatives pour voir ce que coûte vraiment un mois sur les outils facturés à l’exécution.
- Vérifiez la page de statut : prend-elle en charge votre domaine, votre charte et les notifications aux abonnés sans module supplémentaire ?
Comment utiliser Hyperping pour le monitoring navigateur avec Playwright
Si vous migrez vos vérifications Playwright depuis Checkly, voici la marche à suivre dans Hyperping.
1. Créer une vérification navigateur
Dans Hyperping, ajoutez une vérification navigateur à côté de vos moniteurs de disponibilité. Chaque vérification est un script Playwright exécuté à intervalle régulier depuis l’infrastructure de Hyperping, avec replay vidéo et traces en cas d’échec.
2. Écrire ou coller votre script Playwright
Reprenez votre code Playwright existant chez Checkly ou écrivez un nouveau script pour le parcours qui compte pour vous. Les assertions Playwright standard fonctionnent telles quelles. Pour trouver l’inspiration, j’ai rassemblé 10 idées de tests Playwright de bout en bout et un guide sur Playwright lui-même.
3. Choisir les régions et la fréquence
Choisissez les régions depuis lesquelles votre vérification s’exécute. Quand une vérification échoue dans une région, Hyperping revérifie depuis les autres avant d’alerter, et cette revérification n’est jamais décomptée d’un quota.
4. Router les alertes via une politique d’escalade
Rattachez la vérification à un planning d’astreinte et à une politique d’escalade. Les échecs parviennent à la personne d’astreinte par appel vocal, SMS, Slack ou Teams, et l’escalade se déclenche automatiquement si personne n’accuse réception.
5. Publier les résultats sur une page de statut
Ajoutez la vérification à une page de statut pour que vos clients voient l’état des vrais parcours utilisateurs, comme la connexion et le paiement, et pas seulement la disponibilité des endpoints.
Pour aller plus loin
- Comparatif Hyperping vs Checkly avec un tableau de prix complet
- Guide Playwright et idées de tests de bout en bout
- Meilleures alternatives à UptimeRobot si vous comparez des outils de disponibilité plus simples
- Hub du monitoring de disponibilité pour toutes nos ressources sur le monitoring
Continuer la comparaison : Hyperping vs Checkly · Hyperping vs Pingdom · Tarifs de Hyperping · Tous les comparatifs
Questions fréquentes
Quelles sont les meilleures alternatives à Checkly ? ▼
Les alternatives à Checkly les plus solides sont Hyperping (vérifications navigateur Playwright, astreinte et pages de statut pour un prix fixe), Better Stack (monitoring, logs et gestion des incidents réunis), Datadog (monitoring synthétique au sein d’une plateforme d’observabilité complète), Uptime.com (vérifications synthétiques sans code et rapports SLA) et Cronitor (monitoring des tâches cron et de la disponibilité).
Pourquoi des équipes quittent-elles Checkly ? ▼
Les raisons les plus fréquentes : une facturation à l’exécution qui pénalise les tests fréquents ou poussés, une tarification par modules où les pages de statut et l’analyse de cause racine par IA coûtent en plus, l’absence de plannings d’astreinte et de politiques d’escalade intégrés, et une approche code-first qui peut laisser de côté les membres moins techniques de l’équipe.
Quelles alternatives à Checkly prennent en charge Playwright ? ▼
Hyperping et Better Stack exécutent tous deux leurs vérifications navigateur avec Playwright : vos scripts de test Checkly se transposent sans gros effort. Datadog utilise son propre enregistreur de tests navigateur plutôt que Playwright. Uptime.com s’appuie sur un éditeur visuel sans code pour les vérifications de transactions.
Existe-t-il une alternative à Checkly sans facturation à l’exécution ? ▼
Oui. Hyperping inclut les vérifications navigateur Playwright dans des offres à prix fixe, sans comptage des exécutions. Vous payez un nombre de vérifications, pas leur fréquence, et la revérification multirégion des échecs ne consomme aucun quota supplémentaire.
Quelle est l’alternative à Checkly la moins chère ? ▼
Tout dépend de ce que vous surveillez. Cronitor démarre à 2 $/moniteur pour le monitoring cron et de disponibilité. Uptime.com démarre à 7 $/mois pour 10 vérifications. Hyperping démarre à 24 €/mois mais inclut 50 moniteurs, 3 vérifications navigateur Playwright, une page de statut et les plannings d’astreinte, de quoi remplacer plusieurs modules Checkly d’un coup.
Puis-je faire tourner mon propre monitoring Playwright au lieu de payer Checkly ? ▼
Vous pouvez planifier vos tests Playwright dans GitHub Actions avec un déclencheur cron et obtenir gratuitement un monitoring synthétique de base. Les contreparties sont bien réelles : pas de vérification multirégion, pas de routage des alertes ni d’escalade, des runners instables qui produisent des faux positifs, et tout cela reste à maintenir vous-même.